


การปฏิวัติ GPU: เราทำให้ Ethereum เร็วขึ้น 1,000 เท่าด้วยการพิสูจน์ความรู้เป็นศูนย์ได้อย่างไร


บทความนี้จะวิเคราะห์ความก้าวหน้าทางเทคโนโลยีที่สำคัญ: ผ่านการผสมผสานระหว่าง GPU ประสิทธิภาพสูงและการพิสูจน์ความรู้เป็นศูนย์ เราจะเพิ่มประสิทธิภาพการทำงานของ Ethereum ได้หลายร้อยหรือแม้กระทั่งหลายพันเท่า สิ่งนี้ไม่เพียงแต่ช่วยแก้ไขปัญหาคอขวดด้านประสิทธิภาพของบล็อคเชนที่มีมายาวนานเท่านั้น แต่ยังมอบเส้นทางทางเทคนิคที่เป็นไปได้สำหรับโครงสร้างพื้นฐาน Web3 ในอนาคตอีกด้วย
หากคุณเคยสงสัยว่าทำไม Ethereum ถึงช้ามากและค่าธรรมเนียมธุรกรรมก็สูงด้วย? หรือคุณกำลังมุ่งเน้นไปที่ปัจจัยขับเคลื่อนหลักของเทคโนโลยีบล็อคเชนรุ่นถัดไปหรือไม่? บทความนี้จะให้คำตอบที่ชัดเจนแก่คุณ
ธรรมชาติของปัญหา: เหตุใดบล็อคเชนจึงเหมือนทางด่วนที่มีการจราจรติดขัด?
คิดว่า Ethereum เป็นทางหลวง ในปัจจุบัน ผู้ใช้และแอปพลิเคชันต่างๆ ทั้งหมดกำลังแข่งขันกันเพื่อแย่งทรัพยากรเครือข่ายที่มีจำกัด ส่งผลให้เกิดความแออัดของเครือข่าย การประมวลผลธุรกรรมล่าช้า และค่าธรรมเนียมก๊าซที่สูง
มีวิธีแก้ไขแบบดั้งเดิมอยู่เพียงสองวิธีเท่านั้น:
สร้างเลนเพิ่มเติม นั่นคือ สร้างเครือข่ายเลเยอร์ 2 (เช่น Rollups)
ทำให้ยานพาหนะมีขนาดเล็กลง นั่นคือ บีบอัดข้อมูลธุรกรรม
แต่จะเกิดอะไรขึ้นหากมีวิธีที่จะ "เทเลพอร์ต" ยานพาหนะแทนที่จะขับต่อไปในเลน? นี่คือการเปลี่ยนแปลงกระบวนทัศน์ที่เกิดจาก Zero-Knowledge Proofs (ZKPs) แนวคิดหลักคือสามารถตรวจยืนยันความถูกต้องของธุรกรรมได้โดยการสร้างหลักฐานทางคณิตศาสตร์โดยไม่ต้องส่งข้อมูลธุรกรรมทั้งหมด กล่าวอีกนัยหนึ่ง เราไม่จำเป็นต้องปล่อยให้รถทุกคันขับบนทางหลวงอีกต่อไป แต่สามารถตรวจสอบได้โดยตรงว่า "รถเหล่านี้ไปถึงจุดสิ้นสุดแล้วจริงๆ" วิธีการนี้ไม่เพียงช่วยลดภาระในการส่งข้อมูลเท่านั้น แต่ยังทำให้ "ปริมาณงานสูง + ความปลอดภัยที่แข็งแกร่ง + การตรวจสอบที่ไม่ต้องไว้วางใจ" เข้ากันได้อีกด้วย
The Verge: วิวัฒนาการครั้งต่อไปของ Ethereum
ในปัจจุบัน Ethereum กำลังพัฒนาแผนเทคโนโลยีอันยิ่งใหญ่ที่เรียกว่า The Verge ซึ่งคุณสามารถเข้าใจได้ว่าเป็น "แผนการลดน้ำหนัก" ของ Ethereum เป้าหมายคือการลดเกณฑ์ในการรันโหนด Ethereum อย่างมีนัยสำคัญ ให้ง่ายพอๆ กับการรันแอปบนโทรศัพท์มือถือ ในอนาคตทุกคนจะสามารถเข้าร่วมเครือข่าย Ethereum ได้อย่างง่ายดายโดยไม่ต้องพึ่งพาคอมพิวเตอร์สำหรับเล่นเกมประสิทธิภาพสูง
แผนนี้มีความท้าทายทางเทคนิคสำคัญอยู่ประการหนึ่ง นั่นก็คือ ต้องทำการคำนวณทางคณิตศาสตร์ที่ซับซ้อนนับล้านๆ รายการให้เสร็จภายในเวลาอันสั้นมาก
นี่เป็นทิศทางการพัฒนาที่ก้าวล้ำอย่างแท้จริงที่ทีม Polyhedra มุ่งเน้น นั่นคือการใช้ GPU เพื่อเร่งการคำนวณ ZK ขนาดใหญ่ และปรับปรุงประสิทธิภาพการดำเนินการอย่างมีนัยสำคัญพร้อมทั้งรับประกันความปลอดภัยในการตรวจสอบ
ความท้าทายทางเทคนิค: ชุดข้อมูลนี้จะทำลายความสามารถในการรับรู้ของคุณ
เพื่อทำความเข้าใจความซับซ้อนที่เรากำลังเผชิญ นี่คือขนาดที่แท้จริงของการดำเนินการบนเครือข่ายของ Ethereum ในปัจจุบัน:
การยืนยันความยินยอม:
แต่ละบล็อกประกอบด้วยการคำนวณแฮช SHA 2-256 ประมาณ 90 ล้านรายการและการตรวจสอบลายเซ็นดิจิทัล BLS 2,048 รายการหลักฐานการเปลี่ยนผ่านสถานะ:
แต่ละบล็อกต้องใช้การดำเนินการแฮช Keccak ประมาณ 500,000 ครั้งปัญหาคอขวดในปัจจุบัน:
ปัจจุบันตัวพิสูจน์ความรู้เป็นศูนย์ที่ใช้ CPU (Prover) สามารถประมวลผลการคำนวณแฮช Poseidon ได้เพียงประมาณ 2 ล้านครั้งต่อวินาทีเท่านั้น
ความท้าทายที่แท้จริงก็คือ เราจำเป็นต้องใช้เทคโนโลยีพิสูจน์ความรู้เป็นศูนย์เพื่อดำเนินการทั้งหมดข้างต้นให้เสร็จสมบูรณ์ ซึ่งไม่ต้องสงสัยเลยว่าจะเพิ่มความซับซ้อนในการคำนวณขึ้นอย่างมาก
จุดเปลี่ยนแปลง: การปฏิวัติการประมวลผลด้วย GPU
อย่างที่เราทราบกันดีว่า GPU ถือเป็นที่ชื่นชอบของเหล่าเกมเมอร์และวิศวกร AI แต่ในความเป็นจริงแล้ว หน่วยประมวลผลกราฟิกเหล่านี้ได้แสดงให้เห็นถึงความสามารถที่เหนือกว่า CPU มากในการจัดการการคำนวณทางคณิตศาสตร์แบบขนานจำนวนมากที่จำเป็นสำหรับการพิสูจน์ความรู้เป็นศูนย์
ที่ Polyhedra เราได้ปรับแต่งระบบพิสูจน์ ZK ให้เหมาะสมกับ GPU โดยเฉพาะ และบรรลุประสิทธิภาพอันล้ำสมัย:
ประสิทธิภาพก้าวกระโดดเหนือความคาดหมาย
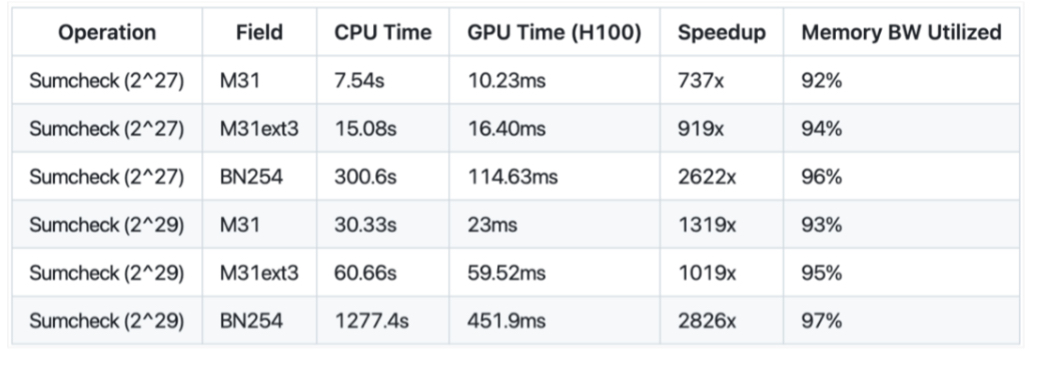
การดำเนินการทางคณิตศาสตร์พื้นฐาน (Mersenne 31 field) เร็วกว่า 362 เท่า
การดำเนินการเข้ารหัสที่ซับซ้อน (เส้นโค้งวงรี BN 254) ได้รับการเร่งความเร็วถึง 2826 เท่า
การคำนวณความรู้เป็นศูนย์ที่เดิมใช้เวลา 21 นาที ตอนนี้ถูกบีบอัดเหลือเพียง 450 มิลลิวินาที
กล่าวอีกนัยหนึ่ง เท่ากับว่าเวลาเดินทางในชั่วโมงเร่งด่วนประจำวันของคุณลดลงจาก 20 นาทีเหลือเพียงไม่ถึงครึ่งวินาที นี่ไม่ใช่การเพิ่มประสิทธิภาพแบบเพิ่มทีละน้อย แต่เป็นการก้าวกระโดดในการประมวลผลในระดับกระบวนทัศน์
เหตุใดความก้าวหน้าครั้งสำคัญนี้จึงสำคัญกับคุณ?
ต้นทุนธุรกรรมที่ต่ำลง: การสร้างหลักฐานที่รวดเร็วยิ่งขึ้นหมายถึงการลดต้นทุนการคำนวณโดยรวมอย่างมาก ซึ่งนำไปสู่ค่าธรรมเนียมก๊าซที่ต่ำลง ผลประโยชน์ทั้งสามประการทั้งผู้ใช้และเครือข่าย
การรับประกันความปลอดภัยที่เข้มงวดยิ่งขึ้น: จำตอนที่เราพูดถึงว่างบประมาณความปลอดภัยประจำปีของ Ethereum สูงเกินกว่า 40 ล้านดอลลาร์ได้หรือไม่? ด้วยเทคโนโลยีของเรา โหนดเบาสามารถตรวจสอบโซ่ฉันทามติ Ethereum ทั้งหมดได้อย่างง่ายดาย และเพลิดเพลินไปกับความปลอดภัยระดับเมนเน็ตโดยไม่ต้องใช้ทรัพยากรจำนวนมาก
การดำเนินการโหนดที่ได้รับความนิยมมากขึ้น โทรศัพท์มือถือยังสามารถรัน Ethereum ได้ด้วย: การเพิ่มประสิทธิภาพอย่างต่อเนื่องของเราในด้านประสิทธิภาพและประสิทธิผลทำให้สามารถรันโหนด Ethereum บนอุปกรณ์ทั่วไปได้ ในอนาคตการตรวจสอบข้อมูลบล็อคเชนอาจต้องใช้เพียงโทรศัพท์มือถือเท่านั้น
หลักเทคนิค: เราทำอย่างไร
1. การออกแบบดั้งเดิมของ GPU: โปรโตคอล Sumcheck ที่ได้รับการปรับให้เหมาะสมสำหรับ CUDA
การใช้งาน Sumcheck ของเราที่ใช้ CUDA ใช้ประโยชน์จากข้อดีของการประมวลผลแบบขนานของ GPU ได้อย่างเต็มที่:
ออกแบบเคอร์เนล CUDA แบบกำหนดเองสำหรับการดำเนินการฟิลด์ตัวเลข (การบวก การคูณ การยกกำลัง)
เพิ่มการใช้แบนด์วิดท์ของ GPU ให้สูงสุดด้วยการใช้โหมดการเข้าถึงหน่วยความจำแบบรวม (RTX 4090 วัดแบนด์วิดท์ได้สูงสุดถึง 1,008 GB/วินาที)
ใช้ไพรมิทีฟระดับการบิดเบี้ยวเพื่อให้เกิดการดำเนินการลดขนาดที่มีประสิทธิภาพ (การลดขนาด)
การปรับแต่งในระดับลึกนี้หมายความว่าโปรโตคอล Sumcheck ไม่ถูกจำกัดด้วยคอขวดแบบอนุกรมของ CPU อีกต่อไป
2. หน่วยความจำคือราชา: การเพิ่มประสิทธิภาพคอขวดแบนด์วิดท์ มุมมองแบบเดิมคือคอขวดการประมวลผลของ ZK Prover อยู่ที่พลังการประมวลผล แต่หลักฐานเชิงประจักษ์ของเราแสดงให้เห็นว่า Sumcheck เป็นปัญหาคอขวดแบนด์วิดท์หน่วยความจำทั่วไป:
การวิเคราะห์ปริมาณงานหน่วยความจำ: การใช้แบนด์วิธสูงถึง 95% ของขีดจำกัดสูงสุดตามทฤษฎี
การเพิ่มประสิทธิภาพโครงสร้างข้อมูล: การใช้ Structure-of-Arrays (SoA) เพื่อแทนที่โครงสร้าง Array-of-Structures (AoS) แบบดั้งเดิม
ปรับปรุงการใช้หน่วย SM: ปรับแต่งการกำหนดค่าบล็อกเธรดเพื่อให้ใช้งานฮาร์ดแวร์ได้อย่างเหมาะสมที่สุด
ด้วยการแก้ไขปัญหาปริมาณข้อมูลผ่านหน่วยความจำ เราจึงสามารถเปลี่ยนการประมวลผล ZK ให้เป็นงานสตรีมมิ่งที่มีประสิทธิภาพอย่างแท้จริง
3. กลยุทธ์การปรับแต่งที่กำหนดเองสำหรับโดเมนตัวเลขที่แตกต่างกัน
ฟิลด์การเข้ารหัสต่างๆ จะมีลักษณะการทำงานที่แตกต่างกัน เราได้ปรับแต่งเส้นทางการเพิ่มประสิทธิภาพให้เหมาะกับแต่ละสาขาหลัก:
Mersenne 31 (M 31): การเพิ่มประสิทธิภาพจำนวนเต็ม 31 บิต โครงสร้างเลขคณิตโมดูลาร์ที่มีประสิทธิภาพ
M 31 ext 3: การรองรับสนามขยาย โดยคำนึงถึงการขยายพหุนามและค่าใช้จ่ายต่ำ
BN 254: ตัวคูณแบบกำหนดเองตามอัลกอริทึมของมอนต์โกเมอรี ออกแบบมาสำหรับฟิลด์จำนวนเต็มขนาดใหญ่ 254 บิต
การเพิ่มประสิทธิภาพพื้นฐานที่กำหนดเป้าหมายอย่างแม่นยำนี้ทำให้ ZK Prover ของเรามีความอเนกประสงค์และมีประสิทธิภาพอย่างยิ่ง
การแยกย่อยข้อมูลประสิทธิภาพ: การเพิ่มประสิทธิภาพเกิดขึ้นที่ใด
เราไม่ได้แค่ทำให้มัน “เร็วขึ้นมาก” เท่านั้น แต่เรายังผลักดันประสิทธิภาพของ ZK สู่ระดับที่ไม่เคยมีมาก่อน ข้อมูลประสิทธิภาพที่วัดได้มีดังนี้:
สถาปัตยกรรมทางเทคนิคเปิดเผย: ความจริงที่ซ่อนอยู่
สแต็กโปรโตคอล GKR: แกนหลักของการเร่งความเร็ว
การเพิ่มประสิทธิภาพการเร่งความเร็วของเรามุ่งเน้นไปที่โปรโตคอล GKR (Goldwasser-Kalai-Rothblum) ซึ่งรวมถึง:
ชั้น GKR เชิงเส้น: ใช้ในการประมวลผลเกตการบวกและการคูณ
โปรโตคอล Sumcheck: คอขวดด้านประสิทธิภาพ คิดเป็นเกือบ 50% ของเวลาประมวลผล CPU ทั้งหมด
เฟสการประเมินพหุนาม: ลดเวลาการคำนวณจาก 8.4 วินาทีเป็น 9.5 มิลลิวินาทีบน GPU
คำอธิบายโดยละเอียดเกี่ยวกับการออกแบบแกน GPU
ระยะที่ 1: การประเมินพหุนาม
การคำนวณแบบขนานบนจุด 2^n
ใช้ปัจจัยแคชหน่วยความจำร่วมกันเพื่อปรับปรุงความเร็วในการเข้าถึง
การลดขนาดอย่างมีประสิทธิภาพด้วยการสับเปลี่ยนวาร์ป
ระยะที่ 2: การสร้างความท้าทาย
ดำเนินการแฮช Fiat-Shamir ภายใน GPU เพื่อหลีกเลี่ยงการสลับ CPU-GPU บ่อยครั้ง
ลดความล่าช้าในการสื่อสารระหว่าง CPU และ GPU
การเพิ่มประสิทธิภาพการส่งข้อมูลหน่วยความจำ: เปิด "ไมล์สุดท้าย" ของการไหลของข้อมูล
นอกจากนี้ เรายังทำการเพิ่มประสิทธิภาพอย่างเป็นระบบในการโต้ตอบระหว่าง CPU และ GPU เพื่อให้แน่ใจว่าแบนด์วิดท์ไม่ใช่คอขวด:
การเพิ่มประสิทธิภาพการรับส่งข้อมูล PCIe: ประมวลผล 2^{27} องค์ประกอบในเวลาเพียง 737 มิลลิวินาที
หน่วยความจำที่ติดไว้: รองรับการถ่ายโอนข้อมูลแบบ "ไม่มีสำเนา" ช่วยลดต้นทุนการจำลองข้อมูล
การกำหนดตารางการทำงานแบบอะซิงโครนัส: การคำนวณและการสื่อสารดำเนินการควบคู่กันเพื่อใช้ทรัพยากรให้เกิดประโยชน์สูงสุด
พูดตรงๆ ว่ายังคงมีความท้าทายอยู่
เราจะยืนกรานเสมอว่าความโปร่งใส - การเร่งความเร็วด้วย GPU ไม่ใช่วิธีแก้ปัญหาทุกประการ ในการส่งเสริมการขายจริง เรายังพบกับปัญหาทางเทคนิคมากมาย:
1. แบนด์วิดท์หน่วยความจำถึงจุดสูงสุด
แม้ว่า H100 จะมีแบนด์วิดท์สูงถึง 3.35 TB/s แต่ก็จะกลายเป็นคอขวดด้านประสิทธิภาพภายใต้โหลดสูง
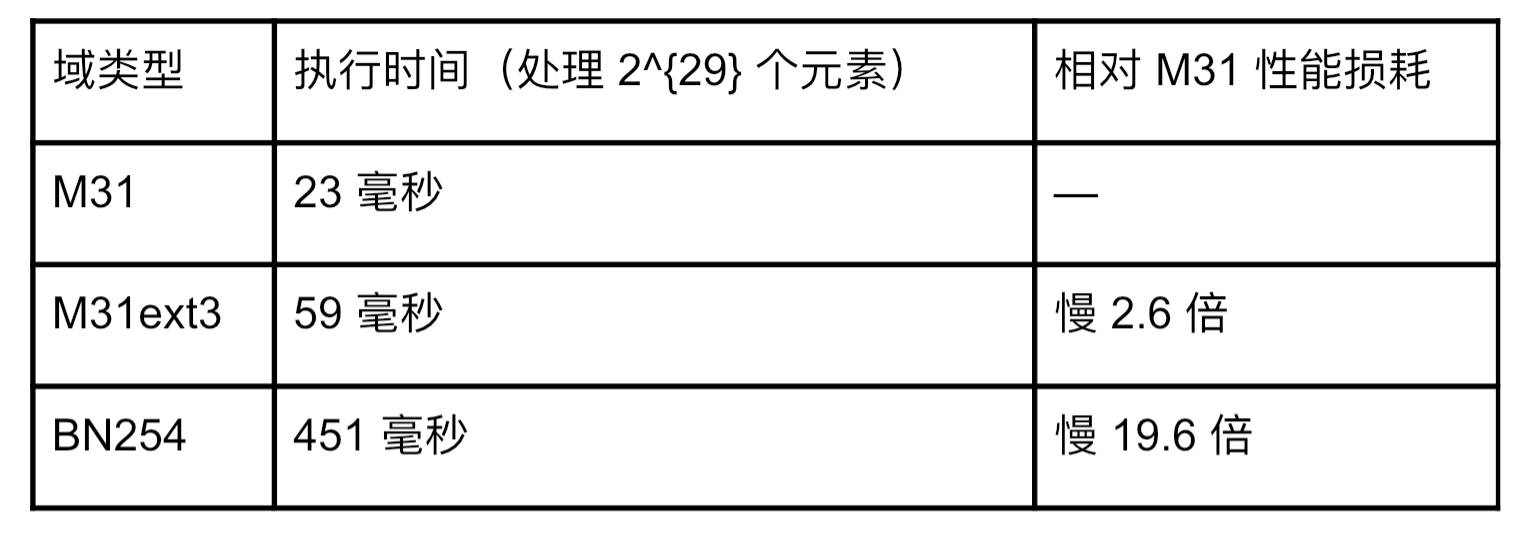
ในทางตรงกันข้าม โดเมนเส้นโค้งวงรีขนาดใหญ่ (เช่น BN 254) จะถึงด้านบนได้เร็วกว่าโดเมนขนาดเล็ก (เช่น M 31)
2. ความจุหน่วยความจำ GPU มีจำกัด
RTX 4090 หมดหน่วยความจำเมื่อประมวลผล 2^{29} องค์ประกอบ
จำเป็นต้องมีกลยุทธ์การกำหนดตารางหน่วยความจำที่ซับซ้อนในการใช้งานจริงเพื่อหลีกเลี่ยงความเสี่ยงจากการล้น
3. การแลกเปลี่ยนระหว่างขนาดโดเมนและประสิทธิภาพ
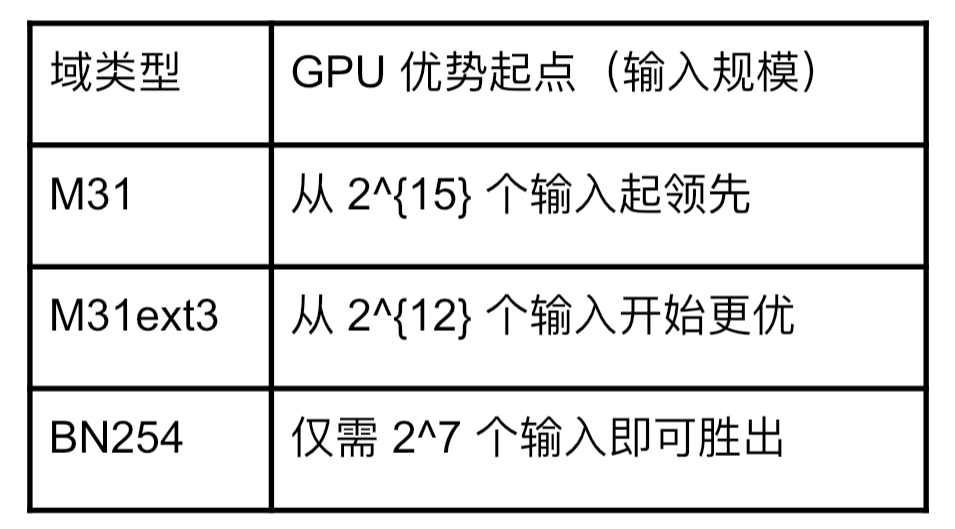
4. การเปรียบเทียบ “ข้อได้เปรียบของ GPU”: เริ่มที่จะแซงหน้า CPU ตั้งแต่เมื่อใด?
การทดสอบประสิทธิภาพการทำงานข้ามแพลตฟอร์ม
เราได้ทำการประเมินประสิทธิภาพบน GPU หลายประเภท โดยครอบคลุมทั้งฮาร์ดแวร์ระดับผู้บริโภคและศูนย์ข้อมูล:
GPU สำหรับผู้บริโภค
RTX 3090: แบนด์วิดท์หน่วยความจำ 936 GB/s ประสิทธิภาพดีขึ้นถึง 951 เท่า
RTX 4090: แบนด์วิดท์หน่วยความจำ 1008 GB/s ประสิทธิภาพดีขึ้นถึง 1565 เท่า
GPU สำหรับศูนย์ข้อมูล
NVIDIA H100: แบนด์วิดท์สูงสุด 3.35 TB/s และปรับปรุงประสิทธิภาพสูงสุด 2826 เท่า
ข้อสรุปชัดเจน: แบนด์วิดท์หน่วยความจำเป็นตัวแปรสำคัญในการเร่งความเร็วแบบพิสูจน์ความรู้เป็นศูนย์
มองไปข้างหน้า: แผนงานของเรา
เราไม่ได้หยุดอยู่แค่นั้น และเราจะดำเนินการตามเป้าหมายต่อไปนี้ต่อไป:
ความเร็วที่เพิ่มขึ้นอย่างสุดขั้ว: กำหนดเป้าหมายความเร็วที่เพิ่มขึ้น 10,000 เท่าสำหรับการดำเนินการบางอย่าง
ความเข้ากันได้ของฮาร์ดแวร์ที่กว้างขึ้น: จากการ์ดจอเกมประสิทธิภาพสูงไปจนถึงการ์ดเร่งความเร็วระดับศูนย์ข้อมูล
การบูรณาการ Ethereum ดั้งเดิม: เรากำลังทำงานร่วมกับทีมพัฒนาไคลเอนต์ Ethereum เพื่อบูรณาการ GPU ZK proof stack ของเราโดยตรงลงในเลเยอร์ L1
มาร่วมคลื่นแห่งการเปลี่ยนแปลงนี้!
นี่ไม่เพียงแต่เป็นการเพิ่มความเร็วเท่านั้น แต่ยังเป็นการปรับเปลี่ยนการเข้าถึงบล็อคเชนโดยสมบูรณ์อีกด้วย ไม่ว่าคุณจะเป็นใคร คุณสามารถหาหนทางในการมีส่วนร่วมได้:
นักพัฒนา: ลองดูที่คลังข้อมูล Expander และ CUDA ของเราเพื่อสร้างอนาคตร่วมกัน
ผู้เรียน: ติดตามสัมมนาการวิจัยและการเจาะลึกเทคโนโลยีของเราเพื่อให้ทันสมัย
ทุกคน: เผยแพร่เทคโนโลยีนี้! ยิ่งผู้คนเข้าใจมากขึ้น อนาคตของ Web3 ก็ใกล้เข้ามามากขึ้นเท่านั้น
การทบทวนแนวคิดหลัก
เรากำลังอยู่ในจุดเปลี่ยนทางเทคโนโลยีที่น่าตื่นเต้น การผสมผสานระหว่างการพิสูจน์ความรู้เป็นศูนย์และการเร่งความเร็ว GPU ไม่เพียงแต่เป็นการปรับปรุงประสิทธิภาพเล็กน้อยเท่านั้น แต่ยังเป็นการเปลี่ยนแปลงขนานใหญ่ด้วย
เรากำลังกำหนดขอบเขตของความเร็ว ต้นทุน และการใช้งานได้ของ Ethereum ใหม่
รายชื่อความสำเร็จทางเทคโนโลยีที่สำคัญ:
ZK Proofs สำหรับสภาพแวดล้อมการผลิตเร่งความเร็วได้มากกว่า 1,000 เท่า
การใช้แบนด์วิดท์หน่วยความจำ GPU เกิน 95%
การใช้งานโอเพ่นซอร์สพร้อมสำหรับการบูรณาการ
อนาคตของ Web3 ไม่เพียงแต่จะเป็นแบบกระจายอำนาจเท่านั้น แต่ยังรวดเร็วอย่างน่าเหลือเชื่อ และมาเร็วกว่าที่คุณคิด
สิ่งที่คุณตื่นเต้นที่สุดในบรรดาการพัฒนาเหล่านี้คืออะไร? โปรดอย่าลังเลที่จะแสดงความคิดเห็นหรือแชทกับฉันทาง Twitter เรายินดีที่จะหารือเกี่ยวกับรายละเอียดทางเทคนิคเหล่านี้ในเชิงลึก!
อนาคตเป็นของความเร็วและเป็นของตัวคุณด้วย จนกว่าจะพบกันใหม่ สร้างต่อไป ไม่ใช่แค่เร็วขึ้นเท่านั้น!





