


GPU革命:ゼロ知識証明でイーサリアムを1,000倍高速化した方法


この記事では、重要な技術的進歩を分析します。高性能 GPU とゼロ知識証明を組み合わせることで、Ethereum の動作効率が数百倍、あるいは数千倍も向上します。これにより、ブロックチェーンの長年のパフォーマンスボトルネックが解決されるだけでなく、将来の Web3 インフラストラクチャに実現可能な技術的パスも提供されます。
「なぜイーサリアムはこんなに遅くて、取引コストはこんなに高いのだろう?」と疑問に思ったことはありませんか?それとも、次世代のブロックチェーン技術の主要な推進力に焦点を当てていますか?さて、この記事では明確な答えを提供します。
問題の本質: なぜブロックチェーンは交通渋滞のある高速道路のようなのでしょうか?
Ethereum を高速道路として考えてみましょう。現在、すべてのユーザーとアプリケーションが限られたレーン リソースをめぐって競争しており、その結果、ネットワークの輻輳、トランザクション処理の遅延、ガス料金の高騰といった問題が発生しています。
従来の解決策は次の 2 つしかありません。
レーンを増やす - つまり、レイヤー2ネットワーク(ロールアップなど)を構築する
車両を小型化する、つまり取引データを圧縮する
しかし、車線内で車線を詰め続けるのではなく、車両を「テレポート」する方法があったらどうなるでしょうか?これは、ゼロ知識証明 (ZKP) によってもたらされたパラダイムシフトです。その中心的なアイデアは、トランザクションデータ自体をすべて送信することなく、数学的証明を生成することでトランザクションの信頼性を検証できるというものです。つまり、すべての車を高速道路を通過させる必要はなくなり、「これらの車が確かに終点に到達した」ということを直接検証できるようになります。これにより、データ転送の負担が軽減されるだけでなく、「高スループット+強固なセキュリティ+トラストレスな検証」を両立することが可能となります。
The Verge: イーサリアムの次の進化
イーサリアムは現在、壮大な技術的青写真(The Verge)を進めており、これはイーサリアムの「スリム化計画」として理解できます。目標は、Ethereum ノードを実行するためのハードルを大幅に下げ、携帯電話でアプリを実行するのと同じくらい簡単にすることです。将来的には、高性能なゲーミングコンピュータに頼ることなく、誰もが簡単に Ethereum ネットワークに参加できるようになります。
しかし、この計画の背後には重要な技術的課題があります。それは、非常に短時間で何百万もの複雑な数学的計算を完了する必要があることです。
これはまさに、Polyhedra チームが注力している画期的な方向性、つまり GPU を使用して大規模な ZK 計算を高速化し、検証のセキュリティを確保しながら実行効率を大幅に向上させる方法です。
技術的課題: このデータセットはあなたの認知を覆すでしょう
私たちが取り組んでいる複雑さを理解するために、イーサリアムの現在のオンチェーン操作の実際の規模を以下に示します。
コンセンサス検証:
各ブロックには、約 9,000 万回の SHA 2-256 ハッシュ計算と 2,048 回の BLS デジタル署名検証が含まれています。状態遷移の証明:
各ブロックには約50万回のKeccakハッシュ演算が必要です現在のボトルネック:
CPUベースのゼロ知識証明器(Prover)は現在、1秒あたり約200万回のPoseidonハッシュ計算しか処理できない。
本当の課題は、上記のすべての操作を完了するためにゼロ知識証明技術を使用する必要があり、計算の複雑さが間違いなく大幅に増加することです。
ブレークスルーポイント:GPUコンピューティング革命
周知のとおり、GPU はゲーマーや AI エンジニアに人気があります。しかし実際には、これらのグラフィックス プロセッシング ユニットは、ゼロ知識証明に必要な超並列数学計算の処理に関しては、CPU よりもはるかに優れた能力を発揮しています。
Polyhedra では、ZK 証明システムを GPU 向けにネイティブに最適化し、画期的なパフォーマンスを実現しました。
予想をはるかに超えるパフォーマンスの飛躍
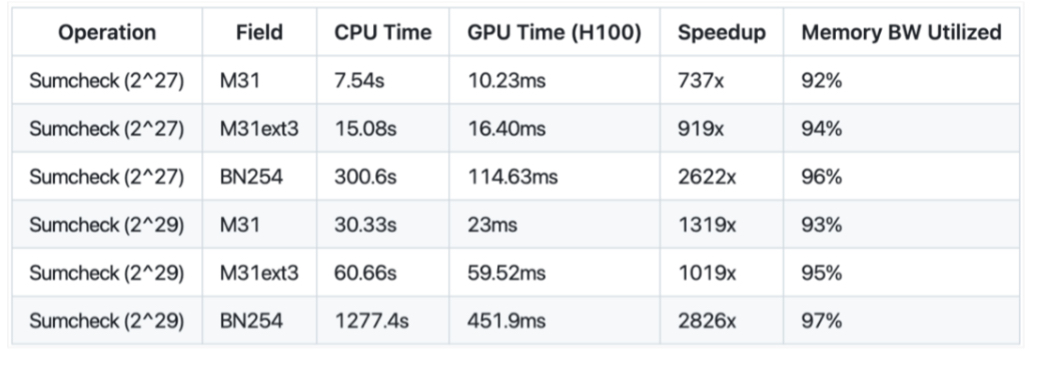
基本的な数学演算(メルセンヌ31体)は362倍高速です
複雑な暗号演算(BN254楕円曲線)は最大2826倍高速化されます
当初21分かかっていたゼロ知識計算が、わずか450ミリ秒にまで短縮されました。
言い換えれば、毎日の通勤ラッシュ時間が 20 分から 0.5 秒未満に短縮されるのと同じです。これは増分最適化ではなく、パラダイムレベルのコンピューティングの飛躍です。
この画期的な進歩はなぜあなたにとって重要なのでしょうか?
取引コストの削減: 証明生成が高速化されると、全体的な計算コストが大幅に削減され、ガス料金も削減されます。ユーザーとネットワークの双方にメリットがあります。
より強力なセキュリティ保証: Ethereum の年間セキュリティ予算が 4,000 万ドルを超えると述べたことを覚えていますか?当社のテクノロジーにより、ライトノードは Ethereum コンセンサス チェーン全体を簡単に検証し、膨大なリソースを費やすことなくメインネット レベルのセキュリティを享受できるようになります。
ノード操作がより普及し、携帯電話でも Ethereum を実行できるようになりました。パフォーマンスと効率性の継続的な最適化により、一般的なデバイスで Ethereum ノードを実行できるようになりました。将来的には、ブロックチェーンのデータの検証には携帯電話のみが必要になるかもしれません。
テクニカルコア:私たちのやり方
1. GPUネイティブ設計:CUDAに最適化されたSumcheckプロトコル
CUDA に基づく当社の Sumcheck 実装は、 GPU の並列コンピューティングの利点を最大限に活用します。
数体演算(加算、乗算、累乗)用のカスタム CUDA カーネルを設計する
統合メモリアクセスモードを使用して GPU 帯域幅の使用率を最大化します (RTX 4090 の測定帯域幅は最大 1008 GB/秒)
ワープレベルのプリミティブを使用して効率的な削減操作を実現する (削減)
このレベルの詳細なカスタマイズにより、Sumcheck プロトコルは CPU のシリアルボトルネックによって制限されなくなります。
2. メモリが王様:帯域幅のボトルネックの最適化 従来の見方では、ZK Prover の計算ボトルネックは計算能力にあると考えられていましたが、私たちの経験的証拠は、Sumcheck が典型的なメモリ帯域幅のボトルネックの問題であることを示しています。
メモリスループット分析: 帯域幅使用率が理論上の上限の95%以上に達する
データ構造の最適化: 従来の構造体配列 (AoS) 構造を構造体配列 (SoA) に置き換える
SMユニットの使用率の向上: 最適なハードウェア使用率を実現するためにスレッドブロック構成を最適化しました。
メモリ スループットの問題を解決することで、ZK コンピューティングを真に効率的なストリーミング タスクに変えました。
3. 異なる数値領域に合わせたカスタマイズされた最適化戦略
暗号化分野によって動作特性は異なります。私たちは、それぞれの主流分野に合わせて最適化パスをカスタマイズしています。
メルセンヌ31(M31):31ビット整数最適化、効率的なモジュラー演算構造
M 31 ext 3: 多項式展開と低オーバーヘッドを考慮した拡張フィールドのサポート
BN 254: 254ビットの大きな整数フィールド用に設計された、モンゴメリアルゴリズムに基づくカスタム乗算器
この高度にターゲットを絞った基礎的な最適化により、ZK Prover は多用途かつ非常に効率的になります。
パフォーマンスデータの内訳: 最適化が行われる場所
単に「大幅に高速化」しただけではなく、ZK のパフォーマンスを前例のないレベルにまで引き上げました。測定されたパフォーマンス データは次のとおりです。
技術アーキテクチャの解明:内部の真実
GKRプロトコルスタック:加速の核
当社の加速最適化は、以下の GKR (Goldwasser-Kalai-Rothblum) プロトコルに重点を置いています。
線形 GKR 層: 加算ゲートと乗算ゲートの処理に使用される
Sumcheckプロトコル: パフォーマンスのボトルネックであり、CPU計算時間全体の約50%を占める
多項式評価フェーズ: GPU での計算時間が 8.4 秒から 9.5 ミリ秒に短縮されました。
GPUコア設計の詳細な説明
フェーズ1:多項式評価
2^n点の並列計算
共有メモリキャッシュ係数を使用してアクセス速度を向上させる
ワープシャッフルによる効率的な削減操作
フェーズ2:課題の生成
頻繁なCPU-GPU切り替えを回避するために、GPU内でFiat-Shamirハッシュ演算を実行する
CPUとGPU間の通信遅延を削減
メモリ転送の最適化: データフローの「ラストマイル」を開放
また、帯域幅がボトルネックにならないように、CPU と GPU の相互作用を体系的に最適化しました。
PCIeデータスループットの最適化:わずか737ミリ秒で2^{27}要素を処理
固定メモリ:「ゼロコピー」データ転送をサポートし、複製コストを削減します。
非同期操作スケジューリング: 計算と通信は、リソース利用率を最大化するために並行して実行されます。
正直に言うと、課題はまだ存在する
私たちは常に透明性を重視しています。GPU アクセラレーションは万能薬ではありません。実際のプロモーションでは、多くの技術的なボトルネックにも遭遇しました。
1. メモリ帯域幅はピークに達した
H100 は最大 3.35 TB/s の帯域幅を備えていますが、高負荷時にはパフォーマンスのボトルネックになります。
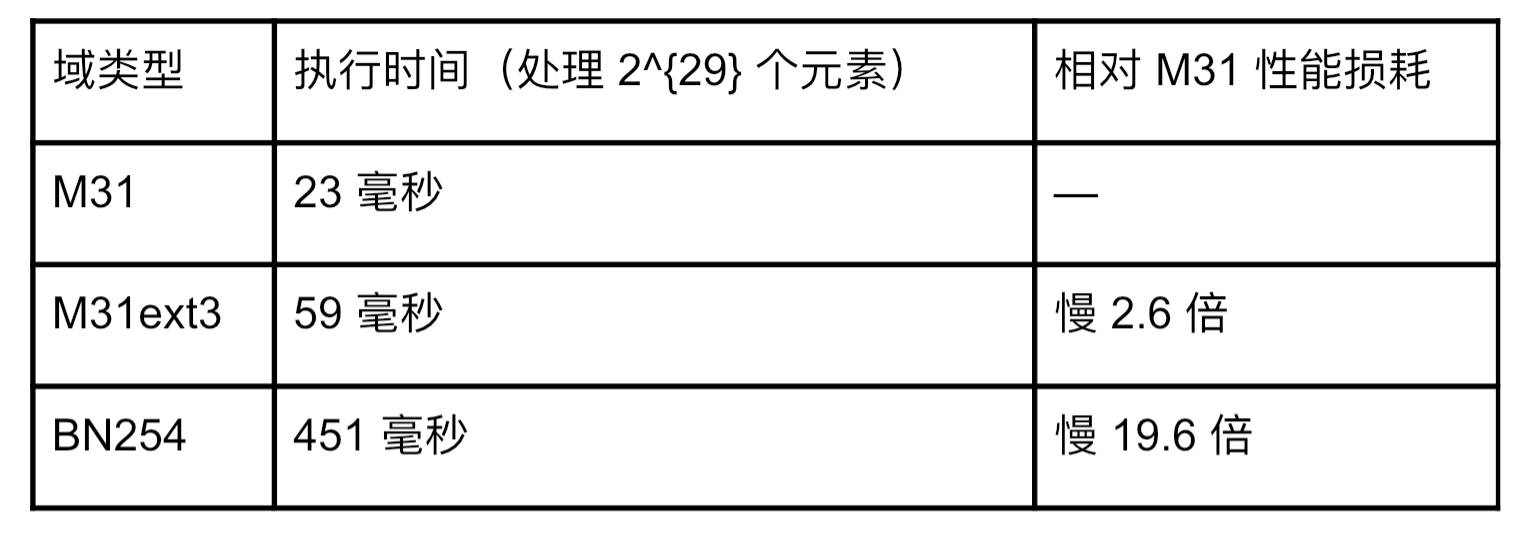
対照的に、より大きな楕円曲線ドメイン (BN 254 など) は、小さなドメイン (M 31 など) よりも早くトップに到達します。
2. GPUメモリ容量には限界がある
RTX 4090は2^{29}要素を処理するとメモリ不足になる
実際の展開では、オーバーフローのリスクを回避するために、洗練されたメモリスケジューリング戦略が必要です。
3. ドメインサイズとパフォーマンスのトレードオフ
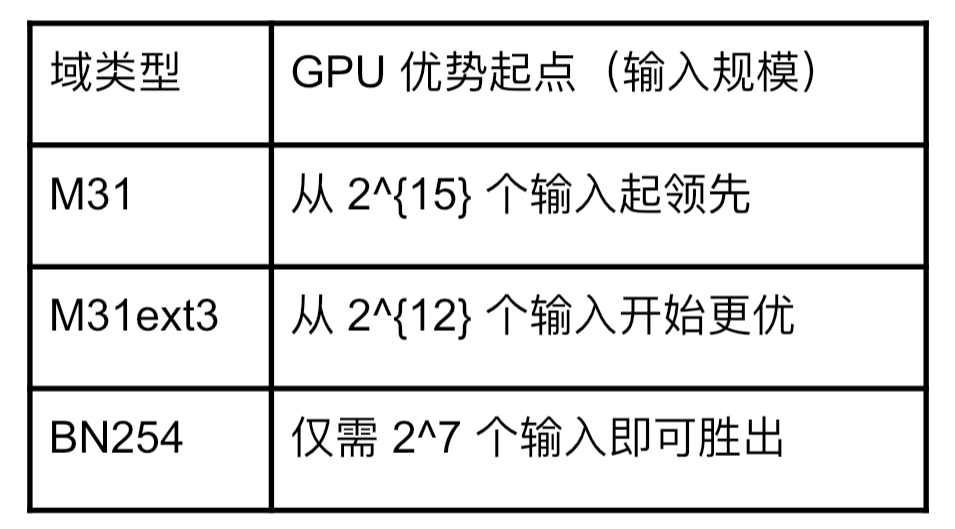
4. 「GPU の優位性」の比較: いつから GPU が CPU を上回り始めたのか?
クロスプラットフォームパフォーマンステスト
私たちは、コンシューマー向けとデータセンター向け両方のハードウェアを対象に、さまざまなクラスの GPU のベンチマークを実行しました。
コンシューマー向けGPU
RTX 3090: メモリ帯域幅936 GB/s、パフォーマンスは最大951倍向上
RTX 4090: メモリ帯域幅1008 GB/s、パフォーマンスは最大1565倍向上
データセンターGPU
NVIDIA H100: 最大3.35 TB/秒の帯域幅と最大2826倍のパフォーマンス向上
結論は明らかです。メモリ帯域幅はゼロ知識証明加速における重要な変数です。
今後の展望:ロードマップ
私たちはこれからも止まることはなく、以下の目標に取り組み続けます。
さらなる高速化:特定の操作で10,000倍の高速化を目指す
より幅広いハードウェア互換性: 高性能ゲーミンググラフィックカードからデータセンターレベルのアクセラレータカードまで
ネイティブEthereum統合:Ethereumクライアント開発チームと協力して、GPU ZKプルーフスタックをL1レイヤーに直接統合しています。
この変化の波に参加しましょう!
これは単に速度の向上だけではなく、ブロックチェーンのアクセシビリティの完全な再構築でもあります。誰であっても、参加する方法を見つけることができます。
開発者の皆様: ExpanderとCUDA リポジトリをチェックして、共に未来を築きましょう
学習者: 最新の情報を得るために、当社の研究セミナーやテクノロジーの深掘りに参加してください。
みなさん、この技術を広めてください!理解する人が増えれば増えるほど、Web3の未来は近づく
中核となるアイデアのレビュー
私たちは今、エキサイティングなテクノロジーの転換点に立っています。ゼロ知識証明と GPU アクセラレーションの組み合わせは、パフォーマンスのわずかな向上だけではなく、パラダイムシフトをもたらします。
私たちは、Ethereum の速度、コスト、使いやすさの境界を再定義しています。
主な技術的成果のリスト:
実稼働環境向けZKプルーフが1,000倍以上高速化
GPUメモリ帯域幅の使用率が95%を超える
オープンソース実装、統合準備完了
Web3 の未来は分散化されているだけでなく、信じられないほど高速であり、あなたが思っているよりも早く到来します。
これらの展開で最も興奮していることは何ですか?お気軽にコメントを残したり、Twitter でチャットしたりしてください。これらの技術的な詳細について深く議論したいと思っています。
未来はスピードのものであり、またあなたのものでもあります。次回まで、ただ速くするだけでなく、構築し続けてください。





