


バイナリGKR: ケッカックの証明速度記録を破る新しいゼロ知識証明システム


原著者:Weikeng Chen
Ethereum 仮想マシン (EVM) では、Keccak ハッシュ関数は状態ツリー (Merkle Patricia Trees) の構築と検証に広く使用されており、ゼロ知識証明における主な計算オーバーヘッドを占めています。 Keccak を効率的に証明する方法は、ゼロ知識証明の分野における長年の未解決の技術的問題です。
この課題に対処するために、Polyhedra チームは、Keccak およびその他のバイナリ演算用に設計された高性能証明システムである Binary GKR を導入しました。
コアの進捗:ケチャックの証明速度が5.7倍に増加
バイナリ GKR は、これまでで最速の Keccak ゼロ知識証明パフォーマンスを実現しており、これは既存のバイナリ証明システム FRI-Binius の最適解よりも約 5.7 倍高速です。この画期的な進歩は理論的に大きな意義を持つだけでなく、実用化への新たな可能性も切り開きます。
応用の展望:zkEVMの「ユニバーサル加速サイドカー」
バイナリGKRは、さまざまなzkEVMアーキテクチャにおいて「ユニバーサルアクセラレーションサイドカー」として機能し、イーサリアムの状態ツリーで多数のKeccak操作を効率的に処理することで、証明コストを大幅に削減し、システムのスループットと応答速度を向上させることができると考えています。
Polyhedra は、Binary GKR の製品化とオープンソース プロセスを継続的に推進し、Ethereum およびより広範なエコシステムにおける zk アーキテクチャのアップグレードを可能にします。
Keccak: ゼロ知識イーサリアムの聖杯
Ethereum は、ゼロ知識証明ネイティブ レイヤー 1 に向けて徐々に進化しています。 21 のチームが参加し、22 の ZK(E)VM 実装をカバーするEthproofsプロジェクトは、Ethereum の過去のブロックを完全に証明しようとしており、重要な一歩を踏み出しています。
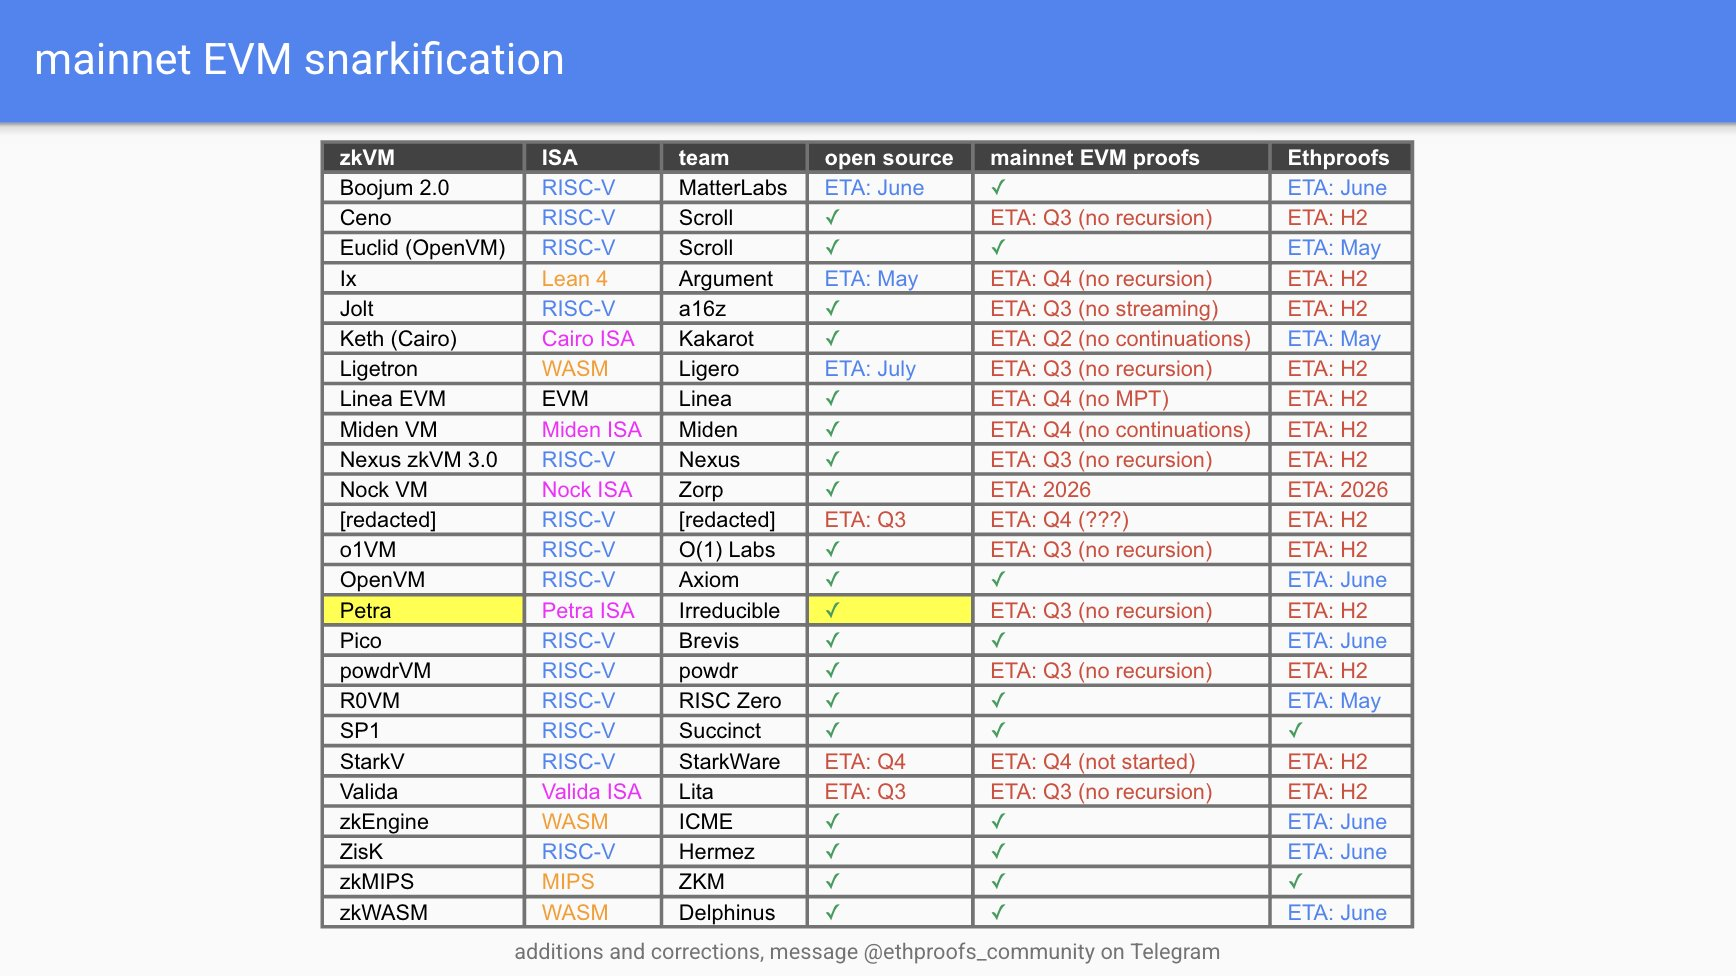
Ethproofs の公式サイトでは、複数のチームの進捗状況をリアルタイムで確認できます。ZkCloud、Succinct、Snarkify、ZKM などのプロジェクトは、最新のブロックの ZK 証明を継続的に提出し始めています。このトレンドの最終的な目標は、イーサリアムをゼロ知識証明によって駆動される実行レイヤーに構築し、コンセンサスレイヤーではトランザクションリストの提案などの軽量タスクのみを完了することです。
zkEVMアーキテクチャが直面する最大の課題:Keccakの証明効率のボトルネック
現在、zkEVM の実装を試みている Ethereum 互換の zkRollup プロジェクト (Polygon、Taiko、Scroll など) がいくつかあります。ただし、CPU 上では効率的な従来の EVM の一部の操作は、ゼロ知識証明システムではコストがかかります。主なパフォーマンスのボトルネックとなるのは、Keccak ハッシュ関数です。
Keccak は、チェーン全体のステータスをハッシュ形式で記録する Ethereum の Merkle Patricia Tree の構築に広く使用されています。しかし、Keccak の基礎となる演算はビットレベルの演算に基づいており、ほとんどの ZK システムで使用される素数体演算モデルと互換性がないため、パフォーマンスが大幅に低下します。
Keccak ハッシュ関数が本質的に「ビット演算」の集合である理由を理解するために、コアとなる演算のうち 5 つ、θ (シータ)、ρ (ロー)、π (パイ)、χ (カイ)、ι (イオタ) について簡単に説明します。これらの操作は 5 × 5 のマトリックス構造に適用されます。各セルは 64 ビットの整数であり、これを「ワード」と呼びます。マトリックス全体には 5 行と 5 列が含まれます。
θ (シータ): まず、各列のパリティ値が計算され、次にそのパリティ値は左側の隣接列と排他的論理和演算されます。同時に、右側の隣接する列が左に回転し、排他的論理和が取られます。このプロセスには、「XOR」や「左回転」などの基本的なバイナリ演算が含まれます。
ρ (ロー): 行列内の各ワードをビットごとに左に回転します。各単語の回転距離は異なりますが、すべて事前に設定された固定値です。このステップは完全に「左手」の操作で構成されます。
π (パイ): 固定パターンに従ってマトリックス内の単語を並べ替えます。このプロセスは単なる位置の置換であるため、通常、ゼロ知識証明では「ゼロコスト操作」と見なされます。
χ (カイ): 各行に沿ってビット単位の組み合わせ演算を実行し、各単語はその行の左側と右側に隣接する 2 つの単語と結合されます。演算には「排他的論理和」、「否定」、「論理積」などがあります。
ι (イオタ): 固定定数を使用して、行列の最初のワードに対して XOR 演算を実行します。これには、「XOR」演算のみが含まれます。
ゼロ知識証明で Keccak を実装する際の主な課題は、特に各操作が 64 ビット整数で実行される場合に、これらのビットレベルの操作を効率的に表現する方法です。これを Keccak-1600 と呼ぶのは、各ラウンドの状態空間が 5 × 5 × 64 = 1600 ビットだからです。この操作プロセスを 24 回繰り返す必要があります。
次に、Keccak を実装するためのこれまでの試みを簡単にいくつか見ていきます。
試み1: Groth 16またはその他のR 1 CSに基づく証明システム
現在、最も一般的で直接的な方法は、Groth 16 またはその他の R 1 CS (Rank-1 Constraint System) 証明システムを使用して Keccak を実装することです。 Groth 16 でビット演算を表現するには、各ビットを 0 または 1 として表現し、算術関係を通じて次の論理演算をシミュレートします。
排他的論理和: a + b − 2 abという式を使用する
否定:1 − aという式を使用する(通常は他の制約に自由に組み込むことができる)
そして:a × bという式を使う
ただし、左回転などの操作やその他の順列操作は、通常、ZK 環境ではコストフリーの操作と見なされ、追加の制約は必要ありません。
計算によると、Keccak の各ラウンドの制約の数は次のとおりです。
シータ演算は約4480の制約を生成する
ρ と π の演算は「コストゼロ」です
χ操作は約3200の制約を生成する。
この操作では約64の制約が生成される
したがって、完全な Keccak-1600 (24 ラウンド) では、Groth 16 で 185,856 の制約が生成されます。
Ingonyama の ICICLE ライブラリのデータによると、Nvidia 4090 GPU で Keccak ZK 証明を生成するには約 30 ~ 40 ミリ秒、CPU では約 450 ミリ秒かかります。 8192 回の Keccak 演算を証明する必要がある場合、GPU では少なくとも 250 ~ 300 秒かかりますが、CPU では 1 時間近くかかる場合があります。
試み2: ルックアップベースの証明システム
より現代的な最適化では、データをバッチで(たとえば、4 ビットまたは 8 ビットのグループで)処理し、すべてのビット操作をルックアップ テーブル経由で実行します。つまり、各 64 ビット整数は複数の小さなブロック (たとえば、8 つの 8 ビット チャンク) に分割され、ルックアップ テーブルを使用して論理演算が実行されます。
具体的には、次のルックアップ テーブルがあります。
XOR ルックアップ テーブル: 2 つの 8 ビット チャンクの XOR 値を計算するために使用される 2 ⁸ × 2 ⁸ ルックアップ テーブル。これにより、従来の 8 つの制約ではなく 1 つの制約で 8 ビット XOR を実行できるようになります。
AND 演算ルックアップ テーブル: これは 2 ⁸ × 2 ⁸ ルックアップ テーブルで、2 つの 8 ビット チャンクのビット単位の AND 演算に使用されます。制約を保存する効果は XOR に似ています。
左回転ルックアップ テーブル: Keccak で頻繁に発生する左回転操作を処理するために、複数のルックアップ テーブルが導入されています。具体的には、8k+1、8k+2 などの回転距離に対応する、サイズ 2⁸ の 7 つのルックアップ テーブルです (k は負でない整数)。回転をまったく処理しない試行 1 と比較すると、このアプローチでは追加のオーバーヘッド (ラウンドごとに約 192 個の追加制約) が発生します。しかし、他の部品と比較すると、このコストはまだ比較的小さいです。
このシステムを実装するために、Groth 16 は使用しなくなり、ルックアップ テーブルをより完全にサポートする Stwo や Plonky 3 などの小さなドメイン証明システムを使用する方が適しています。この方式では、各完全な Keccak 操作には約 27,264 個の制約が必要であり、ルックアップ テーブルの呼び出しと組み合わせることで、全体的な制約の数を大幅に削減できます。これは、Groth 16 と比較して大幅な最適化です。
ただし、この最適化はパフォーマンスにおいて絶対的に優位であるわけではありません。ルックアップ テーブルの呼び出しと管理自体にもオーバーヘッドが発生するため、適切に処理しないと、制約の数の削減によってもたらされる利点が相殺される可能性があります。したがって、実際の動作効率は、シナリオによっては Groth 16 ベースの実装ほど良くない可能性があります。
3回目の試み:ビニウス
ルックアップ テーブルやカスタマイズされたゲートによってもたらされる高速化は、実際には期待したほどには良くない可能性があります。ルックアップ自体のオーバーヘッドが制約最適化の効果を相殺する可能性があるため、Keccak 証明の効率をさらに向上させるには、他の方法を検討する必要があります。
これが、ケチャックが「ゼロ知識の聖杯」として知られている理由です。比較すると、SHA-256 や Blake 2/3 などの初期のハッシュ関数も XOR や AND などのビット演算に依存していますが、そのパフォーマンスの最大のボトルネックは整数の加算にあります。多くの場合、証明システムでは整数の加算を複数の 4 ビット チャンクに分割することで最適化され、パフォーマンスが大幅に向上します。しかし、Keccak では整数の加算は行われないため、これらの最適化戦略はここでは失敗します。
現在最も最先端のソリューションは Binius です。このシステムの中核となる考え方は、Keccak は完全にビット操作で構成されているため、ビットに基づく証明システムを使用して実装できるというものです。ここでビニウスが突破します。
Binius では、Keccak は、2 元体である有限体 𝐹₂ 上の演算として表現されます。 XOR は本質的には 𝐹₂ での単なる加算であるため、それに関連するオーバーヘッドはほぼ完全に排除されます。全体的なプロセスは一連の多項式演算として構造化されており、ビット回転演算もビット単位の処理モデルで簡単に実装できます。コストは主に x ステップに現れる AND ゲートに集中していることがわかります。
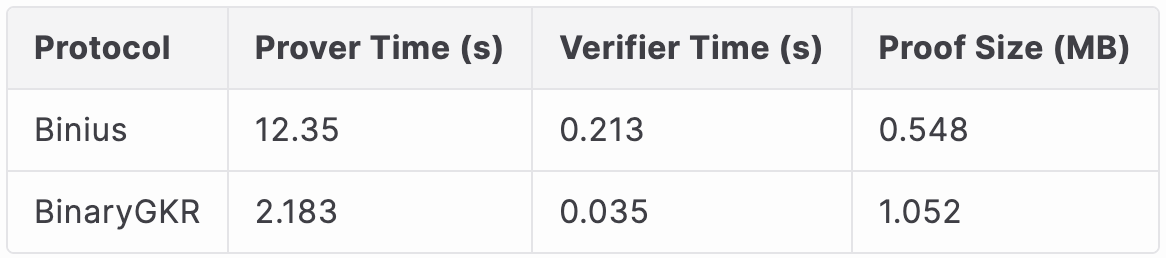
Binius のベンチマーク テストでは、8192 回の Keccak 演算を証明するのに約 12.35 秒しかかからないことが示されており、これは Groth 16 (試行 1) やルックアップ テーブル方式 (試行 2) よりもはるかに優れています。
ビニウスは終わりですか?実際にはそうではありません。 Keccak 証明の冗長性の一部を削除することで、現在の Binius 実装よりもパフォーマンスを約 5 倍向上できることがわかりました。
PolyhedraがバイナリGKRをリリース:Keccakに最適化されたバイナリ証明システム
Polyhedra チームは、新しい証明システムである Binary GKR ( ePrint 2025/717を参照) を構築しています。これは、バイナリ演算の効率的な証明に特化したフレームワークであり、特に Keccak のようなビット演算を中心とした関数に適しています。 Binary GKR の主な利点は、次の 3 つの主要な技術革新から生まれます。
1. GKRプロトコルに基づいて繰り返し計算を最適化する
繰り返し計算の処理によって発生する冗長なオーバーヘッドを効果的に削減できるため、バイナリ GKR の設計は GKR プロトコル (Goldwasser–Kalai–Rothblum) に基づいて行うことを選択しました。
典型的な zkEVM シナリオでは、Keccak は、zkEVM によって委任された多数の Keccak コンピューティング タスクをバッチ処理する「サイドカー プルーバー」として登場することがよくあります。したがって、私たちがターゲットとする回路構造には、当然、多数の繰り返しパターンが含まれます。たとえば、8192 Keccak コールは一般的なサイズです。
さらに重要なのは、Keccak アルゴリズム自体の再現性が非常に高いことです。
5 × 5 状態行列に対して同様のブール演算を繰り返し実行します。
全体のプロセスは、ほぼ同一のステップを 24 回繰り返して構成されます。
各ラウンドの構造は同じで、入力状態のみが異なります。
このような特性により、Keccak は GKR プロトコルの「自然なアダプター」になります。
検証ツールはコストが低く、高頻度の検証シナリオに適しています。
証明者は構造的な反復性を最大限に活用し、計算パスを再利用し、証明のオーバーヘッドを大幅に簡素化できます。
従来の一般的な証明システムと比較すると、バッチ Keccak シナリオではパフォーマンス上の大きな利点があります。
2. バイナリフィールドに基づく多項式コミットメント
バイナリ フィールド上で直接動作する線形コードに基づく多項式コミットメント スキームを採用します。前述したように、ネイティブ バイナリ表現を使用すると、XOR などの演算を「無料で」実行できます。さらに、ビニウス法と同様に、バイナリ フィールドに基づく多項式コミットメントは、より大きな数値フィールドを使用することによって発生する冗長性を回避し、システムのパフォーマンスと効率の両方を大幅に向上させます。
3. 二項演算用の事前計算テーブル
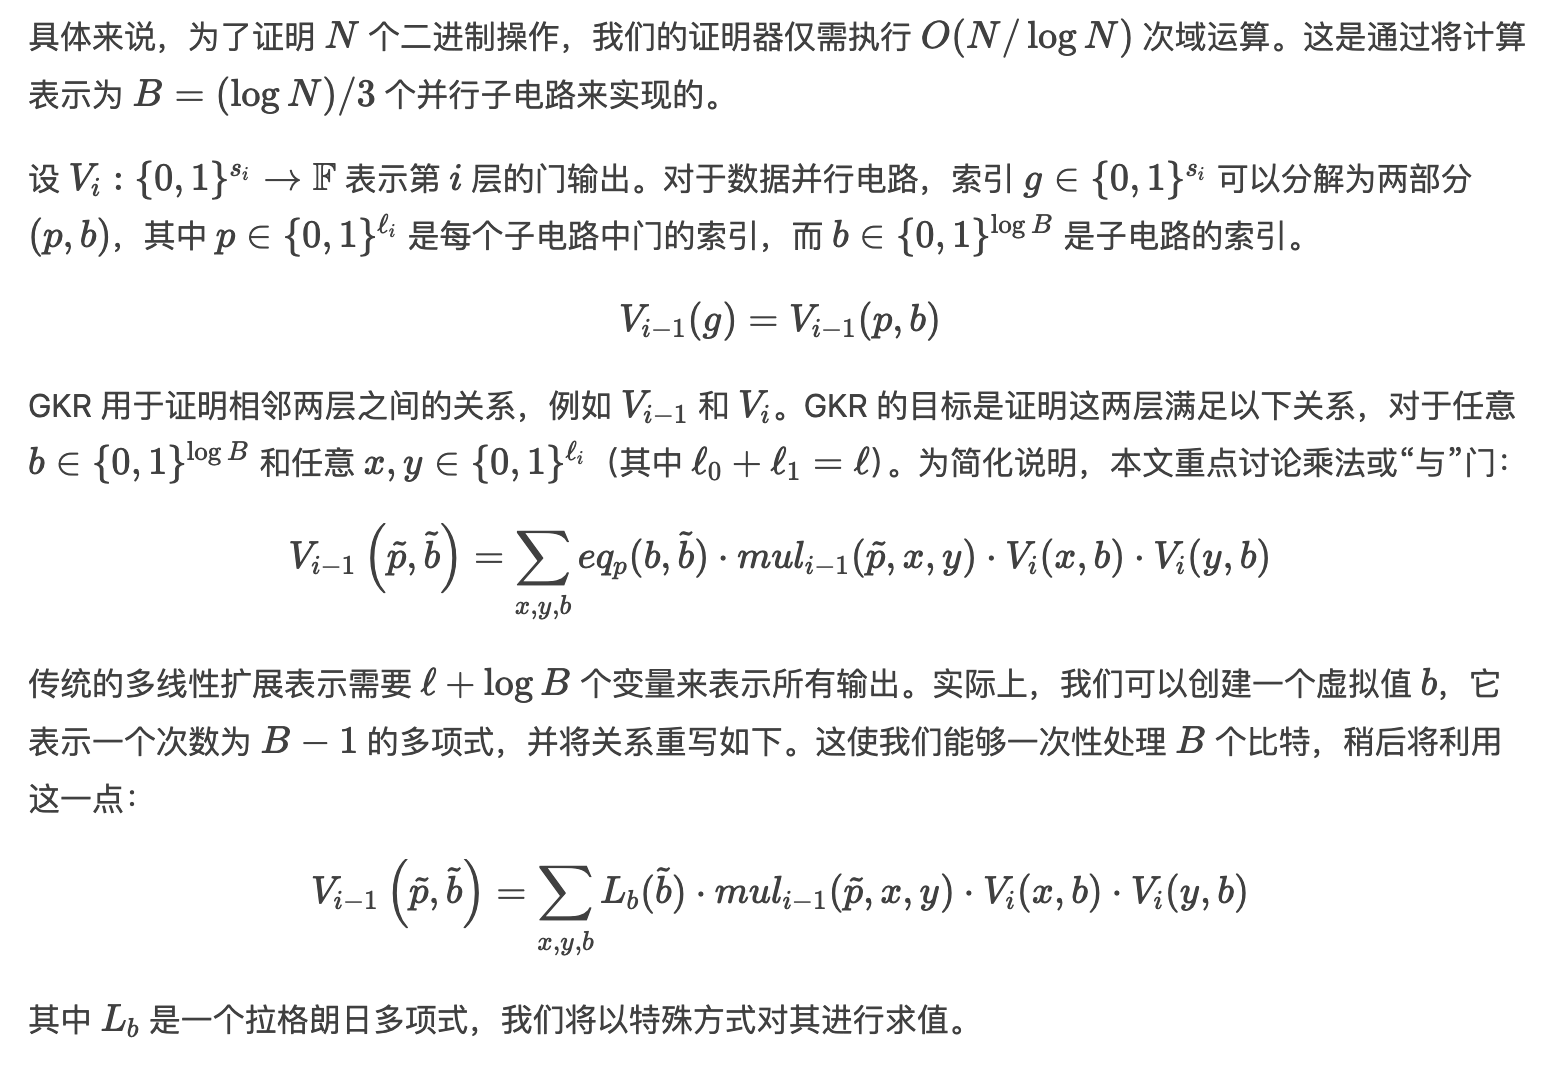
バイナリ GKR 論文の主な革新は、回路構造の高いスパース性を最大限に活用することで、GKR プロトコルの証明効率が大幅に向上したことです。このスパース性は、多数のビットを同時に処理する場合でも維持されます。私たちが行っているのは、複数のビットを GKR プロトコルの多項式に「パック」し (注: これらは中間多項式であり、コミットメントは必要ありません)、これらのパックされたデータに対して直接 GKR プロトコル操作を実行することです。
スパース性は依然として高いため、事前に計算されたテーブルを活用して、従来の GKR プロトコルよりもはるかに少ない計算オーバーヘッドで証明者が証明を生成できるようにすることができます。この最適化により、バイナリ関係を処理する際の GKR の効率が大幅に向上します。
この記事では、前述の 3 番目の技術的最適化である、バイナリ演算用の事前計算済みテーブルに焦点を当てます。
ビットを多項式に詰め込む
私たちの方式の中核は、データ並列ブール回路用に特別に設計された GKR プロトコルの新しい合計チェック方式です。この方法は、証明者の計算負荷を効果的に軽減し、複数のビットを多項式に詰め込むことで効率を大幅に向上させます。
二項関係をより効率的に評価する
従来の GKR と比較して、バイナリ GKR は新しい最適化空間をもたらします。
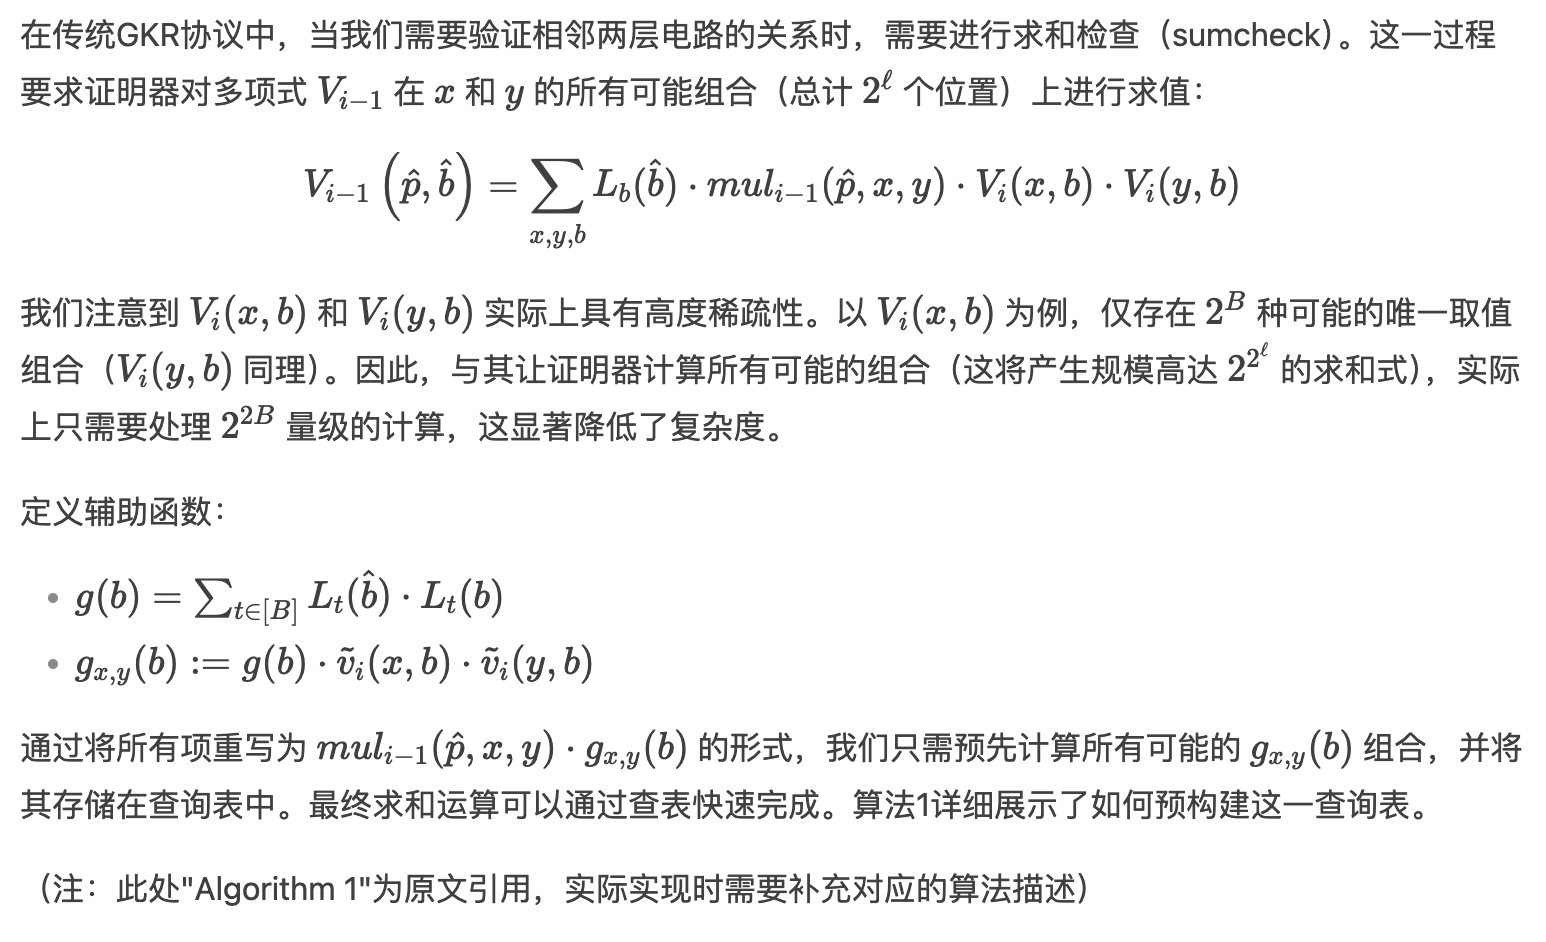
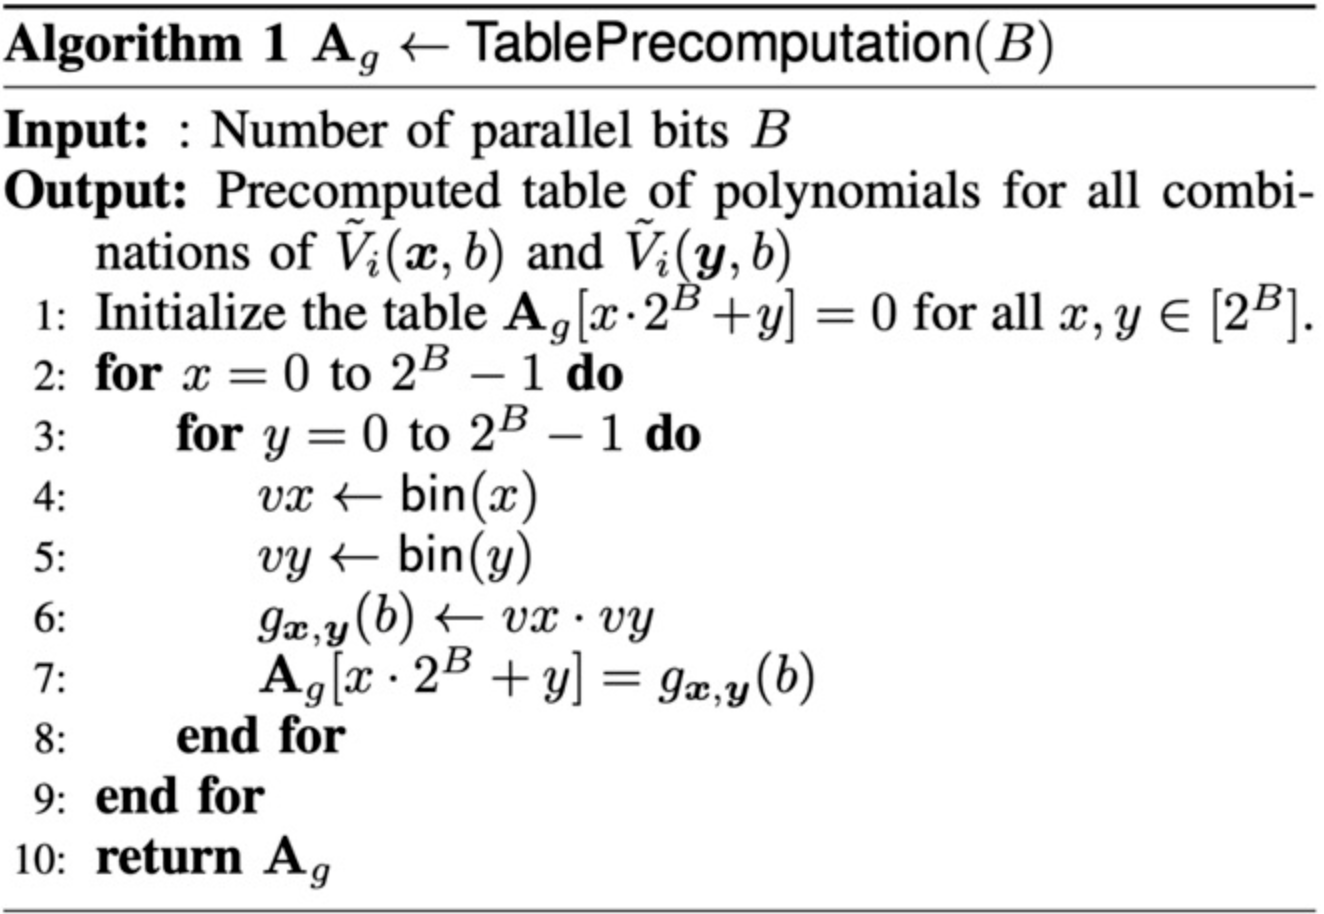
この前処理テーブルは非常に小さいです。パラメータを適切に設定することで、テーブルのサイズを約 15 MB に抑えることができます。このサイズは CPU の L3 キャッシュに簡単に収まるため、テーブル検索操作が非常に効率的になります。
この手法はほぼすべてのバイナリ演算に適用可能であり、バイナリ GKR 構築におけるパフォーマンス向上の中核となります。
実施と評価
私たちは、arkworks エコシステムに基づいて Rust で SNARK システムを実装し、さまざまなサイズのランダム ブール回路の包括的なベンチマークを実施しました。
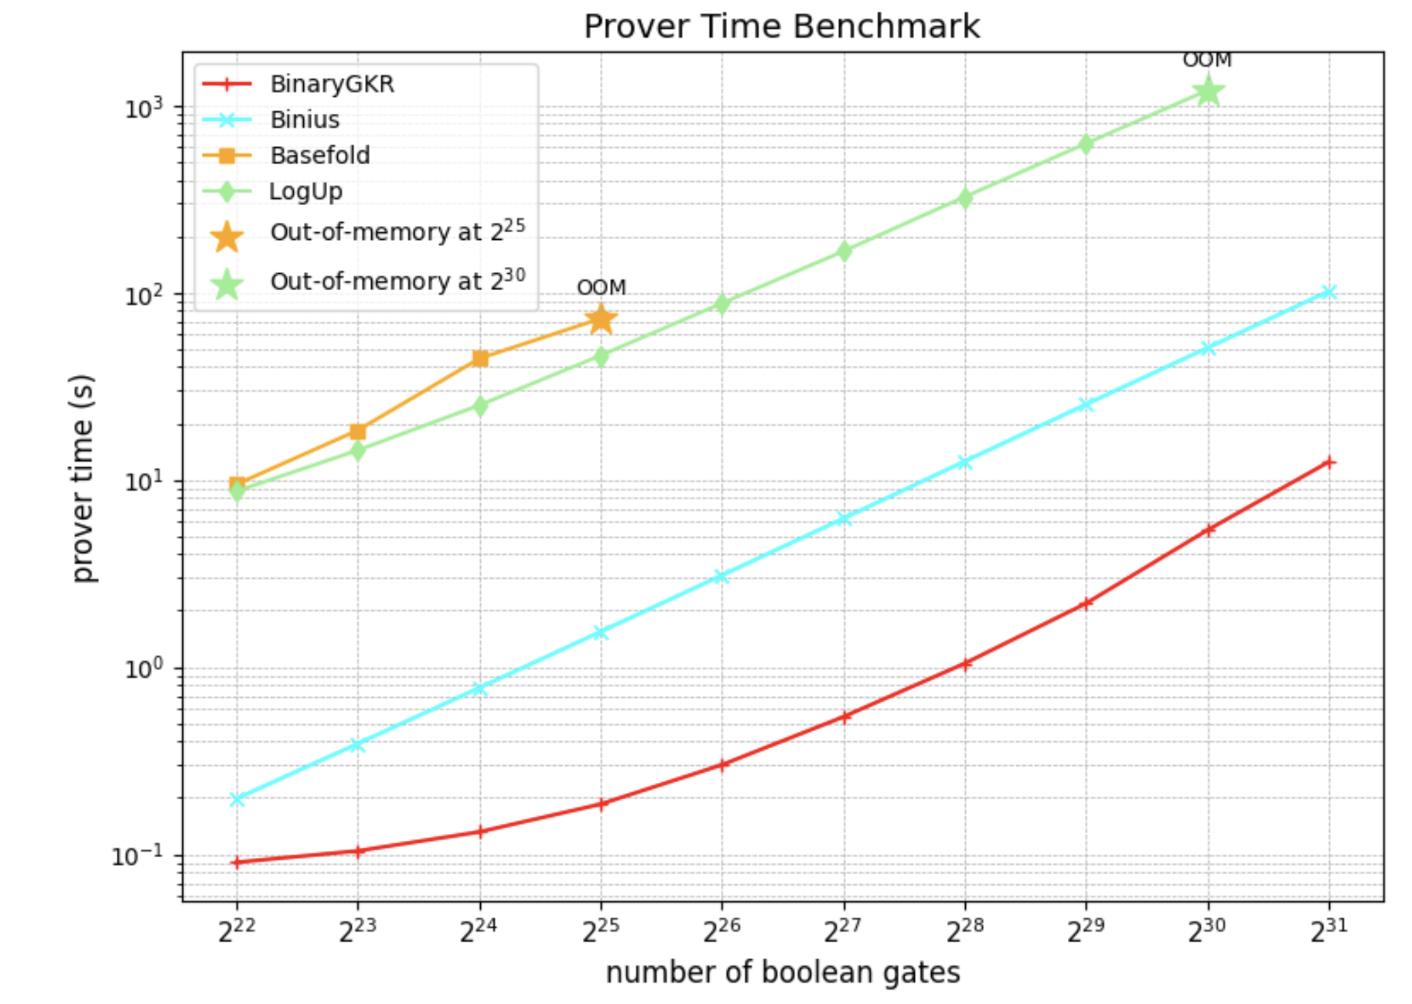
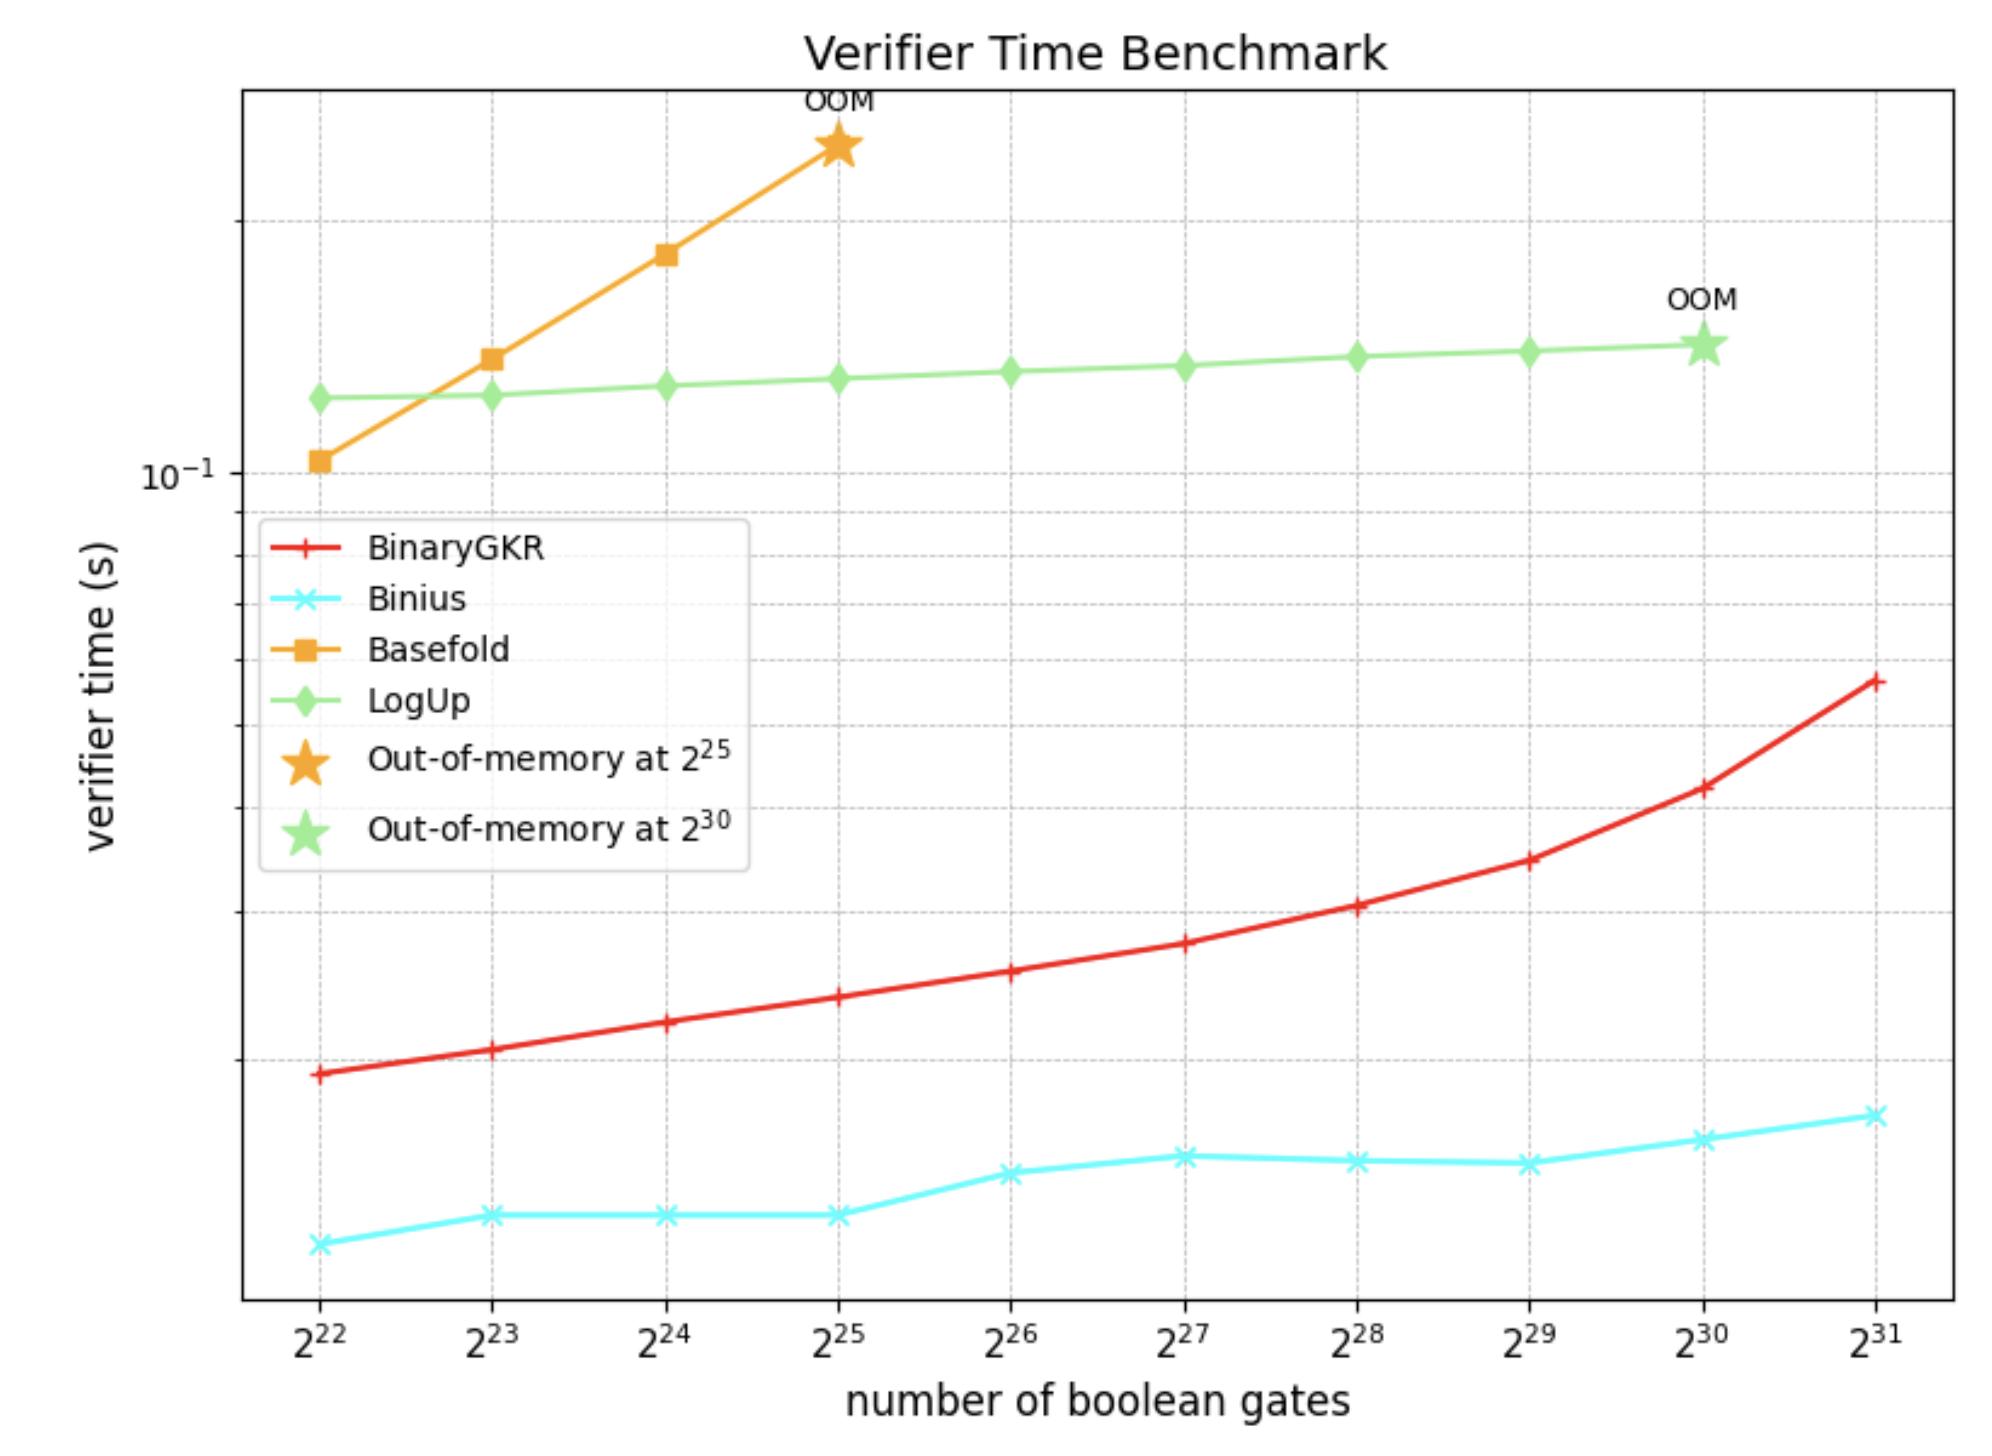
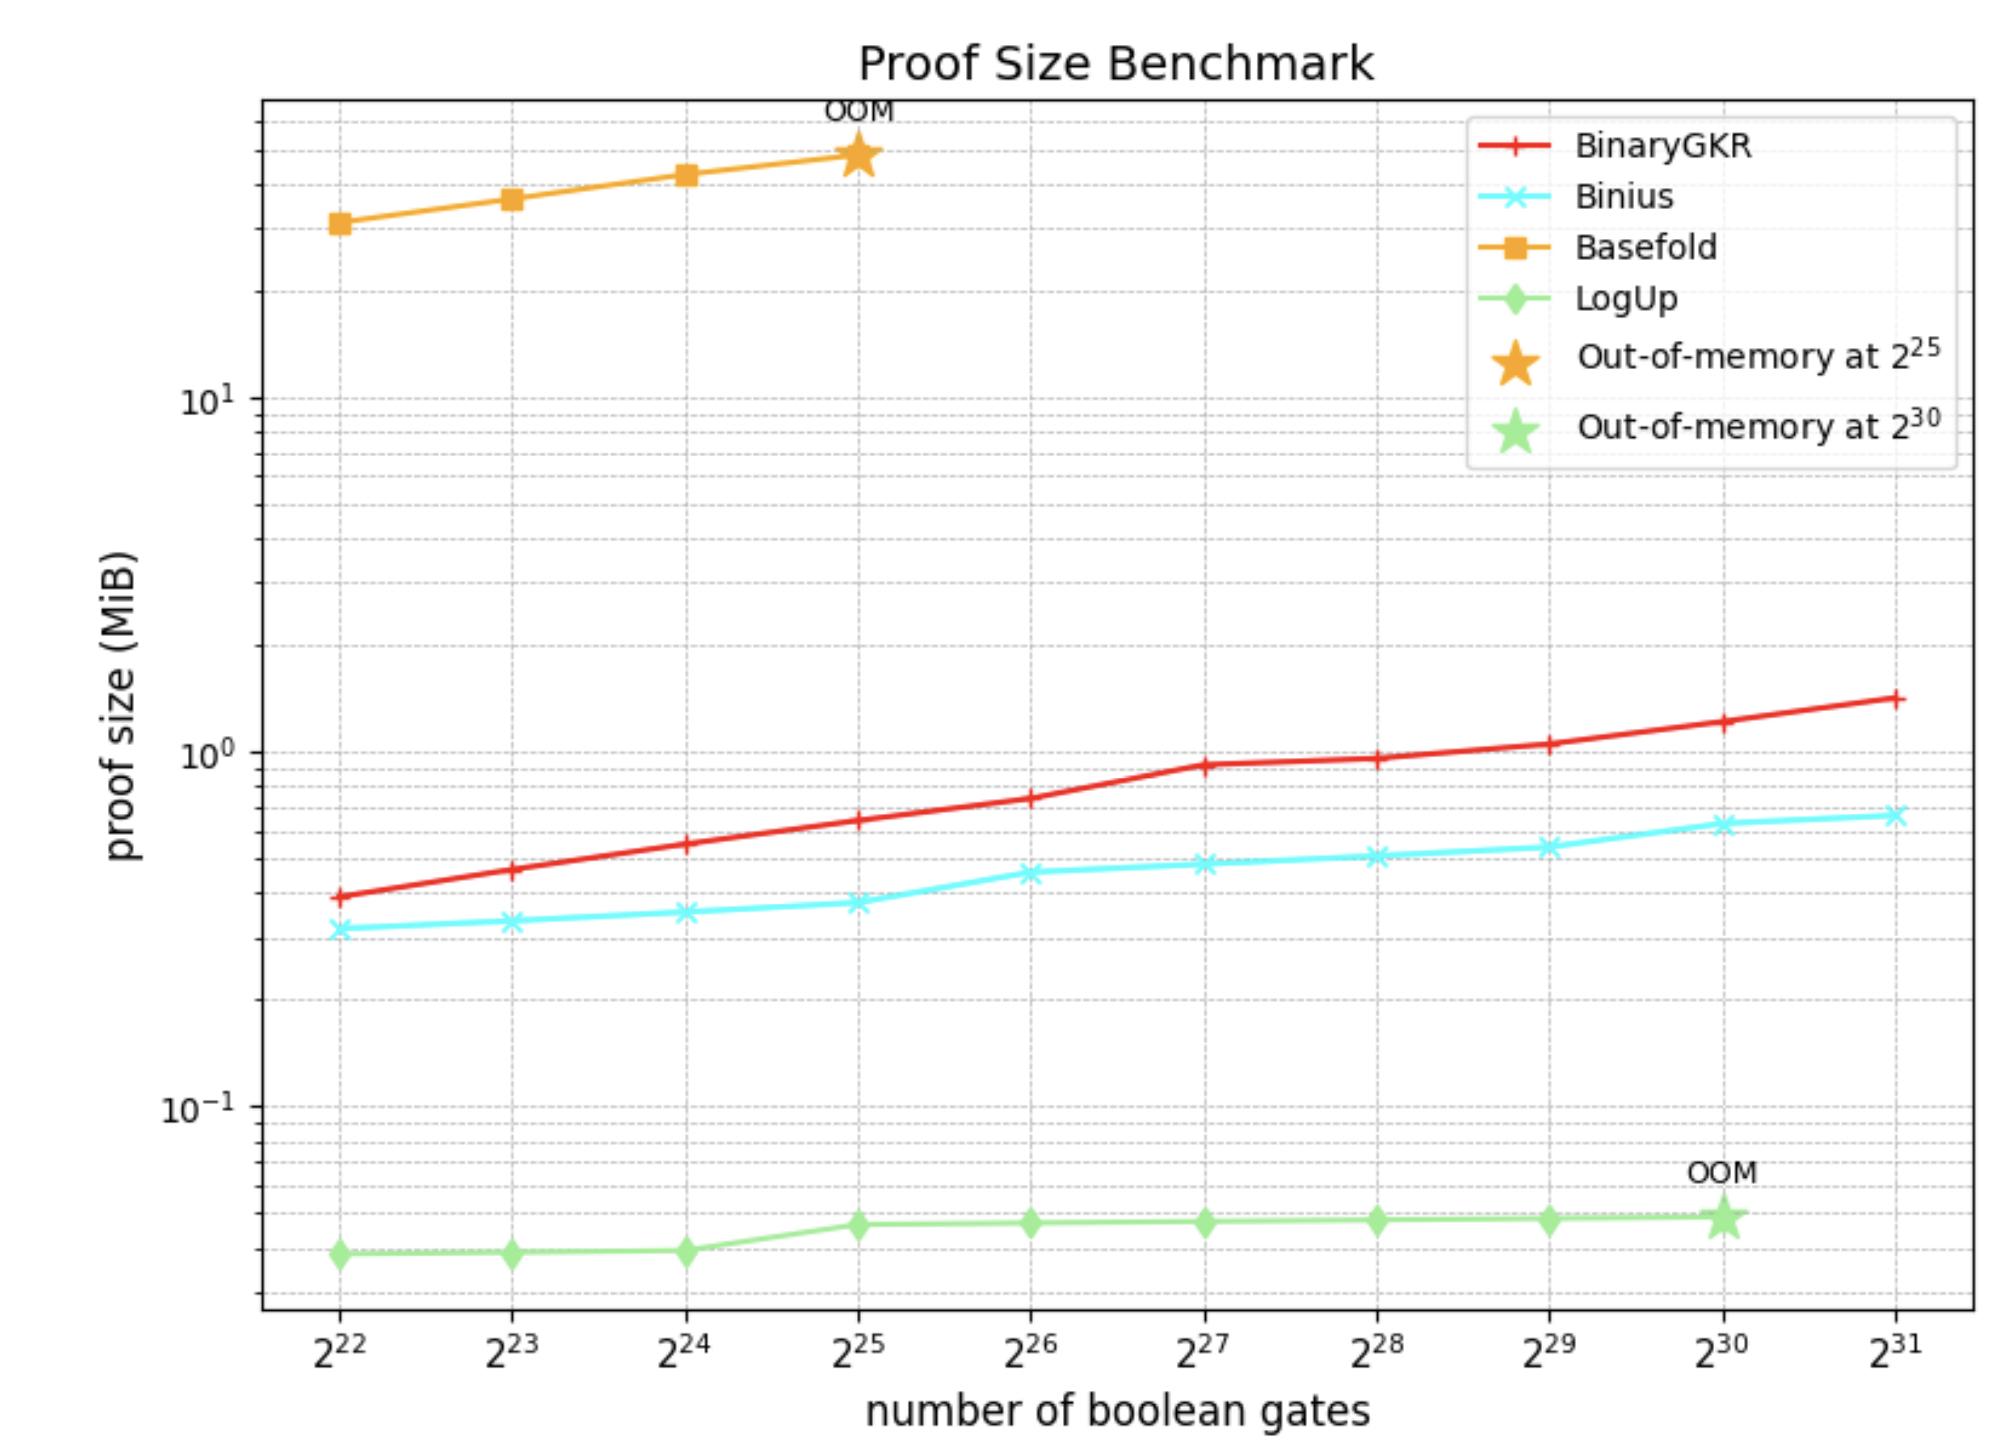
ランダム ブール回路に加えて、ゼロ知識証明の「聖杯」である Keccak にも焦点を当てています。提案手法のパフォーマンスを Keccak 証明における Binius と比較します。どちらもバイナリ ドメイン演算に基づいています。
8192 回の Keccak 呼び出しを処理する場合、Binius では証明の生成に 12.35 秒かかりますが、私たちの方法では 2.18 秒しかかかりません。同時に、Keccak の簡潔な構造のおかげで、検証時間もわずか 0.035 秒と短くなりました。通信オーバーヘッドの観点から見ると、証明のサイズは 1.052 MB です。
結論
この記事では、Keccak などのバイナリ関数の最適化に焦点を当て、ゼロ知識証明の分野における Polyhedra チームの最新の進歩を紹介します。この成果は、さまざまなタイプの zkEVM を構築するための効率的な「補助モジュール」として使用できます。
私たちは、バイナリ GKR を RISC Zero や SP 1 などの zkEVM システムに統合し、Keccak のパフォーマンスボトルネックの緩和におけるその役割をさらに検証する予定です。最終的な目標は、既存の EVM アーキテクチャを破壊することなく、レイヤー 1 の完全な SNARK 化に向けた Ethereum の進歩を加速することです。
オリジナルリンク: https://blog.polyhedra.network/binary-gkr/





