


IOSG Ventures: ZK コプロセッサは 0 から 1 になりますが、何ができるのですか?


原作者: IOSG Ventures
Celer Network および Brevis の Mo Dong 氏には、ZK コプロセッサの中心的な概念とユースケースについて詳細な議論をしていただき、このシリーズ記事の作成にインスピレーションを与えてくれたことに感謝します。
ZK コプロセッサは、ブロックチェーン分野におけるエキサイティングなイノベーションです。 Brevis、Axiom、Lagrange、Herodotus などのプロジェクトによって先駆けられ、ブロックチェーン上でアプリケーションを開発する方法に革命を起こすことが約束されています。 ZK コプロセッサを使用すると、開発者はオムニチェーン データの履歴を活用して、追加の信頼仮定に依存することなく複雑な計算を実行できるデータ駆動型の dApp を作成できます。さらに重要なのは、これが新しい開発モデルである非同期アプリケーション アーキテクチャにつながり、Web 3.0 ソフトウェア フレームワークに前例のない効率と拡張性をもたらします。
この一連の記事では、ZK コプロセッサーについてわかりやすく説明します。その概念、実用的なアプリケーション、基本的なメカニズム、課題、市場戦略に興味がある場合でも、さまざまなプロジェクトを比較したい場合でも、これらの記事が新しいインスピレーションをもたらすことを願っています。
DEX で VIP トレーダー プログラムが欠落しているケース
ZK コプロセッサの基本的な考え方を理解するには、実際の例を動機とすることから始める必要があります。
集中型取引所 (CEX) と分散型取引所 (DEX) の明らかな違いの 1 つは、一般に「VIP トレーダー ロイヤルティ プログラム」として知られる、出来高ベースの手数料の存在です。これらのプログラムは、トレーダーを維持し、流動性を高め、最終的には取引所収益を増やすための強力なツールです。
興味深いことに、どの CEX にもそのようなプロジェクトが少なくとも 1 つあるのに対し、DEX にはまったくありません。なぜ?
これは、この機能を DEX に実装するのは CEX よりも難しく、コストがかかるためです。
CEX では、ロイヤルティ プログラムを実装するには以下が必要です。
すべてのユーザーのトランザクション履歴を集中データベースに記録する。これは、将来のクエリのコストを削減するのに役立つタスクです。
直接クエリは高性能の一元化データベースで毎月実行され、履歴データに基づいて各ユーザーのトランザクション量と料金層が決定されます。
ただし、DEX が同じ手順を実行しようとすると、重大な課題に直面します。
ブロックチェーンのストレージコストが高いため、各ユーザーの取引履歴をスマートコントラクトに直接保存することは現実的ではありません。このロジックを実装すると、ユーザーはトランザクションごとに 4 倍の手数料を支払うことになります。
取引記録のデータ ストレージがある場合でも、このデータに対する統計クエリと計算のコストは高くなります。たとえば、1 人のユーザーの 10,000 件のトランザクションのトランザクション量データを計算すると、15,600 万ガスのコストがかかります (はい、計算しました)。
「待って、一体何を言っているのですか? ブロックチェーン上では、すべてのユーザーのすべてのトランザクションが自動的に保存されます (ブロックチェーンだからです!)。」 ブロックチェーン上の自家製インテリジェンス 契約は、すべてのユーザーにすぐにアクセスできる必要があります。このデータですよね?
申し訳ありません!
ブロックチェーンに保存されているデータと、ブロックチェーン仮想マシン内のスマート コントラクトによってアクセスできるデータは、まったく別のものです。
ブロックチェーンのフル/アーカイブ ノードの場合、ブロックチェーンの履歴からの大量のデータが保存されます。これらのノードを使用すると、以下に簡単にアクセスできます。
歴史上の任意の時点におけるブロックチェーン全体の状態 (例: Cryptopunk の最初の所有者は誰か)。
履歴上の任意の時点でのトランザクションおよびトランザクションから生じるイベント (たとえば、チャーリーは 1,000 ドルを 0.5 ETH に交換しました)。
実際、Nansen や Dune Analytics などの一般的なオフチェーン データ インデックス作成ツールや分析ツールは、この広範なデータ セットを活用して詳細な分析を行うことができます。
ただし、ブロックチェーン仮想マシンに埋め込まれたスマート コントラクトの場合、データ アクセス制限はさらに厳しくなります。オフチェーンのインデックス作成ソリューションによって生成されたデータは使用できません。これは、これらの外部の、多くの場合集中型のインデックス作成ソリューションに対して追加の信頼性の問題が発生するためです。
実際、スマート コントラクトは次のデータにのみ簡単かつトラストレスにアクセスできます。
仮想マシンの状態に保存されたデータ (トランザクション データやイベント データは含まれません)。
最新ブロック内のデータ (履歴データへのアクセスは制限されています)。
「表示」機能を通じて公開される他のスマート コントラクトからのデータ (プライベートまたは内部契約データを除く)。
上記のステートメントの重要なニュアンスは、「簡単」という言葉です。
スマート コントラクトは、ブロックチェーン上のすべてのデータをまったく認識していないわけではありません。 EVM では、スマート コントラクトは最新の 256 ブロックのブロック ヘッダー ハッシュにアクセスできます。これらのブロック ヘッダーには、現在のブロックに至るまでのブロックチェーン上のすべてのアクティビティが含まれており、マークル ツリーとケチャック ハッシュを通じて 32 バイトのハッシュ値に凝縮されます。
圧縮されたものを解凍することはできます...それは簡単ではありません😂
最新のブロック ヘッダーを使用して、前のブロック内の特定のデータにトラストレスにアクセスしたい場合を想像してください。このアプローチには、アーカイブ ノードからオフチェーン データを取得し、ブロックチェーン内のデータの信頼性を判断するためにマークル ツリーとブロック妥当性証明を構築することが含まれます。次に、有効性証明は検証と解釈のために EVM によって処理されます。このような操作は面倒で骨の折れる作業であり、過去のいくつかのトークン残高を取得するだけでも数千万のガスを消費する可能性があります。
この課題の根本は、ブロックチェーン仮想マシン自体に大量のデータや集中的な計算 (前述の解凍タスクなど) を処理する能力がないことです。
ZK コプロセッサ アーキテクチャ
(出典: ETHSG での Brevis のプレゼンテーション スライド)
このようなデータ集約的で退屈な計算をブロックチェーンに委任し、追加の信頼を前提とすることなく、低コストで迅速に結果を取得できる魔法があれば理想的です。
皆さん、それが ZK コプロセッサの目的です。
「コプロセッサ」という名前は、コンピュータ アーキテクチャの歴史に由来しています。たとえば、GPU は CPU のコプロセッサとして導入されました。これは、CPU が、高価で単独で実行するのが難しい特定の重要なコンピューティング タスク (グラフィックス コンピューティングや人工知能のトレーニングなど) を「補助プロセッサ」に委任する必要があるためです。 、つまりGPUです。
しかし、ZK コプロセッサの「ZK」とは何を意味するのでしょうか?複雑な技術的な詳細に入る前に、この革新的なテクノロジーのより広範な影響と可能性を見てみましょう。
Web 3.0 にはデータドリブンの dApps が必要です
取引手数料リベートが良い例です。このアイデアに従って、ZK コプロセッサーを使用すると、さまざまなロイヤルティ プログラムを多くの DeFi プロトコルにシームレスに導入できます。
ただし、これは DeFi ロイヤルティ プログラムをはるかに超えたものです。おそらく、Web 3.0 の他の領域にも同じ問題が存在することがおわかりいただけるでしょう。考えてみると、最新の Web 2.0 アプリケーションはすべてデータ駆動型ですが、Web 3.0 アプリケーションも例外ではありません。 「キラー アプリケーション」を作成し、従来のインターネット アプリケーションと同等のユーザー エクスペリエンスを実現したい場合、このデータ駆動型のアプローチは不可欠です。
DeFi 分野の別の例を見てみましょう。流動性マイニングの報酬メカニズムを再設計することで流動性の効率を向上させます。
現在、AMM DEX の流動性インセンティブ メカニズムは「従量課金制」モデルを採用しています。このモードでは、LP が流動性に貢献すると、ファーミング報酬がすぐに LP に分配されます。ただし、このモデルは最適とは程遠いです。プロの農業従事者は、市場の変動を感知すると、一時的な損失を避けるために流動性をすぐに引き出すことができます。このようにして、プロトコルに最小限の価値を提供しますが、依然として大きな利益を受け取ります。
理想的な AMM 流動性インセンティブ メカニズムは、特に市場のボラティリティが大きい期間に、LP の堅さを遡及的に評価するものです。この状況で常にプールをサポートする人は最高の報酬を受け取るべきです。ただし、このモデルにとって重要である過去の LP 行動データを取得することは、今日でもまだ実現できません。
これを行うには、ZK コプロセッサが必要です。
DeFiの分野では、アクティブなLPポジション管理のための所定のアルゴリズムとルールの使用、クレジットラインを確立するための非トークン流動性ポジションの使用、過去の返済行動に基づいたローンの動的な清算優先の決定など、同様の例を多く挙げることができます。
ただし、ZK コプロセッサの可能性は DeFi に限定されません。
ZK コプロセッサを使用して、優れたユーザー エクスペリエンスを備えたオンチェーン ゲームを作成
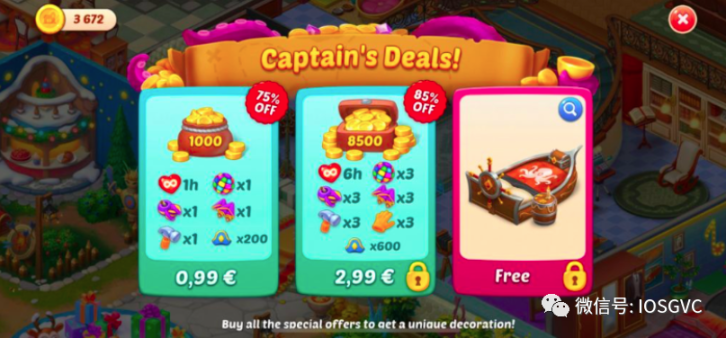
Web2.0ゲームのリアルタイム動作機能例
新しくインストールされた Web 2.0 ゲームに参加すると、すべての動きが詳細に記録されます。これらのデータはアイドル状態になることはありませんが、ゲームプレイに大きな影響を与えます。ゲーム内購入オプションをいつ提供するか、いつボーナス ゲームを開始するか、いつマッチングした対戦相手に対して慎重に言葉を使ったプッシュ通知を送信するかなどが決定されます。これらはすべて、ゲーム業界でリアルタイム オペレーション (LiveOps) と呼ばれるもののコンポーネントであり、プレーヤーのエンゲージメントと収益源を増やすための基礎となります。
これらの LiveOps 機能は、完全なオンチェーン ゲームのユーザー エクスペリエンスを Web 2.0 のクラシック ゲームと同等にするために必要です。これらの機能は、ゲームのスマート コントラクトとのプレイヤーの過去のやり取りとトランザクションに基づいている必要があります。
残念ながら、ブロックチェーン ゲームでは、そのような機能が完全に欠落しているか、依然として集中型ソリューションによって駆動されています。理由は DEX の例と同じです。ブロックチェーン上で過去のゲーム データをマイニングして計算するのは困難です。
はい、繰り返しますが、これを実現するには ZK コプロセッサが必要です。
Web 3.0 ソーシャルおよびアイデンティティ アプリケーションは、ZK コプロセッサのサポートなしでは実行できないもう 1 つの分野です。
ブロックチェーンの世界では、あなたのデジタルアイデンティティは、あなたの過去の行動から織り込まれたウェブです。
あなたがNFT OGであることを証明したいですか?あなたは、Cryptopunk の最初のマイナーの 1 人であることを証明する必要があります。
偉大なトレーダーであることを自慢しますか? DEX で 100 万ドル以上の取引手数料を支払ったことを証明してください。
ヴィタリックと親密な関係?彼の住所からあなたの住所に資金が送金されたことを証明してください。
オフチェーン システムは、人間であろうと Web 2.0 アプリケーションであろうと、トランザクション ボリュームの例のように、すべてのデータを含むアーカイブ ノードにアクセスできるため、そのような証明を簡単に生成できます。
この直接データアクセスに基づく身元証明には、強力なウォレットアドレスの関連付けが必要なため、プライバシーが犠牲になるという欠点がありますが、実行可能です。
ただし、トランザクション量の例と同様に、スマート コントラクトに OG の ID を信頼させ、追加の信頼の証明を導入せずに新しいものに早期アクセスできるようにしたい場合、これ以上の良い方法はありません。
ZK コプロセッサを使用すると、信頼できる身元証明、過去の行動の証明、スマート コントラクトが疑問なく受け入れる証明を作成できます。さまざまなアプリケーション、さらにはさまざまなブロックチェーン間のやり取りをうまく組み合わせて、この証明を形成することができます。
さらに魅力的なのは、ZK 固有のプライバシーです。あなたのウォレットアドレスはあなたの身元と公に関連付けられている必要はありません。たとえば、特定のウォレットアドレスを明らかにせずに、クリプトパンクNFTを所有していることを証明できます。あるいは、正確な数を開示せずに、Uniswap で 10,000 件のトランザクションを実行したことを証明することもできます。
ZK コプロセッサは、データ駆動型の dApp 構築という全く新しい領域を切り開きますが、それはそれだけではありません。
データ駆動型パラダイムを超えて: ZK コプロセッサを使用して Web 3.0 の非同期モードを作成する
データ駆動型の dApp モデルは魅力的ではありますが、氷山の一角にすぎません。
ZK コプロセッサの登場は、ブロックチェーン コンピューティングに対する私たちの見方を完全に変え、非同期処理が Web 3.0 の標準となる時代を生み出すでしょう。この変化により、タスクの処理方法が再定義され、専用プロセッサが独立して動作できるようになり、効率が向上します。
まずは非同期処理とは何かを理解しましょう。
一人の人がシェフとウェイターの役割を同時に演じる同期レストランを想像してみてください。何か注文するとすぐに準備を始めて待たせてしまいます。彼はあなたにサービスを提供した後、次の顧客を待つことしかできません。この設定はあなたのニーズに合っているかもしれませんが、他の人にとっては効率的であることが難しい場合があります。
対照的に、非同期レストランでは、異なるシェフと異なるサーバーが連携して作業します。ウェイターは注文を受け取ると、他の顧客にサービスを提供しながら、すぐにシェフに注文を渡します。料理が完成すると、シェフがウェイターに合図し、ウェイターが料理を提供します。
コンピュータ システムの場合:
同期アーキテクチャは、1 人が各タスクが完了するまで待ってから続行する最初のレストランのようなものです。このアーキテクチャはシンプルで簡単ですが、一度に 1 つのタスクしか処理しないため、処理が遅くなる可能性があります。また、この人はウェイターとしては上手ですが、料理は下手かもしれません。
非同期アーキテクチャは、調整の手段として情報とタスクを相互に送信する、分離された特殊なシステム コンポーネントが存在する 2 番目のレストランのようなものです。これにより、各コンポーネントが独自の一連のタスクを同時に管理できるようになります。より複雑な管理方法が必要になる場合がありますが、このアーキテクチャはより高速で効率的です。
最新のインターネット アプリケーションはすべて、効率性と拡張性を高めるために非同期アーキテクチャに基づいて構築されており、Web 3.0 も同様であるべきだと私たちは考えています。
ZK コプロセッサは、この変化の先駆けとなります。 dApp 開発者にとって、ブロックチェーンは非同期レストランのウェイターのようなものです。主に、偶発的な資産所有権の変更など、ブロックチェーンの状態を直接変更する計算を処理します。他のすべての計算は堅牢な ZK コプロセッサーによって処理され、マスター シェフと同様に、非同期処理の力を利用して結果を効率的に作成し、ウェイターに送信します。
具体的には、ブロックチェーン アプリケーションの計算が次の 2 つの「実現可能性条件」のいずれかを満たしている場合、ZK コプロセッサの使用を検討する必要があります。
ZK コプロセッサの実行条件:
オンチェーンのコンピューティングコスト > (オフチェーンの ZK コプロセッサー計算 (証明の生成を含む) + オンチェーンの検証コスト)
オンチェーン計算遅延 > (オフチェーン ZK コプロセッサー計算 (プルーフ生成を含む) + オンチェーン検証遅延)
たとえこれらのうちの 1 つにしか当てはまらないとしても、検討する価値はあります。
これで、単なるデータ駆動型の dApps ではないことがわかります。これは、ML などの高レベルの汎用コンピューティングをブロックチェーンに導入するまったく新しい方法ですが、さらに重要なのは、これまで不可能だった dApp 構築のためのパラダイムを変える非同期アーキテクチャを導入することです。
次の章…。
ZK コプロセッサが広範囲に影響を与えるアイデアであることを納得していただいたなら、それがどのように動作するかについて話す時期が来たかもしれません。次回のブログでは、ZK コプロセッサの主要なアーキテクチャを調査し、この領域に残る最大の技術的課題について説明します。





