


ヴィタリック・ブテリン氏: ソーシャル メディアの実験 コミュニティ ノートは非常に暗号化されています


原作者:ヴィタリック
原文編集:Deep Tide TechFlow
過去 2 年間は、Twitter (X) にとって間違いなく激動の年でした。昨年、イーロン・マスク氏はこのプラットフォームを440億ドルで購入し、同社の人員配置、コンテンツレビュー、ビジネスモデル、ウェブサイト文化を徹底的に見直したが、これらの変化は特定の政策決定というよりもイーロン・マスク氏のソフトパワーによるものかもしれない。しかし、こうした物議を醸す動きのさなか、Twitter の新機能であるコミュニティ ノートが急速に重要性を増し、政治的領域を超えて支持を得ているようです。
Community Notes は、事実確認および偽情報対策ツールとして、上記のイーロン マスクのもののように、ツイートに状況に応じた注釈を添付することがある事実確認ツールです。当初は Birdwatch と呼ばれ、2021 年 1 月にパイロット プログラムとして初めて開始されました。それ以来、徐々に拡大しており、最も急速な拡大期は昨年イーロン・マスク氏によるツイッター買収と重なった。現在、コミュニティ ノートは、物議を醸している政治的トピックを取り上げたツイートなど、Twitter 上で多くの注目を集めているツイートの定期的な機能です。私の意見、また政治的スペクトルを超えた多くの人々との会話から、これらのメモは有益であり、公開されると価値があると思います。
しかし、私が最も興味を持っているのはコミュニティ ノートです。これは「暗号プロジェクト」ではありませんが、おそらく主流の世界で見た「暗号の価値」に最も近い例です。コミュニティ ノートは、中央で選ばれた専門家によって書かれたり管理されたりするのではなく、誰でも書いて投票することができ、どのノートを表示するか表示しないかは完全にオープンソース アルゴリズムによって決定されます。 Twitter Web サイトには、アルゴリズムがどのように機能するかを説明した詳細かつ包括的なガイドがあり、投稿されたメモと投票を含むデータをダウンロードし、アルゴリズムをローカルで実行し、出力が Twitter Web サイトに表示されるものと一致することを確認できます。完璧ではありませんが、非常に物議を醸す状況において信頼できる中立性という理想に驚くほど近づき、同時に非常に役立ちます。
コミュニティ ノートのアルゴリズムはどのように機能しますか?
特定の基準 (基本的に: 6 か月以上アクティブ、違反歴がない、確認済みの携帯番号) を満たす Twitter アカウントをお持ちであれば、誰でもサインアップしてコミュニティ ノートに参加できます。現在、参加者はゆっくりとランダムに受け付けられていますが、最終的には資格のある人なら誰でも参加できるようにする予定です。承認されると、まず既存のノートの採点に参加でき、採点が十分に良好になったら (どの採点がそのノートの最終結果と一致するかを確認することで評価されます)、独自のノートを作成することもできます。
ノートを作成すると、他のコミュニティ ノート メンバーのレビューに基づいてノートにスコアが付与されます。これらのレビューは、「役に立った」、「やや役に立った」、「役に立たなかった」の 3 つのレベルに沿った投票として見ることができますが、レビューにはアルゴリズム内で役割を果たす他のラベルを含めることもできます。これらのレビューに基づいて、Notes にスコアが付けられます。ノートのスコアが 0.40 を超える場合、このノートは表示されますが、それ以外の場合、このノートは表示されません。
このアルゴリズムがユニークなのは、スコアの計算方法です。ユーザー評価の何らかの合計または平均を単純に計算し、それを最終結果として使用するように設計された単純化されたアルゴリズムとは異なり、コミュニティ ノート評価アルゴリズムは、ノートの異なる視点を持つ人々から肯定的な評価を得たものを明示的に優先しようとします。つまり、通常は評価に同意しない人々が特定のノートについて最終的に同意した場合、そのノートは高く評価されることになります。
それがどのように機能するかを詳しく見てみましょう。ユーザーのセットとノートのセットがあり、セル Mij が i 番目のユーザーが j 番目のノートをどのように評価したかを表す行列 M を作成できます。
どのノートについても、ほとんどのユーザーはそのノートを評価していないため、マトリックスのほとんどのエントリはゼロになりますが、それは問題ありません。このアルゴリズムの目標は、ユーザーとメモの 4 列モデルを作成し、各ユーザーに「友好度」と「極性」と呼ぶ 2 つの統計を割り当て、各メモに「有用性」と呼ぶ 2 つの統計を割り当てることです。 極性。モデルは、次の式を使用して、これらの値の関数として行列を予測しようとします。
ここでは、数学的概念に立ち入ることなく、変数の意味をより直観的に理解できるように、バードウォッチの論文で使用されている用語と私自身の用語を紹介しています。
μ は、ユーザーが一般にどの程度高い評価を評価しているかを測定する「国民感情」パラメーターです。
iu はユーザーの「親しみやすさ」、つまりユーザーがどの程度高い評価を与える傾向があるかを表します。
in はメモの「有用性」、つまりそのメモがどの程度高く評価される可能性があるかを表します。これが私たちが注目する変数です。
fu または fn は、ユーザーまたは Notes の「極性」、つまり、政治的両極端の支配的な軸におけるユーザーの位置です。実際には、負の極性は大まかに「左傾」を意味し、正の極性は「右傾」を意味しますが、極値の軸はユーザーと Notes データの分析から導出され、左と右の概念はハードコードされていないことに注意してください。
このアルゴリズムは、かなり基本的な機械学習モデル (標準勾配降下法) を使用して、行列値を予測するための最適な変数値を見つけます。特定のノートに割り当てられた有用性が、そのノートの最終スコアとなります。メモの有用性が + 0.4 以上の場合にメモが表示されます。
ここでの工夫の核となるのは、「極性」はノートの特徴を吸収し、それが一部のユーザーに好まれ、他のユーザーに嫌われる原因となるのに対し、「有用性」はノートの特徴だけを測定することであり、これらの特徴がノートが好まれることにつながるということです。すべてのユーザーによって。したがって、有用性を選択すると、部族全体で承認されているノートが特定され、ある部族では歓迎されているが別の部族では嫌われているノートが除外されます。
上記はアルゴリズムのコア部分のみを説明しています。実際には、その上に多くの追加メカニズムが追加されています。幸いなことに、それらは公開ドキュメントに記載されています。これらのメカニズムには次のものが含まれます。
このアルゴリズムは複数回実行され、そのたびに非常にランダムに生成された「疑似投票」が投票に追加されます。これは、各ノートのアルゴリズムの実際の出力は値の範囲であり、最終結果はその範囲から取得され、しきい値 0.32 と比較される「より低い信頼レベル」に依存することを意味します。
多くのユーザー (特に、メモと同様の極性を持つユーザー) がメモを「役に立たない」と評価し、同じ「ラベル」 (たとえば、「物議を醸すまたは偏った言葉」、「ソースがメモをサポートしていない」など) を割り当てる場合、スコアリングの理由として、ノートの公開に必要な有用性のしきい値が 0.4 から 0.5 に増加します (これは小さいように思えるかもしれませんが、実際には非常に重要です)。
ノートが受け入れられる場合、その有用性はノートを受け入れるために必要なしきい値である 0.01 ポイントを下回っていなければなりません。
このアルゴリズムは複数のモデルを使用してより多くの実行を実行し、場合によっては 0.3 から 0.4 の間の生の有用性スコアで Notes を向上させます。
全体として、22 のファイルにまたがる合計 6,282 行のかなり複雑な Python コードが得られます。しかし、それはすべてオープンであり、メモとスコアリングデータをダウンロードして自分で実行して、出力がTwitterで実際に起こっていることと一致するかどうかを確認することができます。
実際に、これはどのように見えるでしょうか?
おそらく、このアルゴリズムと単に人々の投票から平均スコアを取得する方法との最大の違いは、私が「極性」値と呼ぶものの概念です。アルゴリズムのドキュメントでは、これらを fu および fn と呼んでおり、この 2 つの項は互いに乗算されるため、f を因数として使用しています。より一般的な用語の理由の 1 つは、fu と fn を最終的に多次元にしたいという理由によるものです。
極性はユーザーとメモに割り当てられます。ユーザー ID と基礎となる Twitter アカウント間のリンクは意図的に非公開に保たれていますが、Notes は公開されています。実際、少なくとも英国のデータセットでは、アルゴリズムによって生成された極性は左右と非常に密接に相関しています。
以下に、極性が -0.8 付近の Notes の例をいくつか示します。
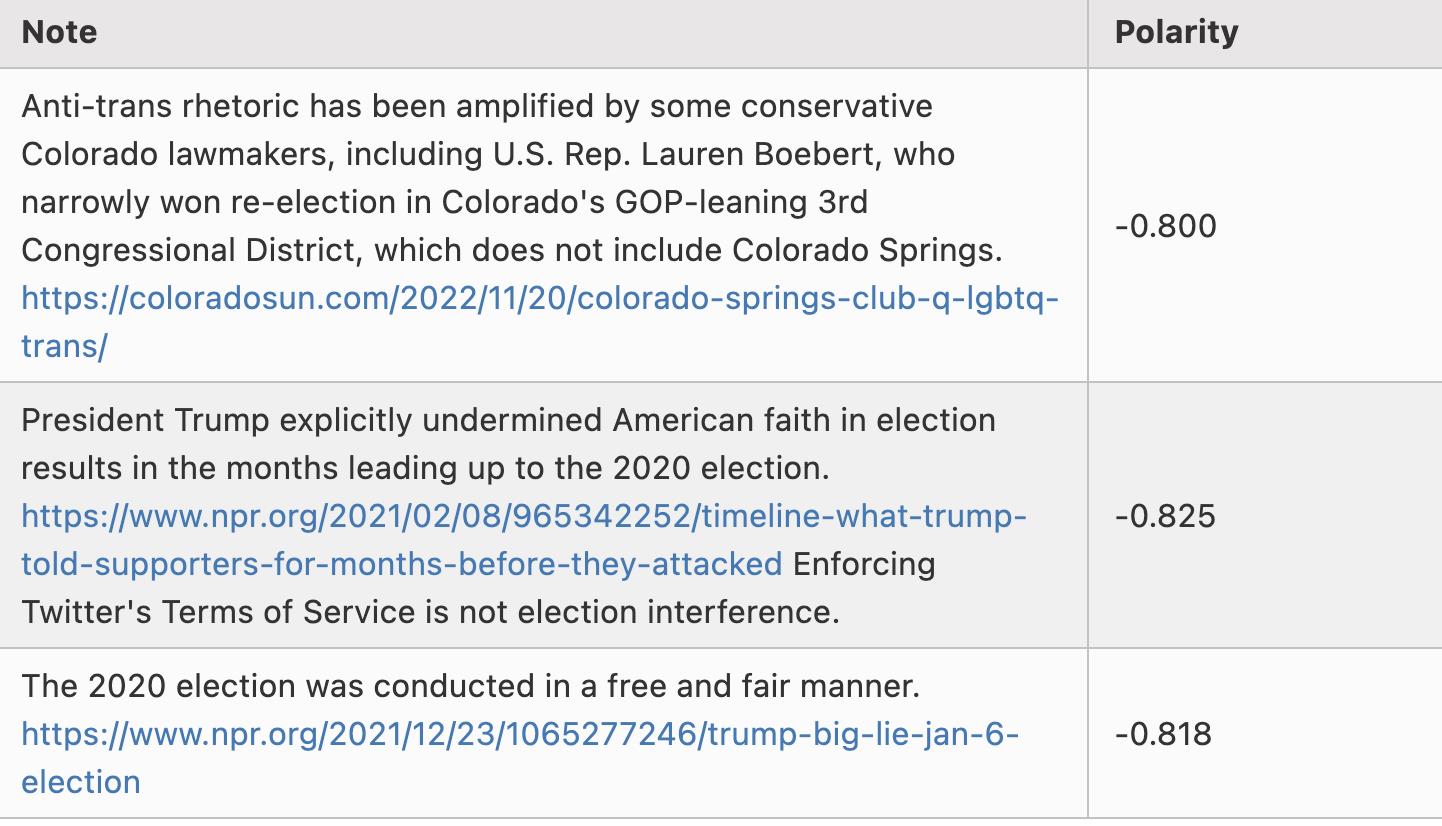
ここで厳選しているわけではないことに注意してください。これらは実際には、アルゴリズムをローカルで実行するときに生成するscoreed_notes.tsv スプレッドシートの最初の 3 行であり、その極性スコア (スプレッドシートでは coreNoteFactor 1 と呼ばれます) は - 未満です。 0.8。
ここで、+0.8 付近の極性を持つノートをいくつか示します。結局のところ、その多くはポルトガル語でブラジルの政治について話している人々か、テスラに対する批判に怒って反論しているテスラファンでした。そこで、どちらのカテゴリーにも当てはまらないいくつかのメモを少しだけ抜粋して見つけてみましょう。
もう一度思い出していただきたいのですが、"左右に分ける"アルゴリズムにはいかなる方法でもハードコード化されておらず、計算によって検出されます。これは、このアルゴリズムを他の文化的文脈に適用すると、主要な政治的分裂を自動的に検出し、それらの間に橋を架けることができることを示唆しています。
一方、最も有用性が高いメモは次のようになります。今回は、メモが実際に Twitter に表示されるので、1 つだけスクリーンショットを撮ります。
そしてもう一つ:
2 番目のノートでは、非常に党派的な政治テーマをより直接的に扱っていますが、明確で質が高く、有益なノートとして高いスコアを獲得しています。全体として、アルゴリズムは機能しているようで、コードを実行してアルゴリズムの出力を検証することも可能だと思われます。
アルゴリズムについてどう思いますか?
このアルゴリズムを分析したときに最も印象に残ったのは、その複雑さです。ここに一つ"学術論文版"これは、勾配降下法を使用して 5 項のベクトルおよび行列方程式への最適な適合を見つけ、その後に実際のバージョンが続きます。これは、途中で多数の異なる実行と多数の任意の係数を伴うアルゴリズム実行の複雑なシーケンスです。
学術論文のバージョンであっても、根底にある複雑さは隠されています。最適化する方程式は負の 4 次です (予測式には 2 次 fu*fn 項があり、コスト関数は誤差の 2 乗を測定するため)。任意の数の変数に対する 2 次方程式の最適化には、ほぼ常に一意の解があり、これはかなり基本的な線形代数で理解できますが、多くの変数に対する 4 次方程式の最適化には通常多くの解が存在するため、勾配降下法アルゴリズムを複数ラウンド実行する必要があります。が得られる場合があります。小さな入力変化により、降下が 1 つの極小値から別の極小値に反転し、出力結果が大きく変化する可能性があります。
これと、二次ファイナンスなど、私が開発に協力したアルゴリズムとの違いは、私にとっては、経済学者のアルゴリズムとエンジニアのアルゴリズムの違いのようなものです。経済学者のアルゴリズムは、せいぜい単純さに重点を置いており、分析が比較的簡単で、当面のタスクに最適である (または最も悪くない) という明確な数学的特性を備えており、理想的には、誰かがどのくらいの損害を与えることができるかを証明します。それを利用しようとしています。一方、エンジニアのアルゴリズムは、エンジニアの動作環境で何が機能し、何が機能しないのかを確認する試行錯誤のプロセスを繰り返すことによって導き出されます。エンジニアのアルゴリズムは実用的で仕事をやり遂げますが、経済学者のアルゴリズムは予期せぬ事態に直面しても制御を完全に失うことはありません。
または、尊敬されるインターネット哲学者 roon (別名 tszzl) が関連スレッドに次のように述べています。
もちろん、真にトラストレスなプロトコルと、見た目は良く表面的にはうまく機能するが、実際には中央集権的なアクターを信頼する必要があるプロトコルとを正確に区別できるようにするには、暗号通貨の「理論的な美学」の側面が必要であると私は言います。さらに悪いことに、それは完全な詐欺である可能性があります。
ディープラーニングは通常の状況では効果的ですが、さまざまな敵対的な機械学習攻撃に対して避けられない弱点があります。正しく実行されれば、技術的なトラップや高度に抽象化されたはしごがこれらの攻撃に対抗できます。そこで質問があります。コミュニティ ノート自体を経済アルゴリズムのようなものに変えることはできますか?
これが実際に何を意味するのかを知るために、私が数年前に同様の目的で考案したアルゴリズムであるペアワイズ有界二次ファンディングを検討してみましょう。
ペアごとに制限された二次関数ファンディングの目標は、「従来の」二次関数ファンディングの抜け穴を埋めることです。つまり、2 人のプレーヤーが互いに共謀した場合でも、偽のプロジェクトに非常に多額の資金を寄付し、資金を返してもらい、資金を得ることができます。プール全体のお金を使い果たすような巨額の補助金。ペアワイズ有界二次ファンディングでは、参加者の各ペアに有限の予算 M を割り当てます。アルゴリズムは、考えられるすべての参加者のペアに対して反復され、参加者 A と参加者 B の両方がサポートしているため、アルゴリズムがプロジェクト P に補助金を追加することを決定した場合、この補助金はそのペア (A、B) に割り当てられた予算から差し引かれます。 。したがって、たとえ k 人の参加者が共謀したとしても、機構から最大で k*(k-1)*M を盗むことができます。
この形式のアルゴリズムは、各ユーザーが少数の投票しか投じないため、コミュニティ ノートのコンテキストではうまく機能しません。平均すると、2 人のユーザー間の共通投票はゼロであるため、各ペアを個別に調べるだけで、ユーザー、アルゴリズムはユーザーの極性を理解できません。機械学習モデルの目標は、まさに、この方法では直接分析できない非常にまばらなソース データから行列を「取り込む」ことを試みることです。しかし、このアプローチの課題は、少数の悪い投票に直面して非常に不安定な結果を避けるために余分な努力が必要なことです。
コミュニティノートは本当に左派にも右派にも対抗できるのか?
コミュニティ ノート アルゴリズムが実際に極端な状況に耐性があるかどうか、つまり、単純な投票アルゴリズムよりも優れたパフォーマンスを発揮するかどうかを分析できます。この投票アルゴリズムはすでに極端な場合にある程度耐性があります。いいね 200 件と嫌い 100 件の投稿は、いいね 200 件のみの投稿よりもパフォーマンスが悪くなります。しかし、コミュニティ ノートのほうが優れているでしょうか?
抽象的なアルゴリズムの観点からは、何とも言えません。なぜ、平均評価が高い二極化した投稿が強い二極性と高い有用性を獲得できないのでしょうか?これらの票が矛盾している場合、その投稿が多くの票を獲得する原因となった機能を極性が「吸収」するという考え方ですが、実際にそうなるのでしょうか?
これを確認するために、単純化した実装を 100 ラウンド実行しました。平均的な結果は次のとおりです。
このテストでは、「良い」ノートは同じ政治的所属のユーザーによって +2 と評価され、反対の政治的所属のユーザーによって +0 と評価され、「良いがより極端な」ノートは同じ所属のユーザーによって +4 と評価されました。 、反対派閥のユーザーでは -2。平均点は同じですが、極性が異なります。そして実際、「良い」メモの平均的な有用性は、「良いがより極端な傾向がある」メモよりも高いようです。
「経済学者のアルゴリズム」に近いアルゴリズムがあれば、そのアルゴリズムが極端な行動をどのように罰するのかについて、より明確なストーリーが得られるでしょう。
一か八かの状況において、これらすべてがどれほど役立つでしょうか?
特定の状況を見ることで、これらのいくつかについて知ることができます。約 1 か月前、イアン ブレマーは、中国政府関係者に関するツイートに非常に批判的なコミュニティ ノートが追加されたと不満を述べました?item_id=888" target="_blank" rel="noopener noreferrer">続きを見る? item_id= 888" target="_blank" rel="noopener noreferrer">もっと見る? item_id= 888" target="_blank" rel="noopener noreferrer">もっと見る? item_id= 888" target="_blank" rel="noopener noreferrer">もっと見る? item_id= 888" target="_blank" rel="noopener noreferrer">もっと見る? item_id= 888" target="_blank" rel="noopener noreferrer">もっと見る? item_id= 888" target="_blank" rel="noopener noreferrer">もっと見る? item_id= 888" target="_blank" rel="noopener noreferrer">もっと見る? item_id= 888" target="_blank" rel="noopener noreferrer">もっと見る? item_id= 888" target="_blank" rel="noopener noreferrer">もっと見る? item_id= 888" target="_blank" rel="noopener noreferrer">もっと見る? item_id= 888" target="_blank" rel="noopener noreferrer">もっと見る ただし、メモは削除されました。
これは大変な作業です。イーサリアム コミュニティ環境では、メカニズムの設計は重要な問題の 1 つです。最大の不満は、Twitter の極端なインフルエンサーに 20,000 ドルが支払われることかもしれません。何百万もの人々に影響を与える政治的および地政学的な問題となると話は別であり、誰もが合理的に考えられる最悪の動機を想定する傾向があります。しかし、メカニックデザイナーが世界に大きな影響を与えたいのであれば、こうした一か八かの環境と対話することが不可欠です。
Twitter の場合、メモ削除の原因として集中操作を疑う明白な理由があります。イーロン・マスクは中国で多くのビジネス上の利益を持っているため、イーロン・マスクがコミュニティ メモ チームにメモの出力への介入を強制した可能性があります。アルゴリズムを実行し、この特定のメモを削除します。
幸いなことに、このアルゴリズムはオープンソースで検証可能であるため、実際にその真相に迫ることができます。これをやろう。元ツイートのURLはhttps://twitter.com/MFA_China/status/1676157337109946369です。最後の1676157337109946369という数字がツイートのIDです。ダウンロード可能なデータ内でその ID を検索し、上記の注記が含まれるスプレッドシート内の特定の行を特定できます。
ここには、Notes 自体の ID 1676391378815709184 があります。次に、アルゴリズムの実行によって生成されたscoreed_notes.tsvファイルとnote_status_history.tsvファイル内でこのIDを検索します。次の結果が得られました。
最初の出力の 2 列目は、Notes の電流定格です。 2 番目の出力は Notes の履歴を示します。現在のステータスは 7 列目 (NEEDS_MORE_RATINGS) にあり、最初に受信した NEEDS_MORE_RATINGS ではないステータスは 5 列目 (CURRENTLY_RATED_HELPFUL) にあります。したがって、アルゴリズム自体が最初にメモを表示し、評価がわずかに下がった後にメモを削除したことがわかります。中央の介入は関与していないようです。
投票自体を見ることで、これを別の見方で見ることもできます。 ratings-00000.tsv ファイルをスキャンして、このノートのすべての評価を分離し、HELPFUL および NOT_HELPFUL と評価されたものがいくつあるかを確認できます。
ただし、タイムスタンプで並べ替えて上位 50 票を見ると、HELPFUL 票が 40 票、NOT_HELPFUL 票が 9 票あることがわかります。そこで私たちは同じ結論に達しました。Notes は最初の視聴者からはより肯定的に評価され、その後の視聴者からはより低く評価されました。そのため、評価は最初は高く、時間の経過とともに低下し、低くなっていきました。
残念ながら、Notes のステータスがどのように変化するかを正確に説明するのは困難です。「以前は 0.40 を超えていたが、現在は 0.40 を下回っているので削除される」という単純な問題ではありません。代わりに、NOT_HELPFUL 応答の数が多いと例外条件の 1 つがトリガーされ、Notes がしきい値を超え続けるために必要な有用性スコアが増加します。
これは、私たちに教訓を与えるもう 1 つの素晴らしい学習機会です。信頼できる中立的なアルゴリズムを真に信頼できるものにするためには、アルゴリズムをシンプルに保つ必要があります。ノートが受け入れられた状態から受け入れられない状態になった場合、その理由について単純かつ明確なストーリーが存在する必要があります。
もちろん、この投票を操作できる別のまったく異なる方法があります。それは「団結」です。承認していないメモを見た人は、熱心なコミュニティ (さらに悪いことに、大量の偽アカウント) に NOT_HELPFUL の評価を求めることができます。おそらく、そのメモを「役に立った」から削除するのに多くの投票は必要ありません。 」が「極端」になります。このような組織的な攻撃に対するアルゴリズムの脆弱性を適切に軽減するには、さらなる分析と作業が必要です。考えられる改善策としては、どのユーザーもノートに投票できないようにする代わりに、「for you」アルゴリズム推奨を使用してノートを採点者にランダムに割り当て、採点者は割り当てられたノートのみを採点できるようにすることです。
コミュニティノートは十分「勇敢」ではないでしょうか?
コミュニティ ノートについて私が目にする主な批判は、基本的には十分な効果が得られないということです。これについて言及している最近の記事を 2 つ見かけました。記事の 1 つを引用すると、次のようになります。
このプロセスには、コミュニティ ノートが公開されるためには、政治的スペクトルを超えた人々のコンセンサスによって一般に受け入れられなければならないという重大な制限があります。
「イデオロギー上のコンセンサスが必要だ」と彼は語った。 「つまり、左の人も右の人も、ツイートにメモを添付する必要があることに同意する必要があるということです。」
本質的には、「真実についてのイデオロギーを超えた合意」が必要だが、これは党派色が強まる環境ではほぼ不可能だと同氏は述べた。
難しい質問ですが、最終的には、1 つのツイートが不当に注釈を付けられるよりも、10 件の誤った情報が自由にされる方が良いと考える傾向があります。私たちは何年にもわたって、「実際に私たちは真実を知っており、一方が他方よりも嘘をついていることが多いことを知っている」という観点からの勇気あるファクトチェックを見てきました。何が起こるか?
正直に言うと、ファクトチェックという概念自体に対する不信感がかなり広く広まっています。ここでの 1 つの戦略は、「こうした批判者は無視し、ファクトチェッカーはどの投票システムよりもよく事実を知っていることを忘れずに、それを使い続ける」ということです。しかし、このアプローチに全面的に取り組むのは危険に思えます。すべての人から少なくともある程度は尊敬される部族間の組織を構築することには価値があります。ウィリアム・ブラックストーンの格言や裁判所と同様に、その敬意を維持するには、自発的な誤りではなく、不作為によって誤りを犯すシステムが必要であると私は感じています。したがって、少なくとも 1 つの主要な組織がこれとは異なる道を歩み、稀有な部族間の敬意を貴重な資源として捉えていることは、私にとって価値のあることのように思えます。
コミュニティ ノートが保守的であってもいいと私が考えるもう 1 つの理由は、すべての誤った情報を与えられたツイート、あるいはほとんどの誤った情報を与えられたツイートが修正通知を受ける必要があるとは思わないからです。たとえ誤った情報を提供したツイートの 1% 未満であっても、文脈や修正を提供するための注釈が付けられているとしても、コミュニティ ノートは依然として教育ツールとして非常に価値のあるサービスを提供します。目標は、すべてを修正することではなく、複数の視点があること、説得力があり、孤立しているように見える投稿のいくつかは実際には完全に間違っていること、そして基本的なことは通常できることを人々に思い出させることです。インターネット検索して間違いを確認してください。
コミュニティ ノートは公共の認識論におけるすべての問題を解決する万能薬にはなり得ませんし、またそのつもりもありません。それが解決できない問題が何であれ、予測市場のような新しいガジェットであれ、ギャップを埋めるために分野の専門知識を持つフルタイムのスタッフを雇用する確立された組織であれ、他のメカニズムが埋める余地はたくさんあります。
結論は
コミュニティ ノートは、ソーシャル メディアにおける興味深い実験であるだけでなく、新たなタイプのメカニズム設計の興味深い例でもあります。このメカニズムは、意識的に両極端を特定しようとし、分裂を永続させるのではなく交差を促進する傾向があります。
私が知っているこのカテゴリの他の 2 つの例は、(i) Gitcoin Grants で使用される一対の二次資金調達メカニズム、および (ii) Polis です。Polis は、クラスタリング アルゴリズムを使用して、コミュニティが一般的な人気の発言を特定するのに役立つディスカッション ツールです。異なる意見を持つことがよくあります。機構設計のこの分野は貴重であり、この分野での学術研究がさらに増えることを願っています。
コミュニティ ノートが提供するアルゴリズムの透明性は、完全に分散型のソーシャル メディアではありません。コミュニティ ノートの仕組みに同意できない場合、同じコンテンツについて異なるアルゴリズムの視点を見る方法はありません。しかし、これは今後数年間でハイパースケール アプリケーションが実現するものに最も近いものであり、集中的な操作を防止し、そのような操作を行わないプラットフォームが認識されるに値するものを確実に取得できるようにするという両方で、すでに多くの価値を提供していることがわかります。 。
私は、コミュニティ ノートや同様の精神を持つ多くのアルゴリズムが今後 10 年間で開発、成長するのを見ることを楽しみにしています。





