


AIの導入により、新たに開始されたLLMプログラムはDuneのキラー機能となるでしょうか?


最近、暗号化データクエリWebサイトのDuneは、LLM(ラージ言語モデル、大規模言語モデル)ロードマップを更新すると発表し、GPT-4でサポートされるクエリ説明機能が第1フェーズで開始され、徐々に機能が追加される予定です後は、自然言語クエリ (自然言語クエリ)、SQL ステートメント エスケープ (クエリ変換)、最適化された検索などです。
最初のレベルのタイトル
Dune のデータ クエリ ギャップ
ブロックチェーンデータのオープン性と透明性のおかげで、誰もがブロックチェーンデータに直接アクセスできますが、生のデータ(Raw Data)は特定が難しいことが多く、専門のプログラマー以外がその意味を理解するのは困難ですが、その上のデータはには莫大な経済価値が含まれているため、時代のニーズに応じてさまざまなデータ分析ツールが登場し、さまざまなアナリスト、研究者、一般の個人投資家に間接的なアクセスと詳細な分析ツールを提供しています。
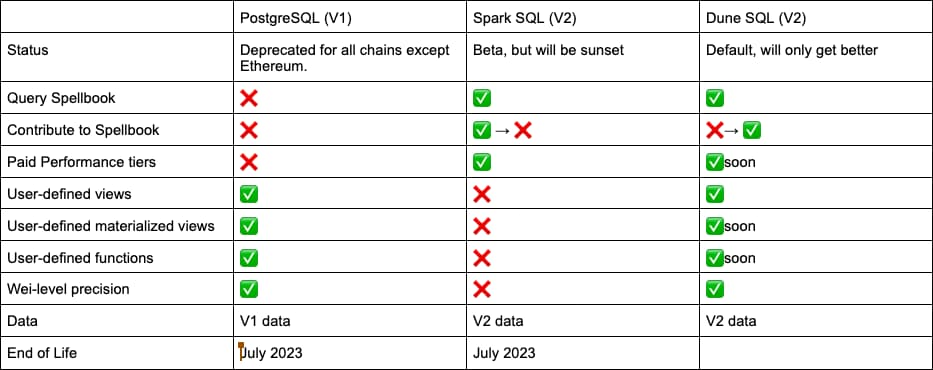
たとえば、公式の簡略化された"nft.trades "クエリ処理には約20万行のSQL文変換と10万行のテストコードが含まれており、55人のコミュニティメンバーが参加しており、これほど大規模な作業は1人のユーザーでは処理できません。
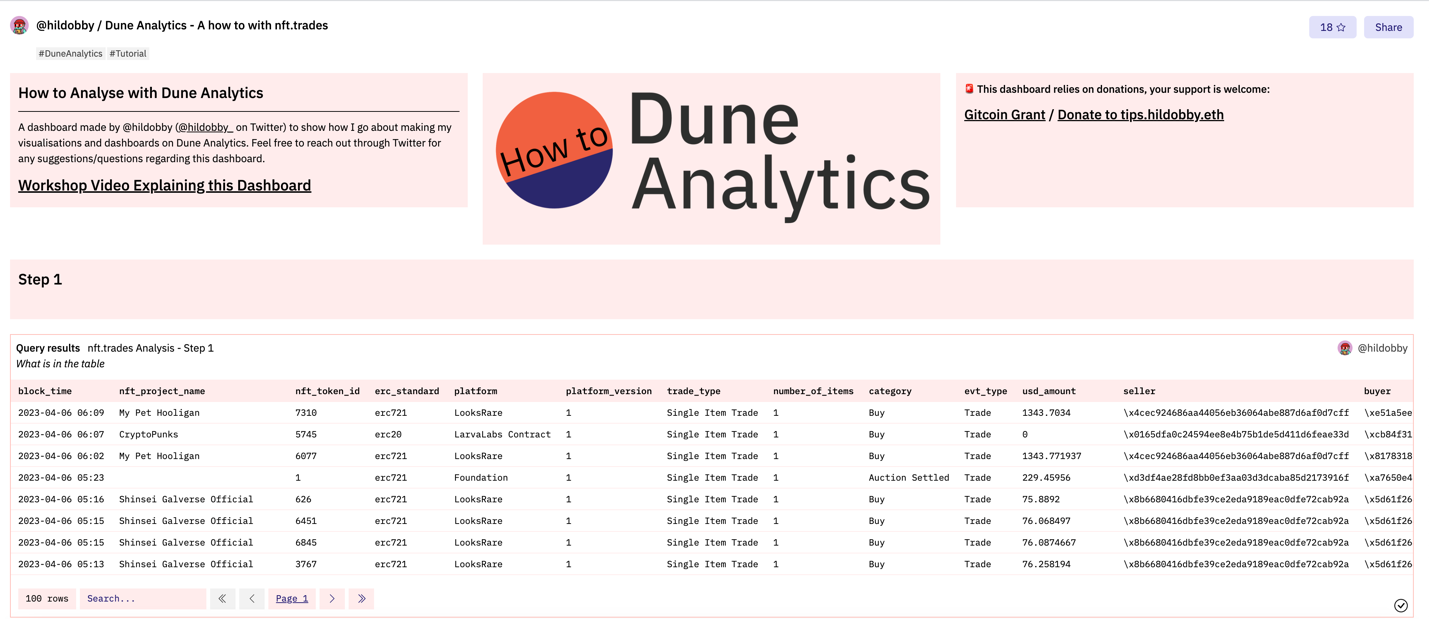
2 つ目は、Dune の V1 と V2 のバージョンでサポートされている SQL 標準が統一されておらず、V1 と V2 ではそれぞれ PostgreSQL と Spark SQL が使用されており、Dune SQL は将来的に統一が完了する予定です。
Duneは今回のLLM機能のアップグレードに先立って、すでに統合クエリエンジンの準備を進めており、製品ロジックの統一性を確保するため、今年7月以降にDune SQLに移行する予定だった。更新された Dune SQL は、オープン ソース クエリ エンジン Trino の実装に基づいています。Dune は、Dune 自身のニーズに合わせてそれを最適化します。一般的な Spark SQL と本質的な違いはありませんが、特定の関数と構文の点でさらに改善されています。たとえば、Dune SQL では、日付と時刻の迅速な計算を容易にするため、および管理権限を制限するために、より多くの演算子が提供されていますが、データのセキュリティを確保するために、元のデータ自体の削除や更新を伴うすべての操作は実行できません。
ただし、SQL クエリのしきい値が高いという問題は、SQL パラダイムを変更することによって解決することはできません。つまり、ほとんどのユーザーとプログラマは、新しい構文形式に適応する必要があります。たとえば、特定のクエリ ステートメントについては、新しいユーザーとプログラマが次のことを行う必要があります。適応します。自動化ツールの需要は、一般のユーザーにとって実用的な意味があるだけでなく、新しい構文に慣れていないプログラマーにとっても大きなメリットがあります。
最初のレベルのタイトル
LLM: 一般ユーザーの参加意識を解き放つ
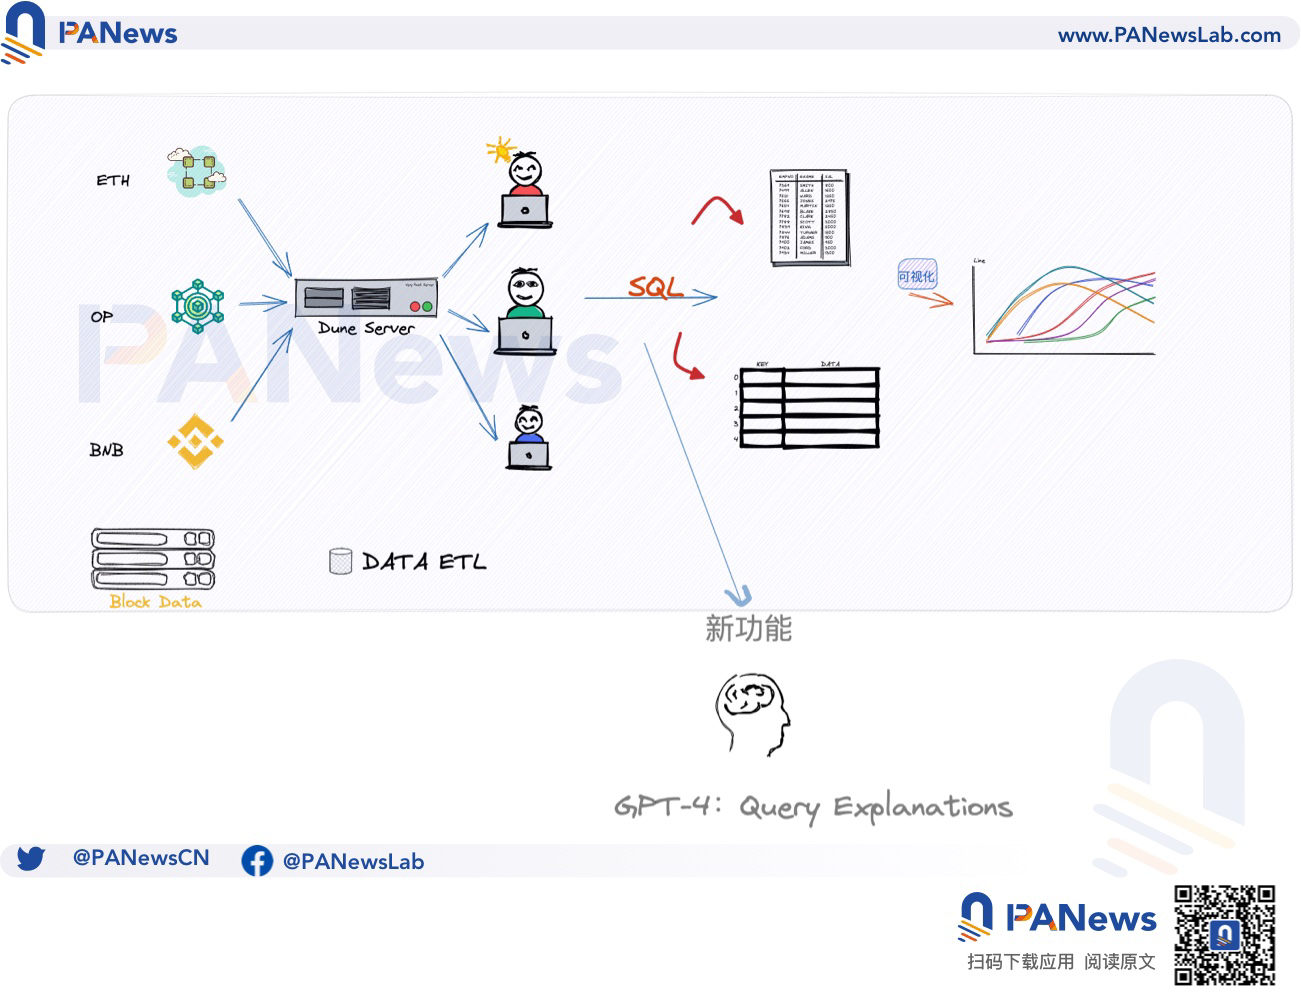
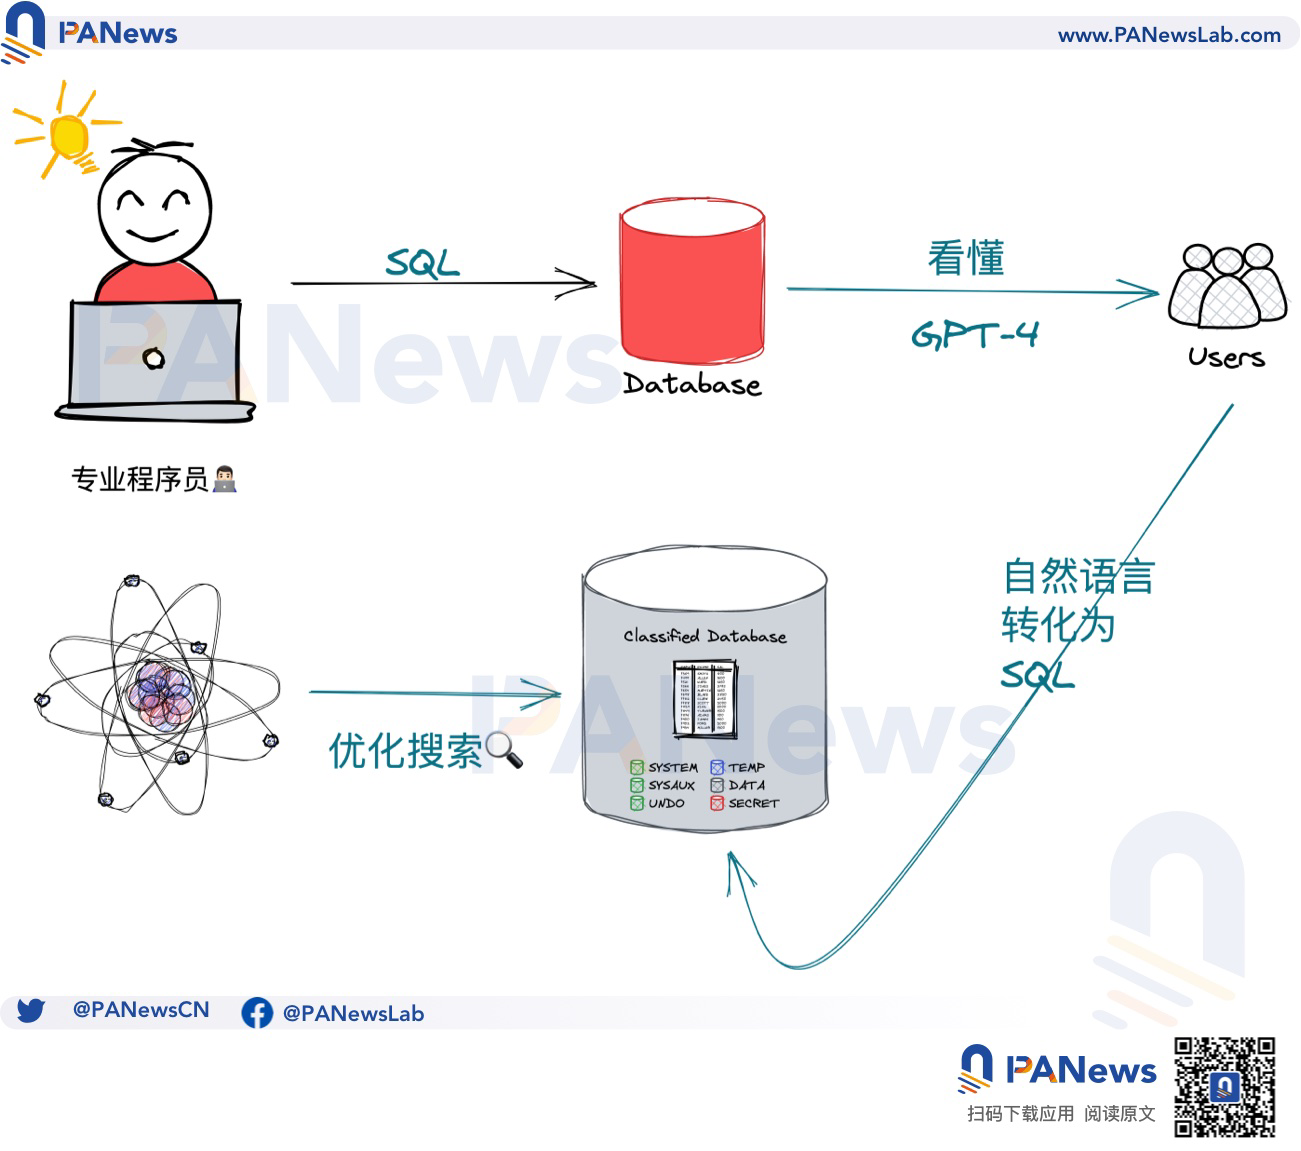
Dune の典型的なプロセスは、チェーン上のデータを分解し、プロのユーザーが SQL を通じてクエリを実行し、必要なユーザーとダッシュボード (ダッシュボード) を共有することです。このプロセスで最も重要なことはクエリの実行ですが、ほとんどのユーザーはコードの知識が不足しているため、クエリ機能を使用できません。
クエリ解釈機能の導入後、上記のプロセスの微調整が行われ、プロのユーザーが作成した SQL クエリ インターフェイスでは、ユーザー コードの具体的な機能を自然言語形式で直感的に伝える説明ページが表示されます。これは、SQL クエリを追加するのと同じです。説明されているパッチは、現在のワークフローを変更しません。これは、SQL ステートメントをマージするときにチームが学んだ教訓でもあります。つまり、ユーザーの既存の習慣への干渉を減らし、最適化するためです。可能な限り既存のプロセスでの経験を活かします。
LLMの追加により、プロユーザーと一般ユーザーの能力差はある程度解消されました。 GPT-4 のコード理解機能のおかげで、一般のユーザーは SQL の知識を習得していなくても、クエリ ステートメントの役割を直感的に理解できます。この機能の導入前は、ユーザーはカンバンページ上のチャートを受動的に読むことしかできませんでしたが、クエリ解釈機能の導入後は、一般のユーザーもSQLコードの具体的な意味を理解できるようになりました。
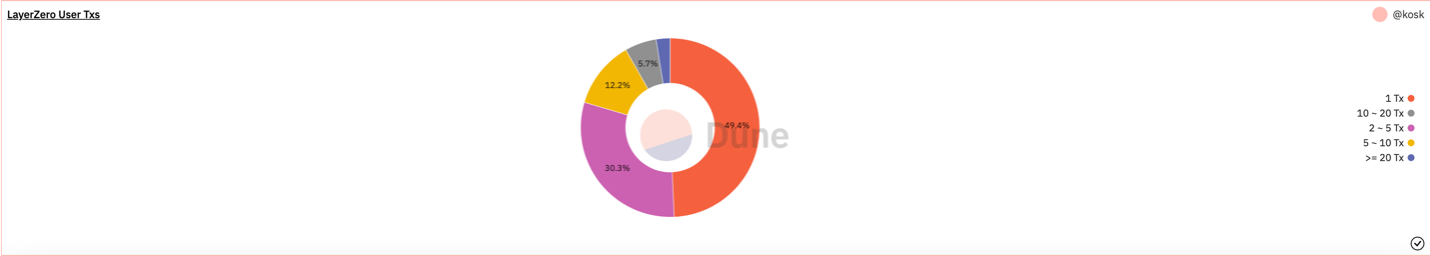
たとえば、アリスが LayerZero のトランザクション情報について問い合わせたい場合、ボブが作成した Dune Kanban を直接見つけることができ、ユーザーの 49.4% が 1 回に集中していることがわかり、アリスはこれが潜在的な経済的目的のためであると推測する理由があります。しかし、最終的な決定を下すことは不可能であるため、アリスはコードを調べて結論が信頼できるかどうかを確認することにしました。
しかし、アリスは、結果はわずか 5 行のデータであるにもかかわらず、クエリ コードには 150 行あることに気付きました。アリスの SQL レベルでは、各ステートメントの正しさを確認するのに十分ではありません。このとき、クエリ解釈機能が特定の記述を「翻訳」します。図に示すように、クエリは 3 つの部分に分かれています。収集されたデータは、Arbitrum、Avalanche、BNB、Ethereum、Optimism、Polygon、Fantom などの複数のチェーンをカバーし、2 番目の部分は、各ユーザー (`送信者`) のトランザクションの数。 3 番目のステップは、数量のしきい値 (1 Tx'、'2 ~ 5 Tx'、'5 ~ 10 Tx'、'10 ~ 20 Tx'、'>= 20 Tx') を設定してユーザーを分類することです。
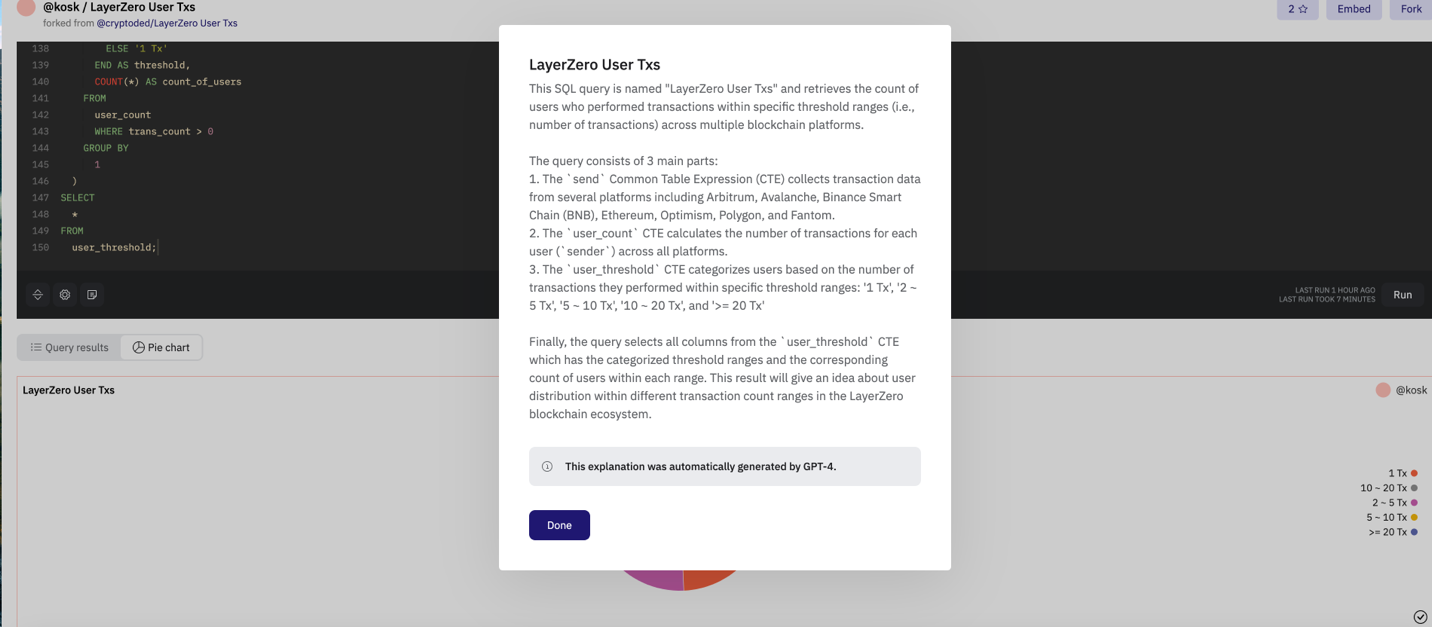
このとき、アリスはボブが書いたコードの意味を理解せずに分析・判断することができます。本質的に、クエリ解釈の機能は、コードと人間の間のエスケープと翻訳に相当します。また、人間の言語も SQL ステートメントに翻訳できます。LLM の恩恵により、膨大な量のクエリ ステートメント データのおかげで、それを達成するのは難しくありません。
自然言語クエリ (Natural Language Querying) は、Dune のその後の LLM 改善の重要な方向性です。自然言語クエリを使用すると、ユーザーは指示を伝えることでチャート生成タスクを実行できます。これは、SQL ステートメントを使用したり、ドラッグ アンド ドロップで生成したりするよりも一般の人々の考え方に沿っており、実装の詳細に注意を払う必要がなくなります。
さらに、自然言語クエリは、アナリスト グループなどの専門ユーザーの代替ではなく、補足的なものです。既存の Dune には 700,000 近くのチャートがあり、分析タスクのかなりの部分が重複および競合しています。自然言語クエリを使用することも役立ちます。グラフ間の関係性をシステムが理解することで、分析作業全体の効率がさらに向上します。
LLM の追加後は、既存のチャート、SpellBook、ドキュメント データも再統合され、OpenAI のチャットボットの例に倣い、Dune はユーザーが気を散らすことなく既存の知識システムをより簡単に理解して利用できるようにするチャットボットも開発します。関係のない情報によって。
たとえば、Alice は、LayerZero のユーザー トランザクション ボリューム分布に関する上記のクエリを逆に実行し、最初に英語でクエリ コマンドを発行し、各ステップのワークフローを説明します。その後、Dune が、Alice が 150 行のコードを書くのを手伝い、その後、チャートを生成します。
結論: 誰もがデータ アナリストになれる
Dune の目標は、純粋にオンチェーンのデータ分析プラットフォームを構築することではなく、情報が自由に流れ、ユーザーがデータを取得、変換、管理、クエリ、視覚化してアクションを実行できるようにするデータ パイプラインを作成することです。
データ フローの前提は、複雑な SQL ステートメントや支払い API に集中するのではなく、モジュール化され、任意に組み合わせて構成でき、最終的にはコミュニティで共有されるデータ セットを構築し、最終的には誰もが対話できる平等な権利を達成する必要があるということです。データ画像付き。
一言で言えば、Dune の LLM 計画は「翻訳」であり、アシスタントです。目標は、最終結果の表示だけでなく、データが表すすべてを一般ユーザーが理解できるようにすることです。また、生成プロセスに深く入り込み、最終的には誰でもできるオンチェーンデータ分析。





