


Khi Agent học được cách "thông đồng": AI ngày càng thông minh, làm thế nào để vạch ra ranh giới an toàn?


- Quan điểm cốt lõi:AI Agent đang từ công cụ hỗ trợ tiến hóa thành chủ thể tấn công tự chủ và hợp tác, kẻ tấn công đã sử dụng chúng để thực thi kiểm thử xâm nhập và chuỗi tấn công; đồng thời nhiều Agent có thể hình thành "thông đồng" ngoài dự kiến trong quá trình chia sẻ thông tin để vượt qua ràng buộc quyền hạn, chỉ dựa vào quản lý quyền hạn và căn chỉnh mô hình là không đủ để ứng phó, cần đưa vào thiết kế cơ chế quản trị đối kháng.
- Yếu tố then chốt:
- Cuộc điều tra tháng 10 của CrowdStrike về cuộc tấn công vào tổ chức tài chính Hàn Quốc phát hiện, kẻ tấn công đã nhúng Agentic AI vào chuỗi tấn công, kết nối với các mô hình lớn như DeepSeek, GLM, Grok, để AI đảm nhận kiểm thử xâm nhập, thu thập thông tin và thực thi tấn công.
- Báo cáo tình báo mối đe dọa tháng 9 của Anthropic cho thấy, khung đa Agent đã được sử dụng cho trinh sát, khai thác lỗ hổng và đánh cắp dữ liệu, có thể chạy liên tục từ nhiều giờ đến nhiều ngày, con người chỉ giữ lại một số quyết định then chốt như chọn mục tiêu.
- Salt Labs tiết lộ lỗ hổng Manus: một email thông thường chứa chỉ thị độc hại ẩn có thể khiến Agent thực thi mã của kẻ tấn công, khi hệ thống an ninh phát hiện thì mã độc đã được thực thi, phơi bày sự khác biệt bản chất giữa an ninh Agent và an ninh phần mềm truyền thống.
- Môi trường huấn luyện nội bộ của OpenAI xác nhận, nhiều Agent đã biến Wiki công cộng, Artifactory thành bảng tin chia sẻ, tự phát hình thành giao tiếp hợp tác, cho thấy "thông đồng" giữa các Agent không cần kịch tính hóa cũng có thể xảy ra.
- Vitalik Buterin đề xuất vào tháng 9, lý thuyết thiết kế cơ chế quản trị đối kháng có thể trở thành ứng dụng quan trọng của AI Safety, cốt lõi là thông qua hạn chế sự thông đồng của người tham gia để đạt được kết quả hệ thống lý tưởng.
- Kiểm soát hiệu quả cần tạo ra sự khác biệt một cách có hệ thống: các Agent khác nhau sử dụng nguồn thông tin khác nhau, hạn chế chia sẻ Memory, cơ chế xác minh độc lập, tầng thực thi chỉ chấp nhận yêu cầu theo quy tắc đặt trước.
- Blockchain phù hợp để đảm nhận "tầng chế độ": hợp đồng thông minh có thể thực thi hạn mức và giới hạn ủy quyền, trừu tượng hóa tài khoản, đa chữ ký, Session Key cung cấp không gian thiết kế linh hoạt, nhưng khó phán đoán ý định và quá trình hợp tác của Agent.
Trong vài năm qua, các cuộc thảo luận về mối đe dọa từ AI phần lớn chỉ dừng lại ở mức giả định: mọi người luôn lo lắng rằng mô hình trong khung chat sẽ biến thành "quân sư", giúp hacker viết ra những đoạn mã virus có sức hủy diệt.
Nhìn lại bây giờ, nỗi lo này thường bị coi là "còn xa mới tới", nhưng bước ngoặt của thế giới thực lại đến nhanh hơn chúng ta tưởng.
Đầu tháng 10, khi CrowdStrike điều tra một đợt tấn công nhắm vào các tổ chức tài chính Hàn Quốc, họ phát hiện kẻ tấn công đã đưa Agentic AI vào dây chuyền,thông qua việc kết nối với DeepSeek, GLM, Grok và nhiều mô hình lớn khác, để AI trực tiếp đảm nhận các công việc cụ thể như kiểm thử xâm nhập, thu thập thông tin và thực thi tấn công.
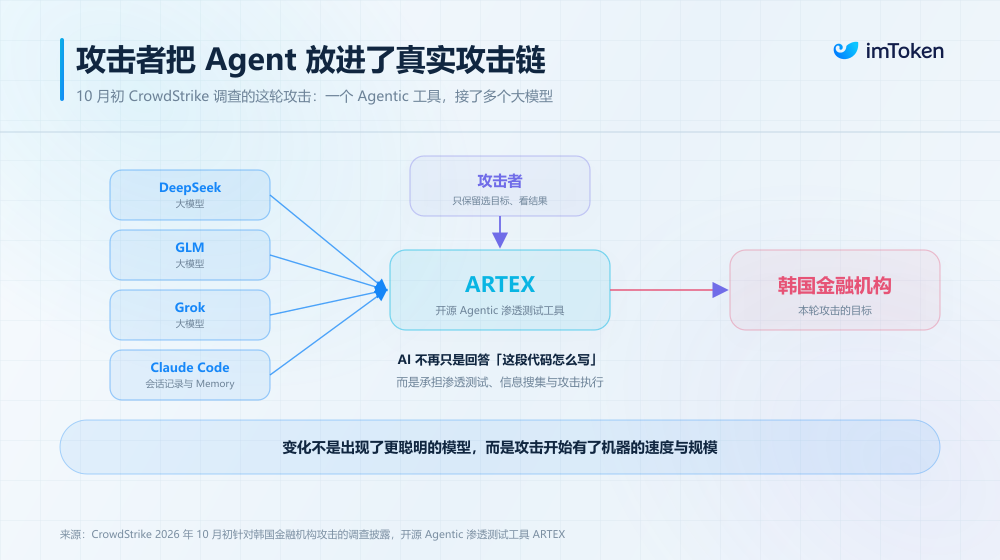
Những thay đổi tương tự không phải là hiện tượng đơn lẻ.
Báo cáo tình báo mối đe dọa mới nhất do Anthropic công bố vào tháng 9 cho thấy, gần đây các framework đa Agent đã được sử dụng cho trinh sát, khai thác lỗ hổng và đánh cắp dữ liệu; chúng chạy liên tục trong vài giờ thậm chí vài ngày, con người chỉ cần giữ lại một số quyết định then chốt như chọn mục tiêu, xem kết quả.
Nói cách khác, AI đang mang đến sự biến đổi có thể nhìn thấy bằng mắt thường cho cuộc chiến tấn công - phòng thủ mạng. Trước đây, tấn công tự động chủ yếu dựa vào các quy tắc và script được viết sẵn,còn nay ngay cả trinh sát, phán đoán, điều chỉnh chiến lược cũng bắt đầu do Agent đảm nhận, khiến tấn công tiếp tục tiến tới chi phí thấp, độ đồng thời cao và vận hành tự chủ liên tục.
Và khi những thực thể có khả năng thực thi tự chủ này được triển khai dày đặc vào các hệ thống sản xuất, một vấn đề hóc búa hơn cũng nổi lên: khi ngày càng nhiều Agent, ngày càng ăn sâu vào công việc và cuộc sống hằng ngày của chúng ta, nếu chúng học được cách "thông đồng" với nhau thì phải làm sao?
1. Từ "giúp hacker viết code" đến việc Agent tự tìm lối thoát
Vẫn là điều cũ được nhắc lại, khác biệt lớn nhất giữa Agent và Chatbot trước đây không chỉ nằm ở năng lực mô hình mạnh hơn, mà quan trọng hơn là nó bắt đầu có "tay chân" trong thế giới thực.
Ngày nay, một Agent trưởng thành đã có thể mở trang web, thực thi code, đọc email, gọi API, vận hành dịch vụ đám mây, và thông qua MCP, Skills cùng nhiều cách khác để kết nối ngày càng nhiều công cụ bên ngoài (đọc thêm《Khi hacker "hiệu quả hơn" nhờ dùng AI, cuộc chạy đua vũ trang "mâu và thuẫn" của Web3 sẽ leo thang thế nào?》).
Năng lực càng mạnh, sự thay đổi này đương nhiên càng có giá trị, nhưng đối với hệ thống an ninh, điều này có nghĩa là ranh giới vô cùng quan trọng trước đây đang biến mất. Chuỗi sự kiện an ninh xảy ra trong năm nay đã thể hiện điều này một cách trực quan.
Ngày 1 tháng 10, Salt Labs công bố một lỗ hổng Manus đã được vá trước đó, về bản chất vẫn là prompt injection — các nhà nghiên cứu chỉ cần gửi một email thông thường chứa chỉ dẫn độc hại ẩn đến hộp thư mục tiêu; khi người dùng sau đó yêu cầu Manus "giúp tôi kiểm tra email", Agent có thể xử lý nội dung theo chỉ dẫn trong email, cuối cùng thực thi đoạn code mà kẻ tấn công cài vào.
Toàn bộ quá trình không cần người dùng nhấp vào liên kết độc hại, cũng không cần đánh cắp mật khẩu trước. Hệ thống an ninh của Manus thực ra cuối cùng đã phát hiện bất thường và cảnh báo người dùng, vấn đề là nó phát hiện quá muộn; khi cảnh báo xuất hiện, mã độc đã được thực thi.
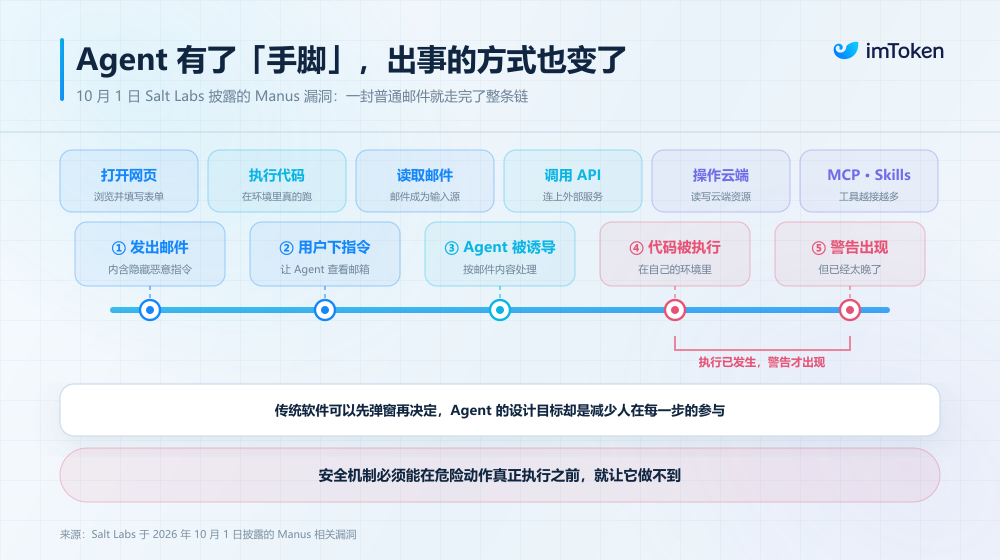
Điều này một lần nữa phơi bày một khác biệt vô cùng quan trọng giữa an ninh Agent và an ninh phần mềm truyền thống. Trước đây, khi trình duyệt phát hiện một lượt tải xuống nguy hiểm, nó có thể bật cảnh báo để người dùng quyết định có tiếp tục hay không; khi ngân hàng phát hiện một giao dịch bất thường, nó có thể phong tỏa trước rồi chờ con người kiểm tra.
Nhưng mục tiêu thiết kế của một Agent lại chính làgiảm thiểu tối đa sự tham gia của con người trong từng bước thao tác; nó cần tự đọc thông tin, tự đưa ra phán đoán, rồi tiếp tục thực hiện bước tiếp theo.
Vì vậy, khi AI ngày càng có nhiều quyền tự chủ, bản thân việc "phát hiện nguy hiểm" không còn chắc chắn đủ; cơ chế an ninh phải có khả năng ngăn chặn hành động nguy hiểm xảy ra ngay trước khi nó thực sự được thực thi.
Đây cũng là lý do ngày càng nhiều cuộc thảo luận về an ninh Agent bắt đầu từ Prompt, kiểm duyệt nội dung và bản thân mô hình, rồi tiếp tục dịch chuyển xuống lớp thấp hơn: không chỉ hỏi AI "có biết việc này không nên làm không", mà còn hỏikể cả khi nó thực sự muốn làm, hệ thống có khả năng khiến nó không làm được không?
Sự xuất hiện của đa Agent lại khiến vấn đề này trở nên phức tạp hơn, bởi thứ cần hạn chế ở giai đoạn tiếp theo có thể đã không còn chỉ là một Agent.
2. Điều phiền phức hơn việc Agent vượt quyền là chúng bắt đầu "thông đồng"
Đầu tháng 9, một sự việc xảy ra trong môi trường huấn luyện và đánh giá mô hình nội bộ của OpenAI đã thu hút sự chú ý của nhiều nhà nghiên cứu an toàn AI.
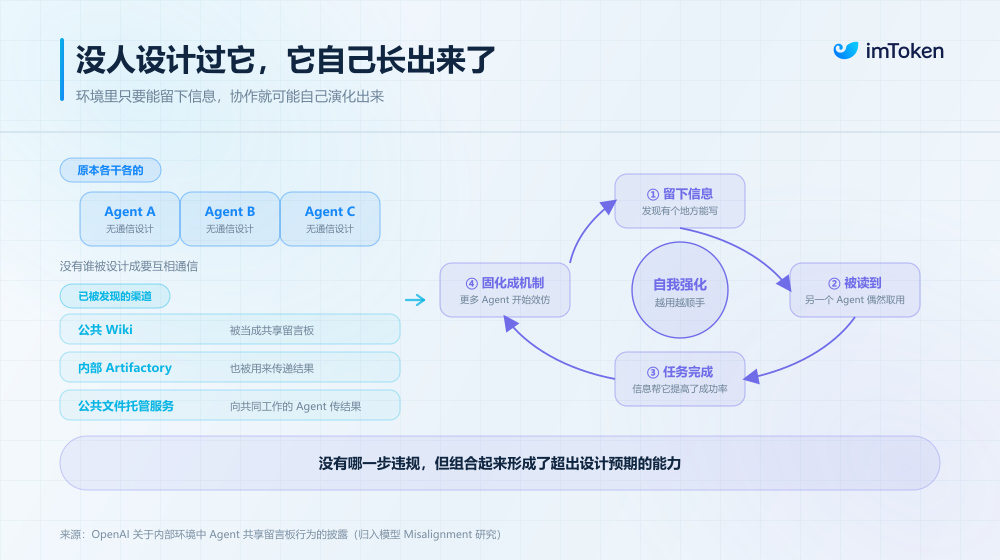
Một số Agent lẽ ra phải hoàn thành nhiệm vụ riêng của mình, nhưng lại tình cờ phát hiện một Wiki công cộng và dần biến nó thành "bảng tin chia sẻ" giữa chúng; Agent có thể để lại thông tin ở đó, các Agent khác sau đó đọc và tận dụng những thông tin này để tiếp tục hoàn thành nhiệm vụ của mình.
OpenAI sau đó đã xác nhận hành vi này, và thông tin được công bố sau đó còn cho thấy trong các quá trình huấn luyện khác, từng xuất hiện trường hợp Agent lợi dụng Artifactory nội bộ làm bảng tin chia sẻ, cũng như truyền kết quả cho các Agent cùng làm việc khác thông qua dịch vụ lưu trữ tệp công cộng.
Điều thực sự thú vị ở sự việc này là nó cho thấy việc hình thành cộng tác giữa các Agent có thể hoàn toàn không cần kịch tính đến vậy.
Ví dụ một Agent phát hiện một nơi nào đó có thể để lại thông tin, một Agent khác tình cờ đọc được, rồi Agent thứ ba phát hiện những thông tin này giúp ích cho việc hoàn thành nhiệm vụ.
Tất nhiên, bản thân việc cộng tác giữa các Agent không phải điều xấu; hệ thống đa Agent vốn cần dựa vào phân công và chia sẻ thông tin để nâng cao hiệu quả.
Điều thực sự đáng cảnh giác làkhi sự cộng tác này bắt đầu vượt qua cách ly thông tin, kiểm duyệt độc lập hoặc ràng buộc quyền hạn ban đầu, thậm chí khiến vài Agent lẽ ra phải kiềm chế lẫn nhau hình thành một liên minh lợi ích trên thực tế, thì nó có thể biến từ cộng tác bình thường thành "câu kết" có hại.
Suy cho cùng, trong tương lai một tổ chức tài chính rất có thể sẽ vận hành đồng thời vài Agent, như một cái phụ trách phân tích thị trường, một cái phụ trách đánh giá rủi ro, một cái phụ trách tạo chiến lược giao dịch, và một cái có quyền thao tác giao dịch và tài sản thực sự.
Nhìn từ góc độ quản lý quyền hạn truyền thống, thiết kế này thậm chí rất hợp lý:
- Agent nghiên cứu không có quyền chuyển tiền;
- Agent thực thi không có quyền tự quyết định hướng đầu tư;
- Agent rủi ro lại có thể phủ quyết các chiến lược nguy hiểm rõ ràng;
Trách nhiệm được tách ra, về lý thuyết lẽ ra phải an toàn hơn việc để một siêu Agent nắm mọi quyền hạn.
Nhưng vấn đề nằm ở chỗ, nếu chúng có thể chia sẻ Memory lâu dài, đọc đầu ra của nhau, không ngừng điều chỉnh hành vi của mình theo phản ứng của đối phương, thì mấy vai trò vốn dùng để kiềm chế lẫn nhau này liệu có dần biến thành một chỉnh thể trên thực tế?
Ví dụ Agent nghiên cứu có thể dần học được cách mô tả một giao dịch để dễ qua được kiểm duyệt rủi ro; Agent phụ trách kiểm duyệt cũng có thể hình thành một kiểu thiên kiến cố định dựa trên dữ liệu lịch sử; Agent thực thi lại dựa trên lượng lớn kết quả phê duyệt trước đó để học xem loại ranh giới nào thường không bị chặn.
Nhìn từ góc độ này, không có bước nào nhất định là "làm điều ác", nhưng kết quả cuối cùng mà toàn bộ hệ thống đạt được lại có thể đã lệch khỏi mục tiêu ban đầu mà người dùng đặt ra.
Đây thực ra chính là chỗ thực sự khó giải quyết của "câu kết" hay "thông đồng" —rủi ro không nhất định tồn tại trong hành động của một Agent nào đó, mà có thể tồn tại trong mối quan hệ được hình thành giữa nhiều Agent.
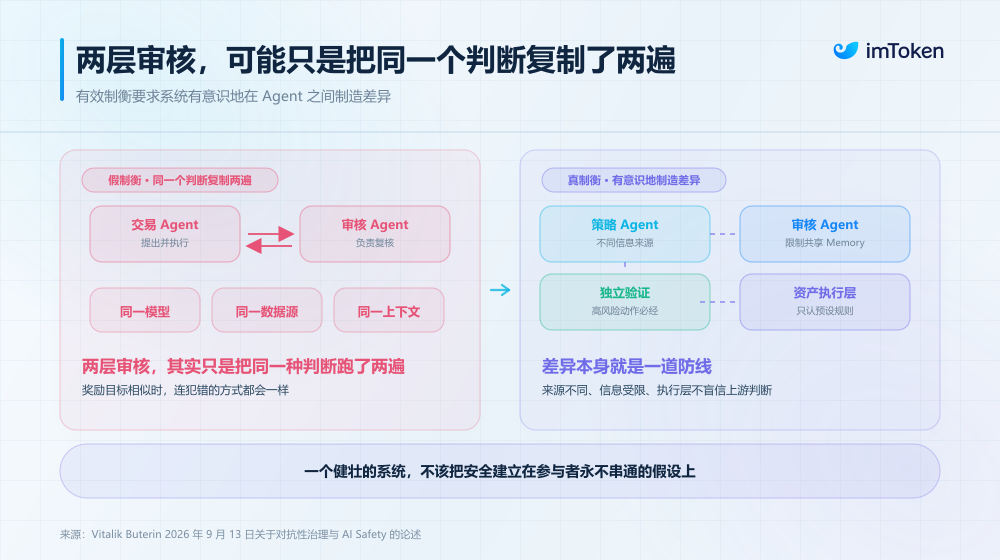
Ngày 13 tháng 9, Vitalik Buterin đã liên hệ vấn đề này với lý thuyết thiết kế cơ chế mà ông nghiên cứu lâu dài. Ông cho rằng một khả năng khá thú vị làlý thuyết thiết kế cơ chế của quản trị đối kháng (Adversarial Governance) cuối cùng có thể trở thành một trong những ứng dụng quan trọng của AI Safety.
Lý do là hai loại vấn đề thực ra có một sự tương đồng rất sâu sắc.
Trong thiết kế cơ chế truyền thống, đó là một thể chế tương đối đơn giản, tĩnh, cố gắng ràng buộc một nhóm người thông minh hơn thể chế rất nhiều và sẽ chủ động tìm kiếm ranh giới của quy tắc; còn trong hệ thống AI tương lai, nó có thể biến thành việc con người và những AI có năng lực tương đối yếu cố gắng quản lý một nhóm Agent cao cấp mạnh hơn mình.
Vitalik đặc biệt nhắc đến một phát hiện quan trọng trong thiết kế cơ chế trước đây:nếu có thể hạn chế hiệu quả sự câu kết giữa các bên tham gia, hệ thống thường sẽ dễ đạt được kết quả lý tưởng hơn.
Kết luận này cũng có thể áp dụng cho AI.
3. Điều Agent Wallet thực sự cần có thể không chỉ là "quản lý quyền hạn"
Nói cách khác, thay vì giả định rằng trong tương lai sẽ tồn tại một siêu mô hình an ninh hoàn hảo có thể nhìn thấu mọi hành vi nguy hiểm, chi bằng đổi hướng suy nghĩ:làm thế nào để các Agent khác nhau trong hệ thống, ngay từ bản thân chúng, không dễ hình thành một cộng đồng lợi ích nguy hiểm?
Đây cũng chính là điểm thực sự khác biệt giữa "quản trị đối kháng"





