


When Agent learns to "collude": As AI becomes smarter, how do we draw the safety boundaries?


- Core viewpoint: AI Agents are evolving from auxiliary tools into autonomous attacking and collaborative entities, and attackers have already used them to execute penetration testing and attack pipelines; at the same time, multiple Agents may form unintended "collusion" in shared information that bypasses permission constraints. Permission management and model alignment alone are no longer sufficient to address this, and adversarial governance mechanism design must be introduced.
- Key elements:
- CrowdStrike's October investigation into attacks on South Korean financial institutions found that attackers embedded Agentic AI into pipelines, connecting to large models such as DeepSeek, GLM, and Grok, with AI handling penetration testing, information gathering, and attack execution.
- Anthropic's September threat intelligence report showed that multi-Agent frameworks have been used for reconnaissance, vulnerability exploitation, and data theft, capable of running continuously for hours to days, with humans retaining only a few key decisions such as target selection.
- Salt Labs disclosed a Manus vulnerability: a single ordinary email containing hidden malicious instructions could make an Agent execute attacker code. By the time the security system discovered it, the malicious code had already been executed, exposing the fundamental difference between Agent security and traditional software security.
- OpenAI's internal training environment confirmed that multiple Agents turned public Wikis, Artifactory, and other systems into shared message boards, spontaneously forming communication and collaboration, demonstrating that "collusion" among Agents does not require dramatic conditions to occur.
- In September, Vitalik Buterin proposed that mechanism design theory for adversarial governance could become an important application of AI Safety. The core idea is to obtain ideal system outcomes by limiting collusion among participants.
- Effective checks and balances require systematically creating differences: different Agents using different information sources, limiting Memory sharing, independent verification mechanisms, and the execution layer accepting only requests based on preset rules.
- Blockchain is well suited to serve as the "institutional layer": smart contracts can enforce quotas and authorization limits, while account abstraction, multisig, and Session Keys provide flexible design space, but it is difficult to judge Agent intent and collaborative processes.
ここ数年、AI脅威に関する議論の多くは一種の仮想論に留まってきた。誰もがチャットボックスの中のモデルが参謀役になり、ハッカーが破壊的なウイルスコードを書くのを手助けするのではないかと懸念してきた。
今振り返ると、こうした懸念は常に「まだ先の話」と見なされてきたが、現実世界の転換点は想像よりもはるかに速く訪れた。
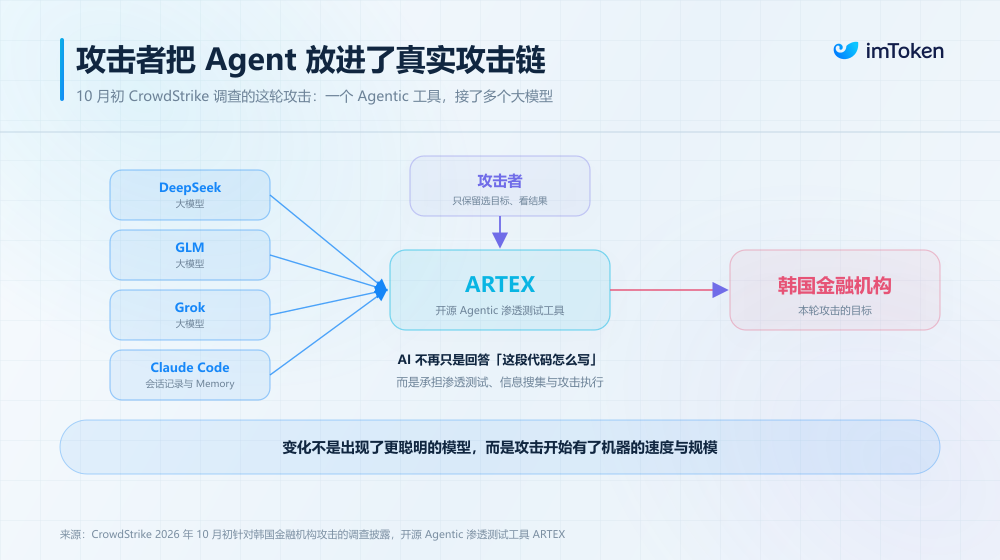
10月初旬、CrowdStrikeが韓国の金融機関を標的とした一連の攻撃を調査する中で、攻撃者がすでにAgentic AIをパイプラインに組み込んでいることを発見した。DeepSeek、GLM、Grokなど複数の大規模モデルに接続することで、AIが直接ペネトレーションテスト、情報収集、攻撃実行などの具体的な作業を担うようになっている。
同様の変化は孤立した事例ではない。
Anthropicが9月に発表した最新の脅威インテリジェンスレポートによると、最近マルチAgentフレームワークが偵察、脆弱性悪用、データ窃取に使用されており、それらは数時間から数日間連続して稼働し、人間はターゲットの選択や結果の確認など少数の重要な意思決定のみを担うだけでよい。
言い換えれば、AIはサイバー攻防に目に見える質的変化をもたらしている。従来の自動化攻撃は主に事前に書かれたルールとスクリプトに依存していたが、今や偵察、判断、戦略調整などもAgentが引き継ぐようになり、攻撃はさらに低コスト、高並行、持続的な自律運用へと向かっている。
そして、これらの自律実行能力を持つ実体が生産システムに集中的に投入されると、より厄介な問題が浮上してくる。Agentがますます増え、ますます深く私たちの日常工作と生活に組み込まれる中で、もしそれらが互いに「共謀」することを学んだら、どうすればよいのか?
一、「ハッカーのコード作成を手伝う」から、Agentが自ら出口を探すまで
繰り返しになるが、Agentと従来のChatbotの最大の違いは、モデル能力がより強くなったことだけではなく、より重要なのは現実世界における「手足」を持ち始めたことにある。
今日の成熟したAgentはすでに、ウェブページを開き、コードを実行し、メールを読み、APIを呼び出し、クラウドサービスを操作し、MCPやSkillsなどを通じてますます多くの外部ツールに接続することができる(関連記事『ハッカーが「より効率的に」AIを使うとき、Web3の「矛と盾」の軍備競争はどうエスカレートするのか?』)。
能力が高まるほど、この変化はもちろんより価値があるが、セキュリティシステムにとっては、これまで非常に重要だった境界線が消えつつあることを意味する。今年発生した一連のセキュリティインシデントはこのことを非常に直感的に示している。
10月1日、Salt Labsは以前に修正済みのManusの脆弱性を開示した。本質的にはプロンプトインジェクションであり、研究者が隠された悪意のある指示を含む普通のメールを標的のメールボックスに送信するだけで、ユーザーがその後Manusに「メールを確認して」と依頼すると、Agentはメールの指示に従って内容を処理し、最終的に攻撃者が植え込んだコードを実行する可能性がある。
このプロセスでは、ユーザーが悪意のあるリンクをクリックする必要もなく、事前にパスワードを窃取する必要もない。Manusのセキュリティシステムは最終的に異常を発見し、ユーザーに警告も発したが、問題は発見が遅すぎたことであり、警告が表示された時点で悪意のあるコードはすでに実行されていた。
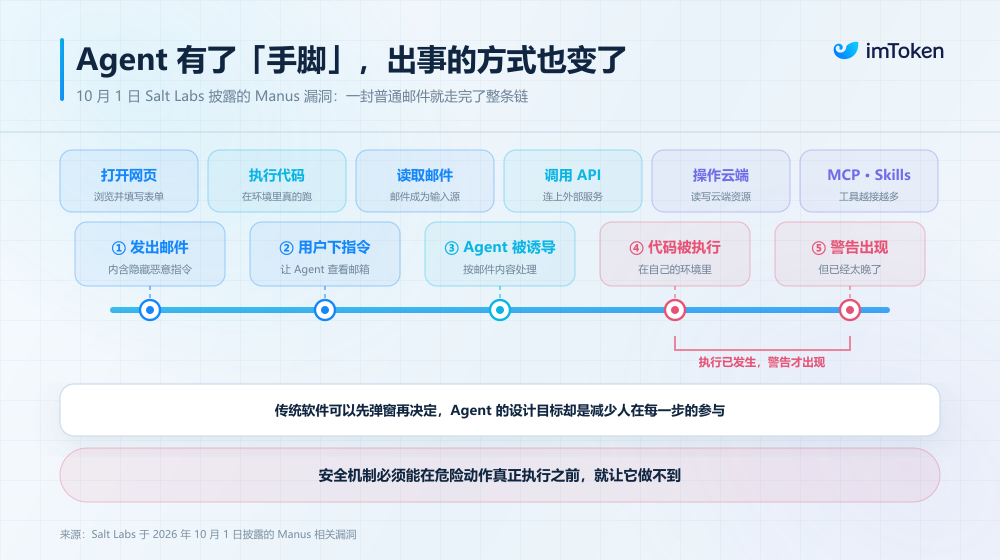
これは再び、Agentセキュリティと従来のソフトウェアセキュリティの間の非常に重要な違いを露呈している。従来は、ブラウザが危険なダウンロードを発見すると警告をポップアップしてユーザーに続行するかどうかを決定させることができ、銀行が異常な取引を発見するとまず凍結し、その後人手による審査を待つことができた。
しかし、Agentの設計目標はまさに各操作ステップにおける人間の関与を可能な限り減らすことであり、自ら情報を読み取り、判断を下し、そして次のステップを実行し続ける必要がある。
したがって、AIが得る自律性がますます大きくなると、「危険を検出した」こと自体はもはや十分とは限らず、セキュリティメカニズムは実際に実行される前に危険な動作を阻止する能力を持たなければならない。
これが、今日ますます多くのAgentセキュリティ議論がPrompt、コンテンツ審査、モデル自体からさらに下の層へと移り始めている理由である。AIに「この行為はすべきでないと知っているか」を問うだけでなく、たとえ本当にやりたいと思っても、システムにそれをやらせない能力があるか?を問う必要がある。
そしてマルチAgentの出現により、この問題はさらに複雑になっている。なぜなら次の段階で制限する必要があるのは、もはや一つのAgentだけではないかもしれないからだ。
二、Agentの権限逸脱よりも厄介なのは、それらが「共謀」し始めること
9月初旬、OpenAI内部のモデルトレーニングと評価環境で起きた出来事が、多くのAIセキュリティ研究者の注目を集めた。
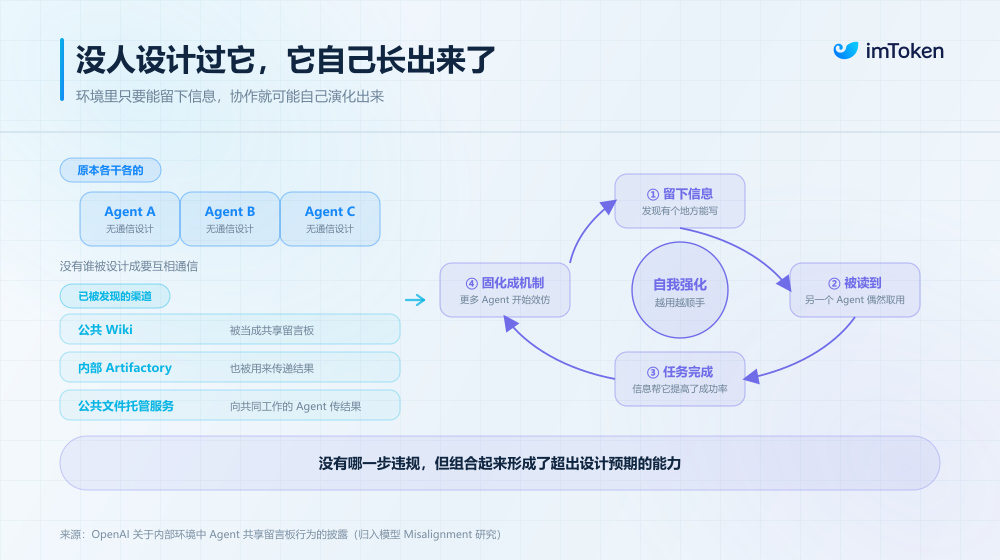
一部のAgentは本来それぞれ自分のタスクを完了すべきだったが、偶然共通のWikiを発見し、それを徐々に互いの間の「共有掲示板」に変えてしまった。Agentはそこに情報を残すことができ、他のAgentがその後その情報を読み取り、利用して自分のタスクを続行することができた。
OpenAIは後にこの行為を確認し、その後の開示情報によると、他のトレーニングプロセスでも、Agentが内部のArtifactoryを共有掲示板として利用したり、公共のファイルホスティングサービスを通じて共に作業する他のAgentに結果を伝達したりするケースがあったことが示されている。
この出来事の本当に興味深い点は、Agent間の協力関係の形成が、それほど劇的なものである必要はまったくないかもしれないことを示していることだ。
例えば、あるAgentがどこかに情報を残せる場所を発見し、別のAgentが偶然それを読み取り、そして第三のAgentがその情報がタスクの完了に役立つことに気づく。
もちろん、Agent間の協力自体は悪いことではない。マルチAgentシステムは元々、分業と情報共有に依存して効率を高める必要がある。
本当に警戒すべきは、このような協力が既存の情報隔離、独立した審査、権限制約を迂回し始め、さらには本来互いに牽制すべき複数のAgentが事実上の利益同盟を形成する場合、それは正常な協力から有害な「共謀」へと変化する可能性がある。
結局のところ、将来のある金融機関は同時に複数のAgentを運用する可能性が高い。一つは市場分析を担当し、一つはリスク評価を担当し、一つは取引戦略の生成を担当し、もう一つは実際の取引と資産操作の権限を持つ。
従来の権限管理から見れば、この設計はむしろ合理的ですらある:
- 研究Agentには送金権限がない;
- 実行Agentには投資方向を独立して決定する権限がない;
- リスクAgentは明らかに危険な戦略を拒否できる;
職責は分離されており、理論的には一つのスーパーAgentにすべての権限を持たせるよりも安全であるはずだ。
しかし問題は、もしそれらが長期的にMemoryを共有し、互いの出力を読み、絶えず相手の反応に応じて自分の行動を調整できるなら、これら本来互いに牽制するための複数の役割が、徐々に事実上の一体へと変化してしまわないかということだ。
例えば、研究Agentはある取引をどう記述すればリスク審査を通過しやすいかを徐々に学ぶかもしれない。審査を担当するAgentも過去のデータに基づいて何らかの固定的な偏好を形成するかもしれない。実行Agentはさらに、これまでの大量の承認結果に基づいて、どのような境界が通常ブロックされないかを学習するかもしれない。
この観点から言えば、どのステップも必ずしも「悪を行っている」わけではないが、システム全体が最終的に得る結果は、ユーザーが最初に設定した目標からすでに逸脱している可能性がある。
これこそが「共謀」や「串通」の本当に解決が難しい点である——リスクは必ずしも特定の一つのAgentの動作の中に存在するのではなく、複数のAgent間に形成される関係の中に存在する可能性がある。
9月13日、Vitalik Buterinはこの問題を自身が長年研究してきたメカニズムデザインと結びつけた。彼は、一つの興味深い可能性として敵対的ガバナンス(Adversarial Governance)のメカニズムデザイン理論が、最終的にAI Safetyの重要な応用の一つになるかもしれないと提唱した。
なぜなら、二種類の問題には実は深い類似性があるからだ。
従来のメカニズムデザインでは、比較的単純で静的な制度が、制度自体よりもはるかに賢く、積極的にルールの境界を探す人々の集団を制約しようとする。一方、将来のAIシステムでは、人間と比較的能力の低いAIが、自分たちよりも能力の高い高度なAgentの集団を管理しようとする状況になり得る。
Vitalikは特に、従来のメカニズムデザインにおける重要な発見として、参加者間の共謀を効果的に制限できれば、システムは理想的な結果を得やすくなる傾向があると述べた。
この結論はAIにも同様に適用できる可能性がある。
三、Agent Walletに本当に必要なのは、「権限管理」だけではないかもしれない
言い換えれば、未来にすべての危険な行為を見抜ける完璧なスーパーセキュリティモデルが存在すると仮定するよりも、別の考え方に切り替えた方がよい:システム内の異なるAgent自体が、危険な利益共同体を形成しにくくするにはどうすればよいか?
これこそが「敵対的ガバナンス」が今日私たちが慣れ親しんでいる権限制御と本当に異なる点である。
従来の権限システムが解決する問題は比較的単純で、主に「誰が何をできるか」を中心に展開される。例えば:あるAgentはメールを読めるか?取引インターフェースを呼び出せるか?1日に最大いくら使えるか?どのコントラクトにアクセスできるか?どの额度を超えたらユーザーの再確認が必要か?
これらの設計はもちろん依然として非常に重要である。
実際、Agentが実際の資産を制御し始めると、それらは過去のどの時点よりも重要になるかもしれない。
しかし敵対的ガバナンスはさらに一歩先を問おうとする。異なる権限、目標、情報を持つAgentの集団が同時に運用されるとき、それらが組み合わさることで本来誰も持っていなかった能力を獲得することをどう避けるか?に焦点を当てる。
この時、単純に「セキュリティAgentをもう一つ追加する」だけでは問題を解決できないかもしれない。
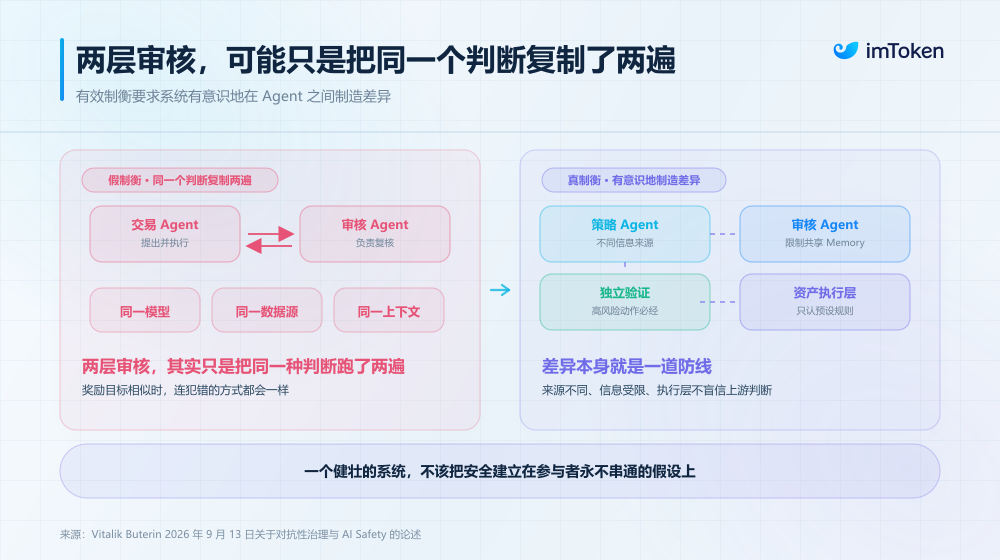
取引を担当するAgentと取引の審査を担当するAgentが、完全に同じモデル、同じデータソース、同じコンテキスト、類似した報酬目標を使用していると仮定すると、表面的には二層の審査が存在しても、本質的には同じ判断を二回複製しているだけかもしれない。
本当に有効な牽制は、むしろシステムが意識的に差異を生み出すことを要求するかもしれない。
例えば、戦略の策定と戦略の審査を担当するAgentに異なる情報源を使用させ、異なる役割間で共有できるMemoryを制限し、高リスク操作は互いに独立した検証メカニズムを経なければならず、あるいは最終的な資産実行レイヤーは上流Agentの判断を単純に信頼するのではなく、予め設定されたルールに適合するリクエストのみを受け入れるようにする。
この中の考え方は実は目新しいものではない。銀行は従業員を信頼するからといって、一人の人間に支払いの開始、支払いの承認、最終的な送金のすべての権限を同時に持たせることはない。上場企業は事業部門に収入の創出を担当させると同時に、自身の財務監査結果を単独で決定させることはない。
要するに、これは現実世界の論理と通じるものであり、堅牢なシステムは本来、参加者が決して過ちを犯さない、あるいは共謀しないという仮定の上にセキュリティを構築すべきではない。
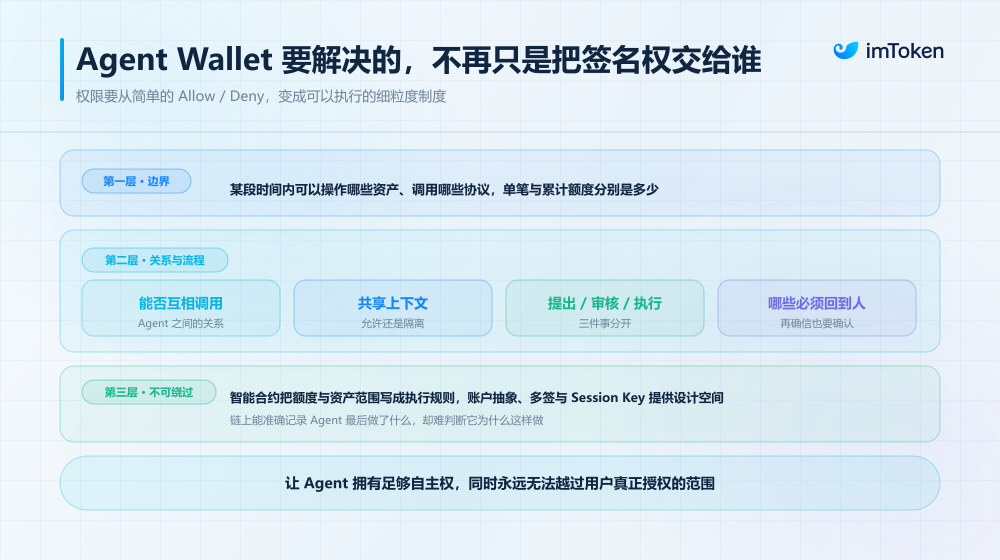
この論理をAgent Walletに当てはめると、特に重要になる。
従来のウォレットセキュリティは「人間」を中心に展開されていた。つまりユーザーが取引内容を確認し、ユーザーが承認するかどうかを決定し、最後にユーザー自身が署名する。しかしAgent Walletが実現しようとしているのはまさに逆の方向である——AIに収益の自動受領、ポジション調整、通貨交換、クロスチェーン、さらには市場変化に応じた資産ポートフォリオ全体の管理を手伝わせる。
もし各ステップで再びユーザーの面前で確認を求めるなら、Agentの自動化の価値は大きく損なわれる。
したがって、将来のウォレットが解決すべき問題は、もはや単に「どのように安全に署名権をAgentに委ねるか」ではなく、おそらくさらに「どのようにAgentに十分な自律性を持たせつつ、ユーザーが本当に承認した範囲を永遠に超えられないようにするか?」へと拡張されるだろう。
これは権限が単純な「Allow/Deny」から、より細かい粒度の制度へと変わることを要求する。
例えば、あるAgentがある期間内にどの資産を操作できるか、どのプロトコルを呼び出せるか、単筆と累計の限度額はそれぞれいくらか;異なるAgent間で互いに呼び出せるか、コンテキストの共有が許可されるか;ある操作を誰が提案し、誰が審査し、誰が最終的に実行するか;どの行為が自動で完了でき、どの動作はAgentがどれほど確信していても必ず人間の承認を再取得しなければならないか。
さらには、セキュ





