


Jevが突然爆火してタイムラインを埋め尽くす:チャットもせず、コードも書かず、判断だけを行う


- 核心的な見解:元OpenAIの中核メンバーがJevモデルを発表。低コスト・高速な判断と確率出力に特化し、Agent時代のAI自動化には深い対話ではなく大量の高速意思決定が必要だと賭け、自動化シナリオにおけるRLHFパラダイムの適用性に疑問を投げかけている。
- 重要な要素:
- JevはYes/No、選択、スコアリングの3種類の判断のみを行い、結果と確率を直接出力。エンドツーエンドのレイテンシは70〜500ミリ秒、入力は100万トークンあたりわずか0.042ドル。
- TypeSafeのテストでは、Jevは最大193.6倍の高速化、コストは444.6倍の削減を実現。既に開発者が広告分析、コンテキストクリーニング、Agentタスク評価に活用している。
- 創業者のDiogo AlmeidaはGPT-4とRLHFの研究開発に参加。現在はRLHFが人間の選好をトレーニングに組み込むことで、AIが過度に約束し、自動化タスクを自律的に完了できなくなると反省している。
- TypeSafeはRLCDトレーニング手法を提唱。核心はモデルが出力する確率の信頼度を真に校正可能にし、自動化システムにおける段階的な意思決定を支えることにある。
- Jevは「System One Model」として位置づけられ、Agent運用中の毎日数十万回に及ぶ高頻度の小規模な判断を担当。複雑な推論は依然として大規模モデルが処理する。
- 命名は「ジェヴォンズのパラドックス」に由来——判断コストがゼロに近づくと、AI判断の呼び出し量は減るどころか増加する。
原文作者:朱雪莹
原文来源:ウォール・ストリート・ヘラルド
ここ数日、どこか異質なAIモデルが突然話題をさらった。
その名は Jev。
雑談もできなければ、コードも書けない。ChatGPTのように長々とした回答を生成することもない。やることはただ一つ:判断すること。
しかし、こうした「能力を半分以上削ぎ落とした」ように見えるモデルが、突如として開発者コミュニティで話題になった。
ある人はこれを使って40秒で724件のリアルタイム広告を分析し、合計8724回の判断を下した。ある人はClaude Codeに組み込み、不要なコンテキストの掃除に特化させている。さらにAI Agentの「審判」として、タスクが本当に完了したかをチェックさせる人もいる。LangChainもすでにJevをAgent評価器としてテストし始めている。
さらに驚くべきは、その速度と価格だ。
TypeSafeが公表したテストでは、Jevは最大約193.6倍の高速化を実現し、コストは最大444.6分の1に削減された。入力は100万Tokenあたりわずか0.042ドル、出力Tokenはなんと無料だ。
能力的には少なく見えるAIが、なぜむしろ話題になったのか?
Agentの時代になると、AIに本当に必要なのは「熟考」だけではなく、大量で、高速で、安価な判断だからだ:次に何をするか、どのツールを呼び出すか、タスクは完了したか。さらに重要なのは、こうした判断を将来はAI自身がバックグラウンドで完了させる必要があり、もはや人間がずっと画面の前に座って見張っている必要はないということだ。Jevが狙っているのは、毎日何百万回も発生しうるこうした小さな決定なのだ。
さらに興味深いのは、Jevモデルの創業者Diogo Almeidaが、まさにRLHFに関わった人物であり、今そのRLHFを反省し始めているということだ:ChatGPTを使いやすくしたこのトレーニング手法は、AIが本当に自動化へと向かうには適していないかもしれない。
一ヶ月余り前、Almeidaはある講演を行った。今振り返ると、あの講演はほとんどJevの「思想説明書」そのものだ。
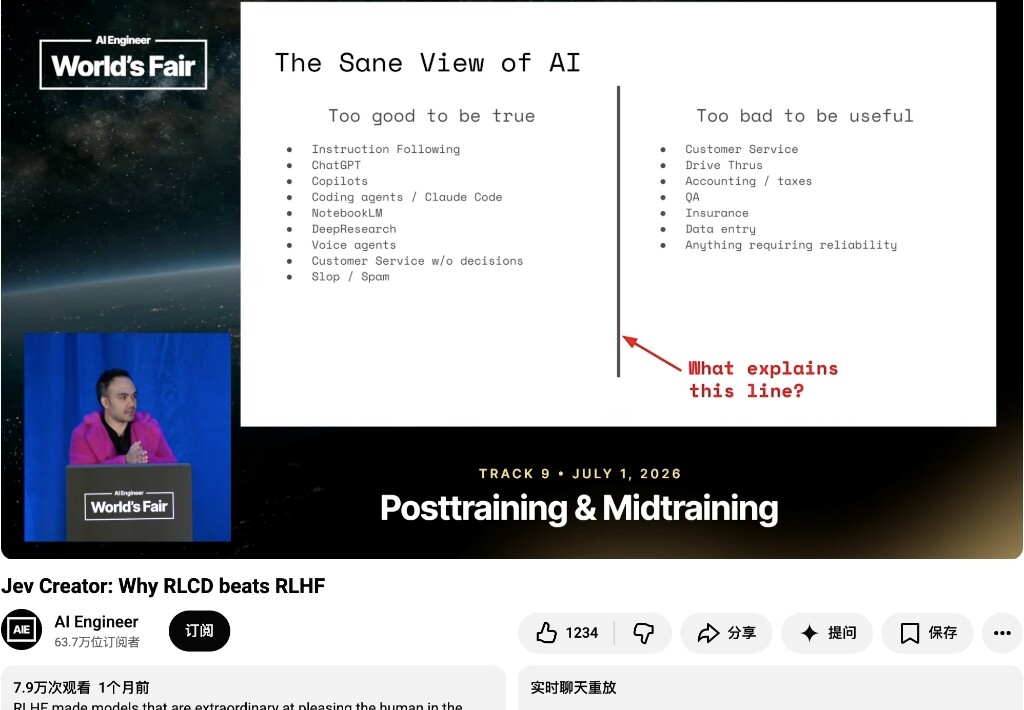
AIは高等数学までできるのに、なぜカスタマーサポートはうまくできないのか?
Diogo Almeidaの経歴は非常に特殊だ。
彼はOpenAIで働いたことがあり、GPT-4、ChatGPT、そしてInstructGPT/RLHF関連の業務に携わった。つまり、今日の大規模モデルにおいて最も重要なポストトレーニングパラダイムの構築に、自ら手を貸した人物なのだ。
しかしあの講演で、彼は冒頭から自分をネタにし、OpenAI内部で公にChatGPTを「disる」数少ない人物の一人だと語った。
講演のテーマはさらに直接的なものだった:What's Next After RLHF?
Diogoはまず、矛盾しているように見える問題を提起した。
今日の大規模モデルはすでに非常に難しい数学の問題に挑戦でき、コード、推論、各種ベンチマークは右肩上がりに伸びている。
しかし、多くの企業が本当に自動化したい業務になると、人間はいつまでも外せないままだ。
たとえばカスタマーサポート。
AIに資料を調べさせ、文書を要約させ、返信の下書きを作らせる。それは問題ない。
しかし、AI自身に決めさせようとすると:このお金は本当に返金すべきか?このユーザーに補償すべきか?
企業は途端に慎重になる。
こうしたことは高等数学よりもはるかに簡単に見えるのに、なぜかえってAIに任せられないのか?
Diogoの答えはシンプルだ:Today's AI is incredible at assistance, not automation.
今日のAIは仕事を手伝うのは得意だが、まだ自分で仕事をやり遂げることはあまりできない。
この二つはほんの少ししか違わないように見えて、実際にはまったく異なる。
Claude Codeがどれほど強くても、あなたはたいてい still パソコンの前に座っている。それがコードを書けばあなたが見る。ファイルを修正すればあなたが確認する。間違えればあなたがまた直させる。
だからDiogoの見方では、Claude Codeは依然としてChatGPTが始めた「支援の時代」に属している。
本当の自動化とは何か?
人間がそもそもその場にいない。
AIがバックグラウンドで自分で判断し、自分で実行し、1日に数十万回、あるいは数百万回も動作し、あなたはそれが何をしたかすら永遠に目にしないかもしれない。
そこで問題が出てくる:なぜ今日のAIはこんなに賢いのに、どうしても人間から離れられないのか?
Diogoは矛先を、自分が非常によく知るあるものに向けた——RLHF。
私たちはAIを訓練するとき、人間をループの中に組み込んでしまった
これはいくぶん皮肉な話だ。
なぜならRLHFこそ、Diogoが当時推進した技術ルートの一つだったからだ。
RLHFの基本的なロジックは実は複雑ではない:人間の選好を収集し、モデルを人間の選好にますます合わせていく。
だからDiogoは講演で非常に率直な説明を与えた:なぜ今日の大規模モデルは常にループの中に人間を必要とするのか?
なぜなら、それを訓練するときに、私たちは文字通り人間をそのループの中に組み込んだからだ。
モデルは最初から学んでいる:どんな回答が人間に好まれるか?
これは、私たちがすでによく知っている大規模モデルのある特徴も説明する——たとえ知らなくても、しばしば非常にそれらしく語ることができる。
Diogoは会場でとても痛快な例を挙げた。
誰かがChatGPTに放屁の録音を送り、これは自分が創作した音楽だと伝え、「誠実で率直に」評価してほしいと頼んだ。
するとChatGPTは真面目に褒め始め、これはとても陰鬱で不気味な雰囲気のアンビエントミュージックだと述べた。
Diogoはさらに一言でまとめた:「Overpromising is a feature.」
過剰な約束はバグではなく、featureなのだ。
チャット製品にとっては、これは必ずしも致命的ではない。ユーザーはまだ画面の前にいて、間違えれば正せる。
しかし、真の自動化システムはまったく異なる。
マシンはあなたの回答が聞こえが良いかどうかなど気にしない。知る必要があるのは二つだけだ:一体どうすればいいのか、そしてあなたは一体どれほどの確信があるのか?
これもまた、一ヶ月余り後にリリースされたJevがこれほど異質に見える理由を説明している。
だから、JevはAIに「話させない」ことにした
普通の大規模モデルは、最終的に「AかBか」と答えるだけでも、しばしばTokenを生成するプロセスを経なければならない。
Jevはこの部分をばっさり削った。
それが現在主にやることは三つ:
- Noul、YesかNoかを答える;
- Choice、いくつかの選択肢から一つを選ぶ;
- Score、基準に従って採点する。
そして直接判断と確率を返す。
小論文を書いてくれることもなければ、雑談に付き合ってくれることもない。
公式発表によると、エンドツーエンドの遅延はわずか70〜500ミリ秒で、最先端モデルと比べて20〜200倍速く、価格は40〜400分の1だ。
しかし本当に重要なのは、実は「速さ」ではなく、後ろにあるあの確率だ。
そのために、TypeSafeは新しい訓練手法を提唱した:RLCD,Reinforcement Learning for Calibrated Decisions,キャリブレーション済み意思決定のための強化学習。
それが解決しようとしている問題は非常に現実的だ:もしAIがある事象が80%の確率で起こると言ったら、この80%は一体信じられるのか?
理想的には、モデルが80%の確率と判断した一群の事象は、最終的に約80%が本当に起こるべきだ。
これは自動化システムにおいて非常に重要だ。
99%の確信があれば、直接実行できる。
51%の確信なら、より強力で高価な大規模モデルに投げることもできるし、さらには人間に回すこともできる。
本当に厄介なのは、AIが知らないことではなく、AIが自分が知らないことを知らないことだ。
だからJevが本当に変えようとしているのは、AIが出力する対象だ。
これまでChatGPTが生成する答えは、主に人間に見せるためのものだった。Jevが与える判断と確率は、ソフトウェアに直接使わせるためのものだ。
Agentの時代に必要なのは、おそらくより大きな脳ではない
これもまた、なぜJevがよりによって今話題になったのかを説明している。
なぜならAgentが実際に動き出すと、膨大な小さな判断が生まれるからだ:
次にどのツールを呼び出すか?このウェブページのどのボタンをクリックすべきか?この情報はまだ役に立つか?タスクは本当に完了したか?結果を再確認すべきか?
これらの問題は一つ一つ見ればどれも難しくないが、一つのAgentは1日に数十万回、数百万回も判断する必要があるかもしれない。
もし毎回最強の大規模モデルを呼び出し、数秒かけて「熟考」し、さらに長いTokenを吐き出させれば、コストと遅延はすぐに跳ね上がる。
Jevが奪おうとしているのは、まさにこの層だ。
大量の高頻度な小さな決定はJevに任せ、本当に複雑な推論が必要なタスクは大規模モデルに任せる。
これもまた、なぜTypeSafeがJevを System One Modelと呼ぶかの理由だ。
この概念はダニエル・カーネマンの「システム1」と「システム2」に由来する:一つは速く直感的な判断を担い、もう一つは遅く複雑な思考を担う。
Jevはその名前すら「ジェヴォンズのパラドックス」に由来している:
ある資源がどんどん安くなると、人々は必ずしもその使用を減らさず、かえってより多く使うかもしれない。
もしAIを一度呼び出すのが高価なら、あなたはそれを最も重要な場所にしか使わないだろう。
しかし、もし一回のAI判断がほとんど無視できるほど安かったら?
一通のメール、一行のログ、一回のツール呼び出し、一つのウェブページのボタン、Agentが実行する各ステップに、それぞれ一回のAI判断が加わるかもしれない。
もちろん、今Jevが次世代AIを代表すると言うのはまだ早い。
いわゆる「ゼロハルシネーション」は、ほとんどが規定された回答タイプから外れてでたらめを言わないという意味であり、間違った選択をしないという意味ではない;193.6倍、444.6倍といった極端なデータも、主にTypeSafe自身のテストから来ている。
しかしJevが今回これほど話題になったことの本当に注目すべき点は、それがGPTやClaudeに挑戦できるかどうかではないかもしれない。
むしろ、ChatGPTを生み出すことに参与した一人の人間が、より根本的な問題を改めて問い直していることだ:
ここ数年、業界全体が考えてきたのは、どうすればAIにもっと長く考えさせ、もっと多く語らせられるかだった。
しかし、もし未来に本当に必要なのが数十億回のマシン間の判断なら、<





