


人工知能における Web3 の事例を調査する


モチベーションと課題
現在の人工知能の分野は、集中型、クローズドソース、寡占的なテクノロジー大手によって支配されています。モデルの開発と推論を容易にする極端な集中化の力により、最もパフォーマンスの高いモデルを少数の企業が管理しています。
機械学習モデルの作成には通常、事前トレーニング、微調整、推論という 3 つの主要な段階が含まれます。これらの段階は、新しい未知のデータをうまく一般化する、強力で正確なモデルを開発するために重要です。
トレーニング前の段階
事前トレーニング段階では、大規模な汎用データセットでモデルがトレーニングされます。このデータセットは、最終モデルが実行するタスクとは関連していませんが、モデルがさまざまな特徴やパターンを学習できるようにすることを目的としています。たとえば、言語モデルの場合、これには、大量のテキスト コーパスから言語構造、文法、広範な語彙を学習することが含まれる場合があります。ここでの目標は、テキスト、画像、その他の形式のデータなど、処理されるデータの基本構造をよく理解したモデルを開発することです。
トレーニング前の段階ではある程度の集中力が高まります。
データの収集と並べ替え - 事前トレーニング段階の鍵は、文献、デジタル記事、専門データベースなどのさまざまなソースから大規模なデータ セットを収集することです。 Google などの業界大手は、歴史的にユーザー生成コンテンツを活用して比類のない効率的なモデルを構築してきました。この慣行は現在も続いており、Microsoft や OpenAI などの企業は、独占的な提携や独自のプラットフォームを通じてトップレベルのデータへのアクセスを獲得しています。これらの機能が少数の企業に集中したことで、AI 業界の大幅な集中が生じました。
さらに、モデルのトレーニングに独自のデータセットに依存すると、重要な倫理的考慮事項が発生し、偏見が永続するリスクが生じます。 AI アルゴリズムは本質的に、基礎となるデータから動作パラダイムを導き出すため、簡単に埋め込み、複製できる固有のバイアスを作成します。この状況は、モデルが公正で意図的なパターンと関連付けを確実に反映するように、開発中に慎重なレビューと倫理的監視の必要性を浮き彫りにしています。
リソース要件 - モデルのパフォーマンスはトレーニング データの量に応じて対数的に増加することが確立されており、最も広範囲の GPU 計算サイクルから恩恵を受けるモデルが一般に最高のパフォーマンスを発揮することを示しています。このダイナミクスは、大手テクノロジー企業やデータ企業が享受している規模の経済と生産性の利点によって促進され、事前トレーニング段階で重要な集中化効果をもたらします。この傾向は、OpenAI、Google、Amazon、Microsoft、Meta といった業界大手の優位性からも明らかです。これらの企業は、世界のデータセンターの大部分を所有および運営しており、NVIDIA の最新かつ最先端のハードウェアにアクセスできます。
微調整フェーズ
モデルが事前トレーニングされた後、微調整が実行されます。この段階では、モデルはより小さなタスク固有のデータセットでさらにトレーニングされます。目的は、事前トレーニング中にモデルによって学習された重みと特徴を調整して、現在の特定のタスクにより適したものにすることです。これには、医学用語を理解できるように言語モデルを教育したり、鳥の異なる種を区別できるように画像認識モデルをトレーニングしたりすることが含まれる場合があります。
微調整フェーズにより、モデルはエンド ユーザーが関心のあるタスクに集中してパフォーマンスを向上させることができます。繰り返しになりますが、微調整フェーズではいくつかの集中的な取り組みが行われており、その中で最も重要なのはクローズドソース モデルと検証可能性です。
微調整フェーズでは、モデルのパラメータが調整および設定され、その機能とパフォーマンスが形成されます。現在、OpenAI の GPT ファミリや Google の Gemini などの独自の AI モデルが主流となっており、これらのモデルの内部動作やパラメーターは公開されていません。したがって、ユーザーが推論を要求した場合、その応答が実際に対話していると考えているモデルからのものであるかどうかを確認することはできません。
この透明性の欠如は、特に信頼性と検証可能性が重要な場合に、ユーザーに悪影響を与える可能性があります。たとえば、医療分野では、人工知能モデルは病気の診断や治療法の推奨に役立つ可能性がありますが、医師はモデル推論の出典と正確さを確認することができないため、不信感や誤診につながる可能性があります。 AI の推奨が最も信頼性の高い最新のモデルに基づいていると医療専門家が確信できない場合、その結果は患者のケアと転帰に直接影響を与える可能性があり、AI 導入における透明性と説明責任の重要性が強調されます。
推理段階
推論段階は、モデルが実際に適用される段階です。この時点で、モデルはトレーニングおよび微調整が完了し、新しいデータに対して予測を行う準備が整いました。 AI モデルの場合、これは質問に答えたり、言語を翻訳したり、推奨事項を提供したりすることを意味します。この段階は、トレーニングされたモデルが実際の問題に適用される段階であり、通常はモデルの価値が実現される段階です。
推論フェーズでは、集中化につながる要因は次のとおりです。
アクセス:AI モデルにアクセスするための一元化されたフロントエンドには、ユーザーが API や推論にアクセスできなくなる可能性があるリスクが伴う可能性があります。少数のエンティティがこれらのポータルを制御している場合、ポリシーの変更や紛争などのさまざまな理由で、その裁量で重要な AI サービスへのアクセスを拒否することができます。この一元化は、AI テクノロジーへのより広範かつ回復力のあるアクセスを確保し、検閲や不平等なアクセスのリスクを軽減するための分散型アプローチの必要性を浮き彫りにしています。
リソース要件:人工知能で推論を実行するコスト、特に大量のコンピューティング リソースを必要とするタスクのコストは、テクノロジー業界内で集中的に発生しています。推論コストが高いということは、高度な AI モデルを大規模に実行できるのは、多額の資金力を持つ大企業だけであることを意味します。この経済的障壁により、小規模な事業体や個人の開発者が最先端の AI テクノロジーを活用する可能性を最大限に発揮することが制限されます。
その結果、状況は少数の強力なプレーヤーによってますます支配され、競争とイノベーションが抑圧されています。この集中化は、AI 開発の多様性に影響を与えるだけでなく、AI の利点へのアクセスを資金豊富な少数の組織に制限し、テクノロジー エコシステムに重大な不均衡を生み出します。
集中型 AI 分野では、特に Web2 企業の進化に関して、いくつかの繰り返しのテーマが浮上しています。もともとオープンなネットワークとして設立されたこれらの企業は、多くの場合、株主価値の最大化に重点を置いています。この変化により、多くの場合、ネットワークをシャットダウンし、外部リンクをブロックするようにアルゴリズムを調整することになりますが、これは多くの場合、ユーザーの最善の利益に反します。
企業のインセンティブとユーザーのニーズのこのような不一致は、組織が成熟し、外部からの資金提供を受けるときによく発生します。人工知能の使用の民主化を目的とした非営利団体としてスタートした OpenAI でこの現象がすでに見られているという事実は、業界における焦点の変化がどのように現れるかを示しています。これらの個別の企業を責めるのは簡単ですが、これはテクノロジー業界内の集中力によって引き起こされるシステム的な問題を反映しており、多くの場合、企業のインセンティブと広範なユーザーのニーズの間の不一致につながると考えられます。
起こり得る未来: 人工知能と Web3
暗号通貨の世界は人工知能の基盤を提供し、情報と価値の交換をシームレス、オープン、そして安全なものにします。ブロックチェーン技術は、トランザクションの管理とデータの記録のための明確で追跡可能なシステムを提供します。暗号通貨と人工知能の交差点では、2 つの分野が相互に強化し、互いの機能から恩恵を受ける多くの機会が生まれます。
モチベーションの調整
分散コンピューティングは、モデル開発の事前トレーニング段階と微調整段階で役立ちます。基本モデルは多くの場合、大量の GPU コンピューティング サイクルを必要とし、これらのプロセスは通常、集中化されたデータ センターで実行されます。分散型物理インフラストラクチャ ネットワーク (DePIN) は、コンピューティングへの分散型の権限のないアクセスを提供できます。暗号通貨の経済的インセンティブにより、ソフトウェアは中央のガバナンス組織を必要とせずにハードウェアの使用量を自律的に補うことができます。これにより、ネットワークのユーザーはネットワークを制御し、インセンティブを調整し、データとモデルのプロバイダーに適切な報酬が支払われるようにすることができます。
検証可能性
現在の AI インフラストラクチャは独自のモデルに大きく偏っており、ユーザーは推論プロバイダーが指定されたモデルを通じてクエリを実行し、正当な出力を生成することを信頼する必要があります。この文脈において、ブロックチェーン上のモデル出力を検証するメカニズムを提供する暗号証明システムが主要なテクノロジーとして登場しました。このプロセスにより、ユーザーはクエリを送信できます。クエリは、合意されたモデルを使用して推論プロバイダーによって処理され、その後、暗号証明を含む出力が生成されます。この証明は、クエリが指定されたモデルによって実際に処理されたことを示す検証可能な証拠として機能します。
これらの取り組みの主な目標は、結果をオンチェーンで検証できるようにしながら、負荷の高い計算タスクをオフチェーン環境にオフロードすることです。このアプローチは、ブロックチェーン上の計算負荷を軽減するだけでなく、オフチェーン計算の正確さと完全性の不変の証明を提供することにより、透明性と信頼性の層を導入します。
これらの暗号証明を AI モデル検証プロセスに組み込むことで、クローズドソース AI システムに関連するいくつかの重要な問題が解決されます。これにより、不透明または未検証の計算のリスクが軽減され、計算プロセスの整合性が強化され、ユーザーと推論プロバイダーの間の信頼に基づく関係が促進されます。さらに、このアプローチは分散型で透明なシステムに向かう広範なトレンドと一致しており、ブロックチェーン技術の基本原則を反映しています。
構成可能性
分散型金融とブロックチェーン ネットワークの主な利点の 1 つは、それらが可能にする構成可能性です。構成可能性により、DeFi での「通貨レゴ」の広範な使用、つまり、さまざまなプロトコルと出力を組み合わせて新しいアプリケーションを作成することが可能になります。このモジュール性により、新しい形式のリスクがシステムに導入されますが、開発者にとってはアプリケーション開発が簡素化され、イノベーションと開発速度が向上し、よりシンプルなユーザー エクスペリエンスと利便性が提供されます。
暗号通貨が金融商品にコンポーザビリティを提供するのと同様に、他のモジュールとの相互接続を維持してネットワークを形成しながら、AI モジュールを構築して独立して動作できるパーミッションレスかつトラストレスなレイヤーとして機能することで、AI ネットワークとアプリケーションのコンポーザビリティも実現します。さまざまなサービスを提供できます。ブロックチェーン ネットワーク効果と暗号通貨を通じて、分散型人工知能プロジェクトとアプリケーションを相互に接続し、人工知能の全体的なアーキテクチャを完成させることができます。
たとえば、Akash または Filecoin の前処理データを使用して、Marlin、Gensyn、または Together を使用してモデルをトレーニングできます。微調整後、これらのトレーニング済みモデルは、Bittensor を通じてユーザーのクエリ (推論) に応答できます。より複雑に見えますが、エンド ユーザーは 1 つのフロント エンドと対話するだけで済み、開発者とアプリケーションはさまざまなスタックやアプリケーション上に構築することで恩恵を受けます。
分散型ネットワークによって可能になる構成性のもう 1 つの重要な側面は、データの構成性です。ユーザーは、自分が生成したデータを所有することへの関心が高まり、異なる AI プロトコル間でデータを転送できる機能を求めるようになり、データが閉じた環境に限定されないことを要求するようになります。分散型のオープンソース AI アプリケーションにより、データのポータブル化が可能になります。
データ保護
分散型コンピューティングを外部のデータおよびプライバシー ソリューションと組み合わせることで、ユーザーは自分のデータに対する自律性を高めることができ、集中型のコンピューティングよりも魅力的なオプションとなります。特に、完全準同型暗号化 (FHE) のような方法を使用すると、最初にデータを復号化することなく、暗号化されたデータに対して計算を実行できます。
FHE を使用すると、暗号化されたデータセットを使用して機械学習モデルをトレーニングできるため、トレーニング プロセス全体を通じてデータのプライバシーと安全性が保たれます。これにより、強力な暗号化が保証されたエンドツーエンドのセキュリティ ソリューションが提供され、エッジ ネットワークでのプライバシー保護モデルのトレーニングが可能になり、ユーザーのプライバシーを保護し、高度な AI 機能を活用する AI システムの開発が可能になります。
FHE の役割は、クラウド環境の暗号化されたデータ上で大規模な言語モデルを安全に実行することにまで及びます。これにより、ユーザーのプライバシーと機密情報が保護されるだけでなく、固有のプライバシーを備えたアプリケーションでモデルを実行する機能も強化されます。さまざまな分野、特に金融などの機密分野での人工知能の統合に伴い、潜在的な情報漏洩を防止できる完全準同型暗号化などのテクノロジーの必要性が重要になっています。
自動アップグレード機能
AI を使用すると、さまざまな変化や条件に基づいてスマート コントラクトを維持、更新、自動的にアップグレードできます。たとえば、AI をプロトコル側で使用して、リスクやその他の市場状況の変化に基づいてリスク パラメーターを調整することができます。一般的な例は為替市場です。現在、短期金融市場は外部組織や DAO の決定に依存して、融資資産のリスクパラメーターを調整しています。 AI エージェントは特定のパラメーターの更新とアップグレードを簡素化できます。これは、遅くて非効率な可能性がある人間や DAO 組織と比較して、大幅な改善となります。
分散型人工知能の課題
分散型 AI は、特に暗号化のオープンソースの性質と、AI のセキュリティ上の懸念および AI の計算ニーズとのバランスをとる際に、独自の一連の課題に直面しています。暗号化では、オープンソースはセキュリティを確保するために重要ですが、人工知能の分野では、モデルまたはそのトレーニング データを公開すると、敵対的な機械学習攻撃のリスクが高まります。これら 2 つのテクノロジーを使用したアプリケーションの開発には、大きな課題が伴います。さらに、人工知能ベースのアービトラージボット、予測市場、意思決定メカニズムなどのブロックチェーンにおける人工知能の応用は、公平性と操作の問題を引き起こします。 AI にはこれらの分野での効率と意思決定を向上させる可能性がありますが、AI が人間主導の市場ダイナミクスの微妙なニュアンスを完全に把握できず、意図しない結果を招くリスクがあります。
もう 1 つの懸念分野は、暗号アプリケーションのインターフェイスとして人工知能を使用することです。 AI はユーザーが暗号通貨の複雑な世界をナビゲートするのに役立ちますが、敵対的な入力の影響を受けやすくなったり、ユーザーが重要な決定を下すために AI に過度に依存したりするなどのリスクも伴います。さらに、DAO やスマート コントラクトなどのブロックチェーン アプリケーションのルールに人工知能を統合することにはリスクが伴います。敵対的機械学習は人工知能モデルの弱点を悪用し、結果が操作されたり不正確になったりする可能性があります。 AI モデルが正確で、ユーザーフレンドリーで、改ざんの影響を受けないことを保証することは、大きな課題です。
さらに、人工知能とゼロ知識証明やマルチパーティ計算を組み合わせると、計算量が多くなるだけでなく、高い計算コスト、メモリ制限、モデルの複雑さなどの障害にも直面します。ゼロ知識機械学習 (zkML) のツールとインフラストラクチャは現在まだ開発が不十分であり、この分野の熟練した開発者が不足しています。これらの要因により、消費者向け製品に適した規模で zkML を実装できるようになるまでに、かなりの量の作業が必要になります。
まとめ
特に AI が信頼できるハードウェアまたは特定のデータ ガバナンス モデルを使用する場合、ブロックチェーンの分散化の精神を維持し、AI システムの信頼性を確保しながら、分散化と信頼のバランスを取ることが特に重要です。この記事の次のパートでは、分散型 AI をサポートできるテクノロジーと、これを可能にする Marlin インフラストラクチャの重要な役割について詳しく説明します。
パート 2: 実装テクノロジーの概要
この記事の前の部分では、集中型 AI の欠点と、Web3 がこれらの問題をどのように軽減できるかを検討しました。ただし、ガス料金が非常に高いため、モデルをオンチェーンで実行することはできません。基礎となるブロックチェーンのコンピューティング能力を向上させようとすると、バリデーターのノード要件が増加し、小規模な家庭用バリデーターが直面する困難により分散化が低下する可能性があります。
次の章では、Web3 で人工知能をさらに開発するために必要ないくつかの一般的なツールとテクノロジ、つまりゼロ知識証明 (ZKP)、完全準同型暗号化 (FHE)、および信頼できる実行環境 (TEE) を紹介します。
ZKP と ZKML
ゼロ知識証明 (ZKP) は、スケーラビリティとプライバシー保護を向上させることができるため、人工知能と Web3 にとって特に重要です。これにより、オフチェーンで計算を実行してからオンチェーンで検証 (検証計算) できるようになり、ブロックチェーンのすべてのノードで計算を再実行するよりもはるかに効率的となり、ネットワークの負荷が軽減され、より複雑な操作が可能になります。 zkML を使用すると、AI モデルをオンチェーン環境で実行できます。これにより、これらのオフチェーン計算の出力が信頼され、検証されることが保証されます。
さらに、zkML は、特定のモデルが予測に使用されたことや、モデルが特定のデータセットでトレーニングされたことの確認など、機械学習プロセスの特定の側面を検証できます。 zkML は、計算プロセスの検証にも使用できます。たとえば、コンピューティング プロバイダーは、検証可能な証拠を通じて、正しいモデルを使用してデータを処理したことを証明できます。これは、Akash などの分散コンピューティング プロバイダーに依存し、計算の精度と整合性を確保したい開発者にとって特に重要です。
zkML は、データに対してモデルを実行する必要があるが、データを非公開にしたいユーザーにも役立ちます。データのプライバシーを損なうことなく、独自のデータに対してモデルを実行し、証明を生成し、その後、正しいモデルの使用を検証できます。
FHE
前述したように、完全準同型暗号化 (FHE) を使用すると、暗号化されたデータを復号化することなく、暗号化されたデータに対して直接計算を実行できます。このテクノロジーは、人工知能の分野、特に機械学習と機密データ処理において重要な用途があります。
FHE の主な用途の 1 つは、暗号化されたデータセットを使用した機械学習モデルのトレーニングです。このアプローチにより、トレーニング プロセス全体を通じてデータが暗号化され、安全な状態が保たれます。その結果、FHE は、機械学習プロセスの最初から最後までデータのプライベートを保つ包括的なセキュリティ ソリューションを提供します。これは、データのセキュリティとプライバシーが重要であり、コンピューティング リソースが集中型データセンターよりも制限されていることが多いエッジ ネットワークでは特に重要です。
完全準同型暗号化技術を使用すると、人工知能の高度な機能を最大限に活用しながら、ユーザーのプライバシーを保護するシステムを開発できます。完全準同型暗号化 (FHE) は、保管中および処理中にデータが暗号化されたままであることを保証することで、不正アクセスやデータ漏洩に対する強力な暗号化保証を提供します。これは、医療アプリケーションの個人データや機密の財務記録など、機密情報が扱われるシナリオでは特に重要です。
完全準同型暗号化 (FHE) は、その有用性をクラウド環境での大規模な言語モデルの実行に拡張します。これらのモデルが暗号化されたデータを処理できるようにすることで、完全準同型暗号化 (FHE) によってユーザーのプライバシーと機密情報が確実に保護されます。クラウド環境に導入される AI アプリケーションが増え、データ セキュリティが重要な問題になるにつれて、この機能はますます重要になります。暗号化されたデータ上でモデルを安全に実行できるため、法律、医療、金融業界など、厳密な機密保持が必要な分野での AI の適用可能性が高まります。
完全準同型暗号化 (FHE) は、潜在的な情報漏洩や不正アクセスから機密データを保護するという重要なニーズに対応します。データ プライバシーが単なる好みではなく規制要件である分野では、完全準同型暗号化 (FHE) は、データ セキュリティとコンプライアンス基準を損なうことなく人工知能を活用する方法を提供します。
TEE
信頼できる実行環境 (TEE) は、人工知能推論のトレーニングと実行において、特にセキュリティの保証、分離、データのプライバシーと保護の点で大きな利点があります。 TEE は安全な分離環境として機能するため、データと計算に強力なセキュリティと整合性を提供します。
まず大きなメリットは、安全性とセキュリティの確保が強化されることです。 TEE は、オペレーティング システム カーネル、デバイス ドライバー、ライブラリなどの広範なトラステッド コンピューティング ベース (TCB) を備えたシステムの脆弱性に対処するように特別に設計されています。これらのコンポーネントは、攻撃対象領域が大きいため、より脆弱になります。 TEE は、安全な実行環境を提供することで、ホスト オペレーティング システムが侵害された場合でも、重要なアプリケーションを保護し、コンパートメント内のソフトウェアの整合性と機密性を維持します。
もう 1 つの重要な利点は分離です。隔離内では、コードとデータは安全に保存され、隔離内のコードからのみアクセスできます。この設計により、他の仮想マシンやハイパーモニターなどからの外部アクセスが防止され、他の仮想マシンからの物理的な攻撃や脅威から保護されます。
TEE (信頼された実行環境) は、ソフトウェアが実際の TEE 内で実行されていることを検証するリモート検証プロセスを容易にします。この機能は、非武装地帯内で実行されるソフトウェアの信頼性と完全性を保証するために重要です。これにより、リモート エンティティと信頼できる実行環境の間に信頼が確立され、ソフトウェアとその実行環境が安全で改ざんされていないことが保証されます。
最後に、TEE はデータ保護にも優れています。 TEE のハードウェア実装セキュリティ機能は、計算の機密性と完全性を保護します。これには、コードとデータ (キーなど) を隔離場所に安全に配信することが含まれます。 TEE はまた、計算結果と出力を取得するための信頼できる通信チャネルを確立し、エンクレーブ内のライフサイクル全体を通じてデータの安全性を確保します。これらの特性により、TEE は、特に高レベルのセキュリティとデータ整合性を必要とするアプリケーションにおいて、AI のトレーニングと AI 推論の実行に理想的な環境となります。
Marlin Oyster
Marlin Oyster は、開発者がカスタム コンピューティング タスクを展開したり、信頼できる実行環境を提供したりするためのオープン プラットフォームです。 Intel の SGX や AWS の Nitro Enclaves に似ています。 Oyster を使用すると、開発者は隔離された環境でコードを実行し、ホストやその環境内の他のアプリケーションが信頼できる実行環境の計算の整合性を変更できないようにすることができます。 Trusted Execution Environment (TEE) によって提供される計算上の整合性と機密性の保証に加えて、オイスター プラットフォームには追加の利点もあります。
稼働時間:Oyster は、ダウンタイムにペナルティを課し、タスクを正常なノードに再分散する監視プロトコルを通じてアプリケーションの可用性を確保します。このメカニズムにより、Oyster にデプロイする開発者は、継続的なアプリケーション機能と活力をエンドユーザーに提供できるようになります。
サーバーレス:AWS Lambda と同様に、Oyster のサーバーレス フレームワークを使用すると、開発者は特定のノードを専用にリースすることなくアプリケーションをデプロイできます。開発者は、アプリケーションの実行時間に対してのみ料金を支払うことでコストを節約し、管理オーバーヘッドを削減します。
通信網:オイスター ゲットーには、ゲットー内で安全な TLS 接続の確立を容易にするネットワーク機能が事前構成されています。この機能により、公開されたエンドポイントを使用してサービス上で外部 API クエリと操作を実行できるようになり、アプリケーションとインターネットの統合が強化されます。
リレー:Oyster は、リレー コントラクトを通じて処理するために、計算集約型のタスクをオフチェーン環境に転送することをサポートします。これらのスマート コントラクトにより、Oyster 上で機能を実行できるようになり、信頼性の高い結果とイベントベースの応答が確保され、オンチェーン リソースの使用が最適化されます。
基準
zkML フレームワークと TEE ML (Oyster) のベンチマーク比較では、パフォーマンス メトリックは Oyster の方が効率的であることを示しています。具体的には、Oyster フレームワークは、テストされたすべての機械学習モデルにわたって合計計算時間が大幅に短縮されています。

Iris データの通常の最小二乗モデルの場合、zkML フレームワーク (RisQ) は証明と検証に 32 秒以上かかりますが、Oyster ではタスクの完了にわずか 0.047 秒しかかかりません。同様に、同じデータセットで、zkML (EZKL フレームワーク) を使用したニューラル ネットワークの 500 入力の合計時間は 212 秒を超えましたが、Oyster ではわずか 0.045 秒しかかかりませんでした。この処理時間の大きな違いは、このような状況では Oyster の方が効率的であることを示唆しています。
MNIST データセットでは、LeNet モデルがこの観察をさらに深めます。 EZKL の zkML フレームワークの検証と証明には 60 秒かかりますが、Oyster の所要時間はわずか 0.056 秒です。 DDKang の zkML フレームワークのパフォーマンスは EZKL よりも優れており、合計時間は約 3.33 秒ですが、それでも Oyster の 0.056 秒ほどではありません。
全体として、データは、テストされた zkML フレームワークと比較して、Oyster が機械学習タスクに対してより効率的なソリューションを提供することを示しています。計算時間の高速化は、提示されたベンチマークに関して、Oyster が同じタスクを大幅に短い処理時間で処理できることを示しており、効率と速度の点で有利です。
検証可能な分散型 AI を広く導入するには、オフチェーン暗号検証システムが、通常の最小二乗計算などの単純なタスクの実行を超えたものでなければなりません。必要な主な進歩は、より複雑なタスクを処理する能力、特に、一般的な LLM を通じてプロンプトを効率的に実行する能力です。これには、現代の LLM の複雑でリソース集約型のニーズに対処するためのコンピューティング能力、アルゴリズムの効率性、スケーラビリティの向上が必要であり、分散型フレームワーク内でより複雑で多様な AI アプリケーションが可能になります。 zkML フレームワークはまだ初期段階にあり、zk 証明の生成は計算量が多いタスクであるため、現段階ではこれらのキューを処理する能力が大幅に妨げられています。
zkML プロトコルが LLM を処理することは示されていませんが、Oyster の信頼された TEE とこれらの zkML フレームワークとの間の処理時間の差は、少なくとも前述の例と同じくらい大きいと想定するのが妥当です。 Marlins Oyster を使用すると、さまざまな LLM のベンチマーク結果を確立できます。
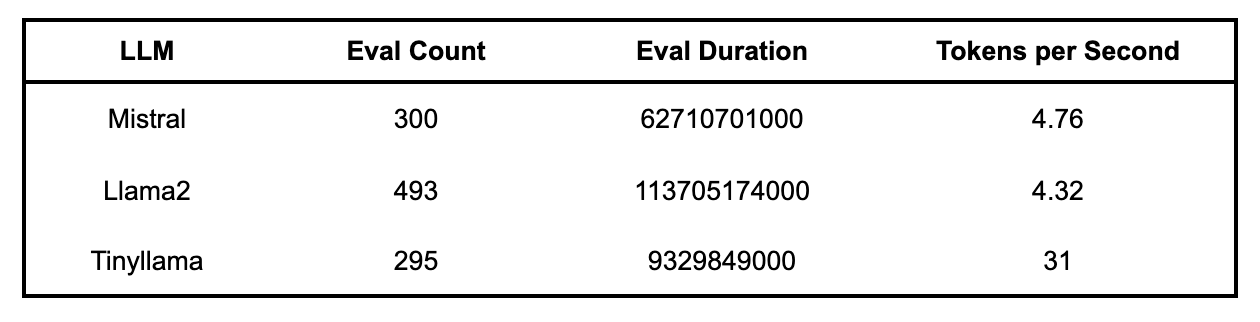
評価数: 応答内のトークンの数、評価期間: 応答の生成にかかったナノ秒
Oyster 内での GPT2-XL ベンチマーク結果:
隔離構成: 12 CPU、28 GB メモリ (c6a.4xlarge)
ヒント: イーサリアムはコミュニティが運営するテクノロジーです
結果: 「イーサリアムは、インターネットの機能を可能にするコミュニティが運営するテクノロジーです。Linux がコンピューターにもたらしたように、イーサリアムは将来にわたってインターネットに力を与えるでしょう。」
出力の生成にかかる時間: 22.091819524765015 秒
1 秒あたりのマーク数: 1.6295624703815754 秒
パート 2: 結論
AI テクノロジーの開発と配布は、高度なハードウェアと洗練されたモデルを備えた少数の大企業によってますます支配されています。このレベルの集中は、検閲、固有のバイアス、AI システムの完全性と公平性の検証に関する懸念を引き起こします。対照的に、暗号通貨の基本原則、つまりパーミッションレスで検閲に耐性があることは、AI テクノロジーの民主化への道を提供します。
ブロックチェーン技術の分散型かつオープンソースの性質により、分散型人工知能は集中型の敵と競争することができます。これは、DePIN、暗号化証明、公開キーと秘密キーの等価性メカニズムの使用によって実現され、これらの組み合わせにより AI の安全、透明性、公正な開発と使用が保証されます。特にブロックチェーン エコシステムにおいて、分散型人工知能の可能性を最大限に発揮するには、堅牢なオフチェーン コンピューティング インフラストラクチャが必要です。これは、複雑な AI タスクを効率的、正確かつ検証可能に処理するために重要です。
現在、信頼できる実行環境 (TEE) が、この要件を満たす最も実現可能なソリューションとして浮上しています。 TEE は、コードに安全で隔離された実行スペースを提供し、処理されるデータの機密性と整合性を保護します。このため、AI アプリケーションのブロックチェーンで必要なオフチェーン コンピューティングに最適な選択肢となります。この分野が進化するにつれ、分散型 AI エコシステムが現在の制限を克服するには、zkML、FHE などのテクノロジーの進歩、および信頼できる実行環境 (TEE) の機能強化が不可欠になります。この開発は、仮想通貨コミュニティの分散化の哲学と一致して、人工知能のよりオープンでアクセスしやすく安全な分野を促進します。





