


Cuộc cách mạng GPU: Cách chúng tôi làm cho Ethereum nhanh hơn 1.000 lần với Zero-Knowledge Proofs


Bài viết này sẽ phân tích một bước đột phá công nghệ quan trọng: thông qua sự kết hợp giữa GPU hiệu suất cao và bằng chứng không kiến thức, chúng tôi đang tăng hiệu quả hoạt động của Ethereum lên hàng trăm hoặc thậm chí hàng nghìn lần. Điều này không chỉ giải quyết được tình trạng tắc nghẽn hiệu suất lâu nay của blockchain mà còn cung cấp một lộ trình kỹ thuật khả thi cho cơ sở hạ tầng Web3 trong tương lai.
Nếu bạn từng thắc mắc: Tại sao Ethereum lại chậm đến vậy và chi phí giao dịch lại cao đến vậy? Hay bạn đang tập trung vào các động lực chính của công nghệ blockchain thế hệ tiếp theo? Vâng, bài viết này sẽ cung cấp cho bạn câu trả lời rõ ràng.
Bản chất của vấn đề: Tại sao blockchain lại giống như đường cao tốc bị tắc đường?
Hãy nghĩ về Ethereum như một đường cao tốc. Ngày nay, tất cả người dùng và ứng dụng đều cạnh tranh để giành tài nguyên đường truyền hạn chế, dẫn đến tình trạng tắc nghẽn mạng, xử lý giao dịch chậm và phí gas cao.
Chỉ có hai giải pháp truyền thống:
Xây dựng nhiều làn đường hơn — nghĩa là xây dựng mạng Lớp 2 (như Rollup)
Làm cho xe nhỏ hơn — tức là nén dữ liệu giao dịch
Nhưng nếu có cách nào đó để "dịch chuyển tức thời" một chiếc xe thay vì tiếp tục chen vào làn đường thì sao? Đây chính là sự thay đổi mô hình được mang lại bởi Zero-Knowledge Proofs (ZKP). Ý tưởng cốt lõi của nó là tính xác thực của giao dịch có thể được xác minh bằng cách tạo ra bằng chứng toán học mà không cần truyền tải toàn bộ dữ liệu giao dịch. Nói cách khác, chúng ta không còn cần phải để mọi chiếc xe chạy qua đường cao tốc nữa mà có thể trực tiếp xác minh rằng "những chiếc xe này thực sự đã đến đích". Điều này không chỉ giảm bớt gánh nặng truyền dữ liệu mà còn tạo nên sự tương thích "thông lượng cao + bảo mật mạnh mẽ + xác minh không cần tin cậy".
The Verge: Sự tiến hóa tiếp theo của Ethereum
Ethereum hiện đang phát triển một bản thiết kế công nghệ lớn - The Verge, mà bạn có thể hiểu là "kế hoạch thu gọn" của Ethereum. Mục tiêu là giảm đáng kể ngưỡng chạy một nút Ethereum, khiến việc này trở nên dễ dàng như chạy một ứng dụng trên điện thoại di động. Trong tương lai, mọi người sẽ có thể dễ dàng tham gia mạng lưới Ethereum mà không cần phải dựa vào máy tính chơi game hiệu suất cao.
Nhưng có một thách thức kỹ thuật quan trọng đằng sau kế hoạch này: nó đòi hỏi phải hoàn thành hàng triệu phép tính toán học phức tạp trong một thời gian rất ngắn.
Đây chính xác là hướng đột phá mà nhóm Polyhedra đang tập trung vào - cách sử dụng GPU để tăng tốc các phép tính ZK quy mô lớn và cải thiện đáng kể hiệu quả thực hiện trong khi vẫn đảm bảo tính bảo mật khi xác minh.
Thách thức kỹ thuật: Bộ dữ liệu này sẽ làm đảo lộn nhận thức của bạn
Để hiểu được mức độ phức tạp mà chúng ta đang phải đối mặt, sau đây là quy mô thực sự của các hoạt động trên chuỗi hiện tại của Ethereum:
Xác minh sự đồng thuận:
Mỗi khối chứa khoảng 90 triệu phép tính băm SHA 2-256 và 2.048 xác minh chữ ký số BLS.Bằng chứng chuyển đổi trạng thái:
Mỗi khối cần khoảng 500.000 phép băm KeccakNhững nút thắt hiện tại:
Các trình chứng minh không kiến thức dựa trên CPU (Prover) hiện chỉ có thể xử lý khoảng 2 triệu phép tính băm Poseidon mỗi giây
Thách thức thực sự là chúng ta cần sử dụng công nghệ chứng minh không kiến thức để hoàn thành tất cả các hoạt động trên, điều này chắc chắn sẽ làm tăng đáng kể độ phức tạp về mặt tính toán.
Điểm đột phá: Cuộc cách mạng điện toán GPU
Như chúng ta đã biết, GPU là lựa chọn ưa thích của các game thủ và kỹ sư AI. Nhưng trên thực tế, các bộ xử lý đồ họa này đã chứng minh khả năng vượt trội hơn nhiều so với CPU khi xử lý các phép tính toán học song song hàng loạt cần thiết cho các bằng chứng không kiến thức.
Tại Polyhedra, chúng tôi đã tối ưu hóa hệ thống chứng minh ZK dành riêng cho GPU và đạt được hiệu suất đột phá:
Hiệu suất nhảy vọt, vượt xa mong đợi
Các phép toán cơ bản (Mersenne 31 trường) nhanh hơn 362 lần
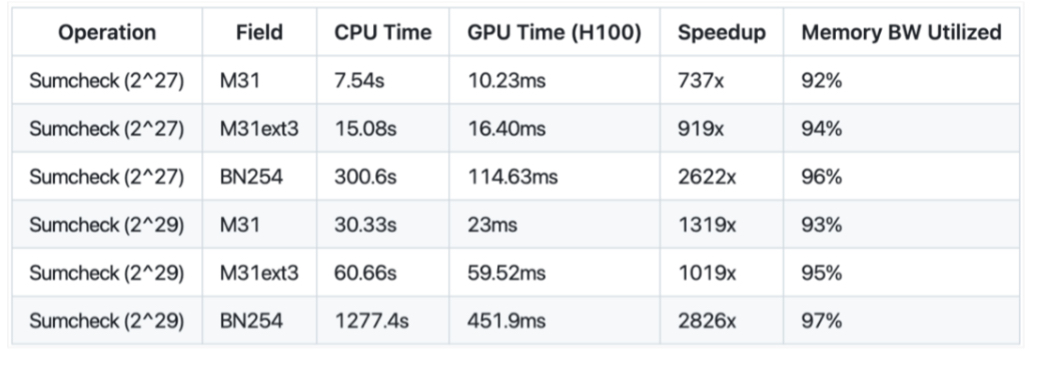
Các hoạt động mã hóa phức tạp (đường cong elip BN 254) được tăng tốc lên tới 2826 lần
Một phép tính không cần kiến thức ban đầu mất 21 phút giờ đã được nén lại chỉ còn 450 mili giây
Nói cách khác, điều này tương đương với việc thời gian đi làm hàng ngày của bạn vào giờ cao điểm được rút ngắn từ 20 phút xuống còn chưa đầy nửa giây. Đây không phải là sự tối ưu hóa gia tăng mà là bước nhảy vọt về mặt tính toán ở cấp độ mô hình.
Tại sao bước đột phá này lại quan trọng với bạn?
Chi phí giao dịch thấp hơn: Việc tạo bằng chứng nhanh hơn có nghĩa là giảm đáng kể tổng chi phí tính toán, dẫn đến phí gas thấp hơn. Giải pháp đôi bên cùng có lợi cho người dùng và mạng lưới.
Đảm bảo an ninh chặt chẽ hơn: Bạn còn nhớ khi chúng tôi đề cập rằng ngân sách an ninh hàng năm của Ethereum vượt quá 40 triệu đô la không? Với công nghệ của chúng tôi, các nút ánh sáng cũng có thể dễ dàng xác minh toàn bộ chuỗi đồng thuận Ethereum và tận hưởng tính bảo mật cấp độ mạng chính mà không cần tốn nhiều tài nguyên.
Hoạt động nút phổ biến hơn, điện thoại di động cũng có thể chạy Ethereum: Việc tối ưu hóa liên tục về hiệu suất và hiệu quả của chúng tôi giúp có thể chạy các nút Ethereum trên các thiết bị thông thường. Trong tương lai, việc xác minh dữ liệu blockchain có thể chỉ cần một chiếc điện thoại di động.
Lõi kỹ thuật: Chúng tôi thực hiện như thế nào
1. Thiết kế GPU gốc: Giao thức Sumcheck được tối ưu hóa CUDA
Việc triển khai Sumcheck của chúng tôi dựa trên CUDA khai thác đầy đủ những lợi thế về tính toán song song của GPU:
Thiết kế các hạt nhân CUDA tùy chỉnh cho các phép toán trường số (cộng, nhân, lũy thừa)
Tối đa hóa việc sử dụng băng thông GPU bằng cách sử dụng chế độ truy cập bộ nhớ hợp nhất (băng thông đo được của RTX 4090 lên tới 1008 GB/giây)
Sử dụng các nguyên mẫu cấp độ cong vênh để đạt được các hoạt động giảm hiệu quả (Giảm)
Mức độ tùy chỉnh sâu này cho phép giao thức Sumcheck không còn bị giới hạn bởi tình trạng tắc nghẽn tuần tự của CPU.
2. Bộ nhớ là vua: tối ưu hóa tình trạng tắc nghẽn băng thông Quan điểm truyền thống cho rằng tình trạng tắc nghẽn điện toán của ZK Prover nằm ở sức mạnh tính toán, nhưng bằng chứng thực nghiệm của chúng tôi cho thấy Sumcheck là một vấn đề tắc nghẽn băng thông bộ nhớ điển hình:
Phân tích thông lượng bộ nhớ: Sử dụng băng thông đạt 95%+ giới hạn trên lý thuyết
Tối ưu hóa cấu trúc dữ liệu: Sử dụng Cấu trúc mảng (SoA) để thay thế cấu trúc Mảng (AoS) truyền thống
Cải thiện việc sử dụng đơn vị SM: Cấu hình khối luồng được tối ưu hóa để đạt được việc sử dụng phần cứng tối ưu
Bằng cách giải quyết vấn đề thông lượng bộ nhớ, chúng tôi đã biến điện toán ZK thành một tác vụ phát trực tuyến thực sự hiệu quả.
3. Chiến lược tối ưu hóa tùy chỉnh cho các miền số khác nhau
Các trường mật mã khác nhau có đặc điểm hoạt động khác nhau. Chúng tôi đã thiết kế các lộ trình tối ưu hóa riêng cho từng lĩnh vực chính:
Mersenne 31 (M 31): Tối ưu hóa số nguyên 31 bit, cấu trúc số học mô-đun hiệu quả
M 31 ext 3: Hỗ trợ trường mở rộng, tính đến việc mở rộng đa thức và chi phí thấp
BN 254: Bộ nhân tùy chỉnh dựa trên thuật toán Montgomery, được thiết kế cho các trường số nguyên lớn 254 bit
Sự tối ưu hóa cơ bản có mục tiêu cao này giúp cho ZK Prover của chúng tôi vừa linh hoạt vừa cực kỳ hiệu quả.
Phân tích dữ liệu hiệu suất: Nơi diễn ra quá trình tối ưu hóa
Chúng tôi không chỉ làm cho nó "nhanh hơn rất nhiều" mà còn đưa hiệu suất của ZK lên tầm cao chưa từng có. Sau đây là dữ liệu hiệu suất được đo lường:
Kiến trúc kỹ thuật được tiết lộ: sự thật ẩn sau lớp vỏ bọc
GKR Protocol Stack: Cốt lõi của sự tăng tốc
Quá trình tối ưu hóa tăng tốc của chúng tôi tập trung vào giao thức GKR (Goldwasser-Kalai-Rothblum), bao gồm:
Lớp GKR tuyến tính: được sử dụng để xử lý các cổng cộng và nhân
Giao thức Sumcheck: nút thắt hiệu suất, chiếm gần 50% tổng thời gian tính toán của CPU
Giai đoạn đánh giá đa thức: Giảm thời gian tính toán từ 8,4 giây xuống 9,5 mili giây trên GPU
Giải thích chi tiết về thiết kế lõi GPU
Giai đoạn 1: Đánh giá đa thức
Tính toán song song trên 2^n điểm
Sử dụng bộ nhớ đệm chia sẻ để cải thiện tốc độ truy cập
Các hoạt động giảm hiệu quả với warp shuffle
Giai đoạn 2: Tạo thách thức
Thực hiện các hoạt động băm Fiat-Shamir bên trong GPU để tránh việc chuyển đổi CPU-GPU thường xuyên
Giảm độ trễ giao tiếp giữa CPU và GPU
Tối ưu hóa truyền tải bộ nhớ: mở ra "dặm cuối" của luồng dữ liệu
Chúng tôi cũng đã thực hiện tối ưu hóa có hệ thống trong tương tác CPU-GPU để đảm bảo băng thông không phải là nút thắt cổ chai:
Tối ưu hóa thông lượng dữ liệu PCIe: xử lý 2^{27} phần tử chỉ trong 737 mili giây
Bộ nhớ ghim: Hỗ trợ truyền dữ liệu "không sao chép", giảm chi phí sao chép
Lên lịch hoạt động không đồng bộ: Tính toán và giao tiếp được thực hiện song song để tối đa hóa việc sử dụng tài nguyên
Hãy thành thật mà nói: Thách thức vẫn còn tồn tại
Chúng tôi luôn nhấn mạnh vào tính minh bạch - tăng tốc GPU không phải là giải pháp hoàn hảo. Trong quá trình quảng bá thực tế, chúng tôi cũng gặp phải nhiều trở ngại về mặt kỹ thuật:
1. Băng thông bộ nhớ đã đạt đỉnh
Mặc dù H100 có băng thông lên tới 3,35 TB/giây nhưng nó sẽ trở thành điểm nghẽn hiệu suất khi tải cao.
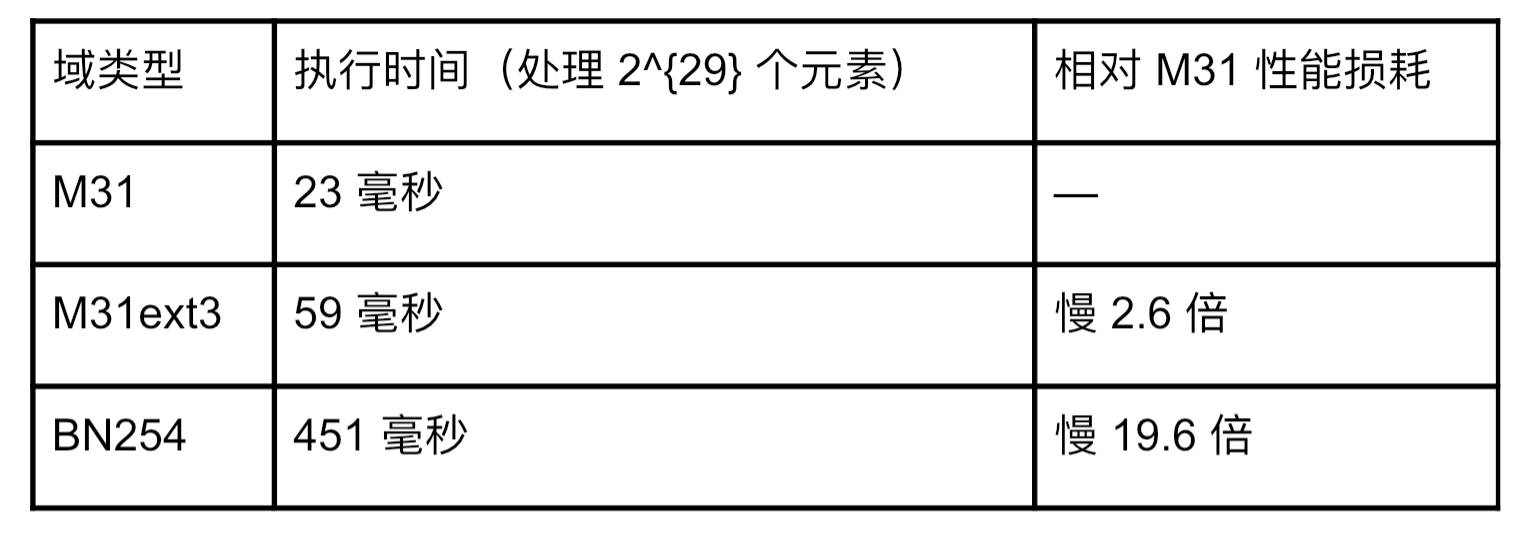
Ngược lại, các miền đường cong elip lớn hơn (như BN 254) đạt đến đỉnh sớm hơn các miền nhỏ (như M 31).
2. Dung lượng bộ nhớ GPU bị hạn chế
RTX 4090 hết bộ nhớ khi xử lý 2^{29} phần tử
Cần có một chiến lược lập lịch bộ nhớ tinh vi trong quá trình triển khai thực tế để tránh rủi ro tràn bộ nhớ
3. Sự cân bằng giữa kích thước miền và hiệu suất
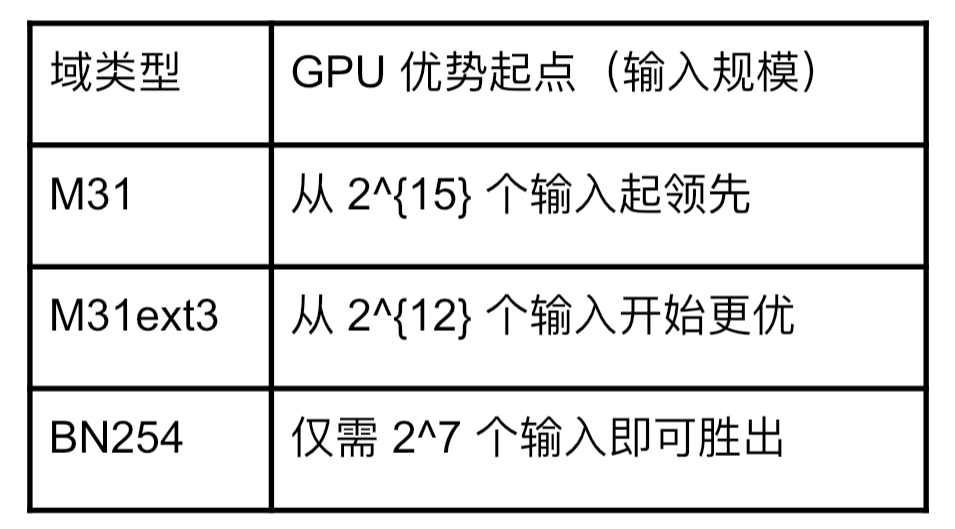
4. So sánh “Ưu điểm của GPU”: Khi nào GPU bắt đầu vượt qua CPU?
Kiểm tra hiệu suất đa nền tảng
Chúng tôi đã thực hiện đánh giá chuẩn trên các loại GPU khác nhau, bao gồm cả phần cứng cấp tiêu dùng và trung tâm dữ liệu:
GPU tiêu dùng
RTX 3090: Băng thông bộ nhớ 936 GB/giây, cải thiện hiệu suất lên tới 951 lần
RTX 4090: Băng thông bộ nhớ 1008 GB/giây, cải thiện hiệu suất lên tới 1565 lần
GPU trung tâm dữ liệu
NVIDIA H100: Băng thông lên đến 3,35 TB/giây và cải thiện hiệu suất lên đến 2826 lần
Kết luận rất rõ ràng: băng thông bộ nhớ là biến số quan trọng trong việc tăng tốc độ xác minh không cần kiến thức.
Nhìn về phía trước: lộ trình của chúng tôi
Chúng tôi không dừng lại và sẽ tiếp tục giải quyết các mục tiêu sau:
Tăng tốc độ cực đại hơn: Mục tiêu tăng tốc độ 10.000 lần cho một số hoạt động nhất định
Khả năng tương thích phần cứng rộng hơn: từ card đồ họa chơi game hiệu suất cao đến card tăng tốc cấp trung tâm dữ liệu
Tích hợp Ethereum gốc: Chúng tôi đang làm việc với các nhóm phát triển máy khách Ethereum để tích hợp ngăn xếp bằng chứng GPU ZK của chúng tôi trực tiếp vào lớp L1
Hãy tham gia làn sóng thay đổi này!
Đây không chỉ là sự gia tăng về tốc độ mà còn là sự thay đổi hoàn toàn về khả năng tiếp cận blockchain. Dù bạn là ai, bạn cũng có thể tìm cách tham gia:
Các nhà phát triển: Hãy xem kho lưu trữ Expander và CUDA của chúng tôi để cùng nhau xây dựng tương lai
Người học: Theo dõi các hội thảo nghiên cứu và tìm hiểu sâu về công nghệ của chúng tôi để cập nhật thông tin
Mọi người hãy phổ biến công nghệ này! Càng nhiều người hiểu, tương lai của Web3 càng gần
Xem xét các ý tưởng cốt lõi
Chúng ta đang ở thời điểm chuyển giao công nghệ đầy thú vị. Sự kết hợp giữa bằng chứng không kiến thức và khả năng tăng tốc GPU không chỉ cải thiện đáng kể hiệu suất mà còn là sự thay đổi lớn.
Chúng tôi đang xác định lại ranh giới về tốc độ, chi phí và khả năng sử dụng của Ethereum.
Danh sách các thành tựu công nghệ quan trọng:
Bằng chứng ZK cho môi trường sản xuất tăng tốc hơn 1.000 lần
Sử dụng băng thông bộ nhớ GPU vượt quá 95%
Triển khai mã nguồn mở, sẵn sàng tích hợp
Tương lai của Web3 không chỉ phi tập trung mà còn cực kỳ nhanh chóng và đến nhanh hơn bạn nghĩ.
Bạn hào hứng nhất về điều gì trong những diễn biến này? Hãy thoải mái để lại bình luận hoặc trò chuyện với tôi trên Twitter, chúng tôi rất muốn thảo luận sâu hơn về các chi tiết kỹ thuật này!
Tương lai thuộc về tốc độ và cũng thuộc về bạn. Hẹn gặp lại lần sau, hãy tiếp tục xây dựng, không chỉ là nhanh hơn!





