


สำรวจกรณี Web3 ในด้านปัญญาประดิษฐ์


แรงจูงใจและความท้าทาย
สาขาปัญญาประดิษฐ์ในปัจจุบันถูกครอบงำโดยยักษ์ใหญ่ด้านเทคโนโลยีแบบรวมศูนย์ แหล่งปิด และผู้ค้าน้อยราย บริษัทจำนวนไม่มากควบคุมโมเดลที่มีประสิทธิภาพสูงสุด ส่วนใหญ่เนื่องมาจากพลังของการรวมศูนย์ระดับสูงสุดที่เอื้อต่อการพัฒนาโมเดลและการอนุมาน
โดยทั่วไปแล้ว การสร้างโมเดลแมชชีนเลิร์นนิงจะเกี่ยวข้องกับสามขั้นตอนหลัก ได้แก่ การฝึกอบรมล่วงหน้า การปรับแต่งอย่างละเอียด และการอนุมาน ขั้นตอนเหล่านี้มีความสำคัญอย่างยิ่งต่อการพัฒนาแบบจำลองที่แข็งแกร่งและแม่นยำซึ่งสามารถสรุปข้อมูลใหม่ที่มองไม่เห็นได้เป็นอย่างดี
ขั้นตอนก่อนการฝึกอบรม
ในขั้นตอนก่อนการฝึกอบรม โมเดลจะได้รับการฝึกบนชุดข้อมูลขนาดใหญ่สำหรับวัตถุประสงค์ทั่วไป ชุดข้อมูลนี้ไม่เกี่ยวข้องกับงานที่โมเดลขั้นสุดท้ายจะดำเนินการ แต่มีวัตถุประสงค์เพื่อช่วยให้โมเดลเรียนรู้คุณสมบัติและรูปแบบต่างๆ ตัวอย่างเช่น ในกรณีของแบบจำลองภาษา สิ่งนี้อาจเกี่ยวข้องกับการเรียนรู้โครงสร้างภาษา ไวยากรณ์ และคำศัพท์ที่กว้างขวางจากกลุ่มข้อความขนาดใหญ่ เป้าหมายคือการพัฒนาแบบจำลองที่มีความเข้าใจโครงสร้างพื้นฐานของข้อมูลที่จะประมวลผลเป็นอย่างดี ไม่ว่าจะเป็นข้อความ รูปภาพ หรือข้อมูลในรูปแบบอื่นๆ
มีสมาธิบ้างในช่วงก่อนการฝึก:
การรวบรวมและการเรียงลำดับข้อมูล - กุญแจสำคัญในขั้นตอนก่อนการฝึกอบรมคือการรวบรวมชุดข้อมูลขนาดใหญ่จากแหล่งข้อมูลที่หลากหลาย รวมถึงวรรณกรรม บทความดิจิทัล และฐานข้อมูลทางวิชาชีพ ยักษ์ใหญ่ในอุตสาหกรรมอย่าง Google ใช้ประโยชน์จากเนื้อหาที่ผู้ใช้สร้างขึ้นในอดีตเพื่อสร้างแบบจำลองที่ไม่มีใครเทียบได้และมีประสิทธิภาพ ซึ่งเป็นแนวทางปฏิบัติที่ดำเนินอยู่ในปัจจุบัน โดยหน่วยงานอย่าง Microsoft และ OpenAI สามารถเข้าถึงข้อมูลระดับสูงผ่านพันธมิตรพิเศษและแพลตฟอร์มที่เป็นกรรมสิทธิ์ การกระจุกตัวของความสามารถเหล่านี้ภายในไม่กี่บริษัทได้นำไปสู่การกระจุกตัวในอุตสาหกรรม AI อย่างมีนัยสำคัญ
นอกจากนี้ การใช้ชุดข้อมูลที่เป็นกรรมสิทธิ์สำหรับการฝึกโมเดลทำให้เกิดข้อพิจารณาด้านจริยธรรมที่สำคัญและความเสี่ยงของการเกิดอคติอย่างต่อเนื่อง อัลกอริธึม AI ได้รับกระบวนทัศน์การดำเนินงานจากข้อมูลพื้นฐานโดยธรรมชาติ และสร้างอคติโดยธรรมชาติที่สามารถฝังและทำซ้ำได้ง่าย สถานการณ์นี้เน้นย้ำถึงความจำเป็นในการทบทวนอย่างรอบคอบและการกำกับดูแลด้านจริยธรรมในระหว่างการพัฒนาเพื่อให้แน่ใจว่าแบบจำลองสะท้อนถึงรูปแบบและการเชื่อมโยงที่ยุติธรรมและตั้งใจ
ข้อกำหนดด้านทรัพยากร - เป็นที่ยอมรับกันว่าประสิทธิภาพของโมเดลจะเพิ่มขึ้นตามลอการิทึมตามจำนวนข้อมูลการฝึก ซึ่งบ่งชี้ว่าโดยทั่วไปแล้วโมเดลที่ได้รับประโยชน์จากรอบการประมวลผล GPU ที่หลากหลายที่สุดจะทำงานได้ดีที่สุด ไดนามิกนี้ทำให้เกิดผลกระทบจากการรวมศูนย์ที่สำคัญในช่วงก่อนการฝึกอบรม ซึ่งได้รับแรงหนุนจากการประหยัดจากขนาดและความได้เปรียบด้านประสิทธิภาพการผลิตที่บริษัทเทคโนโลยีและข้อมูลรายใหญ่ได้รับ แนวโน้มนี้เห็นได้ชัดจากการครอบงำของยักษ์ใหญ่ในอุตสาหกรรม OpenAI, Google, Amazon, Microsoft และ Meta บริษัทเหล่านี้เป็นเจ้าของและดำเนินการศูนย์ข้อมูลส่วนใหญ่ของโลก และสามารถเข้าถึงฮาร์ดแวร์ล่าสุดและทันสมัยที่สุดของ NVIDIA
เฟสการปรับแต่ง
หลังจากที่โมเดลได้รับการฝึกล่วงหน้าแล้ว จะทำการปรับแต่งแบบละเอียด ในขั้นตอนนี้ โมเดลจะได้รับการฝึกเพิ่มเติมเกี่ยวกับชุดข้อมูลขนาดเล็กเฉพาะงาน จุดประสงค์คือเพื่อปรับน้ำหนักและคุณสมบัติที่โมเดลเรียนรู้ระหว่างการฝึกล่วงหน้าเพื่อให้เหมาะสมกับงานเฉพาะในปัจจุบันมากขึ้น ซึ่งอาจเกี่ยวข้องกับการสอนแบบจำลองภาษาเพื่อทำความเข้าใจคำศัพท์ทางการแพทย์ หรือการฝึกอบรมแบบจำลองการจดจำรูปภาพเพื่อแยกแยะระหว่างนกสายพันธุ์ต่างๆ
ขั้นตอนการปรับแต่งอย่างละเอียดช่วยให้โมเดลสามารถมุ่งเน้นและปรับปรุงประสิทธิภาพในงานที่ผู้ใช้ปลายทางสนใจได้ ขอย้ำอีกครั้งว่ามีความพยายามอย่างเข้มข้นในขั้นตอนการปรับแต่ง ซึ่งสิ่งที่สำคัญที่สุดคือแบบจำลองแบบแหล่งปิดและความสามารถในการตรวจสอบได้
ในระหว่างขั้นตอนการปรับแต่งอย่างละเอียด พารามิเตอร์ของโมเดลจะได้รับการปรับปรุงและตั้งค่า เพื่อกำหนดรูปแบบการทำงานและประสิทธิภาพของโมเดล แนวโน้มที่เกิดขึ้นคือโมเดล AI ที่เป็นกรรมสิทธิ์ เช่น ตระกูล GPT ของ OpenAI และ Gemini ของ Google ซึ่งหมายความว่าการทำงานภายในและพารามิเตอร์ของโมเดลเหล่านี้จะไม่เปิดเผยต่อสาธารณะ ดังนั้น เมื่อผู้ใช้ร้องขอการอนุมาน พวกเขาไม่สามารถตรวจสอบได้ว่าการตอบสนองนั้นมาจากแบบจำลองที่พวกเขาคิดว่ากำลังโต้ตอบอยู่จริงหรือไม่
การขาดความโปร่งใสนี้อาจส่งผลเสียต่อผู้ใช้ โดยเฉพาะอย่างยิ่งเมื่อความน่าเชื่อถือและการตรวจสอบความถูกต้องเป็นสิ่งสำคัญ ตัวอย่างเช่น ในวงการแพทย์ แบบจำลองปัญญาประดิษฐ์อาจช่วยวินิจฉัยโรคหรือแนะนำการรักษาได้ แต่แพทย์ไม่สามารถยืนยันแหล่งที่มาและความแม่นยำของการอนุมานแบบจำลองได้ ซึ่งอาจนำไปสู่ความไม่ไว้วางใจหรือแม้แต่การวินิจฉัยผิดพลาดได้ หากผู้เชี่ยวชาญทางการแพทย์ไม่สามารถมั่นใจได้ว่าคำแนะนำ AI นั้นอิงตามแบบจำลองที่เชื่อถือได้และทันสมัยที่สุด ผลที่ตามมาอาจส่งผลโดยตรงต่อการดูแลผู้ป่วยและผลลัพธ์ โดยเน้นย้ำถึงความสำคัญของความโปร่งใสและความรับผิดชอบในการปรับใช้ AI
ขั้นตอนการให้เหตุผล
ขั้นตอนการอนุมานคือขั้นตอนที่นำแบบจำลองไปใช้จริง ณ จุดนี้ โมเดลได้รับการฝึกอบรมและปรับแต่งอย่างละเอียด และพร้อมที่จะคาดการณ์ข้อมูลใหม่ ในกรณีของโมเดล AI อาจหมายถึงการตอบคำถาม แปลภาษา หรือการให้คำแนะนำ ระยะนี้เป็นระยะที่แบบจำลองที่ผ่านการฝึกอบรมถูกนำไปใช้กับปัญหาจริง และโดยปกติจะเป็นระยะที่ตระหนักถึงคุณค่าของแบบจำลอง
ในระหว่างขั้นตอนการอนุมาน ปัจจัยที่นำไปสู่การรวมศูนย์คือ:
เข้าถึง:ส่วนหน้าแบบรวมศูนย์สำหรับการเข้าถึงโมเดล AI อาจมีความเสี่ยงที่อาจทำให้ผู้ใช้ไม่สามารถเข้าถึง API หรือการอนุมานได้ เมื่อมีหน่วยงานจำนวนไม่มากควบคุมพอร์ทัลเหล่านี้ พวกเขาสามารถปฏิเสธการเข้าถึงบริการ AI ที่สำคัญได้ด้วยเหตุผลหลายประการ ขึ้นอยู่กับดุลยพินิจของพวกเขา รวมถึงการเปลี่ยนแปลงนโยบายหรือข้อพิพาท การรวมศูนย์นี้เน้นย้ำถึงความจำเป็นในแนวทางการกระจายอำนาจเพื่อให้แน่ใจว่าการเข้าถึงเทคโนโลยี AI ในวงกว้างและยืดหยุ่นมากขึ้น ช่วยลดความเสี่ยงของการเซ็นเซอร์และการเข้าถึงที่ไม่เท่าเทียมกัน
ข้อกำหนดด้านทรัพยากร:ค่าใช้จ่ายในการดำเนินการอนุมานในปัญญาประดิษฐ์ โดยเฉพาะอย่างยิ่งสำหรับงานที่ต้องใช้ทรัพยากรการประมวลผลจำนวนมาก ได้กลายเป็นกำลังที่กระจุกตัวอยู่ในอุตสาหกรรมเทคโนโลยี ต้นทุนการอนุมานที่สูงหมายความว่าเฉพาะบริษัทขนาดใหญ่ที่มีทรัพยากรทางการเงินจำนวนมากเท่านั้นที่สามารถใช้งานโมเดล AI ขั้นสูงในวงกว้างได้ อุปสรรคทางการเงินนี้จำกัดศักยภาพของบริษัทขนาดเล็กหรือนักพัฒนารายบุคคลจากการใช้ประโยชน์จากเทคโนโลยี AI ที่ล้ำสมัย
เป็นผลให้สถานการณ์ถูกครอบงำมากขึ้นโดยผู้เล่นที่ทรงพลังเพียงไม่กี่คน การแข่งขันและนวัตกรรมที่หยุดยั้ง การรวมศูนย์นี้ไม่เพียงแต่ส่งผลกระทบต่อความหลากหลายของการพัฒนา AI เท่านั้น แต่ยังจำกัดการเข้าถึงประโยชน์ของ AI ให้กับองค์กรเล็กๆ ที่ได้รับทุนสนับสนุนอย่างดี ทำให้เกิดความไม่สมดุลที่สำคัญในระบบนิเวศของเทคโนโลยี
มีธีมที่เกิดขึ้นซ้ำๆ ในพื้นที่ AI แบบรวมศูนย์ โดยเฉพาะอย่างยิ่งเกี่ยวกับวิวัฒนาการของบริษัท Web2 หน่วยงานเหล่านี้ซึ่งแต่เดิมก่อตั้งขึ้นเป็นเครือข่ายแบบเปิด มักจะมุ่งเน้นไปที่การเพิ่มมูลค่าสูงสุดของผู้ถือหุ้น การเปลี่ยนแปลงนี้มักจะทำให้พวกเขาต้องปิดเครือข่ายและปรับอัลกอริธึมเพื่อบล็อกลิงก์ภายนอก ซึ่งมักจะขัดต่อผลประโยชน์สูงสุดของผู้ใช้
สิ่งจูงใจขององค์กรและความต้องการของผู้ใช้ที่ไม่สอดคล้องกันนี้มักเกิดขึ้นเมื่อองค์กรเติบโตเต็มที่และได้รับเงินทุนจากภายนอก ความจริงที่ว่าเราเห็นปรากฏการณ์นี้กับ OpenAI แล้ว ซึ่งเริ่มต้นจากการเป็นองค์กรไม่แสวงผลกำไรที่มีจุดมุ่งหมายเพื่อทำให้การใช้ปัญญาประดิษฐ์เป็นประชาธิปไตย แสดงให้เห็นว่าการเปลี่ยนแปลงที่มุ่งเน้นในอุตสาหกรรมสามารถแสดงให้เห็นได้อย่างไร เป็นเรื่องง่ายที่จะตำหนิบริษัทแต่ละแห่ง แต่เราเชื่อว่ามันสะท้อนให้เห็นถึงปัญหาเชิงระบบที่เกิดจากกองกำลังที่รวมตัวกันในอุตสาหกรรมเทคโนโลยี ซึ่งมักจะนำไปสู่ความไม่สอดคล้องกันระหว่างแรงจูงใจขององค์กรและความต้องการของผู้ใช้ในวงกว้าง
อนาคตที่เป็นไปได้: ปัญญาประดิษฐ์และ Web3
โลกสกุลเงินดิจิทัลเป็นรากฐานสำหรับปัญญาประดิษฐ์ ทำให้การแลกเปลี่ยนข้อมูลและคุณค่าเป็นไปอย่างราบรื่น เปิดกว้างและปลอดภัย เทคโนโลยีบล็อคเชนมีระบบที่ชัดเจนและตรวจสอบย้อนกลับได้สำหรับการจัดการธุรกรรมและการบันทึกข้อมูล ที่จุดบรรจบกันของสกุลเงินดิจิทัลและปัญญาประดิษฐ์ มีโอกาสมากมายเกิดขึ้นโดยที่ทั้งสองสาขาสามารถปรับปรุงซึ่งกันและกันและได้รับประโยชน์จากความสามารถของอีกฝ่าย
การจัดตำแหน่งที่สร้างแรงบันดาลใจ
การประมวลผลแบบกระจายมีคุณค่าในระหว่างขั้นตอนก่อนการฝึกอบรมและการปรับแต่งอย่างละเอียดของการพัฒนาแบบจำลอง โมเดลพื้นฐานมักต้องใช้รอบการประมวลผล GPU เป็นจำนวนมาก และโดยทั่วไปกระบวนการเหล่านี้จะทำงานในศูนย์ข้อมูลแบบรวมศูนย์ เครือข่ายโครงสร้างพื้นฐานทางกายภาพแบบกระจายอำนาจ (DePIN) สามารถให้การเข้าถึงคอมพิวเตอร์แบบกระจายอำนาจและไม่ได้รับอนุญาต ด้วยสิ่งจูงใจทางเศรษฐกิจของสกุลเงินดิจิทัล ซอฟต์แวร์สามารถชดเชยการใช้งานฮาร์ดแวร์ได้โดยอัตโนมัติ โดยไม่จำเป็นต้องมีหน่วยงานกำกับดูแลจากส่วนกลาง สิ่งนี้ช่วยให้ผู้ใช้เครือข่ายสามารถควบคุมเครือข่าย ปรับสิ่งจูงใจ และตรวจสอบให้แน่ใจว่าผู้ให้บริการข้อมูลและโมเดลได้รับการชดเชยอย่างเพียงพอ
การตรวจสอบความถูกต้อง
โครงสร้างพื้นฐาน AI ในปัจจุบันมีความเบี่ยงเบนอย่างมากต่อโมเดลที่เป็นกรรมสิทธิ์ และผู้ใช้จำเป็นต้องไว้วางใจผู้ให้บริการการอนุมานเพื่อดำเนินการสืบค้นผ่านโมเดลที่ระบุและสร้างผลลัพธ์ที่ถูกต้องตามกฎหมาย ในบริบทนี้ ระบบพิสูจน์การเข้ารหัสได้กลายเป็นเทคโนโลยีหลัก ซึ่งเป็นกลไกในการตรวจสอบผลลัพธ์ของโมเดลบนบล็อกเชน กระบวนการนี้ทำให้ผู้ใช้สามารถส่งคำถาม ซึ่งดำเนินการโดยผู้ให้บริการการอนุมานโดยใช้แบบจำลองที่ตกลงกันไว้ จากนั้นจึงสร้างเอาต์พุตพร้อมหลักฐานการเข้ารหัส หลักฐานนี้ทำหน้าที่เป็นหลักฐานที่ตรวจสอบได้ว่าแบบสอบถามได้รับการประมวลผลโดยโมเดลที่ระบุจริงๆ
เป้าหมายหลักของความคิดริเริ่มเหล่านี้คือการถ่ายโอนงานด้านการคำนวณจำนวนมากไปยังสภาพแวดล้อมนอกเครือข่าย ในขณะเดียวกันก็ทำให้มั่นใจได้ว่าผลลัพธ์สามารถตรวจสอบได้ทางออนไลน์ แนวทางนี้ไม่เพียงแต่ช่วยลดภาระในการคำนวณบนบล็อกเชนเท่านั้น แต่ยังแนะนำชั้นของความโปร่งใสและความน่าเชื่อถือด้วยการให้หลักฐานพิสูจน์ความถูกต้องและความสมบูรณ์ของการคำนวณนอกเครือข่ายที่ไม่เปลี่ยนแปลง
การรวมการพิสูจน์การเข้ารหัสเหล่านี้เข้ากับกระบวนการตรวจสอบโมเดล AI ช่วยแก้ปัญหาสำคัญหลายประการที่เกี่ยวข้องกับระบบ AI แบบปิด ช่วยลดความเสี่ยงของการคำนวณที่ไม่ชัดเจนหรือไม่ได้รับการตรวจสอบ ปรับปรุงความสมบูรณ์ของกระบวนการคำนวณ และส่งเสริมความสัมพันธ์บนพื้นฐานความน่าเชื่อถือระหว่างผู้ใช้และผู้ให้บริการการอนุมาน นอกจากนี้ แนวทางนี้ยังสอดคล้องกับแนวโน้มที่กว้างขึ้นต่อระบบกระจายอำนาจและโปร่งใส ซึ่งสะท้อนหลักการพื้นฐานของเทคโนโลยีบล็อกเชน
ความสามารถในการประกอบ
ข้อดีหลักประการหนึ่งของการเงินแบบกระจายอำนาจและเครือข่ายบล็อกเชนคือความสามารถในการประกอบที่เปิดใช้งาน ความสามารถในการจัดองค์ประกอบทำให้สามารถใช้ LEGO ทางการเงิน ใน DeFi ได้อย่างแพร่หลาย เช่น การรวมโปรโตคอลและเอาต์พุตที่แตกต่างกันเพื่อสร้างแอปพลิเคชันใหม่ แม้ว่าความเป็นโมดูลนี้จะทำให้เกิดความเสี่ยงรูปแบบใหม่เข้าสู่ระบบ แต่ยังทำให้การพัฒนาแอปพลิเคชันสำหรับนักพัฒนาง่ายขึ้น เพิ่มนวัตกรรมและความเร็วในการพัฒนา ตลอดจนมอบประสบการณ์ผู้ใช้และความสะดวกสบายที่ง่ายขึ้น
เช่นเดียวกับวิธีที่สกุลเงินดิจิทัลให้ความสามารถในการสร้างองค์ประกอบสำหรับผลิตภัณฑ์ทางการเงิน สกุลเงินดิจิทัลจะสร้างความสามารถในการสร้างองค์ประกอบสำหรับเครือข่าย AI และแอปพลิเคชันโดยทำหน้าที่เป็นเลเยอร์ที่ไม่ได้รับอนุญาตและไม่น่าเชื่อถือ ซึ่งโมดูล AI สามารถสร้างและทำงานได้อย่างอิสระ ในขณะที่ยังคงเชื่อมต่อกับโมดูลอื่นๆ เพื่อสร้างเครือข่ายที่ สามารถให้บริการได้หลากหลาย โครงการและแอปพลิเคชันปัญญาประดิษฐ์แบบกระจายอำนาจสามารถเชื่อมต่อถึงกันผ่านเอฟเฟกต์เครือข่ายบล็อกเชนและสกุลเงินดิจิทัล เพื่อทำให้สถาปัตยกรรมโดยรวมของปัญญาประดิษฐ์สมบูรณ์
ตัวอย่างเช่น คุณสามารถใช้ข้อมูลที่ประมวลผลล่วงหน้าของ Akash หรือ Filecoin เพื่อฝึกโมเดลโดยใช้ Marlin, Gensyn หรือ Together หลังจากการปรับแต่งอย่างละเอียด โมเดลที่ผ่านการฝึกอบรมเหล่านี้สามารถตอบสนองต่อคำถามของผู้ใช้ (การอนุมาน) ผ่าน Bittensor แม้ว่าจะดูซับซ้อนกว่า แต่ผู้ใช้จำเป็นต้องโต้ตอบกับส่วนหน้าเพียงอันเดียว ในขณะที่นักพัฒนาและแอปพลิเคชันจะได้รับประโยชน์จากการสร้างบนสแต็กและแอปพลิเคชันที่แตกต่างกัน
สิ่งสำคัญอีกประการหนึ่งของการจัดองค์ประกอบที่เปิดใช้งานโดยเครือข่ายแบบกระจายอำนาจคือการจัดองค์ประกอบข้อมูล เมื่อผู้ใช้เริ่มสนใจที่จะเป็นเจ้าของข้อมูลที่พวกเขาสร้างขึ้นมากขึ้น และต้องการความสามารถในการส่งข้อมูลระหว่างโปรโตคอล AI ต่างๆ พวกเขาจะต้องการให้ข้อมูลของพวกเขาไม่ถูกจำกัดอยู่ในสภาพแวดล้อมแบบปิด แอปพลิเคชัน AI แบบโอเพ่นซอร์สและกระจายอำนาจทำให้ข้อมูลพกพาได้
การป้องกันข้อมูล
การประมวลผลแบบกระจายอำนาจ ผสมผสานกับข้อมูลภายนอกและโซลูชันความเป็นส่วนตัว ช่วยให้ผู้ใช้มีอิสระในการควบคุมข้อมูลมากขึ้น ทำให้เป็นตัวเลือกที่น่าสนใจมากกว่าระบบแบบรวมศูนย์ โดยเฉพาะอย่างยิ่ง วิธีการต่างๆ เช่น การเข้ารหัสโฮโมมอร์ฟิกอย่างสมบูรณ์ (FHE) ช่วยให้สามารถคำนวณข้อมูลที่เข้ารหัสได้โดยไม่ต้องถอดรหัสข้อมูลก่อน
ด้วย FHE โมเดลแมชชีนเลิร์นนิงสามารถฝึกอบรมได้โดยใช้ชุดข้อมูลที่เข้ารหัส ทำให้ข้อมูลเป็นส่วนตัวและปลอดภัยตลอดกระบวนการฝึกอบรม นี่เป็นโซลูชันการรักษาความปลอดภัยแบบ end-to-end พร้อมการรับประกันการเข้ารหัสที่แข็งแกร่ง ช่วยให้สามารถฝึกอบรมโมเดลการรักษาความเป็นส่วนตัวในเครือข่าย Edge และช่วยให้สามารถพัฒนาระบบ AI ที่ปกป้องความเป็นส่วนตัวของผู้ใช้และใช้ประโยชน์จากความสามารถ AI ขั้นสูง
บทบาทของ FHE ขยายไปสู่การใช้งานโมเดลภาษาขนาดใหญ่อย่างปลอดภัยบนข้อมูลที่เข้ารหัสในสภาพแวดล้อมคลาวด์ สิ่งนี้ไม่เพียงแต่ปกป้องความเป็นส่วนตัวและข้อมูลที่ละเอียดอ่อนของผู้ใช้เท่านั้น แต่ยังช่วยเพิ่มความสามารถในการรันโมเดลบนแอปพลิเคชันที่มีความเป็นส่วนตัวโดยธรรมชาติอีกด้วย ด้วยการบูรณาการปัญญาประดิษฐ์ในด้านต่างๆ โดยเฉพาะอย่างยิ่งในด้านที่มีความละเอียดอ่อน เช่น การเงิน ความต้องการเทคโนโลยี เช่น การเข้ารหัสแบบโฮโมมอร์ฟิกอย่างสมบูรณ์ ซึ่งสามารถป้องกันการรั่วไหลของข้อมูลที่อาจเกิดขึ้นได้กลายเป็นสิ่งสำคัญ
ความสามารถในการอัพเกรดอัตโนมัติ
AI สามารถใช้เพื่อรักษา อัปเดต และอัปเกรดสัญญาอัจฉริยะโดยอัตโนมัติตามการเปลี่ยนแปลงและเงื่อนไขต่างๆ ตัวอย่างเช่น สามารถใช้ AI ในด้านโปรโตคอลเพื่อปรับพารามิเตอร์ความเสี่ยงตามการเปลี่ยนแปลงของความเสี่ยงและสภาวะตลาดอื่นๆ ตัวอย่างทั่วไปคือตลาดสกุลเงิน ปัจจุบันตลาดเงินขึ้นอยู่กับองค์กรภายนอกหรือการตัดสินใจของ DAO เพื่อปรับพารามิเตอร์ความเสี่ยงของสินทรัพย์ที่ให้ยืม เจ้าหน้าที่ AI สามารถทำให้การอัปเดตและอัปเกรดพารามิเตอร์เฉพาะง่ายขึ้น ซึ่งจะเป็นการปรับปรุงที่สำคัญเมื่อเทียบกับมนุษย์และองค์กร DAO ซึ่งอาจช้าและไม่มีประสิทธิภาพ
ความท้าทายของปัญญาประดิษฐ์แบบกระจายอำนาจ
AI แบบกระจายอำนาจเผชิญกับความท้าทายในตัวเอง โดยเฉพาะอย่างยิ่งในการสร้างสมดุลระหว่างลักษณะการเข้ารหัสแบบโอเพ่นซอร์สกับข้อกังวลด้านความปลอดภัยของ AI และความต้องการด้านการคำนวณของ AI ในวิทยาการเข้ารหัสลับ โอเพ่นซอร์สมีความสำคัญอย่างยิ่งต่อการรับรองความปลอดภัย แต่ในด้านปัญญาประดิษฐ์ การเปิดเผยโมเดลหรือข้อมูลการฝึกอบรมจะเพิ่มความเสี่ยงที่จะถูกโจมตีจากแมชชีนเลิร์นนิงของฝ่ายตรงข้าม การพัฒนาแอปพลิเคชันโดยใช้เทคโนโลยีทั้งสองนี้ถือเป็นความท้าทายที่สำคัญ นอกจากนี้ การประยุกต์ใช้ปัญญาประดิษฐ์ในบล็อกเชน เช่น บอทเก็งกำไรที่ใช้ปัญญาประดิษฐ์ ตลาดการคาดการณ์ และกลไกการตัดสินใจ ทำให้เกิดประเด็นเรื่องความเป็นธรรมและการยักย้าย AI มีศักยภาพในการปรับปรุงประสิทธิภาพและการตัดสินใจในด้านเหล่านี้ แต่มีความเสี่ยงที่ AI จะไม่เข้าใจความแตกต่างของตลาดที่ขับเคลื่อนโดยมนุษย์อย่างเต็มที่ ซึ่งนำไปสู่ผลลัพธ์ที่ไม่ได้ตั้งใจ
ข้อกังวลอีกประการหนึ่งคือการใช้ปัญญาประดิษฐ์เป็นอินเทอร์เฟซสำหรับแอปพลิเคชันการเข้ารหัส แม้ว่า AI สามารถช่วยให้ผู้ใช้สำรวจโลกที่ซับซ้อนของสกุลเงินดิจิทัลได้ แต่ก็ยังมีความเสี่ยง เช่น ความไวต่ออินพุตของฝ่ายตรงข้าม หรือทำให้ผู้ใช้พึ่งพา AI มากเกินไปในการตัดสินใจที่สำคัญ นอกจากนี้ยังมีความเสี่ยงที่เกี่ยวข้องกับการรวมปัญญาประดิษฐ์เข้ากับกฎของแอปพลิเคชันบล็อกเชน เช่น DAO หรือสัญญาอัจฉริยะ การเรียนรู้ของเครื่องของฝ่ายตรงข้ามสามารถใช้ประโยชน์จากจุดอ่อนในโมเดลปัญญาประดิษฐ์ ซึ่งนำไปสู่ผลลัพธ์ที่ถูกจัดการหรือไม่ถูกต้อง การตรวจสอบให้แน่ใจว่าแบบจำลอง AI มีความแม่นยำ ใช้งานง่าย และมีภูมิคุ้มกันต่อการดัดแปลงถือเป็นความท้าทายที่สำคัญ
นอกจากนี้ การรวมปัญญาประดิษฐ์เข้ากับการพิสูจน์ความรู้แบบศูนย์หรือการคำนวณแบบหลายฝ่ายไม่เพียงแต่เป็นการประมวลผลที่เข้มข้นเท่านั้น แต่ยังเผชิญกับอุปสรรคต่างๆ เช่น ต้นทุนการคำนวณที่สูง ข้อจำกัดของหน่วยความจำ และความซับซ้อนของโมเดล เครื่องมือและโครงสร้างพื้นฐานสำหรับแมชชีนเลิร์นนิงแบบไม่มีความรู้ (zkML) ในปัจจุบันยังด้อยการพัฒนา และนักพัฒนาที่มีทักษะยังขาดแคลนในด้านนี้ ปัจจัยเหล่านี้ส่งผลให้มีงานจำนวนมากที่จำเป็นก่อนที่ zkML จะสามารถนำไปใช้ในระดับที่เหมาะสมสำหรับผลิตภัณฑ์อุปโภคบริโภคได้
สรุป
สิ่งสำคัญอย่างยิ่งคือต้องสร้างสมดุลระหว่างการกระจายอำนาจและความไว้วางใจ ในขณะเดียวกันก็รักษาจิตวิญญาณการกระจายอำนาจของบล็อกเชน และรับประกันความน่าเชื่อถือของระบบ AI โดยเฉพาะอย่างยิ่งเมื่อ AI ใช้ฮาร์ดแวร์ที่เชื่อถือได้หรือโมเดลการกำกับดูแลข้อมูลเฉพาะ ในส่วนถัดไปของบทความนี้ เราจะเจาะลึกเกี่ยวกับเทคโนโลยีที่สามารถรองรับ AI แบบกระจายอำนาจ และบทบาทที่สำคัญของโครงสร้างพื้นฐาน Marlin ในการทำให้สิ่งนี้เป็นไปได้
ส่วนที่ 2: ภาพรวมเทคโนโลยีการใช้งาน
ในส่วนก่อนหน้าของบทความนี้ เราได้สำรวจข้อบกพร่องของ AI แบบรวมศูนย์ และวิธีที่ Web3 สามารถบรรเทาปัญหาเหล่านี้ได้ อย่างไรก็ตาม การรันโมเดลออนไลน์ไม่สามารถทำได้เนื่องจากค่าธรรมเนียมก๊าซที่สูงมาก ความพยายามที่จะเพิ่มพลังการประมวลผลของบล็อกเชนพื้นฐานจะเพิ่มข้อกำหนดโหนดสำหรับเครื่องมือตรวจสอบความถูกต้อง ซึ่งอาจลดการกระจายอำนาจเนื่องจากความยากลำบากที่เครื่องมือตรวจสอบภายในบ้านขนาดเล็กจะเผชิญ
ในบทต่อไปนี้ เราจะแนะนำเครื่องมือและเทคโนโลยียอดนิยมที่จำเป็นในการพัฒนาปัญญาประดิษฐ์เพิ่มเติมใน Web3 ได้แก่ Zero-Knowledge Proofs (ZKP) การเข้ารหัสแบบโฮโมมอร์ฟิกอย่างสมบูรณ์ (FHE) และสภาพแวดล้อมการดำเนินการที่เชื่อถือได้ (TEE)
ZKP และ ZKML
Zero-Knowledge Proofs (ZKP) มีความสำคัญอย่างยิ่งสำหรับปัญญาประดิษฐ์และ Web3 เนื่องจากสามารถปรับปรุงความสามารถในการปรับขนาดและการปกป้องความเป็นส่วนตัวได้ ช่วยให้การคำนวณดำเนินการนอกเครือข่ายแล้วตรวจสอบออนไลน์ (การคำนวณการตรวจสอบความถูกต้อง) ซึ่งมีประสิทธิภาพมากกว่าการคำนวณซ้ำบนโหนดทั้งหมดของบล็อกเชน ช่วยลดภาระของเครือข่ายและทำให้การดำเนินงานที่ซับซ้อนมากขึ้น zkML ช่วยให้โมเดล AI ทำงานในสภาพแวดล้อมแบบออนไลน์ได้ ซึ่งจะทำให้แน่ใจได้ว่าผลลัพธ์ของการคำนวณนอกเครือข่ายเหล่านี้ได้รับความไว้วางใจและตรวจสอบแล้ว
นอกจากนี้ zkML ยังสามารถตรวจสอบลักษณะเฉพาะของกระบวนการการเรียนรู้ของเครื่อง เช่น การยืนยันว่ามีการใช้โมเดลเฉพาะในการทำนาย หรือโมเดลได้รับการฝึกฝนบนชุดข้อมูลเฉพาะ zkML ยังสามารถใช้เพื่อตรวจสอบกระบวนการคำนวณอีกด้วย ตัวอย่างเช่น ช่วยให้ผู้ให้บริการคอมพิวเตอร์พิสูจน์ผ่านหลักฐานที่ตรวจสอบได้ว่าพวกเขาใช้แบบจำลองที่ถูกต้องในการประมวลผลข้อมูล นี่เป็นสิ่งสำคัญอย่างยิ่งสำหรับนักพัฒนาที่ต้องพึ่งพาผู้ให้บริการคอมพิวเตอร์แบบกระจายอำนาจ เช่น Akash และต้องการรับรองความถูกต้องและความสมบูรณ์ของการคำนวณ
zkML ยังมีประโยชน์สำหรับผู้ใช้ที่ต้องการเรียกใช้โมเดลกับข้อมูลของตน แต่ต้องการเก็บข้อมูลให้เป็นส่วนตัว พวกเขาสามารถดำเนินการแบบจำลองด้วยข้อมูลของตนเอง สร้างการพิสูจน์ และตรวจสอบการใช้แบบจำลองที่ถูกต้องในภายหลังโดยไม่กระทบต่อความเป็นส่วนตัวของข้อมูล
FHE
ตามที่กล่าวไว้ก่อนหน้านี้ การเข้ารหัสโฮโมมอร์ฟิกอย่างสมบูรณ์ (FHE) ช่วยให้การคำนวณสามารถดำเนินการได้โดยตรงกับข้อมูลที่เข้ารหัสโดยไม่ต้องถอดรหัสก่อน เทคโนโลยีนี้มีการใช้งานที่สำคัญในด้านปัญญาประดิษฐ์ โดยเฉพาะอย่างยิ่งในการเรียนรู้ของเครื่องและการประมวลผลข้อมูลที่ละเอียดอ่อน
แอปพลิเคชันหลักอย่างหนึ่งของ FHE คือการฝึกอบรมโมเดลการเรียนรู้ของเครื่องโดยใช้ชุดข้อมูลที่เข้ารหัส แนวทางนี้ทำให้แน่ใจได้ว่าข้อมูลยังคงได้รับการเข้ารหัสและปลอดภัยตลอดกระบวนการฝึกอบรม ด้วยเหตุนี้ FHE จึงมอบโซลูชันการรักษาความปลอดภัยที่ครอบคลุมซึ่งรักษาความเป็นส่วนตัวของข้อมูลตั้งแต่ต้นจนจบกระบวนการเรียนรู้ของเครื่อง สิ่งนี้มีความสำคัญอย่างยิ่งในเครือข่าย Edge ซึ่งความปลอดภัยของข้อมูลและความเป็นส่วนตัวเป็นสิ่งสำคัญ และทรัพยากรการประมวลผลมักถูกจำกัดมากกว่าในศูนย์ข้อมูลแบบรวมศูนย์
การใช้เทคโนโลยีการเข้ารหัสโฮโมมอร์ฟิกอย่างสมบูรณ์สามารถพัฒนาระบบที่ปกป้องความเป็นส่วนตัวของผู้ใช้ในขณะที่ใช้ความสามารถขั้นสูงของปัญญาประดิษฐ์ได้อย่างเต็มที่ ด้วยการรับรองว่าข้อมูลยังคงถูกเข้ารหัสในระหว่างการจัดเก็บและการประมวลผล Fully Homomorphic Encryption (FHE) ให้การรับประกันการเข้ารหัสที่แข็งแกร่งต่อการเข้าถึงโดยไม่ได้รับอนุญาตและการรั่วไหลของข้อมูล นี่เป็นสิ่งสำคัญอย่างยิ่งในสถานการณ์ที่มีการจัดการข้อมูลที่ละเอียดอ่อน เช่น ข้อมูลส่วนบุคคลในการใช้งานทางการแพทย์หรือบันทึกทางการเงินที่เป็นความลับ
การเข้ารหัสแบบโฮโมมอร์ฟิกอย่างสมบูรณ์ (FHE) ขยายยูทิลิตี้ไปสู่การรันโมเดลภาษาขนาดใหญ่ในสภาพแวดล้อมคลาวด์ ด้วยการทำให้โมเดลเหล่านี้สามารถประมวลผลข้อมูลที่เข้ารหัสได้ การเข้ารหัสแบบ Homomorphic Encryption (FHE) อย่างสมบูรณ์จึงทำให้มั่นใจได้ว่าความเป็นส่วนตัวของผู้ใช้และข้อมูลที่ละเอียดอ่อนได้รับการปกป้อง ความสามารถนี้มีความสำคัญมากขึ้นเรื่อยๆ เนื่องจากมีการใช้งานแอปพลิเคชัน AI มากขึ้นเรื่อยๆ ในสภาพแวดล้อมคลาวด์ และความปลอดภัยของข้อมูลกลายเป็นประเด็นสำคัญ ความสามารถในการรันโมเดลอย่างปลอดภัยบนข้อมูลที่เข้ารหัสช่วยเพิ่มความสามารถในการบังคับใช้ของ AI ในพื้นที่ที่จำเป็นต้องมีการรักษาความลับที่เข้มงวด เช่น อุตสาหกรรมด้านกฎหมาย การแพทย์ และการเงิน
การเข้ารหัสแบบโฮโมมอร์ฟิกอย่างสมบูรณ์ (FHE) ตอบสนองความต้องการที่สำคัญในการปกป้องข้อมูลที่ละเอียดอ่อนจากการรั่วไหลของข้อมูลที่อาจเกิดขึ้นและการเข้าถึงโดยไม่ได้รับอนุญาต ในพื้นที่ที่ความเป็นส่วนตัวของข้อมูลไม่ได้เป็นเพียงการกำหนดลักษณะ แต่เป็นข้อกำหนดด้านกฎระเบียบ การเข้ารหัสแบบโฮโมมอร์ฟิกอย่างสมบูรณ์ (FHE) นำเสนอวิธีการใช้ประโยชน์จากปัญญาประดิษฐ์โดยไม่กระทบต่อความปลอดภัยของข้อมูลและมาตรฐานการปฏิบัติตามข้อกำหนด
TEE
Trusted Execution Environment (TEE) มีข้อได้เปรียบที่สำคัญในการฝึกอบรมและดำเนินการอนุมานปัญญาประดิษฐ์ โดยเฉพาะอย่างยิ่งในแง่ของการรับประกันความปลอดภัย การแยกส่วน ความเป็นส่วนตัวของข้อมูล และการป้องกัน เนื่องจาก TEE ทำหน้าที่เป็นสภาพแวดล้อมการแยกที่ปลอดภัย จึงให้ความปลอดภัยและความสมบูรณ์ที่แข็งแกร่งสำหรับข้อมูลและการคำนวณ
ประโยชน์หลักประการแรกคือการรับประกันความปลอดภัยและการรักษาความปลอดภัยที่เพิ่มขึ้น TEE ได้รับการออกแบบมาเป็นพิเศษเพื่อต่อสู้กับช่องโหว่ในระบบที่มี Trusted Computing Bases (TCB) ที่ครอบคลุม รวมถึงเคอร์เนลของระบบปฏิบัติการ ไดรเวอร์อุปกรณ์ และไลบรารี ส่วนประกอบเหล่านี้มีความเสี่ยงมากขึ้นเนื่องจากมีพื้นผิวการโจมตีที่ใหญ่ขึ้น ด้วยการจัดเตรียมสภาพแวดล้อมการดำเนินการที่ปลอดภัย TEE จะปกป้องแอปพลิเคชันที่สำคัญและรักษาความสมบูรณ์และการรักษาความลับของซอฟต์แวร์ภายในส่วนแม้ว่าระบบปฏิบัติการโฮสต์จะถูกบุกรุกก็ตาม
ข้อได้เปรียบที่สำคัญอีกประการหนึ่งคือการแยกตัว ภายในเขตกักกัน รหัสและข้อมูลจะถูกเก็บไว้อย่างปลอดภัย และสามารถเข้าถึงได้ด้วยรหัสภายในเขตกักกันเท่านั้น การออกแบบนี้ป้องกันการเข้าถึงจากภายนอก รวมถึงจากเครื่องเสมือนหรือไฮเปอร์มอนิเตอร์อื่นๆ ป้องกันการโจมตีทางกายภาพและภัยคุกคามจากเครื่องเสมือนอื่นๆ
TEE (Trusted Execution Environment) อำนวยความสะดวกในกระบวนการตรวจสอบระยะไกลเพื่อตรวจสอบว่าซอฟต์แวร์กำลังทำงานภายใน TEE จริง คุณลักษณะนี้มีความสำคัญอย่างยิ่งต่อการรับรองความถูกต้องและความสมบูรณ์ของซอฟต์แวร์ที่ทำงานภายในเขตปลอดทหาร สร้างความไว้วางใจระหว่างเอนทิตีระยะไกลและสภาพแวดล้อมการดำเนินการที่เชื่อถือได้ ทำให้มั่นใจได้ว่าซอฟต์แวร์และสภาพแวดล้อมการดำเนินการมีความปลอดภัยและไม่ถูกดัดแปลง
ในที่สุด TEE ก็เก่งในเรื่องการปกป้องข้อมูล คุณลักษณะด้านความปลอดภัยที่ใช้ฮาร์ดแวร์ของ TEE ช่วยปกป้องความลับและความสมบูรณ์ของการคำนวณ ซึ่งรวมถึงการส่งรหัสและข้อมูล (เช่น กุญแจ) อย่างปลอดภัยไปยังการกักกัน TEE ยังสร้างช่องทางการสื่อสารที่เชื่อถือได้สำหรับการดึงผลการคำนวณและเอาต์พุต เพื่อให้มั่นใจว่าข้อมูลยังคงมีความปลอดภัยตลอดวงจรการใช้งานภายในเครือข่าย คุณลักษณะเหล่านี้ทำให้ TEE เป็นสภาพแวดล้อมในอุดมคติสำหรับการฝึกอบรม AI และการดำเนินการอนุมาน AI โดยเฉพาะอย่างยิ่งในแอปพลิเคชันที่ต้องการความปลอดภัยและความสมบูรณ์ของข้อมูลในระดับสูง
Marlin Oyster
Marlin Oyster เป็นแพลตฟอร์มแบบเปิดสำหรับนักพัฒนาในการปรับใช้งานการประมวลผลแบบกำหนดเองหรือให้บริการสภาพแวดล้อมการดำเนินการที่เชื่อถือได้ คล้ายกับ SGX ของ Intel และ Nitro Enclaves ของ AWS ด้วย Oyster นักพัฒนาสามารถรันโค้ดในสภาพแวดล้อมที่แยกออกมา และตรวจสอบให้แน่ใจว่าทั้งโฮสต์และแอพพลิเคชั่นอื่นๆ ภายในนั้นไม่สามารถเปลี่ยนแปลงความสมบูรณ์ของการคำนวณในสภาพแวดล้อมการดำเนินการที่เชื่อถือได้ นอกเหนือจากความสมบูรณ์ในการคำนวณและการรับประกันการรักษาความลับโดย Trusted Execution Environment (TEE) แล้ว Oyster Platform ยังมอบสิทธิประโยชน์เพิ่มเติม:
เวลาทำงาน:Oyster รับประกันความพร้อมใช้งานของแอปพลิเคชันผ่านโปรโตคอลการตรวจสอบที่จะลงโทษการหยุดทำงานและกระจายงานใหม่ไปยังโหนดที่สมบูรณ์ กลไกนี้ช่วยให้แน่ใจว่านักพัฒนาที่ปรับใช้บน Oyster มอบฟังก์ชันการทำงานของแอปพลิเคชันอย่างต่อเนื่องและความมีชีวิตชีวาให้กับผู้ใช้
ไร้เซิร์ฟเวอร์:เช่นเดียวกับ AWS Lambda เฟรมเวิร์กไร้เซิร์ฟเวอร์ของ Oyster ช่วยให้นักพัฒนาสามารถปรับใช้แอปพลิเคชันโดยไม่ต้องเช่าโหนดเฉพาะโดยเฉพาะ นักพัฒนาประหยัดค่าใช้จ่ายและลดค่าใช้จ่ายในการดูแลระบบโดยจ่ายเฉพาะเวลาที่แอปพลิเคชันทำงานอยู่เท่านั้น
เครือข่าย:สลัม Oyster ได้รับการกำหนดค่าล่วงหน้าด้วยความสามารถด้านเครือข่ายที่อำนวยความสะดวกในการสร้างการเชื่อมต่อ TLS ที่ปลอดภัยภายในสลัม คุณลักษณะนี้ช่วยให้สามารถดำเนินการสืบค้น API ภายนอกและดำเนินการกับบริการที่มีจุดสิ้นสุดที่เปิดเผย ซึ่งช่วยเพิ่มการรวมแอปพลิเคชันกับอินเทอร์เน็ต
รีเลย์:Oyster รองรับการถ่ายโอนงานที่เน้นการประมวลผลไปยังสภาพแวดล้อมนอกเครือข่ายเพื่อการประมวลผลผ่านสัญญารีเลย์ สัญญาอัจฉริยะเหล่านี้ทำให้สามารถดำเนินการฟังก์ชันบน Oyster ได้ ทำให้มั่นใจได้ถึงผลลัพธ์ที่เชื่อถือได้และการตอบสนองตามเหตุการณ์เพื่อเพิ่มประสิทธิภาพการใช้ทรัพยากรออนไลน์
เกณฑ์มาตรฐาน
ในการเปรียบเทียบเกณฑ์มาตรฐานระหว่างเฟรมเวิร์ก zkML และ TEE ML (Oyster) ตัวชี้วัดประสิทธิภาพบ่งชี้ว่า Oyster มีประสิทธิภาพมากกว่า โดยเฉพาะอย่างยิ่ง กรอบงาน Oyster แสดงเวลาการคำนวณโดยรวมที่ลดลงอย่างมากสำหรับโมเดลการเรียนรู้ของเครื่องที่ทดสอบทั้งหมด

สำหรับโมเดลกำลังสองน้อยที่สุดธรรมดาบนข้อมูล Iris เฟรมเวิร์ก zkML (RisQ) ใช้เวลามากกว่า 32 วินาทีในการพิสูจน์และตรวจสอบ ในขณะที่ Oyster ใช้เวลาเพียง 0.047 วินาทีในการทำงานให้เสร็จสิ้น ในทำนองเดียวกัน ในชุดข้อมูลเดียวกัน เวลารวมของโครงข่ายประสาทเทียมที่ใช้ zkML (เฟรมเวิร์ก EZKL) สำหรับอินพุต 500 รายการนั้นนานกว่า 212 วินาที ในขณะที่ Oyster ใช้เวลาเพียง 0.045 วินาทีเท่านั้น ความแตกต่างที่สำคัญของเวลาในการประมวลผลนี้แสดงให้เห็นว่า Oyster มีประสิทธิภาพมากกว่าในสถานการณ์เหล่านี้
ในชุดข้อมูล MNIST โมเดล LeNet จะทำให้การสังเกตนี้ลึกซึ้งยิ่งขึ้น กรอบงาน zkML ของ EZKL ใช้เวลา 60 วินาทีในการตรวจสอบและพิสูจน์ ขณะที่ Oyster ใช้เวลาเพียง 0.056 วินาที แม้ว่าเฟรมเวิร์ก zkML ของ DDKang จะทำงานได้ดีกว่า EZKL ด้วยเวลารวมประมาณ 3.33 วินาที แต่ก็ยังไม่ดีเท่าของ Oyster ที่ 0.056 วินาที
โดยรวมแล้ว ข้อมูลแสดงให้เห็นว่า Oyster มอบโซลูชันที่มีประสิทธิภาพมากกว่าสำหรับงานแมชชีนเลิร์นนิง เมื่อเทียบกับเฟรมเวิร์ก zkML ที่ทดสอบแล้ว เวลาในการคำนวณที่เร็วขึ้นแสดงให้เห็นว่าสำหรับการวัดประสิทธิภาพที่นำเสนอ Oyster สามารถจัดการงานเดียวกันโดยใช้เวลาประมวลผลน้อยลงอย่างมาก ทำให้ได้เปรียบในแง่ของประสิทธิภาพและความเร็ว
สำหรับการใช้ AI แบบกระจายอำนาจที่ตรวจสอบได้อย่างกว้างขวาง ระบบการตรวจสอบการเข้ารหัสแบบออฟไลน์จะต้องเป็นมากกว่าการทำงานง่ายๆ เช่น การคำนวณกำลังสองน้อยที่สุดแบบธรรมดา ความก้าวหน้าที่สำคัญที่จำเป็นคือความสามารถในการจัดการกับงานที่ซับซ้อนมากขึ้น โดยเฉพาะอย่างยิ่งการเรียกใช้พร้อมท์อย่างมีประสิทธิภาพผ่าน LLM ยอดนิยม สิ่งนี้ต้องการพลังการประมวลผลที่เพิ่มขึ้น ประสิทธิภาพของอัลกอริธึม และความสามารถในการปรับขนาดเพื่อรองรับความต้องการที่ซับซ้อนและใช้ทรัพยากรมากของ LLM สมัยใหม่ ทำให้แอปพลิเคชัน AI ที่ซับซ้อนและหลากหลายมากขึ้นภายในกรอบงานแบบกระจายอำนาจ เฟรมเวิร์ก zkML ยังอยู่ในช่วงเริ่มต้น และในขั้นตอนนี้ ความสามารถในการจัดการกับสัญญาณเหล่านี้ถูกขัดขวางอย่างรุนแรง เนื่องจากการสร้างการพิสูจน์ zk เป็นงานที่ต้องใช้การคำนวณมาก
แม้ว่าโปรโตคอล zkML จะไม่แสดงให้ประมวลผล LLM แต่ก็สมเหตุสมผลที่จะถือว่าความแตกต่างของเวลาในการประมวลผลระหว่าง TEE ที่เชื่อถือได้ของ Oyster และเฟรมเวิร์ก zkML เหล่านี้มีความสำคัญพอๆ กับตัวอย่างที่กล่าวถึงก่อนหน้านี้ การใช้ Marlin’s Oyster สามารถสร้างผลลัพธ์เกณฑ์มาตรฐานสำหรับ LLM ต่างๆ ได้:
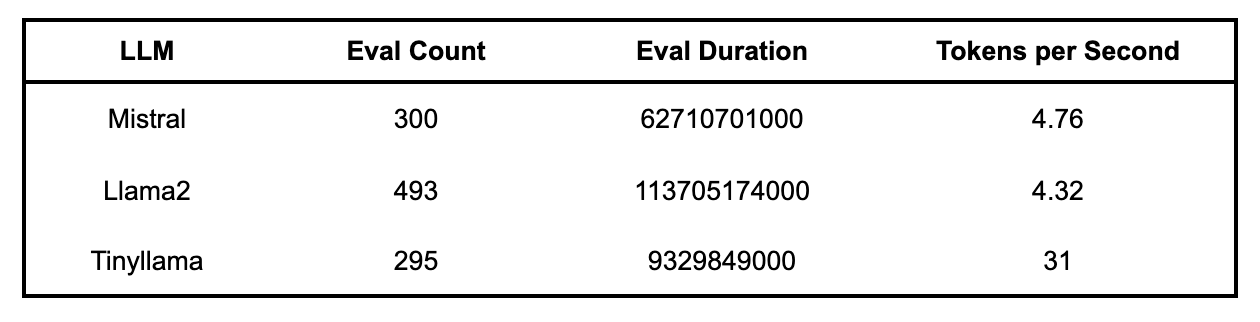
จำนวนการประเมิน: จำนวนโทเค็นในการตอบกลับ ระยะเวลาการประเมิน: นาโนวินาทีที่ใช้ในการสร้างการตอบสนอง
ผลลัพธ์การวัดประสิทธิภาพ GPT2-XL ภายใน Oyster:
การกำหนดค่าการกักกัน: 12 CPU, หน่วยความจำ 28 GB (c6a.4xlarge)
เคล็ดลับ: Ethereum เป็นเทคโนโลยีที่ดำเนินการโดยชุมชน
ผลลัพธ์: Ethereum เป็นเทคโนโลยีที่ดำเนินการโดยชุมชนที่ช่วยให้อินเทอร์เน็ตทำงานได้ เช่นเดียวกับที่ Linux ทำกับคอมพิวเตอร์ Ethereum จะเพิ่มขีดความสามารถให้กับอินเทอร์เน็ตในอนาคต
เวลาที่ใช้ในการสร้างเอาต์พุต: 22.091819524765015 วินาที
เครื่องหมายต่อวินาที: 1.6295624703815754 วินาที
ส่วนที่ 2: บทสรุป
การพัฒนาและการจัดจำหน่ายเทคโนโลยี AI ถูกครอบงำมากขึ้นโดยองค์กรขนาดใหญ่จำนวนไม่มากที่มีฮาร์ดแวร์ขั้นสูงและโมเดลที่ซับซ้อน สมาธิในระดับนี้ทำให้เกิดความกังวลเกี่ยวกับการเซ็นเซอร์ อคติโดยธรรมชาติ และการตรวจสอบความสมบูรณ์และความยุติธรรมของระบบ AI ในทางตรงกันข้าม หลักการพื้นฐานของสกุลเงินดิจิทัล กล่าวคือ การไม่ได้รับอนุญาตและการต่อต้านการเซ็นเซอร์ นำเสนอเส้นทางสู่การทำให้เทคโนโลยี AI เป็นประชาธิปไตย
ลักษณะการกระจายอำนาจและโอเพ่นซอร์สของเทคโนโลยีบล็อกเชนช่วยให้ปัญญาประดิษฐ์แบบกระจายอำนาจสามารถแข่งขันกับฝ่ายตรงข้ามแบบรวมศูนย์ได้ สิ่งนี้สามารถทำได้ผ่าน DePIN การพิสูจน์การเข้ารหัส และการใช้กลไกการเทียบเท่าคีย์สาธารณะและคีย์ส่วนตัว ซึ่งร่วมกันรับประกันการพัฒนาและการใช้ AI ที่ปลอดภัย โปร่งใส และยุติธรรม เพื่อให้ตระหนักถึงศักยภาพสูงสุดของปัญญาประดิษฐ์แบบกระจายอำนาจ โดยเฉพาะอย่างยิ่งในระบบนิเวศบล็อกเชน จำเป็นต้องมีโครงสร้างพื้นฐานการประมวลผลนอกเครือข่ายที่แข็งแกร่ง นี่เป็นสิ่งสำคัญสำหรับการจัดการงาน AI ที่ซับซ้อนอย่างมีประสิทธิภาพ แม่นยำ และตรวจสอบได้
ปัจจุบัน Trusted Execution Environments (TEE) กลายเป็นโซลูชันที่เป็นไปได้มากที่สุดเพื่อตอบสนองข้อกำหนดนี้ TEE มอบพื้นที่ดำเนินการที่ปลอดภัยและแยกออกจากกันสำหรับโค้ด ปกป้องความลับและความสมบูรณ์ของข้อมูลที่กำลังประมวลผล ทำให้เป็นตัวเลือกที่ดีที่สุดสำหรับการประมวลผลนอกเครือข่ายที่จำเป็นสำหรับบล็อกเชนสำหรับแอปพลิเคชัน AI เมื่อสาขานี้มีการพัฒนา ความก้าวหน้าในเทคโนโลยี เช่น zkML, FHE และการปรับปรุง Trusted Execution Environments (TEE) จะมีความสำคัญอย่างยิ่งต่อระบบนิเวศ AI ที่กระจายอำนาจเพื่อเอาชนะข้อจำกัดในปัจจุบัน การพัฒนานี้จะส่งเสริมสาขาปัญญาประดิษฐ์ที่เปิดกว้าง เข้าถึงได้ และปลอดภัยมากขึ้น ซึ่งสอดคล้องกับปรัชญาการกระจายอำนาจของชุมชน crypto





