


Foresight Ventures: มุมมองเชิงเหตุผลเกี่ยวกับเครือข่ายพลังงานคอมพิวเตอร์แบบกระจายอำนาจ


ชื่อระดับแรก
TL;DR
ในปัจจุบัน มีสองทิศทางหลักสำหรับการรวม AI + Crypto: พลังการประมวลผลแบบกระจายและ ZKML สำหรับ ZKML โปรดดูบทความก่อนหน้าของฉันบทความนี้จะวิเคราะห์และสะท้อนถึงเครือข่ายพลังการประมวลผลแบบกระจายศูนย์。
ภายใต้แนวโน้มการพัฒนาของ AI โมเดลขนาดใหญ่ทรัพยากรด้านพลังคอมพิวเตอร์จะเป็นสนามรบใหญ่ในทศวรรษหน้า และยังเป็นสิ่งที่สำคัญที่สุดสำหรับสังคมมนุษย์ในอนาคตและไม่เพียงแต่อยู่ในการแข่งขันทางการค้าเท่านั้น แต่ยังกลายเป็นทรัพยากรเชิงกลยุทธ์สำหรับเกมแห่งมหาอำนาจอีกด้วย ในอนาคต การลงทุนในโครงสร้างพื้นฐานการประมวลผลประสิทธิภาพสูงและพลังงานสำรองในการประมวลผลจะเพิ่มขึ้นแบบทวีคูณ
เครือข่ายพลังการประมวลผลแบบกระจายศูนย์มีความต้องการมากที่สุดสำหรับการฝึกอบรมแบบจำลองขนาดใหญ่ของ AI แต่ก็เผชิญกับความท้าทายและคอขวดทางเทคนิคที่ยิ่งใหญ่ที่สุดเช่นกัน รวมถึงความจำเป็นในการซิงโครไนซ์ข้อมูลที่ซับซ้อนและปัญหาการเพิ่มประสิทธิภาพเครือข่าย นอกจากนี้ ความเป็นส่วนตัวและความปลอดภัยของข้อมูลยังเป็นข้อจำกัดที่สำคัญอีกด้วย แม้ว่าเทคนิคที่มีอยู่บางอย่างสามารถให้วิธีแก้ปัญหาเบื้องต้นได้ แต่ก็ยังไม่สามารถใช้ได้กับงานการฝึกอบรมแบบกระจายขนาดใหญ่ เนื่องจากค่าใช้จ่ายในการคำนวณและการสื่อสารจำนวนมาก
เครือข่ายพลังการคำนวณแบบกระจายศูนย์มีโอกาสที่ดีกว่าในการลงจอดในเหตุผลแบบจำลอง และสามารถคาดการณ์ได้ว่าพื้นที่ส่วนเพิ่มในอนาคตก็ใหญ่เพียงพอเช่นกัน แต่ก็ยังเผชิญกับความท้าทายต่างๆ เช่น ความล่าช้าในการสื่อสาร ความเป็นส่วนตัวของข้อมูล และความปลอดภัยของโมเดล เมื่อเปรียบเทียบกับการฝึกอบรมแบบจำลอง การอนุมานมีความซับซ้อนในการคำนวณและการโต้ตอบกับข้อมูลต่ำกว่า และเหมาะสำหรับสภาพแวดล้อมแบบกระจาย
ชื่อระดับแรก
1. พลังการประมวลผลแบบกระจาย - การฝึกอบรมแบบจำลองขนาดใหญ่
เรากำลังพูดถึงการประยุกต์ใช้พลังการคำนวณแบบกระจายในการฝึกอบรม และโดยทั่วไปจะมุ่งเน้นไปที่การฝึกอบรมโมเดลภาษาขนาดใหญ่ เหตุผลหลักคือการฝึกอบรมโมเดลขนาดเล็กไม่ต้องการพลังการประมวลผลมากนัก เพื่อกระจายความเป็นส่วนตัวของข้อมูลและพวง ของโครงการ ปัญหาไม่คุ้มค่าควรแก้โดยตรงและจากส่วนกลางจะดีกว่า โมเดลภาษาขนาดใหญ่มีความต้องการพลังการประมวลผลอย่างมากและขณะนี้อยู่ในช่วงเริ่มต้นของการระเบิด จากปี 2012 ถึงปี 2018 ความต้องการพลังการประมวลผลของ AI จะเพิ่มขึ้นเป็นสองเท่าทุกๆ 4 เดือน ตอนนี้เป็นจุดรวมของความต้องการพลังการประมวลผล ซึ่งสามารถคาดการณ์ได้ว่าอีก 5-8 ปีข้างหน้าจะยังคงมีความต้องการที่เพิ่มขึ้นอย่างมาก
ชื่อเรื่องรอง
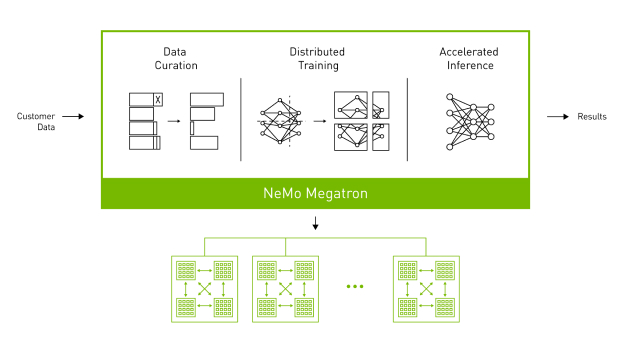
(NVIDIA NeMo Megatron Framework)
1. กระบวนการฝึกอบรมโดยรวม
ยกตัวอย่างเช่น การฝึกโมเดลขนาดใหญ่ที่มีพารามิเตอร์ 175 พันล้านพารามิเตอร์ เนื่องจากโมเดลมีขนาดใหญ่ จึงจำเป็นต้องฝึกพร้อมกันบนอุปกรณ์ GPU หลายตัว สมมติว่ามีห้องคอมพิวเตอร์ส่วนกลางที่มี GPU 100 ตัว และอุปกรณ์แต่ละเครื่องมีหน่วยความจำ 32 GB
การเตรียมข้อมูล: ก่อนอื่นจำเป็นต้องมีชุดข้อมูลขนาดใหญ่ซึ่งประกอบด้วยข้อมูลต่างๆ เช่น ข้อมูลทางอินเทอร์เน็ต ข่าว หนังสือ ฯลฯ ข้อมูลเหล่านี้จำเป็นต้องได้รับการประมวลผลล่วงหน้าก่อนการฝึกอบรม รวมถึงการล้างข้อความ การทำโทเค็น การสร้างคำศัพท์ ฯลฯ
การแบ่งส่วนข้อมูล: ข้อมูลที่ประมวลผลจะถูกแบ่งออกเป็นหลายกลุ่มสำหรับการประมวลผลแบบขนานบน GPU หลายตัว สมมติว่าขนาดแบทช์ที่เลือกคือ 512 นั่นคือ แต่ละแบทช์มีลำดับข้อความ 512 ลำดับ จากนั้น เราจะแบ่งชุดข้อมูลทั้งหมดออกเป็นชุดๆ เพื่อสร้างคิวชุดหนึ่งๆ
การถ่ายโอนข้อมูลระหว่างอุปกรณ์: ที่จุดเริ่มต้นของแต่ละขั้นตอนการฝึกอบรม CPU จะดึงแบทช์จากคิวแบทช์ จากนั้นจึงส่งข้อมูลของแบทช์นี้ไปยัง GPU ผ่านบัส PCIe สมมติว่าความยาวเฉลี่ยของลำดับข้อความแต่ละรายการคือ 1024 โทเค็น ขนาดข้อมูลของแต่ละชุดจะอยู่ที่ประมาณ 512 * 1024 * 4 B = 2 MB (โดยสมมติว่าแต่ละโทเค็นแสดงด้วยเลขทศนิยมที่มีความแม่นยำเดียว 4 ไบต์) กระบวนการถ่ายโอนข้อมูลนี้มักใช้เวลาเพียงไม่กี่มิลลิวินาที
การฝึกอบรมแบบคู่ขนาน: หลังจากที่อุปกรณ์ GPU แต่ละตัวได้รับข้อมูลแล้ว อุปกรณ์จะเริ่มทำการคำนวณแบบส่งต่อและย้อนกลับเพื่อคำนวณการไล่ระดับสีของแต่ละพารามิเตอร์ เนื่องจากโมเดลมีขนาดใหญ่ หน่วยความจำของ GPU ตัวเดียวจึงไม่สามารถเก็บพารามิเตอร์ทั้งหมดได้ เราจึงใช้เทคโนโลยีแบบขนานของโมเดลเพื่อกระจายพารามิเตอร์ของโมเดลไปยัง GPU หลายตัว
Gradient Aggregation และการปรับปรุงพารามิเตอร์: หลังจากการคำนวณ backpropagation เสร็จสิ้น GPU แต่ละตัวจะได้รับการไล่ระดับสีจากส่วนหนึ่งของพารามิเตอร์ จากนั้นจำเป็นต้องรวมการไล่ระดับสีเหล่านี้ในอุปกรณ์ GPU ทั้งหมดเพื่อคำนวณการไล่ระดับสีส่วนกลาง สิ่งนี้ต้องการการถ่ายโอนข้อมูลผ่านเครือข่าย และสมมติว่าเครือข่าย 25 Gbps จะใช้เวลาประมาณ 224 วินาทีในการถ่ายโอนข้อมูล 700 GB (ประมาณ 700 GB สำหรับพารามิเตอร์ 175 พันล้านพารามิเตอร์ โดยสมมติว่ามีจุดลอยตัวที่มีความแม่นยำจุดเดียวสำหรับแต่ละพารามิเตอร์) จากนั้น GPU แต่ละตัวจะอัปเดตพารามิเตอร์ที่เก็บไว้ตามการไล่ระดับสีทั่วโลก
ซิงโครไนซ์: หลังจากอัปเดตพารามิเตอร์แล้ว อุปกรณ์ GPU ทั้งหมดจำเป็นต้องซิงโครไนซ์เพื่อให้แน่ใจว่าอุปกรณ์ทั้งหมดใช้พารามิเตอร์โมเดลที่สอดคล้องกันสำหรับการฝึกขั้นต่อไป นอกจากนี้ยังต้องมีการถ่ายโอนข้อมูลผ่านเครือข่าย
ทำซ้ำขั้นตอนการฝึกอบรม: ทำซ้ำขั้นตอนข้างต้นจนกว่าการฝึกของแบทช์ทั้งหมดจะเสร็จสิ้น หรือถึงจำนวนรอบการฝึก (epoch) ที่กำหนดไว้ล่วงหน้า
ชื่อเรื่องรอง
2. คอขวดของค่าใช้จ่ายในการสื่อสาร:
ควรสังเกตว่าคอขวดของการสื่อสารยังเป็นสาเหตุของเครือข่ายพลังการคำนวณแบบกระจายในปัจจุบันไม่สามารถทำเช่นนี้ได้เหตุผลสำหรับการฝึกอบรมโมเดลภาษาขนาดใหญ่
แต่ละโหนดจำเป็นต้องแลกเปลี่ยนข้อมูลบ่อยครั้งเพื่อทำงานร่วมกัน ซึ่งสร้างค่าใช้จ่ายในการสื่อสาร สำหรับโมเดลภาษาขนาดใหญ่ ปัญหานี้ร้ายแรงเป็นพิเศษเนื่องจากพารามิเตอร์จำนวนมากของโมเดล ค่าโสหุ้ยการสื่อสารแบ่งออกเป็นลักษณะเหล่านี้:
การส่งข้อมูล: โหนดจำเป็นต้องแลกเปลี่ยนพารามิเตอร์โมเดลและข้อมูลการไล่ระดับสีระหว่างการฝึกบ่อยๆ สิ่งนี้ต้องการการส่งข้อมูลจำนวนมากในเครือข่าย ซึ่งใช้แบนด์วิธเครือข่ายจำนวนมาก หากเงื่อนไขของเครือข่ายไม่ดีหรือระยะห่างระหว่างโหนดคอมพิวเตอร์มีมาก ความล่าช้าในการรับส่งข้อมูลจะสูง และเพิ่มค่าใช้จ่ายในการสื่อสาร
ปัญหาการซิงค์: ในระหว่างการฝึกอบรม โหนดจำเป็นต้องทำงานร่วมกันเพื่อให้แน่ใจว่าการฝึกอบรมถูกต้อง สิ่งนี้ต้องการการดำเนินการซิงโครไนซ์บ่อยครั้งระหว่างโหนด เช่น การอัปเดตพารามิเตอร์โมเดล การคำนวณ Global Gradients เป็นต้น การดำเนินการแบบซิงโครนัสเหล่านี้จำเป็นต้องส่งข้อมูลจำนวนมากในเครือข่าย และจำเป็นต้องรอให้โหนดทั้งหมดดำเนินการจนเสร็จสิ้น ซึ่งจะทำให้เสียเวลาในการสื่อสารและเสียเวลารอคอยมาก
การสะสมและอัปเดตการไล่ระดับสี: ในระหว่างขั้นตอนการฝึกอบรม แต่ละโหนดจำเป็นต้องคำนวณการไล่ระดับสีของตนเอง และส่งไปยังโหนดอื่นเพื่อสะสมและอัปเดต สิ่งนี้ต้องการการส่งข้อมูลการไล่ระดับสีจำนวนมากในเครือข่าย และจำเป็นต้องรอให้โหนดทั้งหมดทำการคำนวณและส่งข้อมูลการไล่ระดับสีให้เสร็จสมบูรณ์ ซึ่งเป็นสาเหตุของค่าใช้จ่ายในการสื่อสารจำนวนมาก
ความสอดคล้องของข้อมูล: จำเป็นต้องตรวจสอบให้แน่ใจว่าพารามิเตอร์โมเดลของแต่ละโหนดสอดคล้องกัน สิ่งนี้ต้องการการตรวจสอบข้อมูลบ่อยครั้งและการดำเนินการซิงโครไนซ์ระหว่างโหนด ซึ่งส่งผลให้มีค่าใช้จ่ายในการสื่อสารจำนวนมาก
แม้ว่าจะมีบางวิธีในการลดค่าใช้จ่ายในการสื่อสาร เช่น การบีบอัดพารามิเตอร์และการไล่ระดับสี กลยุทธ์คู่ขนานที่มีประสิทธิภาพ ฯลฯ วิธีการเหล่านี้อาจเพิ่มภาระการคำนวณเพิ่มเติมหรือส่งผลเสียต่อผลการฝึกฝนของแบบจำลอง นอกจากนี้ วิธีการเหล่านี้ไม่สามารถแก้ปัญหาโอเวอร์เฮดการสื่อสารได้อย่างสมบูรณ์ โดยเฉพาะอย่างยิ่งในกรณีที่สภาพเครือข่ายไม่ดีหรือมีระยะห่างระหว่างโหนดคอมพิวเตอร์มาก
ตัวอย่างเช่น:
การกระจายอำนาจของเครือข่ายคอมพิวเตอร์แบบกระจายอำนาจ
โมเดล GPT-3 มีพารามิเตอร์ 175 พันล้านพารามิเตอร์ และถ้าเราแสดงพารามิเตอร์เหล่านี้โดยใช้เลขทศนิยมที่มีความแม่นยำเดียว (4 ไบต์ต่อพารามิเตอร์) การจัดเก็บพารามิเตอร์เหล่านี้ต้องใช้หน่วยความจำประมาณ 700 GB ในการฝึกอบรมแบบกระจาย พารามิเตอร์เหล่านี้จำเป็นต้องส่งและอัปเดตบ่อยๆ ระหว่างโหนดการคำนวณ
สมมติว่ามีโหนดการประมวลผล 100 โหนด แต่ละโหนดจำเป็นต้องอัปเดตพารามิเตอร์ทั้งหมดในแต่ละขั้นตอน จากนั้นแต่ละขั้นตอนจำเป็นต้องถ่ายโอนข้อมูลประมาณ 70 TB (700 GB* 100 ) หากเราถือว่าขั้นตอนหนึ่งใช้เวลา 1 วินาที (สมมติฐานในแง่ดีมาก) ก็จำเป็นต้องถ่ายโอนข้อมูล 70 TB ทุกๆ วินาที ความต้องการแบนด์วิธนี้เกินกว่าเครือข่ายส่วนใหญ่มากอยู่แล้ว และยังเป็นเรื่องของความเป็นไปได้อีกด้วย
ในความเป็นจริง เนื่องจากความล่าช้าในการสื่อสารและความแออัดของเครือข่าย เวลาในการรับส่งข้อมูลอาจนานกว่า 1 วินาทีมาก ซึ่งหมายความว่าโหนดคอมพิวเตอร์อาจต้องใช้เวลามากในการรอการส่งข้อมูลแทนการคำนวณจริง สิ่งนี้จะลดประสิทธิภาพของการฝึกอบรมลงอย่างมาก และการลดประสิทธิภาพนี้ไม่สามารถแก้ไขได้ด้วยการรอ แต่ความแตกต่างระหว่างความเป็นไปได้และเป็นไปไม่ได้ ซึ่งจะทำให้กระบวนการฝึกอบรมทั้งหมดเป็นไปไม่ได้
ห้องคอมพิวเตอร์ส่วนกลาง
แม้ในสภาพแวดล้อมห้องคอมพิวเตอร์แบบรวมศูนย์ การฝึกอบรมโมเดลขนาดใหญ่ยังคงต้องการการเพิ่มประสิทธิภาพการสื่อสารอย่างมาก
ในสภาพแวดล้อมห้องคอมพิวเตอร์ส่วนกลาง อุปกรณ์คอมพิวเตอร์ประสิทธิภาพสูงถูกใช้เป็นคลัสเตอร์ เชื่อมต่อผ่านเครือข่ายความเร็วสูงเพื่อแบ่งปันงานคอมพิวเตอร์ อย่างไรก็ตาม แม้ในขณะที่ฝึกโมเดลด้วยพารามิเตอร์จำนวนมากในสภาพแวดล้อมเครือข่ายความเร็วสูง โอเวอร์เฮดการสื่อสารยังคงเป็นปัญหาคอขวด เนื่องจากพารามิเตอร์และการไล่ระดับสีของโมเดลจำเป็นต้องส่งและอัปเดตบ่อยครั้งระหว่างอุปกรณ์คอมพิวเตอร์ต่างๆ .
ตามที่กล่าวไว้ในตอนต้น ให้ถือว่าโหนดคอมพิวท์ 100 โหนดที่มีแบนด์วิธเครือข่าย 25 Gbps ต่อเซิร์ฟเวอร์ หากทุกเซิร์ฟเวอร์จำเป็นต้องอัปเดตพารามิเตอร์ทั้งหมดในทุกขั้นตอนการฝึกอบรม จะใช้เวลาประมาณ 224 วินาทีในการถ่ายโอนข้อมูลประมาณ 700 GB ต่อขั้นตอนการฝึกอบรม ด้วยการใช้ประโยชน์จากห้องคอมพิวเตอร์ส่วนกลาง นักพัฒนาสามารถเพิ่มประสิทธิภาพโทโพโลยีเครือข่ายภายในศูนย์ข้อมูลและใช้เทคโนโลยี เช่น การขนานแบบจำลองเพื่อลดเวลานี้ลงอย่างมาก
ในทางตรงกันข้าม หากดำเนินการฝึกอบรมแบบเดียวกันในสภาพแวดล้อมแบบกระจาย สมมติว่ายังมีโหนดคอมพิวเตอร์ 100 โหนดกระจายอยู่ทั่วโลก แบนด์วิธเครือข่ายเฉลี่ยของแต่ละโหนดจะอยู่ที่ 1 Gbps เท่านั้น ในกรณีนี้ จะใช้เวลาประมาณ 5600 วินาทีในการถ่ายโอนข้อมูล 700 GB เดียวกัน ซึ่งนานกว่าในห้องคอมพิวเตอร์ส่วนกลางมาก นอกจากนี้ เนื่องจากความล่าช้าและความแออัดของเครือข่าย เวลาจริงที่ต้องใช้อาจนานกว่านั้น
อย่างไรก็ตาม เมื่อเปรียบเทียบกับสถานการณ์ในเครือข่ายพลังงานการประมวลผลแบบกระจาย การปรับค่าโสหุ้ยการสื่อสารให้เหมาะสมในสภาพแวดล้อมห้องคอมพิวเตอร์แบบรวมศูนย์นั้นค่อนข้างง่าย เนื่องจากในสภาพแวดล้อมห้องคอมพิวเตอร์ส่วนกลาง อุปกรณ์คอมพิวเตอร์มักจะเชื่อมต่อกับเครือข่ายความเร็วสูงเดียวกัน และแบนด์วิธและความล่าช้าของเครือข่ายก็ค่อนข้างดี ในเครือข่ายพลังการประมวลผลแบบกระจาย โหนดคอมพิวเตอร์อาจกระจายไปทั่วโลก และสภาพเครือข่ายอาจค่อนข้างแย่ ซึ่งทำให้ปัญหาด้านค่าใช้จ่ายในการสื่อสารรุนแรงมากขึ้น
ชื่อเรื่องรอง
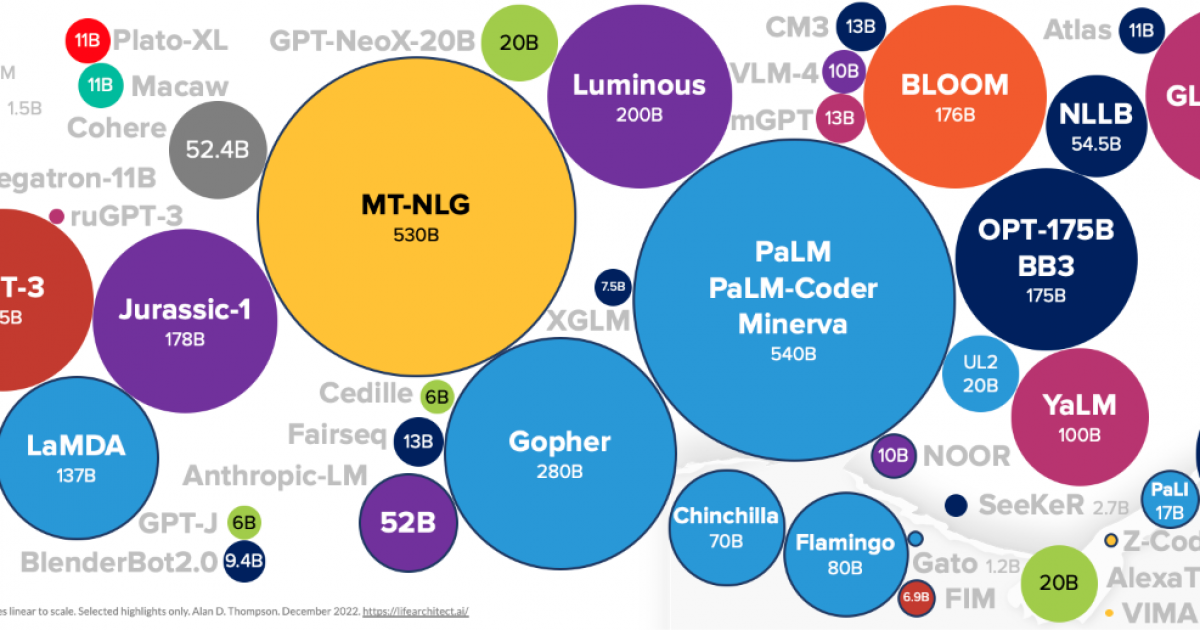
(Data used to train LLM models)
3. เหตุใดเครือข่ายพลังการคำนวณแบบกระจายจึงไม่สามารถเพิ่มประสิทธิภาพเหล่านี้ได้
สามารถทำได้ แต่เมื่อเทียบกับห้องคอมพิวเตอร์ส่วนกลาง ผลของการเพิ่มประสิทธิภาพเหล่านี้มีจำกัดมาก
1. การเพิ่มประสิทธิภาพโทโพโลยีเครือข่าย: ในห้องคอมพิวเตอร์ส่วนกลาง ฮาร์ดแวร์เครือข่ายและโครงร่างสามารถควบคุมได้โดยตรง ดังนั้นโทโพโลยีเครือข่ายจึงสามารถออกแบบและปรับให้เหมาะสมตามความต้องการ อย่างไรก็ตาม ในสภาพแวดล้อมแบบกระจาย โหนดคอมพิวเตอร์จะกระจายไปตามตำแหน่งที่ตั้งทางภูมิศาสตร์ที่แตกต่างกัน แม้แต่โหนดหนึ่งในประเทศจีนและหนึ่งในสหรัฐอเมริกา และไม่มีวิธีใดที่จะควบคุมการเชื่อมต่อเครือข่ายโดยตรงระหว่างกัน แม้ว่าจะสามารถใช้ซอฟต์แวร์เพื่อปรับเส้นทางการรับส่งข้อมูลให้เหมาะสม แต่ก็ไม่ได้ผลเท่ากับการปรับเครือข่ายฮาร์ดแวร์โดยตรง ในเวลาเดียวกัน เนื่องจากความแตกต่างของที่ตั้งทางภูมิศาสตร์ ความล่าช้าของเครือข่ายและแบนด์วิธจึงแตกต่างกันอย่างมาก ซึ่งจำกัดผลกระทบของการเพิ่มประสิทธิภาพโทโพโลยีเครือข่ายเพิ่มเติม
2. ความเท่าเทียมกันของแบบจำลองชื่อเรื่องรอง
4. ความท้าทายด้านความปลอดภัยของข้อมูลและความเป็นส่วนตัว
ลิงก์เกือบทั้งหมดที่เกี่ยวข้องกับการประมวลผลและการส่งข้อมูลอาจส่งผลต่อความปลอดภัยและความเป็นส่วนตัวของข้อมูล:
1. การกระจายข้อมูล: ข้อมูลการฝึกอบรมจำเป็นต้องกระจายไปยังแต่ละโหนดที่เข้าร่วมในการคำนวณ ข้อมูลในลิงก์นี้อาจถูกนำไปใช้ในทางที่ผิด/รั่วไหลบนโหนดแบบกระจาย
2. การฝึกอบรมแบบจำลอง: ในระหว่างขั้นตอนการฝึกอบรม แต่ละโหนดจะใช้ข้อมูลที่กำหนดสำหรับการคำนวณ จากนั้นจึงส่งออกการอัพเดตหรือการไล่ระดับสีของพารามิเตอร์โมเดล ในระหว่างกระบวนการนี้ หากกระบวนการคำนวณของโหนดถูกขโมยหรือผลลัพธ์ถูกวิเคราะห์อย่างมุ่งร้าย ข้อมูลก็อาจรั่วไหลได้เช่นกัน
3. การรวมพารามิเตอร์และการไล่ระดับสี: เอาต์พุตของแต่ละโหนดจำเป็นต้องรวมเพื่ออัปเดตโมเดลส่วนกลาง และการสื่อสารระหว่างการรวมอาจทำให้ข้อมูลเกี่ยวกับข้อมูลการฝึกอบรมรั่วไหลได้
อะไรคือวิธีแก้ปัญหาความเป็นส่วนตัวของข้อมูล?
การคำนวณแบบหลายฝ่ายที่ปลอดภัย: SMC ได้รับการนำไปใช้อย่างประสบความสำเร็จในงานการคำนวณขนาดเล็กที่เฉพาะเจาะจงบางอย่าง อย่างไรก็ตาม ในงานฝึกอบรมแบบกระจายขนาดใหญ่ เนื่องจากมีค่าใช้จ่ายในการคำนวณและการสื่อสารที่มาก จึงยังไม่มีการใช้งานอย่างแพร่หลาย
ความเป็นส่วนตัวที่แตกต่าง: นำไปใช้ในงานรวบรวมและวิเคราะห์ข้อมูลบางอย่าง เช่น สถิติผู้ใช้ของ Chrome แต่ในงานการเรียนรู้เชิงลึกขนาดใหญ่ DP จะมีผลกระทบต่อความแม่นยำของโมเดล ในขณะเดียวกัน ก็เป็นความท้าทายเช่นกันในการออกแบบกลไกการสร้างและการเพิ่มเสียงรบกวนที่เหมาะสม
การเรียนรู้แบบรวมศูนย์: นำไปใช้กับงานฝึกอบรมโมเดลอุปกรณ์ Edge เช่น การคาดเดาคำศัพท์สำหรับแป้นพิมพ์ Android เป็นต้น แต่ในงานฝึกอบรมแบบกระจายขนาดใหญ่ FL ประสบปัญหาเช่นค่าใช้จ่ายในการสื่อสารสูงและการประสานงานที่ซับซ้อน
การเข้ารหัสแบบโฮโมมอร์ฟิก: ประสบความสำเร็จในการใช้งานบางอย่างที่มีความซับซ้อนในการคำนวณเล็กน้อย อย่างไรก็ตาม ในงานฝึกอบรมแบบกระจายขนาดใหญ่ เนื่องจากมีค่าใช้จ่ายในการคำนวณสูง จึงยังไม่มีการใช้งานอย่างแพร่หลาย
สรุป
วิธีการข้างต้นแต่ละวิธีมีสถานการณ์และข้อจำกัดที่เกี่ยวข้อง และไม่มีวิธีการใดที่สามารถแก้ปัญหาความเป็นส่วนตัวของข้อมูลได้อย่างสมบูรณ์ในการฝึกอบรมโมเดลขนาดใหญ่ของเครือข่ายพลังการประมวลผลแบบกระจาย
ZK ซึ่งมีความหวังสูงจะแก้ปัญหาความเป็นส่วนตัวของข้อมูลในการฝึกอบรมแบบจำลองขนาดใหญ่ได้หรือไม่
ตามทฤษฎีแล้ว ZKP สามารถใช้เพื่อรับประกันความเป็นส่วนตัวของข้อมูลในการประมวลผลแบบกระจาย ทำให้โหนดสามารถพิสูจน์ได้ว่ามีการคำนวณตามระเบียบข้อบังคับ แต่ไม่จำเป็นต้องเปิดเผยข้อมูลอินพุตและเอาต์พุตจริง
แต่ในความเป็นจริง ปัญหาคอขวดต่อไปนี้เกิดขึ้นในสถานการณ์ของการใช้ ZKP สำหรับการฝึกอบรมโมเดลขนาดใหญ่ของเครือข่ายพลังงานการประมวลผลแบบกระจายขนาดใหญ่:
ค่าใช้จ่ายในการคำนวณและการสื่อสาร: การสร้างและตรวจสอบหลักฐานที่ไม่มีความรู้ต้องใช้ทรัพยากรคอมพิวเตอร์จำนวนมาก นอกจากนี้ ZKP มีค่าใช้จ่ายสูงในการสื่อสารเนื่องจากจำเป็นต้องส่งหลักฐานเอง ค่าโสหุ้ยเหล่านี้อาจมีความสำคัญอย่างยิ่งในกรณีของการฝึกอบรมแบบจำลองขนาดใหญ่ ตัวอย่างเช่น หากการคำนวณของแต่ละมินิแบทช์จำเป็นต้องสร้างการพิสูจน์ สิ่งนี้สามารถเพิ่มเวลาและค่าใช้จ่ายในการฝึกอบรมโดยรวมได้อย่างมาก
ความซับซ้อนของโปรโตคอล ZK: การออกแบบและนำโปรโตคอล ZKP ไปใช้ให้เหมาะสมกับการฝึกโมเดลขนาดใหญ่อาจมีความซับซ้อนมาก โปรโตคอลนี้จำเป็นต้องสามารถจัดการกับข้อมูลขนาดใหญ่และการคำนวณที่ซับซ้อนได้ และจำเป็นต้องสามารถจัดการกับข้อผิดพลาดที่ผิดปกติที่อาจเกิดขึ้นได้
ความเข้ากันได้ของฮาร์ดแวร์และซอฟต์แวร์: การใช้ ZKP จำเป็นต้องมีการสนับสนุนฮาร์ดแวร์และซอฟต์แวร์เฉพาะ ซึ่งอาจไม่มีในอุปกรณ์คอมพิวเตอร์แบบกระจายทั้งหมด
สรุป
ชื่อระดับแรก
2. พลังการคำนวณแบบกระจาย—การให้เหตุผลแบบจำลอง
อีกสถานการณ์หนึ่งที่ค่อนข้างใหญ่ของการประมวลผลแบบกระจายคือการให้เหตุผลของโมเดล ตามวิจารณญาณของเราเกี่ยวกับเส้นทางการพัฒนาของโมเดลขนาดใหญ่ ความต้องการในการฝึกอบรมโมเดลจะค่อยๆ ช้าลงเมื่อโมเดลขนาดใหญ่เติบโตขึ้นหลังจากผ่านจุดสูง ข้อกำหนดการอนุมานจะเพิ่มขึ้นเป็นทวีคูณตามลำดับ ด้วยวุฒิภาวะของรุ่นใหญ่และAIGC
ชื่อเรื่องรอง

(Power LLM inference with NVIDIA Triton)
1. ความท้าทาย
ความล่าช้าในการสื่อสาร:
ในสภาพแวดล้อมแบบกระจาย การสื่อสารระหว่างโหนดเป็นสิ่งสำคัญ ในเครือข่ายพลังการคำนวณแบบกระจายศูนย์ โหนดอาจกระจายไปทั่วโลก ดังนั้นเวลาแฝงของเครือข่ายอาจเป็นปัญหาได้ โดยเฉพาะอย่างยิ่งสำหรับงานการให้เหตุผลที่ต้องการการตอบสนองแบบเรียลไทม์
การปรับใช้โมเดลและการอัปเดต:
ต้องปรับใช้โมเดลกับแต่ละโหนด หากมีการอัปเดตโมเดล แต่ละโหนดจำเป็นต้องอัปเดตโมเดลของตน ซึ่งใช้แบนด์วิธเครือข่ายและเวลาจำนวนมาก
ความเป็นส่วนตัวของข้อมูล:
แม้ว่างานการอนุมานมักจะต้องการเพียงข้อมูลป้อนเข้าและแบบจำลอง และไม่จำเป็นต้องส่งคืนข้อมูลกลางและพารามิเตอร์จำนวนมาก แต่ข้อมูลที่ป้อนอาจยังมีข้อมูลที่ละเอียดอ่อน เช่น ข้อมูลส่วนบุคคลของผู้ใช้
ความปลอดภัยของโมเดล:
ในเครือข่ายแบบกระจายอำนาจ โมเดลจำเป็นต้องปรับใช้บนโหนดที่ไม่น่าเชื่อถือ ซึ่งจะนำไปสู่การรั่วไหลของโมเดลและนำไปสู่ปัญหาสิทธิ์ในทรัพย์สินของโมเดลและการละเมิด สิ่งนี้ยังทำให้เกิดความกังวลด้านความปลอดภัยและความเป็นส่วนตัว หากโมเดลถูกใช้เพื่อประมวลผลข้อมูลที่ละเอียดอ่อน โหนดสามารถอนุมานข้อมูลที่ละเอียดอ่อนได้โดยการวิเคราะห์พฤติกรรมของโมเดล
ควบคุมคุณภาพ:
ชื่อเรื่องรอง
2. ความเป็นไปได้
ความซับซ้อนในการคำนวณ:
ในขั้นตอนการฝึกอบรม แบบจำลองจำเป็นต้องวนซ้ำๆ ในระหว่างขั้นตอนการฝึกอบรม จำเป็นต้องคำนวณการแพร่กระจายไปข้างหน้าและย้อนกลับของแต่ละชั้น รวมถึงการคำนวณฟังก์ชันการเปิดใช้งาน การคำนวณฟังก์ชันการสูญเสีย การคำนวณ การไล่ระดับสีและการอัพเดทน้ำหนัก ดังนั้นความซับซ้อนในการคำนวณของการฝึกอบรมแบบจำลองจึงสูง
ในขั้นตอนการอนุมาน ต้องใช้การส่งต่อเพียงครั้งเดียวเพื่อคำนวณการทำนาย ตัวอย่างเช่น ใน GPT-3 ข้อความอินพุตจำเป็นต้องแปลงเป็นเวกเตอร์ จากนั้นจึงส่งต่อผ่านแต่ละเลเยอร์ของโมเดล (โดยปกติคือเลเยอร์ Transformer) และสุดท้ายจะได้การแจกแจงความน่าจะเป็นเอาต์พุต และสร้างคำถัดไป ตามการแจกแจงนี้. ใน GAN โมเดลจำเป็นต้องสร้างภาพจากเวกเตอร์สัญญาณรบกวนอินพุต การดำเนินการเหล่านี้เกี่ยวข้องกับการเผยแพร่โมเดลไปข้างหน้าเท่านั้น ไม่จำเป็นต้องคำนวณการไล่ระดับสีหรืออัปเดตพารามิเตอร์ และมีความซับซ้อนในการคำนวณต่ำ
การโต้ตอบข้อมูล:
ในระหว่างขั้นตอนการอนุมาน โมเดลมักจะประมวลผลอินพุตเดียวแทนที่จะเป็นชุดข้อมูลจำนวนมากในระหว่างการฝึกอบรม ผลลัพธ์ของการอนุมานแต่ละครั้งขึ้นอยู่กับอินพุตปัจจุบันเท่านั้น ไม่ใช่อินพุตหรือเอาต์พุตอื่น ดังนั้นจึงไม่จำเป็นต้องมีการโต้ตอบกับข้อมูลจำนวนมาก และความกดดันในการสื่อสารก็น้อยลง
ยกตัวอย่างโมเดลการสร้างภาพ สมมติว่าเราใช้ GAN เพื่อสร้างภาพ เราเพียงแค่ป้อนเวกเตอร์สัญญาณรบกวนให้กับโมเดล จากนั้นโมเดลจะสร้างภาพที่สอดคล้องกัน ในกระบวนการนี้ แต่ละอินพุตจะสร้างเอาต์พุตเดียวเท่านั้น และไม่มีการพึ่งพาระหว่างเอาต์พุต ดังนั้นจึงไม่จำเป็นต้องมีการโต้ตอบกับข้อมูล
ยกตัวอย่าง GPT-3 แต่ละรุ่นของคำถัดไปต้องการเพียงการป้อนข้อความปัจจุบันและสถานะของโมเดล และไม่จำเป็นต้องโต้ตอบกับอินพุตหรือเอาต์พุตอื่น ดังนั้นข้อกำหนดสำหรับการโต้ตอบกับข้อมูลจึงอ่อนแอเช่นกัน
สรุป
ชื่อระดับแรก
3. โครงการ
คำอธิบายภาพ
1.Together
(RedPajama from Together)
Together เป็นบริษัทที่มุ่งเน้นไปที่โอเพ่นซอร์สของโมเดลขนาดใหญ่ และมุ่งมั่นที่จะแก้ปัญหาการประมวลผล AI แบบกระจายศูนย์ โดยหวังว่าทุกคนจากทุกที่จะสามารถเข้าถึงและใช้ AI ได้ ร่วมกันเพิ่งปิดรอบเมล็ดพันธุ์มูลค่า 20 ล้านเหรียญสหรัฐที่นำโดย Lux Capital
ร่วมกันก่อตั้งโดย Chris, Percy และ Ce ความตั้งใจเดิมคือการฝึกอบรมแบบจำลองขนาดใหญ่ต้องใช้คลัสเตอร์ GPU ระดับไฮเอนด์จำนวนมากและมีค่าใช้จ่ายสูง และทรัพยากร และความสามารถในการฝึกอบรมแบบจำลองเหล่านี้ยังกระจุกตัวอยู่ในบริษัทขนาดใหญ่เพียงไม่กี่แห่ง .
จากมุมมองของฉัน แผนการประกอบการที่สมเหตุสมผลกว่าสำหรับพลังการประมวลผลแบบกระจายคือ:
ขั้นตอนที่ 1 โมเดลโอเพ่นซอร์ส
ในการใช้การให้เหตุผลแบบจำลองในเครือข่ายพลังการประมวลผลแบบกระจายอำนาจ ข้อกำหนดเบื้องต้นคือโหนดต้องสามารถรับแบบจำลองได้ในราคาประหยัด กล่าวคือ แบบจำลองที่ใช้เครือข่ายพลังการประมวลผลแบบกระจายอำนาจจะต้องเป็นโอเพ่นซอร์ส (หากแบบจำลอง จำเป็นต้องได้รับใบอนุญาตที่เกี่ยวข้อง หากใช้ด้านล่างจะเพิ่มความซับซ้อนและค่าใช้จ่ายในการดำเนินการ) ตัวอย่างเช่น chatgpt ซึ่งเป็นโมเดลที่ไม่ใช่โอเพ่นซอร์ส ไม่เหมาะสำหรับการดำเนินการบนเครือข่ายพลังการประมวลผลแบบกระจายอำนาจ
ดังนั้นจึงสามารถคาดเดาได้ว่าอุปสรรคที่มองไม่เห็นของบริษัทที่ให้บริการเครือข่ายพลังการประมวลผลแบบกระจายอำนาจจำเป็นต้องมีการพัฒนาแบบจำลองขนาดใหญ่ที่แข็งแกร่งและความสามารถในการบำรุงรักษา การพัฒนาตนเองและโอเพ่นซอร์สโมเดลพื้นฐานที่ทรงพลังสามารถกำจัดการพึ่งพาโอเพ่นซอร์สโมเดลของบุคคลที่สามได้ในระดับหนึ่ง และแก้ปัญหาพื้นฐานที่สุดของเครือข่ายพลังการประมวลผลแบบกระจายอำนาจ ในขณะเดียวกัน ก็เอื้อต่อการพิสูจน์ว่าเครือข่ายพลังการประมวลผลสามารถดำเนินการฝึกอบรมและให้เหตุผลกับแบบจำลองขนาดใหญ่ได้อย่างมีประสิทธิภาพ
และร่วมกันทำเช่นเดียวกัน RedPajama ที่ใช้ LLaMA ที่เพิ่งเปิดตัวได้รับการเปิดตัวร่วมกันโดยทีมต่างๆ ได้แก่ Together, Ontocord.ai, ETH DS 3 Lab, Stanford CRFM และ Hazy Research เป้าหมายคือการพัฒนาชุดโมเดลภาษาขนาดใหญ่แบบโอเพ่นซอร์สเต็มรูปแบบ
ขั้นตอนที่ 2 ใช้พลังการประมวลผลแบบกระจายในการให้เหตุผลแบบจำลอง
ตามที่กล่าวไว้ในสองส่วนข้างต้น เมื่อเปรียบเทียบกับการฝึกอบรมแบบจำลอง การอนุมานแบบจำลองมีความซับซ้อนในการคำนวณและการโต้ตอบกับข้อมูลต่ำกว่า และเหมาะสำหรับสภาพแวดล้อมแบบกระจายศูนย์มากกว่า
บนพื้นฐานของโมเดลโอเพ่นซอร์ส ทีม R&D ของ Together ได้ทำการอัปเดตโมเดล RedPajama-INCITE-3 B เช่น การใช้ LoRA เพื่อให้ได้การปรับแต่งที่มีต้นทุนต่ำ ทำให้โมเดลทำงานบน CPU (โดยเฉพาะอย่างยิ่ง MacBook ที่ใช้โปรเซสเซอร์ M 2 Pro) Pro) เพื่อให้โมเดลทำงานลื่นขึ้น ในขณะเดียวกัน แม้ว่าสเกลของโมเดลนี้จะมีขนาดเล็ก แต่ความสามารถของมันนั้นเหนือกว่าโมเดลอื่นๆ ในสเกลเดียวกัน และมันถูกนำไปใช้จริงในสถานการณ์ทางกฎหมาย สังคม และสถานการณ์อื่นๆ
คำอธิบายภาพ
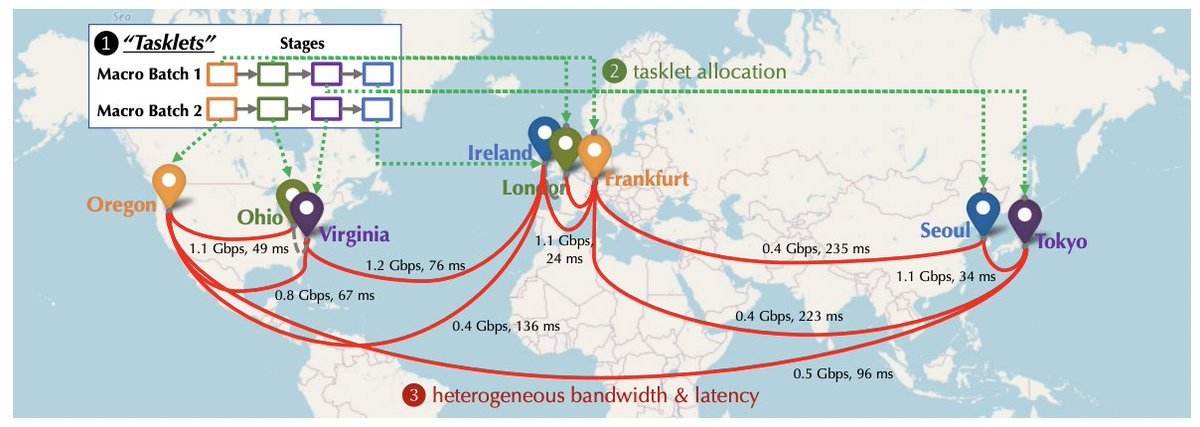
(แผนผังของเครือข่ายพลังการประมวลผลของการเอาชนะคอขวดการสื่อสารสำหรับการฝึกอบรมแบบกระจายอำนาจ)
ในระยะกลางและระยะยาว แม้จะเผชิญกับความท้าทายที่ยิ่งใหญ่และปัญหาคอขวดทางเทคนิค แต่การดำเนินการตามความต้องการด้านพลังการประมวลผลสำหรับการฝึกอบรมแบบจำลองขนาดใหญ่ของ AI จะต้องเป็นสิ่งที่น่าสนใจที่สุด ร่วมกันเริ่มวางแนวทางที่จะเอาชนะคอขวดของการสื่อสารในการฝึกอบรมแบบกระจายอำนาจในช่วงเริ่มต้นของการก่อตั้ง พวกเขายังได้เผยแพร่เอกสารที่เกี่ยวข้องกับ NeurIPS 2022:Overcoming Communication Bottlenecks for Decentralized Training. เราสามารถสรุปแนวทางหลักๆ ได้ดังนี้
การเพิ่มประสิทธิภาพการจัดกำหนดการ
เมื่อฝึกอบรมในสภาพแวดล้อมแบบกระจายศูนย์ สิ่งสำคัญคือต้องมอบหมายงานที่มีการสื่อสารสูงให้กับอุปกรณ์ที่มีการเชื่อมต่อที่เร็วกว่า เนื่องจากการเชื่อมต่อระหว่างโหนดมีเวลาแฝงและแบนด์วิธที่แตกต่างกัน ร่วมกันสร้างแบบจำลองเพื่ออธิบายต้นทุนของกลยุทธ์การจัดกำหนดการเฉพาะ และปรับปรุงกลยุทธ์การจัดกำหนดการให้ดียิ่งขึ้นเพื่อลดต้นทุนการสื่อสารและเพิ่มปริมาณการฝึกอบรมสูงสุด ทีม Together ยังพบว่าแม้เครือข่ายจะทำงานช้าลง 100 เท่า แต่ทรูพุตการฝึกอบรมแบบ end-to-end ก็ช้าลงเพียง 1.7 ถึง 2.3 เท่า ดังนั้นจึงเป็นเรื่องที่น่าสนใจที่จะจับช่องว่างระหว่างเครือข่ายแบบกระจายและคลัสเตอร์แบบรวมศูนย์ผ่านการเพิ่มประสิทธิภาพการตั้งเวลา
การเพิ่มประสิทธิภาพการบีบอัดการสื่อสาร
ร่วมกันเสนอการบีบอัดการสื่อสารสำหรับการเปิดใช้งานไปข้างหน้าและการไล่ระดับสีย้อนหลัง และแนะนำอัลกอริทึม AQ-SGD ซึ่งให้การรับประกันที่เข้มงวดสำหรับการบรรจบกันของการไล่ระดับสีแบบสุ่ม AQ-SGD สามารถปรับแต่งโมเดลพื้นฐานขนาดใหญ่บนเครือข่ายที่ช้า (เช่น 500 Mbps) โดยมีประสิทธิภาพการฝึกอบรมแบบ end-to-end ที่ช้าลงเพียง 31% บนเครือข่ายส่วนกลาง (เช่น 10 Gbps) โดยไม่มีการบีบอัด นอกจากนี้ AQ-SGD สามารถใช้ร่วมกับเทคนิคการบีบอัดการไล่ระดับสีที่ล้ำสมัย เช่น QuantizedAdam เพื่อให้ได้ความเร็วแบบ end-to-end 10%
สรุปโครงการ
การกำหนดค่าทีมร่วมกันนั้นครอบคลุมมาก สมาชิกมีพื้นฐานทางวิชาการที่แข็งแกร่งมาก ตั้งแต่การพัฒนาโมเดลขนาดใหญ่ การประมวลผลแบบคลาวด์ไปจนถึงการปรับแต่งฮาร์ดแวร์ได้รับการสนับสนุนโดยผู้เชี่ยวชาญในอุตสาหกรรม และ Together ได้แสดงท่าทางในระยะยาวและอดทนในการวางแผนเส้นทาง ตั้งแต่การพัฒนาโมเดลขนาดใหญ่แบบโอเพ่นซอร์สไปจนถึงการทดสอบพลังการประมวลผลที่ไม่ได้ใช้งาน (เช่น mac) ในเครือข่ายพลังการประมวลผลแบบกระจายโดยใช้เหตุผลของแบบจำลอง จากนั้นจึงกระจายพลังการประมวลผลในรูปแบบขนาดใหญ่บน การฝึกอบรมแบบจำลอง — มีการสะสมและรู้สึกผมบาง :)
คำอธิบายภาพ
2.Gensyn.ai
(Gensyn.ai)
จากเส้นทางทางเทคนิคของ Together เราสามารถเข้าใจอย่างคร่าว ๆ เกี่ยวกับกระบวนการดำเนินการของเครือข่ายพลังการประมวลผลแบบกระจายอำนาจในการฝึกอบรมแบบจำลองและการใช้เหตุผล ตลอดจนลำดับความสำคัญของการวิจัยและพัฒนาที่สอดคล้องกัน
ประเด็นสำคัญอีกประการที่ละเลยไม่ได้คือการออกแบบอัลกอริทึมเลเยอร์แรงจูงใจ/ฉันทามติของเครือข่ายพลังการประมวลผล ตัวอย่างเช่น เครือข่ายที่ยอดเยี่ยมจำเป็นต้องมี:
1. ตรวจสอบให้แน่ใจว่าผลประโยชน์นั้นน่าสนใจเพียงพอ
2. ตรวจสอบให้แน่ใจว่าคนงานเหมืองแต่ละคนได้รับผลประโยชน์ที่สมควรได้รับ รวมทั้งการต่อต้านการโกงและค่าตอบแทนที่มากขึ้นสำหรับงานที่มากขึ้น
3. ตรวจสอบให้แน่ใจว่างานได้รับการกำหนดเวลาและจัดสรรบนโหนดต่างๆ โดยตรงและสมเหตุสมผล และจะไม่มีโหนดที่ไม่ได้ใช้งานจำนวนมากหรือมีโหนดบางโหนดมากเกินไป
4. อัลกอริทึมแรงจูงใจนั้นง่ายและมีประสิทธิภาพและจะไม่ทำให้ระบบมีภาระและความล่าช้ามากเกินไป
……
ดูว่า Gensyn.ai ทำได้อย่างไร:
กลายเป็นโหนด
ตรวจสอบ
ตรวจสอบ
Solver สร้างจุดตรวจสอบหลายจุดในขณะที่อัปเดตพารามิเตอร์ (เพื่อให้แน่ใจว่ามีความโปร่งใสและตรวจสอบย้อนกลับของงานได้) และสร้างหลักฐานการให้เหตุผลแบบเข้ารหัสลับเป็นระยะ (หลักฐานความคืบหน้าของงาน) เกี่ยวกับงาน
เมื่อ Solver ทำงานเสร็จสิ้นและสร้างส่วนหนึ่งของผลการคำนวณ โปรโตคอลจะเลือกผู้ตรวจสอบ และผู้ตรวจสอบจะจำนำเงินจำนวนหนึ่งด้วย (เพื่อให้แน่ใจว่าผู้ตรวจสอบดำเนินการตรวจสอบอย่างตรงไปตรงมา) และตัดสินใจว่าส่วนใดของการคำนวณ ผลลัพธ์จะต้องได้รับการตรวจสอบตามหลักฐานที่ให้ไว้ด้านบน
หากผู้แก้ปัญหาและผู้ตรวจสอบแตกต่างกัน
ผ่านโครงสร้างข้อมูลแบบต้นไม้ของ Merkle ค้นหาตำแหน่งที่แน่นอนซึ่งผลการคำนวณแตกต่างกัน การดำเนินการตรวจสอบทั้งหมดจะเป็นห่วงโซ่ และผู้โกงจะถูกหักออกจากจำนวนเงินที่จำนำ
สรุปโครงการ
การออกแบบอัลกอริทึมแรงจูงใจและการตรวจสอบทำให้ Gensyn.ai ไม่จำเป็นต้องเล่นซ้ำผลลัพธ์ทั้งหมดของงานคอมพิวเตอร์ทั้งหมดในระหว่างกระบวนการตรวจสอบ แต่จำเป็นต้องคัดลอกและตรวจสอบผลลัพธ์เพียงบางส่วนตามหลักฐานที่ให้ไว้ ซึ่งช่วยปรับปรุงอย่างมาก ประสิทธิภาพของการตรวจสอบ ในขณะเดียวกัน โหนดจำเป็นต้องจัดเก็บเพียงบางส่วนของผลการคำนวณ ซึ่งยังลดการใช้พื้นที่จัดเก็บและทรัพยากรการประมวลผลอีกด้วย นอกจากนี้โหนดการโกงที่อาจเกิดขึ้นไม่สามารถคาดเดาได้ว่าส่วนใดจะถูกเลือกสำหรับการตรวจสอบ ดังนั้นสิ่งนี้จึงช่วยลดความเสี่ยงของการโกงด้วย
วิธีการตรวจสอบความแตกต่างและค้นหาผู้โกงนี้ยังสามารถค้นหาข้อผิดพลาดในกระบวนการคำนวณได้อย่างรวดเร็วโดยไม่ต้องเปรียบเทียบผลการคำนวณทั้งหมด (เริ่มจาก root node ของ Merkle tree และสำรวจทีละขั้นตอน) มีประสิทธิภาพมากสำหรับงานคอมพิวเตอร์ขนาดใหญ่
กล่าวโดยย่อ เป้าหมายการออกแบบของชั้นสิ่งจูงใจ/การยืนยันของ Gensyn.ai คือ: เรียบง่ายและมีประสิทธิภาพ อย่างไรก็ตาม ขณะนี้ยังจำกัดอยู่เพียงระดับทฤษฎีเท่านั้น และการดำเนินการเฉพาะอาจเผชิญกับความท้าทายดังต่อไปนี้:
ในแบบจำลองทางเศรษฐกิจ วิธีการตั้งค่าพารามิเตอร์ที่เหมาะสมเพื่อให้สามารถป้องกันการฉ้อโกงได้อย่างมีประสิทธิภาพโดยไม่กำหนดเกณฑ์ที่สูงเกินไปสำหรับผู้เข้าร่วม
ในแง่ของการใช้งานทางเทคนิค วิธีการสร้างการพิสูจน์การให้เหตุผลการเข้ารหัสเป็นระยะที่มีประสิทธิภาพยังเป็นปัญหาที่ซับซ้อนที่ต้องใช้ความรู้ด้านการเข้ารหัสขั้นสูง
ชื่อระดับแรก
4. คิดถึงอนาคต
คำถามที่ว่าใครต้องการเครือข่ายอำนาจการประมวลผลแบบกระจายอำนาจยังไม่ได้รับการยืนยัน การประยุกต์ใช้พลังการประมวลผลที่ไม่ได้ใช้งานกับการฝึกอบรมแบบจำลองขนาดใหญ่ที่ต้องใช้ทรัพยากรพลังการประมวลผลขนาดใหญ่นั้นเห็นได้ชัดว่าเหมาะสมที่สุดและเป็นพื้นที่ที่มีจินตนาการมากที่สุด แต่ในความเป็นจริงแล้ว ปัญหาคอขวด เช่น การสื่อสารและความเป็นส่วนตัว ทำให้เราคิดใหม่ว่า
มีความหวังสำหรับการฝึกอบรมแบบกระจายอำนาจของรุ่นใหญ่หรือไม่?
หากคุณข้ามความเห็นพ้องต้องกันนี้ "สถานการณ์การลงจอดที่เหมาะสมที่สุด" ไม่ว่าจะใช้พลังการประมวลผลแบบกระจายอำนาจกับการฝึกอบรมโมเดล AI ขนาดเล็กหรือไม่ก็เป็นสถานการณ์ใหญ่เช่นกัน จากมุมมองทางเทคนิค ปัจจัยจำกัด ปัจจุบันได้รับการแก้ไขแล้วเนื่องจากขนาดและสถาปัตยกรรมของโมเดล ขณะเดียวกัน จากมุมมองของตลาด เรารู้สึกเสมอว่าการฝึกอบรมโมเดลขนาดใหญ่จะยิ่งใหญ่จาก ถึงอนาคตแล้ว แต่ตลาดสำหรับโมเดล AI ขนาดเล็กยังไม่น่าสนใจ?
ข้อจำกัดความรับผิดชอบ: บทความ Foresight Ventures ทั้งหมดไม่ได้มีไว้เพื่อเป็นคำแนะนำในการลงทุน การลงทุนมีความเสี่ยง โปรดประเมินการยอมรับความเสี่ยงส่วนบุคคลและตัดสินใจลงทุนอย่างรอบคอบ
Reference
https://www.together.xyz/blog/neurips-2022-overcoming-communication-bottlenecks-for-decentralized-training-12
https://www.together.xyz/blog/redpajama
https://docs.gensyn.ai/litepaper/
https://www.nvidia.com/en-in/deep-learning-ai/solutions/large-language-models/
https://indiaai.gov.in/article/training-data-used-to-train-llm-models
เกี่ยวกับ Foresight Ventures
Foresight Ventures เดิมพันกับนวัตกรรมของสกุลเงินดิจิทัลในอีกไม่กี่ทศวรรษข้างหน้า บริษัทจัดการกองทุนหลายแห่ง: กองทุน VC, กองทุนการจัดการรองที่ใช้งานอยู่, FOF หลายกลยุทธ์, กองทุน S วัตถุประสงค์พิเศษ "Foresight Secondary Fund l" โดยมีขนาดการจัดการสินทรัพย์รวมเท่ากับ มากกว่า 4 หนึ่งร้อยล้านเหรียญสหรัฐ Foresight Ventures ยึดมั่นในแนวคิด "ไม่ซ้ำใคร เป็นอิสระ ก้าวร้าว ระยะยาว" และให้การสนับสนุนอย่างกว้างขวางสำหรับโครงการผ่านพลังทางนิเวศวิทยาที่แข็งแกร่ง ทีมงานมาจากบุคลากรอาวุโสจากบริษัทการเงินและเทคโนโลยีชั้นนำ เช่น Sequoia China, CICC, Google, Bitmain เป็นต้น
Website: https://www.foresightventures.com
ข้อจำกัดความรับผิดชอบ: บทความ Foresight Ventures ทั้งหมดไม่ได้มีไว้เพื่อเป็นคำแนะนำในการลงทุน การลงทุนมีความเสี่ยง โปรดประเมินการยอมรับความเสี่ยงส่วนบุคคลและตัดสินใจลงทุนอย่างรอบคอบ





