


SignalPlus: 生成 AI の概要


序文
“What I cannot create, I do not understand.”
-Richard Feynman
序文
Stable Diffusion と MidJourney を活用して、素晴らしい画像を作成します。
あなたは、ChatGPT と LLaMa を使用してエレガントな単語を作成することに熟練しています。
MuseNet と MuseGAN を行き来してマウンテン ミュージックを作成します。
人間の最もユニークな能力は創造することであることは間違いありませんが、今日の絶え間なく変化するテクノロジーの中で、私たちは機械を作ることによって創造を行っています。マシンは、与えられたスタイルに基づいて、オリジナルのアートワークを描画 (描画)、一貫した長い記事を作成 (執筆)、メロディアスな音楽を作曲 (作曲)、そして複雑なゲームの勝利戦略を策定 (プレイ) することができます。この技術は生成人工知能 (Generative Artificial Intelligence,最初のレベルのタイトル
1. 生成モデルと識別モデル
GenAI はバズワードですが、その背後にある本質は次のとおりです。モデルを生成する(生成モデル)。これは機械学習の分野であり、その目標は、特定のデータセットに類似した新しいデータを生成するようにモデルをトレーニングすることです。
馬のデータセットがあるとします。まず、このデータセットで生成モデルをトレーニングして、馬の画像内のピクセル間の複雑な関係を支配するルールをキャプチャできます。次に、このモデルをサンプリングして、元のデータセットには存在しなかった馬のリアルな画像を作成します (次の図を参照)。
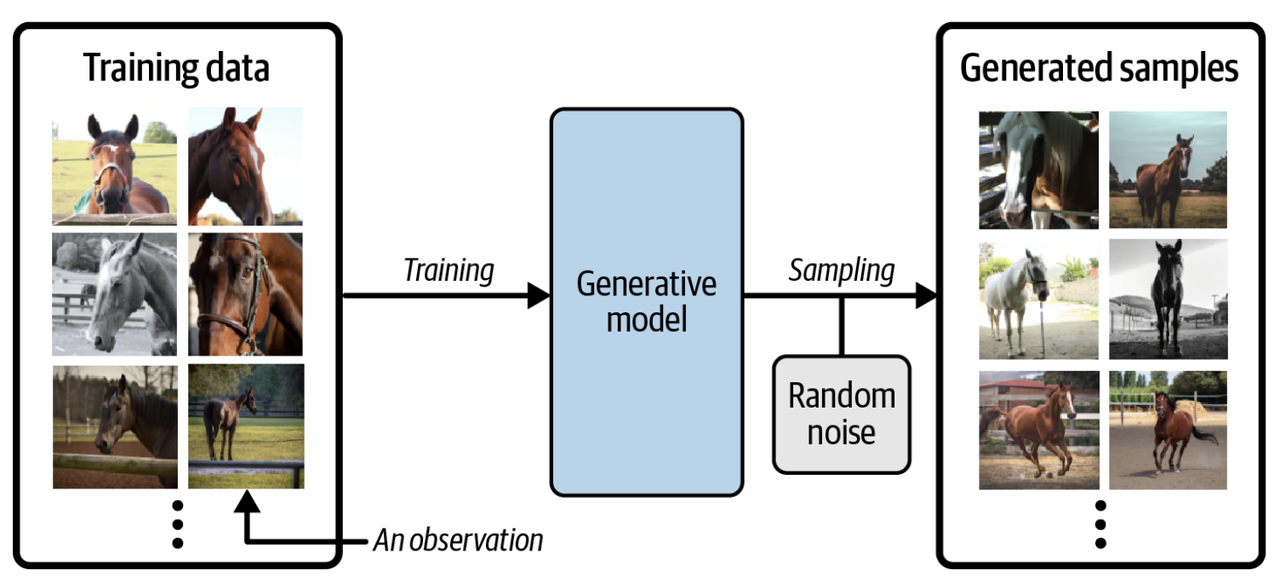
生成モデルの目的と重要性を真に理解するには、それらを次のものと比較してください。判別モデル(判別モデル)比較が必要です。実際、機械学習におけるほとんどの問題は判別モデルによって解決されます。次の例を参照してください。
ゴッホの絵画と他のアーティストの絵画のデータセットがあるとします。十分なデータがあれば、次の図に示すように、特定の絵画がファン ゴッホによるものであるかどうかを予測するための識別モデルをトレーニングできます。
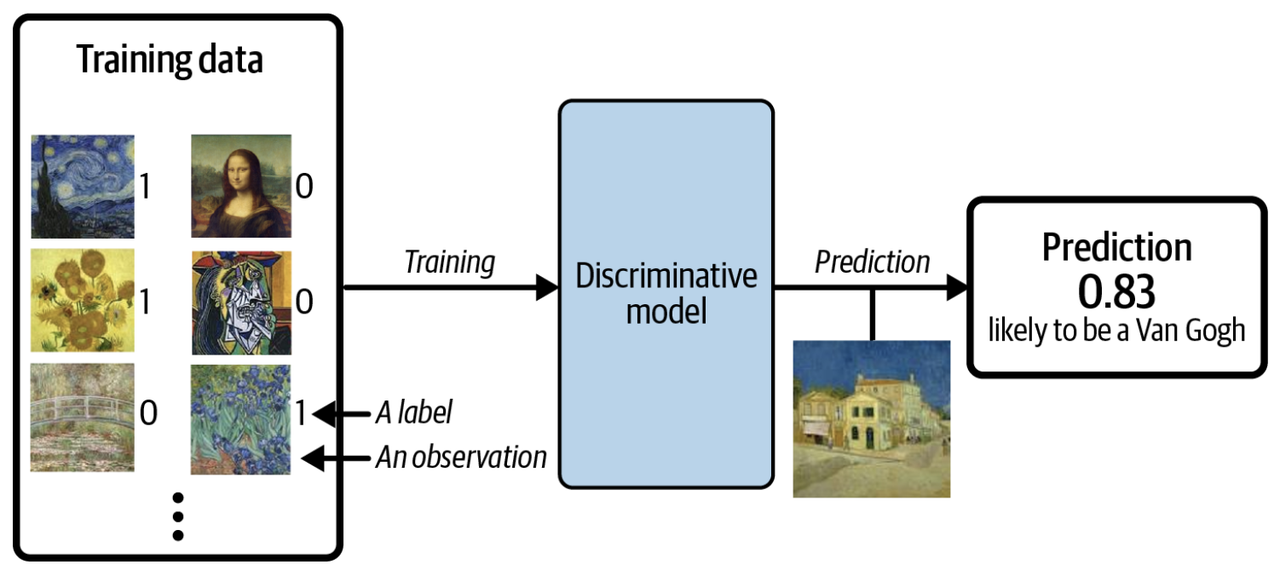
識別モデルを使用する場合、トレーニング セット内の各サンプルにはラベル (ラベル) が付けられます。上記の 2 カテゴリー問題では、通常、ゴッホの絵画のラベルは 1 で、ゴッホ以外の絵画のラベルは 0 になります。上の図では、モデルの最終予測確率は 0.83 であるため、ゴッホによって作成された可能性が非常に高くなります。判別モデルとは異なり、生成モデルの目的はデータのラベルを予測することではなく、新しいデータを生成することであるため、サンプルにラベルが含まれる必要はありません。
例を読んだ後、数学的表記法を使用して生成モデルと識別モデルを正確に定義してみましょう。
判別モデルペア P(y|x) モデリング、与えられた特徴x ラベルを推定するには y の条件付き確率。
モデルペアの生成 P(x) モデリング、特徴の直接推定 xの確率は、この確率分布からサンプリングすることによって新しい特徴を生成できます。
最初のレベルのタイトル
2. 生成モデルのフレームワーク
生成モデルのフレームワークに入る前に、ゲームをしてみましょう。下図の点がある規則によって生成されたと仮定し、これを規則と呼びます。 Pデータを使用して、別のデータを生成できるようになりましたx = (x 1,x 2) ポイントが同じルールによって決定されるように見せます。Pデータによって生成されます。
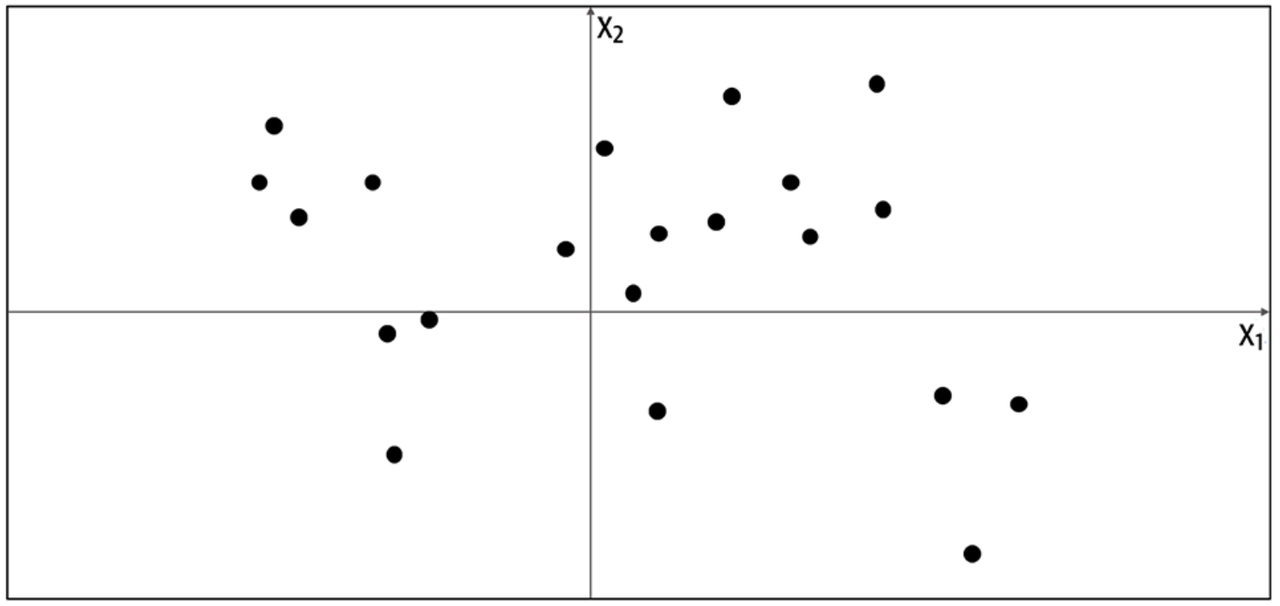
この点をどのように生成しますか?与えられたポイントを使用して頭の中でモデルを生成できますPこのモデルが占める位置によって、必要な点が生成される可能性があります。このことから、モデルがPモデルはPデータの推定値。次に、最も単純なモデルPモデルは下図のオレンジ色のボックスで、ポイントはボックスの内側にのみ生成でき、ボックスの外側には生成できません。
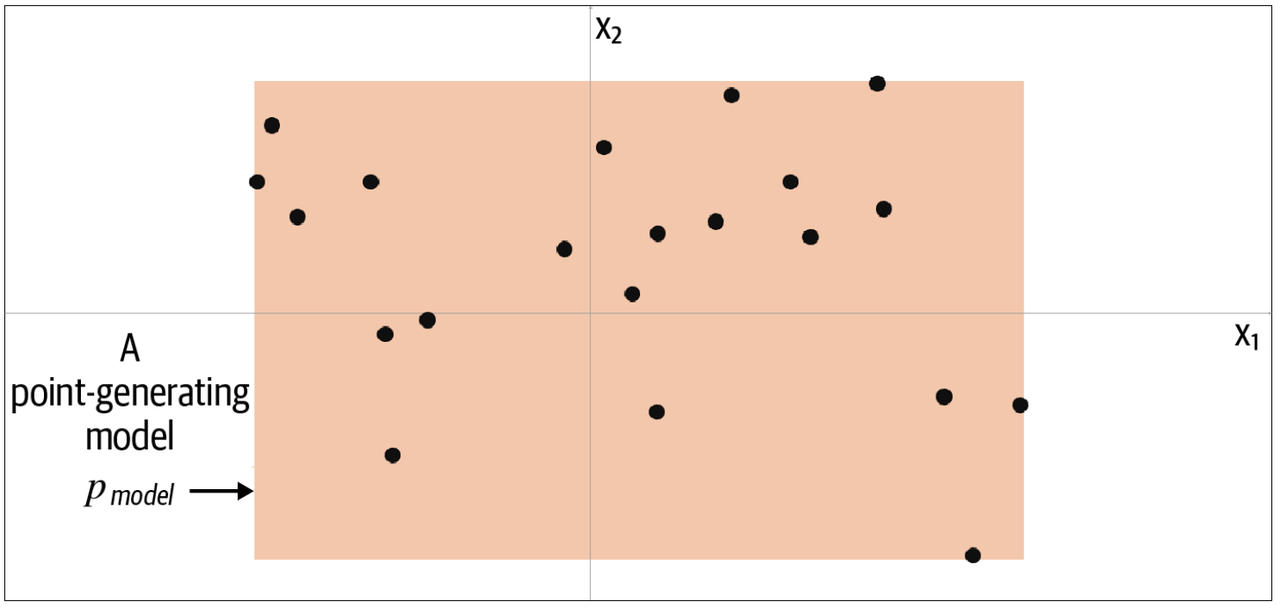
新しい点を生成するには、ボックスから、より厳密にはモデルから点をランダムに選択します。Pモデル分布でのサンプリング。これは最小限の生成モデルです。トレーニング データ (黒い点) からモデル (オレンジ色のボックス) を作成し、生成されたポイントがトレーニング セット内のポイントと似ていることを期待しながらモデルからサンプリングします。
これで、生成学習のフレームワークを正式に提案できるようになりました。
真のデータ生成分布を明らかにしましょうPデータを参照し、上記のフレームワークがこの例にどのように適用されるかを確認してください。以下の図から、データ生成ルールが次のとおりであることがわかります。Pデータによると、ポイントは陸地に均一に分布しているだけで、海には現れません。
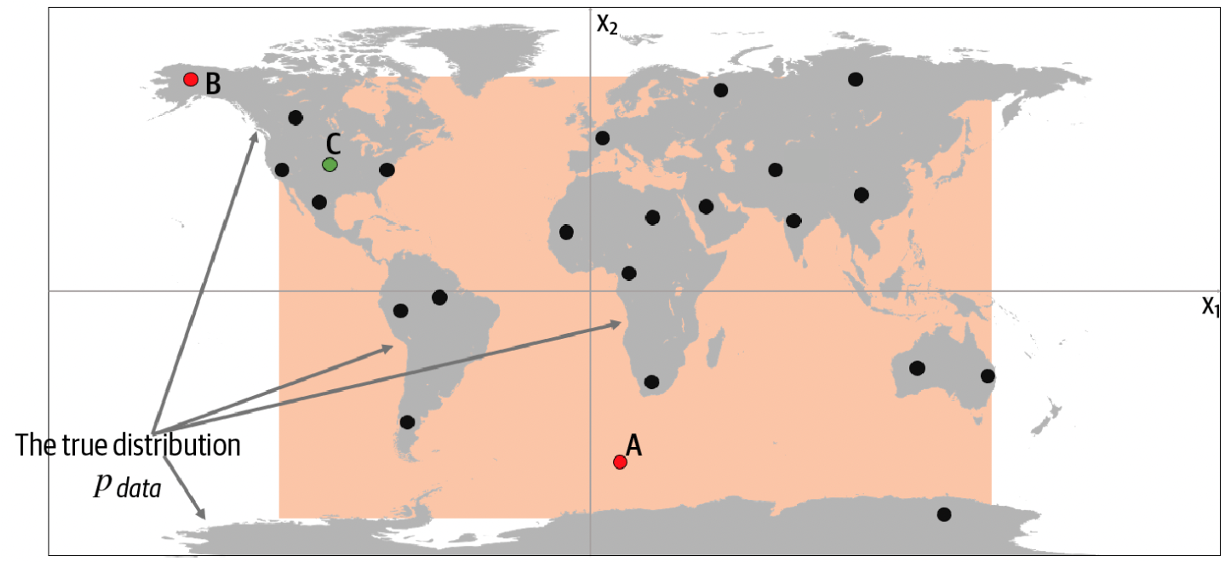
明らかに、私たちのモデルはPモデルがルールですPデータの簡略化。上図の点 A、B、C を調べることで、モデルを理解するのに役立ちます。Pモデルがルールをうまく模倣しているかどうかPdata。
点Aはルールを満たしていません Pデータは海中で見られるものですが、モデルによって決定される可能性がありますPモデルはオレンジ色のボックス内に表示されるように生成されます。
点 B はモデル化できませんPモデルはオレンジ色のボックスの外側に表示されるため生成されますが、ルールに準拠していますP陸上で表示されるデータ。
点 C は次のようにモデル化されます。Pモデルが生成され、ルールに準拠しますPdata。
最初のレベルのタイトル
3. 最初の生成モデル
あなたが会社の最高ファッション責任者 (CFO) で、新しい流行の服を作成するのが仕事だとします。今年は、ファッション コロケーションに関する 50 個のデータ セット (以下を参照) を受け取り、10 個の新しいファッション コロケーションを作成する必要があります。
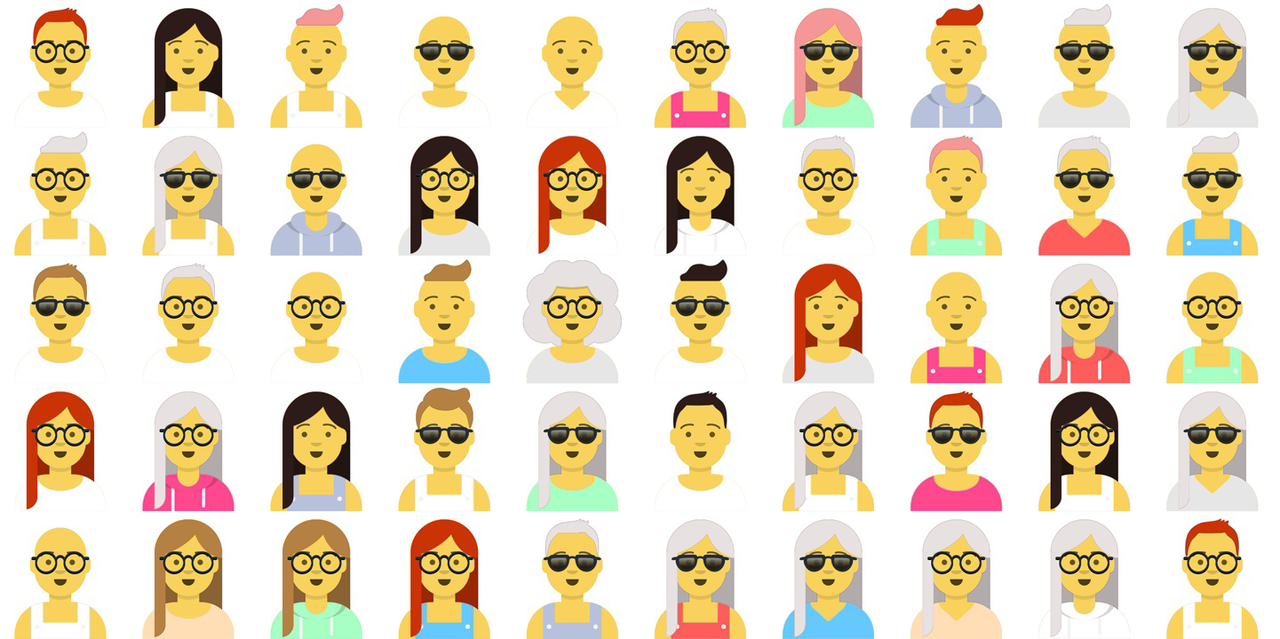
あなたは最高ファッション責任者ですが、データ サイエンティストでもあるため、この問題を解決するために生成モデルを使用することにしました。上記の 50 枚の画像を読んだ後、5 つの機能を使用することに決めました。付属品の種類 (accessies type)、服の色 (clothing color)、服装の種類 (clothing type)、髪の色(髪の色)と髪の種類(髪のタイプ)、ファッションの組み合わせを説明します。
画像データの特徴トップ10は以下の通りです。
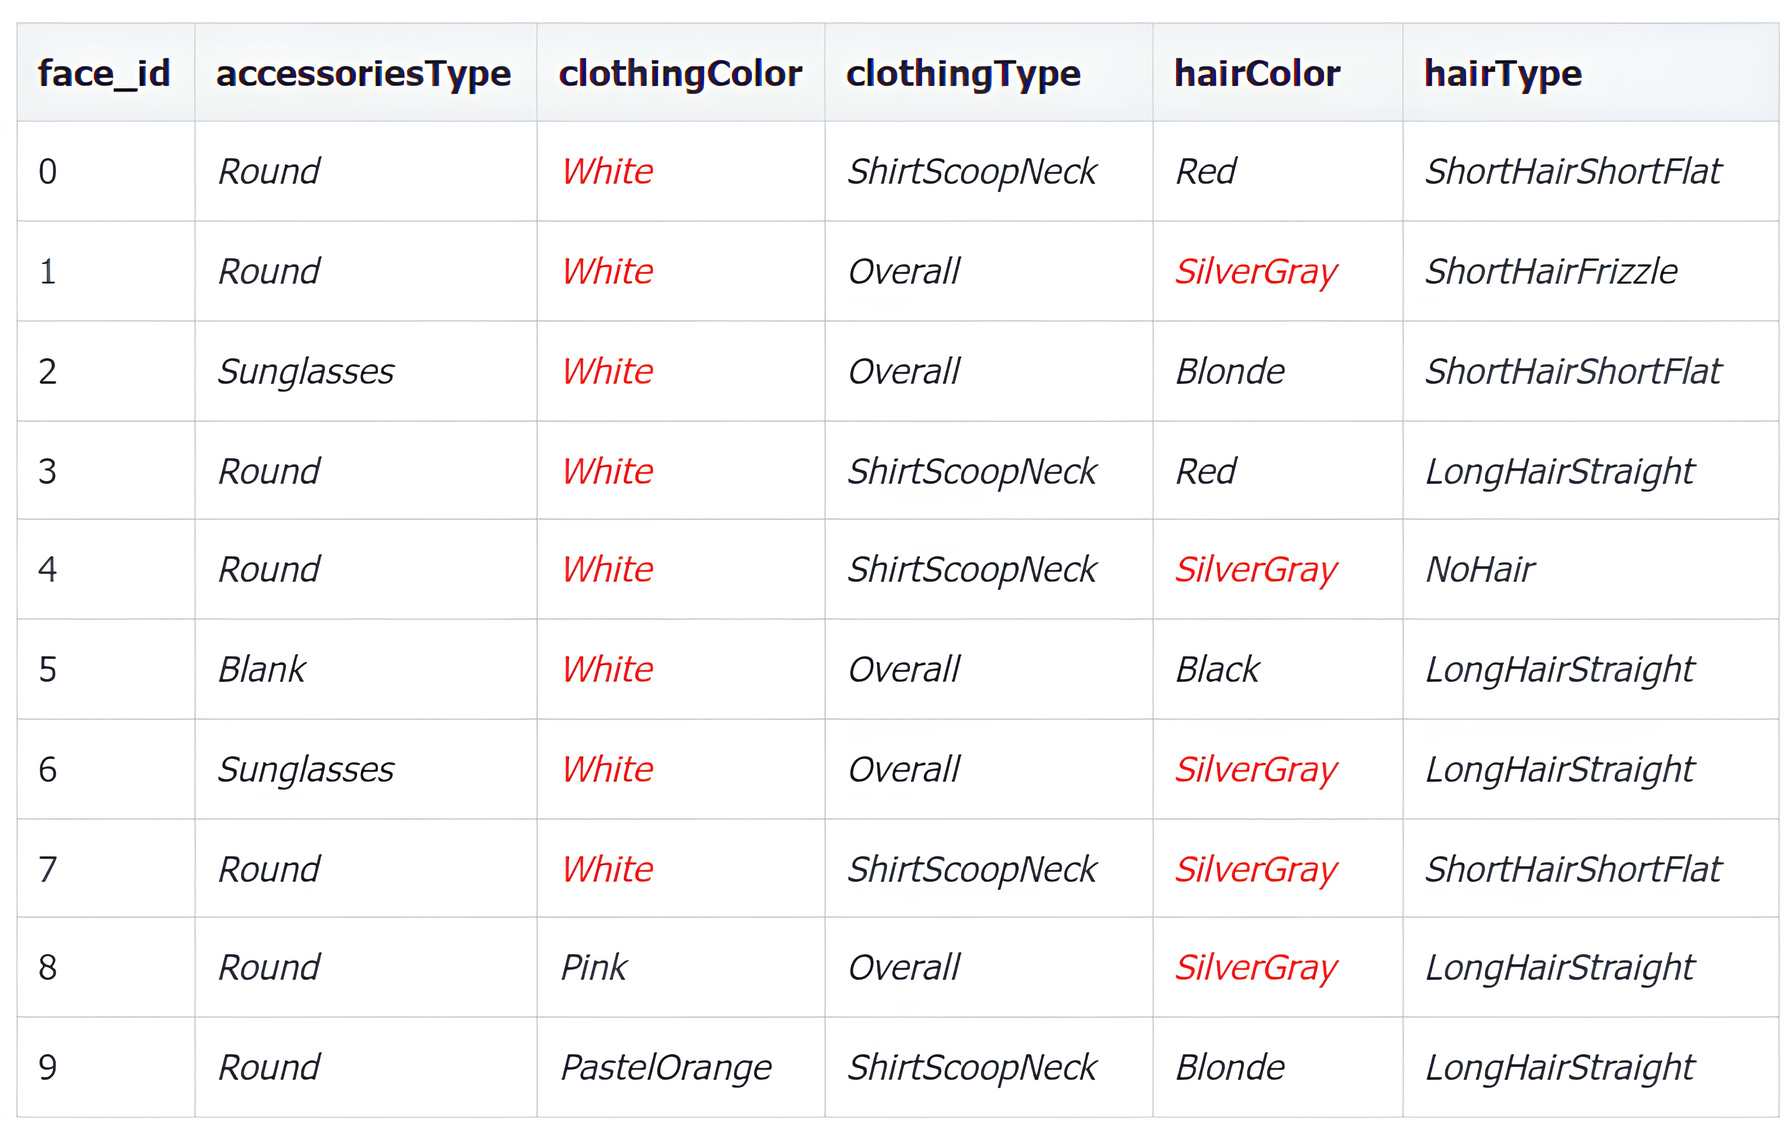
各特徴には異なる数の固有値もあります。
付属品3種類(付属品種類):
Blank, Round, Sunglasses
8つの服の色:
Black, Blue 01, Gray 01, PastelGreen, PastelOrange, Pink, Red, White
4種類の服装:
Hoodie, Overall, ShirtScoopNeck, ShirtVNeck
6つの髪の色:
Black, Blonde, Brown, PastelPink, Red, SilverGray
7つの髪のタイプ:
NoHair, LongHairBun, LongHairCurly, LongHairStraight, ShortHairShortWaved, ShortHairShortFlat, ShortHairFrizzle
このように、3 * 8 * 4 * 6 * 7 = 4032 個の特徴の組み合わせがあるため、サンプル空間には 4032 個の点が含まれていると想像できます。与えられた 50 のデータ ポイントから、次のことがわかります。Pデータは、さまざまな特徴に対して特定の特徴値を優先します。上の表から、画像には白い服の色とシルバーグレーの髪の色が多く含まれていることがわかります。本当のことが分からないので、Pデータの場合、これら 50 個のデータのみを使用して、Pで使用できるモデルP副題
3.1 ミニマリストモデル
最も簡単な方法の 1 つは、4032 個の特徴の組み合わせの各ポイントに確率パラメーターを割り当てることです。この場合、すべての確率パラメーターの合計は 1 に等しいため、モデルには 4031 個のパラメーターが含まれます。次に、50 個のデータを 1 つずつ調べて、モデルのパラメーターを更新してみましょう(θ 1 ,θ 2 ,…,θ 4031 )で
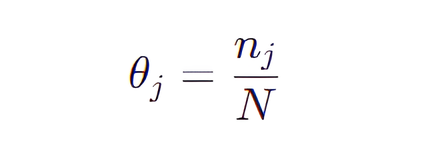
で Nは観測データの数、つまり 50 です。nj最初ですj50 個のデータに現れる特徴の組み合わせの数。
たとえば、(LongHairStraight、Red、Round、 ShirtScoopNeck、White) の特徴の組み合わせ (組み合わせ 1 と呼ばれる) が 2 回出現し、
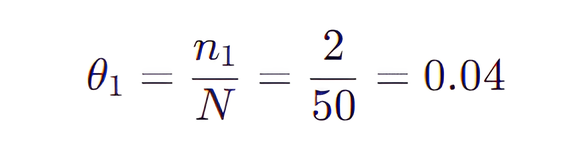
たとえば、(LongHairStraight、Red、Round、 ShirtScoopNeck、Blue 01) の特徴の組み合わせ (組み合わせ 2 と呼ばれる) が表示されない場合、
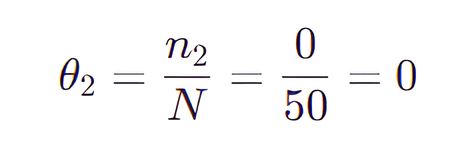
上記のルールに従って、4031の組み合わせを計算します。θ値がたくさんあることは難しくありません。θ値はすべて 0 で、さらに悪いことに、新しい未表示の画像を生成できないことです (θ= 0 は、その特徴の組み合わせを持つ画像がこれまでに観察されていないことを意味します)。これを修正するには、特徴の総数 d を分母に、1 を分子に加算するだけです。これはラプラス平滑化と呼ばれる手法です。
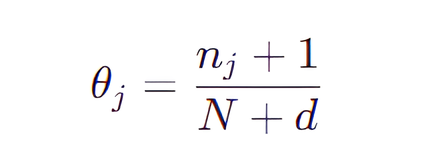
すべての組み合わせ (元のデータセットにないものを含む) のサンプリング確率はゼロではありませんが、元のデータセットにない点の確率は定数であるため、これはまだ満足のいく生成モデルではありません。このようなモデルを使用してゴッホの絵画を生成しようとすると、次の 2 つの絵画が同じ確率で動作します。
オリジナルのゴッホ絵画の複製 (オリジナルのデータセットには含まれていません)
ランダムなピクセルで作られた絵画 (元のデータセットにはない)
副題
3.2 準単純モデル
Naive Bayes モデル (Naive Bayes) は、上記の特徴の組み合わせの数を大幅に減らすことができ、そのモデルによれば、各特徴は互いに独立していると仮定されます。上記のデータに戻ると、人の髪の色(特徴)xj)とその服の色(特徴 xk ) は関係がありません。数式で表すと次のようになります。
p(xj | xk) = p(xk)
この仮定により、次のように計算できます。
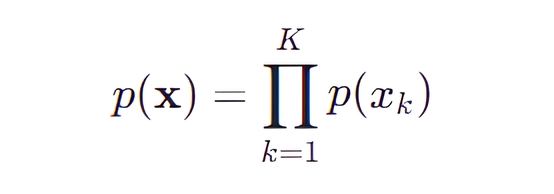
ナイーブ ベイジアン モデルは、元の問題「各特徴の組み合わせの確率推定」を「各特徴の確率推定」に単純化します。当初は 4031 ( 3 * 8 * 4 * 6 * 7) パラメーターを使用する必要がありました。現在は 23 ( 3 ) のみです。 + 8 + 4 + 6 + 7) パラメーターは必須であり、各パラメーターの式は次のとおりです。
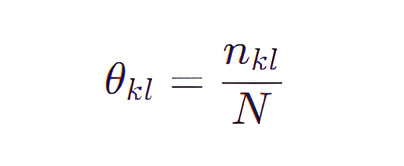
ここで、N は観測データの数、つまり 50 です。nkl 最初です k次の機能l 固有値の数。
50 個のデータの統計を通じて、次の表にナイーブ ベイジアン モデルのパラメーター値を示します。
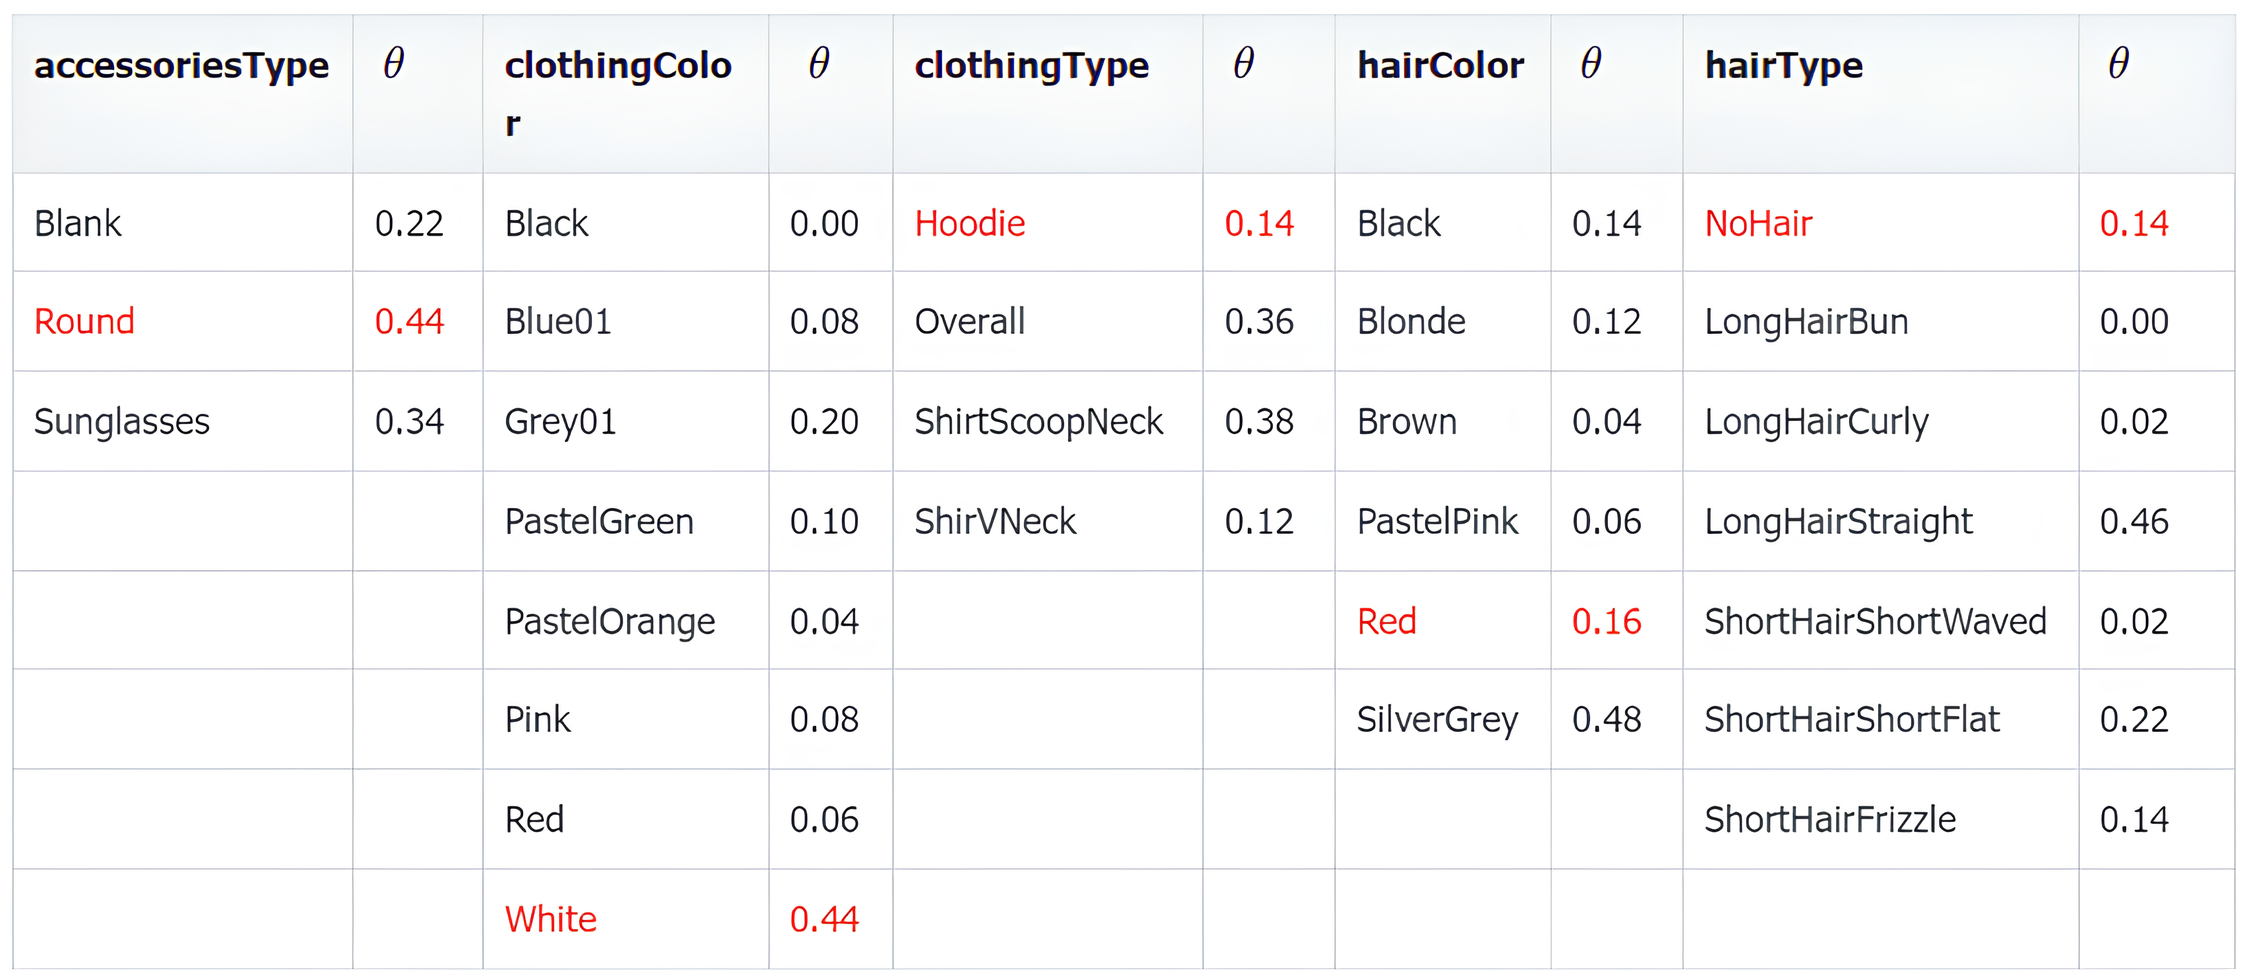
モデルがデータ特徴を生成する確率を計算するには、上の表の確率を乗算するだけです。たとえば、次のようになります。
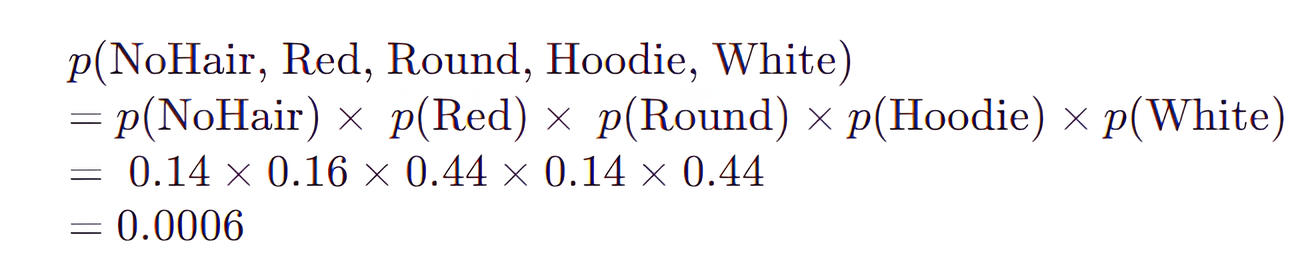
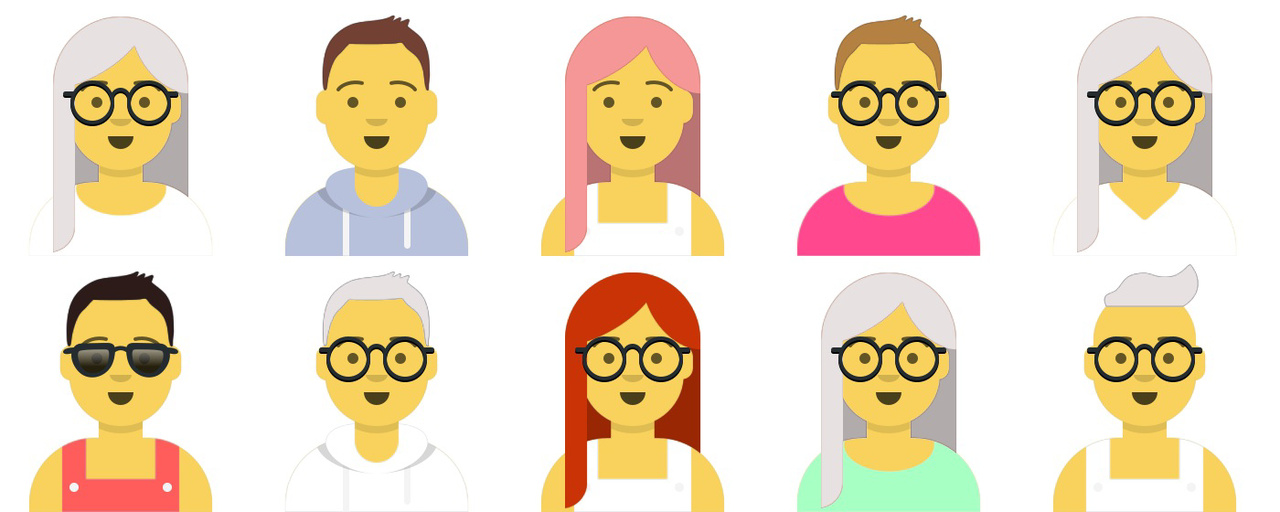
上記の組み合わせは元のデータセットには現れませんでしたが、モデルは依然としてゼロ以外の確率を割り当てていたため、モデルによって生成することができました。したがって、単純ベイジアン モデルはデータから何らかの構造を学習し、それを使用して元のデータセットには見られない新しい例を生成できます。下の写真は、モデルによって生成された 10 個の新しいファッション コロケーションの写真です。
最初のレベルのタイトル
副題
4.1 高次元データ
最高ファッション責任者として、あなたは Naive Bayesian を使用して 10 個の新しいファッション コロケーションを生成することに成功しました。次のデータ セットに遭遇するまで、自分のモデルは無敵であると確信しています。
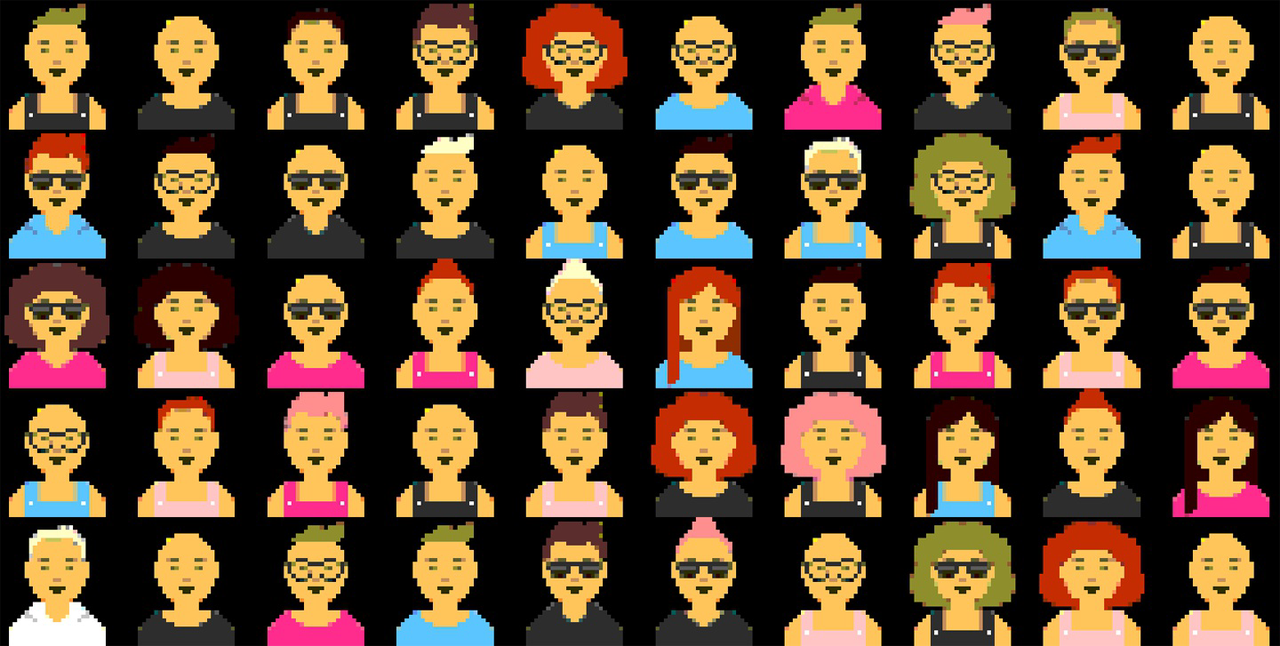
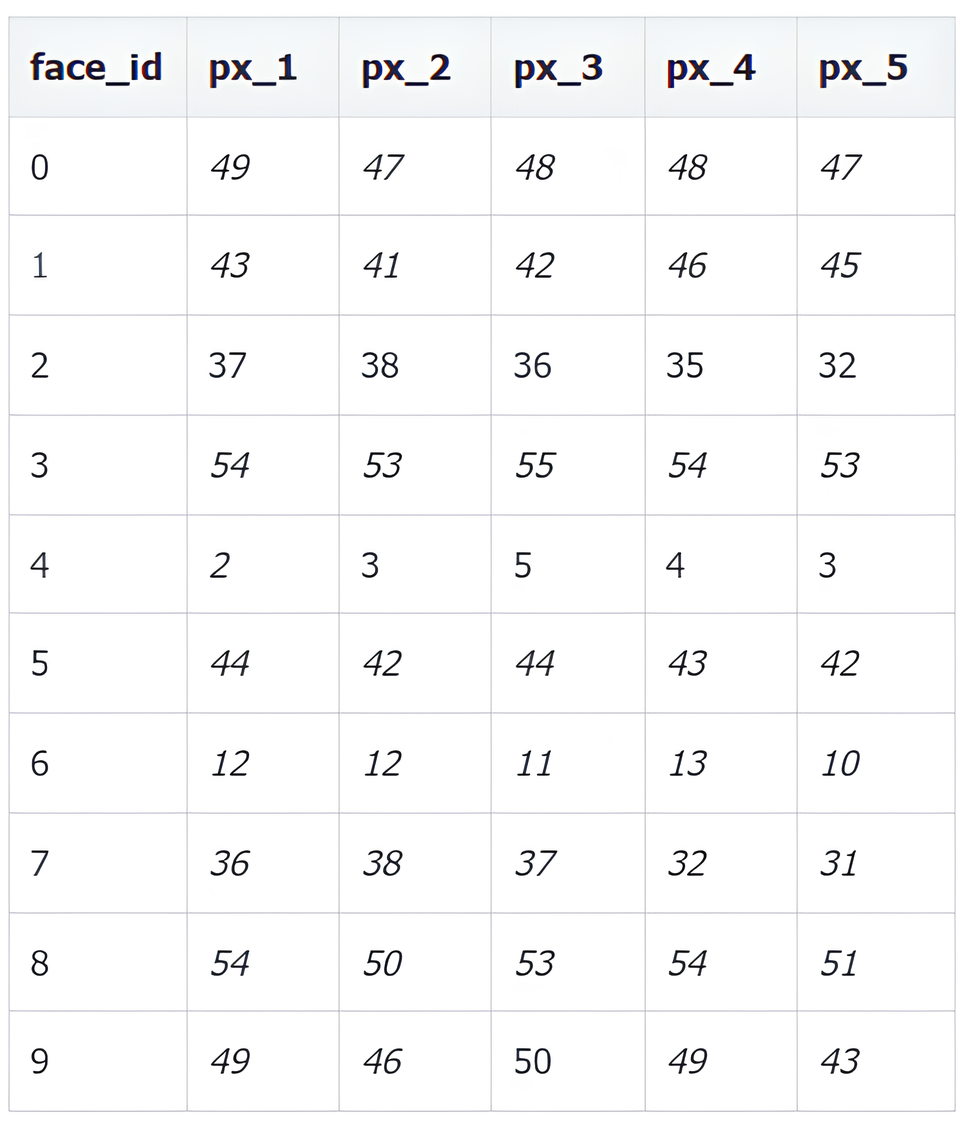
データ セットは 5 つの特徴では表されなくなり、32*32 = 1024 ピクセルで表され、各ピクセル値は 0 ~ 255 のいずれかになります。0 は白、255 は黒を意味します。次の表に、最初の 10 枚の画像のピクセル 1 ~ 5 の値を示します。
同じモデルを使用して、まったく新しいファッション コロケーションを 10 セット生成します。モデル生成の結果は次のとおりです。それぞれは醜くて似ており、異なる特徴は区別できません。これはなぜでしょうか?
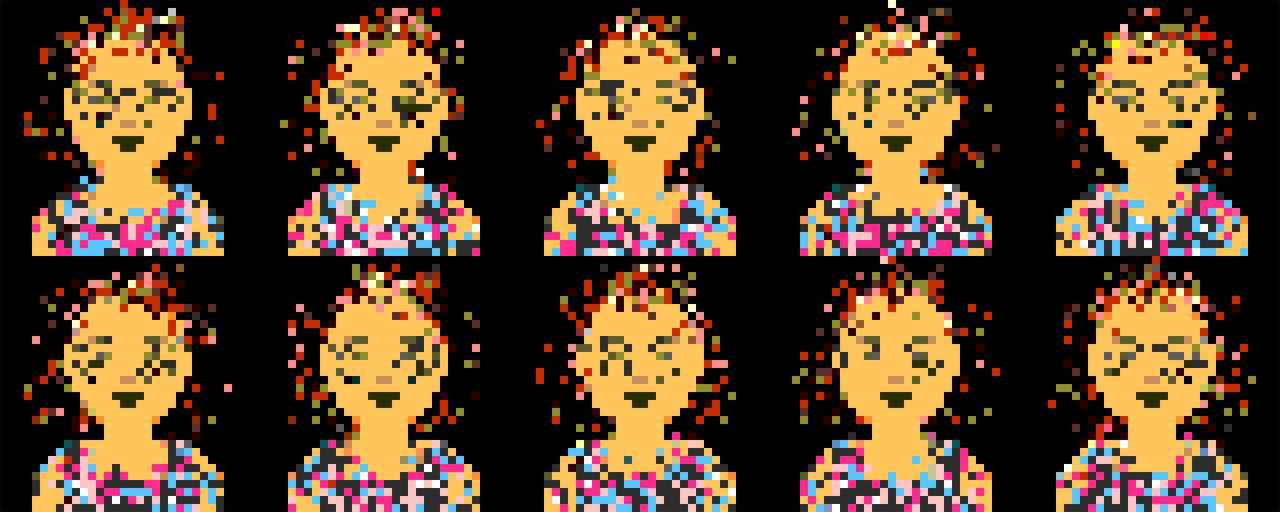
まず第一に、単純ベイジアン モデルはピクセルを個別にサンプリングするため、隣接するピクセルは実際には非常に似ています。服の場合、実際にはピクセルはほぼ同じであるはずですが、モデルがランダムにサンプリングされているため、上の写真の服はすべてカラフルです。第 2 に、高次元のサンプル空間には可能性が多すぎて、特定できるのはほんの一部です。単純ベイジアン モデルがこのような相関性の高いピクセル値を直接処理する場合、値の満足のいく組み合わせが見つかる可能性は非常に低くなります。
要約すると、低次元で特徴の相関性が低いサンプル空間の場合、独立サンプリングによる単純ベイジアン効果は非常に優れていますが、高次元で特徴の相関性が高いサンプル空間では、効果的な人間の顔を見つけるために独立サンプリング ピクセルが使用されます。ほぼ不可能である。
この例では、生成モデルが成功するために克服しなければならない 2 つの問題を強調しています。
モデルは高次元特徴間の条件依存関係をどのように処理しますか?
モデルは高次元のサンプル空間で条件を満たすごくわずかな割合の観測値をどのように見つけ出すのでしょうか?
生成モデルが高次元で相関性の高いサンプル空間で成功するには、深層学習モデルを利用する必要があります。どのような仮定を立てるべきかを事前に指示されるのではなく、データから関連する構造を推測できるモデルが必要です。ディープラーニングは、低次元空間で独自の特徴を形成できます。これは、表現学習副題
4.2 表現学習
表現学習とは、高次元データの表現の意味を学習することです。
あなたが会ったことのないネチズンに会いに行き、待ち合わせ場所で彼女を見つけることができない人がたくさんいるので、彼女に電話して自分の外見を説明するとします。画像のピクセル 1 の色は黒、ピクセル 2 の色は明るい黒、ピクセル 3 の色はグレーなどとは言わないと思います。それどころか、ネチズンは一般人の外見を一般的に理解しており、その理解をピクセルグループの特徴を説明するために提供すると考えるでしょう。たとえば、あなたは短くて黒い美しい髪をしていて、靴下を着ています。金色のメガネなど。通常、そのような説明が 10 個以下であれば、ネットユーザーは頭の中であなたのイメージを生成できます。イメージは粗いかもしれませんが、たとえ彼女があなたを見たことがない場合でも、ネットユーザーは数百人の中からあなたを見つけることができます。
これは表現学習の背後にある中心的な考え方であり、直接的な試みではありません。高次元サンプル空間(高次元サンプル空間) をモデリングに使用しますが、一部を使用します。低次元の潜在空間(低次元の潜在空間) を使用してトレーニング セット内の各観測値を記述し、その後、マッピング関数(マッピング関数)。潜在空間内の点を取得し、それを元のサンプル空間にマッピングします。言い換えれば、潜在空間内の各点は高次元データの特徴を表します。
上記の言葉が理解しにくい場合は、いくつかのグレースケールの jar 画像で構成される以下のトレーニング セットを参照してください。
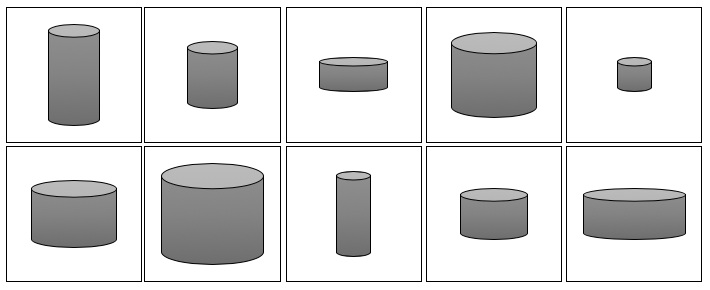
これらの瓶が高さと幅という 2 つの特徴だけで説明できることは、難しくありません。したがって、次の図に示すように、画像の高次元ピクセル空間を二次元の潜在空間に変換できます。このようにして、潜在空間 (青い点) からサンプリングして、マッピング関数を渡すことができます。fそれを画像に変換します。
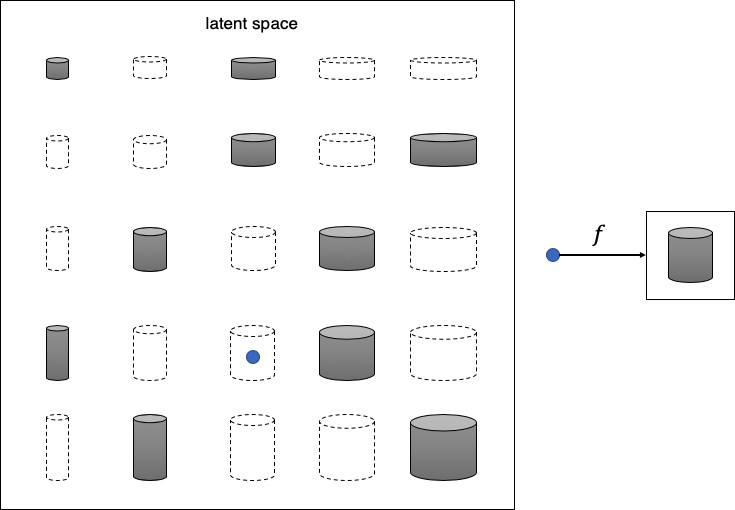
マシンにとって、元のデータ セットがより単純な潜在空間で表現できることを認識するのは簡単ではありません。まず、マシンは、データ セットを最もよく表す 2 つの潜在空間の次元が高さと幅であることを判断し、その後学習する必要があります。マッピング関数f 最初のレベルのタイトル
5. 生成モデルの分類
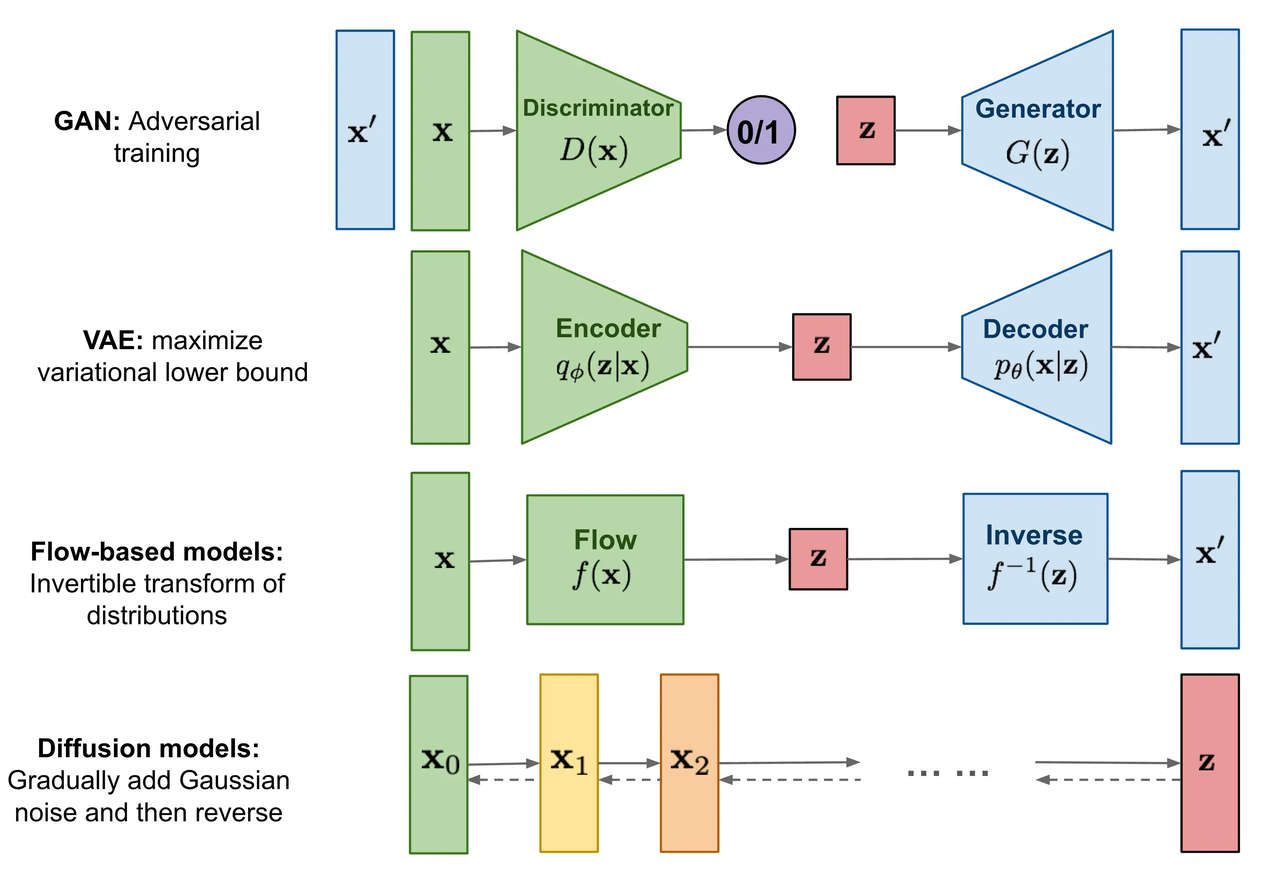
すべてのタイプの生成モデルは、最終的には同じタスクを解決することを目的としていますが、それらはすべてわずかに異なる方法で密度関数をモデル化しており、一般に次の 2 つのカテゴリに分類されます。
ペア密度関数明示的なモデリング(explicitly modeling),
ただし、次のように密度関数が計算されるようにモデルを何らかの方法で制約します。正規化された流れモデル(normalizing FLOW model)
しかし、密度関数を近似するには、次のようにします。変分オートエンコーダ (variational autoencoder,VAE)と普及モデル (diffusion model)
ペア密度関数暗黙的なモデリング(暗黙的なモデリング)、データを直接生成する確率的プロセスを通じて。例えば要約する (generative adversarial network, GAN)
要約する
生成人工知能 (GenAI) は、テキスト、画像、ビデオ、音楽などの新しいコンテンツやアイデアを作成するために使用できる人工知能の一種です。すべての人工知能と同様に、GenAI は、大量のデータに基づいて深層学習モデルによって事前トレーニングされた非常に大規模なモデルであり、多くの場合、ベースモデル(foundation model,FM)。 GenAI を使用すると、よりクールな画像を描き、より美しいテキストを書き、より感動的な音楽を作曲することができますが、記事の責任者であるリチャード・ファインマン氏が述べたように、最初のステップでは GenAI がどのように新しいものを作成するかを理解する必要があります。私には作れないもの。」





