


SignalPlus: ディープ ニューラル ネットワークについての話


序文
Deep neural networks are completely flexible by design, and there really are no fixed rules when it comes to model architecture.
-- David Foster
序文
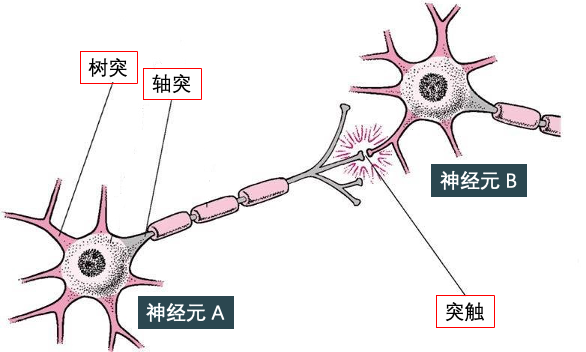
ニューラルネットワーク(ニューラル ネットワーク) 人間の脳にヒントを得て、生物学的なニューロンを模倣して相互に信号を送信することができます。ニューラル ネットワークはニューロンで構成されるシステムです。下図に示すように、ニューロンにはたくさんの神経細胞が存在します。デンドライト(樹状突起) 入力には、軸索(軸索) 出力用。これには、興奮性と伝導性という 2 つの主な特性があります。
興奮性とは、刺激強度が一定の閾値に達しない場合には神経インパルスが発生せず、刺激強度がこの値に達すると神経インパルスが発生し、瞬間的に最大強度に達する可能性があることを意味します。
伝導性とは、隣接するニューロン間の小さなギャップを介したニューロンの伝導を指します。この小さなギャップは、シナプス(シナプス)、その機能は異なるニューロン間で神経インパルスを伝達することであり、下図のシナプスはニューロン A とニューロン B を接続します。
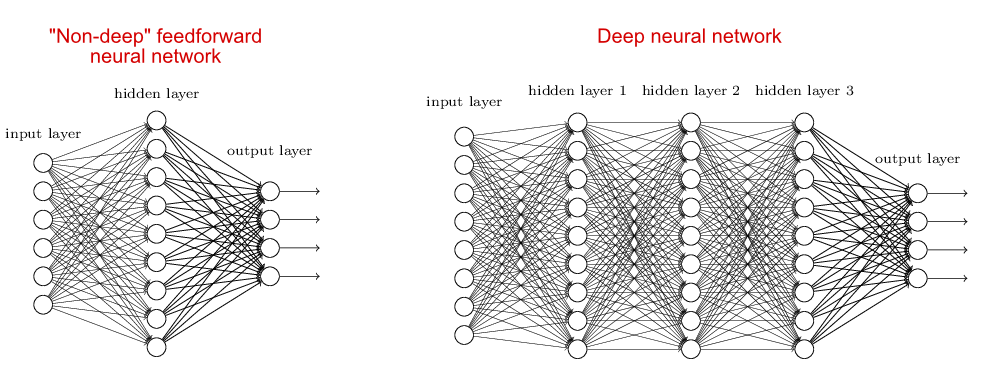
たくさんのシナプスがたくさんのニューロンを接続していると想像してみてください。それがニューラルネットワークを形成しているのではないでしょうか?はい、次のような類推です人工ニューラルネットワーク (artificial neural network,ANN) も、下の左のような無数の人工ニューロンで構成されています。浅いニューラルネットワーク(シャドウ ニューラル ネットワーク) とその右下のディープ ニューラル ネットワーク (ディープ ニューラル ネットワーク)。
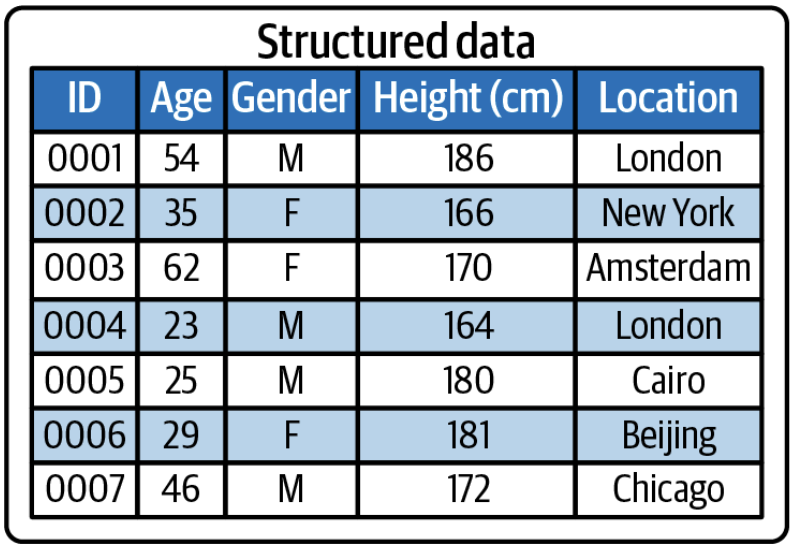
浅いニューラル ネットワークは次のような用途に適しています。構造化データ(構造化データ)たとえば、下図のExcelに格納された2次元データ。
 ディープニューラルネットワークは次のような用途に適しています。非構造化データ下図に示すような画像、テキスト、音声データなどの(非構造化データ)。
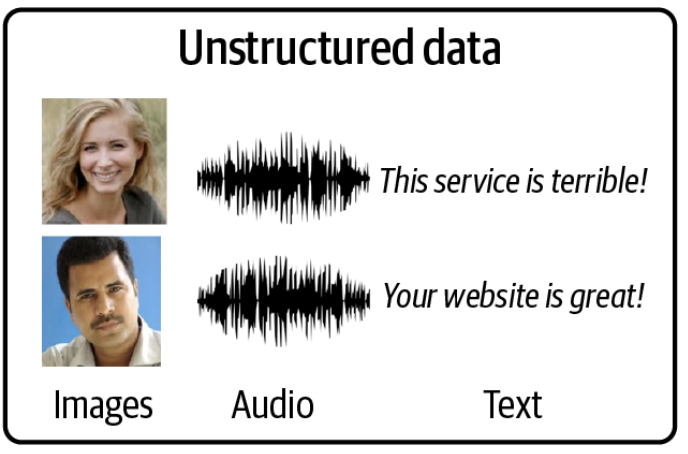
生成 AI モデルは主に非構造化データを生成するため、ディープ ニューラル ネットワークを理解する必要があります。この記事から、モデルとコードを飛ばしていきます。
Talk is cheap. Show me the code.
-- Linus Torvalds
最初のレベルのタイトル
副題
1.1 ニューラルネットワークの概要
次のニューラル ネットワークがトレーニングされ、写真に笑顔が含まれているかどうかを予測するために使用されたとします。
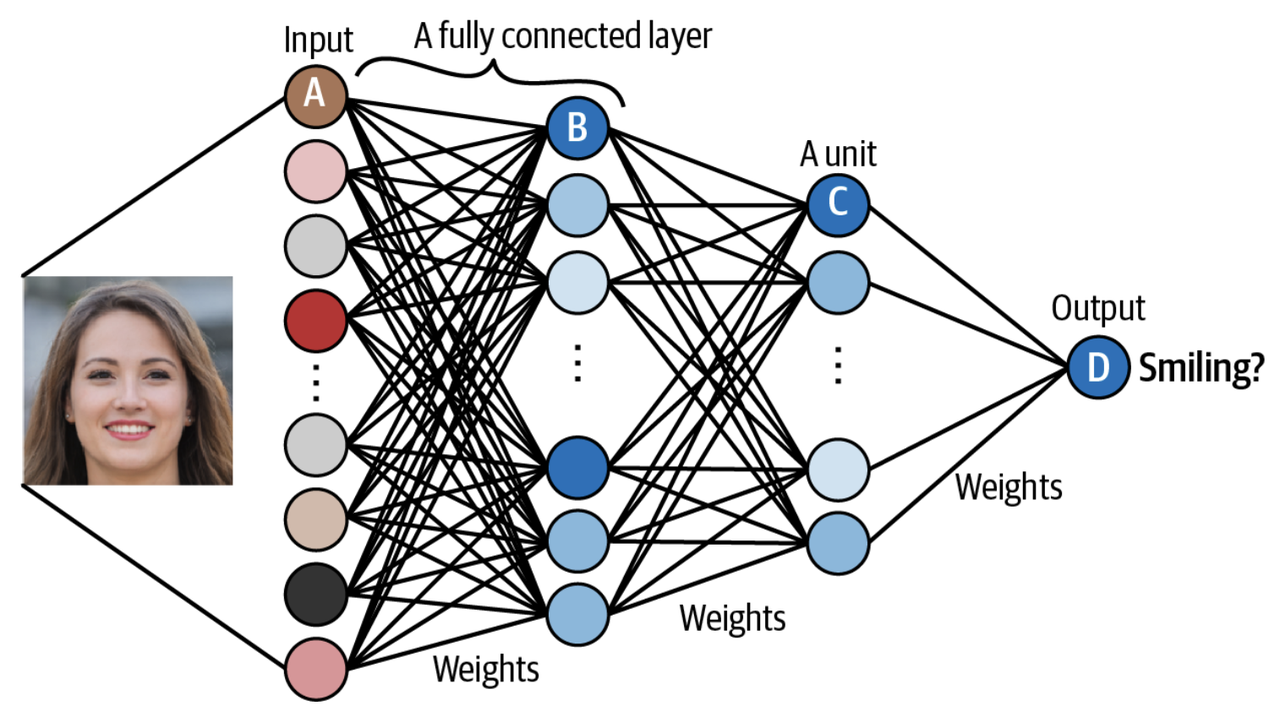
ユニット A は画像内のピクセル情報を受け取ります。
ユニット B は、元の画像が次の場合に入力ピクセルを結合します。低レベルの機能(低レベルの特徴) 例えば、エッジ(エッジ)のときに最も強い信号が放射されます。
ユニット C は、低レベルの機能を組み合わせます。高度な機能歯(ティーチ)などの(上位機能)、最も強い信号が発せられます。
ユニット D には、元の画像内の人物が笑っているときに最も強い信号を発する高レベルの機能が組み込まれています。
このニューラル ネットワークに十分なデータ、つまり画像が「供給」されると、一連のデータが「検索」されます。重み(重み)を使用して、最終的な予測を可能な限り正確にします。重みを見つけるプロセスは、実際にはニューラル ネットワークをトレーニングすることです。
副題
1.2 Keras のトレーニング プロセス
モデル
モデル (models)
層 (layers),入力(入力)と出力 (output)
オプティマイザ(オプティマイザー) と損失関数 (loss)
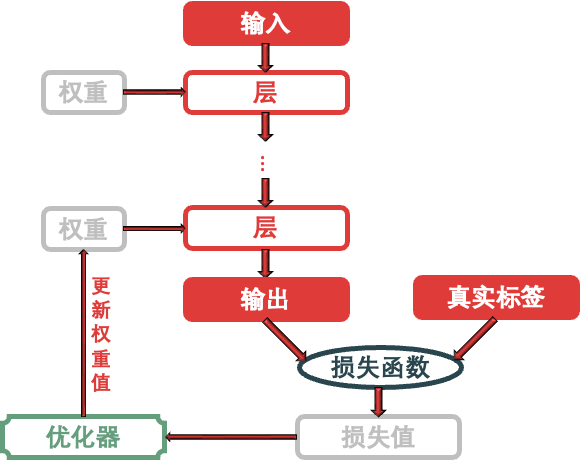
上記のキーワードを使用して、Keras トレーニング ニューラル ネットワークのプロセスを要約します。複数のキーワードを組み合わせます。層モデルモデル、意思入力データは予測値にマッピングされます。それから損失関数これらの予測値を取得します出力、ターゲットと比較して損失値を取得します (ネットワーク予測値が期待される結果とどの程度一致するかを測定するために使用されます)。オプティマイザこの損失値を使用して、ネットワークの重みを更新します。
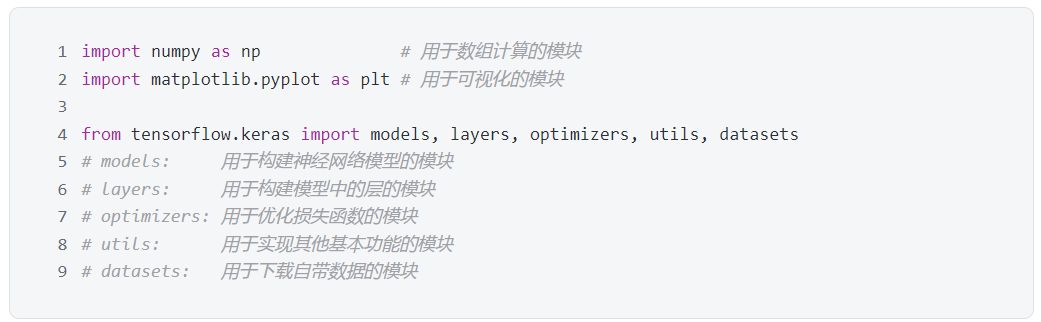
この時点で、ツール ライブラリが導入されていても、ようやくコードを表示できるようになります。まず、tensorflow.keras ライブラリからニューラル ネットワークを構築するために使用されるモジュールです。
副題
1.3 ミニマリストのニューラル ネットワーク
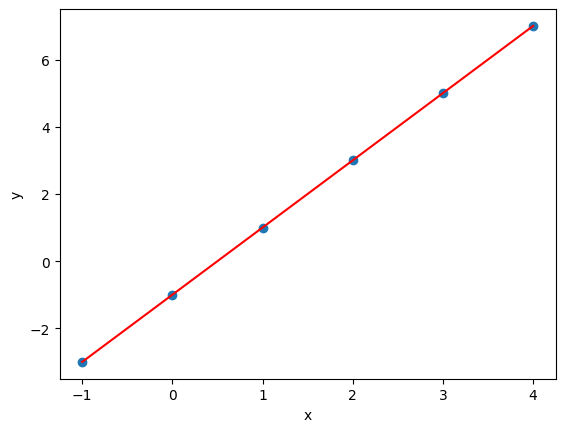
そしてx そしてy データ:
x = [-1, 0, 1, 2, 3, 4 ]
y = [-3, -1, 1, 3, 5, 7 ]
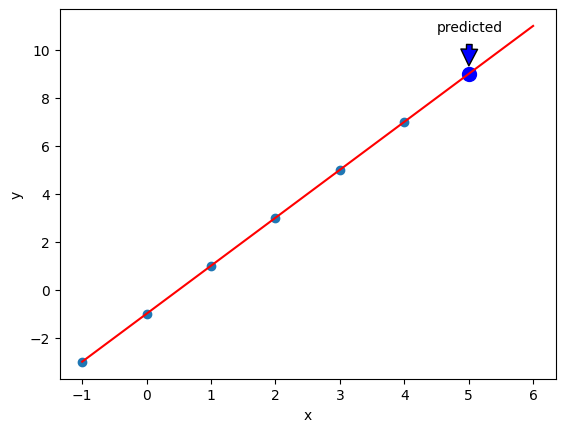
そしてx そして y x のときの関係new= 10、y に質問してくださいnew幾つか?
以下の図に示すように、xそして y散在点の形でそれを描画します。下の図の赤い線がそれであることを見つけるのは難しくありません。 xそして y副題
1.3.1 モデルの作成
1 つのニューロンを含むニューラル ネットワークの層を使用するだけです。コードは次のとおりです。
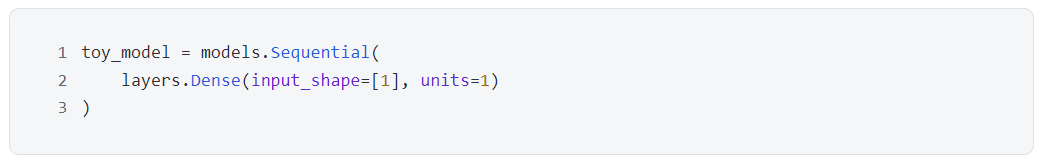
初めて使うmodels.Sequential() 空のニューラル ネットワークを作成し、レイヤーを追加し続けます。ここでは追加しました。layers.Dense()副題
1.3.2 機種の確認
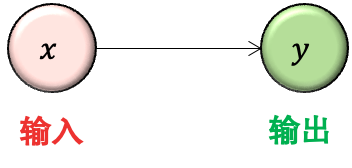
モデル情報を確認してください。奇妙なことに、パラメーターの数 (下図の Param #) が実際には 1 ではなく 2 になっていることです。というのも、上の写真からy = wx、あるはずですwパラメータ。
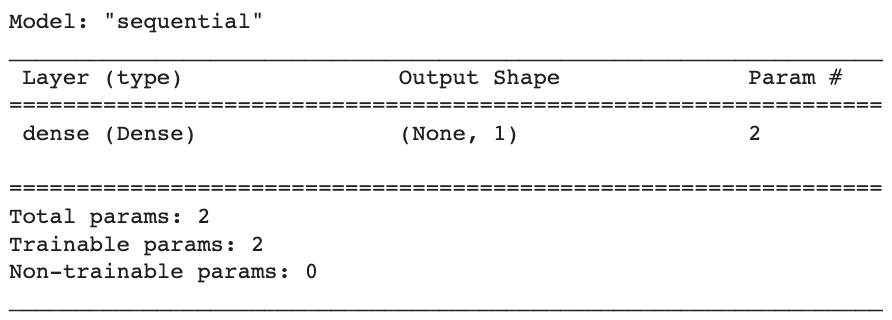
その理由は、各レイヤーのパラメーターの数を計算するときに、各ニューロンがデフォルトで値 1 に接続されるためです。バイアスユニット(バイアス ユニット) したがって、実際には、上の図のより正確な外観は次のようになります。
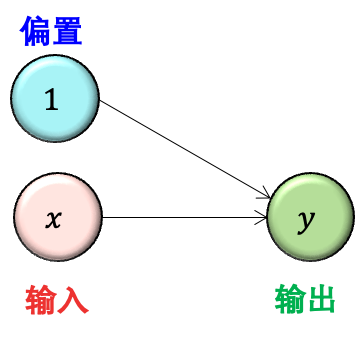
そうなんです、この時はy = wx+b、はいwそして b 2 つのパラメータ。
実は厳密に言えば Dense()関数にはまだ活性化と呼ばれるパラメータがあります。これは文字通り活性化関数を意味し、本質的に行うことは次のとおりです。wx+b は非線形モードの切り替えに与えられます。 y。活性化関数が次のように定義されている場合、 g、それでy = g(wx+b)。 Keras では、アクティブ化の値を指定しない場合、非線形変換を行う必要はありません。活性化関数の概念を追加すると、全体像が得られます。
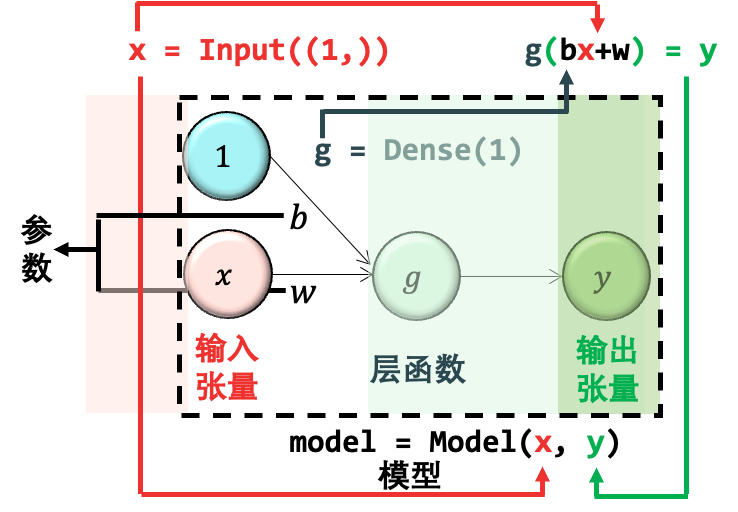
私たちの目標は、上の図のパラメータ、つまり重みを見つけることです。w副題
1.3.3 モデルをコンパイルする
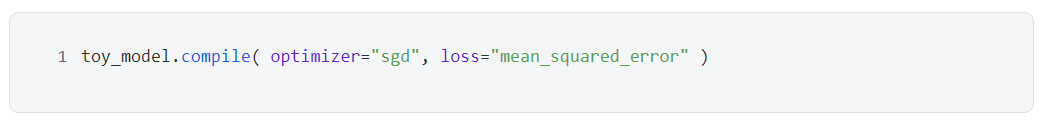
モデル フレームワークが設定されたら、次のステップは次のように問題を最適化することです。complie()機能設定パラメータオプティマイザー="sgd"つまり、最適化手法を確率的勾配降下法として指定し、パラメーター loss= を設定します。"mean_squared_error"副題
1.3.4 トレーニングモデル
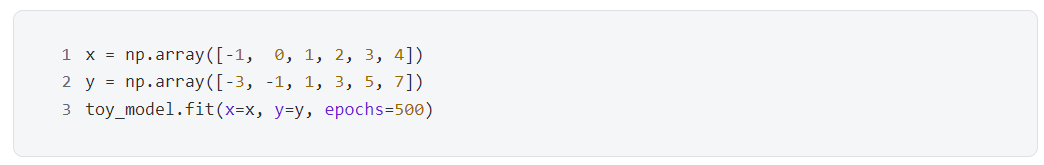
トレーニングモデル fit()関数。データ x と y を渡します。パラメーター epochs= 500 であることに注意してください。エポックは中国語での期間、つまり、トレーニング セット全体がアルゴリズムによって走査される回数です。ここでは、500 回走査した後のモデル トレーニングの終了を示します。
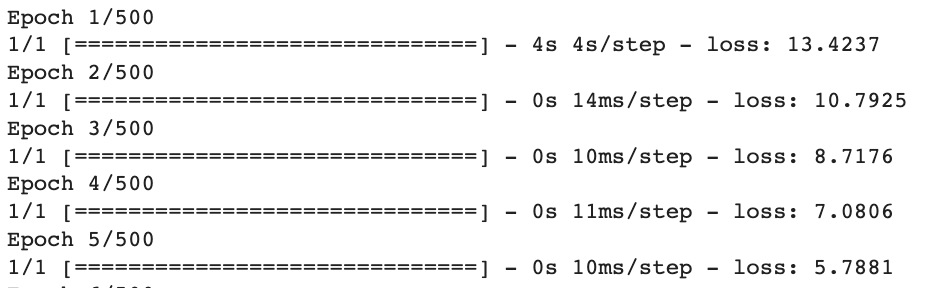
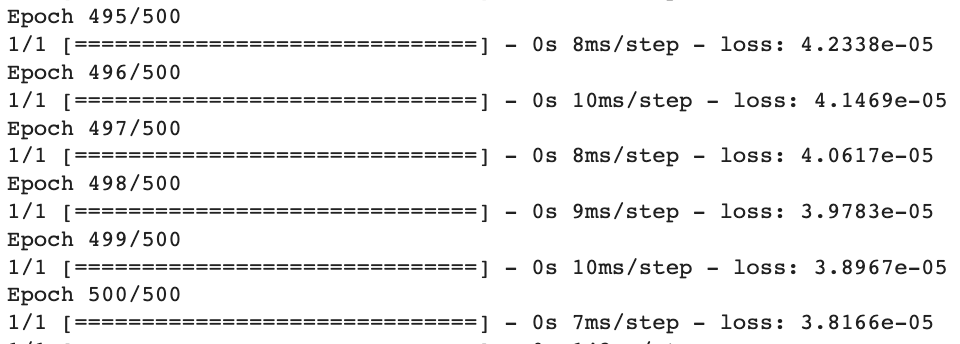
最初と最後の 5 期間の情報を出力します。13.4237 の開始時の損失が非常に大きく、最後の損失は非常に小さく、わずか 3.8166 e-05 であることを見つけるのは難しくありません。トレーニングセット内の値は実際の値とほぼ同じです。
モデルのトレーニング後、次を使用できます。get_weights() パラメータをチェックする機能。
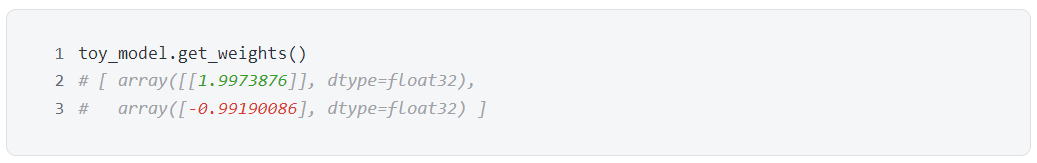 返される最初の結果は重量ですw、2番目のバイアスb副題y = 1.9973876 x - 0.99190086 ≈ 2 x - 1 。
1.3.5 評価モデル
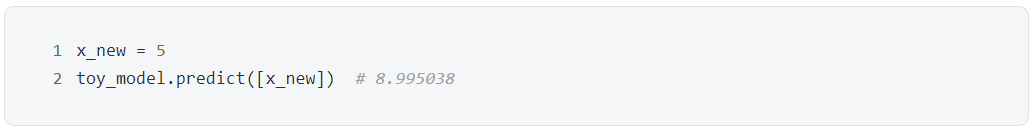
モデルの評価用predict() 関数に新しいデータ x_new を渡すと、結果 8.995028 が得られます。これは 2*x_new - 1 = 9 に非常に近い値です。
以下の図からわかるように、ニューラル ネットワークは 6 つのデータ (濃いシアンの点) からモデル (赤い線) を「学習」し、そのモデルを新しいデータ (青い点) で使用できるようになります。
ニューラル ネットワークのプロセス全体を要約します。
モデルを作成する:使用Sequential()もちろん、他のより良い方法もありますが、それについては次のセクションで説明します。
モデルをチェックする:使用summary()
モデルをコンパイルする:使用compile()
トレーニングモデル:使用fit()
評価モデル:使用predict()
この例では最小限のニューラル ネットワークを構築しますが、多くの 5 つのステップがあり、これらの 5 つのステップは複雑なニューラル ネットワークの構築にも必要です。違いは、最初のステップでモデルを作成するときに多くのレイヤーがつなぎ合わされることです。 5 番目のステップでは、より高度なオプティマイザーが選択されますが、それは決して変更されません。次の 2 つのセクションでは、もう少し複雑な 2 つのニューラル ネットワークを見てみましょう。フォワードフィードバックニューラルネットワーク (feedforward neural network,FNN)と最初のレベルのタイトル (convoluational neural network, CNN)。
2. フィードフォワード ニューラル ネットワーク (FNN)
前のセクションのミニマリスト ニューラル ネットワークは退屈すぎますが、主に Keras のニューラル ネットワークの概念と手順を明確にするために使用されます。いくつかの興味深いことを実行し、画像カテゴリを予測するニューラル ネットワークを見てみましょう。まず、使用されているデータセット CIFAR-10 (https://www.cs.toronto.edu/~kriz/cifar.html) を見てください。
データセットには合計 60,000 のカラー画像があり、これらの画像は 32*32 で 10 のクラスに分割され、各クラスには 6000 の画像があります。これらのうち、50,000 枚の画像がトレーニングに使用され、残りの 10,000 枚がテストに使用されます。次の図は、10 個のカテゴリと、各カテゴリにランダムに表示される 10 枚の画像のリストです。
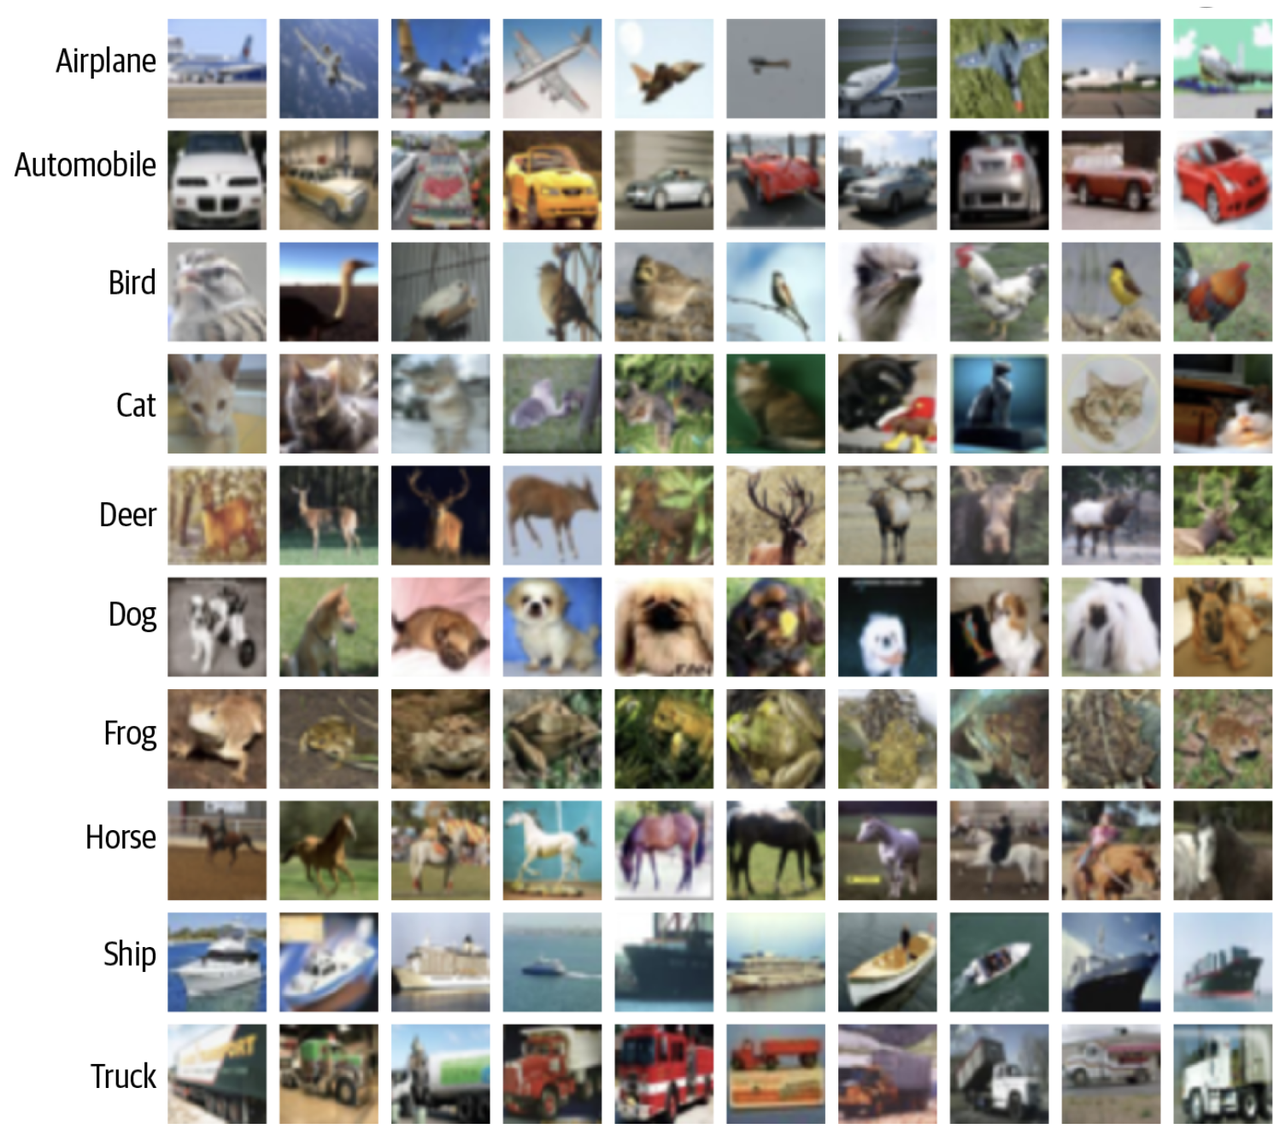
モジュール データセットのload_data() 関数を使用して、データをダウンロードし、画像のピクセルを正規化します。元のピクセルは 0 ~ 255 であり、現在は 0 ~ 1 に正規化されています。
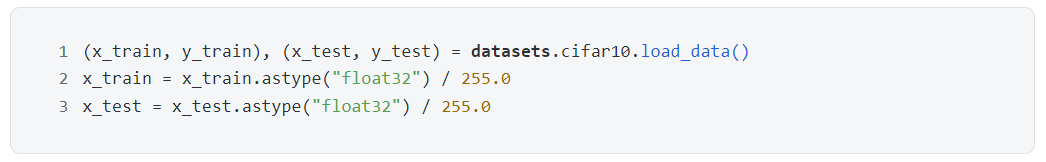
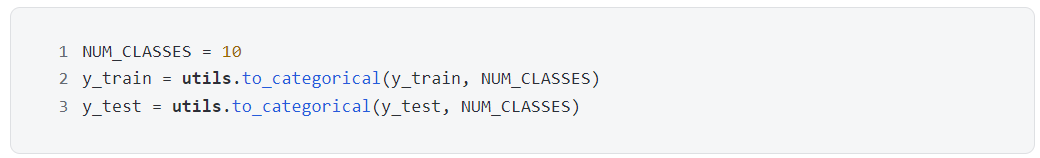
カテゴリの場合は、utils モジュールの関数を使用します。to_categorical() この関数は、カテゴリに対してワンホット エンコーディングを実行します。アイデアは、1 を 1 つだけ含むベクトルで整数を表すことです。たとえば、カテゴリ 5 は、ワンホット エンコード後は [ 0, 0, 0, 0, 1, 0, 0, 0, 0, 0 ] になります。ベクトルは 10 個です 要素の数はカテゴリの数と同じです ベクトルの 5 番目の要素だけが 1 (独特に暑い🧊) で、他は 0 (とても寒い🧊) です。
副題

副題
2.1.1 シーケンス
前のセクションでシーケンシャルモデリングを見てきましたが、最初に使用します。models.Sequential() は空のニューラル ネットワークを作成し、レイヤーを追加し続けます。この例ではレベリング層がありますlayers.Flatten() と 3 つの密なレイヤーlayers.Dense()。
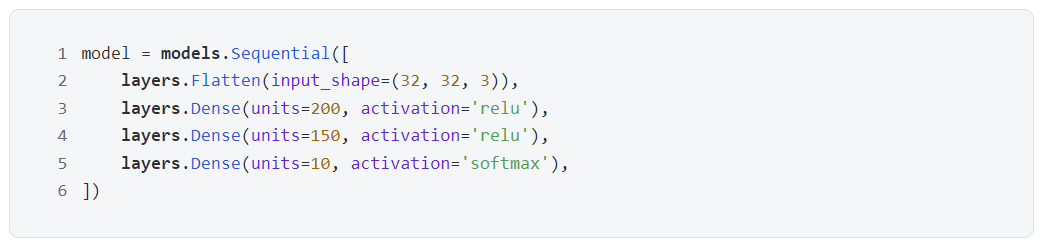
上記のコードにより、次の図に示すモデルが得られます。
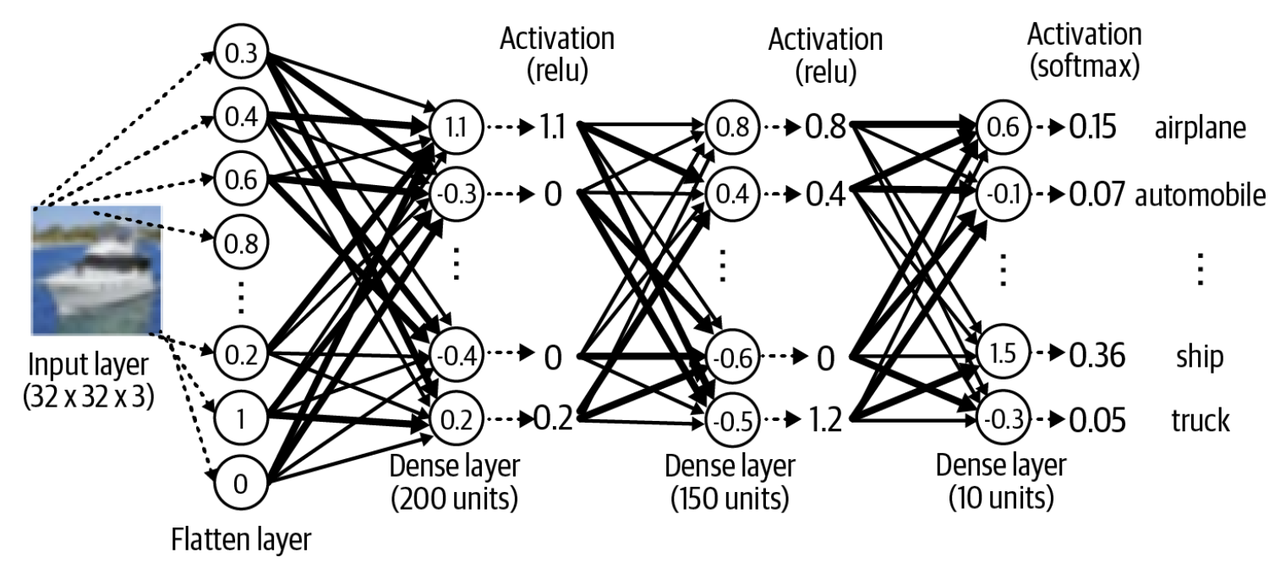
感覚的な知識を身につけて、コードを勉強しましょう。なぜレベリング層が必要なのでしょうか?画像には幅、高さ、カラー チャネルの 3 つの次元があるため、1 つの次元に平坦化するプロセスを次の図に示します。
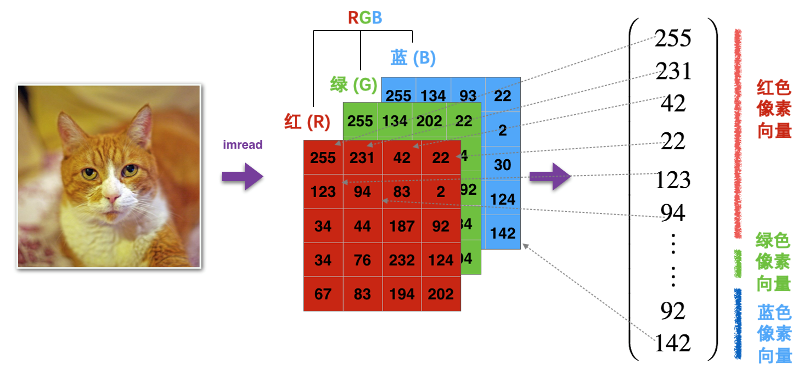
元の画像 (32, 32, 3) は平坦化レイヤー (パラメーター input_shape で画像の寸法サイズを指定) に入力され、平坦化後は 32*32*3 = 3072 のベクトルになります。これは次のように想像できます。現在、入力には 3072 個のニューロンがあります。緻密な三層を経た後
ニューロン (パラメータ ユニット) の数はそれぞれ 200、150、10 です。最初の 200 と 150 はハイパーパラメータとして何気なく与えられるかデバッグされますが、最後の 10 はカテゴリの数と一致します。
使用する活性化関数 (パラメータ活性化) はそれぞれ relu、relu、softmax です。最初の 2 つの relu はほぼ標準ですが、最後のソフトマックスはタスクに関連します。多分類問題の場合はソフトマックスを使用します。
一般活性化関数(アクティベーション関数) 以下に示すように:
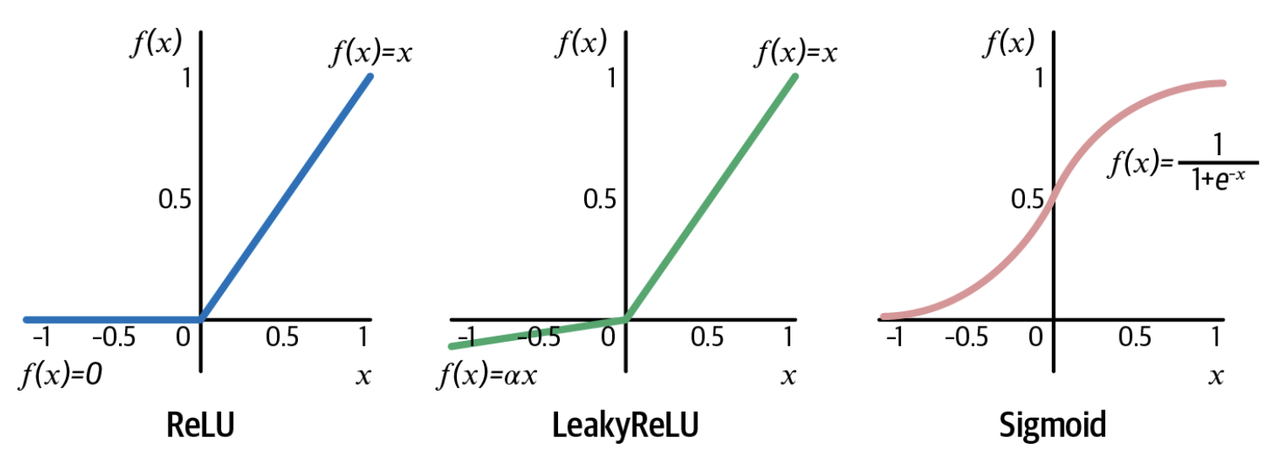
ReLU は負の入力 (x < 0) を 0 に変換し、正の入力 (x > 0) は変更されません。 LeakyReLU は ReLU に非常によく似ていますが、唯一の違いは負の入力 (x< 0)、変換の結果も入力に対して負の数 (ax) になります。
Sigmoid 実数を0から1までの数値に変換すると、この数値は確率とみなすことができるので、Sigmoid 二項分類問題の関数、その拡張版Softmax副題
2.1.2 機能的なスタイル
実際には、私たちは使用することに慣れています。機能的(機能的な)モデリング。順次構築されるモデルは、関数型メソッドを使用して完成させることも、その逆も可能です。2 つのうちのいずれかを選択する場合は、関数型メソッドのみを使用してモデルを構築することをお勧めします。コードは以下のように表示されます。
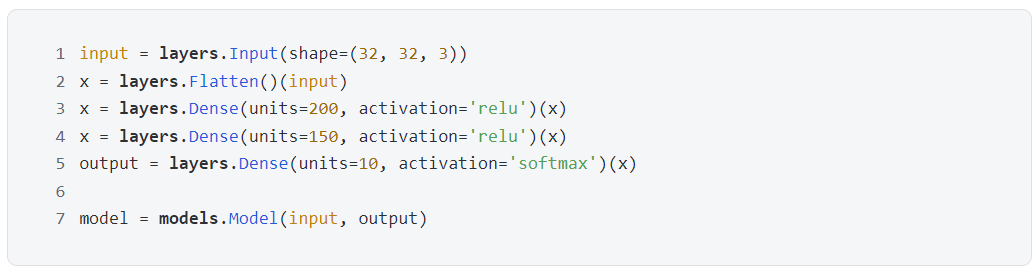
機能モデリングでは、次の 1 つの文を覚えておくだけで済みます。レイヤーを関数として使用する。この文を念頭に置いておけば、コードは数秒で理解できます。
1行目、 Input() 画像データを受信します。
2行目、入れますFlatten() 機能としてf、簡略化は x = f(input) ではありません。
3行目に次のように入れますDense(units= 200,activate='relu') 関数としてg、単純化は x = g(x) ではありません。
4行目、入れますDense(units= 150,activate='relu') 関数としてh、単純化は x = h(x) ではありません。
5行目、入れますDense(units= 10,activate='softmax') を関数として使用q、単純化は出力されません = q(x)
このようなレイヤーごとの関数は、入力を出力に転送し、output = q(h(g(f(input))))、最後に次を使用します。models.副題
2.2 機種の確認
モデルの作成後、使用する前に、次のコマンドを使用して、ニューラル ネットワークの各層のデータ形状が正しいかどうかを確認するのが最善です。summary() 機能は、そのような情報を印刷するのに役立ちます。
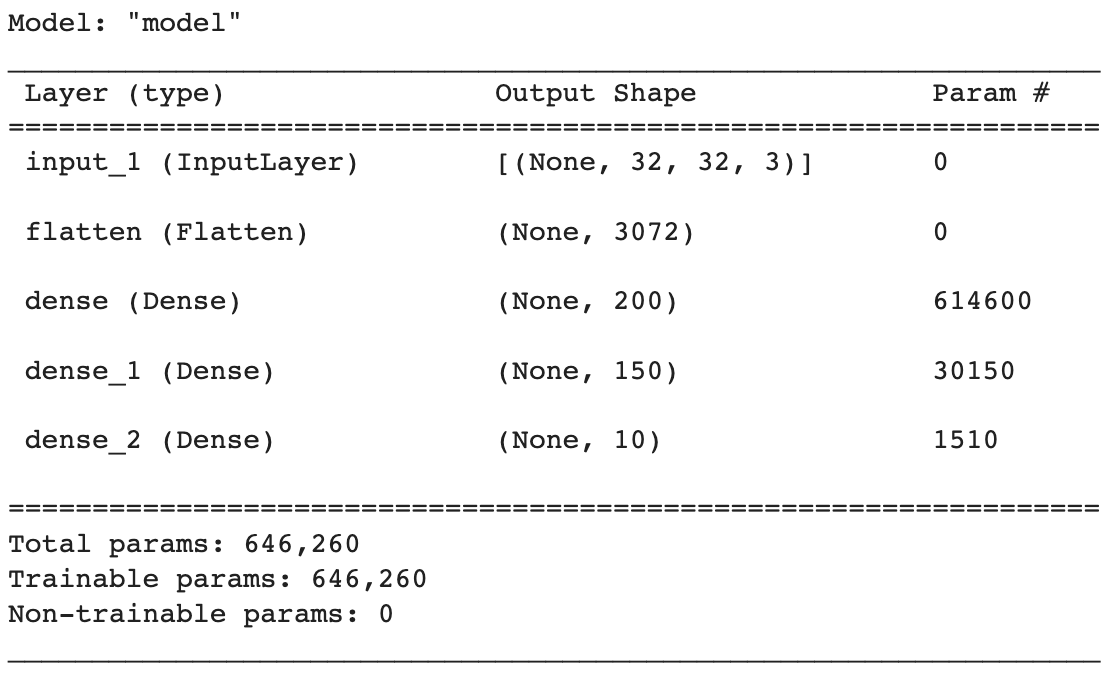
モデルには自動的に「model」という名前が付けられ、その後に名前のタイプ (レイヤー (type))、出力形状 (Output Shape)、各レイヤーのパラメーターの数 (Param #) を説明するテーブルが続きます。レイヤーごとに見てみましょう
InputLayer レイヤーの名前は input_ 1 、出力形状は [None, 32, 32, 3 ] です。最後の 3 つの要素は画像の幅、高さ、およびカラー チャネルに対応します。最初の None は実際にサンプルの数を表します。より厳密には、言い換えれば、それはバッチ内のサンプルの数です。コードを簡潔にするため、通常、モデリング時にこのサンプル番号を明示的に記述する必要はありません。
Flatten レイヤーの名前は flatten です。3072 は平坦化後の 32*32*3 の数で、平坦化は単に配列を再形成するだけであり、再形成アクションを完了するためにパラメーターは必要ないため、パラメーターの数は 0 です。
最初の Dense レイヤーの名前は「dense」、出力形状は 200、パラメータは 614、600 = ( 3072 + 1) * 200、バイアス ユニットを忘れないでください。
2 番目の Dense レイヤーの名前はdensence_1、出力形状は 150、パラメータは 30、150 = (200 + 1) * 150、バイアス ユニットも考慮します。
3 番目の Dense レイヤーの名前はdensence_2、出力形状は 10、パラメーターは 1、510 = (150 + 1) * 10、バイアス ユニットも考慮します。
下部には合計パラメーター (Total params) もリストされています。646, 260 、トレーニング可能なパラメータの量 (Trainable params)646, 260 、トレーニング不可能なパラメーターの量 (Non-trainable params)0 副題
2.3 モデルをコンパイルする
モデルが構築されたら、モデルをコンパイルする必要があります。次の 3 つの点を設定する必要があります。
解決すべきタスクに応じて損失関数を選択してください
理想的なオプティマイザーを選択する
監視したいメトリクスを選択します
モデルをコンパイルしますcomplie() 存在する
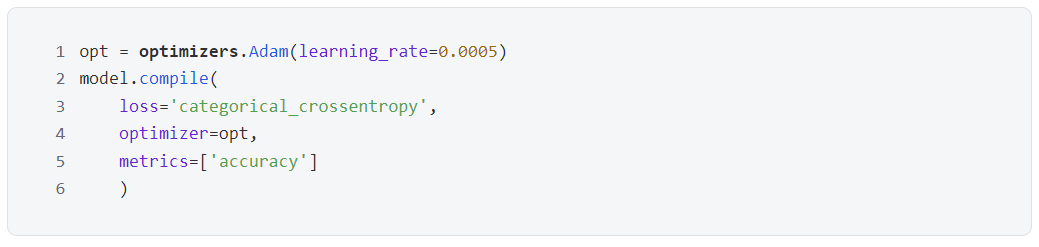
存在するcomplie()関数内:
パラメーター損失の場合、この例は非常にクラスの問題であるため、使用される損失関数は categorical_crossentropy に加えて次のとおりです。
2 つの分類問題: 損失関数は binary_crossentropy
回帰問題: 損失関数はmean_squared_errorです
パラメーター オプティマイザーの場合、adam オプティマイザーと rmsprop オプティマイザーをデフォルトの学習率で使用することが、ほとんどの場合安全です。このパラメータを設定するときは、名前を使用してオブジェクトをインスタンス化して呼び出すこともできます。
名前: 'sgd'
オブジェクト: optimizers.Adam(learning_rate= 0.0005)
パラメーター メトリックの場合、名前を使用してオブジェクトをインスタンス化することによって呼び出すこともできます。この例では、インジケーターは精度であるため、次のように記述できます。
名前: ['精度']
オブジェクト: [metrics.categorical_accuracy]
副題
2.4 トレーニングモデル
トレーニング モデルは、すべてのデータをまとめてスローするのではなく、バッチでスローします。トレーニング モデルを導入する前に、いくつかの概念を明確にする必要があります。
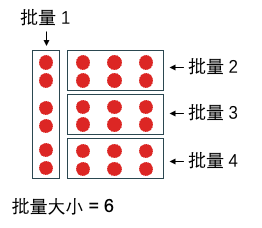
バッチサイズ(バッチ サイズ) は、バッチ内のサンプルの数を指します。次の例では合計 24 個のデータがありますが、各バッチに 6 個のデータがある場合、オフィス全体を 4 つのバッチに分割できます。
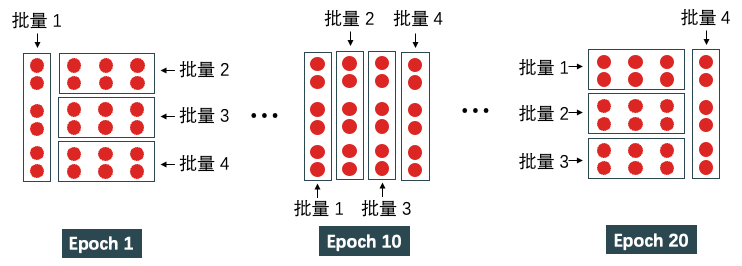
期待する(エポック) は、トレーニング セット全体がアルゴリズムによって 1 回走査されることを意味します。エポックが 20 に設定されている場合、トレーニング セット全体をさまざまな方法で 20 回走査する必要があります。データセット全体を走査するには、エポックは 4 回の反復を実行する必要があります。つまり、サンプルの総数 / バッチ サイズ = 24 / 6 反復になります。 20 エポックの実行プロセスを次の図に示します。
トレーニングモデルfit()関数のコードは次のとおりです。
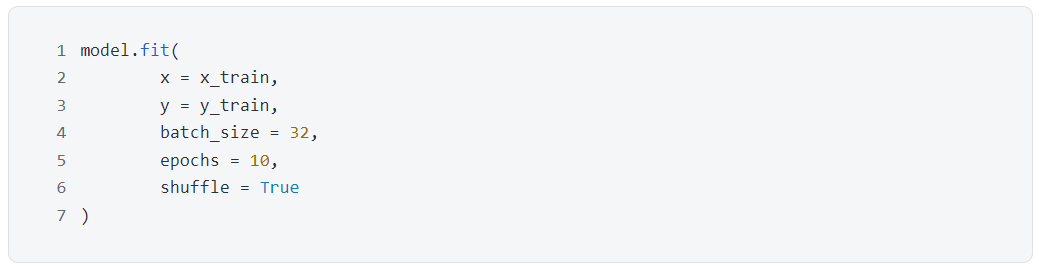
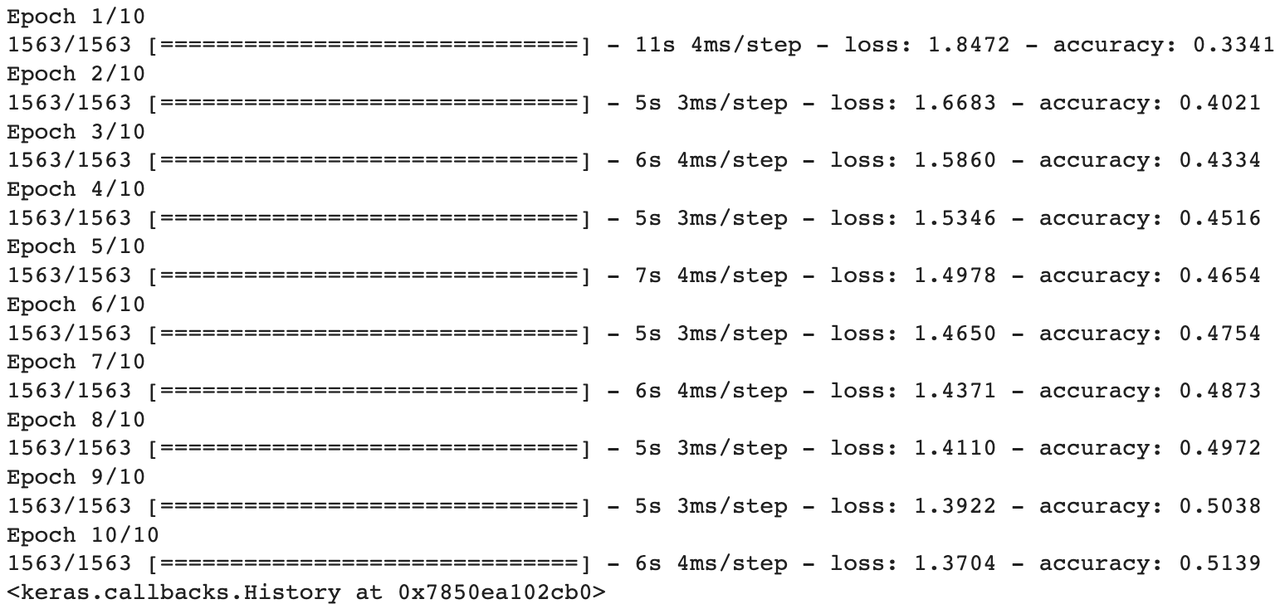
上の図はトレーニング ステップを示しており、トレーニング セットが 1563 個のパイルに分割されており、それぞれに 32 個の画像 (バッチ サイズ) が含まれていることがわかります。 10エポック後、損失関数(カテゴリクロスエントロピー) は 1.8472 から 1.3696 に低下しましたが、正確さ(精度) 33.41% から 51.39% 。モデルはトレーニング セット上で到達可能です51.39% 副題
2.5 評価モデル
使用evaluate()関数は正解率に直接依存します。
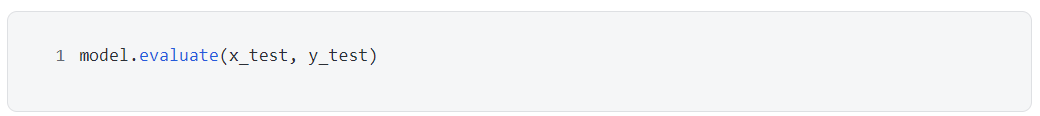
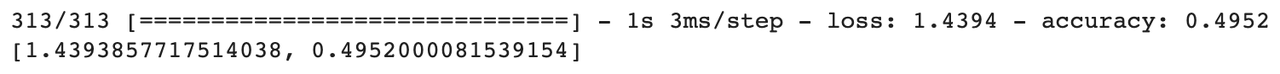
テスト セットのモデルの精度は次のとおりです。49.52% これは、カテゴリをランダムに予測する 10% の精度よりもはるかに高くなります (カテゴリが 10 個あるため)。このような非常に単純なフィードフォワード ニューラル ネットワークを使用して画像カテゴリを予測するため、49.52% 正解率はすでに良好な結果と考えられます。
使用predict()関数は、予測されたクラスと実際のクラスを比較します。
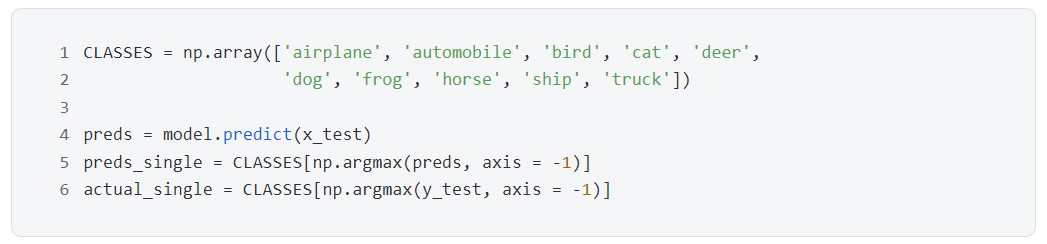
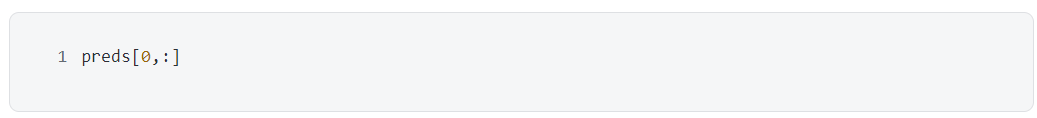
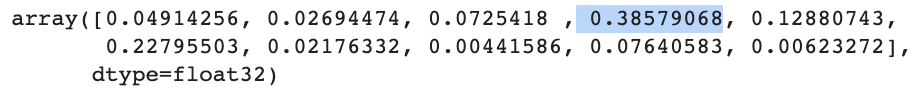
テスト セットには 10,000 枚の画像があり、10 個のカテゴリがあるため、 preds は [ 10000, 10 ] の配列であり、各行は、対応する画像のモデルによって予測された 10 個のカテゴリの確率です。合計して 1 になります。テスト セットの最初の画像の予測を見てみましょう。
y_test も [ 10000, 10 ] の配列で、各行は対応するピクチャの真のカテゴリであるため、10 個の要素には 9 個のゼロと 1 個の 1 が含まれます。テスト セットの最初の画像の真のカテゴリを確認します。
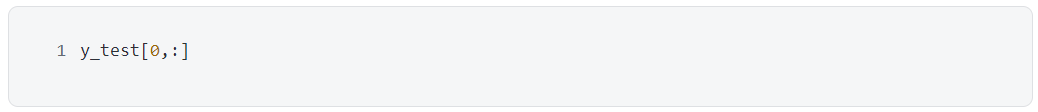
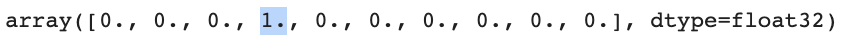
予測結果 preds[0,:] のカテゴリ 4 の確率が最も高い 0.38579068 であり、実際のカテゴリ test[0.:] がカテゴリ 4 (4 番目の要素が 1) であることを確認するのは難しくありません。 np.argmax を使用して、予測結果 preds[0,:] と実際のカテゴリ test[0.:] から最大値に対応するインデックスを見つけ、CLASSES からカテゴリの説明をマッピングします。
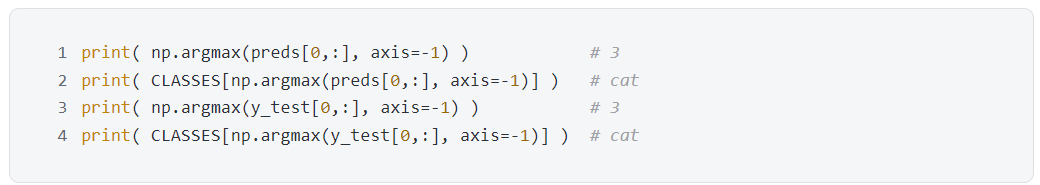
テスト セットの最初の写真は猫で、モデルは猫を予測したので、それは正解です。
4番目をもう一度試してください。
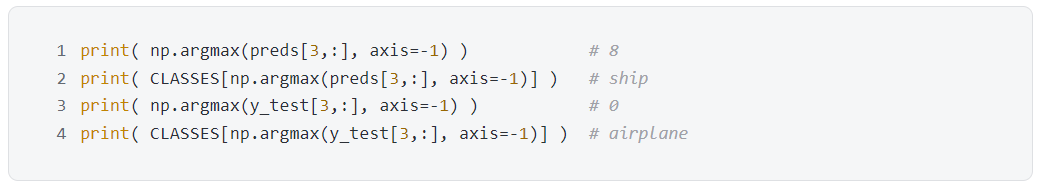
テスト セットの 4 番目の写真は船ですが、モデルは飛行機を予測していましたが、これは間違いです。
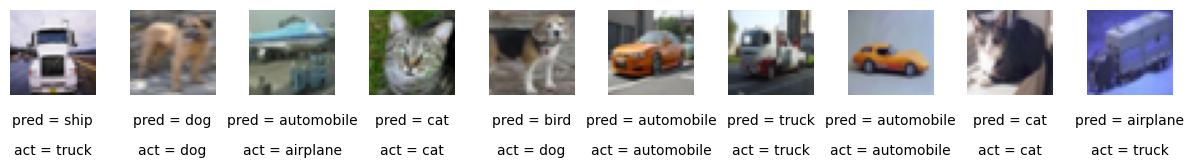
視覚化: 上記の比較方法は面倒すぎるため、テスト セットからランダムに 10 枚の画像を選択し、各画像を印刷して、モデル予測カテゴリとその実際のカテゴリを画像の下に貼り付けることができます。
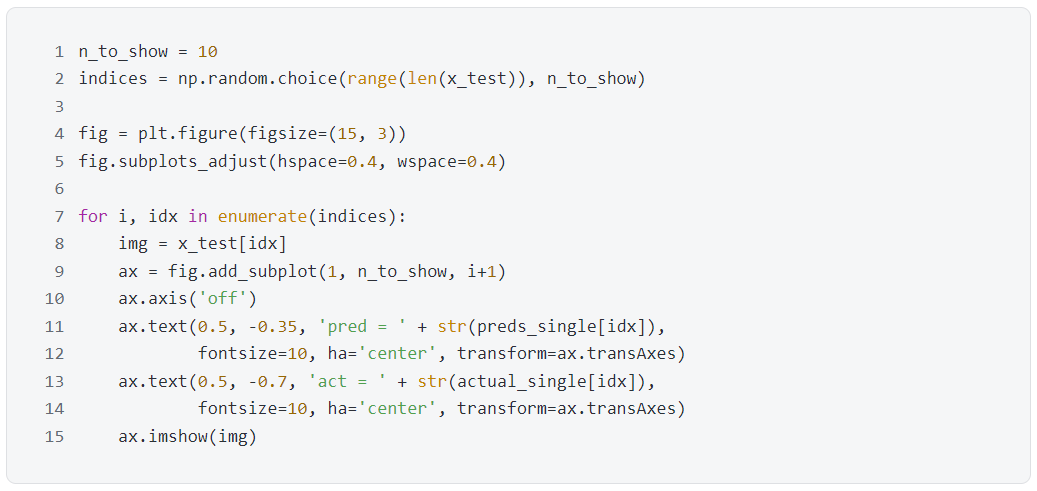
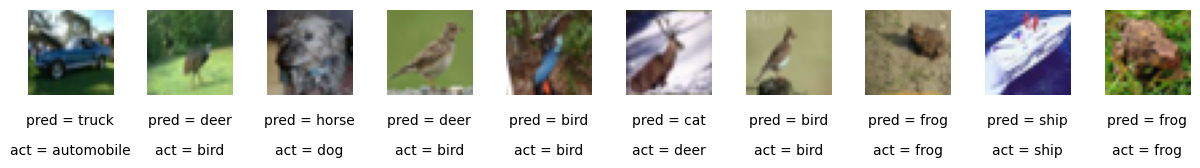
上記の 10 枚の小さな画像から、モデルはそのうち 5 枚を正しく予測し、正解率は 50% で、以前の統計の 49.52% と一致していることがわかります。これは予測のための判別モデルにすぎませんが、このセクションで紹介した内容 (レイヤー、活性化関数、オプティマイザーなど) は生成モデルを作成するときにも適用されます。
最初のレベルのタイトル
3. 畳み込みニューラルネットワーク (CNN)
副題
3.1 基本概念
暗闇の中で巨大な絵が目の前に現れたとします。暗闇ではそれは車としては見えません。懐中電灯を使って少しずつスキャンし、そのたびに見えるものを画面に投影することしかできません。次の層、などのように。たとえば、最初のレイヤーにはいくつかの水平線、垂直線、斜線、2 番目のレイヤーにはいくつかの円と四角形、3 番目のレイヤーには車輪、ドア、ボディ、4 番目のレイヤーには車が表示されます。このようにして、懐中電灯を使用して、暗闇の中で写真に写っている車を見つけることができます。
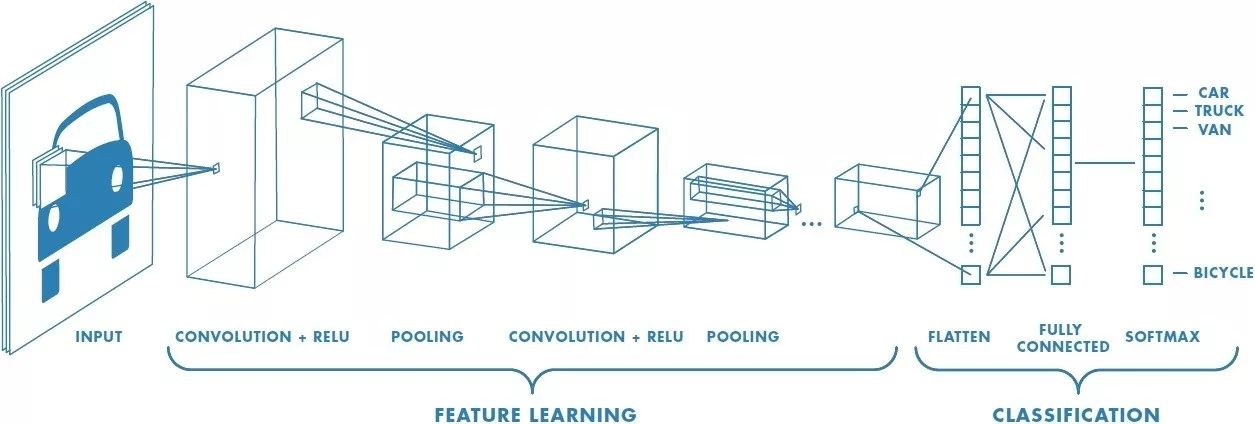
上記の例は、実際には畳み込みニューラル ネットワークによる画像認識プロセスです。まず、いくつかの定義を明確にします。
フィルター(フィルター): 上の例の懐中電灯のように、入力データを畳み込みながら、入力データの幅と高さを横切ってスワイプします。
畳み込み(畳み込み): ここでの定義は、すべての「フィルターのピクセル」と「画像をスイープするフィルターのピクセル」を乗算し、合計することです。
刻み幅(ストライド): 画像を移動するときのフィルターのステップ サイズ。デフォルト値は 1 です。つまり、フィルターは一度に 1 ピクセルずつ移動します。
充填(パディング): 入力データの端が 0 で埋められる場合があります。これにより、出力データのサイズを制御できます (最も一般的に使用されるのは、出力データのサイズを入力データと一致させることです)。
コンボリューション
畳み込みニューラルネットワークの最大の特徴は、やはり畳み込み演算です。上記の定義に戻り、フィルタのサイズを 3*3 として、「フィルタの画素数」と「フィルタで掃引した画像の画素数」を掛けて合計すると、次の 2 つの例を参照してください。
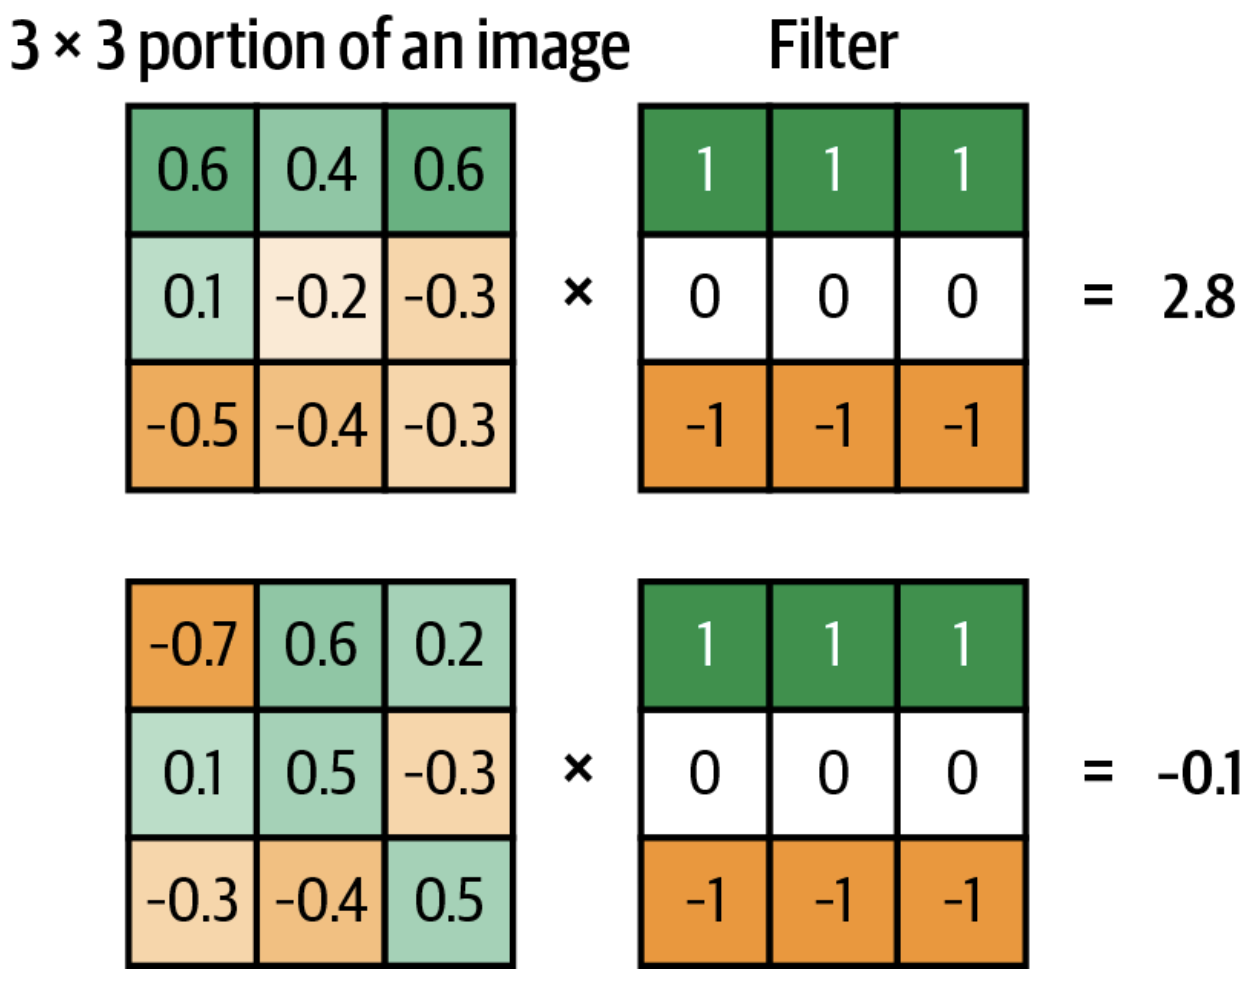
最初の画像とフィルターの畳み込みは、0.6*1 + 0.4*1 + 0.6*1 + 0.1*0 + (-0.2)*0 + (-0.3)*0 + (-0.5)*(-1) + (-0.4)*(-1) + (-0.3)*(-1) =2.8 。
2 番目のイメージとフィルターの畳み込みは、(-0.7)* 1 + 0.6* 1 + 0.2* 1 + 0.1* 0 + 0.5* 0 + (-0.3)* 0 + (-0.3)*(-1) + (-0.4)*(-1) + 0.5*(-1) =-0.1 。
畳み込み値が大きい場合ただ、フィルターと画像がより多くのことを示しますマッチ; 畳み込み値が大きい場合重荷、フィルターと画像がより多くのことを示します一致していません。上の例の最初の画像とフィルターの畳み込み値は次のとおりです。2.8 、 両方マッチ; 2 番目の画像とフィルターの畳み込み値は次のとおりです。-0.1 、 両方一致していません。
フィルター
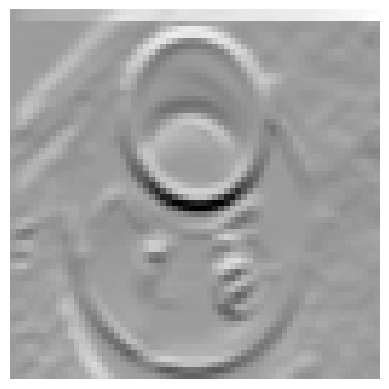
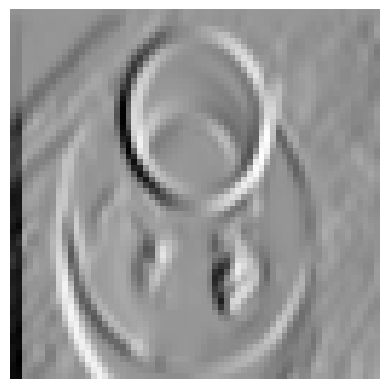
フィルタの機能はフィルタリング、つまり一部の情報を取り除くことであり、これは保持されている情報を抽出することに相当します。次のコードは、サイズ 3*3 の 2 つのフィルターを作成します。フィルター 1 は画像の水平線を抽出でき、フィルター 2 は画像の垂直線を抽出できます。ここで、1 は黒、0 はグレー、-1 は白を表すことに注意してください。
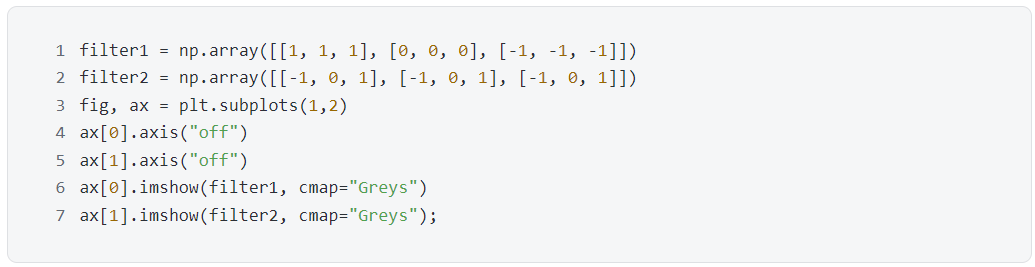
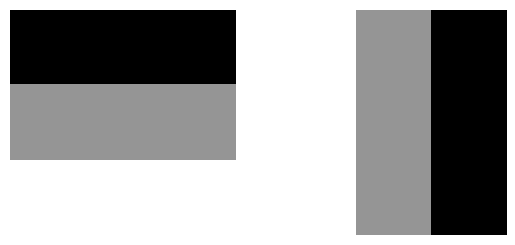
これら 2 つのフィルターを使用して情報を抽出する方法を見てみましょう。元の画像は次のとおりです。
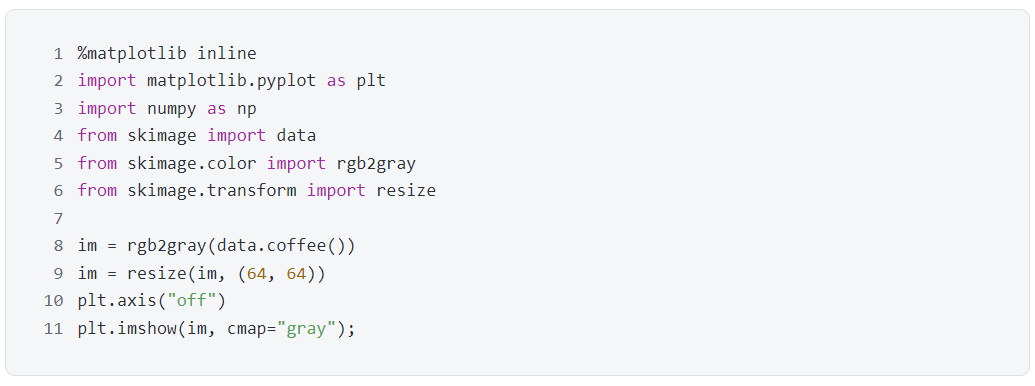
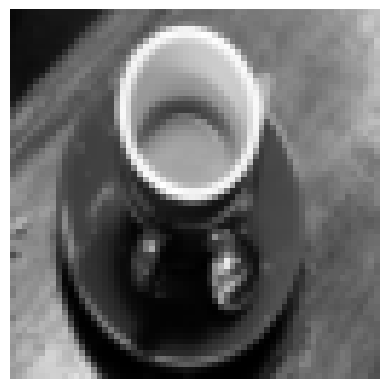
フィルタ 1 がカップの口の上端と下端などの水平方向のエッジ情報を画像から抽出していることを見つけるのは難しくありません。
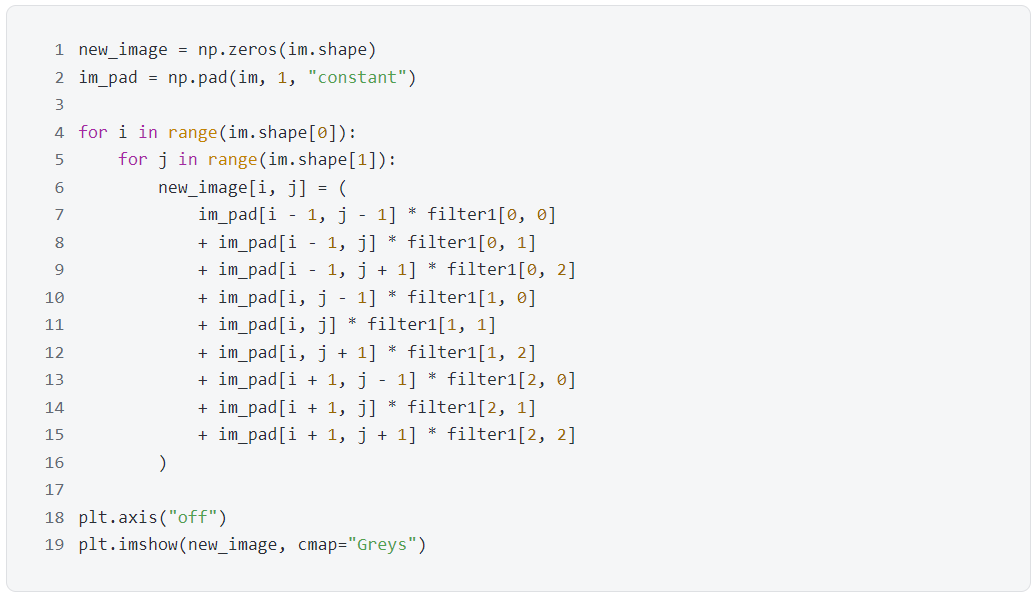
フィルター 2 がカップの口の左右のエッジなど、画像から垂直エッジ情報を抽出していることを見つけるのは難しくありません。
フィルターを追加すると、次のようなものを作成できます。畳み込み層(畳み込み層)。畳み込み層は本質的にフィルターのセットであり、以下の例ではその数は 2 であり、フィルター内の要素の値は重みと呼ばれ、CNN のトレーニングによって学習されます。
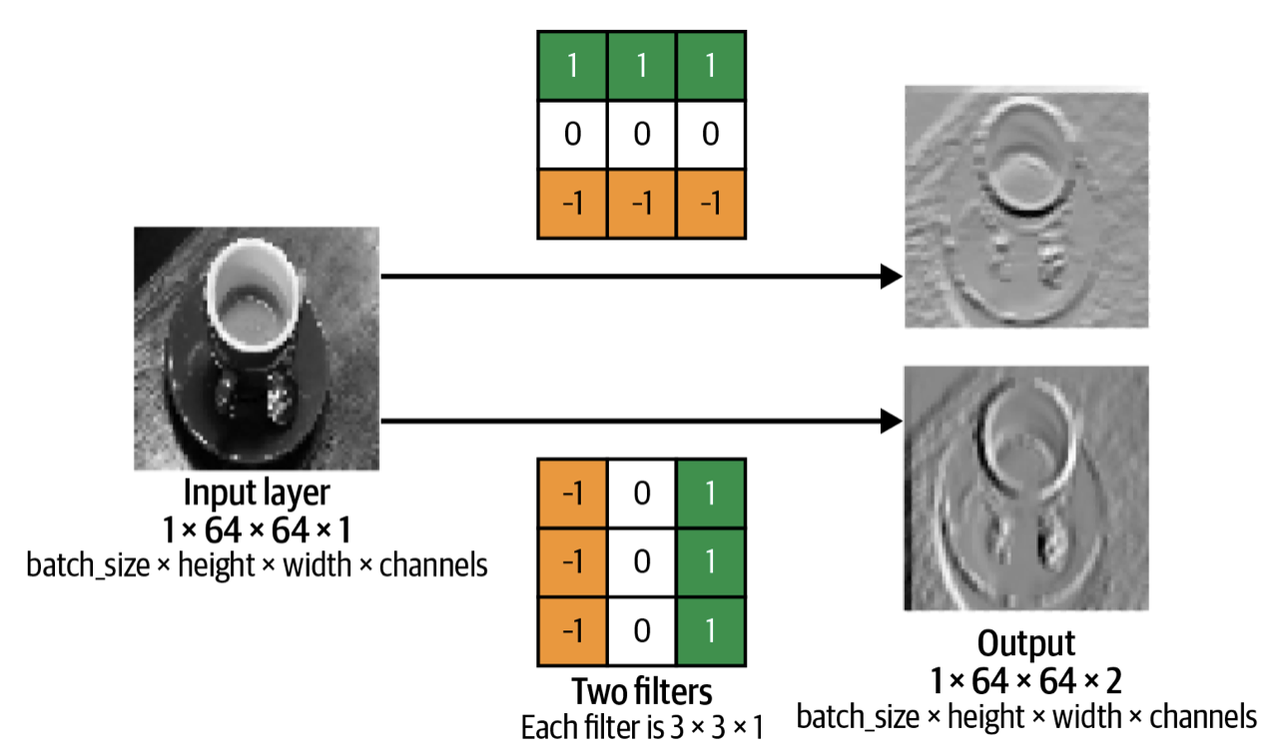
Kerasで使用されるlayers.Con v 2 D() を使用して畳み込み層を作成します。ここで、白黒写真は 64*64*1 (カラー チャネルは 1 つだけ)、フィルターは 2 つあり (フィルター パラメーターは 2 に設定されています)、フィルター サイズは 3*3 (パラメーター kernel_size が設定されています) です。 (3, 3)) に。
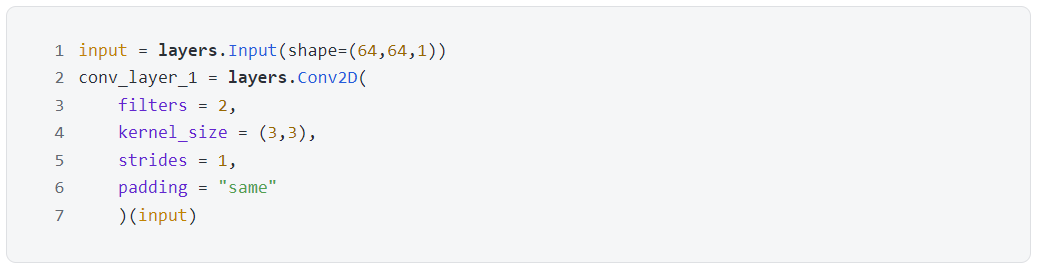
ストライドとパディングの 2 つのパラメータとは何ですか?
歩幅
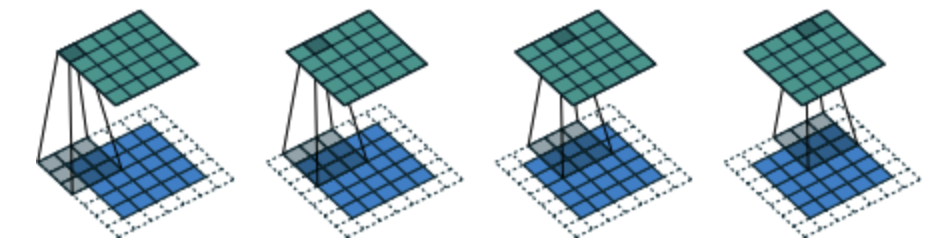
ステップ サイズは、フィルタがイメージを移動するときに移動するピクセル数です。デフォルト値は 1 で、これはフィルタが一度に 1 ピクセルずつ移動することを意味します。ストライドが 2 の場合、出力画像のサイズが入力画像の半分のサイズしかないことは想像に難くありません。
パディング
パディングとは、その名前が示すように、画像の周囲に要素を追加することです。パディングの場合 ="same"strides = 1 の場合、出力イメージが入力イメージと同じサイズであることが保証されます。下図の入力画像サイズは 5*5 (青い画像)、塗りつぶし後の画像サイズは 7*7 (白い画像)、フィルター サイズは 3*3 (灰色)、出力画像サイズは 5 のままです。 ※5(緑色の写真)。
副題
3.2 連結された畳み込み層
まずコードの一部を見てください。
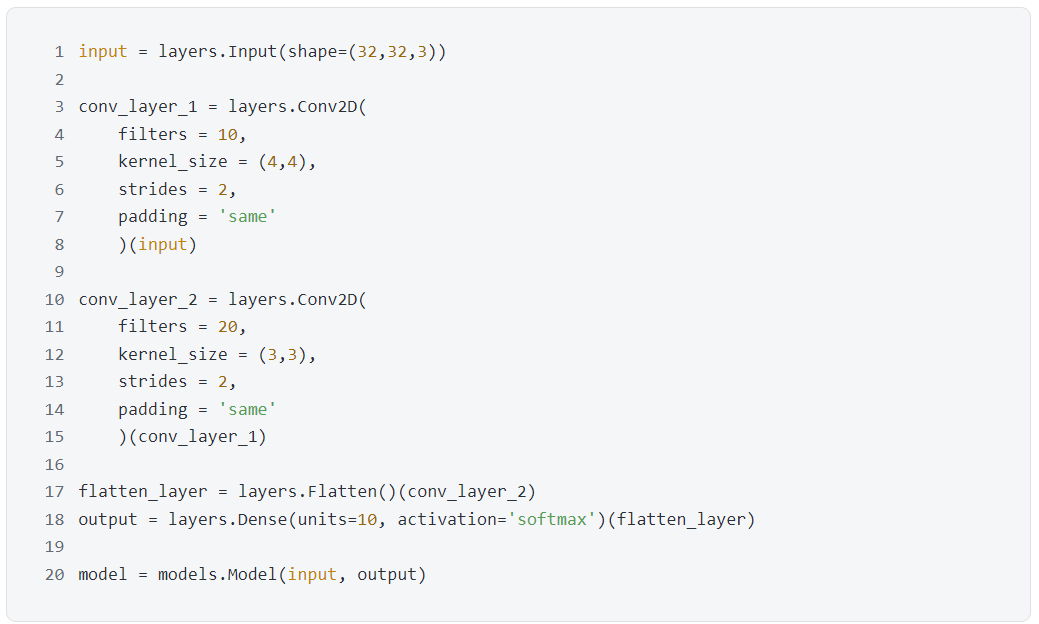
上記のコードは、以下の画像に対応します。
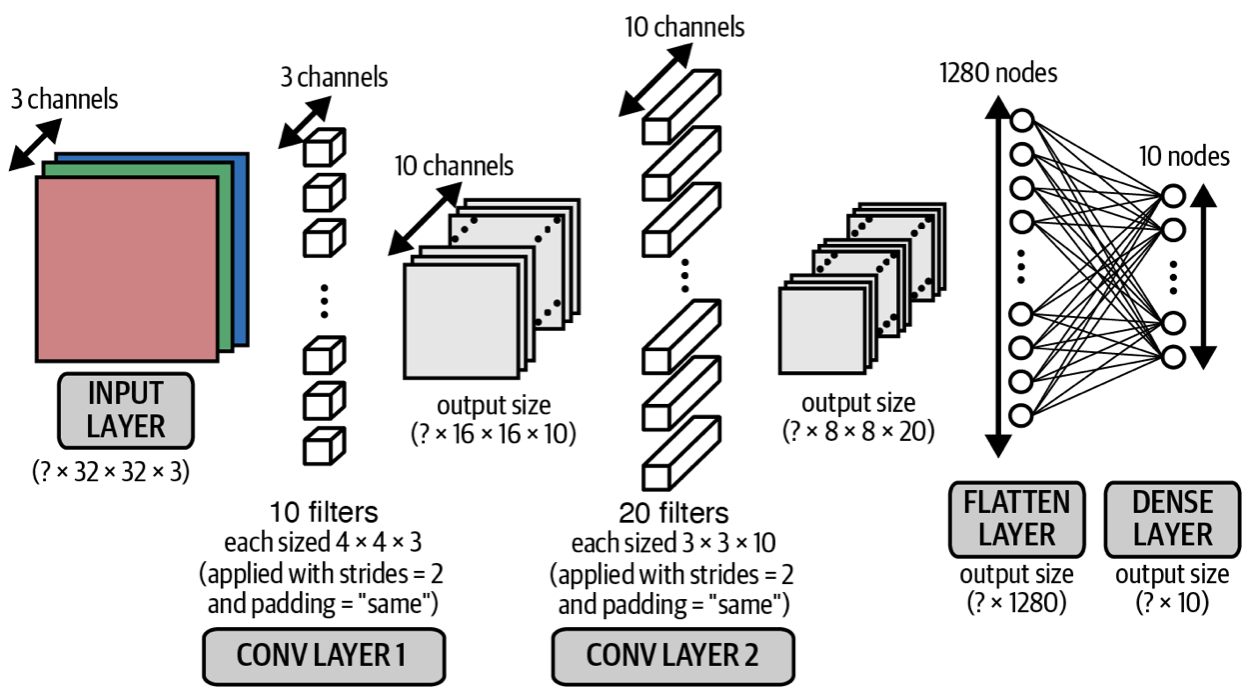
上記の各畳み込み層の出力のサイズは目を見張るものがあります。 nI 入力画像のサイズを表します。f フィルターのサイズを表し、sステップサイズを表し、p充填層の数を表します。nO入力画像のサイズを表すと、次の関係があります。
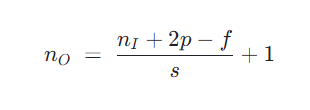
次の式を使用して、最初と 2 番目の畳み込み層の出力の幅と高さを確認します。
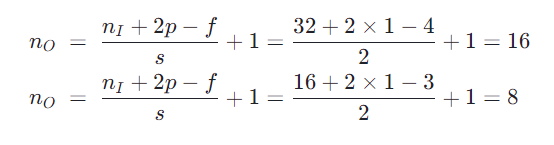
ここで最も重要なことは、畳み込み層の出力カラー チャネルは、フィルターの数 (つまり、コード内のパラメーター フィルター) と同じです。。直観的に理解すると、各フィルターは「スキャン」画像に対して並列で畳み込みを実行し、最終出力はフィルターの数と同じ次元サイズを持つ必要があるということです。
モデルをチェックしてください。
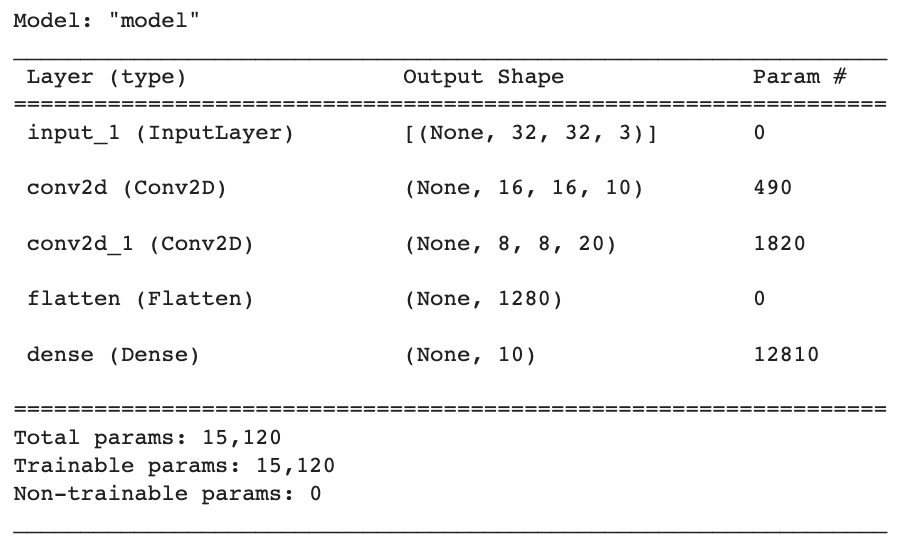
モデルには自動的に「model」という名前が付けられ、その後に名前のタイプ (レイヤー (type))、出力形状 (Output Shape)、各レイヤーのパラメーターの数 (Param #) を説明するテーブルが続きます。レイヤーごとに見てみましょう
InputLayer レイヤーの名前は input_ 1 、出力形状は [None, 32, 32, 3 ] です。最後の 3 つの要素は画像の幅、高さ、およびカラー チャネルに対応します。最初の None は実際にサンプルの数を表します。より厳密には、言い換えれば、それはバッチ内のサンプルの数です。コードを簡潔にするため、通常、モデリング時にこのサンプル番号を明示的に記述する必要はありません。
最初の Con v 2 D レイヤーの名前は con v 2 d、出力形状は [None, 16, 16, 10 ]、パラメーター 490 = ( 4* 4* 3 + 1) * 10、まず第一に、バイアスがあることを忘れる 次に、4*4 はフィルターのサイズ、3 は入力カラー チャネルの数であるため、各フィルターを記述するには 4*4*3 の重みが必要で、合計 10 個あります。
2 番目の Con v 2 D 層の名前は con v 2 d_ 1 、出力形状は [None, 8, 8, 20 ]、パラメーターは 1, 820 = ( 3* 3* 10 + 1) * 20 です。最初に次のことを考慮します。同じバイアス単位に続く 3*3 はフィルタのサイズ、10 は入力カラー チャネルの数であるため、このフィルタを記述するには 3*3*10 の重みが必要で、合計 20 になります。
Flatten レイヤーの名前は flatten です。1, 280 は平坦化後の 8*8*20 の数で、平坦化は単に配列を再形成するだけであり、再形成アクションを完了するためにパラメーターは必要ないため、パラメーターの数は 0 です。
最後の Dense レイヤーは Density という名前で、出力形状は 10、パラメーターは 12、810 = (1280 + 1) * 10、バイアス ユニットも考慮します。
下部には、合計パラメーター (Total params) 15、120、トレーニング可能なパラメーター (Trainable params) 15、120、およびトレーニング不可能なパラメーター (Non-trainable params) 0 もリストされています。
この時点で、CNN は基本的に構築されています。CNN をより適切に機能させるために、さらに 2 つのテクニックを追加します。バッチ正規化(バッチ正規化) および副題 (dropout)。
3.3 バッチ正規化
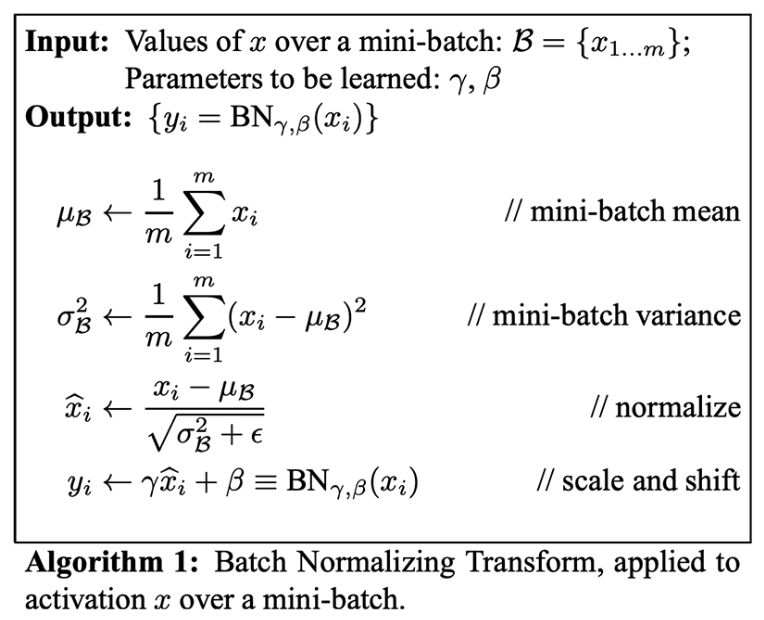
CNN をトレーニングする場合、モデルを成功させる鍵は、重みが特定の範囲内に収まるようにすることです。そうしないと、勾配が爆発的に増加します。バッチ正規化によりこの問題を解決できます。各層でデータをバッチ (ミニバッチ) で計算します。平均(意地悪)そして標準偏差(標準偏差) を計算し、各データの平均を標準偏差で割った値を引きます。データを「復元」するには、2 つのパラメータ、スケーリング パラメータを「学習」する必要があります。γおよび翻訳パラメータβ。
バッチ正規化アルゴリズムは次のとおりです。
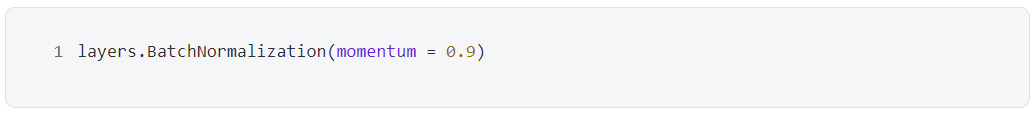
Keras では BatchNormalization() を使用してバッチ正規化を実現します。バッチ正規化層は通常、密層または畳み込み層の後に配置されます。
副題
3.4 ランダムな非アクティブ化
ランダム化は試験からインスピレーションを受けました。通常、試験前に学生は知識ポイントを学ぶために過去の論文に取り組みます。学生の中には、暗記で問題を解くため、知識のポイントがよく理解できずに本番のテストで成績が上がらない人もいます。優秀な学生は、新しい質問に正しく答えることができるように、共通知識のポイントを理解するために論文を使用します。
同様に、ニューラル ネットワークの「暗記」を防ぐために、下の図に示すように、一部のニューロンをランダムに非アクティブ化、つまり出力を 0 にできます。
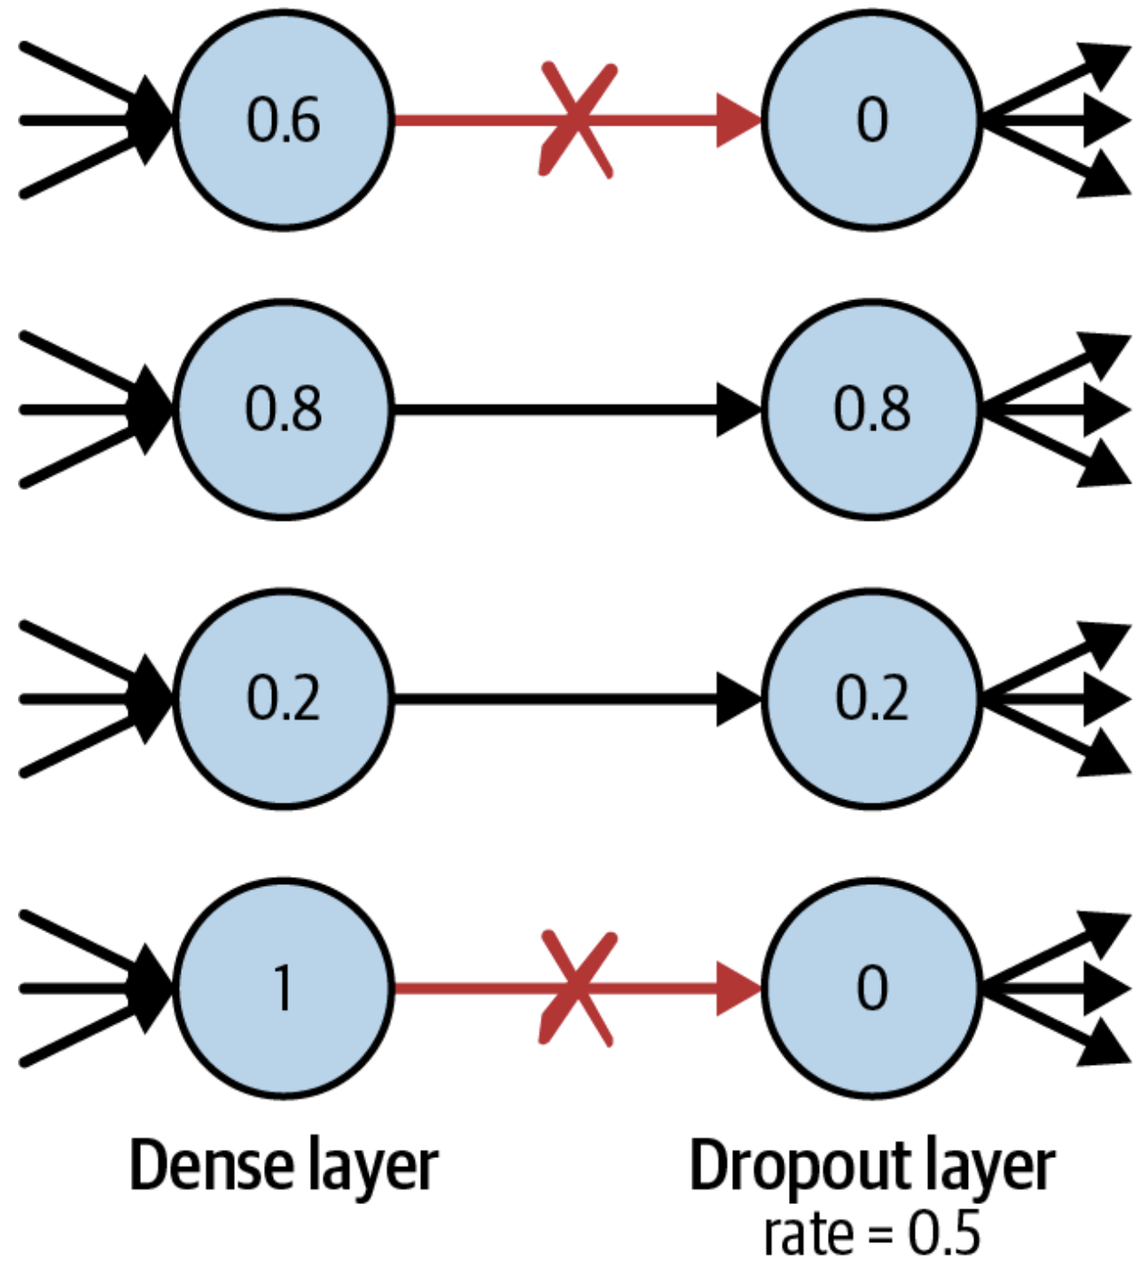
予測プロセス中、ニューロンは非アクティブ化されないため、完全なニューラル ネットワークが予測を行うために使用されます。
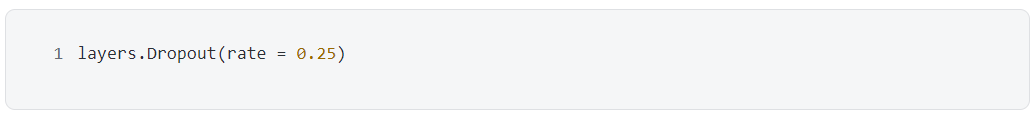
Kerasで使用されるDropout()不活性化層を実現します。不活性化層は通常、緻密層の後に配置されます。
副題
3.5 完全なモデル
これで、バッチ正規化レイヤーと非アクティブ化レイヤーを前の CNN に追加してモデルを改善できるようになりました。
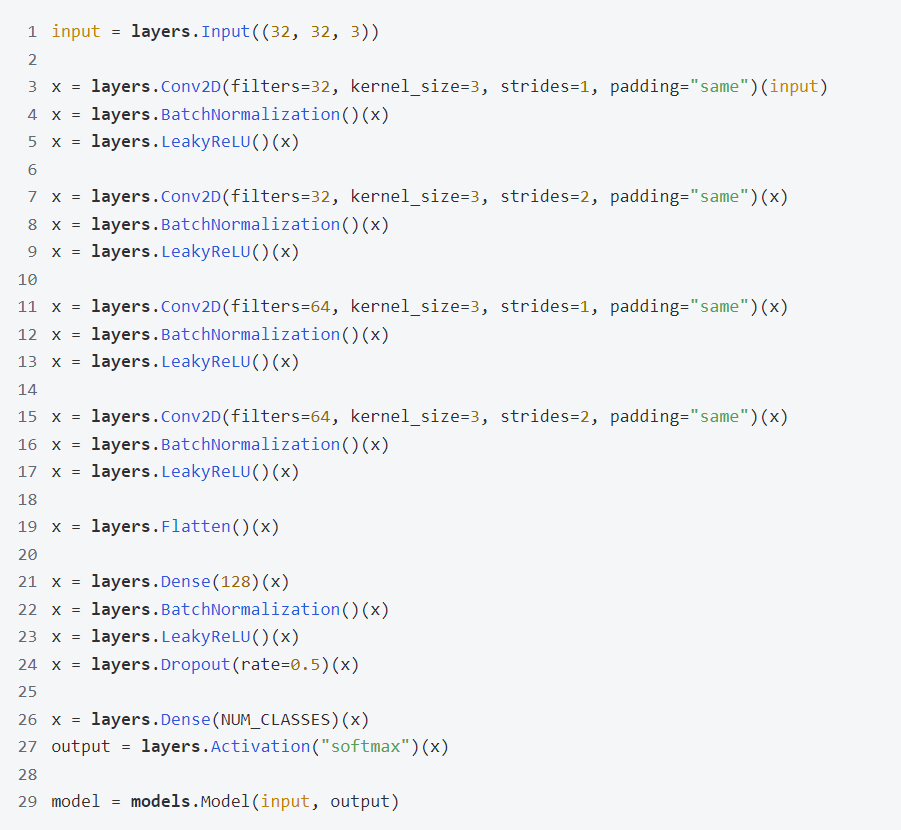
上記のコードが理解しやすいかどうかを確認してください。CNN には 4 つの畳み込み層があり、それぞれにバッチ正規化層と LeakyReLu 層が続きます。 Keras のすべてのものをレイヤーとして使用でき、アクティベーション関数もレイヤーの形式で実装できることに注意してください。次に、平坦化層を使用してデータを平坦化し、次に密層、バッチ正規化層、LeakyReLu 層、不活性化層、密層を使用し、最後にソフトマックスを使用して確率の形式で出力します。
この洗練された CNN モデルをご覧ください。
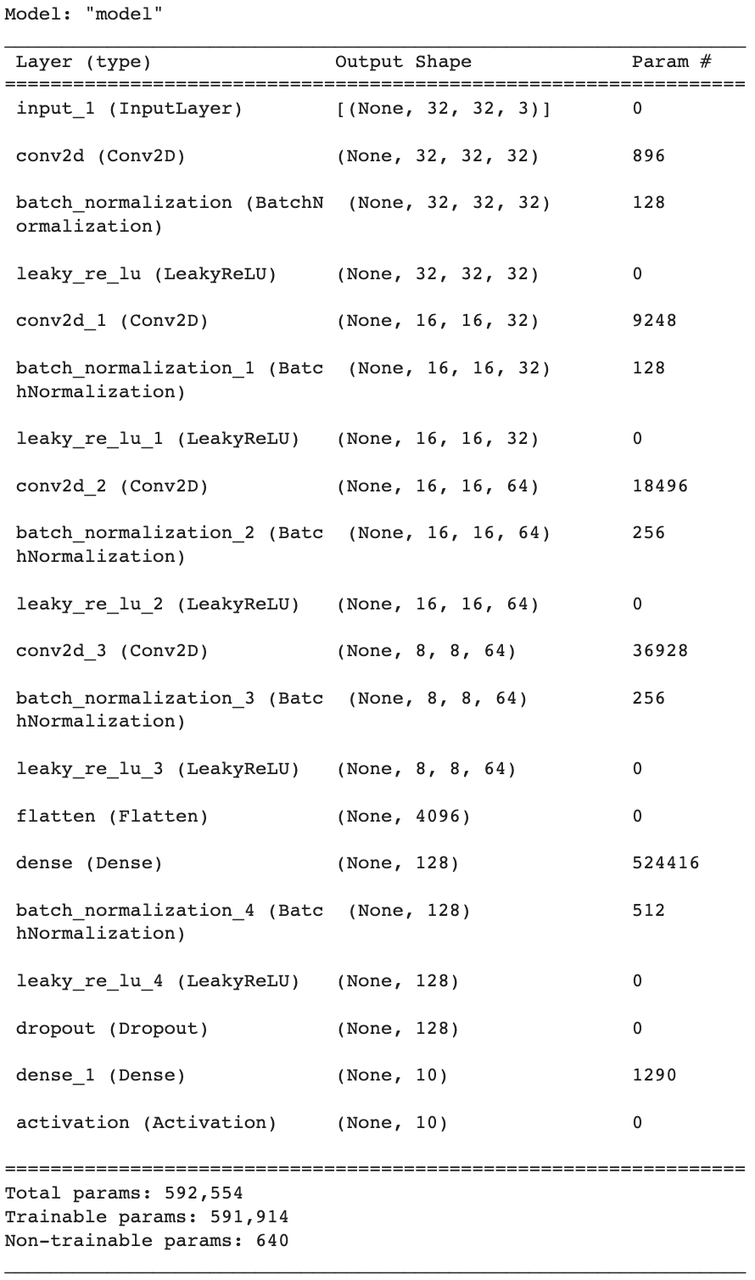
活性化層は変換であるためパラメータを含まないことがわかり、平坦化層と不活性化層はパラメータを含まないことも分かりやすく、畳み込み層と密層のパラメータ量については、アルゴリズムについては以前に説明しました。バッチ正規化の場合、スケーリング パラメータをチャネルごとに学習する必要があります。γおよび翻訳パラメータβ、移動平均と移動標準偏差が含まれるため、含まれるパラメータはチャネル数 * 4 と等しくなります。
副題
3.6 トレーニングの評価
すべての準備が整いました。必要なのはトレーニングだけです。今回は、トレーニング中にモデルが過学習しているかどうかを監視するパラメーター validation_data を追加しました。過学習は、学習誤差 (損失) が減少しているのに、検証誤差 (val_loss) が増加している場合に発生します。下の写真を見る限り、そのような問題はありません。
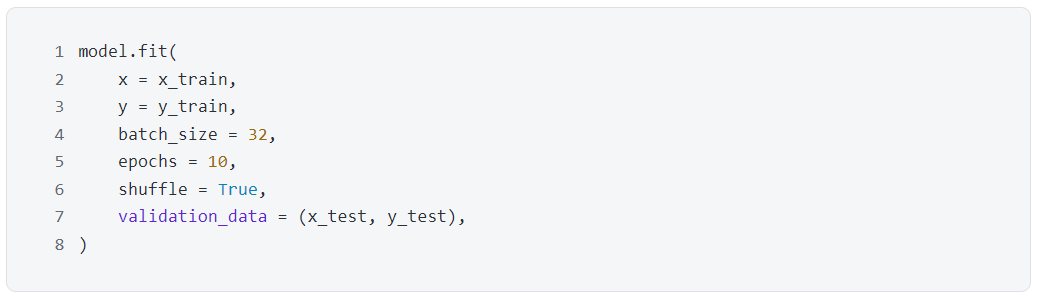
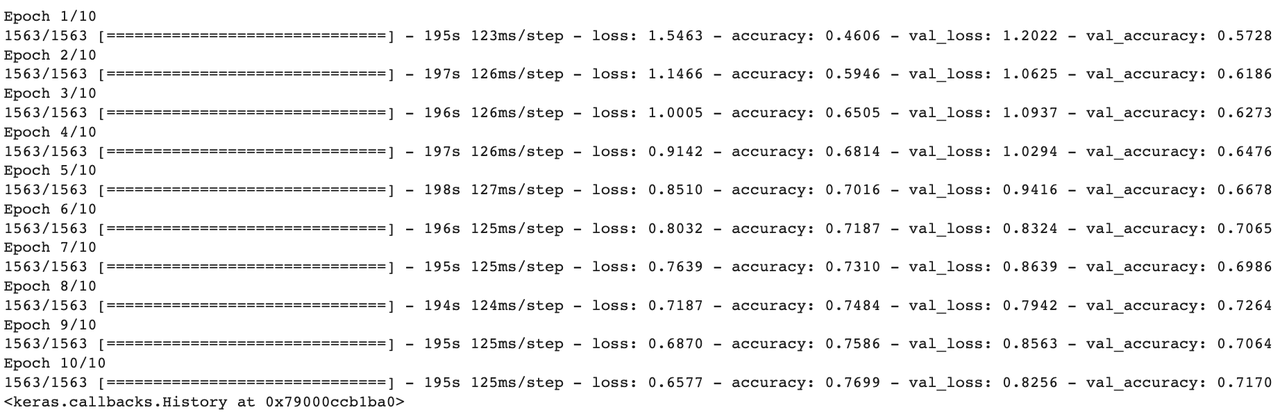
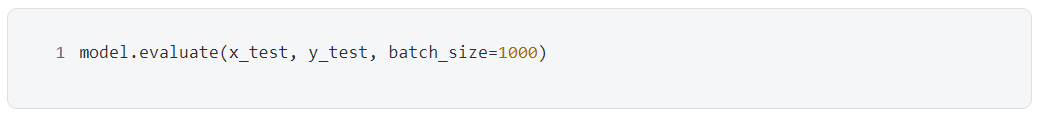

現在の畳み込みニューラル ネットワーク (CNN) と以前のフィードフォワード ニューラル ネットワーク (FNN) と比較して、トレーニング セットの既存のモデルの精度は 51.39% から 76.99% に向上し、トレーニング セットの精度も 51.39% から 76.99% に向上しました。 49.52% 最大 71.70% となり、モデルのパフォーマンスが大幅に向上しました。
驚くべきことに、CNN のパラメーター (592、554) は実際には FNN のパラメーター (646、260) よりもはるかに小さいですが、モデルのパフォーマンスは大幅に向上しており、この向上には畳み込み層を含むようにモデル アーキテクチャを変更するだけで十分です。バッチ 1 つのレイヤーを正規化し、そのレイヤーを非アクティブ化することで実現できます。 CNN は FNN よりもパラメーターが少ないですが、層の数ははるかに多く、これがディープ ニューラル ネットワークの利点です。ネットワークの中間層が最も関心のある高レベルの特徴を捕捉するためです。
要約する
要約する
この記事では、ディープ生成モデルの構築を開始するために必要なコアとなるディープラーニングの概念を紹介しました。 Keras を使用してフィードフォワード ニューラル ネットワーク (FNN) を構築し、モデルをトレーニングして CIFAR-10 データセット内の特定の画像のクラスを予測します。次に、畳み込み層、バッチ正規化層、非アクティブ化層を導入してこのアーキテクチャを改善し、畳み込みニューラル ネットワーク (CNN) を作成します。
ディープ ニューラル ネットワークの設計は完全に柔軟であり、可能な限りベスト プラクティスがありますが、さまざまなレイヤーやその表示順序を自由に試すことができます。Keras の使用は、レゴ ブロックを構築するのと同じくらいスムーズです。ニューラル ネットワークに必要なものは、自分の想像力によって制限されるだけです。
ChatGPT 4.0 のプラグイン ストアで SignalPlus を検索すると、リアルタイムの暗号化情報を取得できます。最新情報をすぐに受け取りたい場合は、Twitter アカウント @SignalPlus_Web 3 をフォローするか、WeChat グループ (小さなアシスタント WeChat: chillywzq を追加)、Telegram グループ、および Discord コミュニティに参加して、より多くの友人と通信して交流してください。
ChatGPT 4.0 のプラグイン ストアで SignalPlus を検索すると、リアルタイムの暗号化情報を取得できます。最新情報をすぐに受け取りたい場合は、Twitter アカウント @SignalPlus_Web 3 をフォローするか、WeChat グループ (小さなアシスタント WeChat: chillywzq を追加)、Telegram グループ、および Discord コミュニティに参加して、より多くの友人と通信して交流してください。
SignalPlus Official Website: https://www.signalplus.com





