


Foresight Ventures: 分散型コンピューティング電力ネットワークに関する合理的な見解


最初のレベルのタイトル
TL;DR
現在、AI + 暗号の組み合わせには、分散コンピューティング能力と ZKML の 2 つの主な方向性があり、ZKML については、前回の記事を参照してください。この記事では、分散型分散コンピューティング電力ネットワークを分析し、考察します。。
AI大型モデルの開発トレンドのもと、コンピューティング電源資源は今後10年の大きな戦場となり、将来の人類社会にとって最も重要なものでもある、商業的な競争にとどまるだけでなく、大国のゲームの戦略的リソースにもなります。将来的には、高性能コンピューティング インフラストラクチャとコンピューティング能力の予備への投資が飛躍的に増加するでしょう。
分散型分散コンピューティング電力ネットワークは、AI 大規模モデルのトレーニングに対する最大の需要を抱えていますが、同時に最大の課題と技術的なボトルネックにも直面しています。これには、複雑なデータ同期の必要性やネットワークの最適化の問題が含まれます。さらに、データのプライバシーとセキュリティも重要な制約です。一部の既存の技術は暫定的な解決策を提供できますが、計算と通信のオーバーヘッドが膨大であるため、大規模な分散トレーニング タスクにはまだ適用できません。
分散型分散コンピューティングパワーネットワークは、モデル推論に到達する可能性が高く、将来の増分スペースも十分に大きいと予測できます。しかし、通信遅延、データプライバシー、モデルのセキュリティなどの課題にも直面しています。モデルのトレーニングと比較して、推論は計算の複雑さとデータの相互作用が低く、分散環境により適しています。
最初のレベルのタイトル
1. 分散コンピューティング能力 - 大規模モデルのトレーニング
私たちはトレーニングにおける分散コンピューティング能力の適用について議論しており、一般に大規模な言語モデルのトレーニングに焦点を当てています。主な理由は、小さなモデルのトレーニングにはそれほど多くのコンピューティング能力を必要としないからです。分散データのプライバシーと束を行うには、プロジェクトの数 この問題は費用対効果が高くないため、直接かつ一元的に解決する方が良いでしょう。大規模な言語モデルには膨大な計算能力の需要があり、現在爆発の初期段階にあります。2012 年から 2018 年にかけて、AI の計算需要は 4 か月ごとに 2 倍になります。現在、計算能力の需要が集中しています。これは、今後 5 ~ 8 年間、依然として大きな需要の増加が見込まれると判断できます。
副題
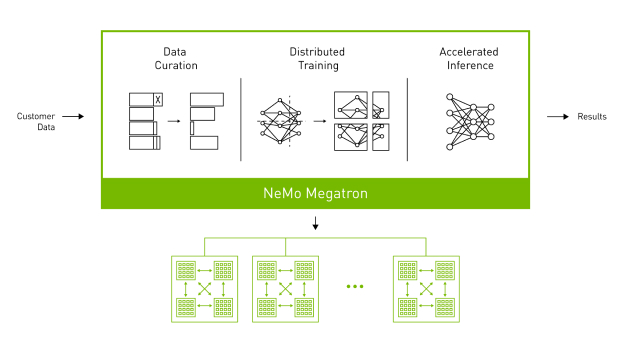
(NVIDIA NeMo Megatron Framework)
1. 全体的なトレーニングプロセス
たとえば、1,750 億個のパラメーターを使用して大規模なモデルをトレーニングする場合を考えてみましょう。モデルのサイズが大きいため、多くの GPU デバイスで並行してトレーニングする必要があります。 100 個の GPU を備えた集中コンピューター室があり、各デバイスに 32 GB のメモリがあるとします。
データの準備:まず、インターネットの情報、ニュース、書籍など、さまざまなデータを含む膨大なデータセットが必要になります。これらのデータは、テキストのクリーニング、トークン化、語彙の構築などを含め、トレーニングの前に前処理する必要があります。
データのセグメンテーション: 処理されたデータは、複数の GPU で並列処理するために複数のバッチに分割されます。選択したバッチ サイズが 512 であるとします。つまり、各バッチには 512 個のテキスト シーケンスが含まれます。次に、データセット全体をバッチに分割し、バッチのキューを形成します。
デバイス間のデータ転送: 各トレーニング ステップの開始時に、CPU はバッチ キューからバッチをフェッチし、このバッチのデータを PCIe バス経由で GPU に送信します。各テキスト シーケンスの平均長が 1024 トークンであると仮定すると、各バッチのデータ サイズは約 512 * 1024 * 4 B = 2 MB になります (各トークンが 4 バイトの単精度浮動小数点数で表されると仮定)。このデータ転送プロセスには通常、数ミリ秒しかかかりません。
並行トレーニング: 各 GPU デバイスはデータを受信した後、各パラメーターの勾配を計算するために前方パスと後方パスの計算の実行を開始します。モデルのサイズが大きいため、単一の GPU のメモリではすべてのパラメーターを保存できないため、モデル並列テクノロジを使用してモデル パラメーターを複数の GPU に分散します。
勾配集約とパラメータ更新: バックプロパゲーション計算が完了すると、各 GPU は一部のパラメーターの勾配を取得します。グローバル勾配を計算するには、これらの勾配をすべての GPU デバイスにわたって集約する必要があります。これにはネットワーク経由のデータ転送が必要で、25 Gbps ネットワークを想定すると、700 GB のデータを転送するのに約 224 秒かかります (各パラメーターに単精度浮動小数点を想定した場合、1,750 億個のパラメーターで約 700 GB)。次に、各 GPU は、グローバル勾配に従って、保存されているパラメーターを更新します。
同期する: パラメーターが更新された後、すべての GPU デバイスが同期されて、トレーニングの次のステップで一貫したモデル パラメーターが使用されるようにする必要があります。これには、ネットワーク経由のデータ転送も必要です。
トレーニングステップを繰り返す: すべてのバッチのトレーニングが完了するか、所定のトレーニング ラウンド数 (エポック) に達するまで、上記の手順を繰り返します。
副題
2. 通信オーバーヘッドのボトルネック:
通信のボトルネックは、現在の分散コンピューティング電力ネットワークの原因でもあることに注意する必要があります。これはできません大規模な言語モデルをトレーニングする理由。
各ノードは連携して動作するために頻繁に情報を交換する必要があるため、通信オーバーヘッドが発生します。大規模な言語モデルの場合、モデルのパラメータが多数あるため、この問題は特に深刻です。通信オーバーヘッドは次の側面に分けられます。
データ送信: ノードはトレーニング中にモデルのパラメーターと勾配情報を頻繁に交換する必要があります。これには、ネットワーク内で大量のデータを送信する必要があり、大量のネットワーク帯域幅が消費されます。ネットワークの状態が悪い場合や計算ノード間の距離が遠い場合には、データ伝送の遅延が大きくなり、通信のオーバーヘッドがさらに大きくなります。
同期の問題: トレーニング中、正しいトレーニングを保証するためにノードは連携する必要があります。これには、モデルパラメータの更新、グローバル勾配の計算など、ノード間の頻繁な同期操作が必要です。これらの同期操作では、ネットワーク内で大量のデータを送信する必要があり、すべてのノードが操作を完了するまで待機する必要があるため、多くの通信オーバーヘッドと待ち時間が発生します。
勾配の蓄積と更新: トレーニング プロセス中、各ノードは独自の勾配を計算し、蓄積と更新のために他のノードに送信する必要があります。これには、ネットワーク内で大量の勾配データを送信する必要があり、すべてのノードが勾配の計算と送信を完了するまで待機する必要があり、これが大量の通信オーバーヘッドの原因でもあります。
データの一貫性: 各ノードのモデル パラメーターが一貫していることを確認する必要があります。これには、ノード間でデータのチェックサムと同期操作を頻繁に行う必要があり、その結果、大量の通信オーバーヘッドが発生します。
パラメータや勾配の圧縮、効率的な並列戦略など、通信オーバーヘッドを削減する方法はいくつかありますが、これらの方法では追加の計算負荷が生じたり、モデルのトレーニング効果に悪影響を及ぼしたりする可能性があります。また、これらの方法は、特にネットワーク状態が悪い場合やコンピューティング ノード間の距離が遠い場合には、通信オーバーヘッドの問題を完全に解決することはできません。
例として:
分散型分散コンピューティング電力ネットワーク
GPT-3 モデルには 1,750 億個のパラメーターがあり、これらのパラメーターを単精度浮動小数点数 (パラメーターあたり 4 バイト) を使用して表す場合、これらのパラメーターを保存するには約 700 GB のメモリが必要です。分散トレーニングでは、これらのパラメーターをコンピューティング ノード間で頻繁に送信および更新する必要があります。
100 個のコンピューティング ノードがあると仮定すると、各ノードは各ステップですべてのパラメーターを更新する必要があり、各ステップで約 70 TB (700 GB * 100 ) のデータを転送する必要があります。ステップに 1 秒かかると仮定すると (非常に楽観的な仮定)、毎秒 70 TB のデータを転送する必要があります。この帯域幅の需要はすでにほとんどのネットワークの需要をはるかに上回っており、実現可能性の問題でもあります。
実際には、通信遅延やネットワークの混雑により、データ送信時間が 1 秒よりもはるかに長くなる場合があります。これは、コンピューティング ノードが実際の計算を実行する代わりに、データ送信の待機に多くの時間を費やす必要がある可能性があることを意味します。これによりトレーニングの効率が大幅に低下します。この効率の低下は待っていても解決できませんが、実行可能と実行不可能の差が生じ、トレーニング プロセス全体が実行不可能になります。
集中コンピュータ室
集中管理されたコンピューター ルーム環境であっても、大規模なモデルのトレーニングには依然として多大な通信の最適化が必要です。
集中型のコンピュータ ルーム環境では、高性能コンピューティング デバイスがクラスタとして使用され、高速ネットワークを介して接続され、コンピューティング タスクを共有します。ただし、このような高速ネットワーク環境で非常に多くのパラメーターを使用してモデルをトレーニングする場合でも、モデルのパラメーターと勾配をさまざまなコンピューティング デバイス間で頻繁に送信および更新する必要があるため、通信オーバーヘッドが依然としてボトルネックになります。 。
冒頭で述べたように、サーバーごとに 25 Gbps のネットワーク帯域幅を持つ 100 個の計算ノードがあると仮定します。すべてのサーバーがトレーニング ステップごとにすべてのパラメーターを更新する必要がある場合、トレーニング ステップごとに約 700 GB のデータを転送するのに約 224 秒かかります。集中管理されたコンピュータ ルームを利用することで、開発者はデータ センター内のネットワーク トポロジを最適化し、モデル並列処理などのテクノロジを使用して時間を大幅に短縮できます。
対照的に、同じトレーニングが分散環境で実行される場合、依然として 100 個のコンピューティング ノードが世界中に分散していると仮定すると、各ノードの平均ネットワーク帯域幅はわずか 1 Gbps になります。この場合、同じ 700 GB のデータを転送するのに約 5,600 秒かかります。これは、集中管理されたコンピューター室よりもはるかに長い時間です。また、ネットワークの遅延や混雑により、実際の所要時間はさらに長くなる場合があります。
ただし、分散型コンピューティング パワー ネットワークの状況と比較すると、集中型のコンピュータ ルーム環境では通信オーバーヘッドを最適化するのが比較的簡単です。集中型のコンピュータ ルーム環境では、コンピューティング デバイスは通常、同じ高速ネットワークに接続されており、ネットワークの帯域幅と遅延は比較的良好であるためです。分散型コンピューティング電力ネットワークでは、コンピューティング ノードが世界中に分散しており、ネットワークの状態が比較的劣悪なため、通信オーバーヘッドの問題がより深刻になります。
副題
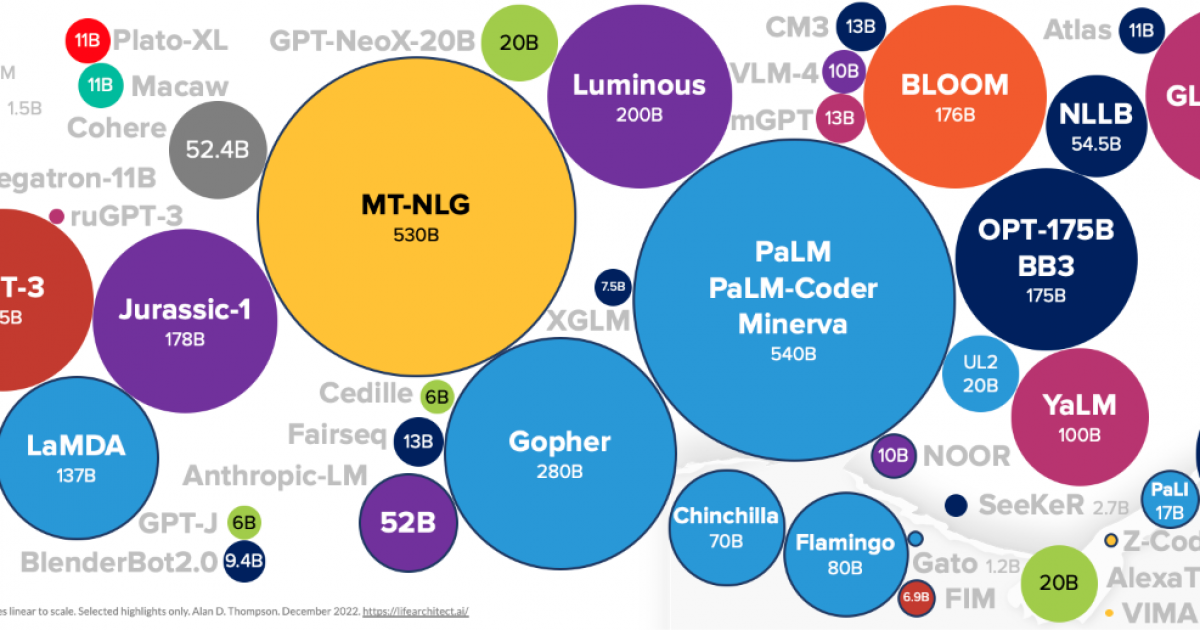
(Data used to train LLM models)
3. 分散コンピューティング電力ネットワークではこれらの最適化ができない理由
実行することは可能ですが、集中型のコンピューター室と比較すると、これらの最適化の効果は非常に限定されます。
1. ネットワークトポロジーの最適化: 集中コンピュータ室では、ネットワークのハードウェアとレイアウトを直接制御できるため、ニーズに応じてネットワーク トポロジを設計および最適化できます。ただし、分散環境では、コンピューティング ノードが地理的に異なる場所 (中国と米国に 1 つずつなど) に分散されており、それらの間のネットワーク接続を直接制御する方法はありません。ソフトウェアを使用してデータ伝送パスを最適化することはできますが、ハードウェア ネットワークを直接最適化するほど効果的ではありません。同時に、地理的な場所の違いにより、ネットワークの遅延と帯域幅も大きく異なり、ネットワーク トポロジの最適化の効果がさらに制限されます。
2. モデルの並列性副題
4. データセキュリティとプライバシーの課題
データの処理と送信を伴うほとんどすべてのリンクは、データのセキュリティとプライバシーに影響を与える可能性があります。
1. データ配信: トレーニング データは、計算に参加する各ノードに配布する必要があります。このリンク内のデータは、分散ノード上で悪意を持って使用または漏洩される可能性があります。
2. モデルトレーニング: トレーニング プロセス中、各ノードは割り当てられたデータを計算に使用し、モデル パラメーターの更新または勾配を出力します。この際、ノードの計算処理が盗まれたり、結果が不正に解析されたりすると、データが漏洩する可能性もあります。
3. パラメータと勾配の集計: グローバル モデルを更新するには、個々のノードの出力を集約する必要がありますが、集約中の通信によってトレーニング データに関する情報が漏洩する可能性もあります。
データプライバシーの懸念に対する解決策は何ですか?
安全なマルチパーティ コンピューティング: SMC は、いくつかの特定の小規模コンピューティング タスクに適用されて成功しています。ただし、大規模な分散トレーニング タスクでは、計算と通信のオーバーヘッドが大きいため、まだ広く使用されていません。
差分プライバシー: Chrome のユーザー統計など、特定のデータ収集および分析タスクに適用されます。ただし、大規模な深層学習タスクでは、DP はモデルの精度に影響を与えます。同時に、適切なノイズ生成・付加機構を設計することも課題です。
Federated Learning: Android キーボードの語彙予測など、一部のエッジ デバイス モデルのトレーニング タスクに適用されます。しかし、大規模な分散トレーニング タスクでは、FL は高い通信オーバーヘッドや複雑な調整などの問題に直面します。
準同型暗号化: 計算量が少なく、一部のタスクに適用されることに成功しています。ただし、大規模な分散トレーニング タスクでは、計算オーバーヘッドが高いため、まだ広く使用されていません。
要約する
上記の各方法には適用可能なシナリオと制限があり、分散コンピューティング パワー ネットワークの大規模モデルのトレーニングにおけるデータ プライバシーの問題を完全に解決できる方法はありません。
大きな期待を寄せるZKは、大規模モデルトレーニングにおけるデータプライバシー問題を解決できるだろうか?
理論的には、ZKP を使用すると分散コンピューティングにおけるデータのプライバシーを確保でき、ノードは規制に従って計算を実行したことを証明できますが、実際の入出力データを開示する必要はありません。
しかし実際には、大規模なモデルをトレーニングする大規模な分散コンピューティング パワー ネットワークに ZKP を使用するシナリオでは、次のボトルネックに直面しています。
計算および通信のオーバーヘッドの増加: ゼロ知識証明の構築と検証には、膨大な計算リソースが必要です。さらに、ZKP は証明自体を送信する必要があるため、通信オーバーヘッドが高くなります。これらのオーバーヘッドは、大規模なモデルのトレーニングの場合に特に重大になる可能性があります。たとえば、各ミニバッチの計算に証明の生成が必要な場合、トレーニングの全体的な時間とコストが大幅に増加する可能性があります。
ZKプロトコルの複雑さ: 大規模なモデルのトレーニングに適した ZKP プロトコルの設計と実装は、非常に複雑になる場合があります。このプロトコルは、大規模なデータと複雑な計算を処理できる必要があり、また、起こり得る異常エラーを処理できる必要があります。
ハードウェアとソフトウェアの互換性: ZKP を使用するには、特定のハードウェアおよびソフトウェアのサポートが必要ですが、すべての分散コンピューティング デバイスで利用できるわけではありません。
要約する
最初のレベルのタイトル
2. 分散コンピューティング能力 - モデル推論
分散コンピューティング能力のもう 1 つの比較的大規模なシナリオはモデル推論です。大規模モデルの開発パスに関する私たちの判断によると、モデル トレーニングの需要は大規模モデルが最高点を超えて成熟するにつれて徐々に減速します。これに応じて推論要件が指数関数的に増加します。大規模モデルと AIGC の成熟とともに。
副題

(Power LLM inference with NVIDIA Triton)
1. チャレンジ
通信遅延:
分散環境では、ノード間の通信が不可欠です。分散型分散コンピューティング電力ネットワークでは、ノードが世界中に分散している可能性があるため、特にリアルタイム応答が必要な推論タスクの場合、ネットワーク遅延が問題になる可能性があります。
モデルのデプロイと更新:
モデルは各ノードにデプロイする必要があります。モデルが更新される場合、各ノードはそのモデルを更新する必要があり、これにより多くのネットワーク帯域幅と時間が消費されます。
データのプライバシー:
通常、推論タスクには入力データとモデルのみが必要で、大量の中間データやパラメーターを返す必要はありませんが、入力データにはユーザーの個人情報などの機密情報が含まれる場合があります。
モデルのセキュリティ:
分散型ネットワークでは、信頼できないノードにモデルを展開する必要があるため、モデルの漏洩につながり、モデルの所有権や悪用の問題が発生します。これにより、セキュリティとプライバシーの問題が生じる可能性があります。モデルが機密データの処理に使用されている場合、ノードはモデルの動作を分析することで機密情報を推測する可能性があります。
品質管理:
副題
2. 実現可能性
計算の複雑さ:
トレーニングフェーズでは、モデルを繰り返し反復する必要があり、トレーニングプロセス中に、活性化関数の計算、損失関数の計算、勾配と重みの更新。したがって、モデルトレーニングの計算の複雑さは高くなります。
推論フェーズでは、予測を計算するために必要な前方パスは 1 つだけです。たとえば、GPT-3 では、入力テキストをベクトルに変換し、モデルの各層 (通常は Transformer 層) に転送し、最後に出力確率分布を取得して次の単語を生成する必要があります。この分布によると。 GAN では、モデルは入力ノイズ ベクトルから画像を生成する必要があります。これらの操作にはモデルの順伝播のみが含まれ、勾配の計算やパラメーターの更新は必要なく、計算の複雑さは低くなります。
データの対話性:
推論フェーズでは、モデルは通常、トレーニング中の大量のデータ バッチではなく、単一の入力を処理します。各推論の結果は、他の入力や出力には依存せず、現在の入力にのみ依存するため、大量のデータのやり取りは必要なく、通信のプレッシャーも少なくなります。
生成画像モデルを例に挙げると、GAN を使用して画像を生成すると仮定すると、ノイズ ベクトルをモデルに入力するだけで、モデルは対応する画像を生成します。このプロセスでは、各入力は 1 つの出力のみを生成し、出力間に依存関係がないため、データのやり取りは必要ありません。
GPT-3 を例にとると、次の単語の各生成には現在のテキスト入力とモデルの状態のみが必要で、他の入力や出力と対話する必要がないため、データの対話性の要件も弱くなります。
要約する
最初のレベルのタイトル
3. プロジェクト
画像の説明
1.Together
(RedPajama from Together)
Together は、大規模モデルのオープンソースに焦点を当て、分散型 AI コンピューティング ソリューションに注力する企業であり、誰でも、どこからでも AI にアクセスして使用できることを望んでいます。 Together は、Lux Capital が主導する 2,000 万ドルのシードラウンドを完了したばかりです。
Together は Chris、Percy、Ce によって共同設立されました。当初の目的は、大規模なモデルのトレーニングには多数のハイエンド GPU クラスターと高額な支出が必要であり、これらのリソースとモデル トレーニング機能も少数の大企業に集中していました。 。
私の観点から見ると、分散コンピューティング能力に関するより合理的な起業計画は次のとおりです。
ステップ 1. オープンソース モデル
分散型分散コンピューティング電力ネットワークでモデル推論を実装するには、前提条件として、ノードが低コストでモデルを取得できなければなりません。つまり、分散型コンピューティング電力ネットワークを使用するモデルはオープンソースである必要があります (モデルが対応するライセンスが必要です。以下で使用すると、実装の複雑さとコストが増加します)。たとえば、chatgpt は非オープン ソース モデルなので、分散型コンピューティング パワー ネットワークでの実行には適していません。
したがって、分散型コンピューティングパワーネットワークを提供する企業には、強力な大規模モデルの開発および保守能力が必要であるという見えない壁があると推測できます。自社開発およびオープンソース化された強力な基本モデルにより、サードパーティ モデルのオープンソースへの依存をある程度取り除くことができ、分散型コンピューティング パワー ネットワークの最も基本的な問題を解決できます。同時に、コンピューティングパワーネットワークが大規模モデルのトレーニングと推論を効果的に実行できることを証明するのにさらに役立ちます。
そしてTogetterも同じことをしました。最近リリースされた LLaMA ベースの RedPajama は、Togetter、Ontocord.ai、ETH DS 3 Lab、Stanford CRFM、Hazy Research などのチームによって共同で立ち上げられ、完全にオープンソースの大規模言語モデルのシリーズを開発することを目標としています。
ステップ 2. モデル推論に分散コンピューティング能力を実装する
上の 2 つのセクションで述べたように、モデルのトレーニングと比較して、モデル推論は計算の複雑さとデータの相互作用が低く、分散分散環境により適しています。
オープンソース モデルに基づいて、Togetter の研究開発チームは、LoRA を使用して低コストの微調整を実現し、モデルを CPU 上で実行できるようにするなど、RedPajama-INCITE-3 B モデルに一連の更新を行いました (特にM 2 Pro プロセッサーを使用する MacBook (Pro) を使用すると、モデルをよりスムーズに実行できます。同時に、このモデルの規模は小さいものの、その能力は同規模の他のモデルを上回っており、法的、社会的などの場面で実用化されています。
画像の説明
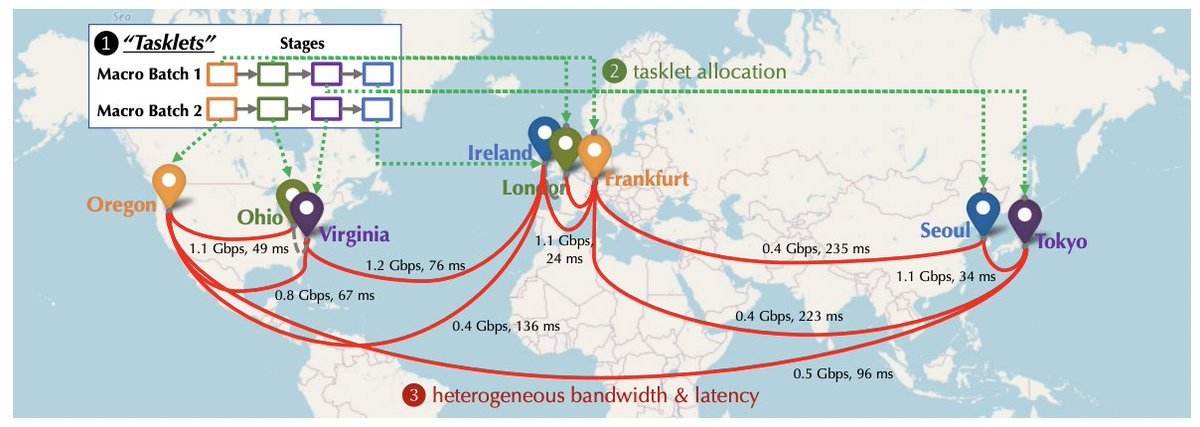
(分散型トレーニングのための通信ボトルネックの克服のコンピューティングパワーネットワークの概略図)
中長期的には、大きな課題と技術的なボトルネックに直面していますが、AI の大規模モデルのトレーニングに必要なコンピューティング能力を引き受けることが最も魅力的であるはずです。設立当初に、分散型トレーニングにおけるコミュニケーションのボトルネックを克服する方法を一緒に検討し始めました。彼らはまた、NeurIPS 2022 に関する関連論文も発表しました。Overcoming Communication Bottlenecks for Decentralized Training。主に次の方向性を要約できます。
スケジュールの最適化
分散環境でトレーニングする場合、ノード間の接続には遅延と帯域幅が異なるため、通信量の多いタスクをより高速な接続を備えたデバイスに割り当てることが重要です。特定のスケジューリング戦略のコストを記述するモデルを共同で構築し、スケジューリング戦略をより適切に最適化して、通信コストを最小限に抑え、トレーニング スループットを最大化します。 Together チームはまた、ネットワークが 100 倍遅い場合でも、エンドツーエンドのトレーニング スループットは 1.7 ~ 2.3 倍遅いだけであることも発見しました。したがって、スケジューリングの最適化を通じて、分散ネットワークと集中クラスターの間のギャップを埋めることは興味深いことです。
通信圧縮の最適化
一緒に、前方アクティベーションと後方勾配の通信圧縮を提案し、確率的勾配降下収束の厳密な保証を提供する AQ-SGD アルゴリズムを導入します。 AQ-SGD は、低速ネットワーク (例: 500 Mbps) 上で大規模な基本モデルを微調整することができ、圧縮なしの集中型ネットワーク (例: 10 Gbps) ではエンドツーエンドのトレーニング パフォーマンスが 31% 低下するだけです。さらに、AQ-SGD を QuantizedAdam などの最先端の勾配圧縮技術と組み合わせて、エンドツーエンドの 10% の高速化を達成できます。
プロジェクトの概要
チーム構成は非常に包括的で、メンバーは非常に優れた学歴を持ち、大規模モデルの開発、クラウド コンピューティングからハードウェアの最適化まで、業界の専門家によってサポートされています。そして Together は、オープンソースの大規模モデルの開発から、モデル推論を使用した分散コンピューティング パワー ネットワーク内のアイドル状態のコンピューティング パワー (Mac など) のテスト、そして大規模なレイアウトでの分散コンピューティング パワーのテストに至るまで、パス プランニングにおける長期的かつ忍耐強い姿勢を示しました。モデルトレーニング。 — そういう蓄積と薄毛感がありますね:)
画像の説明
2.Gensyn.ai
(Gensyn.ai)
Together の技術的なパスから、モデルのトレーニングと推論における分散型コンピューティング パワー ネットワークの実装プロセス、および対応する研究開発の優先順位を大まかに理解できます。
無視できないもう 1 つの重要な点は、コンピューティング パワー ネットワークのインセンティブ層/コンセンサス アルゴリズムの設計です。たとえば、優れたネットワークには次のものが必要です。
1. 特典が十分に魅力的であることを確認します。
2. 各マイナーが不正行為防止や、より多くの仕事に対するより多くの賃金などの利益を確実に得られるようにする。
3. タスクが直接的かつ合理的にスケジュールされ、異なるノードに割り当てられていることを確認します。また、多数のアイドル ノードや一部のノードが過密状態にならないようにします。
4. インセンティブアルゴリズムはシンプルかつ効率的であり、過度のシステム負荷や遅延を引き起こしません。
……
Gensyn.ai がどのように行うかをご覧ください。
ノードになる
確認する
確認する
ソルバーは、パラメーターの更新中に複数のチェックポイントを生成し (作業の透明性と追跡可能性を確保するため)、タスクに関する暗号推論の証拠 (作業の進捗状況の証拠) を定期的に生成します。
ソルバーが作業を完了し、計算結果の一部を生成すると、プロトコルは検証者を選択し、検証者も(検証者が誠実に検証を実行することを保証するために)一定の金額を約束し、計算のどの部分を決定するかを決定します。結果は上記の証明に従って検証する必要があります。
ソルバーとベリファイアーが異なる場合
マークル ツリー ベースのデータ構造を通じて、計算結果が分岐する正確な位置を特定します。検証作業全体がチェーン上で行われ、詐欺師は約束した金額から差し引かれます。
プロジェクトの概要
インセンティブと検証アルゴリズムの設計により、Gensyn.ai は検証プロセス中にコンピューティング タスク全体のすべての結果を再生する必要がなく、提供された証明に従って結果の一部をコピーして検証するだけで済み、大幅に改善されます。検証の効率化。同時に、ノードは計算結果の一部のみを保存すればよいため、ストレージスペースとコンピューティングリソースの消費も削減されます。さらに、不正行為を行う可能性のあるノードは、検証のためにどの部分が選択されるかを予測できないため、不正行為のリスクも軽減されます。
この差異を検証し不正行為者を発見するこの方法は、計算結果全体を比較することなく(マークル ツリーのルート ノードから開始してステップごとに下にたどる)、計算プロセス内のエラーを迅速に見つけることもでき、大規模なコンピューティング タスクに非常に効果的です。
つまり、Gensyn.ai のインセンティブ/検証レイヤーの設計目標は、シンプルかつ効率的です。ただし、現時点では理論レベルに限定されており、具体的な実装では次のような課題に直面する可能性があります。
経済モデルでは、参加者に高すぎるしきい値を設定せずに不正行為を効果的に防止できるように、適切なパラメーターを設定する方法。
技術的な実装の観点からは、効果的な定期的な暗号化推論の証明をどのように定式化するかは、高度な暗号化の知識を必要とする複雑な問題でもあります。
最初のレベルのタイトル
4. 将来について考える
誰が分散型コンピューティング電力ネットワークを必要とするかという問題は検証されていません。膨大なコンピューティング能力リソースを必要とする大規模モデルのトレーニングにアイドル状態のコンピューティング能力を適用することは、明らかに最も理にかなっており、最も想像力豊かな領域です。しかし実際には、コミュニケーションやプライバシーなどのボトルネックにより、次のことを再考する必要があります。
大規模モデルの分散トレーニングに本当に希望はあるのでしょうか?
このコンセンサスである「最も合理的な着地シナリオ」から飛び出す場合、分散型コンピューティングパワーを小型AIモデルのトレーニングに適用するかどうかも大きなシナリオとなる。技術的な観点から見ると、モデルのサイズとアーキテクチャによる現在の制限要因は解決されましたが、同時に市場の観点から見ると、大規模なモデルのトレーニングは今後膨大になるだろうと常々感じていました。現在から未来に至るまで、小型 AI モデルの市場はまだ魅力的ではありませんか?
免責事項: Foresight Ventures のすべての記事は、投資アドバイスを目的としたものではありません。投資にはリスクが伴います。ご自身のリスク許容度を評価し、慎重に投資決定を行ってください。
Reference
https://www.together.xyz/blog/neurips-2022-overcoming-communication-bottlenecks-for-decentralized-training-12
https://www.together.xyz/blog/redpajama
https://docs.gensyn.ai/litepaper/
https://www.nvidia.com/en-in/deep-learning-ai/solutions/large-language-models/
https://indiaai.gov.in/article/training-data-used-to-train-llm-models
フォーサイト・ベンチャーズについて
フォーサイト・ベンチャーズは、今後数十年の仮想通貨の革新に賭け、VCファンド、セカンダリーアクティブ運用ファンド、マルチストラテジーFOF、特定目的Sファンド「フォーサイトセカンダリーファンドl」の複数のファンドを運営しており、総資産運用規模は4億米ドル以上。 Foresight Ventures は、「ユニーク、独立、積極的、長期的」というコンセプトを堅持し、強力なエコロジーの力を通じてプロジェクトを広範囲にサポートします。そのチームは、Sequoia China、CICC、Google、Bitmain などのトップ金融およびテクノロジー企業の上級人材で構成されています。
Website: https://www.foresightventures.com
免責事項: Foresight Ventures のすべての記事は、投資アドバイスを目的としたものではありません。投資にはリスクが伴います。ご自身のリスク許容度を評価し、慎重に投資決定を行ってください。





