






Coinbase อัปเกรดระบบป้องกันการฉ้อโกงด้านการชำระเงินด้วยโมเดลพารามิเตอร์ 9 พันล้าน: ธุรกรรมฉ้อโกงออนไลน์ลดลง 30%


- ประเด็นหลัก: ทีมวิศวกรรมของ Coinbase เปิดเผยแนวปฏิบัติ Agent ป้องกันการฉ้อโกงของ Onramp: ผ่านสถาปัตยกรรมการแบ่งงาน "การคัดกรองเบื้องต้นด้วยโมเดลแบบดั้งเดิม + โมเดลขนาดใหญ่อ่านลำดับธุรกรรม" ผสานกับการฝึกโมเดลพารามิเตอร์ขนาดเล็กด้วยข้อมูลของตนเอง ส่งผลให้ปริมาณธุรกรรมฉ้อโกงลดลง 30% และมูลค่าความเสียหายจากการฉ้อโกงลดลง 22%
- องค์ประกอบสำคัญ:
- เดือนตุลาคม 2026 Coinbase เผยแพร่บทความสามชิ้นต่อเนื่อง แนะนำการสร้าง Agent ป้องกันการฉ้อโกง การเลือกโมเดล และกระบวนการฝึกโมเดล
- ในด้านสถาปัตยกรรม โมเดลแมชชีนเลิร์นนิงและระบบกฎจะประมวลผลธุรกรรมเดี่ยวก่อน ส่วน Agent จะอ่านลำดับธุรกรรมล่าสุดและส่งออกการจำแนกความเสี่ยงเฉพาะเมื่อต้องการบริบท
- บริษัทใช้ข้อมูลประวัติของตนเองสร้างชุดทดสอบเฉพาะ domain พบว่าโมเดลปิดบางรุ่นที่ใหม่กว่าแม้ความแม่นยำจะเพิ่มขึ้น แต่召回率, F1 และ召回率ถ่วงน้ำหนักด้วยมูลค่ากลับลดลง
- ทำการฝึกหลังการเรียนแบบเสริมกำลัง (RLVR) กับโมเดลโอเพนซอร์ส Qwen3.5-9B ขนาด 9 พันล้านพารามิเตอร์ บน基準ภายในของบริษัทมีความแม่นยำสูงกว่า Opus 4.5 อยู่ 7.5 จุดเปอร์เซ็นต์ 召回率สูงกว่า 12 จุดเปอร์เซ็นต์ F1 สูงกว่า 9.6 จุดเปอร์เซ็นต์ และ召回率ถ่วงน้ำหนักด้วยมูลค่าสูงกว่า 35.4 จุดเปอร์เซ็นต์
- ความหน่วงแบบ end-to-end ในการอนุมานออนไลน์ลดลง 55% ต้นทุนการฝึกต่ำกว่า 100 ดอลลาร์ โมเดลส่งออกเฉพาะข้อสรุปความเสี่ยง ส่วนการดำเนินการจัดการ将由ชั้นกลยุทธ์และการตรวจสอบซ้ำโดยมนุษย์ดำเนินการแบบ闭环
图 1|Coinbase 工程团队公开了反欺诈 Agent 系列研究
ธุรกรรมการซื้อสินทรัพย์คริปโตด้วยบัตรเครดิตหนึ่งครั้ง ผิวเผินดูมีเพียงจำนวนเงิน อุปกรณ์ และผลการชำระเงิน แต่ผู้ฉ้อโกงมักแบ่งการโจมตีออกเป็นหลายครั้ง: เริ่มจากการทดสอบบัตรด้วยธุรกรรมจำนวนน้อยก่อน จากนั้นเปลี่ยนอุปกรณ์ ที่อยู่ หรือเครื่องมือชำระเงิน แล้วจึงทำการซื้อในจำนวนที่มากขึ้นในที่สุด หากดูเพียงธุรกรรมเดียว สัญญาณความเสี่ยงอาจอ่อนมาก แต่เมื่อนำการกระทำหลายครั้งล่าสุดมามองรวมกัน รูปแบบจึงปรากฏขึ้น
ระหว่างวันที่ 6 ถึง 8 ตุลาคม 2026 Coinbase ได้เผยแพร่บทความด้านวิศวกรรมสามชิ้นติดต่อกัน เพื่ออธิบายกระบวนการสร้าง Agent ป้องกันการฉ้อโกงสำหรับธุรกิจ Onramp ของตน Coinbase เริ่มจากการนำโมเดลขนาดใหญ่มาต่อท้ายโมเดลแมชชีนเลิร์นนิงและระบบกฎที่มีอยู่เดิม เพื่อให้อ่านลำดับธุรกรรม จากนั้นสร้างชุดทดสอบเฉพาะทางเพื่อเปรียบเทียบโมเดลปิดแบบต่างๆ สุดท้ายใช้ข้อมูลการฉ้อโกงของตนเองในการฝึกปรับโมเดลน้ำหนักเปิดที่มีพารามิเตอร์ 9 พันล้านตัว การทดลองออนไลน์ที่บริษัทเปิดเผยแสดงว่า เมื่อเพิ่ม Agent เข้าไป จำนวนธุรกรรมการฉ้อโกงลดลง 30% และมูลค่าการฉ้อโกงลดลง 22% โมเดลที่ผ่านการฝึกปรับได้คะแนน F1 สูงขึ้นบนเกณฑ์มาตรฐานภายใน และมีความหน่วงแบบต้นทางถึงปลายทางต่ำลงด้วย
ตัวเลขเหล่านี้อ้างอิงจากการทดลองของ Coinbase เอง ปัจจุบันภายนอกไม่สามารถทำซ้ำชุดข้อมูลทั้งหมดได้ อย่างไรก็ตาม แนวปฏิบัติชุดนี้ได้มอบตัวอย่าง AI สำหรับองค์กรที่ konkret มาก: ในงานแคบอย่างการควบคุมความเสี่ยงด้านการชำระเงิน ความใหม่หรือขนาดของโมเดลอาจไม่ใช่สิ่งสำคัญอันดับแรก สิ่งที่ส่งผลต่อประสิทธิภาพจริงคือ องค์กรมีข้อมูลผลลัพธ์ที่เชื่อถือได้หรือไม่ สามารถสร้างชุดทดสอบที่ใกล้เคียงธุรกิจจริงได้หรือไม่ และผลลัพธ์ของโมเดลเข้าสู่ระบบตัดสินใจเดิมอย่างไร
一、传统模型先筛一遍,Agent 负责阅读交易过程
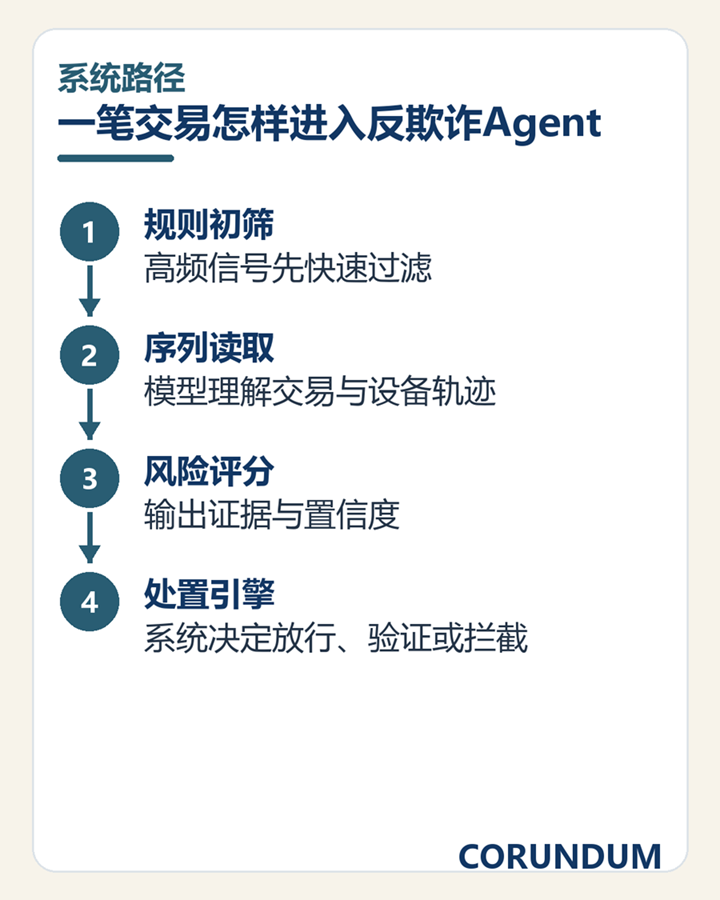
图 2|一笔交易进入反欺诈 Agent 的处理路径
Coinbase Onramp ให้ผู้ใช้ซื้อสินทรัพย์คริปโตภายในแอปของพันธมิตร โดยบางสถานการณ์อนุญาตให้ผู้เยี่ยมชมชำระเงินได้ ผู้เยี่ยมชมไม่มีบันทึกบัญชีระยะยาว ข้อมูลที่แพลตฟอร์มใช้ได้จึงมาจากการชำระเงินปัจจุบันและพฤติกรรมธุรกรรมล่าสุดเป็นหลัก โมเดลแมชชีนเลิร์นนิงเดิมเก่งในการประมวลผลลักษณะของธุรกรรมเดี่ยวอย่างรวดเร็ว ส่วนระบบกฎจะสกัดกั้นเงื่อนไขผิดปกติที่ชัดเจน เช่น การล้มเหลวซ้ำ อุปกรณ์เปลี่ยนแปลงกะทันหัน หรือข้อมูลการชำระเงินไม่สอดคล้องกัน
ความยากปรากฏในชุดการกระทำต่อเนื่อง ในการซื้อครั้งหนึ่ง จำนวนเงินและอุปกรณ์ล้วนดูธรรมดา แต่เมื่อวางกลับเข้าไปในลำดับธุรกรรมไม่กี่นาทีล่าสุด มันอาจตามหลังการทดสอบจำนวนน้อยหลายครั้ง การเปลี่ยนบัตรธนาคาร และการเปลี่ยนแปลงที่อยู่ Coinbase จึงจัดเรียงธุรกรรมล่าสุดตามเวลาให้เป็นบริบท แล้วส่งให้โมเดลขนาดใหญ่ประเมินความเสี่ยง โมเดลจะส่งผลลัพธ์การจัดประเภทความเสี่ยงแบบสั้น จากนั้นโปรแกรม后续จะตัดสินใจปล่อยผ่าน ปฏิเสธ หรือเข้าสู่การตรวจสอบโดยมนุษย์ตามการจัดประเภทนี้
โครงสร้างนี้รักษาความเร็วของระบบควบคุมความเสี่ยงแบบดั้งเดิมไว้ ธุรกรรมส่วนใหญ่จะถูกประมวลผลโดยโมเดลแมชชีนเลิร์นนิงและกฎก่อน Agent จะเข้ามามีส่วนร่วมเฉพาะเมื่อต้องการบริบทเพิ่มเติม ภารกิจของมันยังถูกจำกัดอย่างเข้มงวด: อ่านข้อมูลธุรกรรมที่จัดเรียงไว้แล้ว ระบุความสัมพันธ์ในลำดับ และส่งคืนข้อสรุปในรูปแบบที่กำหนด การดำเนินการสุดท้ายยังคงถูกดำเนินการโดยชั้นนโยบายในระบบ
การแบ่งงานนี้ อธิบายว่าทำไม Coinbase จึงเรียกมันว่า Agent ความเสี่ยง มันไม่ได้สืบสวนลูกค้าด้วยตนเอง และไม่ได้เรียกใช้ระบบภายในทั้งหมดอย่างอิสระ แพลตฟอร์มได้กำหนดขอบเขตข้อมูล รูปแบบคำถาม และคำตอบที่สามารถส่งคืนได้ให้มัน ดังนั้นโมเดลจึงสามารถมุ่งความสนใจไปที่คำถามแคบๆ อย่าง “ธุรกรรมเหล่านี้เมื่อเชื่อมโยงกันแล้วผิดปกติหรือไม่”
二、模型升级可能悄悄改变风险尺度
หลังจากระยะแรกเปิดใช้งาน ปัญหาถัดไปที่ Coinbase พบคือการเลือกโมเดล เกณฑ์มาตรฐานทั่วไปมักบอกองค์กรว่าโมเดลใดมีความสามารถโดยรวมแข็งแกร่งกว่า แต่ตัวชี้วัดที่การควบคุมความเสี่ยงด้านการชำระเงินสนใจนั้น konkret กว่า: สามารถสกัดกั้นธุรกรรมการฉ้อโกงได้มากน้อยเพียงใด ผู้ใช้ปกติจะได้รับผลกระทบผิดพลาดมากน้อยเพียงใด การฉ้อโกงมูลค่าสูงถูกระบุได้หรือไม่ และการตัดสินใจแต่ละครั้งใช้เวลานานเท่าใด
Coinbase ใช้ข้อมูลประวัติของตนเองสร้างชุดทดสอบ เพื่อเปรียบเทียบโมเดล Opus, Sonnet และ GPT หลายเวอร์ชัน บริษัทเปิดเผยว่า โมเดลใหม่บางเวอร์ชันแม้ความแม่นยำ (precision) เพิ่มขึ้น แต่召回率, คะแนน F1 และ召回率แบบถ่วงน้ำหนักตามมูลค่ากลับลดลง ความแม่นยำหมายถึงสัดส่วนของธุรกรรมที่โมเดลตัดสินว่าเป็น Fraud ที่เป็น Fraud จริง召回率หมายถึงสัดส่วนของธุรกรรม Fraud ทั้งหมดที่ถูกค้นพบ หากระบบควบคุมความเสี่ยงมุ่งแค่ความแม่นยำสูง อาจลดการกระทบผู้ใช้ปกติ แต่ก็พลาดความสูญเสียจริงมากขึ้น
คะแนน F1 ใช้เพื่อสังเกตความแม่นยำและ召回率ร่วมกัน พูดง่ายๆ คือช่วยให้ทีมตัดสินว่าโมเดลเก่งเพียงตัวชี้วัดเดียวหรือไม่ Coinbase ยังเพิ่ม召回率แบบถ่วงน้ำหนักตามมูลค่า Fraud เพราะการพลาด Fraud มูลค่าสูงหนึ่งครั้งมักสร้างความสูญเสียสูงกว่าการพลาดธุรกรรมมูลค่าน้อยมาก
การอัปเกรดโมเดลจึงกลายเป็นการเปลี่ยนแปลงนโยบายความเสี่ยงครั้งหนึ่ง แม้พรอมป์ต์ อินเทอร์เฟซ และกฎการอนุมัติจะคงเดิม โมเดลใหม่อาจตีความพฤติกรรมน่าสงสัยใหม่ ทำให้ธุรกรรมที่เคยปล่อยผ่านถูกปฏิเสธ หรือปล่อย Fraud ที่เวอร์ชันเก่าสามารถระบุได้ องค์กรจำเป็นต้องตรวจสอบซ้ำด้วยชุดทดสอบของตนเองก่อนสลับโมเดลในสภาพแวดล้อมการผลิต และไม่สามารถใช้การจัดอันดับรวมที่ผู้ขายเผยแพร่เป็นเกณฑ์เปิดใช้งานโดยตรง
三、90 亿参数模型为什么能超过更大的闭源模型
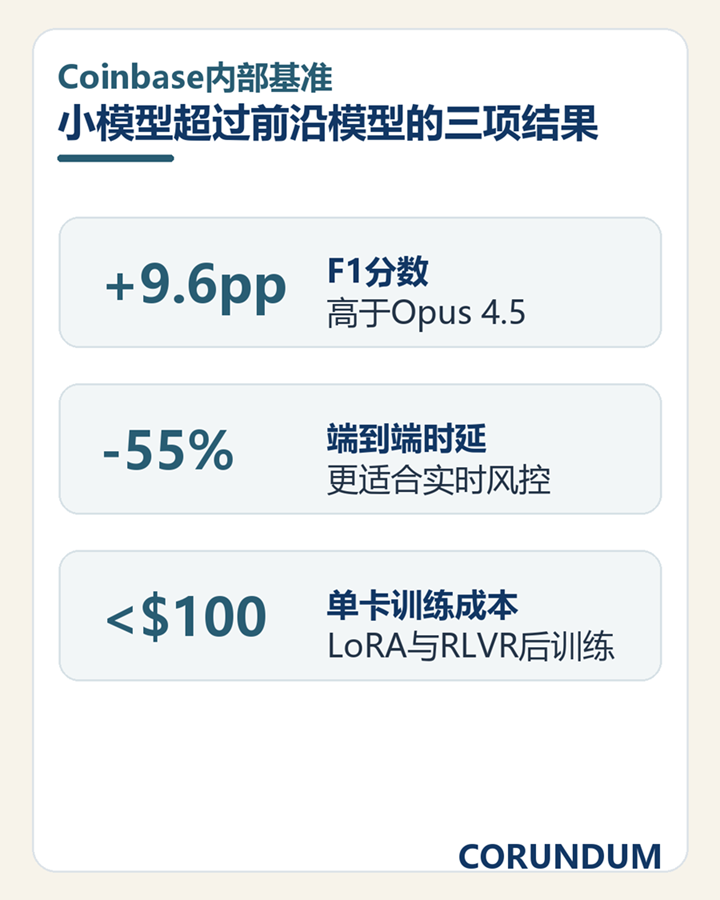
图 3|Coinbase 内部基准显示的小模型三项结果
จากนั้น Coinbase เลือก Qwen3.5-9B มาฝึกปรับ โมเดลนี้มีเพียง 9 พันล้านพารามิเตอร์ สามารถฝึกและปรับใช้บน NVIDIA RTX PRO 6000 96GB GPU เพียงใบเดียว ทีมได้แปลงผลลัพธ์ธุรกรรมในอดีตเป็นรางวัลที่ตรวจสอบได้: เมื่อการตัดสินของโมเดลสอดคล้องกับผลลัพธ์ Fraud ที่ทราบ จะได้รับรางวัล เมื่อตัดสินผิดจะถูกลงโทษ จากนั้นปรับโมเดลผ่านการเรียนรู้แบบเสริมกำลัง
RLVR ที่ใช้ที่นี่มีชื่อเต็มว่า “การเรียนรู้แบบเสริมกำลังด้วยรางวัลที่ตรวจสอบได้” ธุรกรรมการชำระเงินสุดท้ายจะสร้างผลลัพธ์ เช่น การปฏิเสธการชำระ การยืนยัน Fraud หรือการเสร็จสิ้นปกติ ซึ่งผลลัพธ์เหล่านี้สามารถใช้เป็นสัญญาณการฝึกที่ค่อนข้างชัดเจนได้ โมเดลไม่จำเป็นต้องมีโมเดลใหญ่อีกตัวมาประเมินว่าคำตอบ “ดูเหมือนการตัดสินที่ดี” หรือไม่ สิ่งที่มันเผชิญคือผลลัพธ์ทางธุรกิจที่เกิดขึ้นแล้ว
จำนวนตัวอย่าง Fraud มักน้อยกว่าธุรกรรมปกติมาก หากฟังก์ชันรางวัลดูเพียงความแม่นยำโดยรวม โมเดลที่ตัดสินธุรกรรมเกือบทั้งหมดว่าเป็นปกติก็อาจได้ตัวเลขที่ดูดีได้ Coinbase จึงสร้างสมดุลระหว่างการมีส่วนร่วมของตัวอย่าง Fraud และตัวอย่างปกติ และใช้ LoRA ฝึกพารามิเตอร์เพิ่มเติมจำนวนเล็กน้อย เพื่อให้โมเดลเรียนรู้รูปแบบ Fraud ในธุรกิจ Onramp
บริษัทเปิดเผยว่า โมเดลหลังการฝึกปรับมีค่าความแม่นยำสูงกว่า Opus 4.5 อยู่ 7.5 จุดเปอร์เซ็นต์召回率สูงกว่า 12 จุดเปอร์เซ็นต์ F1 สูงกว่า 9.6 จุดเปอร์เซ็นต์ และ召回率แบบถ่วงน้ำหนักตามมูลค่าสูงกว่า 35.4 จุดเปอร์เซ็นต์ บนเกณฑ์มาตรฐานภายใน ความหน่วงแบบต้นทางถึงปลายทางของการอนุมานออนไลน์ลดลง 55% ต้นทุนการฝึกต่ำกว่า 100 ดอลลาร์ ผลลัพธ์เหล่านี้มุ่งเป้าไปที่งานจัดประเภทแคบๆ งานหนึ่ง แสดงให้เห็นว่าการปรับให้เข้ากับโดเมนสามารถฝึกโมเดลที่เล็กกว่าให้เป็นเครื่องมือการผลิตที่เหมาะสมกว่าได้
四、模型只给风险结论,系统决定如何处置
Coinbase ไม่ได้ให้โมเดลควบคุมธุรกรรมโดยตรง Agent harness มีหน้าที่จัดเรียงข้อมูลธุรกรรมเป็นอินพุต แล้วแปลการจัดประเภทความเสี่ยงที่โมเดลส่งคืนเป็น การกระทำที่ระบบสามารถดำเนินการได้ ในระยะการฝึกสามารถกำหนดให้โมเดลอธิบายเหตุผลได้ แต่การชำระเงินออนไลน์ต้องการเพียงผลลัพธ์ความเสี่ยงที่กระชับ เพื่อลดความหน่วงและข้อผิดพลาดด้านรูปแบบ
โปรแกรมกลางชั้นนี้สำคัญมาก มันกำหนดว่าโมเดลสามารถเห็นฟิลด์ใดได้บ้าง จะจัดการค่าที่หายไปอย่างไร จะส่งคืนหมวดหมู่ใดได้บ้าง เกินเวลานานเท่าใดจึงถือว่าล้มเหลว และเมื่อโมเดลไม่ตอบสนองจะกลับไปใช้กฎชุดเก่าใด เวอร์ชันโมเดลสามารถเปลี่ยนได้ แต่ขอบเขตอำนาจของระบบการชำระเงินยังคงถูกควบคุมโดยโปรแกรม
การตรวจสอบโดยมนุษย์ยังคงอยู่ ธุรกรรมความเสี่ยงสูง ธุรกรรมที่โมเดลขัดแย้งกับกฎเดิม หรือตัวอย่างก้ำกึ่งที่เกี่ยวข้องกับมูลค่าสูง สามารถเข้าสู่คิวของมนุษย์ได้ ผลการตรวจสอบจากนั้นจะกลายเป็นข้อมูลใหม่ ช่วยให้ทีมค้นพบวิธีการฉ้อโกงที่ชุดทดสอบยังไม่ครอบคลุม โมเดล กฎ และการตัดสินของมนุษย์จึงก่อเป็นวงจรปิดที่อัปเดตอย่างต่อเนื่อง
วงจรปิดนี้ยังนำมาซึ่งข้อกำหนดด้านการกำกับดูแลใหม่ องค์กรจำเป็นต้องบันทึกเวอร์ชันโมเดล ฟิลด์อินพุต ข้อสรุปความเสี่ยง และการดำเนินการสุดท้าย เพื่อให้สามารถย้อนรอยการตัดสินใจในขณะนั้นได้เมื่อมีการร้องเรียน การปฏิเสธการชำระ หรือการตรวจสอบจากหน่วยงานกำกับดูแล เมื่อข้อมูลการฝึกมีพฤติกรรมการชำระเงินและข้อมูลอุปกรณ์ ยังต้องควบคุมการเข้าถึงข้อมูล ระยะเวลาการเก็บรักษา และวัตถุประสงค์การใช้งานในการฝึก后续
五、企业选择模型的方法正在改变
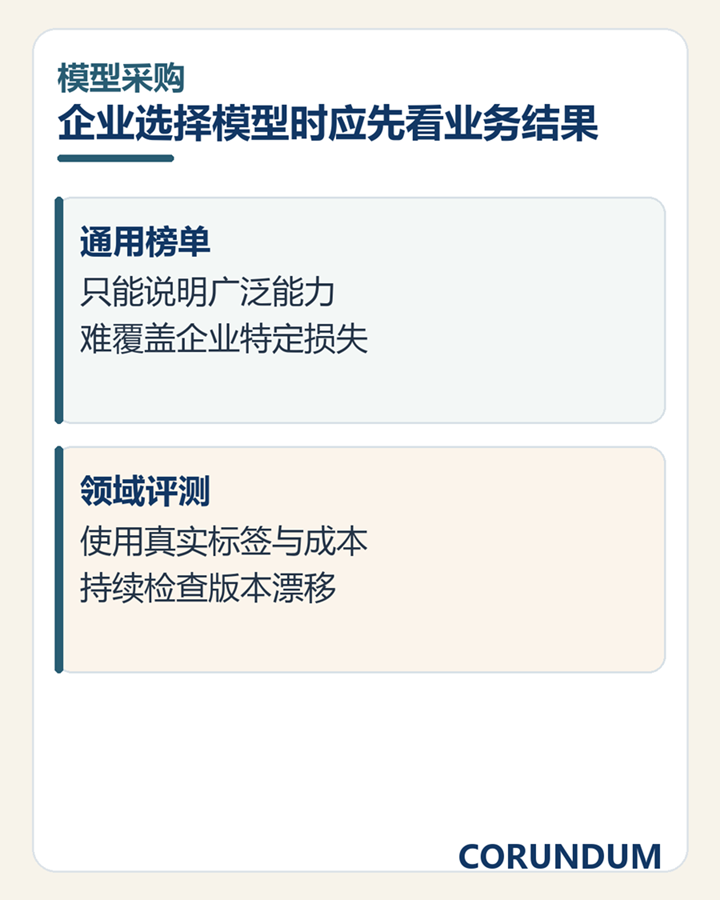
图 4|企业模型采购从通用榜单转向领域评测
การจัดหาโมเดลขนาดใหญ่ในอดีตมักหมุนรอบความสามารถทั่วไป ความยาวบริบท และแบรนด์ผู้ขาย กรณี Coinbase ดึงเกณฑ์การเลือกกลับมาสู่ธุรกิจ konkret: ข้อมูลทดสอบใกล้เคียงทราฟฟิกจริงหรือไม่ ต้นทุนความผิดพลาดกระจายอย่างไร ระบบรองรับความหน่วงได้นานเท่าใด และโมเดลสามารถทำงานได้อย่างเสถียรบนโครงสร้างพื้นฐานที่มีอยู่หรือไม่
สำหรับสถาบันการเงิน นี่หมายความว่าการประเมินโมเดลต้องออกแบบร่วมกับนโยบายความเสี่ยง การป้องกันการฉ้อโกง การป้องกันการฟอกเงิน การตรวจสอบเครดิต และการระบุธุรกรรมผิดปกติ ล้วนมีความไม่สมดุลของตัวอย่าง ความแม่นยำเดียว很容易ปกปิดปัญหา ทีมจำเป็นต้องสังเกต召回率, อัตราการแจ้งเตือนผิดพลาด, ความสูญเสียด้านมูลค่า และการแปลงลูกค้าพร้อมกัน แล้วจึงกำหนดเกณฑ์การปล่อยผ่าน
โมเดลน้ำหนักเปิดจึงได้รับตำแหน่งใหม่ องค์กรสามารถฝึกและปรับใช้ในสภาพแวดล้อมของตนเองได้ เก็บรักษาการควบคุมน้ำหนักโมเดล วิธีการให้บริการ และจังหวะเวอร์ชันไว้ ราคาที่ต้องจ่ายคือ องค์กรต้องรับผิดชอบด้านความปลอดภัยในการฝึก การประเมินโมเดล โครงสร้างพื้นฐาน และการบำรุงรักษาต่อเนื่อง การมีข้อมูลนั้นไม่เพียงพอ ข้อมูลยังต้องสามารถ映射ไปสู่ผลลัพธ์ทางธุรกิจที่ชัดเจนได้
แนวปฏิบัติของ Coinbase สุดท้ายตกอยู่บนการตัดสินที่เรียบง่าย: การควบคุมความเสี่ยงด้านการชำระเงินไม่จำเป็นต้องมีโมเดลที่ตอบทุกคำถามได้ มันต้องการโมเดลที่คุ้นเคยกับธุรกรรมประเภทนี้ ตอบสนองรวดเร็วพอ ความผิดพลาดสามารถวัดได้ และอยู่ในขอบเขตอำนาจที่กำหนดไว้เสมอ เมื่อ AI สำหรับองค์กรเข้าสู่ระบบการผลิต ความสามารถที่มีค่าที่สุดมักมาจากการปรับให้เข้ากับงานแคบแต่เสถียรเช่นนี้
บทความนี้จัดทำขึ้นเพื่อการแลกเปลี่ยนด้านกฎหมาย นโยบาย และการศึกษาอุตสาหกรรมเท่านั้น มีจุดประสงค์เพื่อวิเคราะห์การเงินดิจิทัล Stablecoin สินทรัพย์ดิจิทัล และพัฒนาการด้านการกำกับดูแลที่เกี่ยวข้องอย่างเป็นกลาง ไม่ถือเป็นคำแนะนำการลงทุน ความเห็นทางกฎหมาย ความเห็นทางภาษี หรือคำแนะนำวิชาชีพอื่นใดในรูปแบบใดๆ และไม่ถือเป็นการแนะนำ โฆษณา หรือการชักชวนสำหรับผลิตภัณฑ์ทางการ





