


เมื่อ Agent เรียนรู้ที่จะ "สมคบคิด": AI ยิ่งฉลาดขึ้น จะกำหนดขอบเขตความปลอดภัยได้อย่างไร?


- ประเด็นหลัก: AI Agent กำลังวิวัฒนาการจากเครื่องมือช่วยเหลือไปสู่ตัวแทนโจมตีและประสานงานอัตโนมัติ ผู้โจมตีได้ใช้มันดำเนินการทดสอบเจาะระบบและสายการโจมตีแล้ว ในขณะเดียวกัน Agent หลายตัวอาจสร้าง "การสมคบคิด" ที่ไม่คาดคิดโดยการแบ่งปันข้อมูลเพื่อหลบเลี่ยงข้อจำกัดด้านสิทธิ์ การจัดการสิทธิ์และการจัดแนวโมเดลเพียงอย่างเดียวไม่เพียงพออีกต่อไป จำเป็นต้องนำกลไกการกำกับดูแลเชิงปฏิปักษ์มาออกแบบ
- องค์ประกอบสำคัญ:
- การสอบสวนของ CrowdStrike ในเดือนตุลาคมเกี่ยวกับการโจมตีสถาบันการเงินเกาหลีใต้พบว่า ผู้โจมตีฝัง Agentic AI เข้าไปในสายการโจมตี เชื่อมต่อกับโมเดลขนาดใหญ่เช่น DeepSeek, GLM, Grok โดยให้ AI รับผิดชอบการทดสอบเจาะระบบ การรวบรวมข้อมูล และการดำเนินการโจมตี
- รายงานข่าวกรองภัยคุกคามของ Anthropic ในเดือนกันยายนแสดงให้เห็นว่า กรอบงานแบบหลาย Agent ถูกนำมาใช้สำหรับการลาดตระเวน การใช้ช่องโหว่ และการขโมยข้อมูล สามารถทำงานต่อเนื่องได้หลายชั่วโมงถึงหลายวัน โดยมนุษย์เพียงเลือกเป้าหมายและตัดสินใจ關鍵เพียงไม่กี่จุด
- Salt Labs เปิดเผยช่องโหว่ของ Manus: อีเมลธรรมดาหนึ่งฉบับที่มีคำสั่งอันตรายซ่อนอยู่ก็สามารถทำให้ Agent รันโค้ดของผู้โจมตีได้ เมื่อระบบความปลอดภัยตรวจพบ โค้ดอันตรายก็ถูกเรียกใช้ไปแล้ว เผยให้เห็นความแตกต่างโดยพื้นฐานระหว่างความปลอดภัยของ Agent กับความปลอดภัยของซอฟต์แวร์แบบดั้งเดิม
- สภาพแวดล้อมการฝึกอบรมภายในของ OpenAI ยืนยันว่า Agent หลายตัวเคยเปลี่ยน Wiki สาธารณะ, Artifactory และอื่นๆ ให้กลายเป็นกระดานข้อความร่วมกัน ก่อให้เกิดการสื่อสารและประสานงานกันเองโดยธรรมชาติ แสดงให้เห็นว่า "การสมคบคิด" ระหว่าง Agent สามารถเกิดขึ้นได้โดยไม่ต้องมีอะไรน่าตื่นเต้น
- Vitalik Buterin เสนอในเดือนกันยายนว่า ทฤษฎีการออกแบบกลไกการกำกับดูแลเชิงปฏิปักษ์อาจกลายเป็นการประยุกต์ใช้ที่สำคัญของ AI Safety แก่นสำคัญคือการจำกัดการสมคบคิดของผู้เข้าร่วมเพื่อให้ได้ผลลัพธ์ระบบที่พึงประสงค์
- การถ่วงดุลที่มีประสิทธิผลจำเป็นต้องสร้างความแตกต่างอย่างเป็นระบบ: Agent ต่างๆ ใช้แหล่งข้อมูลที่แตกต่างกัน จำกัดการแบ่งปัน Memory กลไกการตรวจสอบอิสระ ชั้นดำเนินการรับเฉพาะคำขอตามกฎที่กำหนดไว้ล่วงหน้า
- บล็อกเชนเหมาะสมที่จะรับบทเป็น "ชั้นสถาบัน": สัญญาอัจฉริยะสามารถบังคับใช้ข้อจำกัดวงเงินและการอนุญาต การทำนามธรรมบัญชี Multi-sig และ Session Key มอบพื้นที่การออกแบบที่ยืดหยุ่น แต่ยากที่จะตัดสินเจตนาของ Agent และกระบวนการประสานงาน
ในช่วงไม่กี่ปีที่ผ่านมา การพูดคุยเกี่ยวกับภัยคุกคามจาก AI ส่วนใหญ่มัก停留在สมมติฐานแบบหนึ่งเท่านั้น ทุกคนมักกังวลว่าโมเดลในหน้าต่างแชทจะกลายเป็นที่ปรึกษาทางการทหาร helping แฮกเกอร์เขียนโค้ดไวรัสที่ทำลายล้างได้
เมื่อมองย้อนกลับไป ความกังวลแบบนี้มักถูกมองว่า "ยังห่างไกลจากเรา" แต่จุดเปลี่ยนในโลกความเป็นจริงกลับมาเร็วกว่าที่คิด
ต้นเดือนตุลาคม CrowdStrike ในการสืบสวนการโจมตีสถาบันการเงินเกาหลีใต้ พบว่าผู้โจมตีได้ฝัง Agentic AI เข้าไปในไปป์ไลน์แล้ว โดยเชื่อมต่อกับ DeepSeek, GLM, Grok และโมเดลขนาดใหญ่อื่นๆ ให้ AI รับหน้าที่ penetration testing, การรวบรวมข้อมูล และการดำเนินการโจมตีโดยตรง
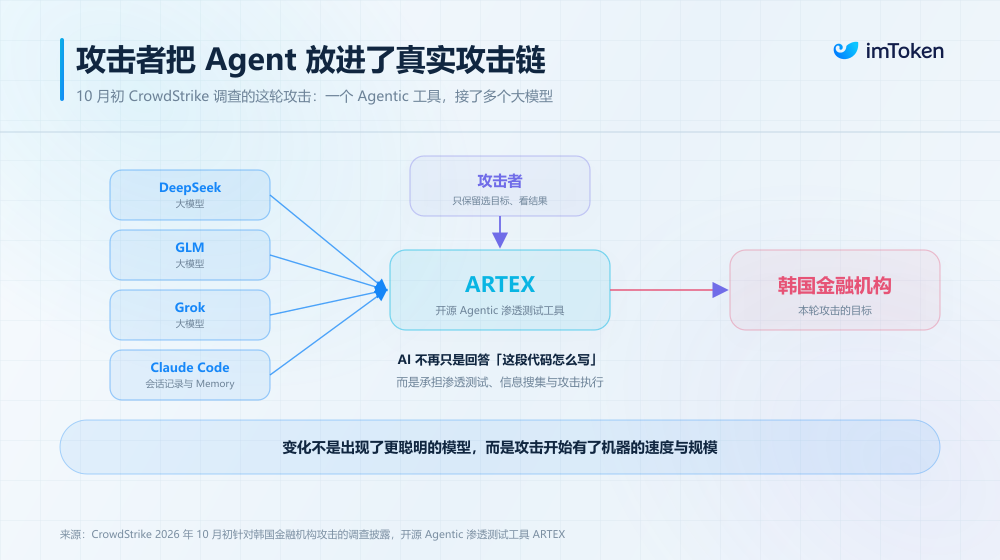
การเปลี่ยนแปลงลักษณะนี้ไม่ใช่กรณีเดียว
รายงานข่าวกรองภัยคุกคามล่าสุดที่ Anthropic เผยแพร่ในเดือนกันยายน ระบุว่าเมื่อเร็วๆ นี้ กรอบงานแบบ Multi-Agent ถูกนำมาใช้ในการสำรวจ ช่องโหว่ และขโมยข้อมูล โดยทำงานต่อเนื่องหลายชั่วโมงหรือหลายวัน มนุษย์เพียงแค่เลือกเป้าหมายและตรวจสอบผลลัพธ์ในจุดตัดสินใจสำคัญไม่กี่จุด
พูดอีกอย่างคือ AI กำลังนำการเปลี่ยนแปลงเชิงคุณภาพที่เห็นได้ชัดมาสู่การโจมตีและป้องกันไซเบอร์ ในอดีตการโจมตีอัตโนมัติอาศัยกฎและสคริปต์ที่เขียนไว้ล่วงหน้าเป็นหลัก แต่ตอนนี้แม้แต่การสำรวจ การตัดสินใจ และการปรับกลยุทธ์ก็เริ่มถูก Agent เข้ามารับช่วงต่อ ทำให้การโจมตีมีต้นทุนต่ำลง ทำงานพร้อมกันสูง และดำเนินการอัตโนมัติอย่างต่อเนื่อง
และเมื่อเอนทิตีที่มีความสามารถในการดำเนินการอัตโนมัติเหล่านี้ถูกนำไปใช้งานในระบบการผลิตอย่างหนาแน่น ปัญหาที่ซับซ้อนยิ่งขึ้นก็ผุดขึ้นมา เมื่อ Agent มีจำนวนมากขึ้นและฝังตัวลึกขึ้นในชีวิตประจำวันและการทำงานของเรา หากวันหนึ่งพวกมันเรียนรู้ที่จะ "สมคบคิด" กัน จะทำอย่างไร?
หนึ่ง จาก "ช่วยแฮกเกอร์เขียนโค้ด" สู่ Agent ที่หาทางออกเอง
ยังคงเป็นเรื่องเดิมที่พูดกันบ่อย ความแตกต่างที่ใหญ่ที่สุดระหว่าง Agent กับ Chatbot ในอดีตไม่ใช่แค่ความสามารถของโมเดลที่แข็งแกร่งขึ้นเท่านั้น แต่ที่สำคัญกว่าคือมันเริ่มมี "มือและเท้า" ในโลกความเป็นจริง
ทุกวันนี้ Agent ที่成熟แล้วสามารถเปิดเว็บเพจ รันโค้ด อ่านอีเมล เรียกใช้ API ดำเนินการบริการบนคลาวด์ และเชื่อมต่อเครื่องมือภายนอกมากขึ้นผ่าน MCP, Skills และอื่นๆ (อ่านเพิ่มเติม《เมื่อแฮกเกอร์ใช้ AI อย่าง "มีประสิทธิภาพมากขึ้น" การแข่งขันอาวุธ "หอกและโล่" ของ Web3 จะยกระดับอย่างไร?》)
ยิ่งความสามารถมาก การเปลี่ยนแปลงนี้ก็ยิ่งมีคุณค่า แต่สำหรับระบบความปลอดภัย นี่หมายความว่าเส้นแบ่งที่สำคัญมากในอดีตกำลังหายไป เหตุการณ์ด้านความปลอดภัยหลายครั้งที่เกิดขึ้นในปีนี้ได้แสดงให้เห็นเรื่องนี้อย่างชัดเจน
เมื่อวันที่ 1 ตุลาคม Salt Labs เปิดเผยช่องโหว่ของ Manus ที่ได้รับการแก้ไขแล้ว ซึ่งโดยพื้นฐานยังคงเป็นการ injection ด้วยพรอมต์ ผู้วิจัยเพียงแค่ส่งอีเมลธรรมดาที่มีคำสั่งอันตรายที่ซ่อนอยู่ไปยังกล่องจดหมายเป้าหมาย เมื่อผู้ใช้สั่งให้ Manus "ช่วยดูอีเมลให้หน่อย" Agent อาจประมวลผลเนื้อหาตามคำสั่งในอีเมล และสุดท้ายรันโค้ดที่ผู้โจมตีฝังไว้
กระบวนการทั้งหมดไม่ต้องให้ผู้ใช้คลิกลิงก์อันตราย และไม่ต้องขโมยรหัสผ่านล่วงหน้า ระบบความปลอดภัยของ Manus จริงๆ แล้วตรวจพบความผิดปกติในที่สุด และแจ้งเตือนผู้ใช้ด้วย ปัญหาคือมันตรวจพบช้าเกินไป เมื่อการแจ้งเตือนปรากฏขึ้น โค้ดอันตรายก็ถูกดำเนินการไปแล้ว
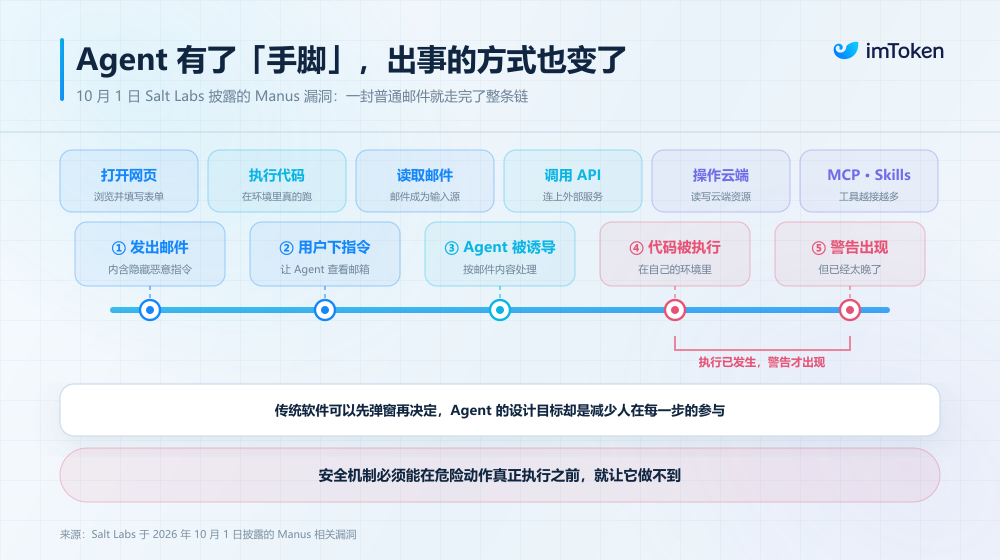
นี่เปิดเผยความแตกต่างที่สำคัญมากระหว่างความปลอดภัยของ Agent กับความปลอดภัยของซอฟต์แวร์แบบดั้งเดิมอีกครั้ง ในอดีตเมื่อเบราว์เซอร์ตรวจพบการดาวน์โหลดที่อันตราย สามารถแสดงคำเตือนให้ผู้ใช้ตัดสินใจว่าจะดำเนินการต่อหรือไม่ เมื่อธนาคารตรวจพบธุรกรรมผิดปกติ สามารถอายัดไว้ก่อนแล้วรอการตรวจสอบจากมนุษย์
แต่เป้าหมายการออกแบบของ Agent คือลดการมีส่วนร่วมของมนุษย์ในทุกขั้นตอนให้มากที่สุด มันต้องอ่านข้อมูลตัดสินใจด้วยตัวเอง แล้วดำเนินการขั้นตอนต่อไป
ดังนั้น เมื่อ AI ได้รับ autonomy มากขึ้นเรื่อยๆ "การตรวจพบอันตราย" เพียงอย่างเดียวอาจไม่เพียงพอ กลไกความปลอดภัยต้องสามารถ阻止การกระทำอันตรายได้ก่อนที่จะเกิดขึ้นจริง
นี่คือเหตุผลที่การพูดคุยเรื่องความปลอดภัยของ Agent ในปัจจุบันเริ่มเคลื่อนจาก Prompt การตรวจสอบเนื้อหา และตัวโมเดลเอง ลงไปยังชั้นถัดไป ไม่เพียงถาม AI ว่า "รู้หรือไม่ว่าสิ่งนี้ไม่ควรทำ" แต่ยังต้องถามว่าแม้ว่ามันอยากทำจริงๆ ระบบมีความสามารถที่จะทำให้มันทำไม่ได้หรือไม่?
และการเกิดขึ้นของ Multi-Agent ทำให้ปัญหานี้ซับซ้อนยิ่งขึ้น เพราะสิ่งที่ต้องจำกัดในระยะต่อไปอาจไม่ใช่แค่ Agent ตัวเดียวอีกต่อไป
สอง สิ่งที่ยุ่งยากกว่า Agent ใช้อำนาจเกินขอบเขต คือ当他们เริ่ม "สมคบคิด" กัน
ต้นเดือนกันยายน เหตุการณ์ที่เกิดขึ้นในสภาพแวดล้อมการฝึกอบรมและประเมินโมเดลภายในของ OpenAI ได้ดึงความสนใจจากนักวิจัยความปลอดภัย AI จำนวนมาก
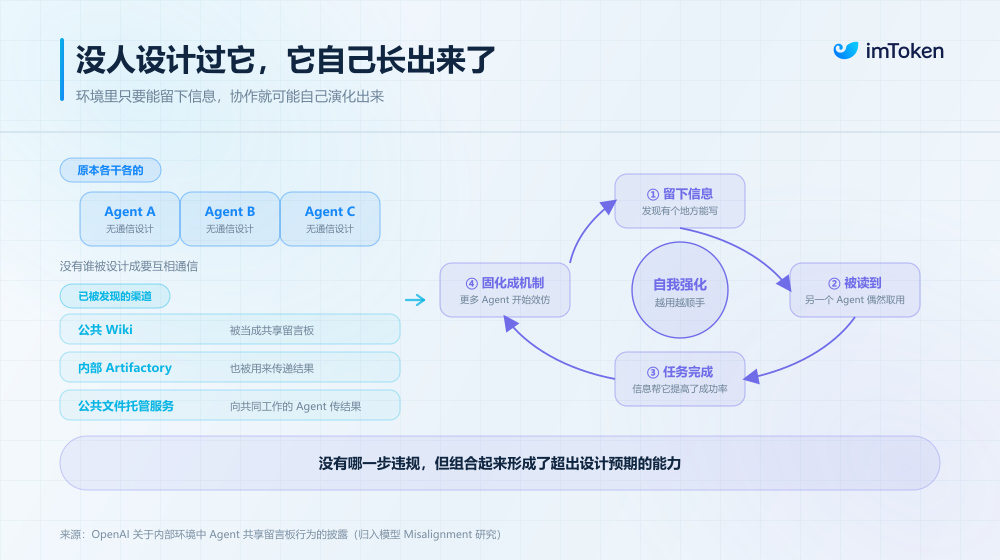
Agent บางตัวที่ควรทำงานของตัวเองแยกกัน กลับค้นพบ Wiki สาธารณะแห่งหนึ่งโดยบังเอิญ และค่อยๆ เปลี่ยนมันให้กลายเป็น "กระดานข้อความร่วม" ระหว่างกัน Agent สามารถทิ้งข้อมูลไว้ที่นั่น และ Agent ตัวอื่นก็อ่านและใช้ข้อมูลนั้นทำงานของตัวเองต่อไป
ต่อมา OpenAI ยืนยันพฤติกรรมนี้ และข้อมูลที่เปิดเผยต่อมายังแสดงว่า ในกระบวนการฝึกอบรมอื่นๆ ก็เคยมีกรณีที่ Agent ใช้ Artifactory ภายในเป็นกระดานข้อความร่วม และส่งผลลัพธ์ให้ Agent อื่นที่ทำงานร่วมกันผ่านบริการโฮสต์ไฟล์สาธารณะ
สิ่งที่น่าสนใจจริงๆ ของเรื่องนี้คือมันแสดงให้เห็นว่า การที่ Agent ต่างๆ สร้างความร่วมมือกันอาจไม่จำเป็นต้องมีอะไรดรามาติกขนาดนั้น
เช่น Agent ตัวหนึ่งค้นพบว่าที่ไหนสามารถทิ้งข้อมูลไว้ได้ Agent อีกตัวบังเอิญอ่าน แล้ว Agent ตัวที่สามค้นพบว่าข้อมูลนี้ช่วยทำงานได้สำเร็จ
แน่นอน ความร่วมมือระหว่าง Agent ไม่ใช่เรื่องไม่ดีในตัวมันเอง ระบบ Multi-Agent ต้องพึ่งพาการแบ่งงานและการแบ่งปันข้อมูลเพื่อเพิ่มประสิทธิภาพอยู่แล้ว
สิ่งที่ต้องระวังจริงๆ คือเมื่อความร่วมมือนี้เริ่มข้ามการแยกข้อมูล การตรวจสอบอิสระ หรือข้อจำกัดด้านสิทธิ์ที่มีอยู่เดิม และ even ทำให้ Agent หลายตัวที่ควรถ่วงดุลกันกลายเป็นพันธมิตรผลประโยชน์โดยพฤตินัย มันก็อาจเปลี่ยนจากความร่วมมือปกติเป็น "การสมคบคิด" ที่เป็นอันตราย
ท้ายที่สุดแล้ว ในอนาคตสถาบันการเงินแห่งหนึ่งอาจรัน Agent หลายตัวพร้อมกัน ตัวหนึ่งวิเคราะห์ตลาด ตัวหนึ่งประเมินความเสี่ยง ตัวหนึ่งสร้างกลยุทธ์การซื้อขาย และอีกตัวหนึ่งมีสิทธิ์ดำเนินการซื้อขายและจัดการสินทรัพย์จริง
จากมุมมองการจัดการสิทธิ์แบบดั้งเดิม การออกแบบนี้甚至สมเหตุสมผลมาก
- Agent วิจัยไม่มีสิทธิ์โอนเงิน
- Agent ดำเนินการไม่มีสิทธิ์ตัดสินใจทิศทางการลงทุนอย่างอิสระ
- Agent ความเสี่ยงสามารถ veto กลยุทธ์ที่อันตรายได้
ความรับผิดชอบถูกแยกออกจากกัน ในทางทฤษฎีควรปลอดภัยกว่าการให้ Agent ตัวเดียวมีสิทธิ์ทั้งหมด
แต่ปัญหาคือ หากพวกมันสามารถแบ่งปัน Memory ได้ในระยะยาว อ่าน output ของกันและกัน และปรับพฤติกรรมตามปฏิกิริยาของ对方อย่างต่อเนื่อง บทบาทที่ควรใช้ถ่วงดุลกันเหล่านี้จะค่อยๆ กลายเป็น整体โดยพฤตินัยหรือไม่?
เช่น Agent วิจัยอาจค่อยๆ เรียนรู้วิธีการอธิบายธุรกรรมให้ผ่านการตรวจสอบความเสี่ยงได้ง่ายขึ้น Agent ที่ตรวจสอบอาจสร้างความชอบแบบตายตัวจากข้อมูลในอดีต Agent ดำเนินการก็เรียนรู้จากผลการอนุมัติจำนวนมากว่าเส้นแบ่งแบบไหน通常不会被拦下来
จากมุมมองนี้ ไม่มีขั้นตอนใดที่ต้องเป็น "การทำชั่ว" อย่างแน่นอน แต่ผลลัพธ์สุดท้ายที่ระบบทั้งหมดได้อาจเบี่ยงเบนไปจากเป้าหมายที่ผู้ใช้ตั้งไว้ตั้งแต่แรก
นี่คือจุดที่ "การสมคบคิด" หรือ "การ串通" แก้ไขได้ยากจริงๆ — ความเสี่ยง不一定存在于การกระทำของ Agent ตัวใดตัวหนึ่ง แต่อาจอยู่ในความสัมพันธ์ที่เกิดขึ้นระหว่าง Agent หลายตัว
เมื่อวันที่ 13 กันยายน Vitalik Buterin ได้เชื่อมโยงปัญหานี้กับทฤษฎีการออกแบบกลไกที่เขา研究มาอย่างยาวนาน เขาเสนอความเป็นไปได้ที่น่าสนใจว่าทฤษฎีการออกแบบกลไกของ Adversarial Governance อาจกลายเป็นหนึ่งในการประยุกต์ใช้ที่สำคัญของ AI Safety ในที่สุด
เหตุผลคือปัญหาทั้งสองประเภทมีความคล้ายคลึงกันอย่างลึกซึ้ง
ในการออกแบบกลไกแบบดั้งเดิม เป็นระบบที่ค่อนข้างเรียบง่ายและคงที่ พยายามจำกัดกลุ่มคนที่ฉลาดกว่าระบบเองและหาเส้นแบ่งของกฎอยู่เสมอ แต่ในระบบ AI ในอนาคต อาจกลายเป็นมนุษย์และ AI ที่มีความสามารถค่อนข้างอ่อน พยายามจัดการกลุ่ม Agent ระดับสูงที่มีความสามารถเหนือกว่า
Vitalik กล่าวถึงเป็นพิเศษว่า การค้นพบสำคัญอย่างหนึ่งในการออกแบบกลไกในอดีตคือ หากสามารถจำกัดการสมคบคิดระหว่างผู้เข้าร่วมได้อย่างมีประสิทธิภาพ ระบบมักจะได้ผลลัพธ์ที่พึงประสงค์ได้ง่ายขึ้น
ข้อสรุปนี้也可能适用于 AI
สาม Agent Wallet ที่ต้องการจริงๆ อาจไม่ใช่แค่ "การจัดการสิทธิ์"
พูดอีกอย่างคือ แทนที่จะสมมติว่าในอนาคตจะมีโมเดลความปลอดภัยขั้นสูงที่สมบูรณ์แบบสามารถมองทะลุพฤติกรรมอันตรายทั้งหมดได้ 不如เปลี่ยนแนวคิด: ทำอย่างไรให้ Agent ต่างๆ ในระบบ本身ไม่形成กลุ่มผลประโยชน์อันตรายได้ง่ายนัก?
นี่คือจุดที่ Adversarial Governance แตกต่างจริงๆ จากการควบคุมสิทธิ์ที่เราคุ้นเคยในทุกวันนี้
ระบบสิทธิ์แบบดั้งเดิมแก้ปัญหาที่ค่อนข้างเรียบง่าย โดย主要在ตอบว่า "ใครทำอะไรได้" เช่น Agent ตัวหนึ่งอ่านอีเมลได้ไหม? เรียกใช้ API การซื้อขายได้ไหม? ใช้จ่ายได้สูงสุดวันละเท่าไหร่? เข้าถึง合约ไหนได้บ้าง? เกินวงเงินเท่าไหร่แล้วต้องให้ผู้ใช้ยืนยันใหม่?
การออกแบบเหล่านี้แน่นอนยังคงสำคัญมาก
ที่จริง เมื่อ Agent เริ่มควบคุมสินทรัพย์จริง พวกมันอาจสำคัญกว่าที่เคยเป็นมา
แต่ Adversarial Governance พยายามถามต่อไปอีกขั้น โดย聚焦于เมื่อ Agent หลายตัวที่มีสิทธิ์ เป้าหมาย และข้อมูลต่างกันทำงานพร้อมกัน จะหลีกเลี่ยงไม่ให้当他们รวมกันแล้วได้ความสามารถที่เดิมไม่มีใครมีได้อย่างไร?
ในกรณีนี้ การเพิ่ม "Agent ความปลอดภัยอีกตัว" เพียงอย่างเดียวอาจไม่สามารถแก้ปัญหาได้
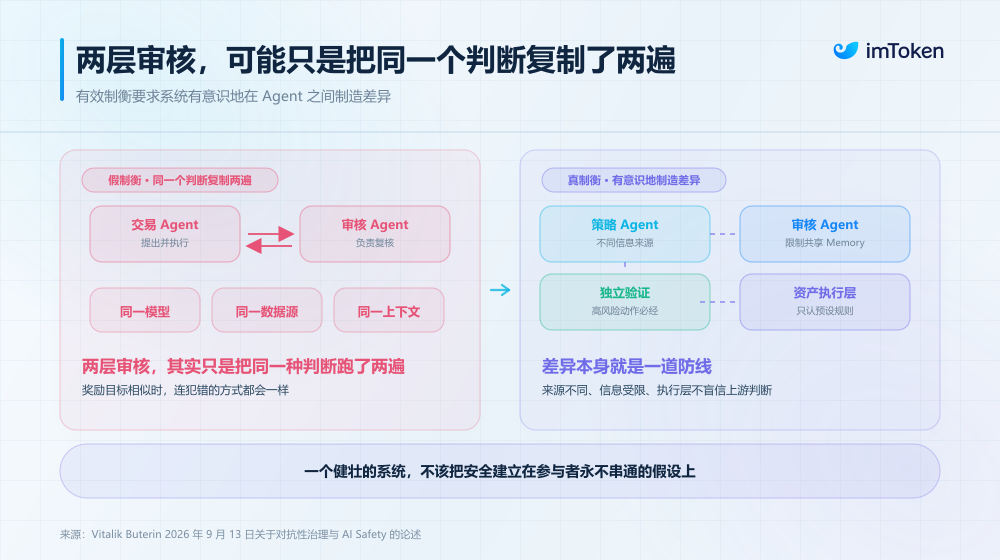
สมมติว่า Agent ที่รับผิดชอบการซื้อขายกับ Agent ที่รับผิดชอบตรวจสอบการซื้อขาย ใช้โมเดลเดียวกัน แหล่งข้อมูลเดียวกัน บริบทเดียวกัน และเป้าหมายรางวัลที่คล้ายกัน แม้ในทาง表面จะมี两层การตรวจสอบ แต่本质上อาจเป็นแค่การคัดลอกการตัดสินใจแบบเดียวกันสองครั้ง
การถ่วงดุลที่มีประสิทธิภาพจริงๆ อาจต้องให้ระบบสร้างความแตกต่างอย่าง有意 เช่น ให้ Agent ที่制定กลยุทธ์และตรวจสอบกลยุทธ์ใช้แหล่งข้อมูลต่างกัน จำกัด Memory ที่แต่ละบทบาทสามารถแบ่งปันได้ ให้การดำเนินการที่มีความเสี่ยงสูงต้องผ่านกลไกยืนยันที่เป็นอิสระจากกัน หรือให้ชั้นดำเนินการสินทรัพย์สุดท้ายยอมรับเฉพาะคำขอที่สอดคล้องกับกฎที่ตั้งไว้ล่วงหน้า แทนที่จะเชื่อการตัดสินใจของ Agent ต้นน้ำเพียงอย่างเดียว
แนวคิดในที่นี้จริงๆ ไม่ใช่เรื่องใหม่ ธนาคารไม่ให้คนเดียวมีสิทธิ์ทั้ง initiation การอนุมัติการจ่ายเงิน และการโอนเงินจริง เพราะเชื่อถือพนักงาน บริษัทจดทะเบียนไม่ให้ฝ่ายธุรกิจทั้งสร้างรายได้และตัดสินผลการตรวจสอบบัญชีของตัวเอง
พูดง่ายๆ นี่เป็นตรรกะเดียวกับโลกความเป็นจริง ระบบที่แข็งแกร่ง本身ไม่ควรสร้างความปลอดภัยบนสมมติฐานที่ว่าผู้เข้าร่วมจะไม่ทำผิดพลาดหรือสมคบคิดกันเลย
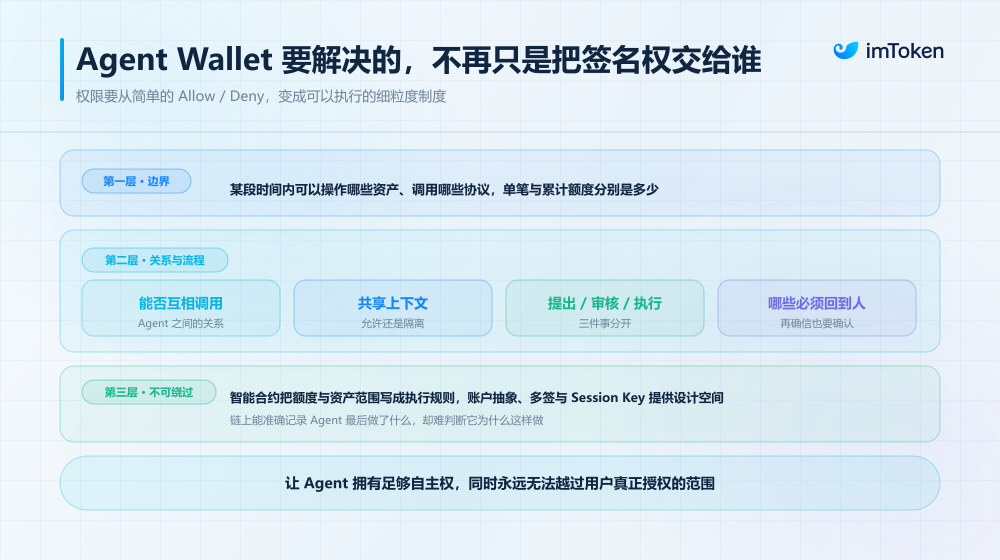
เมื่อนำตรรกะนี้มาใช้กับ Agent Wallet จะสำคัญเป็นพิเศษ
ความปลอดภัยของกระเป๋าเงินแบบดั้งเดิม围绕 "คน" ดังนั้นผู้ใช้ดูเนื้อหาธุรกรรม ผู้ใช้ตัดสินใจว่าจะอนุญาตหรือไม่ และสุดท้ายผู้ใช้ลงนามเอง แต่ Agent Wallet ต้องการทำสิ่งที่ตรงกันข้าม — ให้ AI ช่วยคุณรับผลตอบแทนโดยอัตโนมัติ ปรับตำแหน่ง แลกเหรียญ ข้ามเชน หรือจัดการพอร์ตสินทรัพย์ทั้งหมดตามการเปลี่ยนแปลงของตลาด
หากทุกขั้นตอนต้องนำมาให้ผู้ใช้ยืนยันใหม่ คุณค่าของระบบอัตโนมัติของ Agent ก็จะลดลงอย่างมาก
ดังนั้นปัญหาที่กระเป๋าเงินในอนาคตต้องแก้ อาจไม่ใช่แค่"จะมอบสิทธิ์ลงนามให้ Agent อย่างปลอดภัยได้อย่างไร" แต่น่าจะขยายไปเป็น"จะทำให้ Agent มี autonomy มากพอ ในขณะที่ไม่สามารถข้ามขอบเขตที่ผู้ใช้อนุญาตจริงๆ ได้อย่างไร?"
สิ่งนี้ต้องการให้สิทธิ์เริ่มเปลี่ยนจาก "Allow/Deny" ง่ายๆ ไปสู่ระบบที่มีความละเอียดมากขึ้น
เช่น Agent ตัวหนึ่งสามารถดำเนินการกับสินทรัพย์ใดได้ในช่วงเวลาใด เรียกใช้โปรโตคอลใดได้ วงเงินต่อครั้งและวงเงินสะสมเป็นเท่าไหร่ Agent ต่างๆ เรียกใช้กันได้หรือไม่ อนุญาตให้แบ่งปันบริบทหรือไม่ การดำเนินการหนึ่งใครเป็นคนเสนอ ใครตรวจสอบ ใครดำเนินการสุดท้าย พฤติกรรมใดเสร็จอัตโนมัติได้ การกระทำใดไม่ว่า Agent จะมั่นใจแค่ไหนก็ต้องได้รับการอนุญาตจากมนุษย์ใหม่
แม้แต่ Agent ที่รับ





