


SignalPlus: ข้อมูลเบื้องต้นเกี่ยวกับ Generative AI


คำนำ
“What I cannot create, I do not understand.”
-Richard Feynman
คำนำ
คุณยอมรับ Stable Diffusion และ MidJourney เพื่อสร้างภาพที่น่าทึ่ง
คุณมีความเชี่ยวชาญในการใช้ ChatGPT และ LLaMa เพื่อสร้างคำที่สวยงาม
คุณสลับไปมาระหว่าง MuseNet และ MuseGAN เพื่อสร้างเพลงบนภูเขา
ไม่ต้องสงสัยเลยว่าความสามารถเฉพาะตัวที่สุดของมนุษย์คือการสร้างสรรค์ แต่ในเทคโนโลยีที่เปลี่ยนแปลงตลอดเวลาในปัจจุบัน เราสร้างขึ้นโดยการสร้างเครื่องจักร! เครื่องจักรสามารถวาดงานศิลปะต้นฉบับ (วาด) เขียนบทความยาว ๆ ที่สอดคล้องกัน (เขียน) แต่งเพลงไพเราะ (แต่ง) และกำหนดกลยุทธ์การชนะสำหรับเกมที่ซับซ้อน (การเล่น) ตามสไตล์ เทคโนโลยีนี้ก็คือปัญญาประดิษฐ์กำเนิด (Generative Artificial Intelligence,ชื่อระดับแรก
1. โมเดลเชิงกำเนิดและแบบเลือกปฏิบัติ
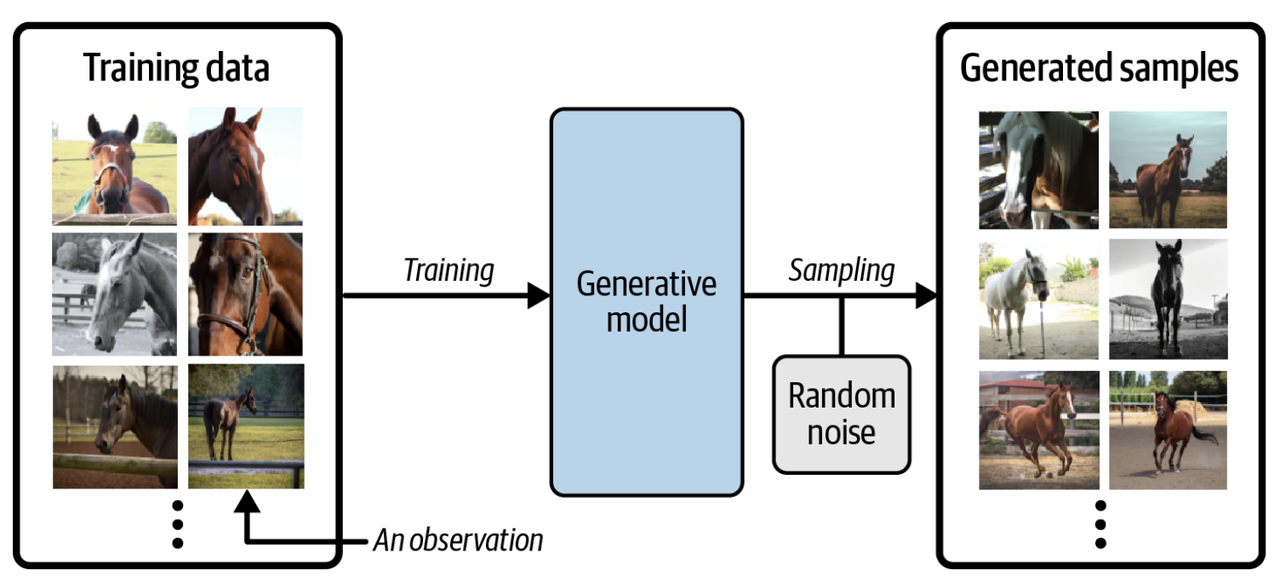
GenAI เป็นคำศัพท์สำคัญที่อยู่เบื้องหลังคำนี้สร้างแบบจำลอง(generative model) ซึ่งเป็นสาขาหนึ่งของการเรียนรู้ของเครื่องโดยมีเป้าหมายเพื่อฝึกโมเดลให้สร้างข้อมูลใหม่ที่คล้ายคลึงกับชุดข้อมูลที่กำหนด
สมมติว่าเรามีชุดข้อมูลม้า อันดับแรก เราสามารถฝึกโมเดลเชิงกำเนิดบนชุดข้อมูลนี้เพื่อจับกฎที่ควบคุมความสัมพันธ์ที่ซับซ้อนระหว่างพิกเซลในภาพม้า จากนั้นแบบจำลองนี้จะถูกสุ่มตัวอย่างเพื่อสร้างภาพที่เหมือนจริงของม้าที่ไม่มีอยู่ในชุดข้อมูลดั้งเดิม ดังแสดงในรูปด้านล่าง
เพื่อให้เข้าใจวัตถุประสงค์และความสำคัญของ generative model อย่างแท้จริง ให้เปรียบเทียบกับโมเดลจำแนก(แบบจำลองการเลือกปฏิบัติ) จำเป็นต้องมีการเปรียบเทียบ ที่จริงแล้ว ปัญหาส่วนใหญ่ใน Machine Learning ได้รับการแก้ไขด้วยแบบจำลองที่เลือกปฏิบัติ ดูตัวอย่างต่อไปนี้
สมมติว่าเรามีชุดข้อมูลภาพวาด บางส่วนเป็นของแวนโก๊ะ และบางส่วนเป็นของศิลปินคนอื่นๆ ด้วยข้อมูลที่เพียงพอ เราสามารถฝึกแบบจำลองที่เลือกปฏิบัติเพื่อคาดการณ์ว่าภาพวาดที่กำหนดเป็นของ Van Gogh หรือไม่ ดังแสดงในรูปด้านล่าง
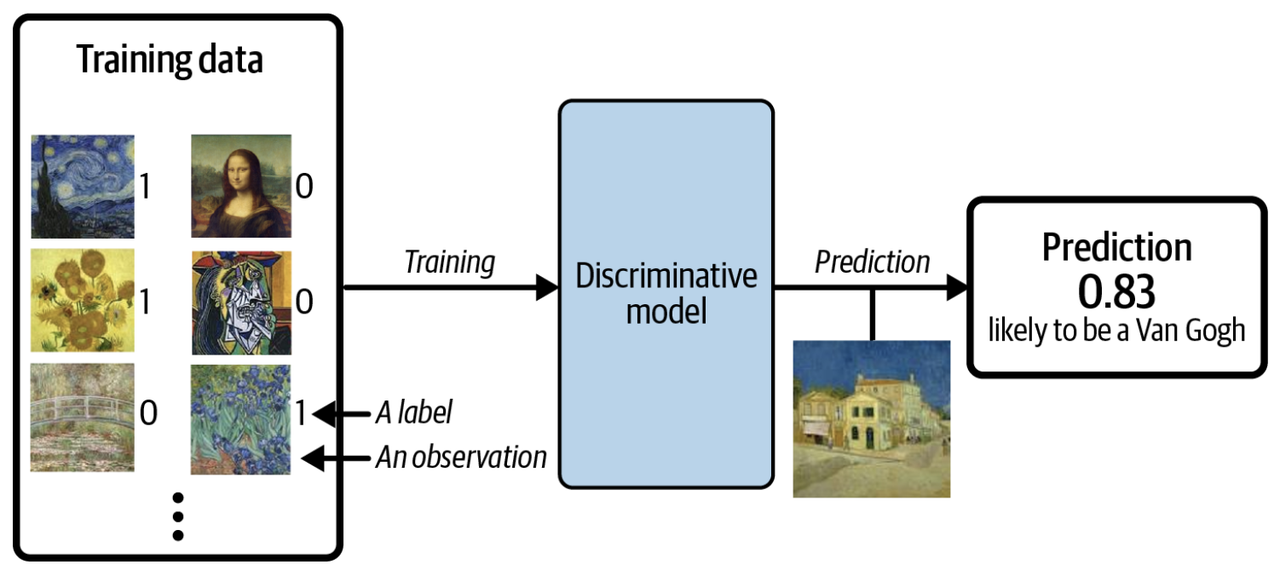
เมื่อใช้แบบจำลองที่เลือกปฏิบัติแต่ละตัวอย่างในชุดการฝึกจะมีป้ายกำกับ (ป้ายกำกับ) สำหรับปัญหาสองหมวดข้างต้น ป้ายกำกับของภาพวาดของ Van Gogh มักจะเป็น 1 และป้ายกำกับของภาพวาดที่ไม่ใช่ของ Van Gogh จะเป็น 0 จากรูปด้านบน ความน่าจะเป็นที่คาดการณ์ไว้ขั้นสุดท้ายของแบบจำลองคือ 0.83 ดังนั้นจึงมีความเป็นไปได้มากที่แบบจำลองนี้จะถูกสร้างโดยแวนโก๊ะ แตกต่างจากแบบจำลองแบบเลือกปฏิบัติ แบบจำลองเชิงกำเนิดไม่จำเป็นต้องมีตัวอย่างที่ต้องมีป้ายกำกับ เนื่องจากเป้าหมายของมันคือการสร้างข้อมูลใหม่ ไม่ใช่เพื่อทำนายป้ายกำกับสำหรับข้อมูล
หลังจากอ่านตัวอย่างแล้ว ให้เราใช้สัญกรณ์ทางคณิตศาสตร์เพื่อกำหนดแบบจำลองเชิงกำเนิดและแบบจำลองจำแนกอย่างแม่นยำ:
คู่แบบจำลองจำแนก P(y|x) การสร้างแบบจำลองตามคุณสมบัติที่กำหนดx เพื่อประเมินฉลาก y ความน่าจะเป็นแบบมีเงื่อนไขของ
สร้างคู่แบบจำลอง P(x) การสร้างแบบจำลองการประมาณคุณสมบัติโดยตรง xความน่าจะเป็นของ คุณลักษณะใหม่สามารถสร้างขึ้นได้โดยการสุ่มตัวอย่างจากการแจกแจงความน่าจะเป็นนี้
ชื่อระดับแรก
2. กรอบการทำงานสำหรับแบบจำลองเชิงกำเนิด
ก่อนจะเข้าสู่ generative model framework มาเล่นเกมกันก่อน สมมติว่าจุดต่างๆ ในรูปด้านล่างถูกสร้างขึ้นตามกฎบางข้อ เราเรียกกฎนี้ว่า Pdata ตอนนี้ให้คุณสร้างข้อมูลอื่นได้x = (x 1,x 2) ทำให้จุดดูเหมือนถูกกำหนดโดยกฎเดียวกันPสร้างขึ้นโดยข้อมูล
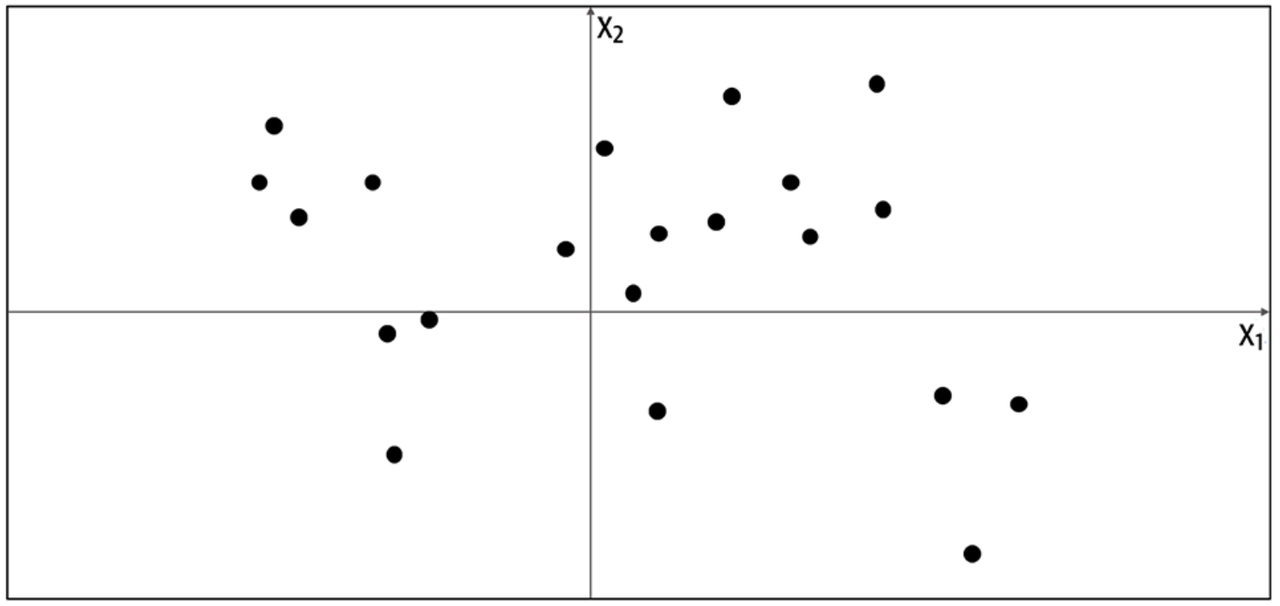
คุณจะสร้างจุดนี้ได้อย่างไร? คุณสามารถสร้างแบบจำลองในหัวของคุณโดยใช้คะแนนที่กำหนดPโมเดลและตำแหน่งที่โมเดลนี้ครอบครองอาจสร้างจุดที่คุณต้องการได้ จากนี้จะเห็นได้ว่าโมเดลนี้Pรุ่นคือPการประมาณข้อมูล จากนั้นเป็นรุ่นที่ง่ายที่สุดPแบบจำลองจะเป็นกล่องสีส้มตามภาพด้านล่าง แต้มสามารถสร้างได้ภายในกล่องเท่านั้น แต่ไม่สามารถสร้างนอกกล่องได้
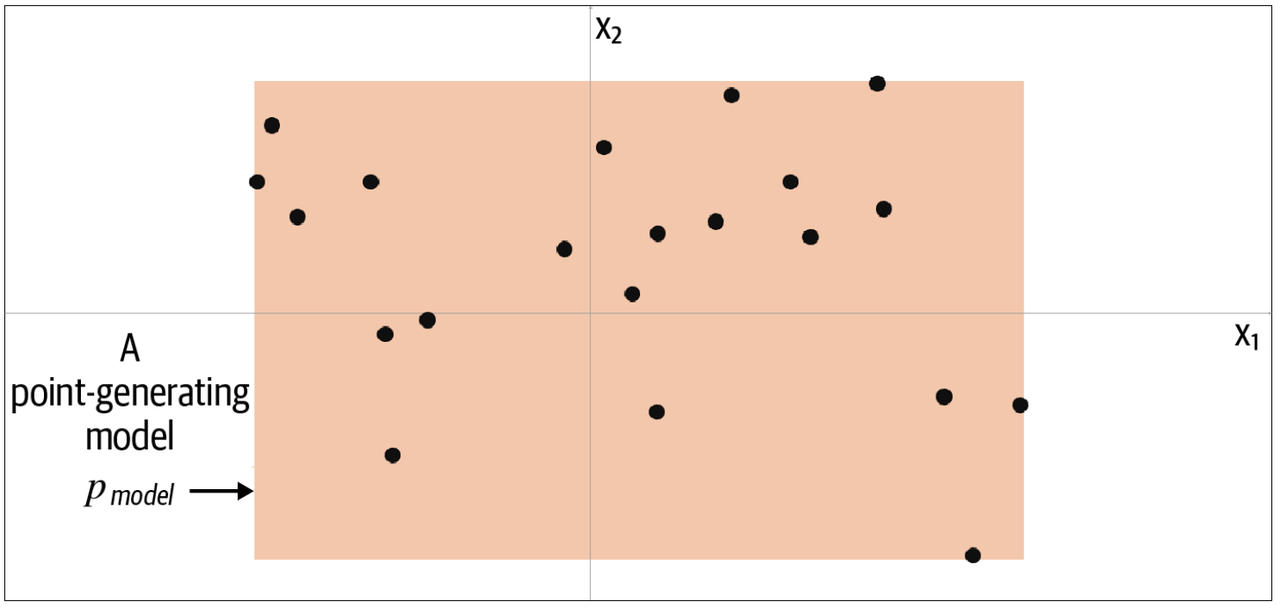
ในการสร้างจุดใหม่ เราสามารถสุ่มเลือกจุดจากกล่องจากแบบจำลองอย่างเข้มงวดยิ่งขึ้นPการสุ่มตัวอย่างในการกระจายตัวแบบ นี่คือโมเดลกำเนิดแบบมินิมอลลิสต์ คุณสร้างแบบจำลอง (กล่องสีส้ม) จากข้อมูลการฝึก (จุดสีดำ) จากนั้นสุ่มตัวอย่างจากแบบจำลอง โดยหวังว่าคะแนนที่สร้างขึ้นจะดูคล้ายกับจุดในชุดการฝึก
ตอนนี้เราสามารถเสนอกรอบการเรียนรู้เชิงสร้างสรรค์อย่างเป็นทางการได้แล้ว
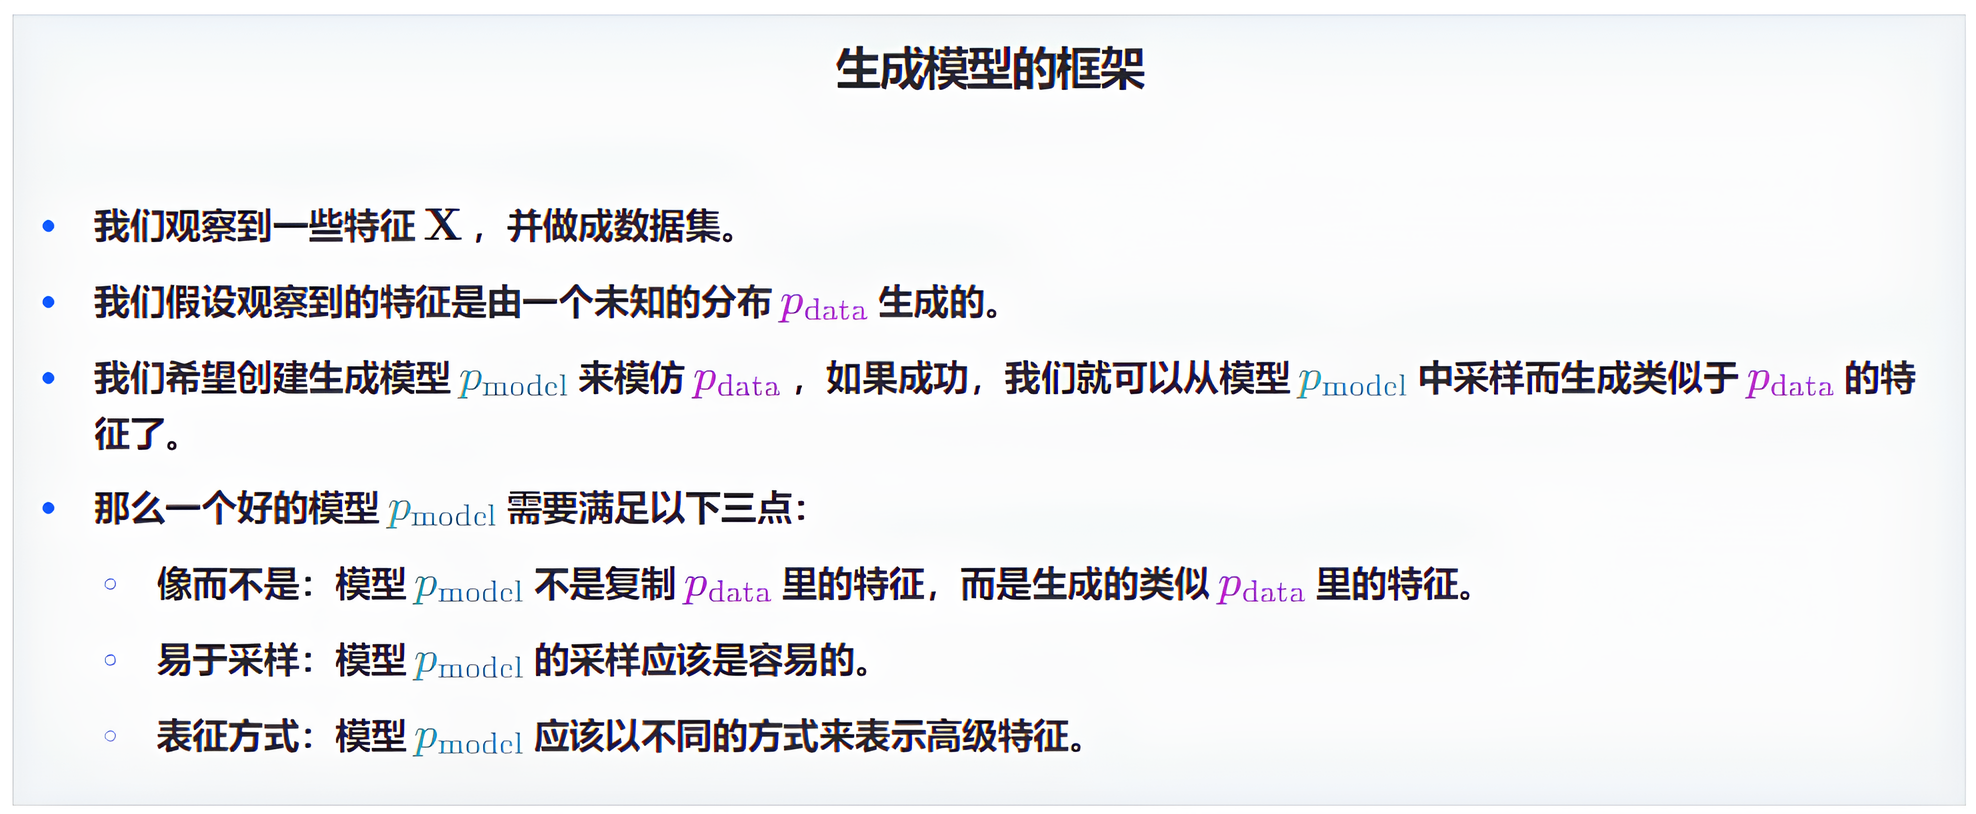
ให้เราเปิดเผยการกระจายการสร้างข้อมูลที่แท้จริงPข้อมูล และดูว่ากรอบงานข้างต้นนำไปใช้กับตัวอย่างนี้อย่างไร จากรูปด้านล่างเราจะเห็นได้ว่ากฎการสร้างข้อมูลPข้อมูลคือจุดต่างๆ มีการกระจายอย่างสม่ำเสมอทั่วพื้นดินและไม่ปรากฏในมหาสมุทร
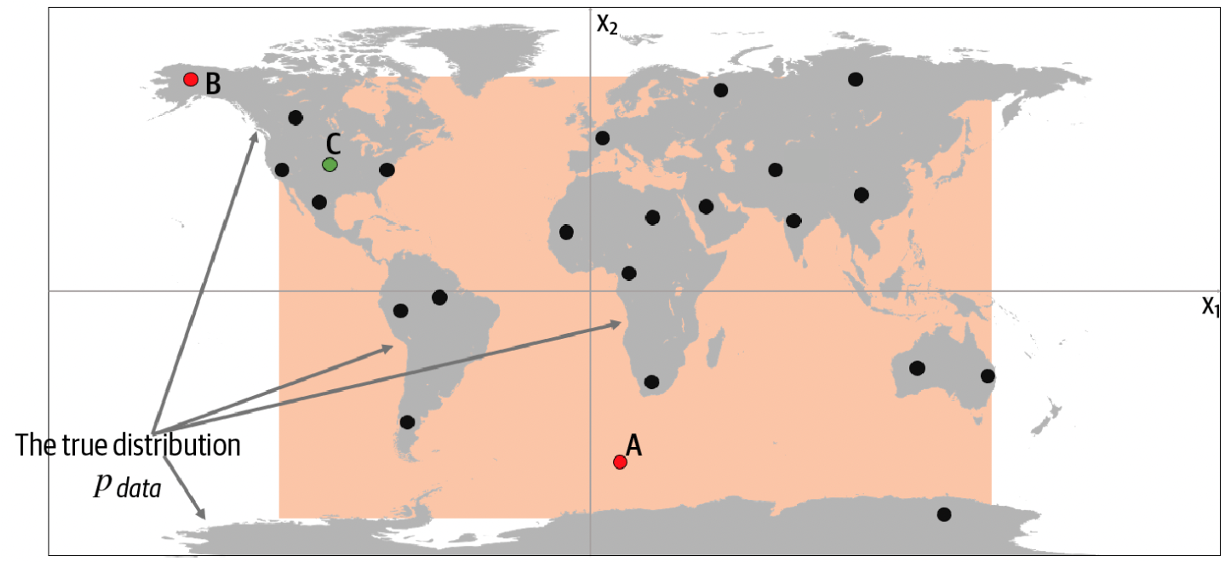
แน่นอนว่าโมเดลของเราPโมเดลเป็นกฎPลดความซับซ้อนของข้อมูล ช่วยให้เราเข้าใจแบบจำลองโดยการตรวจสอบจุด A, B และ C ของแผนภาพด้านบนPไม่ว่าโมเดลจะเลียนแบบกฎได้สำเร็จหรือไม่Pdata。
จุด A ไม่เป็นไปตามกฎ Pข้อมูลตามที่ปรากฏในทะเลแต่อาจถูกกำหนดโดยแบบจำลองPโมเดลจะถูกสร้างขึ้นตามที่ปรากฏภายในกล่องสีส้ม
ไม่สามารถจำลองจุด B ได้Pโมเดลถูกสร้างขึ้นเนื่องจากปรากฏนอกกล่องสีส้ม แต่เป็นไปตามกฎPข้อมูลตามที่ปรากฏบนบก
จุด C ถูกจำลองโดยPโมเดลถูกสร้างขึ้นและเป็นไปตามกฎPdata。
ชื่อระดับแรก
3. รุ่นแรก
สมมติว่าคุณเป็นประธานเจ้าหน้าที่ฝ่ายแฟชั่น (CFO) ของบริษัทแห่งหนึ่ง และงานของคุณคือสร้างสรรค์เสื้อผ้าอินเทรนด์ใหม่ๆ ปีนี้คุณได้รับชุดข้อมูล 50 ชุดเกี่ยวกับการจัดวางแฟชั่น (ดังที่แสดงด้านล่าง) และคุณต้องสร้างชุดข้อมูลแฟชั่นใหม่ 10 ชุด
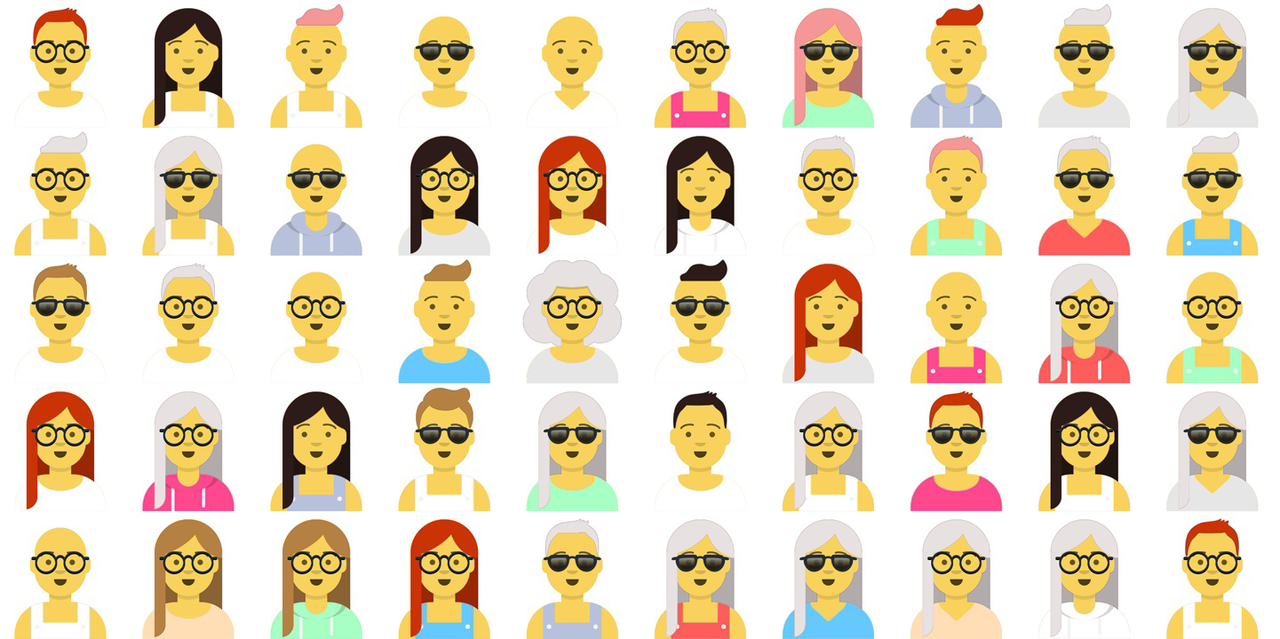
แม้ว่าคุณจะเป็นหัวหน้าเจ้าหน้าที่แฟชั่น แต่คุณก็เป็นนักวิทยาศาสตร์ข้อมูลด้วย ดังนั้นคุณจึงตัดสินใจใช้แบบจำลองเชิงกำเนิดเพื่อแก้ไขปัญหานี้ หลังจากอ่าน 50 รูปภาพข้างต้นแล้ว คุณตัดสินใจใช้คุณสมบัติ 5 ประการประเภทอุปกรณ์เสริม (accessies type)、สีเสื้อผ้า (clothing color)、ประเภทเสื้อผ้า (clothing type)、สีผม(สีผม) และประเภทผม(ประเภทเส้นผม) เพื่ออธิบายการจัดวางแฟชั่น
คุณสมบัติข้อมูลภาพ 10 อันดับแรกมีดังนี้
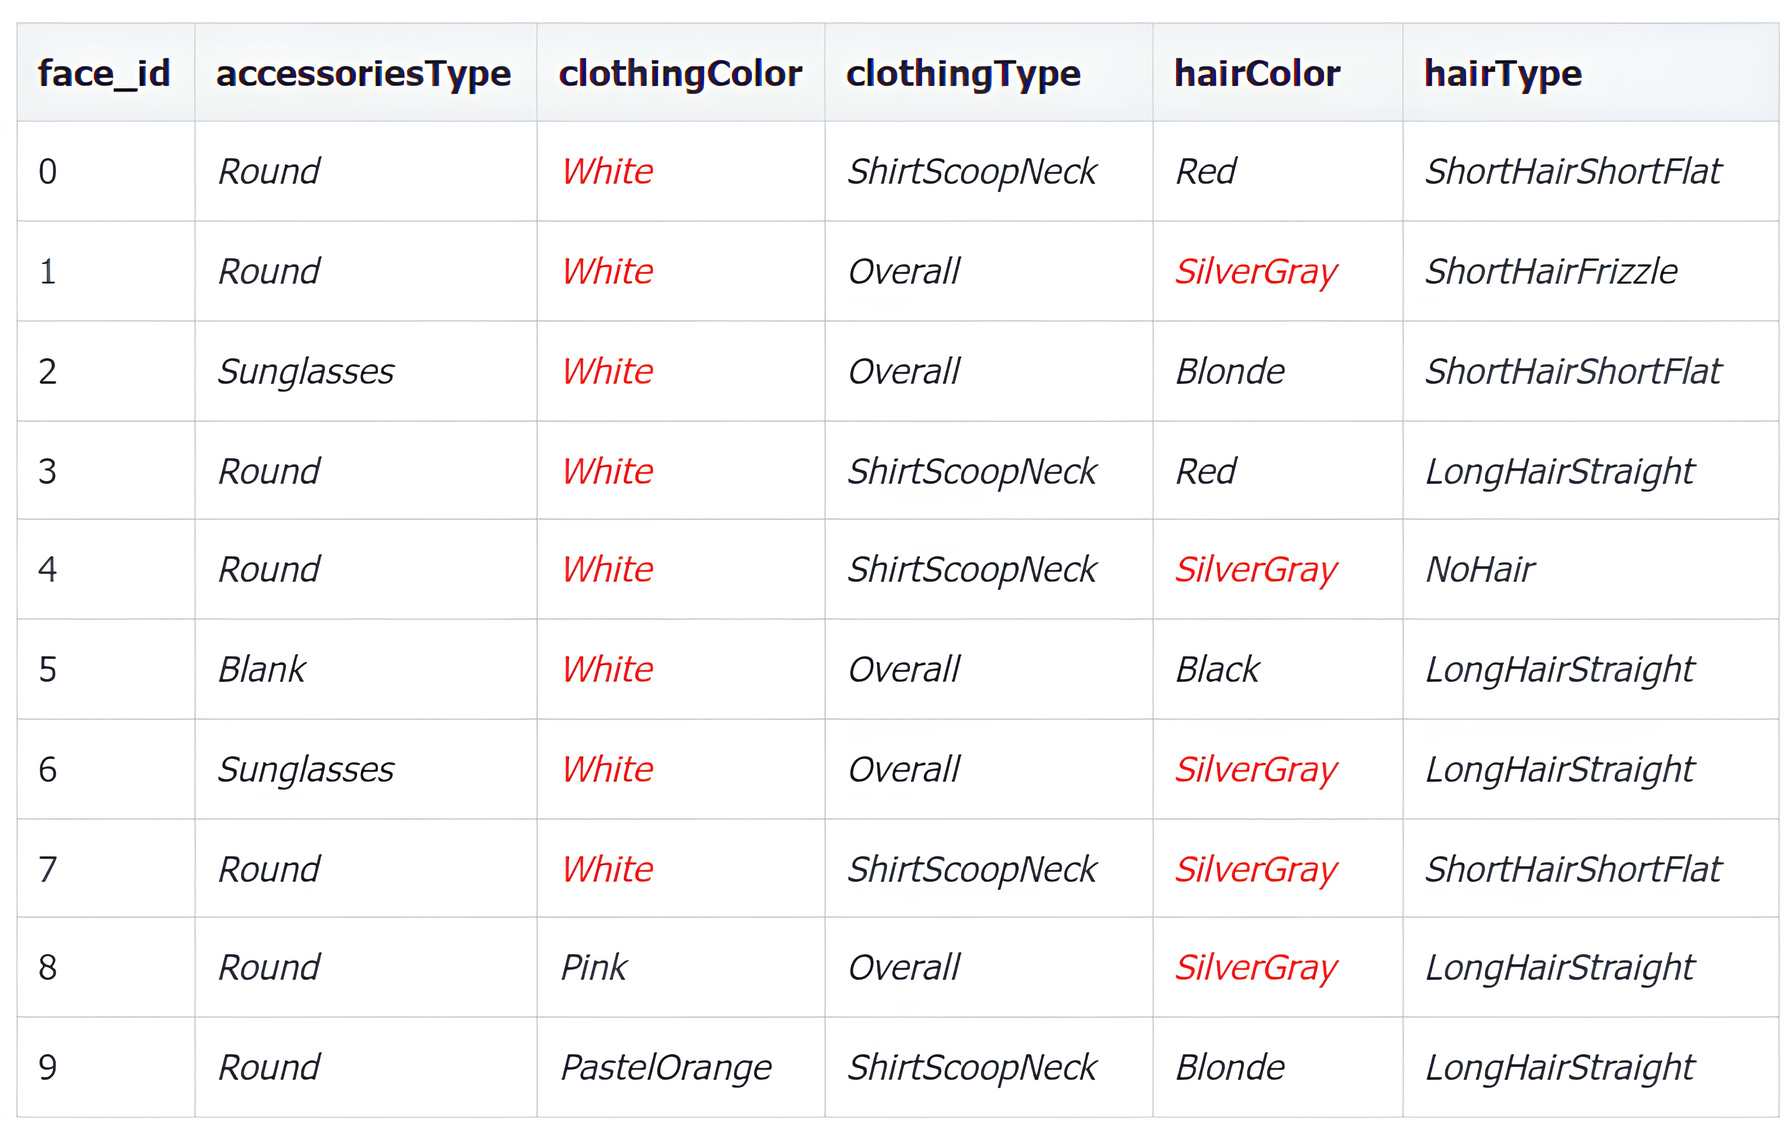
แต่ละฟีเจอร์ยังมีค่าลักษณะเฉพาะที่แตกต่างกันจำนวนหนึ่งด้วย:
อุปกรณ์เสริม 3 ประเภท (ประเภทอุปกรณ์เสริม):
Blank, Round, Sunglasses
8 สีเสื้อผ้า:
Black, Blue 01, Gray 01, PastelGreen, PastelOrange, Pink, Red, White
4 ประเภทเสื้อผ้า:
Hoodie, Overall, ShirtScoopNeck, ShirtVNeck
6 สีผม:
Black, Blonde, Brown, PastelPink, Red, SilverGray
7 ประเภทผม:
NoHair, LongHairBun, LongHairCurly, LongHairStraight, ShortHairShortWaved, ShortHairShortFlat, ShortHairFrizzle
ด้วยวิธีนี้ จะมีชุดคุณลักษณะ 3 * 8 * 4 * 6 * 7 = 4032 ดังนั้นจึงจินตนาการได้ว่าพื้นที่ตัวอย่างมี 4032 จุด จากข้อมูลที่ให้มา 50 จุด จะเห็นได้ว่าPข้อมูลจะชอบค่าคุณสมบัติบางอย่างสำหรับคุณสมบัติที่แตกต่างกัน จากตารางด้านบนจะเห็นได้ว่าในภาพมีสีเสื้อผ้าสีขาวและสีผมสีเทาเงินมากกว่า เพราะเราไม่รู้ความจริงPข้อมูล เราสามารถใช้ข้อมูลเพียง 50 รายการเหล่านี้เพื่อสร้างPรุ่นเพื่อให้สามารถใช้ได้กับPชื่อรอง
3.1 โมเดลมินิมอลลิสต์
วิธีที่ง่ายที่สุดวิธีหนึ่งคือการกำหนดพารามิเตอร์ความน่าจะเป็นให้กับแต่ละจุดในชุดคุณลักษณะ 4032 จากนั้นแบบจำลองจะมีพารามิเตอร์ 4031 เนื่องจากผลรวมของพารามิเตอร์ความน่าจะเป็นทั้งหมดเท่ากับ 1 ตอนนี้เรามาตรวจสอบข้อมูล 50 รายการทีละรายการและอัปเดตพารามิเตอร์ของโมเดล(θ 1 ,θ 2 ,…,θ 4031 )ใน
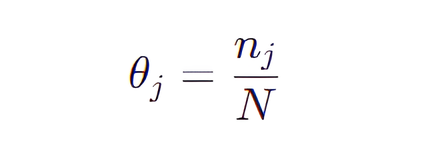
ใน Nคือจำนวนข้อมูลที่สังเกตได้คือ 50njเป็นคนแรกjจำนวนชุดคุณลักษณะที่ปรากฏในข้อมูล 50 รายการ
ตัวอย่างเช่น ชุดค่าผสมคุณสมบัติ (เรียกว่าชุดค่าผสม 1) ของ (LongHairStraight, Red, Round, ShirtScoopNeck, White) จะปรากฏขึ้นสองครั้ง จากนั้น
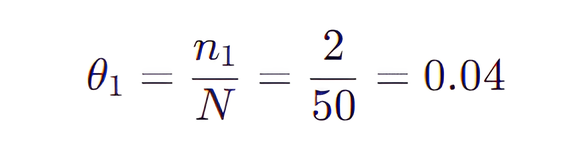
ตัวอย่างเช่น หากชุดค่าผสมของคุณสมบัติ (เรียกว่าชุดค่าผสม 2) ของ (LongHairStraight, Red, Round, ShirtScoopNeck, Blue 01) ไม่ปรากฏขึ้น ดังนั้น
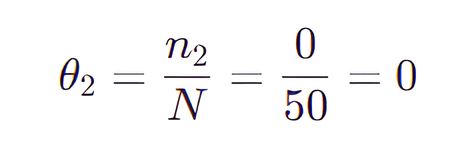
ตามกฎข้างต้น เราจะคำนวณผลรวมของ 4031θคุณค่าก็เห็นได้ไม่ยากว่ามีมากมายθค่าทั้งหมดเป็น 0 และที่แย่กว่านั้นคือเราไม่สามารถสร้างภาพที่มองไม่เห็นใหม่ได้ (θ= 0 หมายถึงไม่เคยพบภาพที่มีลักษณะผสมผสานกัน) ในการแก้ไขปัญหานี้ เพียงเพิ่มจำนวนคุณลักษณะทั้งหมด d ให้กับตัวส่วน และ 1 ให้กับตัวเศษ ซึ่งเป็นเทคนิคที่เรียกว่า Laplace Smoothing
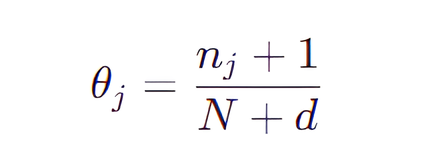
ตอนนี้ ทุกชุดค่าผสม (รวมถึงชุดที่ไม่ได้อยู่ในชุดข้อมูลดั้งเดิม) มีความน่าจะเป็นของการสุ่มตัวอย่างที่ไม่เป็นศูนย์ อย่างไรก็ตาม นี่ก็ยังไม่ใช่แบบจำลองกำเนิดที่น่าพอใจ เนื่องจากความน่าจะเป็นของจุดที่ไม่ได้อยู่ในชุดข้อมูลดั้งเดิมนั้นเป็นค่าคงที่ หากเราพยายามใช้แบบจำลองดังกล่าวเพื่อสร้างภาพวาดของแวนโก๊ะ มันจะทำงานกับภาพวาดสองภาพต่อไปนี้ด้วยความน่าจะเป็นที่เท่ากัน:
การทำซ้ำภาพวาดต้นฉบับของแวนโก๊ะ (ไม่ใช่ในชุดข้อมูลดั้งเดิม)
ภาพวาดที่ทำจากพิกเซลสุ่ม (ไม่ใช่ในชุดข้อมูลดั้งเดิม)
ชื่อรอง
3.2 โมเดลย่อยง่าย
โมเดล Naive Bayes (Naive Bayes) สามารถลดจำนวนการรวมกันของคุณสมบัติข้างต้นได้อย่างมาก และตามรุ่นของมัน แต่ละคุณสมบัติจะถือว่าเป็นอิสระจากกัน กลับมาที่ข้อมูลข้างต้น สีผมของบุคคล (ฟีเจอร์xj) และสีเสื้อผ้า (ลักษณะ xk ) ไม่มีการเชื่อมต่อ ซึ่งแสดงในนิพจน์ทางคณิตศาสตร์คือ:
p(xj | xk) = p(xk)
ด้วยสมมติฐานนี้ เราสามารถคำนวณได้
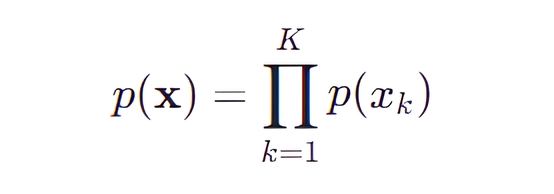
โมเดล Naive Bayesian ช่วยลดความซับซ้อนของปัญหาเดิม การประมาณความน่าจะเป็นสำหรับการรวมคุณลักษณะแต่ละรายการ เป็น การประมาณความน่าจะเป็นสำหรับแต่ละคุณลักษณะ เดิมที เราจำเป็นต้องใช้พารามิเตอร์ 4031 ( 3 * 8 * 4 * 6 * 7) ขณะนี้มีเพียง 23 ( 3 ต้องใช้พารามิเตอร์ + 8 + 4 + 6 + 7) และนิพจน์ของแต่ละพารามิเตอร์คือ:
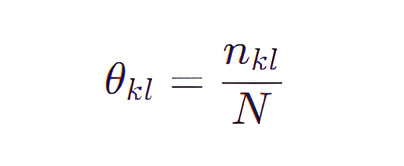
โดยที่ N คือจำนวนข้อมูลที่สังเกตได้คือ 50nkl เป็นคนแรก kคุณสมบัติถัดไปl จำนวนค่าลักษณะเฉพาะ
จากสถิติของข้อมูล 50 รายการ ตารางต่อไปนี้ให้ค่าพารามิเตอร์ของแบบจำลอง Naive Bayesian
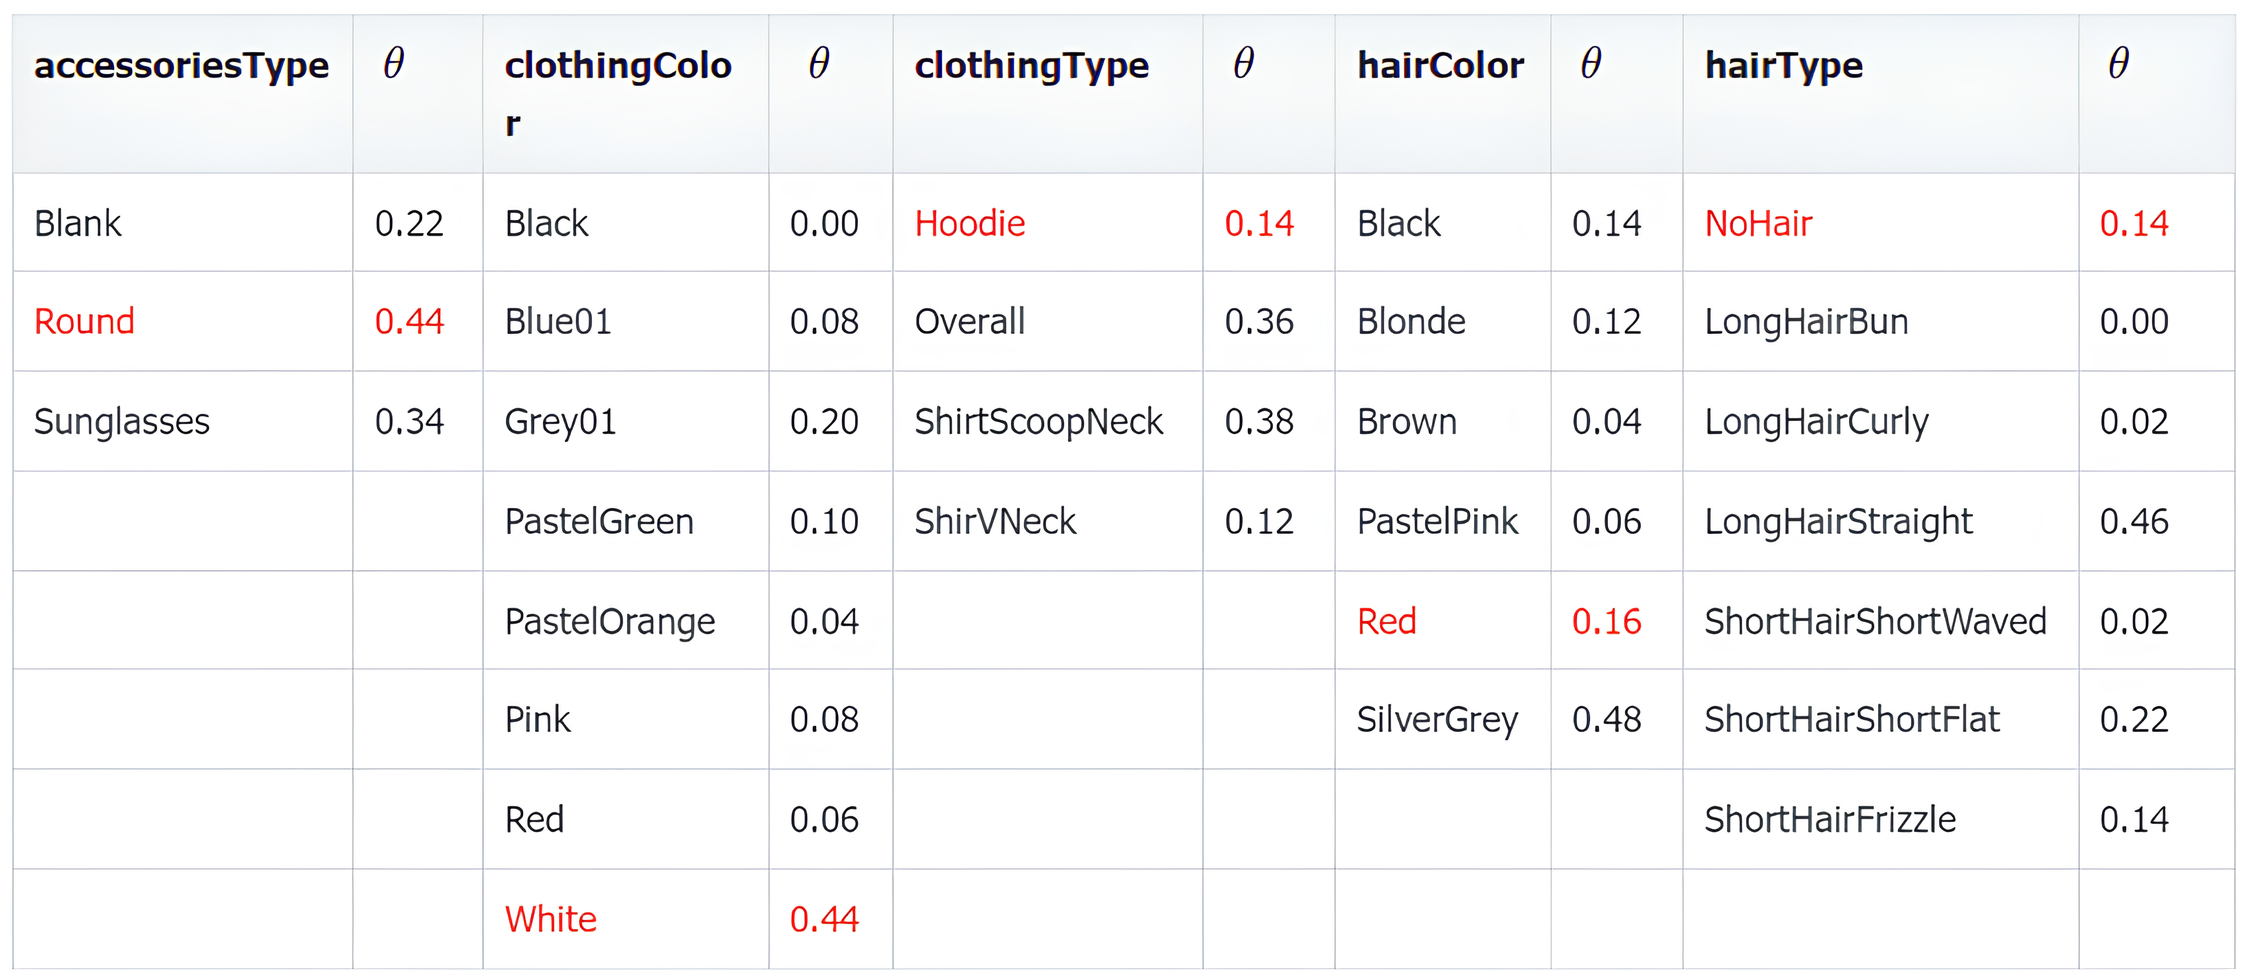
หากต้องการคำนวณความน่าจะเป็นของแบบจำลองที่สร้างคุณลักษณะข้อมูล เพียงคูณความน่าจะเป็นในตารางด้านบน เช่น
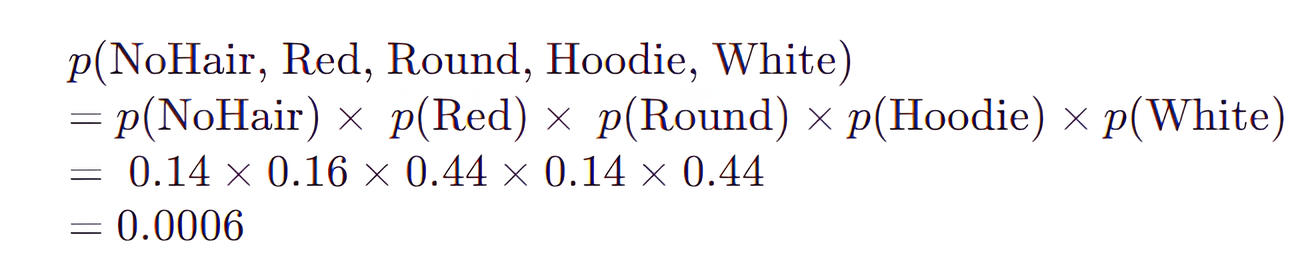
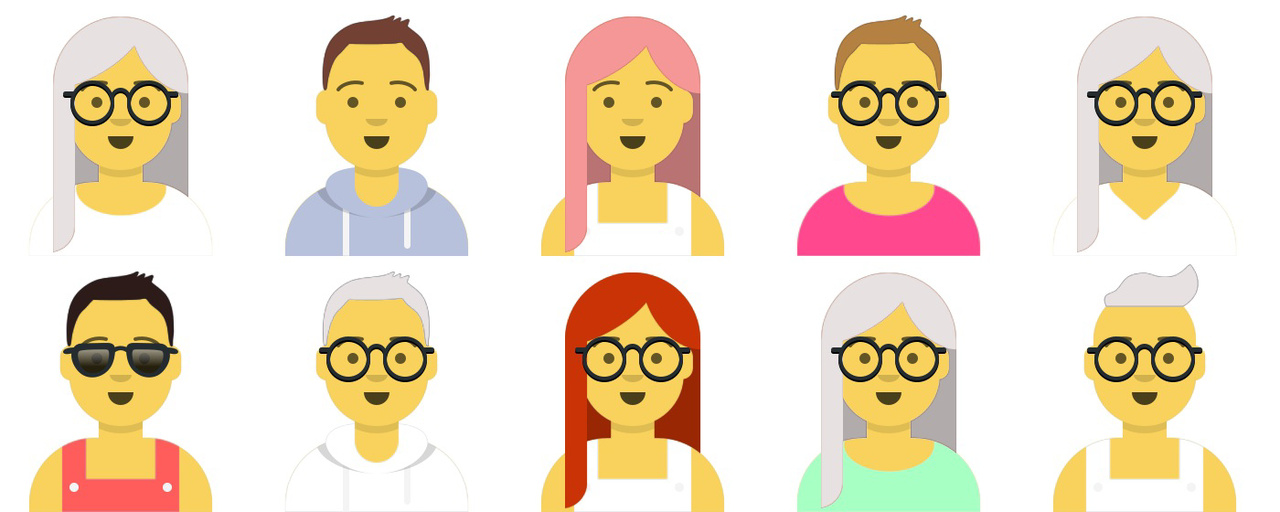
การรวมกันข้างต้นไม่ปรากฏในชุดข้อมูลดั้งเดิม แต่โมเดลยังคงกำหนดความน่าจะเป็นที่ไม่เป็นศูนย์ ดังนั้นจึงยังคงสามารถสร้างโมเดลได้ ดังนั้น โมเดล Naive Bayesian จึงสามารถเรียนรู้โครงสร้างบางอย่างจากข้อมูล และใช้มันเพื่อสร้างตัวอย่างใหม่ที่ไม่เห็นในชุดข้อมูลดั้งเดิม ภาพด้านล่างเป็นภาพการจัดวางแฟชั่นใหม่ 10 รูปแบบที่สร้างโดยนางแบบ
ชื่อระดับแรก
ชื่อรอง
4.1 ข้อมูลมิติสูง
คุณได้สร้างคอลโลเคชั่นแฟชั่นใหม่ 10 รายการด้วย Naive Bayesian ได้สำเร็จ คุณมั่นใจมากว่าโมเดลของคุณจะอยู่ยงคงกระพันจนกว่าคุณจะพบชุดข้อมูลต่อไปนี้
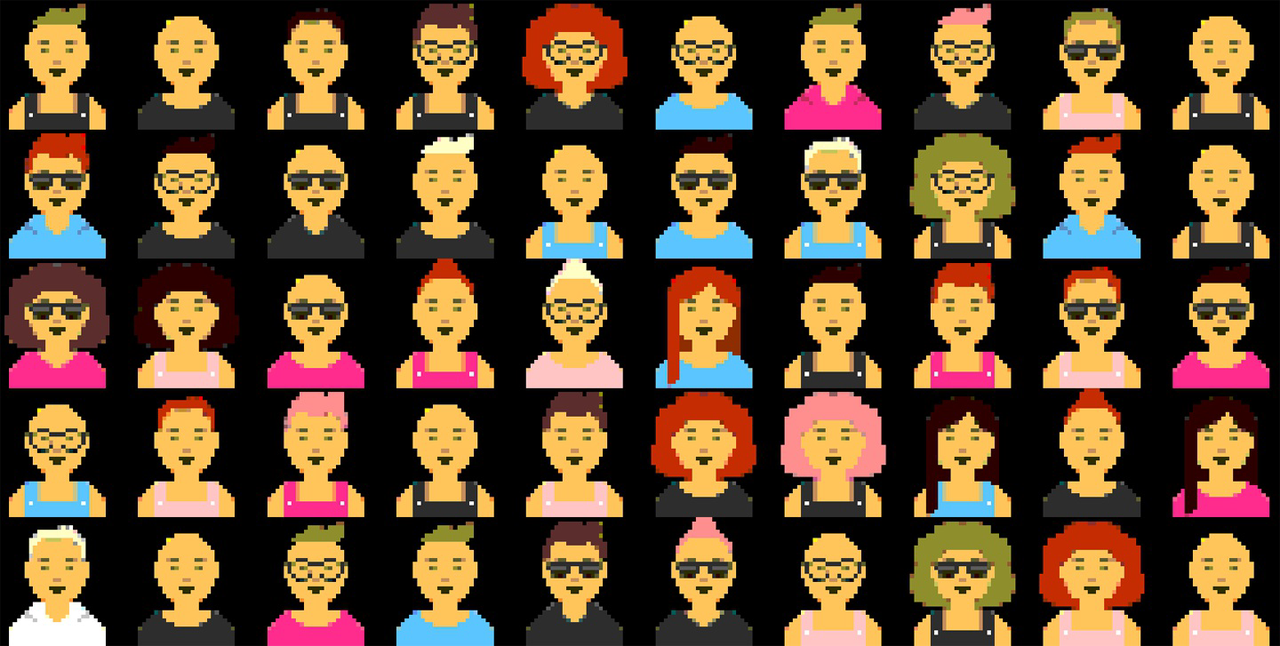
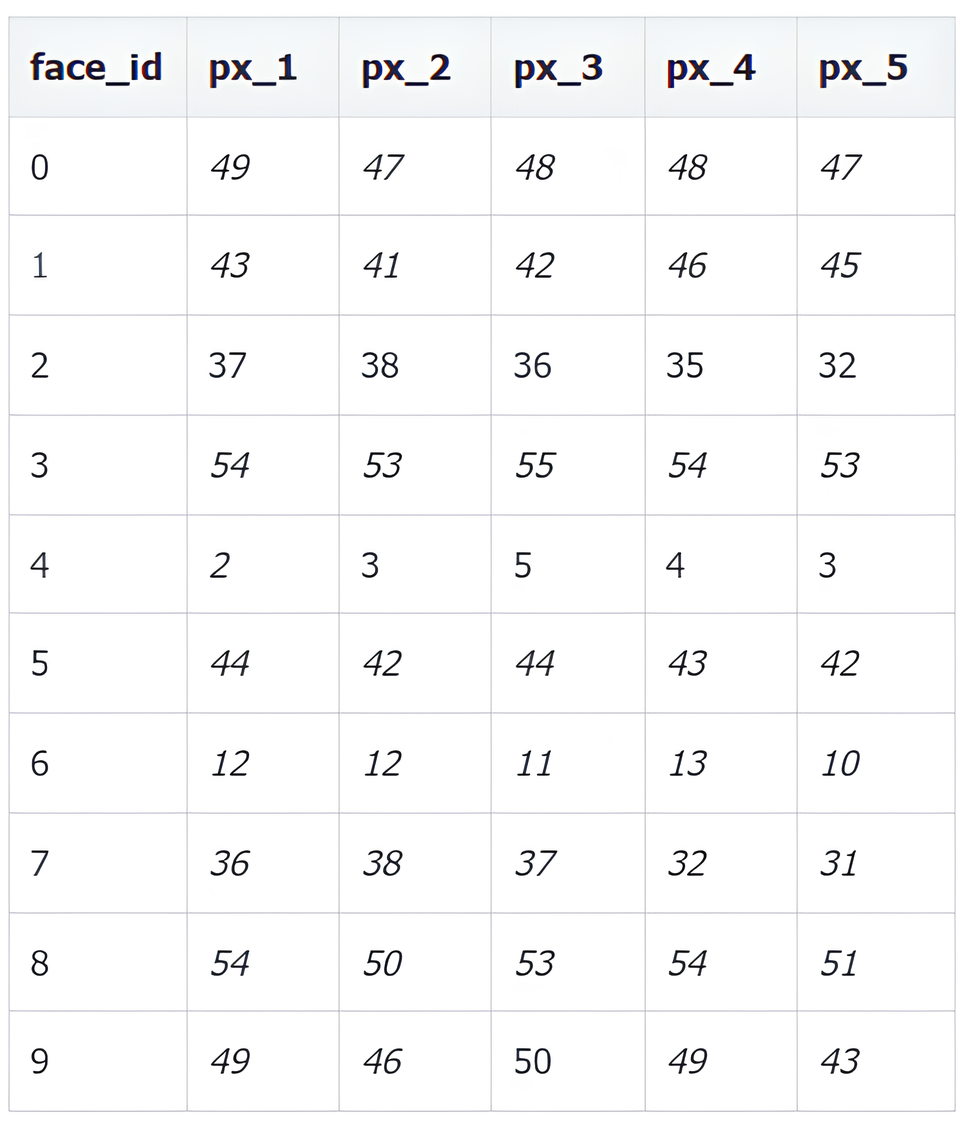
ชุดข้อมูลไม่ได้แสดงด้วยคุณสมบัติห้าประการอีกต่อไป แต่แสดงด้วย 32* 32 = 1,024 พิกเซล แต่ละค่าพิกเซลสามารถเป็นหนึ่งใน 0 ถึง 255 0 หมายถึงสีขาว และ 255 หมายถึงสีดำ ตารางต่อไปนี้แสดงค่าพิกเซล 1 ถึง 5 สำหรับ 10 ภาพแรก
ใช้โมเดลเดียวกันเพื่อสร้างคอลโลเคชั่นแฟชั่นใหม่เอี่ยม 10 ชุด ต่อไปนี้เป็นผลจากการสร้างโมเดล แต่ละแบบน่าเกลียดและคล้ายกัน และคุณสมบัติที่แตกต่างกันไม่สามารถแยกแยะได้ ทำไมจึงเป็นเช่นนี้
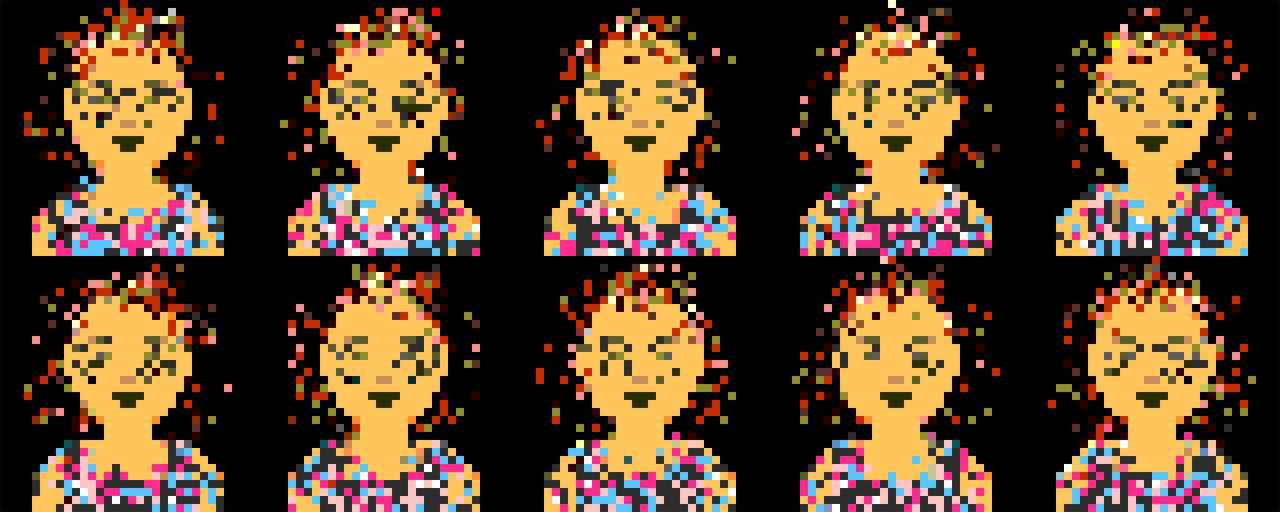
ประการแรก เนื่องจากโมเดล Naive Bayesian เก็บตัวอย่างพิกเซลอย่างอิสระ พิกเซลที่อยู่ติดกันจึงมีความคล้ายคลึงกันมาก สำหรับเสื้อผ้า จริงๆ แล้วพิกเซลควรจะใกล้เคียงกัน แต่โมเดลนั้นสุ่มตัวอย่าง ดังนั้นเสื้อผ้าในภาพด้านบนจึงมีสีสันสดใสทั้งหมด ประการที่สอง มีความเป็นไปได้มากเกินไปในพื้นที่ตัวอย่างที่มีมิติสูง ซึ่งมีเพียงส่วนน้อยเท่านั้นที่สามารถระบุได้ หากโมเดล Naive Bayesian เกี่ยวข้องโดยตรงกับค่าพิกเซลที่มีความสัมพันธ์กันสูง โอกาสที่จะพบค่าผสมที่น่าพอใจนั้นมีน้อยมาก
โดยสรุป สำหรับพื้นที่ตัวอย่างที่มีขนาดต่ำและมีความสัมพันธ์กันของคุณสมบัติต่ำ เอฟเฟกต์ Naive Bayesian นั้นดีมากผ่านการสุ่มตัวอย่างแบบอิสระ แต่สำหรับพื้นที่ตัวอย่างที่มีขนาดสูงและมีความสัมพันธ์กันสูงของคุณสมบัตินั้น พิกเซลการสุ่มตัวอย่างอิสระจะถูกใช้เพื่อค้นหาใบหน้ามนุษย์ที่มีประสิทธิภาพ แทบจะเป็นไปไม่ได้เลย
ตัวอย่างนี้เน้นถึงความยากลำบากสองประการที่โมเดลเชิงกำเนิดต้องเอาชนะเพื่อที่จะประสบความสำเร็จ:
โมเดลจัดการกับการขึ้นต่อกันแบบมีเงื่อนไขระหว่างฟีเจอร์มิติสูงอย่างไร
แบบจำลองค้นหาสัดส่วนการสังเกตที่น้อยมากซึ่งเป็นไปตามเงื่อนไขในพื้นที่ตัวอย่างที่มีมิติสูงได้อย่างไร
เพื่อให้โมเดลกำเนิดประสบความสำเร็จในพื้นที่ตัวอย่างมิติสูงและมีความสัมพันธ์กันสูง ต้องใช้โมเดลการเรียนรู้เชิงลึก เราต้องการแบบจำลองที่สามารถอนุมานโครงสร้างที่เกี่ยวข้องจากข้อมูล แทนที่จะบอกว่าควรตั้งสมมติฐานใดไว้ล่วงหน้า การเรียนรู้เชิงลึกสามารถสร้างคุณลักษณะของตัวเองในพื้นที่มิติต่ำได้ และนี่คือการเรียนรู้การเป็นตัวแทนชื่อรอง
4.2 การเรียนรู้การเป็นตัวแทน
การเรียนรู้การเป็นตัวแทนคือการเรียนรู้ความหมายของการเป็นตัวแทนของข้อมูลมิติสูง
สมมติว่าคุณไปเจอชาวเน็ตที่ไม่เคยเจอและมีคนจำนวนมากที่ไม่พบเธอที่จุดนัดพบคุณจึงโทรหาเธอเพื่ออธิบายรูปลักษณ์ของคุณ ฉันเชื่อว่าคุณจะไม่พูดว่าสีของพิกเซล 1 ในภาพของคุณเป็นสีดำ สีของพิกเซล 2 เป็นสีดำอ่อน สีของพิกเซล 3 เป็นสีเทา และอื่นๆ ในทางตรงกันข้ามคุณคงคิดว่าชาวเน็ตคงมีความเข้าใจโดยทั่วไปเกี่ยวกับรูปร่างหน้าตาของคนทั่วไปแล้วจึงให้ความเข้าใจนี้เพื่ออธิบายลักษณะเฉพาะของกลุ่มพิกเซล เช่น คุณผมสั้นสีดำสวย ใส่ชุด แก้วทองและอื่นๆ โดยปกติแล้วคำอธิบายดังกล่าวจะไม่เกิน 10 คำ ชาวเน็ตสามารถสร้างภาพของคุณจากใจได้ ภาพอาจจะหยาบ แต่ก็ไม่ได้ขัดขวางไม่ให้ชาวเน็ตค้นพบคุณท่ามกลางคนหลายร้อยคนแม้ว่าเธอจะไม่เคยเห็นคุณก็ตาม
นี่คือแนวคิดหลักเบื้องหลังการเรียนรู้แบบเป็นตัวแทน โดยไม่ต้องพยายามโดยตรงพื้นที่ตัวอย่างมิติสูง(พื้นที่ตัวอย่างมิติสูง) สำหรับการสร้างแบบจำลองแต่ใช้บางส่วนพื้นที่แฝงในมิติต่ำ(พื้นที่แฝงในมิติต่ำ) เพื่ออธิบายแต่ละข้อสังเกตในชุดฝึกแล้วเรียนรู้ กฟังก์ชั่นการทำแผนที่(ฟังก์ชันการทำแผนที่) ซึ่งรับจุดในพื้นที่แฝงและแมปกับพื้นที่ตัวอย่างดั้งเดิม กล่าวอีกนัยหนึ่ง แต่ละจุดในพื้นที่แฝงแสดงถึงคุณลักษณะของข้อมูลมิติสูง
หากคำข้างต้นเข้าใจได้ไม่ง่าย โปรดดูชุดฝึกด้านล่างที่ประกอบด้วยภาพขวดโทนสีเทา
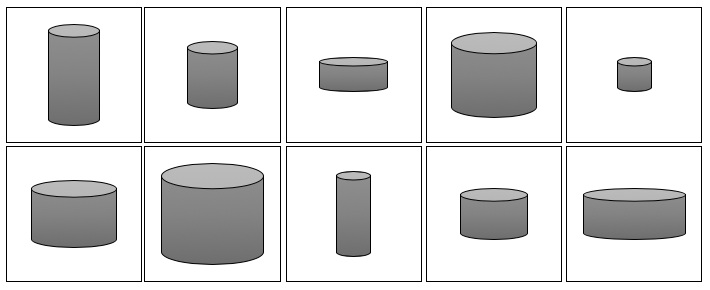
ไม่ใช่เรื่องยากที่จะเห็นว่าขวดโหลเหล่านี้สามารถอธิบายได้เพียงสองลักษณะเท่านั้น คือ ความสูงและความกว้าง ดังนั้นเราจึงสามารถแปลงพื้นที่พิกเซลมิติสูงของรูปภาพให้เป็นพื้นที่แฝงสองมิติได้ ดังแสดงในรูปด้านล่าง วิธีนี้ทำให้เราสามารถเก็บตัวอย่างจากพื้นที่แฝง (จุดสีน้ำเงิน) แล้วส่งผ่านฟังก์ชันการทำแผนที่fแปลงให้เป็นรูปภาพ
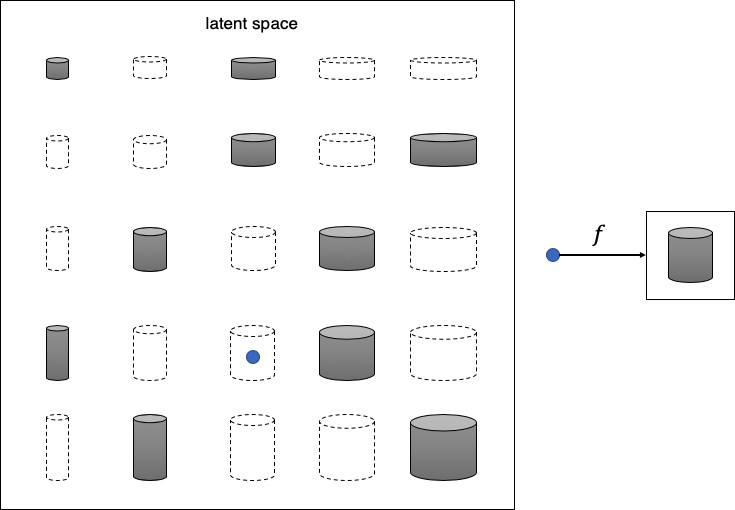
ไม่ใช่เรื่องง่ายสำหรับเครื่องที่จะตระหนักว่าชุดข้อมูลดั้งเดิมสามารถแสดงได้ด้วยพื้นที่แฝงที่ง่ายกว่า ขั้นแรก เครื่องจำเป็นต้องพิจารณาว่าความสูงและความกว้างเป็นมิติพื้นที่แฝงสองมิติที่อธิบายชุดข้อมูลได้ดีที่สุด จากนั้นจึงเรียนรู้ ฟังก์ชั่นการทำแผนที่f ชื่อระดับแรก
5. การจำแนกประเภทของแบบจำลองกำเนิด
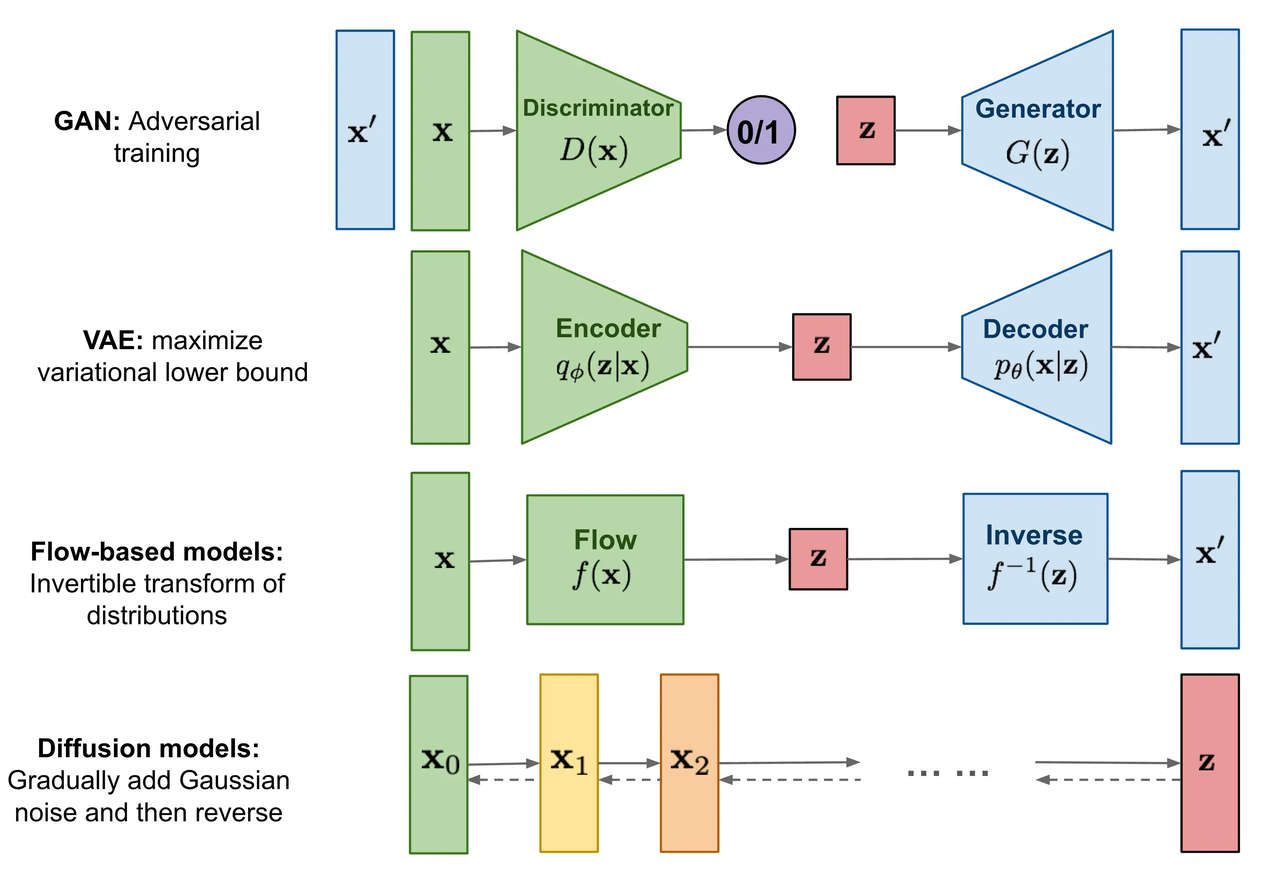
แบบจำลองกำเนิดทุกประเภทมีเป้าหมายที่จะแก้ปัญหางานเดียวกันในท้ายที่สุด แต่ความหนาแน่นของแบบจำลองทั้งหมดทำงานในลักษณะที่แตกต่างกันเล็กน้อย และโดยทั่วไปจะแบ่งออกเป็นสองประเภท:
ฟังก์ชันความหนาแน่นของคู่การสร้างแบบจำลองที่ชัดเจน(explicitly modeling),
แต่อย่างใดก็จำกัดแบบจำลองเพื่อคำนวณฟังก์ชันความหนาแน่นเช่นโมเดลโฟลว์ที่ทำให้เป็นมาตรฐาน(normalizing FLOW model)
แต่จะประมาณฟังก์ชันความหนาแน่นเช่นตัวเข้ารหัสอัตโนมัติแบบต่างๆ (variational autoencoder,วีเออี) และรูปแบบการแพร่กระจาย (diffusion model)
ฟังก์ชันความหนาแน่นของคู่การสร้างแบบจำลองโดยนัย(การสร้างแบบจำลองโดยนัย) ผ่านกระบวนการสุ่มที่สร้างข้อมูลโดยตรง ตัวอย่างเช่นสรุป (generative adversarial network, GAN)
สรุป
ปัญญาประดิษฐ์เจเนอเรทีฟ (GenAI) คือปัญญาประดิษฐ์ประเภทหนึ่งที่สามารถใช้เพื่อสร้างเนื้อหาและแนวคิดใหม่ๆ รวมถึงข้อความ รูปภาพ วิดีโอ และเพลง เช่นเดียวกับปัญญาประดิษฐ์อื่นๆ GenAI เป็นโมเดลขนาดใหญ่มากที่ได้รับการฝึกอบรมล่วงหน้าโดยโมเดลการเรียนรู้เชิงลึกโดยอิงจากข้อมูลจำนวนมาก ซึ่งมักเรียกกันว่าโมเดลพื้นฐาน(foundation model,เอฟเอ็ม) ด้วย GenAI เราสามารถวาดภาพเจ๋งๆ ได้มากขึ้น เขียนข้อความที่สวยงามยิ่งขึ้น และแต่งเพลงที่ไพเราะมากขึ้น แต่ขั้นตอนแรกต้องการให้เราเข้าใจว่า GenAI สร้างสิ่งใหม่ได้อย่างไร ดังที่หัวหน้าบทความ Richard Feynman กล่าวว่า ฉันจะไม่เข้าใจ สิ่งที่ฉันไม่สามารถสร้างได้





