


SignalPlus: พูดคุยเกี่ยวกับ Deep Neural Networks


คำนำ
Deep neural networks are completely flexible by design, and there really are no fixed rules when it comes to model architecture.
-- David Foster
คำนำ
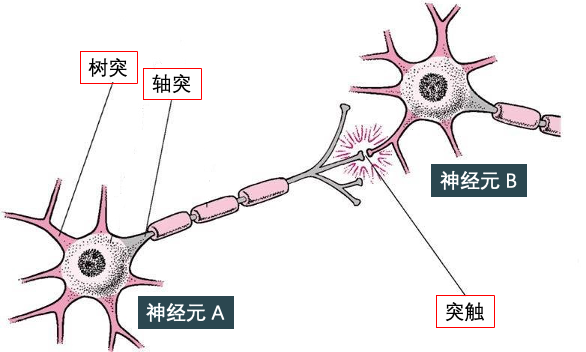
โครงข่ายประสาทเทียม(โครงข่ายประสาทเทียม) แรงบันดาลใจจากสมองของมนุษย์สามารถเลียนแบบเซลล์ประสาทชีวภาพเพื่อส่งสัญญาณถึงกัน โครงข่ายประสาทเทียมคือระบบที่ประกอบด้วยเซลล์ประสาท ดังแสดงในรูปด้านล่าง เซลล์ประสาทมีหลายเซลล์เดนไดรต์(dendrite) สำหรับการป้อนข้อมูลจะมีแอกซอน(แอกซอน) สำหรับเอาต์พุต มีคุณสมบัติหลักสองประการ: ความตื่นเต้นง่ายและการนำไฟฟ้า:
ความตื่นเต้นง่ายหมายความว่า เมื่อความเข้มข้นของการกระตุ้นไม่ถึงเกณฑ์ที่กำหนด แรงกระตุ้นของเส้นประสาทจะไม่เกิดขึ้น และเมื่อความเข้มข้นของการกระตุ้นถึงค่านี้ แรงกระตุ้นของเส้นประสาทจะเกิดขึ้นและสามารถเข้าถึงความเข้มข้นสูงสุดได้ทันที
สภาพนำไฟฟ้าหมายถึงการนำเซลล์ประสาทที่อยู่ติดกันผ่านช่องว่างเล็กๆ ระหว่างเซลล์เหล่านั้น ช่องว่างเล็กๆนี้เรียกว่าไซแนปส์(ไซแนปส์) หน้าที่ของมันคือการส่งกระแสประสาทระหว่างเซลล์ประสาทต่างๆ และไซแนปส์ในรูปด้านล่างเชื่อมต่อเซลล์ประสาท A และ B เข้าด้วยกัน
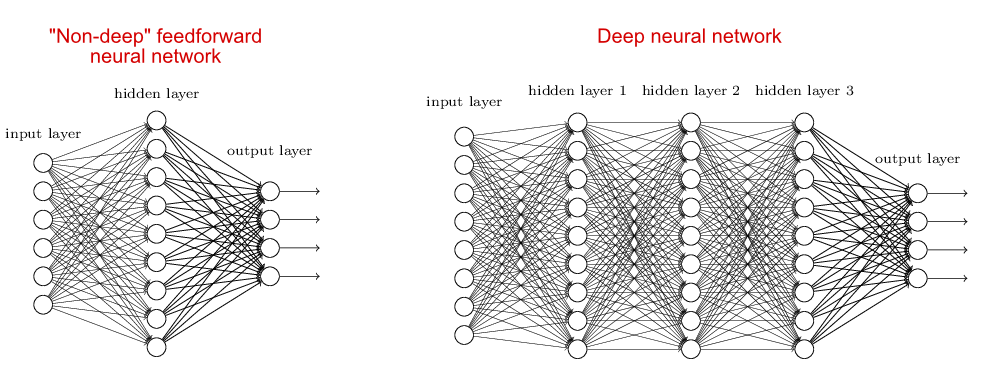
ลองนึกภาพว่าไซแนปส์จำนวนมากเชื่อมต่อเซลล์ประสาทจำนวนมาก มันไม่ได้สร้างโครงข่ายประสาทเทียมใช่ไหม ใช่เปรียบเทียบกับโครงข่ายประสาทเทียม (artificial neural network,ANN) ยังประกอบด้วยเซลล์ประสาทเทียมจำนวนนับไม่ถ้วน เช่นเซลล์ทางด้านซ้ายด้านล่างโครงข่ายประสาทเทียมแบบตื้น(โครงข่ายประสาทเทียมเงา) และโครงข่ายประสาทเทียมเชิงลึก (โครงข่ายประสาทเทียมเชิงลึก) ทางด้านขวาด้านล่าง
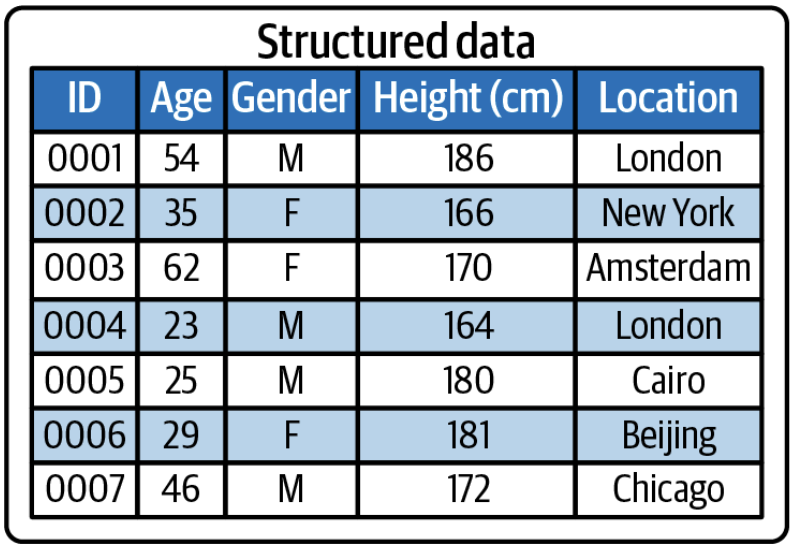
โครงข่ายประสาทตื้นเหมาะสำหรับข้อมูลที่มีโครงสร้าง(ข้อมูลที่มีโครงสร้าง) เช่น ข้อมูลสองมิติที่จัดเก็บไว้ใน Excel ดังรูปด้านล่าง
 Deep Neural Networks เหมาะสำหรับข้อมูลที่ไม่มีโครงสร้าง(ข้อมูลที่ไม่มีโครงสร้าง) เช่น ข้อมูลรูปภาพ ข้อความ และเสียง ดังแสดงในรูปด้านล่าง
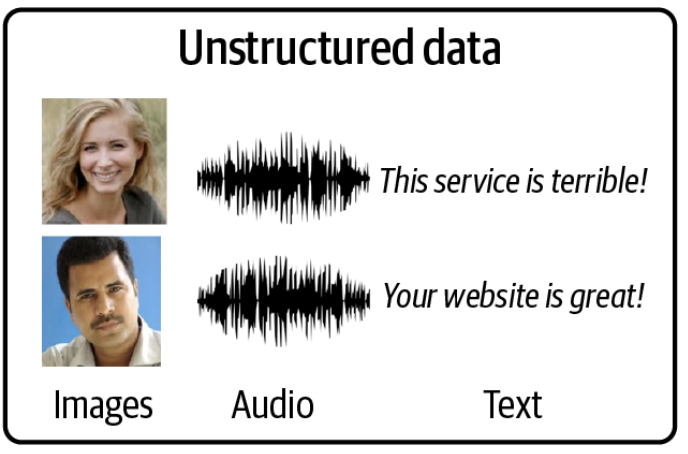
โมเดล AI ทั่วไปจะสร้างข้อมูลที่ไม่มีโครงสร้างเป็นหลัก ดังนั้นการทำความเข้าใจโครงข่ายประสาทเทียมเชิงลึกจึงมีความจำเป็น เริ่มต้นจากบทความนี้เราจะบินโมเดลและโค้ดเพราะว่า
Talk is cheap. Show me the code.
-- Linus Torvalds
ชื่อระดับแรก
ชื่อรอง
1.1 ดูโครงข่ายประสาทเทียมก่อน
สมมติว่าโครงข่ายประสาทเทียมต่อไปนี้ได้รับการฝึกฝนแล้วใช้เพื่อคาดเดาว่ารูปภาพมีใบหน้าที่ยิ้มแย้มหรือไม่
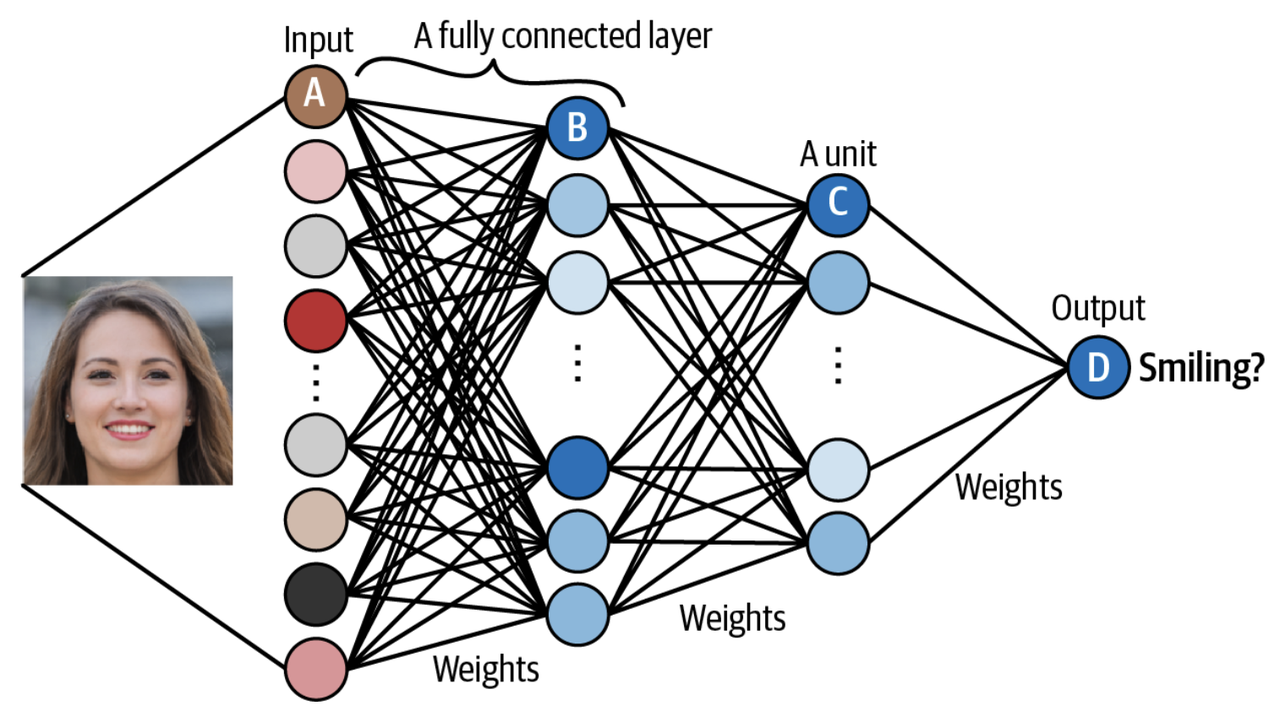
หน่วย A รับข้อมูลพิกเซลในภาพ
หน่วย B รวมพิกเซลอินพุต เมื่อรูปภาพต้นฉบับมีคุณสมบัติระดับต่ำ(ฟีเจอร์ระดับต่ำ) เช่น เมื่อขอบ (edge) สัญญาณที่แรงที่สุดจะถูกปล่อยออกมา
หน่วย C รวมคุณสมบัติระดับต่ำเมื่อมีคุณสมบัติขั้นสูง(คุณสมบัติระดับสูง) เช่น ฟัน (ทีช) โดยสัญญาณที่แรงที่สุดจะถูกปล่อยออกมา
หน่วย D รวมคุณสมบัติระดับสูงที่ให้สัญญาณที่แรงที่สุดเมื่อบุคคลในภาพต้นฉบับยิ้ม
เมื่อโครงข่ายประสาทเทียมนี้ ได้รับ ข้อมูลเพียงพอ เช่น รูปภาพ ก็จะ ค้นหา ชุดของตุ้มน้ำหนัก(น้ำหนัก) เพื่อให้การทำนายขั้นสุดท้ายแม่นยำที่สุด กระบวนการค้นหาตุ้มน้ำหนักคือการฝึกโครงข่ายประสาทเทียมจริงๆ
ชื่อรอง
1.2 กระบวนการฝึกอบรม Keras
แบบอย่าง
แบบอย่าง (models)
ชั้น (layers),เข้า(อินพุต) และเอาท์พุท (output)
เครื่องมือเพิ่มประสิทธิภาพ(เครื่องมือเพิ่มประสิทธิภาพ) และฟังก์ชั่นการสูญเสีย (loss)
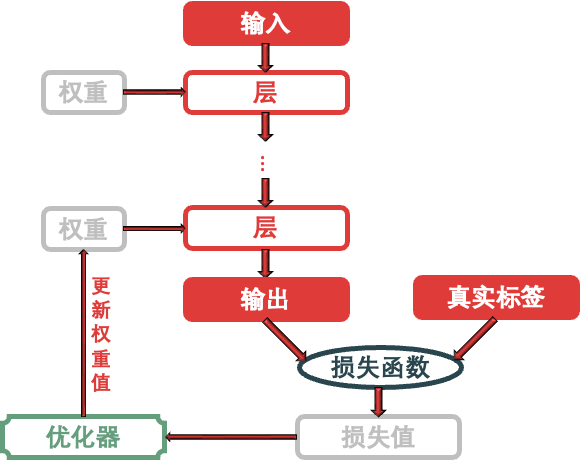
ใช้คำหลักข้างต้นเพื่อสรุปกระบวนการของโครงข่ายประสาทเทียมการฝึกอบรม Keras: รวมหลายรายการชั้นแบบอย่างแบบอย่าง,จะเข้าข้อมูลถูกแมปกับค่าที่คาดการณ์ไว้ แล้วฟังก์ชั่นการสูญเสียนำค่าที่ทำนายไว้เหล่านี้เอาท์พุทและเปรียบเทียบกับเป้าหมายเพื่อให้ได้ค่าการสูญเสีย (ใช้เพื่อวัดว่าค่าที่คาดการณ์ของเครือข่ายตรงกับผลลัพธ์ที่คาดหวังได้ดีเพียงใด)เครื่องมือเพิ่มประสิทธิภาพใช้ค่าที่สูญเสียนี้เพื่ออัปเดตน้ำหนักของเครือข่าย
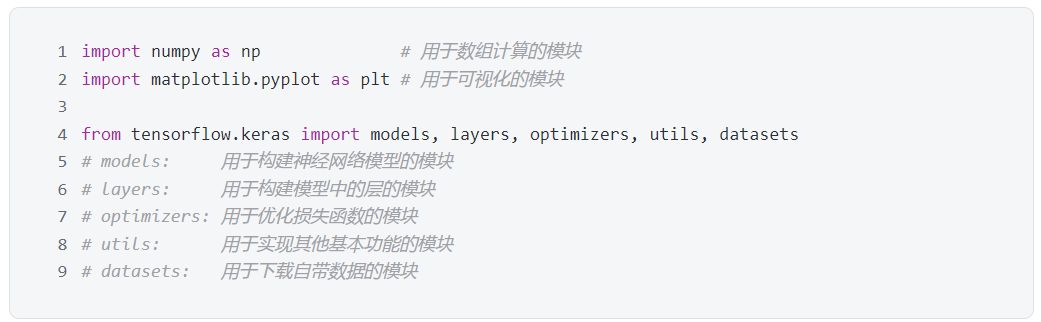
ณ จุดนี้ ในที่สุดก็เป็นไปได้ที่จะแสดงโค้ดบางส่วนได้ แม้ว่าจะมีการแนะนำไลบรารีเครื่องมือก็ตาม ขั้นแรก โมดูลที่ใช้สร้างโครงข่ายประสาทเทียมจากไลบรารี tensorflow.keras
ชื่อรอง
1.3 โครงข่ายประสาทเทียมแบบมินิมัลลิสต์
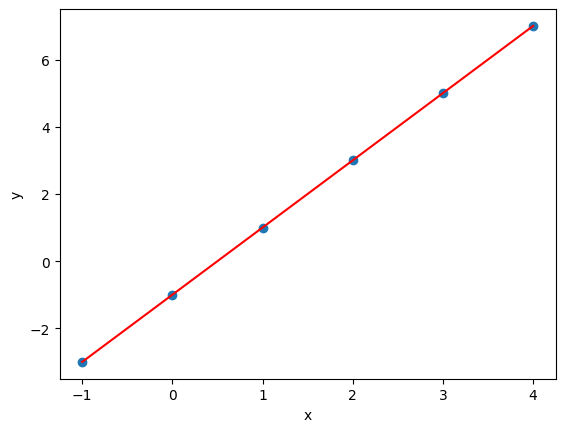
และx และy ข้อมูล:
x = [-1, 0, 1, 2, 3, 4 ]
y = [-3, -1, 1, 3, 5, 7 ]
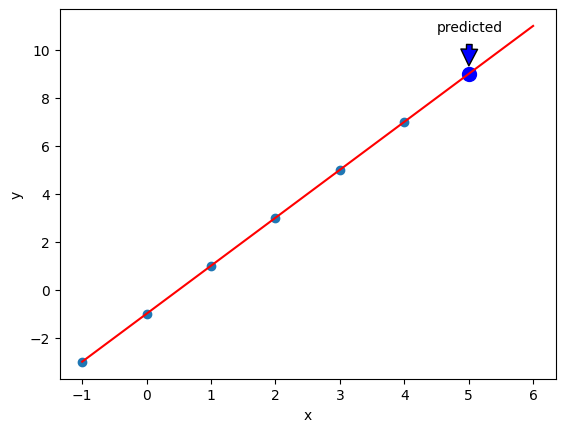
และx และ y ความสัมพันธ์ระหว่างเมื่อ xnew= 10 ถาม ynewเท่าไหร่?
ดังแสดงในรูปด้านล่างxและ yวาดเป็นรูปจุดกระจัดกระจายก็หาได้ไม่ยากว่าเส้นสีแดงในภาพด้านล่างคือ xและ yชื่อรอง
1.3.1 สร้างแบบจำลอง
เพียงใช้เลเยอร์ของโครงข่ายประสาทเทียมกับเซลล์ประสาทหนึ่งอัน รหัสจะเป็นดังนี้:
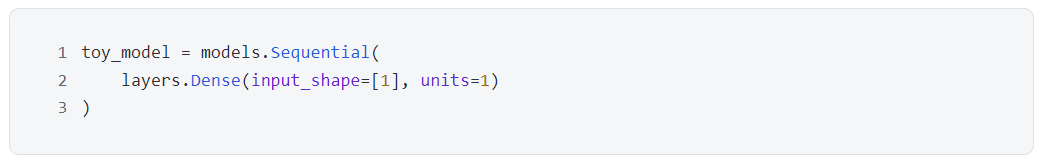
ใช้ครั้งแรกmodels.Sequential() สร้างโครงข่ายประสาทเทียมที่ว่างเปล่า จากนั้นเพิ่มเลเยอร์ต่อไป เราเพิ่มไว้ที่นี่layers.Dense()ชื่อรอง
1.3.2 การตรวจสอบโมเดล
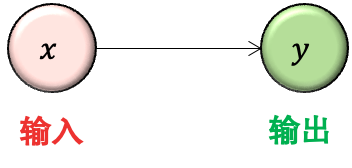
ตรวจสอบข้อมูลโมเดล สิ่งที่แปลกคือจำนวนพารามิเตอร์ (Param # ในรูปด้านล่าง) จริง ๆ แล้วเป็น 2 แทนที่จะเป็น 1 เพราะจากภาพข้างบนนี้y = wxควรมีเท่านั้นwพารามิเตอร์
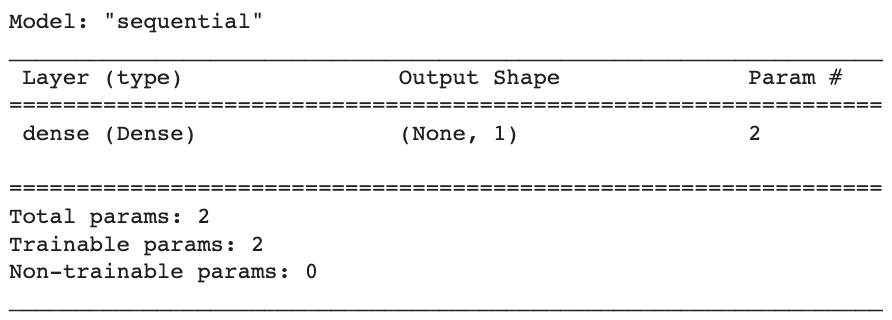
เหตุผลก็คือเมื่อคำนวณจำนวนพารามิเตอร์ในแต่ละเลเยอร์ แต่ละเซลล์ประสาทจะเชื่อมต่อกับค่า 1 ตามค่าเริ่มต้นหน่วยอคติ(หน่วยอคติ) ดังนั้น จริงๆ แล้ว ลักษณะของภาพด้านบนที่แม่นยำยิ่งขึ้นจะเป็นดังนี้:
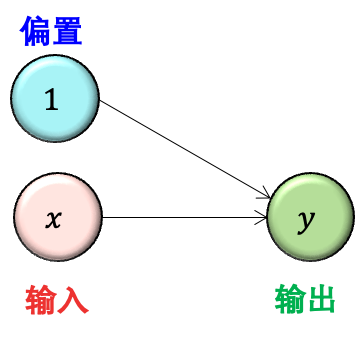
ถูกต้องแล้วในเวลานี้y = wx+ข ใช่wและ b สองพารามิเตอร์
พูดอย่างเคร่งครัดในความเป็นจริง Dense()ยังคงมีพารามิเตอร์ที่เรียกว่าการเปิดใช้งานในฟังก์ชัน ซึ่งหมายถึงฟังก์ชันการเปิดใช้งานอย่างแท้จริง และสิ่งที่ทำโดยพื้นฐานก็คือwx+b ถูกกำหนดไว้ในสวิตช์โหมดที่ไม่ใช่เชิงเส้นเป็น y. หากฟังก์ชั่นการเปิดใช้งานถูกกำหนดเป็น g,ดังนั้นy = g(wx+ข) ใน Keras หากคุณไม่ได้ระบุค่าสำหรับการเปิดใช้งาน คุณก็ไม่จำเป็นต้องทำการแปลงแบบไม่เชิงเส้นใดๆ เมื่อเพิ่มแนวคิดของฟังก์ชันการเปิดใช้งานแล้ว เราจะให้ภาพที่สมบูรณ์:
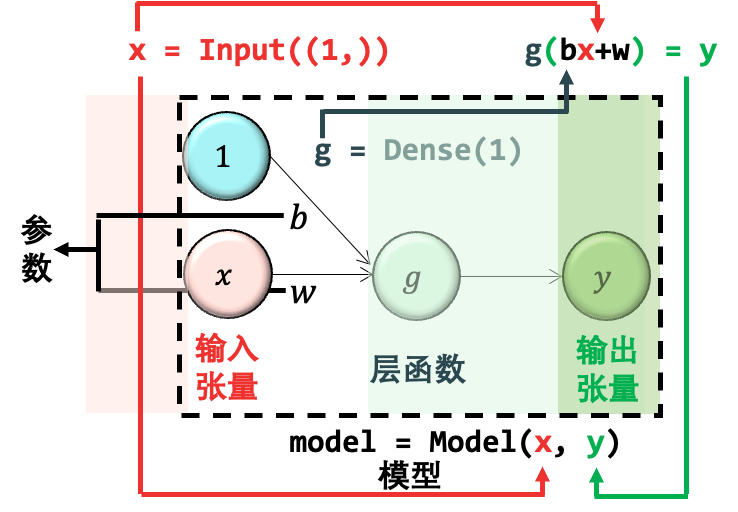
เป้าหมายของเราคือการหาพารามิเตอร์ในรูปด้านบนซึ่งก็คือน้ำหนักwชื่อรอง
1.3.3 รวบรวมโมเดล
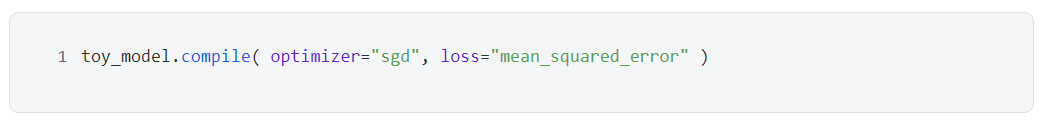
หลังจากตั้งค่ากรอบงานโมเดลแล้ว ขั้นตอนต่อไปคือการเพิ่มประสิทธิภาพปัญหาดังต่อไปนี้complie()เครื่องมือเพิ่มประสิทธิภาพพารามิเตอร์การตั้งค่าฟังก์ชัน="sgd"นั่นคือ ระบุวิธีการปรับให้เหมาะสมเป็นการสุ่มโคตรลาด และตั้งค่าพารามิเตอร์ loss="mean_squared_error"ชื่อรอง
1.3.4 รูปแบบการฝึกอบรม
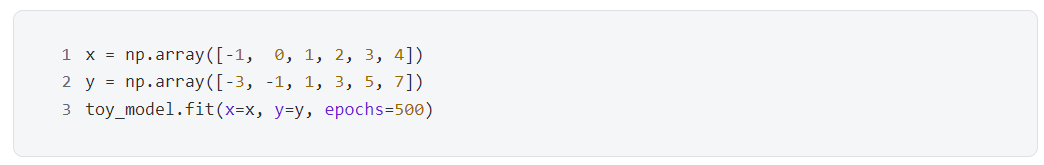
รูปแบบการฝึกอบรม fit()ฟังก์ชัน ส่งผ่านข้อมูล x และ y เป็นที่น่าสังเกตว่าพารามิเตอร์ epochs= 500 ยุคคือช่วงเวลาในภาษาจีน นั่นคือจำนวนครั้งที่ชุดการฝึกทั้งหมดถูกสำรวจโดยอัลกอริธึม นี่คือจุดสิ้นสุดของการฝึกโมเดลหลังจากสำรวจ 500 ครั้ง
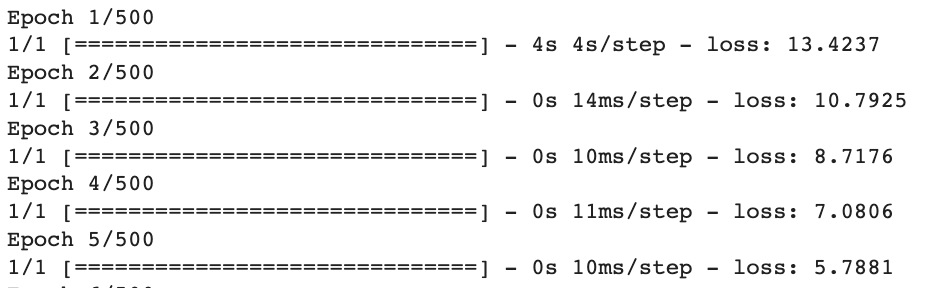
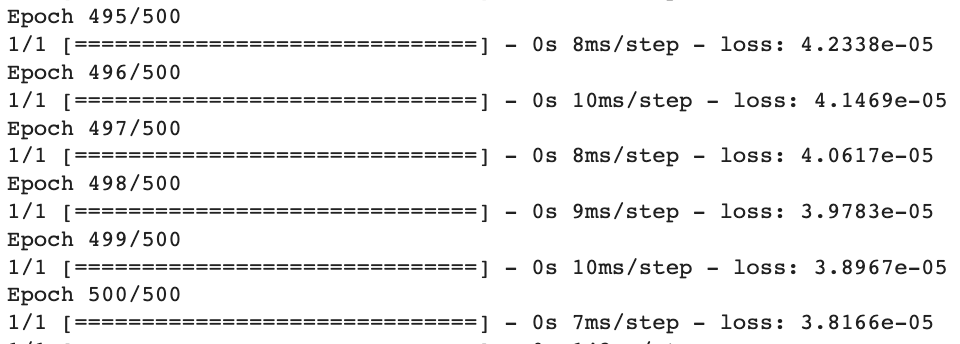
พิมพ์ข้อมูล 5 งวดแรกและงวดสุดท้ายออกมาหาได้ไม่ยากว่าขาดทุนมากที่ต้น 13.4237 และขาดทุนปลายน้อยมากเพียง 3.8166 e-05 บ่งชี้ว่าคำทำนาย มูลค่าในชุดฝึกแทบจะเท่ากับมูลค่าจริง
หลังจากฝึกโมเดลแล้วคุณสามารถใช้get_weights() ฟังก์ชั่นตรวจสอบพารามิเตอร์
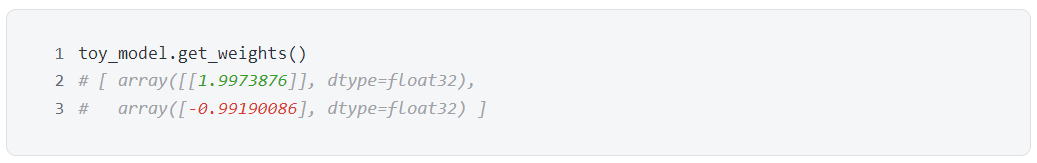 ผลลัพธ์แรกที่ส่งคืนคือน้ำหนักwอคติที่สองbชื่อรองy = 1.9973876 x - 0.99190086 ≈ 2 x - 1 。
1.3.5 แบบประเมินผล
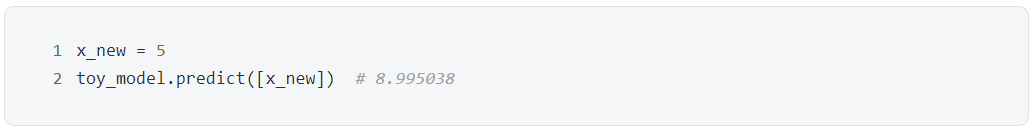
เพื่อประเมินโมเดลpredict() ฟังก์ชัน ส่งผ่านข้อมูลใหม่ x_new เข้าไป และรับผลลัพธ์ 8.995028 ซึ่งใกล้เคียงกับ 2*x_new - 1 = 9 มาก
ดังที่เห็นในภาพด้านล่าง โครงข่ายประสาทเทียม เรียนรู้ โมเดล (เส้นสีแดง) จากข้อมูล 6 ตัว (จุดสีน้ำเงินเข้ม) และแบบจำลองสามารถใช้กับข้อมูลใหม่ได้ (จุดสีน้ำเงิน)
สรุปกระบวนการทั้งหมดของโครงข่ายประสาทเทียม:
สร้างแบบจำลอง:ใช้Sequential()แน่นอนว่ายังมีวิธีอื่นที่ดีกว่า ซึ่งจะกล่าวถึงในหัวข้อถัดไป
ตรวจสอบรุ่น:ใช้summary()
คอมไพล์โมเดล:ใช้compile()
รูปแบบการฝึกอบรม:ใช้fit()
แบบประเมินผล:ใช้predict()
แม้ว่าตัวอย่างนี้จะสร้างโครงข่ายประสาทเทียมแบบมินิมอลลิสต์ แต่ก็มีห้าขั้นตอนจำนวนมาก และห้าขั้นตอนนี้จำเป็นในการสร้างโครงข่ายประสาทเทียมที่ซับซ้อนด้วย ข้อแตกต่างคือในขั้นตอนแรก หลายเลเยอร์จะถูกเย็บเข้าด้วยกันเมื่อสร้างโมเดล และในขั้นตอนที่ห้าจะมีการเลือกขั้นสูงกว่า เครื่องมือเพิ่มประสิทธิภาพ แต่ไม่เคยเปลี่ยนแปลง ในสองส่วนถัดไป เรามาดูโครงข่ายประสาทเทียมที่ซับซ้อนกว่าเล็กน้อยสองเครือข่ายกันซึ่งไปข้างหน้าเครือข่ายประสาทตอบรับ (feedforward neural network,FNN) และชื่อระดับแรก (convoluational neural network, CNN)。
2. โครงข่ายประสาทเทียมป้อนกลับ (FNN)
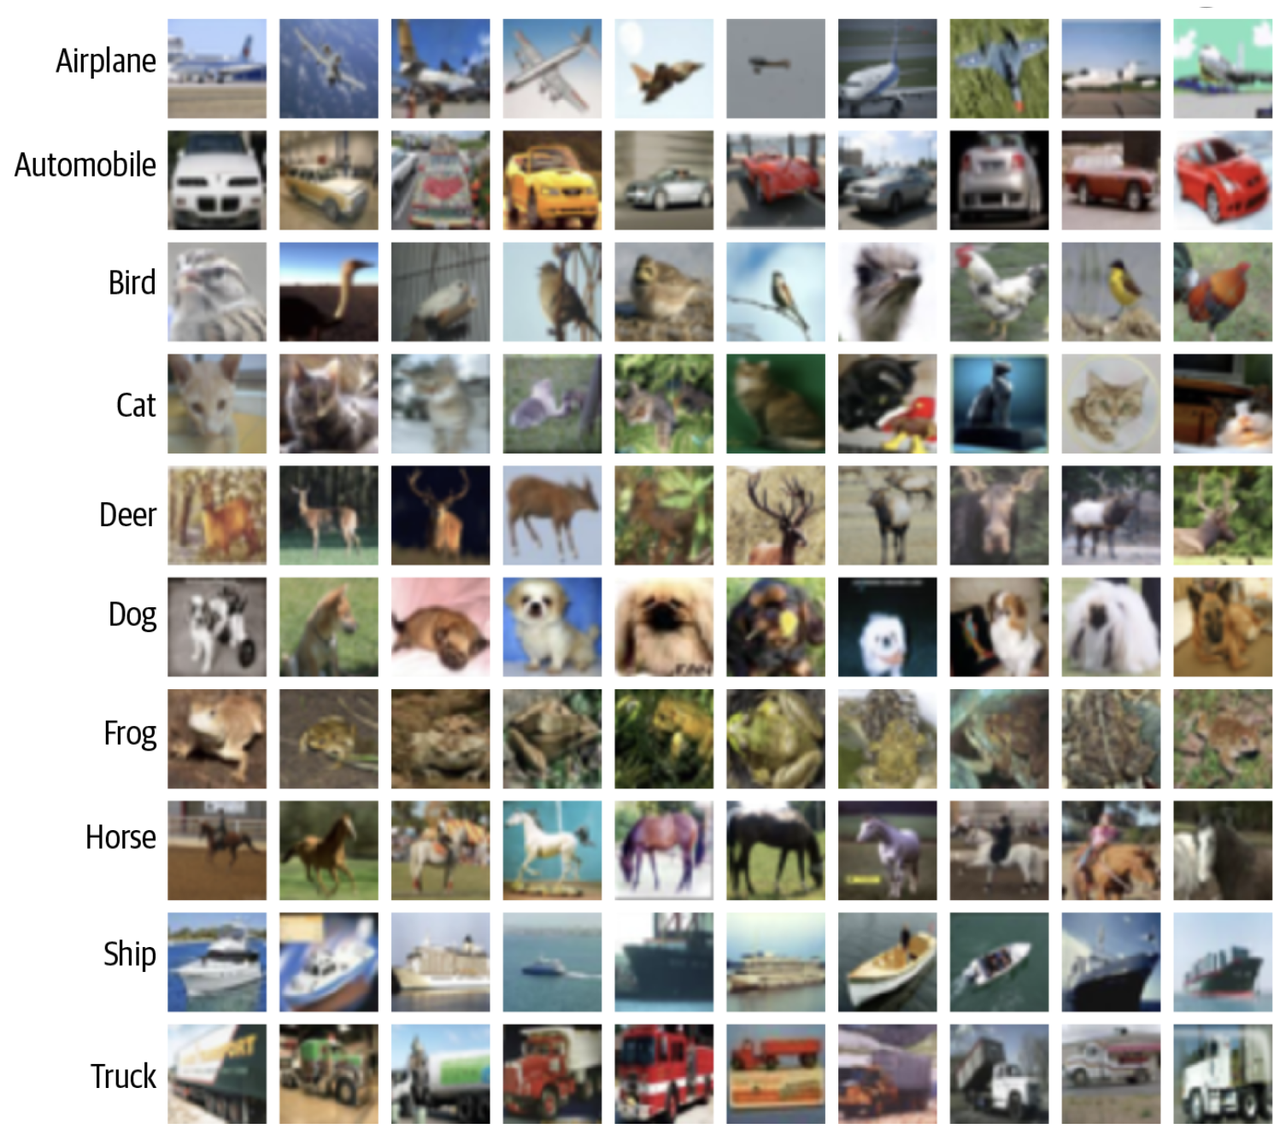
โครงข่ายประสาทเทียมแบบมินิมอลในส่วนที่แล้วน่าเบื่อเกินไป แต่ส่วนใหญ่จะใช้เพื่อชี้แจงแนวคิดและขั้นตอนของโครงข่ายประสาทเทียมใน Keras มาดูโครงข่ายประสาทเทียมเพื่อทำสิ่งที่น่าสนใจและทำนายหมวดหมู่รูปภาพกัน อันดับแรก ดูชุดข้อมูล CIFAR-10 (https://www.cs.toronto.edu/~kriz/cifar.html) ที่ใช้
ชุดข้อมูลมีรูปภาพสีทั้งหมด 60,000 ภาพ รูปภาพเหล่านี้มีขนาด 32*32 แบ่งออกเป็น 10 คลาส แต่ละคลาสมี 6,000 รูปภาพ ในจำนวนนี้ 50,000 ภาพใช้สำหรับการฝึกอบรม และอีก 10,000 ภาพใช้สำหรับการทดสอบ รูปภาพต่อไปนี้เป็นรายการ 10 หมวดหมู่ และรูปภาพ 10 รูปที่สุ่มแสดงในแต่ละหมวดหมู่:
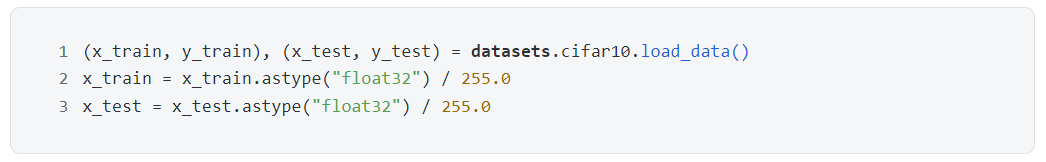
ใช้ฟังก์ชัน load_data() ในชุดข้อมูลโมดูลเพื่อดาวน์โหลดข้อมูลและปรับพิกเซลของภาพให้เป็นมาตรฐาน พิกเซลดั้งเดิมอยู่ระหว่าง 0 ถึง 255 และตอนนี้พิกเซลเหล่านี้ถูกทำให้เป็นมาตรฐานระหว่าง 0 ถึง 1
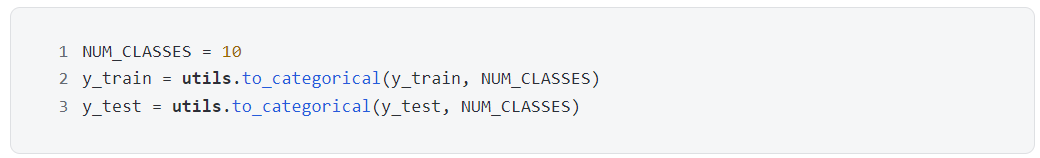
สำหรับหมวดหมู่ ให้ใช้ฟังก์ชันในโมดูล utilsto_categorical() ฟังก์ชั่นทำการเข้ารหัสแบบร้อนแรงในหมวดหมู่ แนวคิดคือการแทนจำนวนเต็มด้วยเวกเตอร์ที่มี 1 เพียงตัวเดียว ตัวอย่างเช่น หมวดหมู่ 5 จะกลายเป็น [ 0, 0, 0, 0, 1, 0, 0, 0, 0, 0 ] หลังจากการเข้ารหัสแบบร้อนแรงครั้งเดียว และที่นั่น เป็นเวกเตอร์ 10 ตัว จำนวนขององค์ประกอบจะเหมือนกับจำนวนหมวดหมู่ เฉพาะองค์ประกอบที่ห้าของเวกเตอร์คือ 1 (hot🔥 ที่ไม่ซ้ำกัน) และองค์ประกอบอื่นๆเป็น 0 (หนาวมาก🧊)
ชื่อรอง

ชื่อรอง
2.1.1 ลำดับ
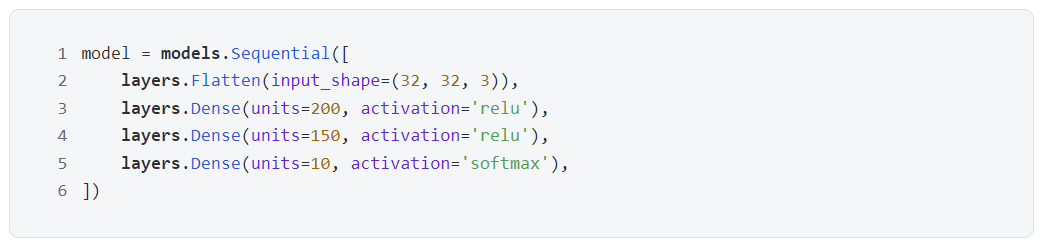
เราได้เห็นการสร้างแบบจำลองตามลำดับในส่วนที่แล้ว การใช้งานครั้งแรกmodels.Sequential() สร้างโครงข่ายประสาทเทียมที่ว่างเปล่า จากนั้นจึงเพิ่มเลเยอร์ต่อไป ในตัวอย่างนี้มีชั้นปรับระดับlayers.Flatten() และสามชั้นหนาแน่นlayers.Dense()。
โค้ดด้านบนนี้ให้โมเดลดังแสดงในรูปด้านล่าง:
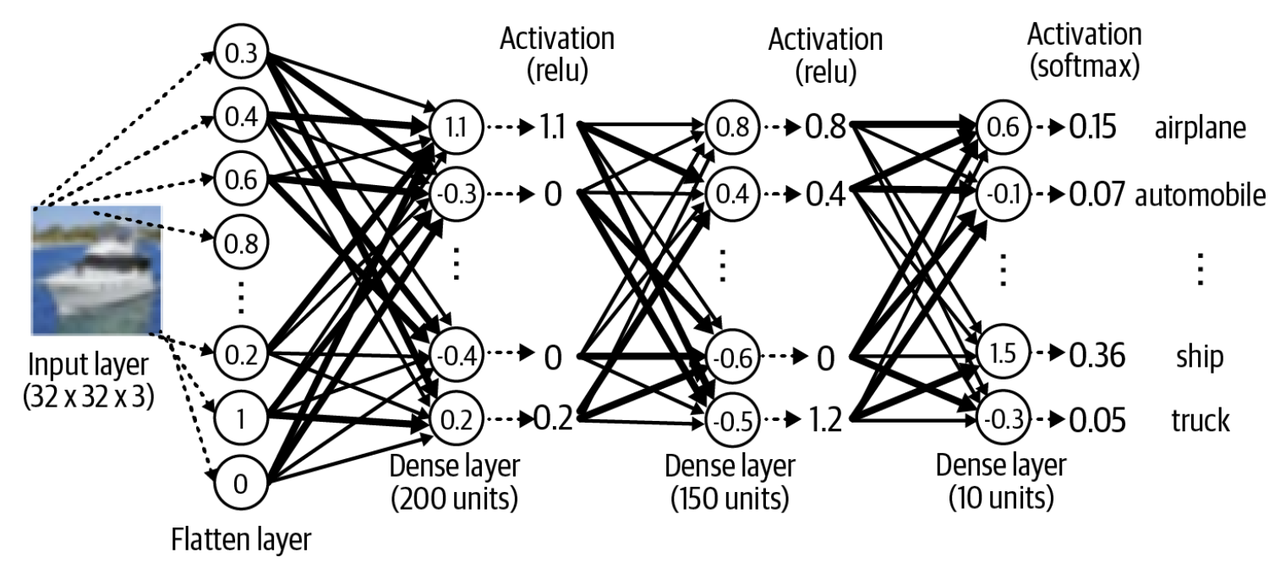
ด้วยความรู้ทางประสาทสัมผัสเรามาศึกษาโค้ดกัน ทำไมคุณถึงต้องมีชั้นปรับระดับ? เนื่องจากรูปภาพมีความกว้าง ความสูง และช่องสีสามมิติ กระบวนการทำให้แบนเป็นมิติเดียวจึงแสดงไว้ในภาพด้านล่าง
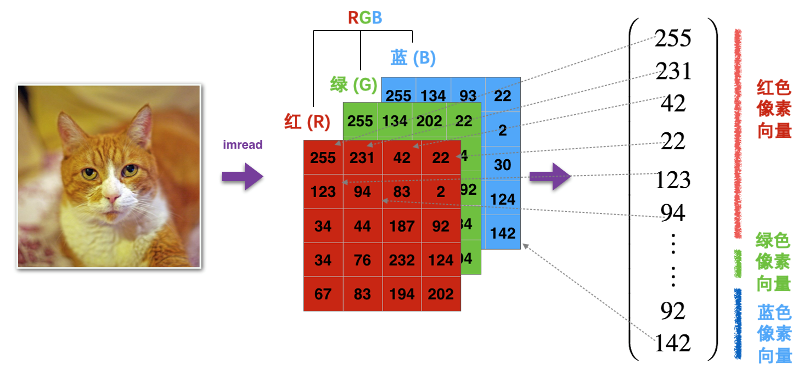
รูปภาพต้นฉบับ (32, 32, 3) ถูกป้อนลงในเลเยอร์การทำให้เรียบ (ระบุขนาดมิติของรูปภาพในพารามิเตอร์ input_shape) และหลังจากการทำให้แบนแล้ว มันจะกลายเป็นเวกเตอร์ 32* 32* 3 = 3072 ซึ่งสามารถจินตนาการได้เป็น อินพุตมี 3,072 เซลล์ประสาทในขณะนี้ หลังจากสามชั้นหนาแน่น
จำนวนเซลล์ประสาท (หน่วยพารามิเตอร์) คือ 200, 150 และ 10 ตามลำดับ 200 และ 150 สองอันแรกถูกกำหนดแบบไม่เป็นทางการหรือดีบั๊กเป็นไฮเปอร์พารามิเตอร์ แต่ 10 อันสุดท้ายสอดคล้องกับจำนวนหมวดหมู่
ฟังก์ชันการเปิดใช้งาน (การเปิดใช้งานพารามิเตอร์) ที่ใช้คือ relu, relu และ softmax ตามลำดับ สอง relu แรกเกือบจะเป็นมาตรฐาน แต่ softmax สุดท้ายเกี่ยวข้องกับงาน หากเป็นปัญหาแบบหลายคลาส ให้ใช้ softmax
ทั่วไปฟังก์ชั่นการเปิดใช้งาน(ฟังก์ชั่นการเปิดใช้งาน) ดังแสดงด้านล่าง:
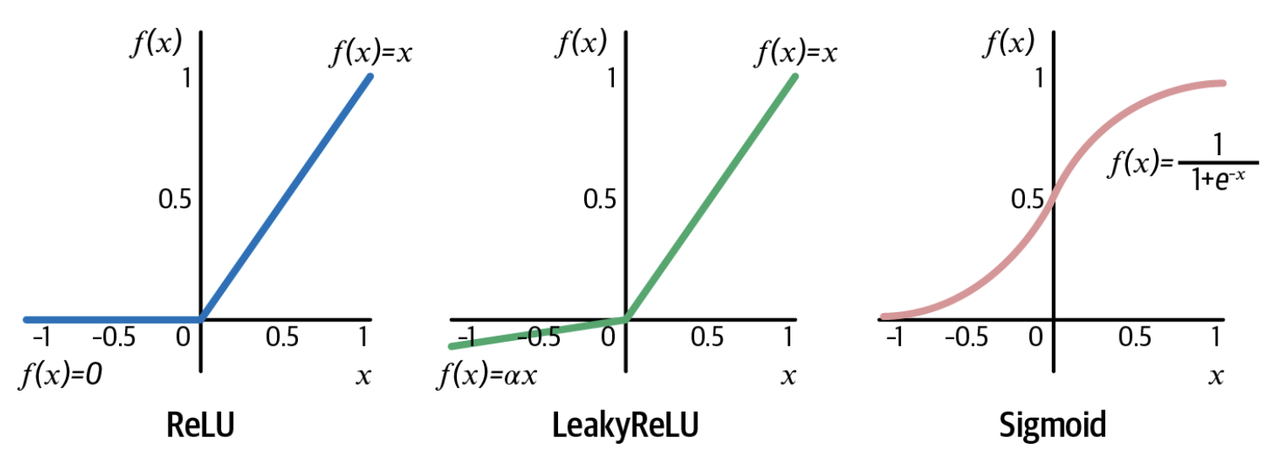
ReLU แปลงอินพุตเชิงลบ (x < 0) เป็น 0 และอินพุตเชิงบวก (x > 0) ยังคงไม่เปลี่ยนแปลง LeakyReLU คล้ายกับ ReLU มาก ข้อแตกต่างเพียงอย่างเดียวคือสำหรับอินพุตเชิงลบ (x< 0) ผลลัพธ์ของการแปลงยังเป็นจำนวนลบ (ax) ที่สัมพันธ์กับอินพุตอีกด้วย
Sigmoid แปลงจำนวนจริงเป็นตัวเลขระหว่าง 0-1 และจำนวนนี้ถือได้ว่าเป็นความน่าจะเป็นดังนั้นSigmoid ฟังก์ชันสำหรับปัญหาการจำแนกไบนารี เวอร์ชันขยายSoftmaxชื่อรอง
2.1.2 รูปแบบการใช้งาน
ในทางปฏิบัติเราคุ้นเคยกับการใช้มากขึ้นการทำงาน(เชิงหน้าที่) การสร้างแบบจำลอง แบบจำลองที่สร้างขึ้นตามลำดับสามารถทำได้โดยใช้วิธีการทำงาน และในทางกลับกัน หากคุณเลือกวิธีใดวิธีหนึ่งขอแนะนำให้ใช้วิธีการทำงานเท่านั้นในการสร้างแบบจำลอง รหัสแสดงดังต่อไปนี้:
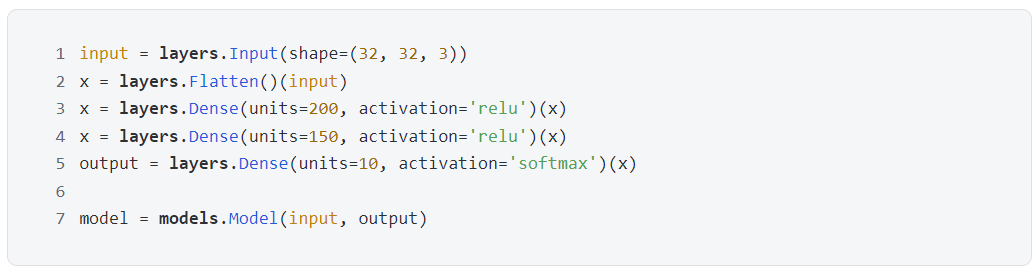
การสร้างแบบจำลองเชิงฟังก์ชันจำเป็นต้องจำประโยคเดียวเท่านั้น:ใช้เลเยอร์เป็นฟังก์ชัน. เมื่อคำนึงถึงประโยคนี้ โค้ดจึงสามารถเข้าใจได้ภายในไม่กี่วินาที
บรรทัดที่ 1 ด้วย Input() รับข้อมูลภาพ
บรรทัดที่ 2 ใส่Flatten() เป็นฟังก์ชันfการทำให้เข้าใจง่ายไม่ใช่ x = f(อินพุต)
ในบรรทัดที่ 3 ให้ใส่Dense(units= 200,activation='relu') เป็นฟังก์ชันgการทำให้เข้าใจง่ายไม่ใช่ x = g(x)
บรรทัดที่ 4 ใส่Dense(units= 150,activation='relu') เป็นฟังก์ชันhการทำให้เข้าใจง่ายไม่ใช่ x = h(x)
บรรทัดที่ 5 ใส่Dense(units= 10,activation='softmax') เป็นฟังก์ชันqการทำให้เข้าใจง่ายไม่ใช่เอาต์พุต = q(x)
ฟังก์ชันแบบเลเยอร์ต่อเลเยอร์ดังกล่าวจะถ่ายโอนอินพุตไปยังเอาต์พุต, output = q(h(g(f(input)))) และสุดท้ายก็ใช้models.ชื่อรอง
2.2 การตรวจสอบแบบจำลอง
หลังจากสร้างโมเดลและก่อนใช้งานแล้ว ควรตรวจสอบว่ารูปร่างข้อมูลของแต่ละเลเยอร์ของโครงข่ายประสาทเทียมนั้นถูกต้องหรือไม่ โดยใช้summary() ฟังก์ชั่นสามารถช่วยคุณพิมพ์ข้อมูลดังกล่าวได้
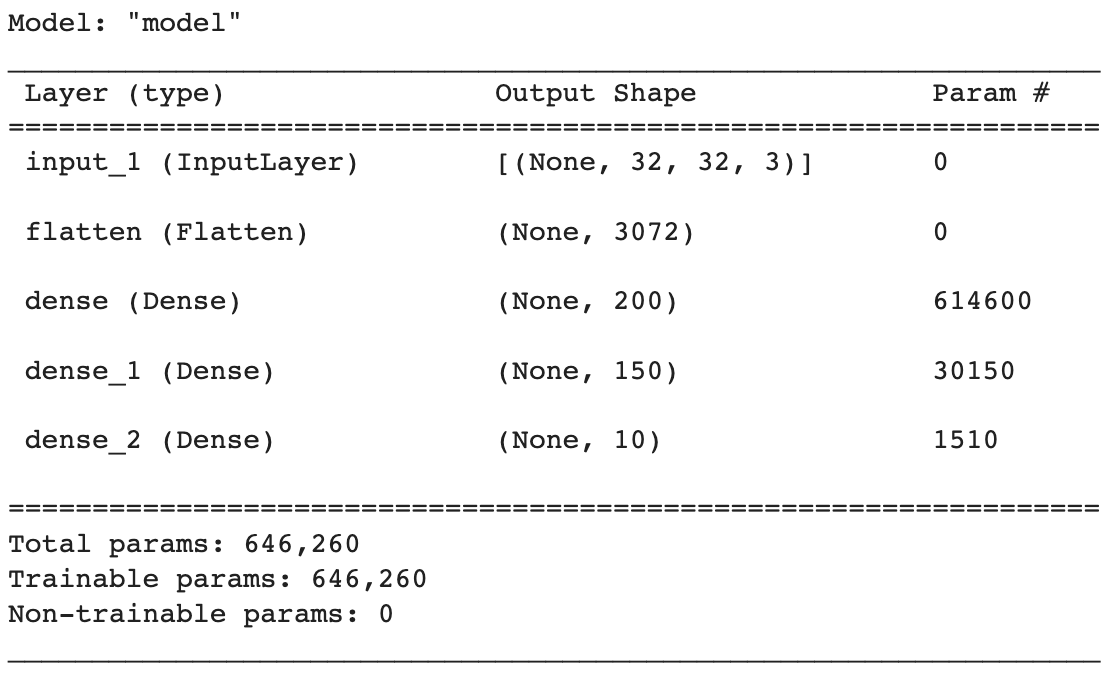
โมเดลจะมีชื่อว่า model โดยอัตโนมัติ ตามด้วยตารางที่อธิบายประเภทชื่อ (เลเยอร์ (ประเภท)) รูปร่างเอาต์พุต (รูปร่างเอาต์พุต) และจำนวนพารามิเตอร์ (Param #) ของแต่ละเลเยอร์ มาดูกันทีละชั้นครับ
เลเยอร์ InputLayer มีชื่อว่า input_ 1 และรูปร่างเอาต์พุตคือ [None, 32, 32, 3 ] องค์ประกอบสามรายการสุดท้ายสอดคล้องกับความกว้าง ความสูง และช่องสีของภาพ องค์ประกอบแรก None จริงๆ แสดงถึงจำนวนตัวอย่าง เข้มงวดมากขึ้น พูดก็คือ จำนวนตัวอย่างในชุด เพื่อความกระชับของโค้ด โดยปกติแล้วหมายเลขตัวอย่างนี้ไม่จำเป็นต้องเขียนอย่างชัดเจนเมื่อสร้างโมเดล
เลเยอร์ที่ราบเรียบมีชื่อว่าราบเรียบ 3072 คือจำนวน 32* 32* 3 หลังจากการราบเรียบ และจำนวนพารามิเตอร์คือ 0 เนื่องจากการราบเรียบเป็นเพียงการปรับรูปร่างอาร์เรย์ใหม่ และไม่จำเป็นต้องใช้พารามิเตอร์ในการดำเนินการปรับรูปร่างใหม่ให้เสร็จสมบูรณ์
เลเยอร์ Dense ชั้นแรกมีชื่อว่า Dense รูปร่างเอาต์พุตคือ 200 พารามิเตอร์ 614, 600 = ( 3072 + 1) * 200 อย่าลืมหน่วยอคติ
เลเยอร์หนาแน่นที่สองชื่อหนาแน่น_1 รูปร่างเอาต์พุตคือ 150 พารามิเตอร์ 30, 150 = (200 + 1) * 150 ให้พิจารณาหน่วยอคติด้วย
เลเยอร์หนาแน่นที่สามชื่อหนาแน่น_2 รูปร่างเอาต์พุตคือ 10 พารามิเตอร์ 1, 510 = (150 + 1) * 10 ให้พิจารณาหน่วยอคติด้วย
ด้านล่างยังแสดงรายการพารามิเตอร์ทั้งหมด (พารามิเตอร์ทั้งหมด)646, 260 , จำนวนพารามิเตอร์ที่สามารถฝึกได้ (params ที่ฝึกได้)646, 260 จำนวนพารามิเตอร์ที่ไม่สามารถฝึกได้ (พารามิเตอร์ที่ไม่สามารถฝึกได้)0 ชื่อรอง
2.3 รวบรวมโมเดล
เมื่อสร้างโมเดลแล้ว คุณจะต้องคอมไพล์โมเดล คุณต้องกำหนดจุดสามจุด:
เลือกฟังก์ชันการสูญเสียตามงานที่จะแก้ไข
เลือกเครื่องมือเพิ่มประสิทธิภาพที่เหมาะสมที่สุด
เลือกเมตริกที่คุณต้องการตรวจสอบ
เรียบเรียงโมเดลด้วยcomplie() มีอยู่
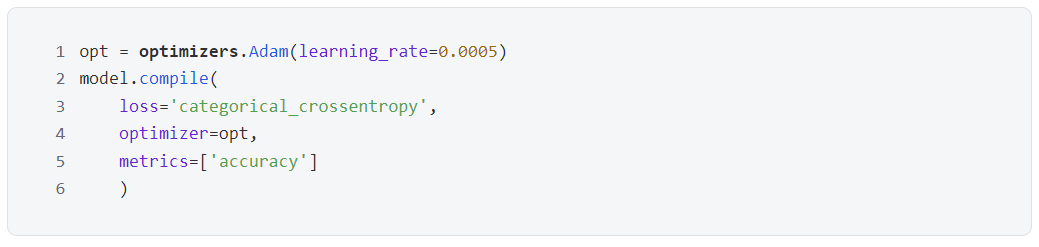
มีอยู่complie()ในฟังก์ชัน:
สำหรับการสูญเสียพารามิเตอร์ ตัวอย่างนี้เป็นปัญหาระดับเดียวกัน ดังนั้นฟังก์ชันการสูญเสียที่ใช้จึงเป็น categorical_crossentropy นอกจากนี้:
ปัญหาการจำแนกสองประการ: ฟังก์ชันการสูญเสียคือ binary_crossentropy
ปัญหาการถดถอย: ฟังก์ชันการสูญเสียคือ meme_squared_error
สำหรับเครื่องมือเพิ่มประสิทธิภาพพารามิเตอร์ การใช้เครื่องมือเพิ่มประสิทธิภาพ adam และ rmsprop ด้วยอัตราการเรียนรู้เริ่มต้นจะปลอดภัยในกรณีส่วนใหญ่ เมื่อตั้งค่าพารามิเตอร์นี้ ยังสามารถเรียกได้โดยใช้ชื่อและสร้างอินสแตนซ์ของออบเจ็กต์
ชื่อ: 'sgd'
วัตถุ: เครื่องมือเพิ่มประสิทธิภาพ อดัม (learning_rate= 0.0005)
สำหรับเมตริกพารามิเตอร์ สามารถเรียกได้โดยใช้ชื่อและสร้างอินสแตนซ์ของออบเจ็กต์ ในตัวอย่างนี้ ตัวบ่งชี้มีความแม่นยำ จึงสามารถเขียนได้เป็น
ชื่อ: ['ความแม่นยำ']
ออบเจ็กต์: [metrics.categorical_accuracy]
ชื่อรอง
2.4 รูปแบบการฝึกอบรม
โมเดลการฝึกไม่ได้รวมข้อมูลทั้งหมดเข้าด้วยกัน แต่จะส่งเป็นชุด ก่อนที่จะแนะนำรูปแบบการฝึกอบรม จำเป็นต้องมีการชี้แจงแนวคิดหลายประการ:
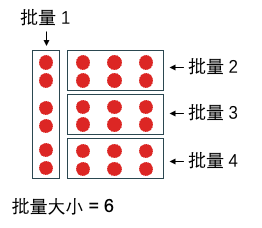
ขนาดชุด(ขนาดแบทช์) หมายถึง จำนวนตัวอย่างในชุด ตัวอย่างต่อไปนี้มีข้อมูลทั้งหมด 24 ข้อมูล หากมีข้อมูล 6 ข้อมูลในแต่ละชุด จำนวนสำนักงานทั้งหมดสามารถแบ่งออกเป็น 4 ชุด
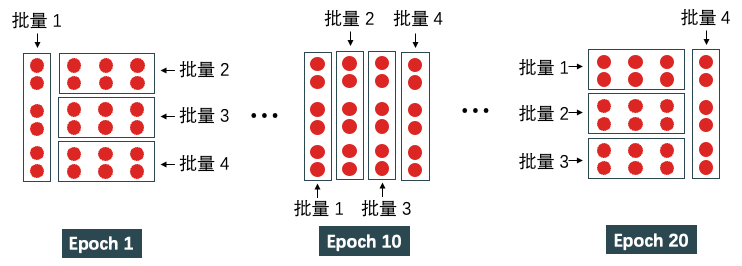
คาดหวัง(ยุค) หมายความว่าชุดการฝึกทั้งหมดถูกสำรวจครั้งเดียวโดยอัลกอริธึม เมื่อตั้งค่ายุคเป็น 20 ชุดการฝึกทั้งหมดจะต้องเคลื่อนที่ 20 ครั้งด้วยวิธีที่ต่างกัน ยุคจะต้องผ่านการวนซ้ำ 4 ครั้งเพื่อสำรวจชุดข้อมูลทั้งหมด กล่าวคือ จำนวนตัวอย่างทั้งหมด / ขนาดแบทช์ = 24/6 การวนซ้ำ กระบวนการทำงานของ 20 ยุคแสดงไว้ในภาพด้านล่าง
รูปแบบการฝึกอบรมfit()ฟังก์ชั่นโค้ดจะเป็นดังนี้:
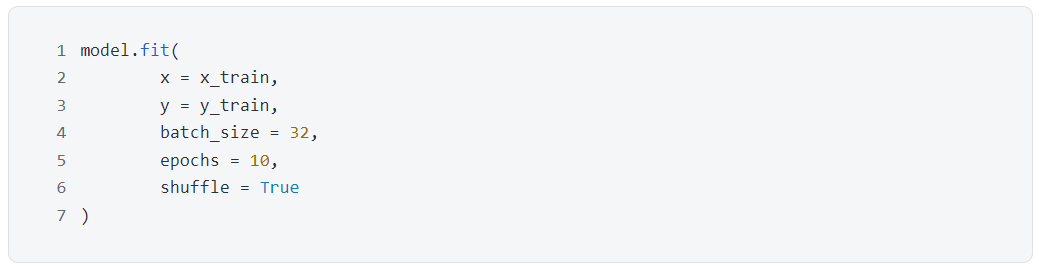
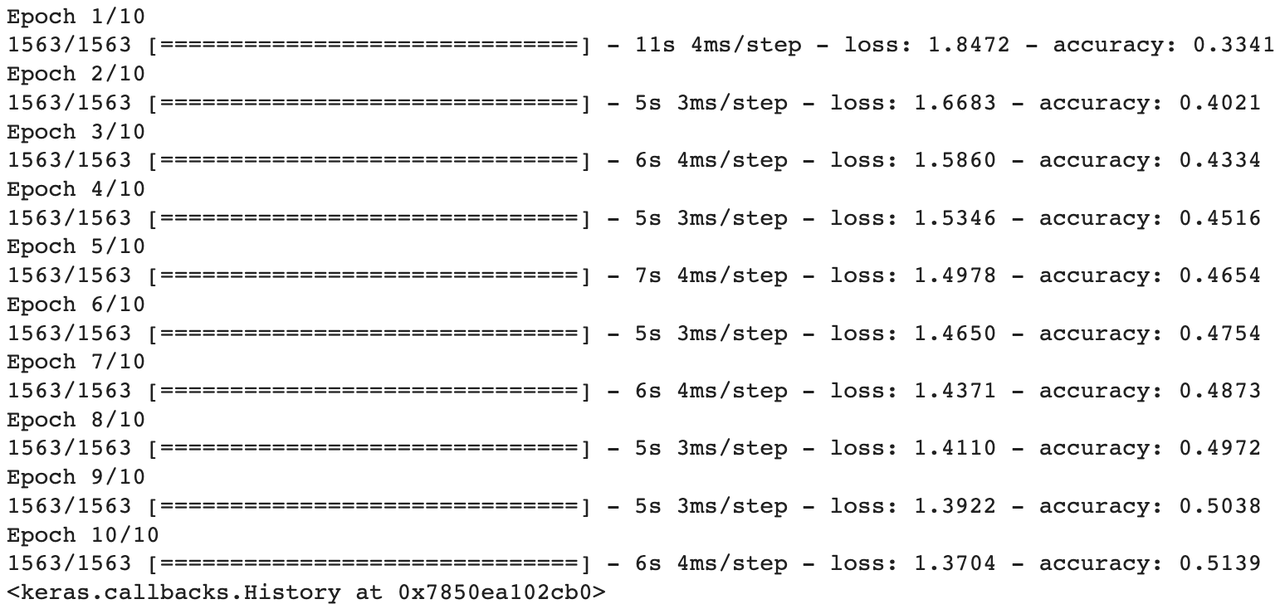
รูปด้านบนแสดงขั้นตอนการฝึกซ้อม ไม่ยากเลยที่จะเห็นว่าชุดฝึกแบ่งออกเป็น 1,563 กอง แต่ละกองมี 32 ภาพ (batch size) หลังจากผ่านไป 10 ยุคฟังก์ชั่นการสูญเสีย(cross-entropy แบบแบ่งประเภท) ลดลงจาก 1.8472 เป็น 1.3696 ในขณะที่ความแม่นยำ(ความแม่นยำ) เพิ่มขึ้นจาก 33.41% เป็น 51.39% . สามารถเข้าถึงแบบจำลองได้ในชุดฝึกอบรม51.39% ชื่อรอง
2.5 แบบประเมินผล
ใช้evaluate()ฟังก์ชั่นขึ้นอยู่กับอัตราความแม่นยำโดยตรง
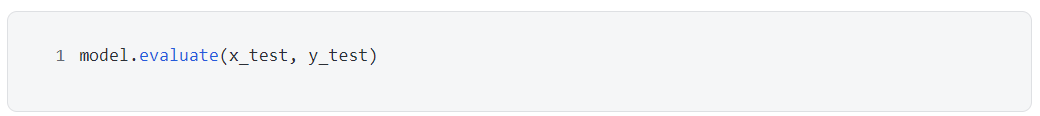
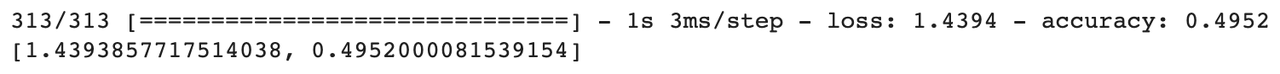
ความแม่นยำของแบบจำลองบนชุดทดสอบคือ49.52% ซึ่งสูงกว่าความแม่นยำ 10% ของการทำนายหมวดหมู่แบบสุ่มอย่างมาก (เนื่องจากมีสิบหมวดหมู่) เนื่องจากเราใช้โครงข่ายประสาทเทียมแบบฟีดฟอร์เวิร์ดที่เรียบง่ายเช่นนี้เพื่อทำนายหมวดหมู่รูปภาพ49.52% อัตราความแม่นยำถือว่าได้ผลดีอยู่แล้ว
ใช้predict()ฟังก์ชั่นเปรียบเทียบคลาสที่ทำนายและคลาสจริง
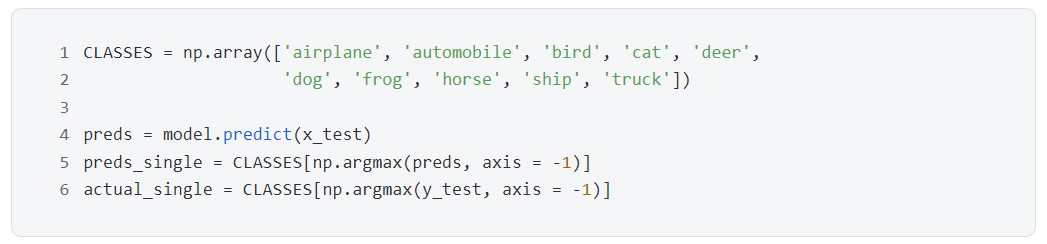
ชุดทดสอบมีรูปภาพ 10,000 ภาพ และมี 10 หมวดหมู่ ดังนั้น preds จึงเป็นอาร์เรย์ของ [ 10,000, 10 ] และแต่ละแถวคือความน่าจะเป็นของ 10 หมวดหมู่ที่แบบจำลองทำนายไว้สำหรับรูปภาพที่เกี่ยวข้อง แน่นอนว่า ความน่าจะเป็นทั้งหมด เพิ่มได้ถึง 1 ดูคำทำนายสำหรับภาพแรกในชุดทดสอบ:
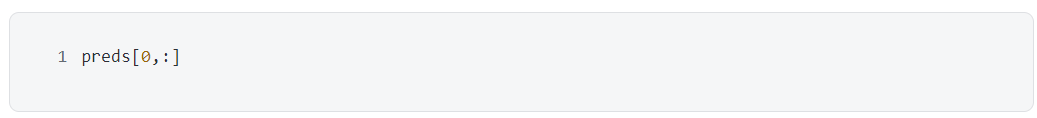
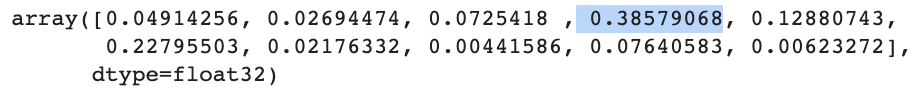
y_test ยังเป็นอาร์เรย์ของ [ 10,000, 10 ] แต่ละแถวเป็นหมวดหมู่ที่แท้จริงของรูปภาพที่เกี่ยวข้อง ดังนั้น 10 องค์ประกอบจึงมีศูนย์ 9 ตัวและ 1 หนึ่งตัว ดูหมวดหมู่ที่แท้จริงของภาพแรกในชุดทดสอบ:
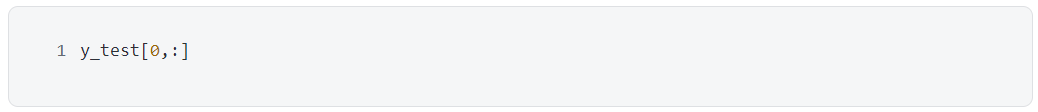
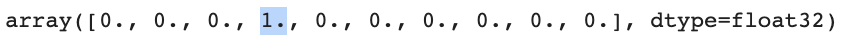
ไม่ใช่เรื่องยากที่จะเห็นว่าความน่าจะเป็นของหมวดที่ 4 ในผลการทำนาย preds[0,:] คือสูงสุด 0.38579068 และการทดสอบหมวดหมู่จริง[0.:] คือหมวดที่ 4 (องค์ประกอบที่สี่คือหนึ่ง) ใช้ np.argmax เพื่อค้นหาดัชนีที่สอดคล้องกับค่าสูงสุดจากผลการทำนาย preds[0,:] และการทดสอบหมวดหมู่จริง[0.:] และแมปคำอธิบายหมวดหมู่จาก CLASSES
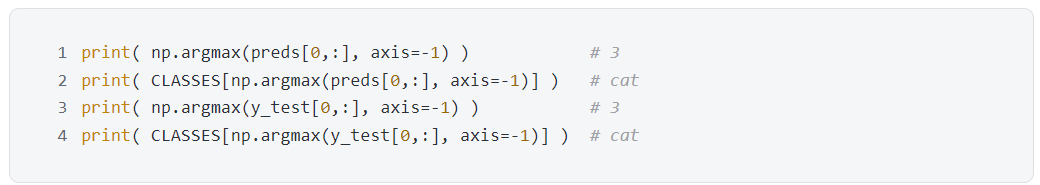
ภาพแรกในชุดทดสอบคือแมว และโมเดลทำนายแมว ถูกต้องแล้ว!
ลองอันที่สี่อีกครั้ง
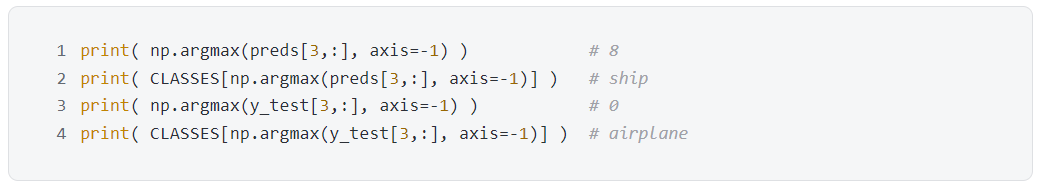
ภาพที่สี่ในชุดทดสอบคือเรือ แต่นางแบบทำนายเครื่องบิน ซึ่งคิดผิด!
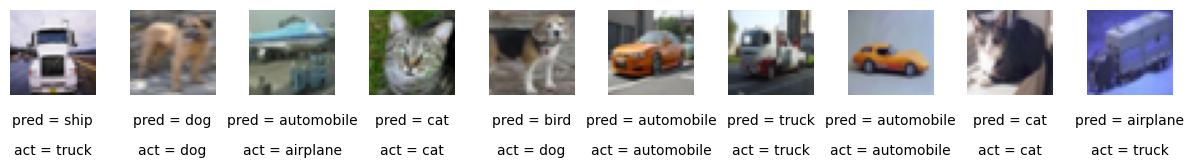
การแสดงภาพ: วิธีการเปรียบเทียบข้างต้นยุ่งยากเกินไป เราสามารถสุ่มเลือก 10 ภาพจากชุดทดสอบ พิมพ์แต่ละภาพ และวางหมวดหมู่การทำนายแบบจำลองและหมวดหมู่จริงไว้ใต้ภาพ
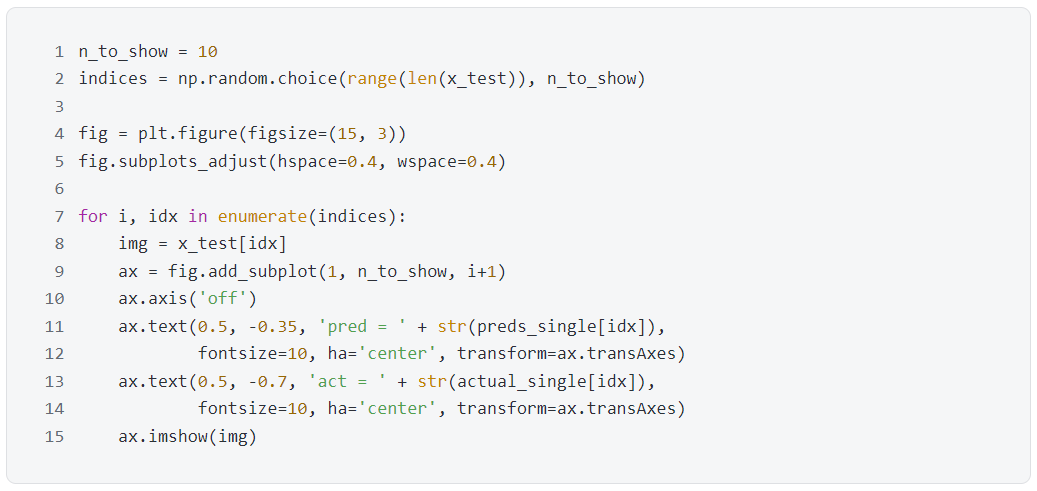
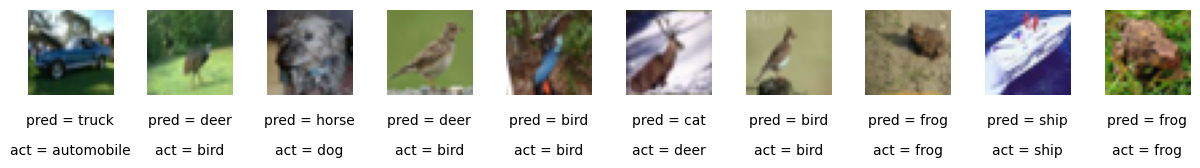
จะเห็นได้จากภาพเล็กๆ 10 ภาพด้านบนที่โมเดลคาดการณ์ได้ถูกต้อง 5 ภาพ โดยมีอัตราที่ถูกต้องอยู่ที่ 50% ซึ่งสอดคล้องกับสถิติก่อนหน้านี้ที่ 49.52% แม้ว่านี่จะเป็นเพียงแบบจำลองที่เลือกปฏิบัติสำหรับการทำนาย แต่เนื้อหาที่แนะนำในส่วนนี้ (เช่น เลเยอร์ ฟังก์ชันการเปิดใช้งาน เครื่องมือเพิ่มประสิทธิภาพ ฯลฯ) ยังคงนำไปใช้เมื่อเราสร้างแบบจำลองเชิงกำเนิด
ชื่อระดับแรก
3. เครือข่ายประสาทเทียม (CNN)
ชื่อรอง
3.1 แนวคิดพื้นฐาน
สมมุติว่าภาพขนาดใหญ่ปรากฏขึ้นตรงหน้าคุณในความมืด และคุณไม่สามารถมองเห็นได้เหมือนรถยนต์ในความมืด คุณสามารถใช้ไฟฉายสแกนภาพทีละนิด แล้วฉายภาพสิ่งที่คุณเห็นในแต่ละครั้งไปที่ ชั้นถัดมา เป็นต้น ตัวอย่างเช่น คุณสามารถเห็นเส้นแนวนอน เส้นแนวตั้ง และเครื่องหมายทับบนชั้นแรก วงกลมและสี่เหลี่ยมบางส่วนบนชั้นที่สอง ล้อ ประตูและตัวถังบนชั้นที่สาม และรถยนต์บนชั้นที่สี่ วิธีนี้ทำให้คุณสามารถใช้ไฟฉายเพื่อส่องรถยนต์ในภาพถ่ายในความมืดได้
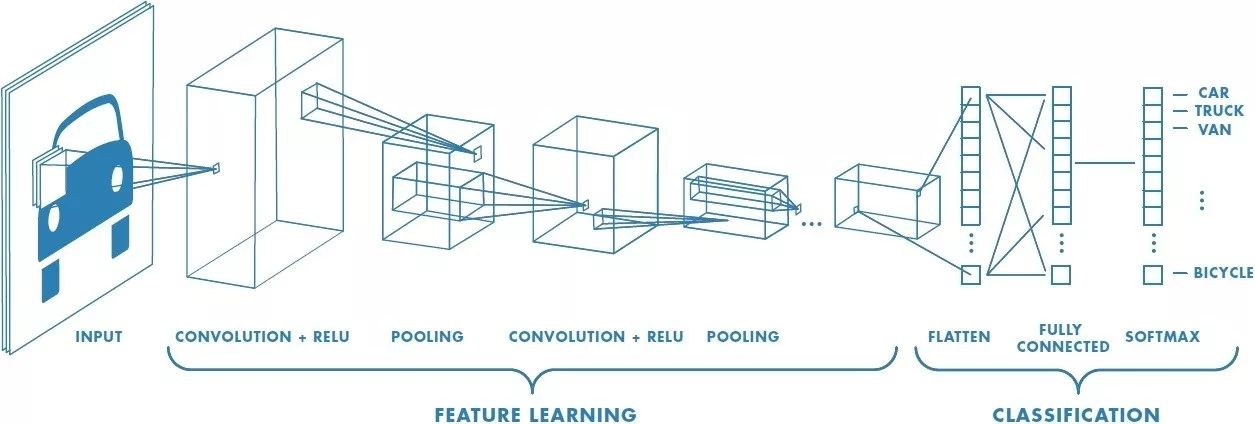
ตัวอย่างข้างต้นเป็นกระบวนการรับรู้รูปภาพโดยโครงข่ายประสาทเทียมแบบหมุนวน ขั้นแรก ให้อธิบายคำจำกัดความบางประการ:
กรอง(ตัวกรอง): ปัดผ่านความกว้างและความสูงของข้อมูลที่ป้อน โดยเชื่อมโยงกับข้อมูลที่ป้อน เช่น ไฟฉายในตัวอย่างด้านบน
การบิด(การบิด): คำจำกัดความที่นี่คือการคูณ พิกเซลของฟิลเตอร์ ทั้งหมดด้วย พิกเซลของฟิลเตอร์ที่กวาดภาพ แล้วบวกกัน
ขนาดขั้นตอน(ก้าวย่าง): ขนาดขั้นตอนของฟิลเตอร์เมื่อเคลื่อนที่ผ่านรูปภาพ ค่าเริ่มต้นคือ 1 กล่าวคือ ฟิลเตอร์จะเลื่อนทีละพิกเซล
การกรอก(ช่องว่างภายใน): บางครั้งข้อมูลอินพุตจะถูกเติมด้วย 0 ที่ขอบ ซึ่งสามารถควบคุมขนาดของข้อมูลเอาท์พุตได้ (ที่นิยมใช้กันมากที่สุดคือการรักษาขนาดของข้อมูลเอาท์พุตให้สอดคล้องกับข้อมูลอินพุต)
การบิดตัว
คุณสมบัติที่ใหญ่ที่สุดของโครงข่ายประสาทเทียมแบบหมุนวนคือการดำเนินการแบบหมุนวน เมื่อมองย้อนกลับไปที่คำจำกัดความข้างต้น ให้คูณ พิกเซลของฟิลเตอร์ ด้วย พิกเซลของรูปภาพที่ฟิลเตอร์กวาด แล้วบวกเข้าด้วยกัน ดูสองตัวอย่างต่อไปนี้ โดยสมมติว่าขนาดของฟิลเตอร์คือ 3*3
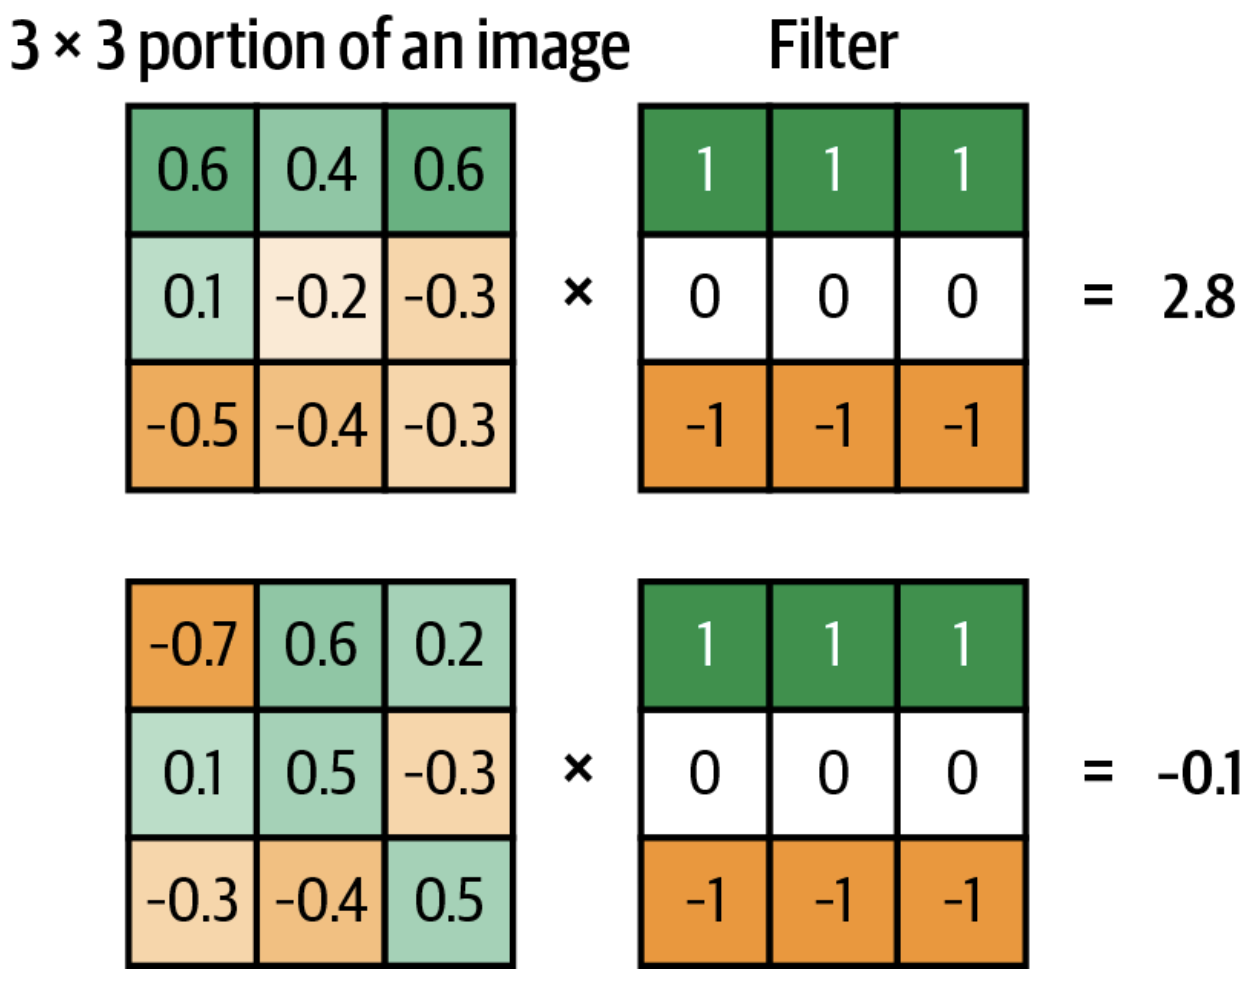
การบิดของภาพแรกและฟิลเตอร์คือ 0.6*1 + 0.4*1 + 0.6*1 + 0.1*0 + (-0.2)*0 + (-0.3)*0 + (-0.5)*(-1) + (-0.4)*(-1) + (-0.3)*(-1) =2.8 。
การบิดของภาพที่สองและฟิลเตอร์คือ (-0.7)* 1 + 0.6* 1 + 0.2* 1 + 0.1* 0 + 0.5* 0 + (-0.3)* 0 + (-0.3)*(-1) + (-0.4)*(-1) + 0.5*(-1) =-0.1 。
เมื่อค่าการบิดมากขึ้นแค่แสดงว่าฟิลเตอร์และรูปภาพมีมากกว่าจับคู่; เมื่อค่าการบิดตัวสูงขึ้นภาระแสดงว่าฟิลเตอร์และรูปภาพมีมากกว่าไม่ตรงกัน. ค่าการบิดของภาพแรกและตัวกรองในตัวอย่างด้านบนคือ2.8 , ทั้งคู่จับคู่; ค่าการหมุนของรูปภาพที่สองและตัวกรองคือ-0.1 , ทั้งคู่ไม่ตรงกัน。
กรอง
หน้าที่ของตัวกรองคือการกรองนั่นคือกรองข้อมูลบางอย่างออกซึ่งเทียบเท่ากับการแยกข้อมูลที่เก็บไว้ รหัสต่อไปนี้จะสร้างฟิลเตอร์ขนาด 3*3 สองตัว ฟิลเตอร์ 1 สามารถแยกเส้นแนวนอนในภาพ และฟิลเตอร์ 2 สามารถแยกเส้นแนวตั้งในภาพได้ โปรดทราบว่า 1 หมายถึงสีดำ 0 หมายถึงสีเทา และ -1 หมายถึงสีขาว
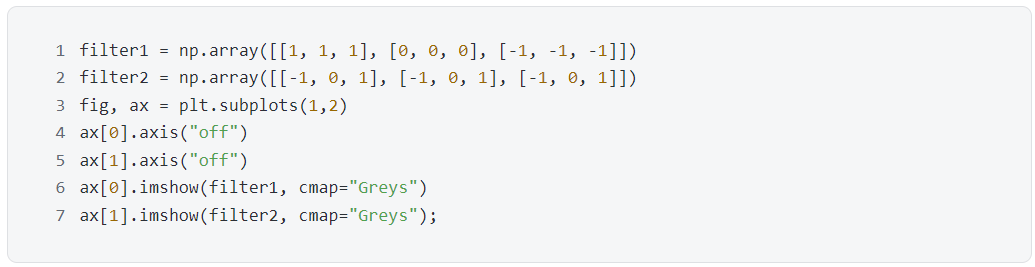
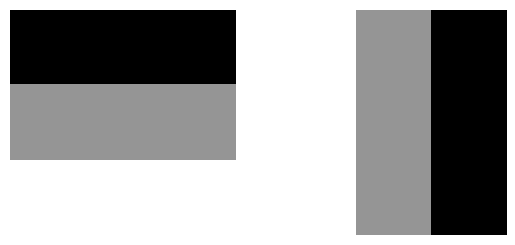
เรามาดูวิธีการดึงข้อมูลทั้ง 2 ฟิลเตอร์กัน ภาพต้นฉบับมีดังนี้
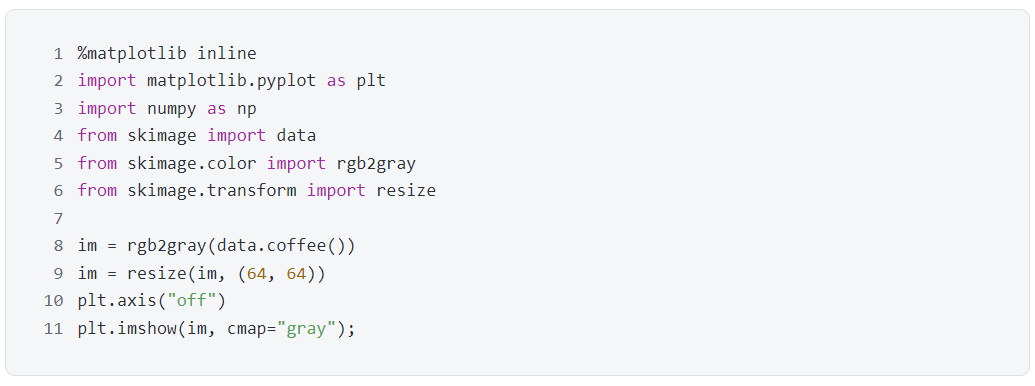
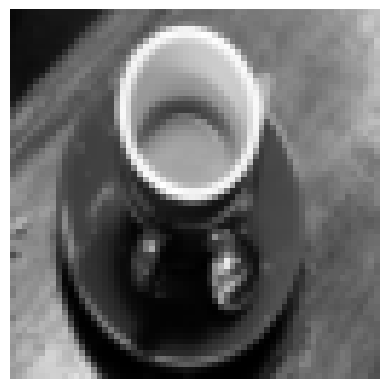
หาได้ไม่ยากว่าฟิลเตอร์ 1 จะดึงข้อมูลขอบแนวนอนจากรูปภาพ เช่น ขอบบนและล่างของปากถ้วย
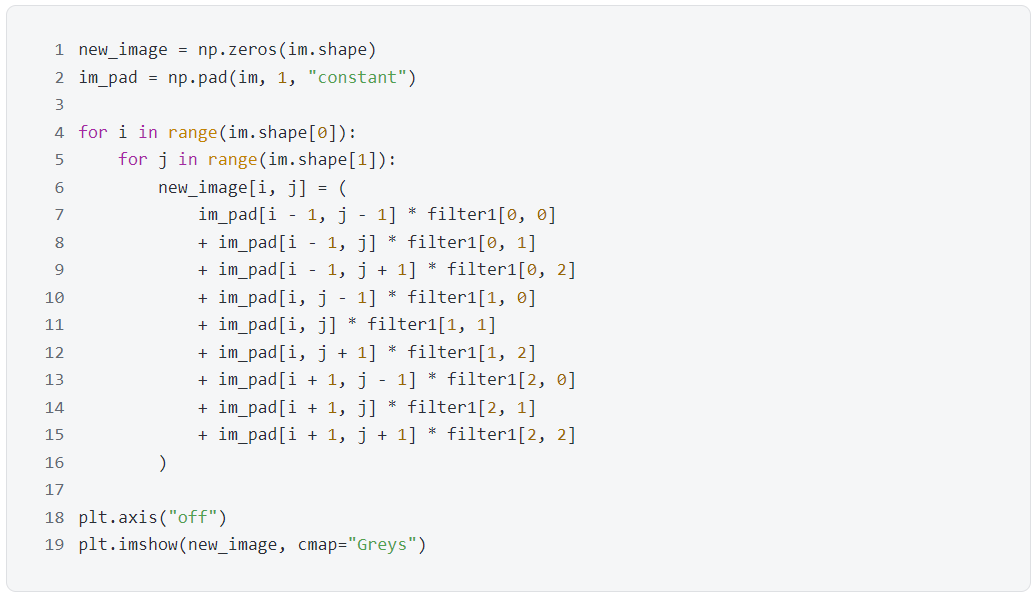
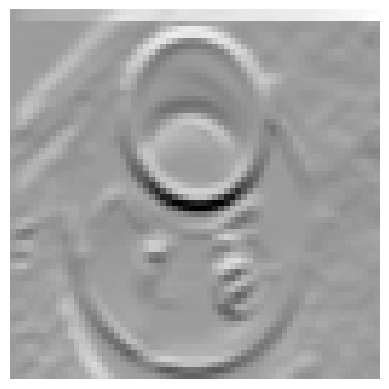
หาได้ไม่ยากว่าฟิลเตอร์ 2 จะดึงข้อมูลขอบแนวตั้งออกจากภาพ เช่น ขอบซ้ายและขวาของปากถ้วย
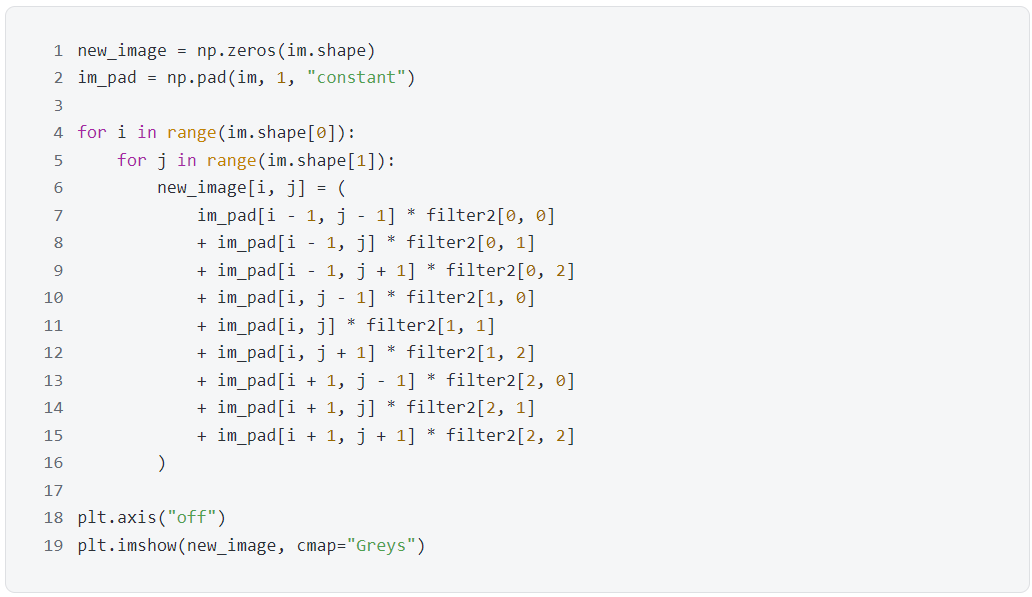
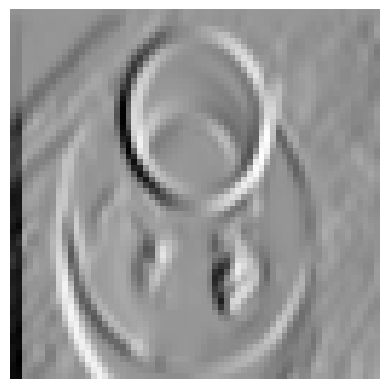
ด้วยการเพิ่มตัวกรอง เราสามารถสร้างได้ชั้นบิด(ชั้น Convoluational) โดยพื้นฐานแล้วเลเยอร์แบบหมุนวนนั้นเป็นชุดของตัวกรอง ในตัวอย่างด้านล่าง ตัวเลขคือ 2 และค่าองค์ประกอบในตัวกรองเรียกว่าตุ้มน้ำหนักซึ่งเรียนรู้จากการฝึกอบรม CNN
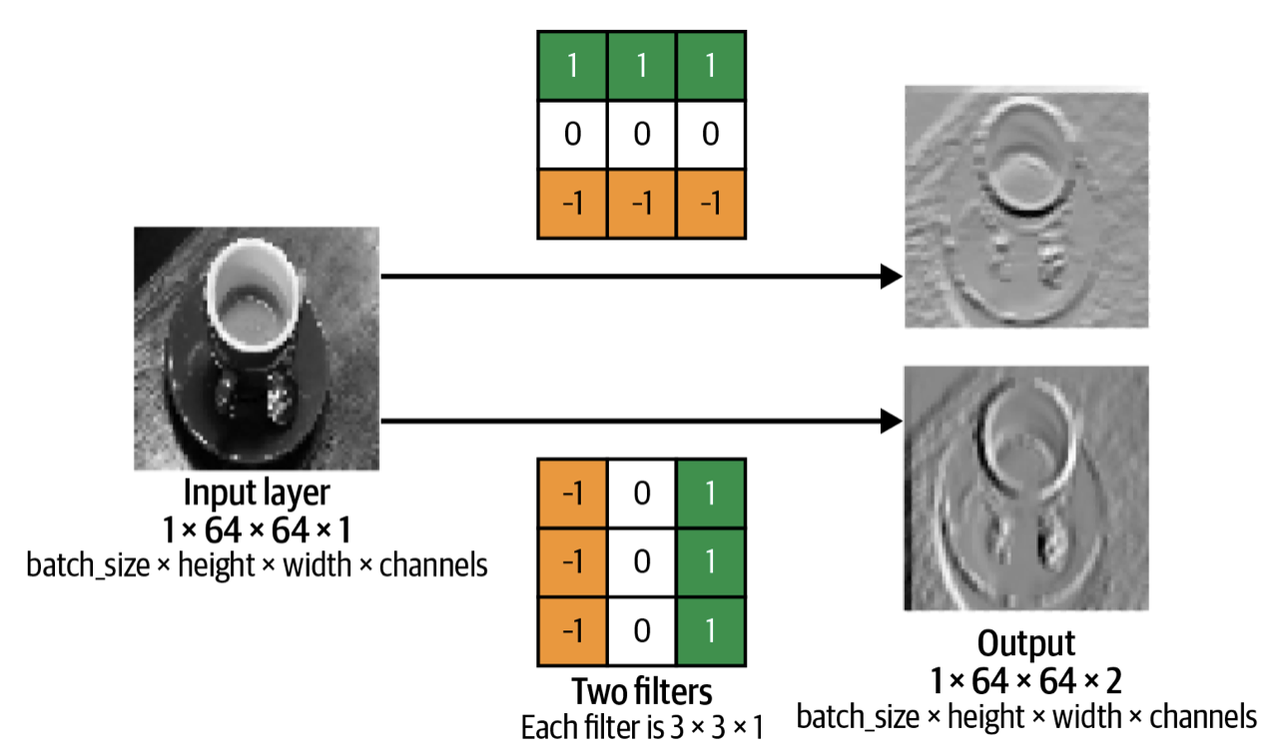
ใช้ในเกะระlayers.Con v 2 D() เพื่อสร้างเลเยอร์แบบหมุนวน ที่นี่ภาพถ่ายขาวดำคือ 64* 64* 1 (มีเพียง 1 ช่องสี) และมีฟิลเตอร์สองตัว (ตั้งค่าฟิลเตอร์พารามิเตอร์เป็น 2) และขนาดฟิลเตอร์คือ 3* 3 (ตั้งค่าพารามิเตอร์ kernel_size ถึง (3, 3))
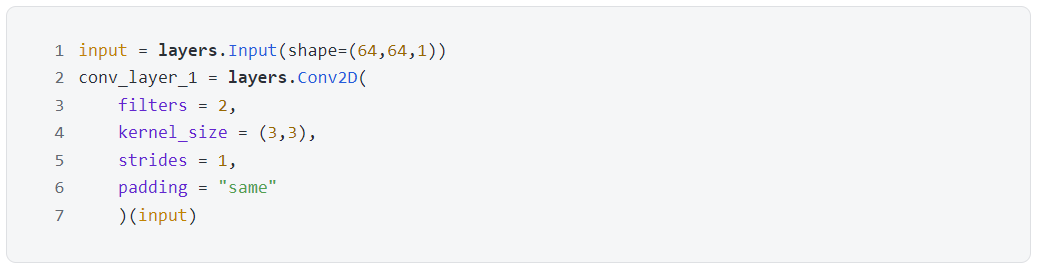
พารามิเตอร์สองตัวที่ก้าวย่างและช่องว่างภายในคืออะไร?
ความยาวขั้นตอน
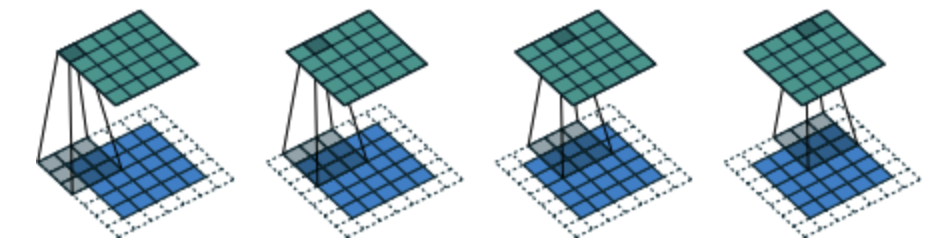
ขนาดขั้นตอนคือจำนวนพิกเซลที่ตัวกรองเคลื่อนที่เมื่อเคลื่อนที่ผ่านรูปภาพ ค่าเริ่มต้นคือ 1 ซึ่งหมายความว่าตัวกรองจะย้ายทีละพิกเซล เมื่อก้าวเป็น 2 ไม่ใช่เรื่องยากที่จะจินตนาการว่าขนาดภาพที่ส่งออกจะมีขนาดเพียงครึ่งหนึ่งของภาพที่นำเข้า
การขยายความ
การเสริมตามชื่อคือการเพิ่มองค์ประกอบรอบๆ รูปภาพ เมื่อเติม ="same"เมื่อก้าว = 1 จะสามารถมั่นใจได้ว่าภาพที่ส่งออกจะมีขนาดเท่ากับภาพที่นำเข้า ขนาดภาพที่ป้อนเข้าในรูปด้านล่างคือ 5*5 (ภาพสีฟ้า) หลังจากเติมแล้ว ขนาดภาพจะกลายเป็น 7*7 (ภาพสีขาว) ขนาดฟิลเตอร์คือ 3*3 (สีเทา) และขนาดภาพที่ส่งออกยังคงอยู่ที่ 5 *5 (ภาพสีเขียว)
ชื่อรอง
3.2 เลเยอร์ Convolutional ที่ต่อกัน
ดูโค้ดก่อน:
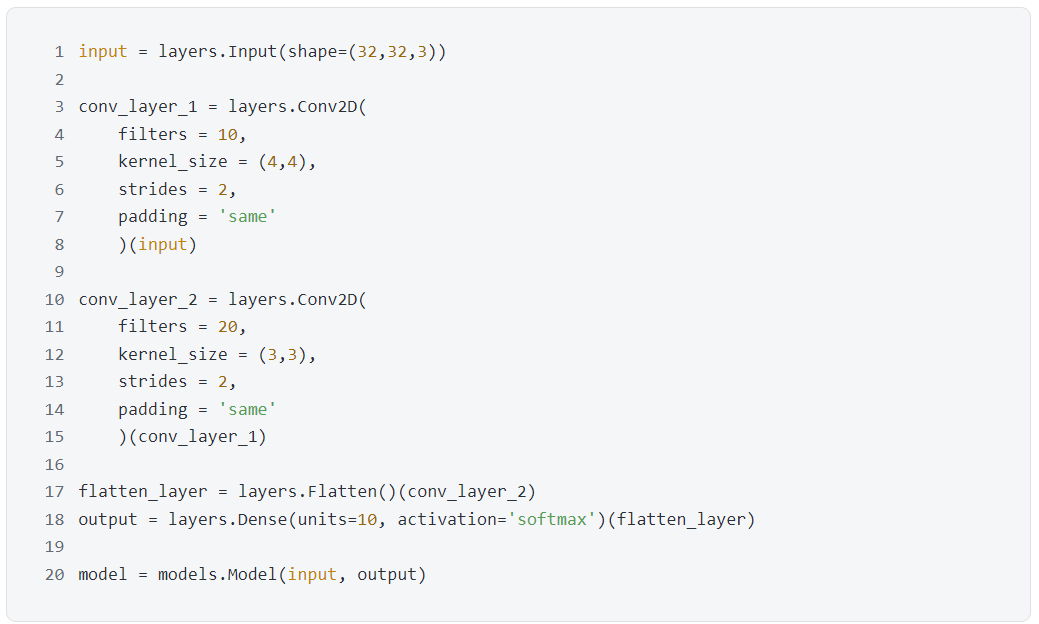
รหัสด้านบนสอดคล้องกับภาพด้านล่าง
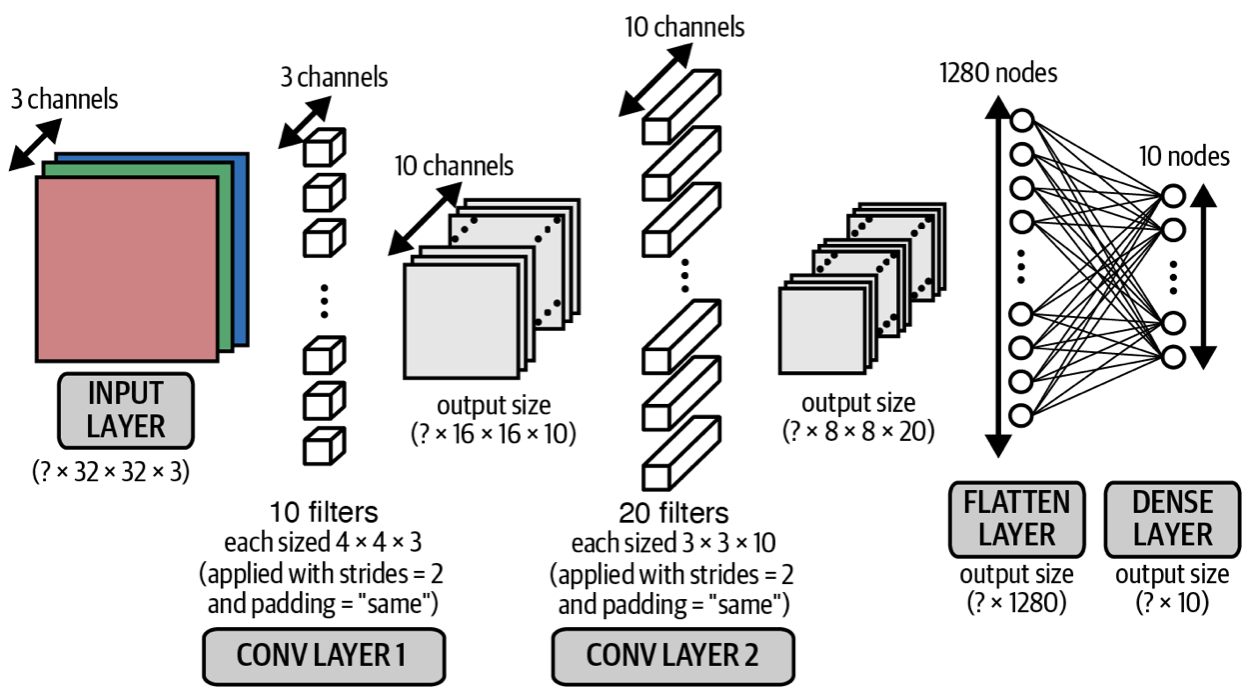
ขนาดของเอาต์พุตของแต่ละเลเยอร์การบิดด้านบนนั้นน่าทึ่งมาก ถ้าคุณใช้ nI แสดงถึงขนาดของภาพที่นำเข้าf หมายถึงขนาดของตัวกรองsหมายถึงขนาดขั้นตอนpหมายถึงจำนวนชั้นเติมnOแสดงถึงขนาดของภาพที่นำเข้าแล้วมีความสัมพันธ์ดังต่อไปนี้:
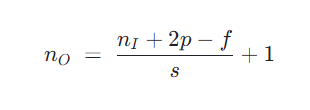
ใช้สูตรนี้เพื่อตรวจสอบความกว้างและความสูงของเอาต์พุตของเลเยอร์การบิดที่หนึ่งและที่สอง:
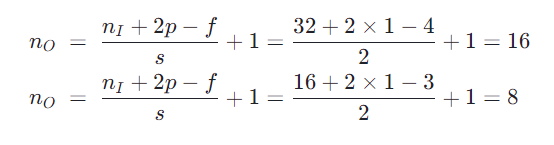
มาถึงสิ่งสำคัญที่สุดก็คือช่องสีเอาต์พุตของเลเยอร์ Convolutional เท่ากับจำนวนตัวกรอง (นั่นคือตัวกรองพารามิเตอร์ในโค้ด). ความเข้าใจโดยสัญชาตญาณคือ ตัวกรองแต่ละตัวจะทำการบิดภาพ สแกน ในแบบคู่ขนาน ดังนั้นผลลัพธ์สุดท้ายจะต้องมีขนาดมิติเท่ากับจำนวนตัวกรอง
ตรวจสอบรุ่น
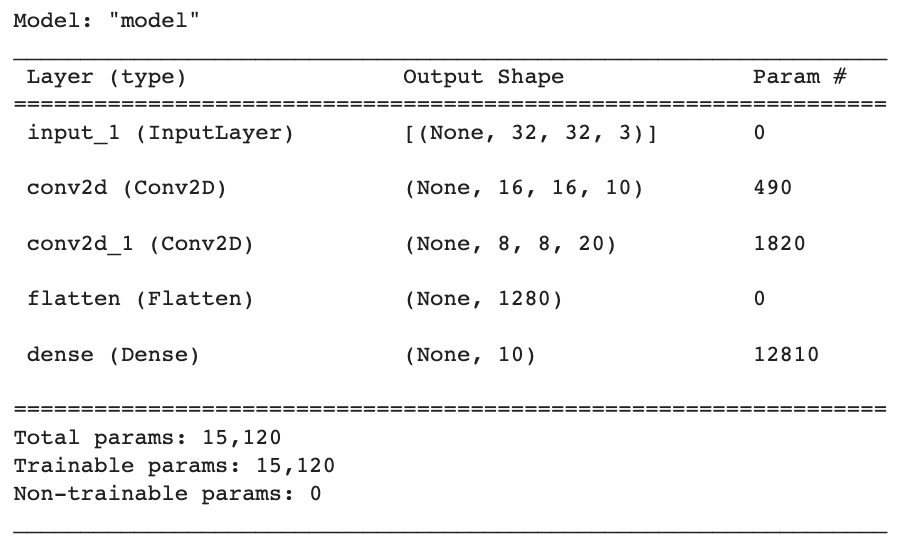
โมเดลจะมีชื่อว่า model โดยอัตโนมัติ ตามด้วยตารางที่อธิบายประเภทชื่อ (เลเยอร์ (ประเภท)) รูปร่างเอาต์พุต (รูปร่างเอาต์พุต) และจำนวนพารามิเตอร์ (Param #) ของแต่ละเลเยอร์ มาดูกันทีละชั้นครับ
เลเยอร์ InputLayer มีชื่อว่า input_ 1 และรูปร่างเอาต์พุตคือ [None, 32, 32, 3 ] องค์ประกอบสามรายการสุดท้ายสอดคล้องกับความกว้าง ความสูง และช่องสีของภาพ องค์ประกอบแรก None แสดงถึงจำนวนตัวอย่างจริง ๆ อย่างเคร่งครัดยิ่งขึ้น พูดก็คือ จำนวนตัวอย่างในชุด เพื่อความกระชับของโค้ด โดยปกติแล้วหมายเลขตัวอย่างนี้ไม่จำเป็นต้องเขียนอย่างชัดเจนเมื่อสร้างโมเดล
เลเยอร์ Con v 2 D แรกชื่อ con v 2 d รูปร่างเอาต์พุตคือ [None, 16, 16, 10 ] พารามิเตอร์ 490 = ( 4* 4* 3 + 1) * 10 ก่อนอื่นเลย ลืมที่จะมีอคติ ถัดไป 4* 4 คือขนาดของฟิลเตอร์ และ 3 คือจำนวนช่องสีอินพุต ดังนั้นเราจึงต้องใช้น้ำหนัก 4* 4* 3 เพื่ออธิบายแต่ละฟิลเตอร์ และมีทั้งหมด 10 อัน
เลเยอร์ Con v 2 D ที่สองชื่อ con v 2 d_ 1 รูปร่างเอาต์พุตคือ [None, 8, 8, 20 ] พารามิเตอร์ 1, 820 = ( 3* 3* 10 + 1) * 20 ก่อนอื่นให้พิจารณา เหมือนกัน หน่วยอคติตามด้วย 3* 3 คือขนาดของตัวกรอง และ 10 คือจำนวนช่องสีอินพุต ดังนั้นเราจึงต้องใช้น้ำหนัก 3* 3* 10 เพื่ออธิบายตัวกรองนี้ รวมเป็น 20
เลเยอร์ที่ราบเรียบมีชื่อว่าราบเรียบ 1, 280 คือจำนวน 8* 8* 20 หลังจากการราบเรียบ และจำนวนพารามิเตอร์คือ 0 เนื่องจากการราบเรียบเป็นเพียงการปรับรูปร่างอาร์เรย์ใหม่ และไม่จำเป็นต้องใช้พารามิเตอร์ใดๆ เพื่อดำเนินการปรับรูปร่างใหม่ให้เสร็จสมบูรณ์
เลเยอร์ Dense สุดท้ายมีชื่อว่า Dense รูปร่างเอาต์พุตคือ 10 พารามิเตอร์ 12, 810 = (1280 + 1) * 10 ให้พิจารณาหน่วยอคติด้วย
ที่ด้านล่าง พารามิเตอร์ทั้งหมด (พารามิเตอร์ทั้งหมด) 15, 120 พารามิเตอร์ที่สามารถฝึกได้ (พารามิเตอร์ที่สามารถฝึกได้) 15, 120 และพารามิเตอร์ที่ไม่สามารถฝึกได้ (พารามิเตอร์ที่ไม่สามารถฝึกได้) 0 จะถูกแสดงรายการด้วย
ณ จุดนี้ โดยพื้นฐานแล้ว CNN ได้ถูกสร้างขึ้น และเราได้เพิ่มเทคนิคอีกสองประการเพื่อทำให้ CNN ทำงานได้ดีขึ้น:การทำให้เป็นมาตรฐานแบบแบตช์(การทำให้เป็นมาตรฐานแบบแบตช์) และชื่อรอง (dropout)。
3.3 การทำให้เป็นมาตรฐานแบบแบตช์
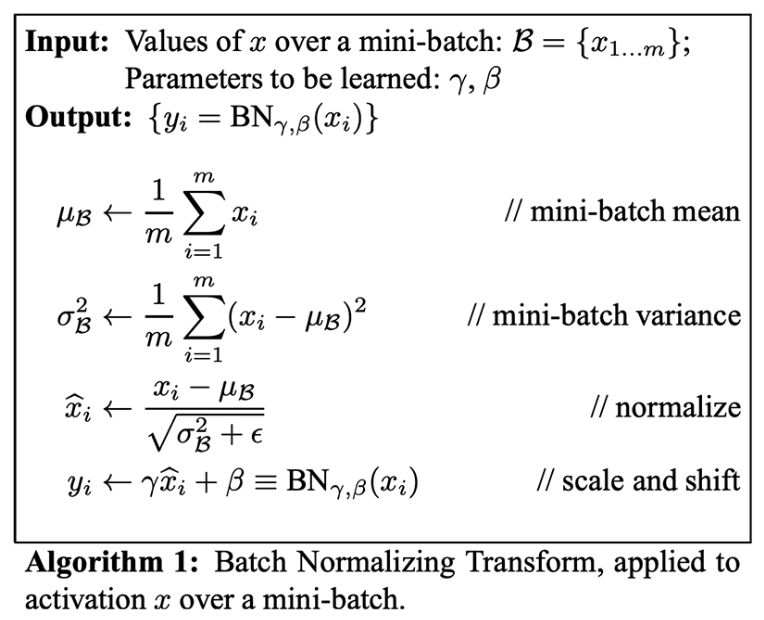
เมื่อฝึก CNN กุญแจสู่ความสำเร็จของโมเดลคือต้องแน่ใจว่าตุ้มน้ำหนักยังอยู่ในช่วงที่กำหนด มิฉะนั้นจะเกิดการไล่ระดับสีแบบระเบิด การทำให้เป็นมาตรฐานแบบแบทช์สามารถแก้ปัญหานี้ได้ โดยจะคำนวณข้อมูลตามแบทช์ (มินิแบทช์) ในแต่ละเลเยอร์เฉลี่ย(หมายถึง) และส่วนเบี่ยงเบนมาตรฐาน(ค่าเบี่ยงเบนมาตรฐาน) แล้วลบค่าเฉลี่ยหารด้วยค่าเบี่ยงเบนมาตรฐานในแต่ละข้อมูล ในการ กู้คืน ข้อมูล เราจำเป็นต้อง เรียนรู้ พารามิเตอร์สองตัว นั่นคือพารามิเตอร์การปรับขนาดγและพารามิเตอร์การแปลβ。
อัลกอริธึมการทำให้เป็นมาตรฐานแบบแบตช์มีดังนี้:
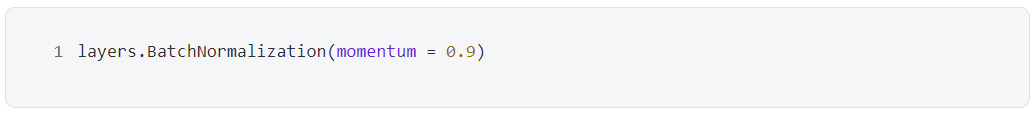
BatchNormalization() ใช้ใน Keras เพื่อให้เกิดการทำให้เป็นมาตรฐานแบบแบตช์ โดยทั่วไปชั้นการทำให้เป็นมาตรฐานแบบแบทช์จะถูกวางไว้หลังชั้นหนาแน่นหรือชั้นแบบม้วน
ชื่อรอง
3.4 การปิดใช้งานแบบสุ่ม
การสุ่มได้รับแรงบันดาลใจจากการสอบ โดยปกติก่อนสอบ นักเรียนจะทำข้อสอบจากปีก่อนๆ เพื่อเรียนรู้ประเด็นความรู้ นักเรียนบางคนแก้ปัญหาโดยการท่องจำ ดังนั้นพวกเขาจะทำได้ไม่ดีในการทดสอบจริงเพราะพวกเขาไม่เข้าใจประเด็นความรู้จริงๆ นักเรียนที่ดีจะใช้ข้อสอบเพื่อทำความเข้าใจประเด็นความรู้ทั่วไป เพื่อให้สามารถตอบคำถามใหม่ๆ ได้อย่างถูกต้อง
ในทำนองเดียวกัน เพื่อป้องกันไม่ให้โครงข่ายประสาทเทียม การท่องจำแบบท่องจำ เราสามารถสุ่มปิดการใช้งานเซลล์ประสาทบางตัวได้ นั่นคือทำให้เอาต์พุตของพวกมันเป็น 0 ดังแสดงในรูปด้านล่าง
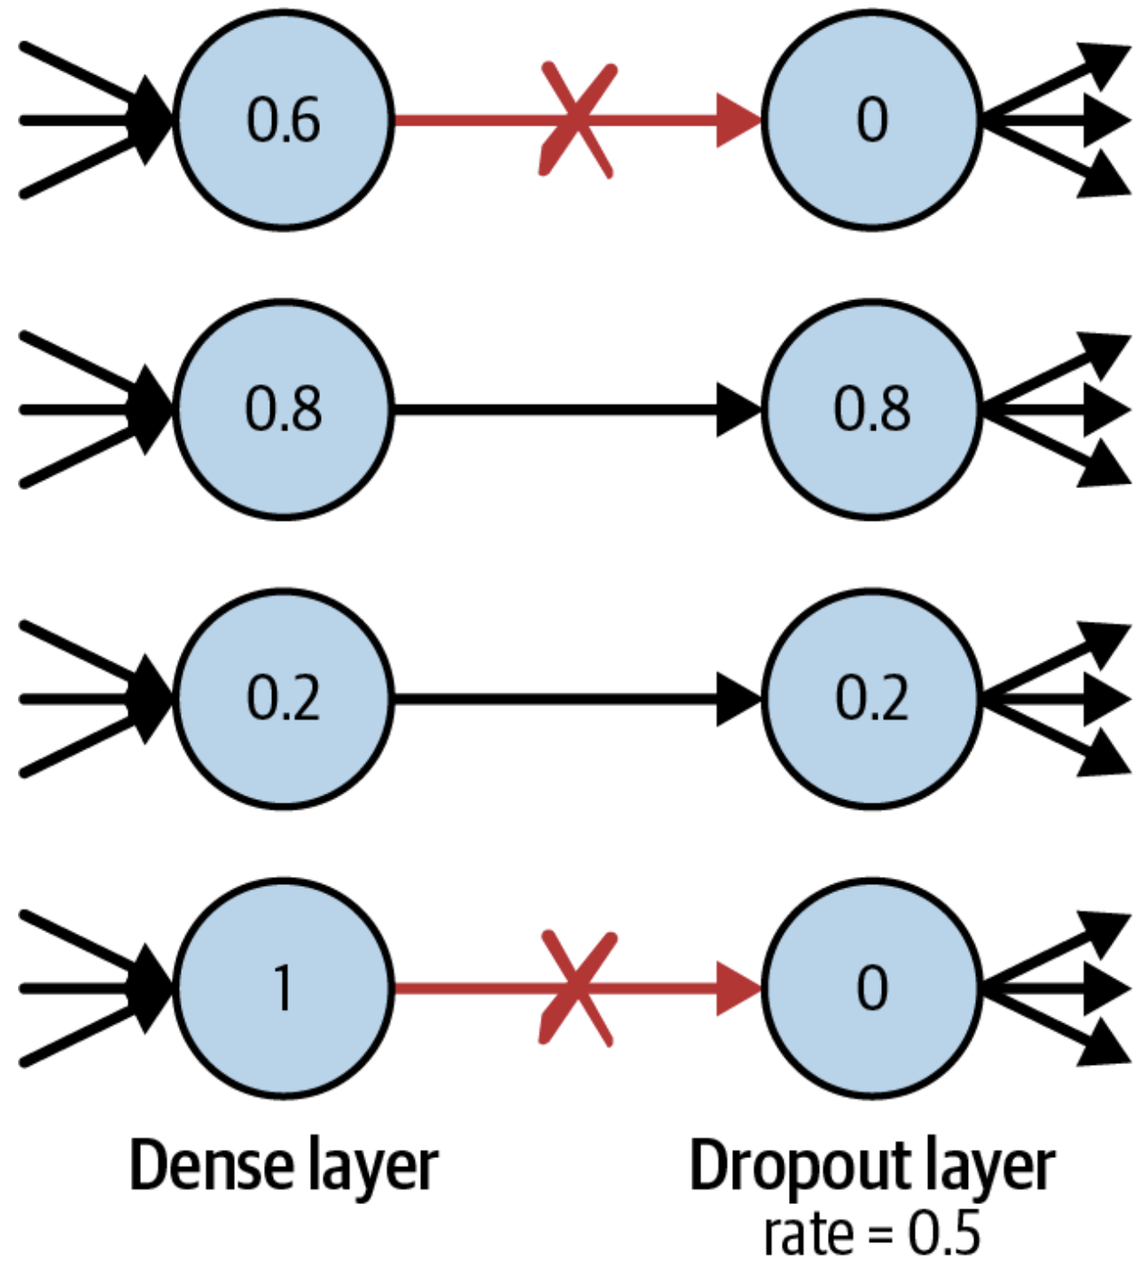
ในระหว่างกระบวนการทำนาย เซลล์ประสาทจะไม่ถูกปิดใช้งาน ดังนั้นจึงใช้โครงข่ายประสาทเทียมที่สมบูรณ์ในการคาดการณ์
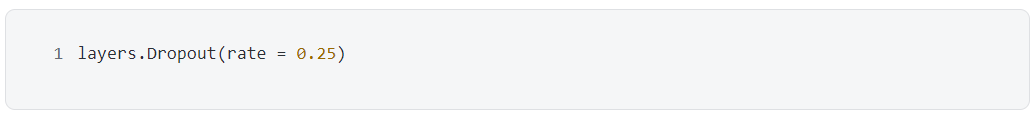
ใช้ในเกะระDropout()เพื่อรับรู้ถึงชั้นการปิดใช้งาน โดยทั่วไปชั้นปิดการใช้งานจะวางอยู่หลังชั้นที่มีความหนาแน่นสูง
ชื่อรอง
3.5 โมเดลที่สมบูรณ์
ตอนนี้เราสามารถเพิ่มเลเยอร์การทำให้เป็นมาตรฐานแบบแบตช์และเลเยอร์การปิดการใช้งานให้กับ CNN ก่อนหน้าเพื่อปรับปรุงโมเดลได้
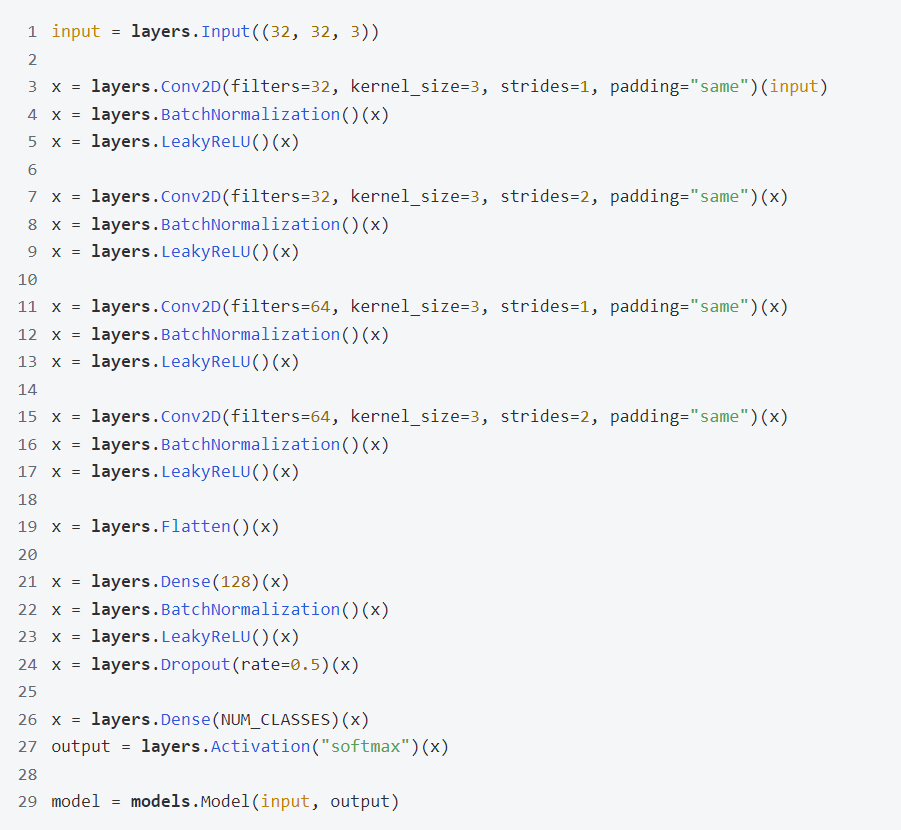
ดูว่าโค้ดด้านบนเข้าใจง่ายหรือไม่ CNN มีเลเยอร์ Convolutional สี่เลเยอร์ แต่ละเลเยอร์ตามด้วยเลเยอร์ Normalization แบบแบตช์และเลเยอร์ LeakyReLu โปรดทราบว่าทุกอย่างใน Keras สามารถใช้เป็นเลเยอร์ได้ แม้แต่ฟังก์ชั่นการเปิดใช้งานก็สามารถนำมาใช้ในรูปแบบของเลเยอร์ได้ จากนั้นใช้เลเยอร์ที่ราบเรียบเพื่อทำให้ข้อมูลราบเรียบ จากนั้นใช้เลเยอร์หนาแน่น เลเยอร์การทำให้เป็นมาตรฐานแบบแบตช์ เลเยอร์ LeakyReLu เลเยอร์การปิดใช้งาน และเลเยอร์ที่มีความหนาแน่น และสุดท้ายใช้ softmax เพื่อส่งออกในรูปแบบของความน่าจะเป็น
ลองดูโมเดล CNN ที่ได้รับการปรับปรุงนี้
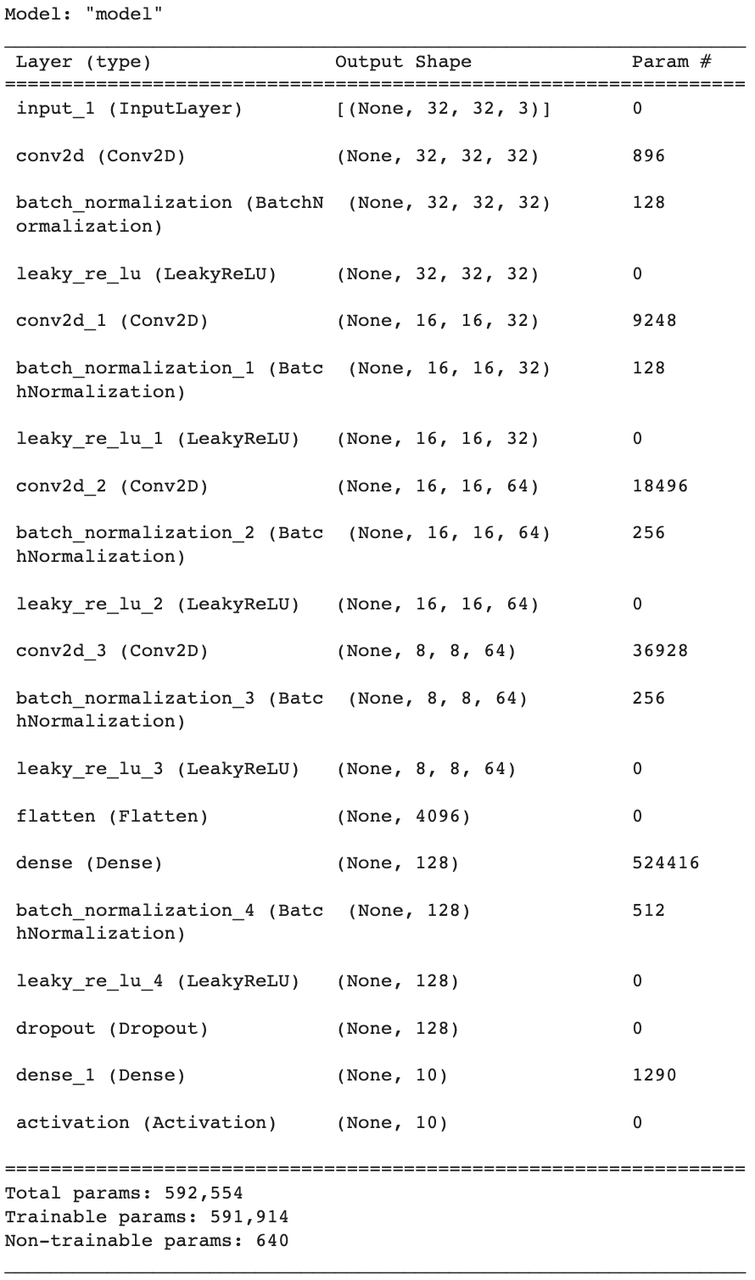
เราพบว่าเลเยอร์การเปิดใช้งานไม่มีพารามิเตอร์เนื่องจากเป็นการเปลี่ยนแปลง เลเยอร์ที่ราบเรียบและเลเยอร์การเปิดใช้งานไม่มีพารามิเตอร์ซึ่งเข้าใจได้ง่ายเช่นกัน สำหรับปริมาตรพารามิเตอร์ของเลเยอร์ convolutional และเลเยอร์หนาแน่น มีการอธิบายอัลกอริทึมไว้ก่อนหน้านี้แล้ว สำหรับการทำให้เป็นมาตรฐานแบบแบตช์ จำเป็นต้องเรียนรู้พารามิเตอร์การปรับขนาดสำหรับแต่ละช่องสัญญาณγและพารามิเตอร์การแปลβและค่าเฉลี่ยเคลื่อนที่และค่าเบี่ยงเบนมาตรฐานเคลื่อนที่ เพื่อให้พารามิเตอร์ที่รวมไว้เท่ากับจำนวนช่องสัญญาณ * 4
ชื่อรอง
3.6 การประเมินผลการฝึกอบรม
ทุกอย่างพร้อมแล้ว มีเพียงการฝึกอบรมเท่านั้นที่จำเป็น ครั้งนี้ เราได้เพิ่มพารามิเตอร์ validation_data เพื่อตรวจสอบว่าโมเดลมีการติดตั้งมากเกินไปในระหว่างการฝึกหรือไม่ และการติดตั้งมากเกินไปเกิดขึ้นเมื่อข้อผิดพลาดในการฝึก (สูญเสีย) ลดลง แต่ข้อผิดพลาดในการตรวจสอบ (val_loss) เพิ่มขึ้น จากภาพด้านล่างไม่มีปัญหาดังกล่าวครับ
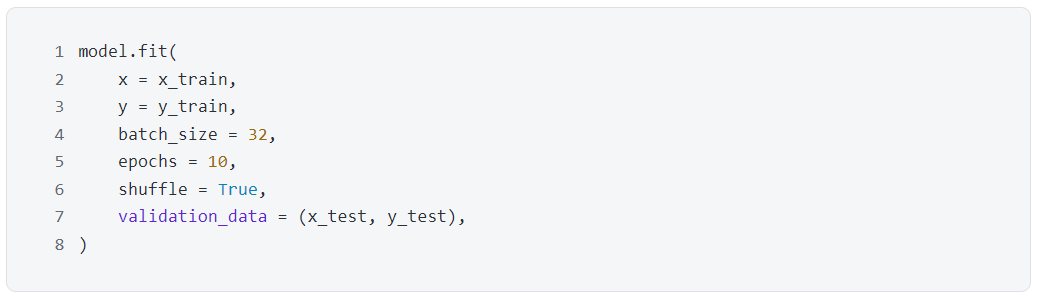
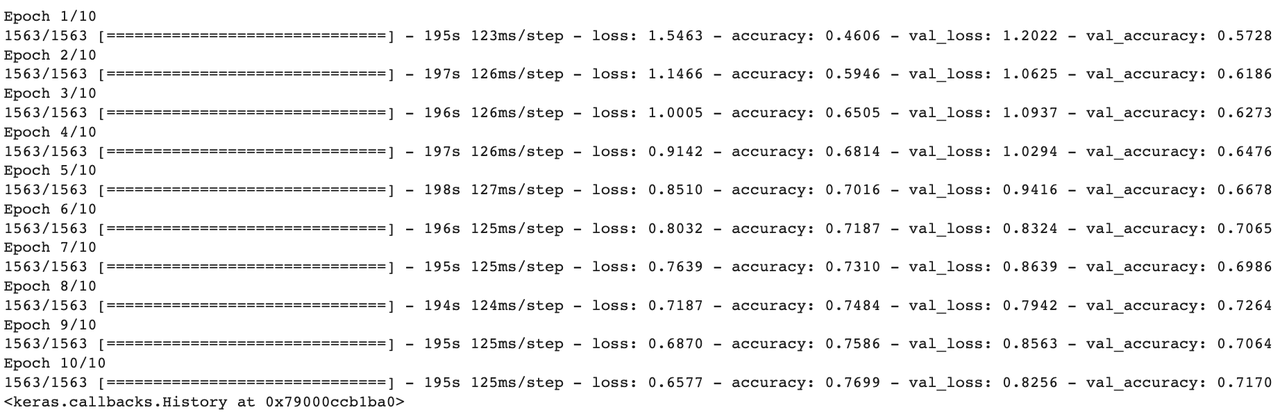
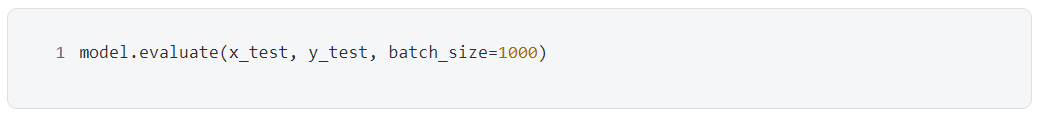

เมื่อเปรียบเทียบกับโครงข่ายประสาทเทียมแบบหมุนวน (CNN) ในปัจจุบันและโครงข่ายประสาทเทียมแบบป้อนล่วงหน้า (FNN) ก่อนหน้านี้ ความแม่นยำของโมเดลที่มีอยู่ในชุดการฝึกเพิ่มขึ้นจาก 51.39% เป็น 76.99% และความแม่นยำในชุดการฝึกก็เพิ่มขึ้นจาก 49.52% สูงถึง 71.70% ประสิทธิภาพของโมเดลได้รับการปรับปรุงอย่างมาก
น่าประหลาดใจที่พารามิเตอร์ของ CNN (592, 554) จริงๆ แล้วน้อยกว่าพารามิเตอร์ของ FNN (646, 260) มาก แต่ประสิทธิภาพของโมเดลได้รับการปรับปรุงอย่างมาก และการปรับปรุงนี้จำเป็นต้องเปลี่ยนสถาปัตยกรรมโมเดลเพื่อรวมเลเยอร์แบบ Convolutional เท่านั้น แบทช์ สามารถรับรู้ได้โดยการทำให้เลเยอร์หนึ่งเป็นมาตรฐานและปิดการใช้งานเลเยอร์ แม้ว่า CNN จะมีพารามิเตอร์น้อยกว่า FNN แต่จำนวนเลเยอร์นั้นมากกว่ามาก ซึ่งเป็นเหตุผลว่าทำไมข้อดีของโครงข่ายประสาทเทียมระดับลึก เนื่องจากเลเยอร์กลางของเครือข่ายจับคุณลักษณะระดับสูงที่เราสนใจมากที่สุด
สรุป
สรุป
บทความนี้แนะนำแนวคิดหลักของการเรียนรู้เชิงลึกที่จำเป็นในการเริ่มสร้างแบบจำลองเชิงลึก ใช้ Keras เพื่อสร้าง feed-forward neural network (FNN) และฝึกฝนโมเดลเพื่อทำนายคลาสของรูปภาพที่กำหนดในชุดข้อมูล CIFAR-10 จากนั้นเราจะปรับปรุงสถาปัตยกรรมนี้โดยการแนะนำเลเยอร์แบบหมุนวน เลเยอร์การทำให้เป็นมาตรฐานแบบแบทช์ และเลเยอร์การปิดใช้งานเพื่อสร้างโครงข่ายประสาทเทียมแบบหมุนวน (CNN)
การออกแบบโครงข่ายประสาทเทียมแบบลึกนั้นมีความยืดหยุ่นอย่างสมบูรณ์และมีแนวทางปฏิบัติที่ดีที่สุดเท่าที่จะเป็นไปได้ แต่เรามีอิสระที่จะลองใช้เลเยอร์ต่างๆ และลำดับที่ปรากฏ การใช้ Keras นั้นราบรื่นพอๆ กับการสร้างบล็อก Lego การออกแบบของคุณ โครงข่ายประสาทเทียมต้องการเพียงการจำกัดด้วยจินตนาการของคุณเอง
คุณสามารถค้นหา SignalPlus ใน Plugin Store ของ ChatGPT 4.0 เพื่อรับข้อมูลการเข้ารหัสแบบเรียลไทม์ หากคุณต้องการรับข้อมูลอัปเดตของเราทันที โปรดติดตามบัญชี Twitter ของเรา @SignalPlus_Web 3 หรือเข้าร่วมกลุ่ม WeChat ของเรา (เพิ่มผู้ช่วยตัวน้อย WeChat: chillywzq) กลุ่ม Telegram และชุมชน Discord เพื่อสื่อสารและโต้ตอบกับเพื่อน ๆ มากขึ้น
คุณสามารถค้นหา SignalPlus ใน Plugin Store ของ ChatGPT 4.0 เพื่อรับข้อมูลการเข้ารหัสแบบเรียลไทม์ หากคุณต้องการรับข้อมูลอัปเดตของเราทันที โปรดติดตามบัญชี Twitter ของเรา @SignalPlus_Web 3 หรือเข้าร่วมกลุ่ม WeChat ของเรา (เพิ่มผู้ช่วยตัวน้อย WeChat: chillywzq) กลุ่ม Telegram และชุมชน Discord เพื่อสื่อสารและโต้ตอบกับเพื่อน ๆ มากขึ้น
SignalPlus Official Website: https://www.signalplus.com





