


ChatGPT の Web3.0 セキュリティ監査技術: 何かはあるが、まだ十分ではない


2022 年 11 月、OpenAI は革新的な人工知能 (AI) プロジェクトを開始しました。
ChatGPT は、記事の作成や要約、ジョークや詩の作成に役立つだけでなく、デバッグやコード生成にも使用できます。
2022 年 1 年間で、ハッカー攻撃や詐欺などの事件による Web3.0 分野の資産損失は 37 億米ドルを超え、その巨額の損失は業界関係者に「ChatGPT のような新技術は使えるのか」という考えを抱かせました。スマート コントラクト コードのセキュリティを向上させるために使用されます。
分散型ゲーム プラットフォームである ZKasino は最近、ChatGPT を通じて事前監査を受けました。
ZKasinoは、CertiKが包括的な監査を実施する一方で、CertiKがChatGPTの結果の初期レビューを実施して、AIの「スマートコントラクト監査人」として機能するChatGPTの能力をテストすることを期待している。
では、ChatGPT のテスト結果はどうなったのでしょうか?
人間のコード監査専門家の仕事を引き継ぐ準備はできていますか?
それとも人間の労働力を完全に置き換えるにはまだ不十分なのでしょうか?
2022 年 12 月 23 日、ZKasino はスマート コントラクトの潜在的なセキュリティ リスクを特定するために ChatGPT を「雇用」しました。このツールは、表面上は正当なリスク懸念をいくつか引き起こします。
ただし、ChatGPT が Web3. コードにいくつかの価値のあるサービスを提供していることは間違いありませんが、コードは正常に動作します。ここで、CertiK セキュリティ専門家の詳細なデータと提案が、ChatGPT がより強力な Web3.0 アプリケーション セキュリティ ツールになることを願っています。
以下では、今回の事件におけるChatGPTの2種類の誤発見について詳しく紹介していきます。
ChatGPT は契約のどのような問題を発見しましたか?
副題
重大な脆弱性または深刻な脆弱性?
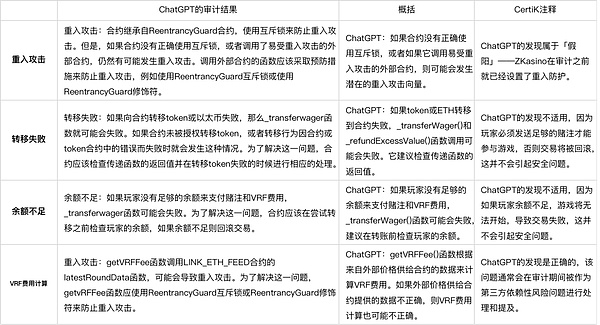
ChatGPT では、多くのスマート コントラクト実装に存在するいくつかの一般的なセキュリティ問題について言及しています。
ただし、次のような特定の重大なリスクを特定できません。
プロジェクト固有のロジックの脆弱性
不正確な数学的計算と統計モデル
コードの実装とプロジェクト設計の間の不一致
バグ #1: プロジェクト固有のロジックの問題
ChatGPT は、攻撃者がバンクロール契約でユーザーの資金を継続的に獲得して流出させることを可能にする重大な脆弱性を特定できませんでした。プレイヤーは検証可能なランダム関数 (VRF) を呼び出すことでゲームに参加でき、Chainlink の VRF は乱数を使用して fillRandomWords() 関数をトリガーし、ゲームを完了します。
ZKasino のコードを使用すると、fulfillRandomWords() 呼び出しが失敗した場合にユーザーが資金を取り戻すことができます。
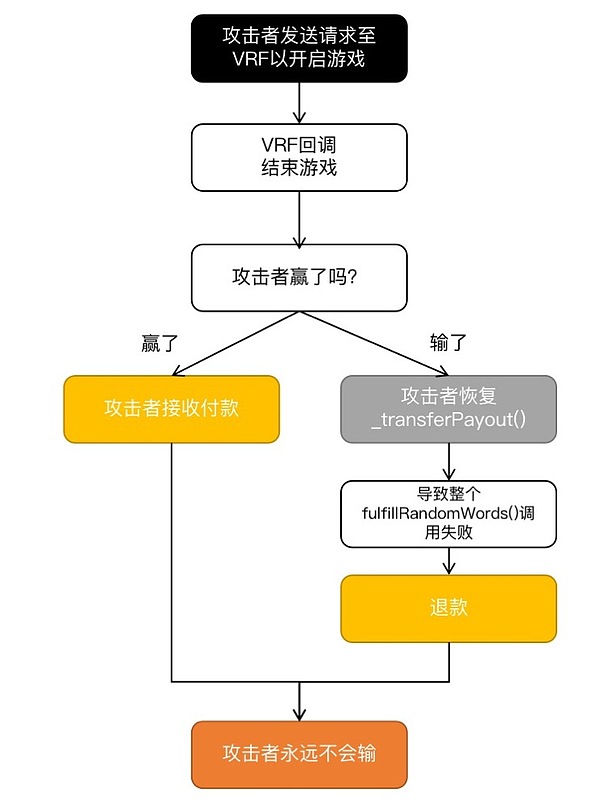
CertiK による同じスマート コントラクト コードのレビュー中に、潜在的に有害な _transferPayout() 呼び出しが発見されました。これは、勝ち金をプレーヤーのアカウントに転送するように設計された関数です。
ただし、攻撃者は負けたときに _transferPayout() を呼び出してロールバックすることができ、その結果、fulfillRandomWords() 呼び出し全体が失敗します。これにより、100 ブロックの待機期間に入り、その後 CoinFlip_Refund() がトリガーされてお金が返されます。攻撃者が金銭を失うことはありません。
ChatGPT は通話失敗の問題を認識していましたが、このプロジェクトでは通話失敗を悪用した攻撃手法を発見できませんでした。
したがって、ChatGPT は、この脆弱性とプロジェクト ロジックを組み合わせた影響を認識していませんでした。特定の攻撃フローの説明については、ZKasino の完全な監査レポートを参照してください。
脆弱性 #2: 不正確な数学計算と統計モデル
ランダム性と結果が合理的な期待を確実に満たすことは、どのゲーム プロジェクトにおいても重要です。これを確認するには、監査中にすべてのゲーム結果のランダム性を完全に評価する必要があります。
ChatGPTもこの重要性には「同意」したが、不公平なゲーム結果は見出されなかった。これは、VRF の使用と、VRF 契約が破られたり操作されたりした場合に起こり得る不公平な結果をもたらします。
「VRF 契約が安全でない場合、または操作されている場合、ゲームで不公平な結果が生じる可能性があります。」
ただし、この結論は単なる結論であり、不公平なゲーム結果の根本原因に実際に対処するものではありません。また、監査プロセス中にランダム性に関する潜在的なリスクの問題もいくつか見つかりました。
不公平なランダム性
ランダム性に関して見つかった中レベルのリスクの 1 つは、ビデオポーカー ゲームでの乱数の不当な使用であり、プレーヤーが特定のカードを入手する機会が少なくなっていました。
小数点以下切り捨て
別のリスクの問題は、プレーヤーが期待される利益を最大化する特定の乗数を選択できるサイコロのようなゲームで見つかります。
脆弱性 #3: コードの実装とプロジェクト設計の間の不一致
ChatGPT は、多くの場合、単一関数の実装を理解できますが、その根本原因は理解できません。
たとえば、特定の機能が技術レベルでどのように実行されるかは理解できますが、スマート コントラクト全体における機能の目的は理解できません。
ChatGPT のコーディングに問題がないことを確認するには、スマート コントラクトのコード ロジックをよりよく理解する必要があります。
現状では、ChatGPT はコードの表面的な読み取りを提供します。監査を機能させ、次のレベルにレベルを上げるには、関数から逆に最初のロジックを推定する方法を学習する必要があります。これは非常に重要です。
間違った入力検証
Plinko コントラクトで、乗数が正しく設定されない原因となる入力検証の問題が見つかりました。
ZKasino によると、Plinko で使用される回線の数は 8 ~ 16 である必要があります。ただし、次のチェックのバグにより、バンクロール コントラクトの所有者は関数 setPlinkoMultipliers() を介して予想範囲外の明細値を設定する可能性があります。
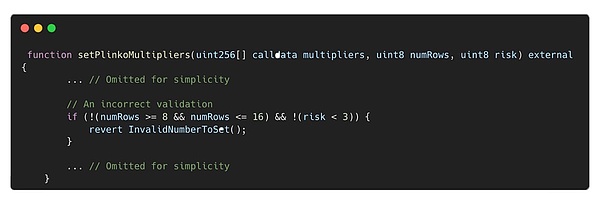
このコードは、numRows もリスクも条件を満たさない場合、プロセスがロールバックされることを示しています。
ただし、2 つの条件のうち 1 つだけが満たされない場合でも、チェックは合格し、コードはロールバックされません。
ChatGPT は 2 番目の質問に対して異なる答えを返します。この関数は、「numRows」の値が 8 ~ 16 の間であるかどうか、および「risk」の値が 3 未満であるかどうかをチェックします。上記の条件のいずれかが満たされない場合、関数はエラー「InvalidNumberToSet」を返します。
ChatGPT はこの機能の目的を理解しているようです。ただし、追加情報がなければ実際の脆弱性を特定するためのアプリケーション知識はありません。
値の更新の不一致
最後に書きます
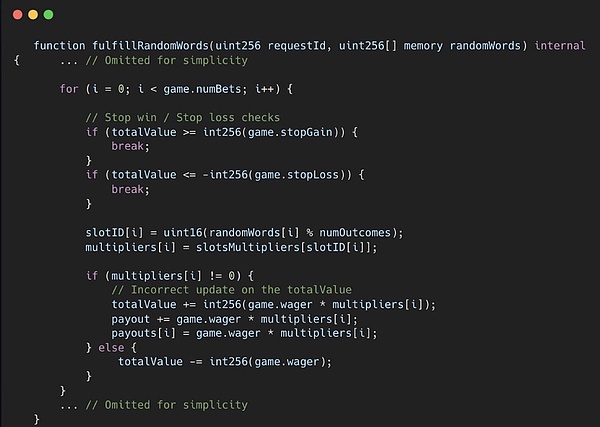
最後に書きます
適切なトレーニングを受けていたにもかかわらず、ChatGPT は監査で特定の重要なセキュリティ問題を見逃していました。これは、人工知能がコードの複雑さとニュアンスを完全に理解するのに限界があることと、現実世界のシナリオでの実践経験が不足しているためです。
公式ウェブサイトに記載されているように、ChatGPT は会話に自然言語処理を利用する研究バージョンです。人間の監査専門家と同じようには、コードの背後にある意図や論理的推論を理解できないことがよくあります。
したがって、全体的な正確性を確保するには、経験豊富なセキュリティ専門家による手動監査で ChatGPT の分析を補完することが重要です。
以下の図は、人間ベースのサービスと ChatGPT の長所と短所をさまざまな基準で示しています。
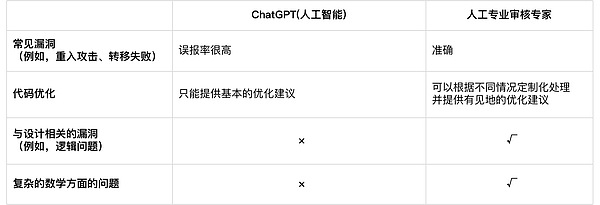
Baidu 翻訳を使用するのと同じように、英語の翻訳結果の精度は中国語の表現に依存することがよくあります。ChatGPT の回答の有効性はプロンプトに大きく依存します (プロンプトは JavaScript 言語のメソッドで、主な用途はプロンプト ダイアログを表示することです) )。
このペーパーでは、ChatGPT と対話する ZKasino の事前監査の結果と、CertiK の専門家によって実行された最終監査の結果を比較します。
テクノロジーが進歩し、プロンプト エンジニアリングに対する理解が深まるにつれて、エンジニアは ChatGPT をより適切に活用できるようになります。
CertiK 公式公開アカウントの次のリリースでは、ChatGPT に効果的な質問をする方法に関するプロンプト プロジェクトのより詳細な内容について説明します。
しかし今では、ChatGPT は、キャプチャ ザ フラッグ コンテストへの参加にも役立ちます。[AI に記事を書かせたり、コードを分析させたり、CTF キャプチャ ザ フラッグで競い合ったりもします。】ようこそクリックして読んでください!





