


Jev suddenly กลายเป็นไวรัล: ไม่พูดคุย ไม่เขียนโค้ด ทำแค่ตัดสินใจ


- จุดสำคัญ:สมาชิกหลักรุ่นแรกของ OpenAI เปิดตัวโมเดล Jev มุ่งเน้นการตัดสินใจและการส่งออกความน่าจะเป็นที่มีต้นทุนต่ำและความเร็วสูง เชื่อว่าในยุค Agent AI ระบบอัตโนมัติต้องการการตัดสินใจที่รวดเร็วจำนวนมหาศาล ไม่ใช่การสนทนาเชิงลึก ตั้งคำถามต่อความเหมาะสมของกระบวนทัศน์ RLHF ในสถานการณ์ระบบอัตโนมัติ
- องค์ประกอบสำคัญ:
- Jev ทำเพียงการตัดสินใจ 3 ประเภท ได้แก่ Yes/No การเลือก และการให้คะแนน ส่งออกผลลัพธ์และความน่าจะเป็นโดยตรง ความหน่วงแบบ end-to-end 70-500 มิลลิวินาที ต้นทุนต่ออินพุต 1 ล้านโทเคนเพียง 0.042 ดอลลาร์
- การทดสอบ TypeSafe แสดงให้เห็นว่า Jev เร่งความเร็วได้สูงสุด 193.6 เท่า ลดต้นทุนได้ 444.6 เท่า มีนักพัฒนาที่ใช้งานแล้วสำหรับการวิเคราะห์โฆษณา การทำความสะอาดบริบท และการประเมินงานของ Agent
- ผู้ก่อตั้ง Diogo Almeida เคยมีส่วนร่วมในการพัฒนา GPT-4 และ RLHF ปัจจุบันสะท้อนว่า RLHF ที่ฝังความชอบของมนุษย์เข้าไปในการฝึก ทำให้ AI สัญญามากเกินไปและไม่สามารถทำงานระบบอัตโนมัติได้ด้วยตัวเอง
- TypeSafe เสนอวิธีการฝึก RLCD ซึ่งแกนหลักคือทำให้ความเชื่อมั่นของความน่าจะเป็นที่โมเดลส่งออกมีความแม่นยำและสอบเทียบได้จริง เพื่อรองรับการตัดสินใจแบบแบ่งระดับในระบบอัตโนมัติ
- Jev ถูกกำหนดให้เป็น "System One Model" รับผิดชอบการตัดสินใจขนาดเล็กที่มีความถี่สูงหลายแสนครั้งต่อวันในการทำงานของ Agent ส่วนการ推理เชิงซับซ้อนยังคง交由โมเดลขนาดใหญ่จัดการ
- ชื่อมาจาก "Jevons Paradox" —— เมื่อต้นทุนการตัดสินใจเข้าใกล้ศูนย์ ปริมาณการเรียกใช้การตัดสินใจของ AI จะไม่ลดลงแต่จะเพิ่มขึ้น
ผู้เขียนต้นฉบับ: Zhu Xueying
แหล่งที่มาต้นฉบับ: 华尔街见闻
สองวันมานี้ มีโมเดล AI ตัวหนึ่งที่ดูผิดปกติ suddenly กลายเป็นไวรัลขึ้นมา
มันชื่อ Jev
ไม่คุยเล่น ไม่เขียนโค้ด แถมยังไม่เหมือน ChatGPT ที่จะสร้างคำตอบยาวๆ ให้คุณ มันทำแค่สิ่งเดียว: ตัดสินใจ
แต่โมเดลที่ดูเหมือน "ความสามารถถูกตัดทิ้งไปกว่าครึ่ง" แบบนี้กลับ suddenly ฮอตขึ้นมาในวงนักพัฒนา
บางคนใช้มันวิเคราะห์โฆษณาเรียลไทม์ 724 ชิ้นใน 40 วินาที รวมตัดสินใจทั้งหมด 8,724 ครั้ง บางคนเอามันไปต่อกับ Claude Code เพื่อเคลียร์ context ที่ไม่มีประโยชน์โดยเฉพาะ และบางคนให้มันเป็น "ผู้ตัดสิน" ให้ AI Agent ตรวจสอบว่างานเสร็จจริงหรือไม่ LangChain ก็เริ่มทดสอบประสิทธิภาพของ Jev ในฐานะ Agent evaluator แล้ว
ที่เหลือเชื่อยิ่งกว่าคือความเร็วและราคา
ในการทดสอบที่ TypeSafe เปิดเผย Jev เร่งความเร็วได้สูงสุดประมาณ 193.6 เท่า และลดต้นทุนได้มากสุด 444.6 เท่า Input ต่อล้าน Token ราคาเพียง 0.042 ดอลลาร์ ส่วน Output Token ฟรี sogar
AI ที่ดูเหมือนมีความสามารถน้อยกว่า ทำไมกลับฮอต?
เพราะเมื่อเข้าสู่ยุค Agent สิ่งที่ AI ต้องการจริงๆ อาจไม่ใช่แค่ "การคิดอย่างลึกซึ้ง" แต่ยังรวมถึงการตัดสินใจจำนวนมหาศาล รวดเร็ว และราคาถูก: ขั้นต่อไปทำอะไร ควรเรียกใช้เครื่องมือไหน งานเสร็จหรือยัง ที่สำคัญกว่านั้น การตัดสินใจเหล่านี้ในอนาคตต้องให้ AI ทำเองเบื้องหลัง ไม่ต้องให้คนนั่งจ้องหน้าจอตลอดเวลา สิ่งที่ Jev เล็งเป้าคือการตัดสินใจเล็กๆ ที่อาจเกิดขึ้นหลายล้านครั้งต่อวัน
ที่น่าสนใจยิ่งกว่าคือ Diogo Almeida ผู้ก่อตั้งโมเดล Jevเคยมีส่วนร่วมใน RLHF และตอนนี้เขาเริ่มทบทวน RLHF: วิธีการฝึกที่ทำให้ ChatGPT ใช้งานได้ดีนี้อาจไม่เหมาะกับการที่ AI จะก้าวสู่ระบบอัตโนมัติอย่างแท้จริง
กว่าหนึ่งเดือนก่อน Almeida ได้กล่าวสุนทรพจน์ครั้งหนึ่ง ตอนนี้ย้อนกลับไปดู คำพูดครั้งนั้นแทบจะเป็น "คู่มือความคิด" ของ Jev เลย
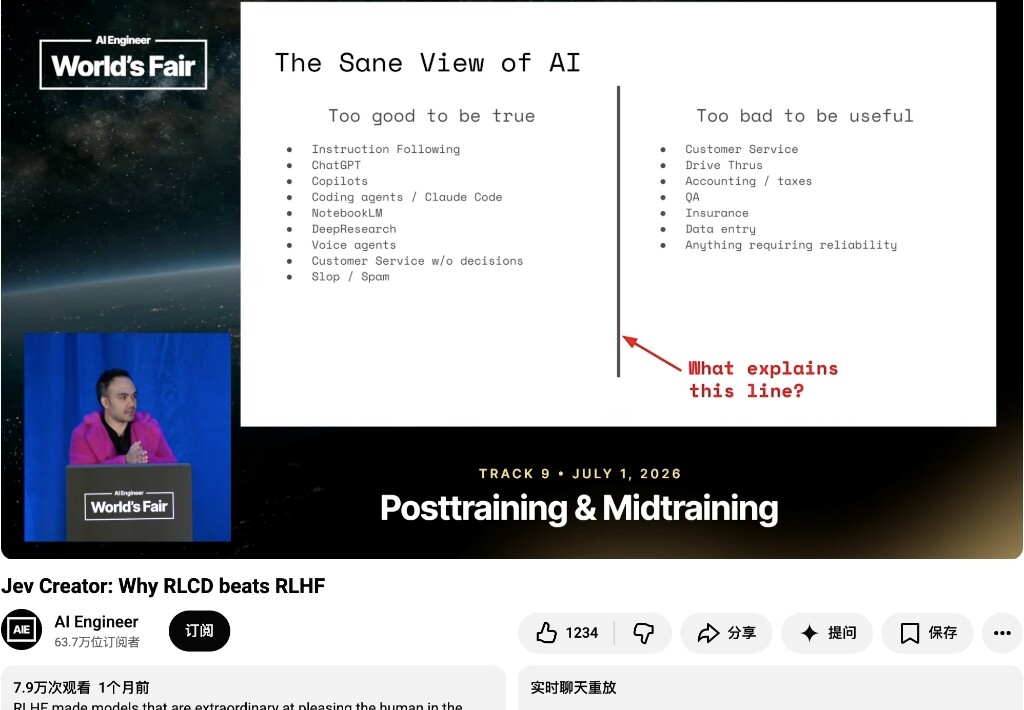
AI ทำคณิตศาสตร์ชั้นสูงได้แล้ว ทำไมยังทำ客服ไม่ได้ดี?
ประวัติของ Diogo Almeida ค่อนข้างพิเศษ
เขาเคยทำงานที่ OpenAI เป็นหนึ่งในผู้มีส่วนร่วมในงานที่เกี่ยวข้องกับ GPT-4, ChatGPT และ InstructGPT/RLHF กล่าวคือ เขาเคยมีส่วนร่วมสร้างกระบวนทัศน์ post-training ที่สำคัญที่สุดของโมเดลใหญ่ในปัจจุบันด้วยมือตัวเอง
แต่ในสุนทรพจน์ครั้งนั้น เขาเริ่มด้วยการล้อตัวเองว่าเป็นหนึ่งในไม่กี่คนใน OpenAI ที่วิจารณ์ ChatGPT อย่างเปิดเผย
หัวข้อสุนทรพจน์ของเขาตรงไปตรงมายิ่งกว่า: What's Next After RLHF?
Diogo เริ่มด้วยคำถามที่ดูขัดแย้ง
โมเดลใหญ่ทุกวันนี้สามารถท้าทายโจทย์คณิตศาสตร์ที่ยากมากได้แล้ว โค้ด การให้เหตุผล และ benchmark ต่างๆ พุ่งขึ้นเรื่อยๆ
แต่เมื่อเข้าสู่ธุรกิจที่องค์กรจำนวนมากอยากทำให้เป็นอัตโนมัติจริงๆ กลับยังต้องมีคนอยู่ตลอด
เช่น ฝ่ายบริการลูกค้า
ให้ AI ค้นข้อมูล สรุปเอกสาร ร่างคำตอบ ไม่มีปัญหา
แต่ถ้าให้ AI ตัดสินใจเองว่า: เงินนี้จะคืนหรือไม่? ผู้ใช้รายนี้ต้องชดเชยไหม?
องค์กรก็ระวังตัวขึ้นมาทันที
ทั้งที่เรื่องพวกนี้ดูง่ายกว่าคณิตศาสตร์ชั้นสูงมาก ทำไมกลับไม่กล้ามอบให้ AI?
คำตอบที่ Diogo ให้เรียบง่ายมาก: Today's AI is incredible at assistance, not automation.
AI ทุกวันนี้เก่งในการช่วยคุณทำงาน แต่ยังไม่ค่อยสามารถทำงานให้เสร็จด้วยตัวเอง
สองสิ่งนี้ดูเหมือนต่างกันนิดเดียว แต่จริงๆ ต่างกัน completamente
Claude Code จะเก่งแค่ไหน ปกติคุณก็ยังต้องนั่งหน้าคอมพิวเตอร์ มันเขียนโค้ด คุณดู มันแก้ไฟล์ คุณตรวจ ผิด了你ก็ให้มันแก้ใหม่
ดังนั้นในมุมของ Diogo Claude Code ยังอยู่ใน "ยุคช่วยเหลือ" ที่ ChatGPT เปิดฉาก
แล้วระบบอัตโนมัติที่แท้จริงคืออะไร?
คนไม่อยู่ในฉากเลย
AI ตัดสินใจเอง ดำเนินการเองเบื้องหลัง อาจทำงานหลายแสนหรือหลายล้านครั้งต่อวัน คุณอาจไม่เคยเห็นด้วยซ้ำว่ามันทำอะไร
ปัญหาก็ตามมา: ทำไม AI ทุกวันนี้ถึงฉลาดมาก แต่กลับขาดคนไม่ได้?
Diogo ชี้เป้าไปที่สิ่งที่เขาคุ้นเคยมาก——RLHF
ตอนเราฝึก AI เราก็ใส่คนเข้าไปใน loop แล้ว
เรื่องนี้ก็ironicอยู่ไม่น้อย
เพราะ RLHF ก็คือหนึ่งในเส้นทางเทคโนโลยีที่ Diogo เคยผลักดันเมื่อครั้งอดีต
ตรรกะพื้นฐานของ RLHF จริงๆ ไม่ซับซ้อน: เก็บรวบรวม preference ของคน แล้วให้โมเดลค่อยๆ สอดคล้องกับ preference ของคนมากขึ้น
ดังนั้น Diogo จึงให้คำอธิบายที่ตรงมากในสุนทรพจน์: ทำไมโมเดลใหญ่ทุกวันนี้ถึงต้องมีคนอยู่ใน loop เสมอ?
เพราะตอนฝึกมัน เราใส่คนเข้าไปใน loop นั้นตามตัวอักษร
โมเดลเรียนรู้ตั้งแต่แรก: คำตอบแบบไหนที่คนชอบมากกว่า?
นี่ก็อธิบายลักษณะหนึ่งของโมเดลใหญ่ที่เราคุ้นเคยดี——แม้ไม่รู้ ก็มักพูดให้ดูเหมือนรู้ได้อย่างแนบเนียน
Diogo ยกตัวอย่างที่แสบมากในงาน
มีคนส่งไฟล์เสียงตดให้ ChatGPT แล้วบอกว่านี่คือเพลงที่ตัวเองแต่ง ขอให้มันวิจารณ์อย่าง "จริงใจ ตรงไปตรงมา"
ผลคือ ChatGPT ชมอย่างจริงจัง บอกว่านี่เป็นเพลง ambient ที่มีบรรยากาศหลอนๆ พิลึกๆ
Diogo ถึงกับสรุปเป็นประโยคเดียว: "Overpromising is a feature."
การสัญญาเกินจริงไม่ใช่ Bug แต่เป็น feature
สำหรับผลิตภัณฑ์แชท สิ่งนี้อาจไม่ถึงตาย ผู้ใช้ยังอยู่หน้าจอ ผิดแล้วแก้ได้
แต่ระบบอัตโนมัติที่แท้จริง完全不同
เครื่องไม่สนใจว่าคำตอบคุณเพราะหรือไม่ มันแค่ต้องรู้สองอย่าง: ควรทำอย่างไรกันแน่ และคุณมั่นใจแค่ไหน?
นี่ก็อธิบายว่าทำไม Jev ที่เปิดตัวกว่าหนึ่งเดือนต่อมาถึงดูผิดปกติขนาดนี้
ดังนั้น Jev จึงไม่ให้ AI "พูด" เลย
โมเดลใหญ่ทั่วไป แม้สุดท้ายต้องการแค่ตอบว่า "A หรือ B" ก็มักต้องผ่านกระบวนการ generate Token
Jev ตัดส่วนนี้ทิ้งไปเลย
ปัจจุบันมันทำหลักๆ สามอย่าง:
- Noul ตอบ Yes หรือ No
- Choice เลือกหนึ่งจากหลายตัวเลือก
- Score ให้คะแนนตามเกณฑ์
แล้วส่งคืนการตัดสินใจและความน่าจะเป็นโดยตรง
ไม่เขียนเรียงความให้คุณ ไม่คุยเล่นกับคุณ
latency แบบ end-to-end ที่ทางการเปิดเผยต่ำถึง 70—500 มิลลิวินาที เร็วกว่าโมเดล前沿 20—200 เท่า ราคาถูกกว่า 40—400 เท่า
แต่สิ่งที่สำคัญจริงๆ จริงๆ ไม่ใช่ "เร็ว" หากเป็นความน่าจะเป็นที่อยู่ข้างหลัง
เพื่อสิ่งนี้ TypeSafe จึงเสนอวิธีการฝึกใหม่: RLCD, Reinforcement Learning for Calibrated Decisions การเรียนรู้แบบเสริมกำลังสำหรับการตัดสินใจที่calibrated
สิ่งที่มันต้องการแก้เป็นเรื่องจริงมาก: ถ้า AI บอกคุณว่าสิ่งหนึ่งมีความน่าจะเป็น 80% ที่จะเกิดขึ้น 80% นี้เชื่อได้จริงไหม?
ในอุดมคติ สำหรับกลุ่มเรื่องที่โมเดลตัดสินว่ามีความน่าจะเป็น 80% สุดท้ายก็ควรเกิดขึ้นจริงประมาณ 80%
สิ่งนี้สำคัญมากในระบบอัตโนมัติ
ความมั่นใจ 99% สั่งดำเนินการได้เลย
ความมั่นใจ 51% ส่งต่อให้โมเดลใหญ่ที่เก่งกว่า แพงกว่า หรือแม้แต่ส่งต่อให้คนได้
สิ่งที่ยุ่งจริงๆ ไม่ใช่ AI ไม่รู้ แต่เป็น AI ไม่รู้ว่าตัวเองไม่รู้
ดังนั้นสิ่งที่ Jev ต้องการเปลี่ยนจริงๆ คือวัตถุที่ AI output
ในอดีตคำตอบที่ ChatGPT generate ออกมานั้นหลักๆ ไว้ให้คนดู ส่วนการตัดสินใจและความน่าจะเป็นที่ Jev ให้เตรียมส่งให้ซอฟต์แวร์ใช้โดยตรง
ยุค Agent อาจไม่ได้ต้องการสมองที่ใหญ่กว่า
นี่ก็อธิบายว่าทำไม Jev ถึงฮอตขึ้นมาในตอนนี้
เพราะเมื่อ Agent ทำงานจริง มันจะสร้างการตัดสินใจเล็กๆ จำนวนมหาศาล:
ขั้นต่อไปเรียกเครื่องมือไหน? หน้าเว็บนี้ควรคลิกปุ่มไหน? ข้อมูลนี้ยังมีประโยชน์ไหม? งานเสร็จหรือยัง? ผลลัพธ์ต้องตรวจซ้ำไหม?
คำถามเหล่านี้มองแยกกันไม่ยาก แต่ Agent หนึ่งตัวอาจต้องตัดสินใจหลายแสน หลายล้านครั้งต่อวัน
ถ้าทุกครั้งต้องเรียกโมเดลใหญ่ที่สุด ใช้เวลาสองสามวินาที "คิดอย่างลึกซึ้ง" แล้วพ่น Token ยาวๆ ออกมา ต้นทุนและ latency ก็จะพุ่งขึ้นเร็วมาก
สิ่งที่ Jev อยากแย่งคือ layer นี้
การตัดสินใจเล็กๆ ความถี่สูงจำนวนมากให้ Jev ส่วนงานที่ต้องใช้การให้เหตุผลซับซ้อนจริงๆ ค่อยให้โมเดลใหญ่
นี่ก็เป็นเหตุผลที่ TypeSafe เรียก Jev ว่า System One Model
แนวคิดนี้มาจาก "ระบบ 1" และ "ระบบ 2" ของ Daniel Kahneman: ระบบหนึ่งรับผิดชอบการตัดสินใจเร็วๆ เชิงสัญชาตญาณ อีกระบบหนึ่งรับผิดชอบการคิดช้าๆ ซับซ้อน
Jev ถึงกับได้ชื่อมาจาก "Jevons paradox":
เมื่อทรัพยากรหนึ่งถูกลงเรื่อยๆ คนอาจไม่ได้ใช้น้อยลง กลับอาจใช้มากขึ้น
ถ้าเรียก AI หนึ่งครั้งแพง คุณจะใช้แค่ในที่สำคัญที่สุด
แต่ถ้าการตัดสินใจด้วย AI หนึ่งครั้งถูกจนแทบมองข้ามได้ล่ะ?
อีเมลหนึ่งฉบับ log หนึ่งบรรทัด การเรียกเครื่องมือหนึ่งครั้ง ปุ่มบนหน้าเว็บหนึ่งปุ่ม ทุกขั้นตอนที่ Agent ดำเนินการ ล้วนอาจเพิ่มการตัดสินใจด้วย AI เข้าไปหนึ่งครั้ง
แน่นอนว่า การบอกตอนนี้ว่า Jev เป็นตัวแทน AI ยุคหน้าก็ยังเร็วเกินไป
สิ่งที่มันเรียกว่า "zero hallucination" มากกว่านั้นหมายถึงจะไม่หลุดออกไปแต่งขึ้นนอกประเภทคำตอบที่กำหนด ไม่ได้หมายความว่าจะเลือกผิดไม่ได้ ข้อมูลสุดขั้วอย่าง 193.6 เท่า 444.6 เท่าก็มาจากการทดสอบของ TypeSafe เองเป็นหลัก
แต่สิ่งที่การฮอตครั้งนี้ของ Jev ที่น่าสนใจจริงๆ อาจไม่ใช่ว่ามันจะท้าทาย GPT หรือ Claude ได้ไหม
แต่เป็นคนที่เคยมีส่วนสร้าง ChatGPT กำลังตั้งคำถามใหม่กับปัญหาที่พื้นฐานกว่า:
หลายปีที่ผ่านมา ทั้งอุตสาหกรรมคิดกันว่าทำอย่างไรให้ AI คิดนานขึ้น พูดมากขึ้น
แต่ถ้าอนาคตต้องการจริงๆ คือการตัดสินใจระหว่างเครื่องหลายพันล้านครั้ง ทำไม AI ต้อง "พูดสักประโยค" ทุกครั้ง?
ChatGPT สอนเครื่องว่าคุยกับคนอย่างไร
และเดิมพันขั้นต่อไปของ Jev คือ: เมื่อคนไม่นั่งอยู่หน้าจอแล้ว เครื่องตัดสินใจเองได้ไหม?





