


一條公鏈為什麼會停?從 Cosmos 停擺 25 小時,真正理解區塊鏈共識


- 核心觀點:Cosmos Hub 因 Neutron 治理攻擊事件,超三分之一驗證人主動停止出塊以阻止駭客資金流動,約一天後透過驗證者協調升級恢復。事件揭示公鏈去中心化不等於永不宕機,共識機制在 Safety 與 Liveness 之間面臨權衡。
- 關鍵要素:
- 攻擊者利用 Neutron 鏈級治理權限,透過 wasmd 特權指令篡改 Astroport 等應用合約管理員,約 170 萬枚 ATOM 跨鏈轉入 Cosmos Hub。
- 超三分之一 voting power 的驗證人停止運行,Cosmos Hub 失去 Liveness,停在區塊高度 33,086,740,用戶 ATOM 轉帳無法確認。
- 恢復方案:Gaia v28.3.0 在恢復高度執行一次性狀態修改,將攻擊者地址中 1,227,121 ATOM 轉入 4-of-6 多簽地址;超 67% 驗證權安裝補丁後約 6 分鐘恢復出塊。
- BFT 共識下,區塊提交需超三分之二 voting power,不足時網路寧願暫停以維護 Safety,而非犧牲一致性繼續出塊。
- 歷史對照:Bitcoin 2013 年客戶端規則分歧、Ethereum 2016 年 The DAO 硬分叉、Solana 2021 年記憶體耗盡停機,均反映共識分歧或 Liveness 喪失的不同故障路徑。
- 私鑰自主權保障資產控制,但底層共識權決定鏈能否處理交易及狀態是否可被集體修改,二者並非同一件事。
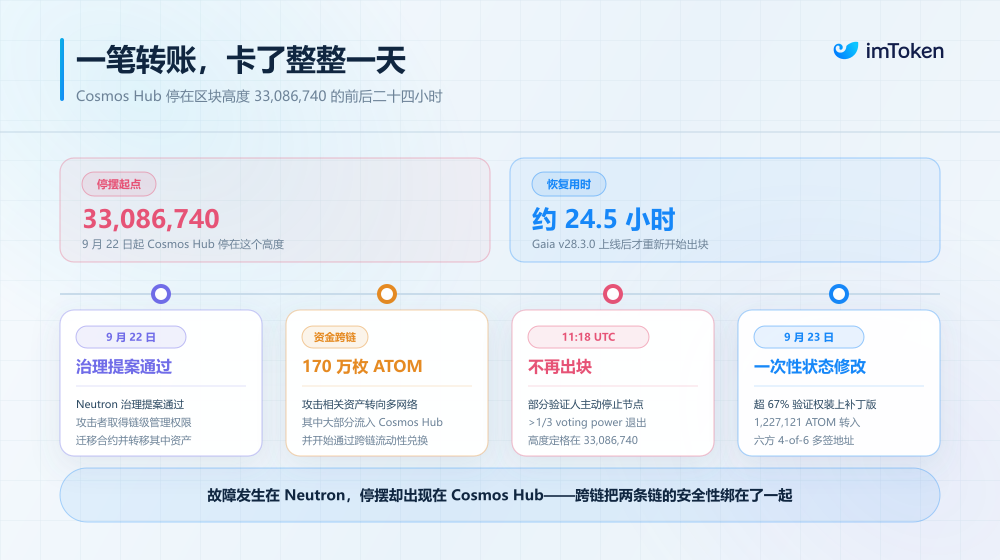
9 月 22 日晚,一名用戶發出了一筆 ATOM 轉帳。
一夜過去,交易依然停留在「等待確認」。
私鑰沒有丟,錢包也沒有出現簽名異常,第二天再次檢查,多個公開 RPC 都顯示 Cosmos Hub 停在了區塊高度 33,086,740。
沒有新的區塊產生,自然也就沒有任何地方能夠把這筆交易打包進去。
直到大約一天之後 Cosmos Hub 恢復出塊,這筆此前一直處於等待狀態的 ATOM 轉帳才最終成功。
對於普通用戶來說,這可能是理解區塊鏈共識最直觀的一堂課。
我們習慣說「沒有任何中心機構可以關掉一條公鏈」,但現實顯然要複雜得多,一條足夠去中心化的區塊鏈,確實通常不存在伺服器機房裡的那個「關機按鈕」,但它仍然可能停止。
這一次 Cosmos Hub 的暫停,恰好把這套平時藏在底層的機制,完整地暴露到了普通用戶面前。
一、Cosmos 為什麼突然「停止出塊」?
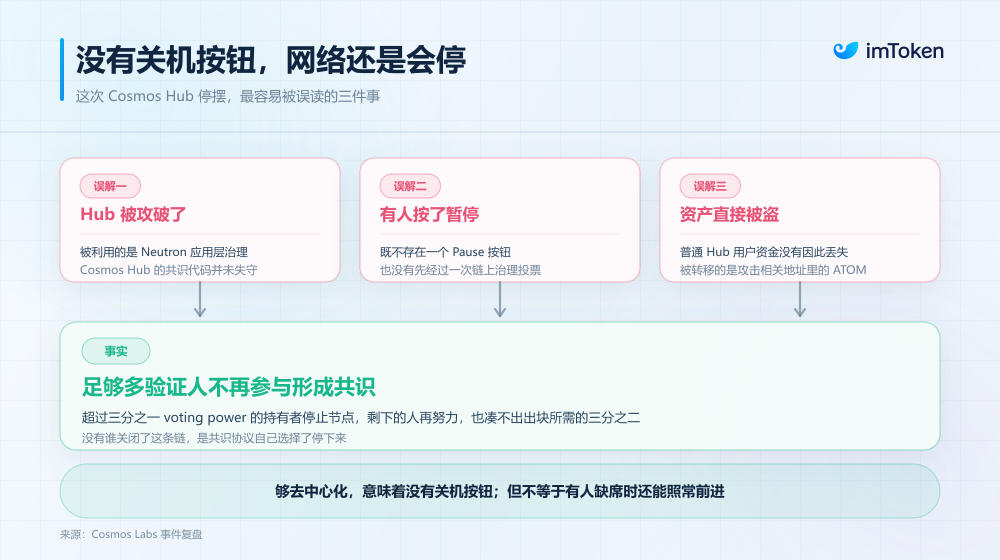
首先需要把一個容易混淆的問題說清楚,本次被直接攻擊的,並不是 Cosmos Hub。
事件最早發生在 Neutron。
9 月 22 日,一項名為「AIATO: AI Agent Takeover」的 Neutron 治理提案獲得通過,攻擊者鑽了鏈級治理權限的空子,利用 wasmd 框架原生提供的特權指令,把 Astroport、Drop 等應用的合約管理員改成了攻擊者控制的地址。
這並不是我們通常理解的那種「代碼漏洞」或「協議缺陷」。
可以簡單理解為,應用本身有自己的「門鎖」,但 Neutron 的鏈級治理手裡還握著一把權限更高的「總鑰匙」,而當攻擊者控制了治理結果,也就等於拿到了這把鑰匙,可以重新指定管理員、遷移合約,進一步轉移其中的資產。
而真正讓 Cosmos Hub 被捲進來的,是隨後發生的跨鏈資金轉移。
Cosmos Labs 復盤顯示,在 Neutron 停止運行前,攻擊者已把部分資產轉向多個網絡,其中大約 170 萬枚 ATOM 被轉入 Cosmos Hub,並開始通過跨鏈流動性進行兌換。
也就是說,Cosmos Hub 本身沒有遭到直接攻擊,普通 Hub 用戶資金也沒有因為 Neutron 漏洞直接被盜。
但攻擊所得的 ATOM 已經進入了 Hub,為了阻止剩餘 ATOM 繼續流出,一部分 Cosmos Hub 驗證人開始停止節點運行。
到 9 月 22 日 19:18 左右(SGT),停止運行的驗證人已經代表超過三分之一的總 voting power,Cosmos Hub 因此無法繼續形成新區塊,最終停在 33,086,740。
這一步非常關鍵。
它意味著 Cosmos Hub 並不存在某家公司可以直接點擊的「Pause」按鈕,也沒有先經過一次鏈上治理投票,真正讓網路停下來的,是足夠多驗證人不再參與形成共識。
但更值得注意的,其實是後面的恢復過程。
停鏈大約 4 個小時後,驗證者收到了一份完整的恢復方案:針對停鏈高度執行一次性的狀態修改,把攻擊者地址中剩餘的 ATOM 轉入由社區驗證者共同管理的多簽地址。
隨後 Cosmos Labs 根據驗證者已經達成的方案製作 Gaia v28.3.0 補丁,對其進行測試,並分發給驗證者。
這版 Gaia 會在指定恢復高度執行一次性的狀態變化,把攻擊者地址中的 1,227,121 ATOM 轉入由 Nansen、Keplr、Enigma、Silknodes、Kiln 和 Polkachu 六方組成的 4-of-6 多簽地址。
到 9 月 23 日凌晨,確認安裝 v28.3.0 的驗證者已經超過總 voting power 的 67%,因此當天 12:00 UTC,Cosmos Hub 協調重啟,約 6 分鐘後,這次一次性狀態修改在區塊高度 33,086,741 執行,網路恢復正常出塊。
說到底,Cosmos 停止出塊到恢復運行的整個過程中,是驗證者先讓網路失去 Liveness,再由超過三分之二 voting power 接受一套新的狀態轉換規則,最終讓這套規則成為恢復後的 canonical state。
到這裡,一個看似簡單的問題也就出現了:既然是一條去中心化公鏈,為什麼超過三分之一的驗證權就能讓它停下來,而恢復網路,又需要足夠多驗證者共同接受並運行同一套軟體?
答案,其實就藏在「共識」兩個字裡。
二、所謂共識,本就不是「永遠不會停」
區塊鏈最容易被誤解的一件事,就是把「去中心化」和「永不宕機」畫上等號。
實際上,共識機制真正解決的問題,是在沒有一個中央記帳人的情況下,許多節點怎樣對交易順序和帳本狀態達成一致。
只不過,不同公鏈實現這件事的方法,並不一樣。
像 Bitcoin 最經典的是 PoW,也就是工作量證明——礦工依靠算力競爭出塊,當網路短時間出現兩條合法分支時,節點按照累計工作量選擇其中一條繼續構建。
所以 Bitcoin 並不存在一個明確的「67% 投票後這個區塊永遠 Finalized」時刻,它更接近一種機率最終性,後續區塊越多,想重新組織掉前面的交易,就需要付出越來越高的算力成本。
這也是為什麼大家過去常說,一筆 Bitcoin 交易最好等待 6 個區塊確認,畢竟即使算力再高,也不能簡單繞過節點正在執行的共識規則。
當然,這並不意味著 Bitcoin 的狀態在任何情況下都「絕對無法修改」。理論上,如果整個生態接受一套新的客戶端和新的共識規則,通過 Hard Fork,同樣可以讓過去規則下無效的狀態變化變成有效。
但問題就在這裡,誰有能力讓足夠多礦工、Full Node、交易平台、錢包和用戶一起接受這樣一套新規則?
幾乎沒有。
開發團隊並不能替整個 Bitcoin 網路決定共識規則,礦工、交易平台也很難,因為它需要跨越的共識門檻非常高,當初幣安被盜 7000 枚 BTC,就有人建議 CZ 聯繫大礦工操作,最終不了了之。
以太坊則提供了另一個很經典的樣本。
在轉向 PoS 之後,現在的以太坊使用 Casper FFG 與 LMD-GHOST 共同組成的 Gasper 共識。簡單理解,一部分機制負責判斷「當前應該跟哪條鏈」,另一部分則負責讓區塊獲得真正意義上的 Finality。
當代表至少三分之二質押 ETH 的驗證者對相應 checkpoint 達成一致,區塊才能進一步走向最終確定;反過來,如果超過三分之一的 stake 長時間不參與正確投票,網路就可能暫時無法形成 Finality,不過 Ethereum 還設計了 inactivity leak,在長時間無法 finalizing 時逐步降低離線驗證者的有效權重,讓網路最終有機會重新恢復 Finality。
想真正改變這種結果,同樣需要改變協議規則和客戶端。
正如 2016 年 The DAO 事件,以太坊社區最終通過 Hard Fork,在區塊 1,920,000 執行了一次 Ethereum Foundation 當時直接稱為 irregular state change 的特殊狀態修改,把相關 ETH 轉入恢復合約。
只是,拒絕升級、繼續維護原有狀態的一部分礦工和社區最終形成了 Ethereum Classic(ETC),導致了眾所周知的 ETH 與 ETC 分叉,表明不是所有人都接受這套規則。

Cosmos Hub 又有所不同,它使用 CometBFT,更接近典型的 BFT 共識。
可以把它理解為更加典型的 BFT 共識,也即一個區塊想真正提交,需要獲得超過三分之二 voting power 的 Commit。
它的好處是 Finality 非常明確,一旦區塊經過足夠驗證權投票提交,就不需要像 PoW 那樣繼續等待越來越多區塊,用機率換取安全感。
但它的另一面也非常直接,那就是如果三分之一或以上 voting power 不再提供形成 Commit 所需要的投票,剩餘驗證人再努力,也湊不出超過三分之二。
這時候網路最安全的選擇,就正如本次的「暫停出塊」,所以從分布式系統的角度看,這次 Cosmos Hub 的短暫停擺其實並不神秘。
一言以蔽之,一群掌握足夠 voting power 的驗證人停止參與之後,共識協議按照自己的規則,寧願失去可用性,也不繼續在缺乏足夠共識的情況下確認新區塊。
這背後其實對應了分布式系統裡兩個經常被普通用戶混在一起的概念:
- Safety:不能讓不同節點同時確認兩個彼此衝突的最終狀態;
- Liveness:網路還能不能持續向前運行、處理新的交易;
對於 BFT 系統來說,當參與共識的節點不足時,暫帶有時候恰恰是維護 Safety 所付出的代價,說得直白一點,這本去中心化帳本寧願先停在那裡,也不能讓剩下的人各記各的。
從這個角度再回頭看,會發現公鏈歷史上許多看似完全不同的事故,其實都圍繞同一件事展開:
當分布式節點無法繼續對「正確狀態」形成一致意見時,網路該怎麼辦?
三、從 Bitcoin 到 Solana,公鏈真正的風險邊界在哪裡?
這不是 Cosmos 第一次把這個問題擺到檯面上。
早在 2013 年,Bitcoin 就發生過一次非常經典的鏈分叉事故。
當時 Bitcoin 0.8 將底層資料庫從 Berkeley DB 切換到 LevelDB,隨後一個包含大量交易輸入的區塊出現,新版節點能夠正常處理,但部分舊版節點由於 Berkeley DB 鎖數量限制,將這個區塊判斷為無效。
於是非常尷尬的一幕出現了,大家運行的都是 Bitcoin,但新舊客戶端開始對「這個區塊到底是否合法」產生不同答案。
網路因此分裂成兩條鏈,而且新版 0.8 一側一度擁有大約 60% 的算力,無法依賴正常的算力競爭快速自行收斂。
最終,大型礦池經過協調切回舊版本,在舊規則一側重新獲得更多算力,網路才重新收斂,Bitcoin 後來也專門以 BIP 50 對這次事故進行了復盤。
到了 2016 年,以太坊的 The DAO 事件又把問題向前推了一步。
正如上文提到的 The DAO 事件,以太坊社區最終通過 Hard Fork,在區塊 1,920,000 執行了一次被 Ethereum Foundation 明確稱作 irregular state change 的特殊狀態修改,把相關 ETH 轉入恢復合約。
但並不是所有人都認同這種處置,拒絕接受狀態修改的一部分礦工和社區繼續維護原來的規則,也就有了後來長期存在的 Ethereum Classic(ETC)。
這次 DAO Fork 也是一個經典事件,相當於告訴所有人,當極端事件發生時,代碼共識之外還存在社會共識,如果無法形成足夠一致的意見,一條鏈真的可以分成兩條。
2021 年的 Solana,則展示了另一種完全不同的故障路徑。
當年 9 月,大量機器人交易湧入網路,引發驗證節點記憶體耗盡,大量節點崩潰,最終整個網路無法對當前狀態形成一致意見,停止確認新區塊約 17 個小時,隨後驗證人共同協調恢復網路。

把這些事故放到一起,會發現它們並不是同一回事:
- Bitcoin 2013 年的問題,是不同客戶端開始執行不同的有效性規則;
- Solana 2021 年的問題,是大量驗證節點無法繼續正常參與共識,網路失去 Liveness;
- Ethereum DAO 面對的,則更接近一個社區是否應該通過新的協議規則主動修改狀態的問題;
- 而這一次 Cosmos Hub,又帶有另一層特殊性,網路先通過驗證人協調主動失去 Liveness,阻止攻擊資產繼續移動;之後又由足夠高比例的驗證權共同接受新的軟體與恢復狀態,讓網路重新形成一致;
所以,與其把這些事件簡單歸結為「區塊鏈原來也能關機」「去中心化都是假的」,不如承認一個更加真實的事實:
共識機制從來不是一台不會壞的機器,它真正提供的其實是一套去中心化的規則,譬如發生分歧時誰來決定正確的鏈;多少參與者才能讓一個狀態獲得最終性;出現故障時網路選擇繼續運行還是停止;以及在極端情況下,什麼樣的集體行動能夠改變接下來的運行規則。
這也讓這次 Cosmos 事件,留下了一個比「該不該停鏈」更值得普通用戶思考的問題。
寫在最後
我們經常說,not your keys, not your coins。
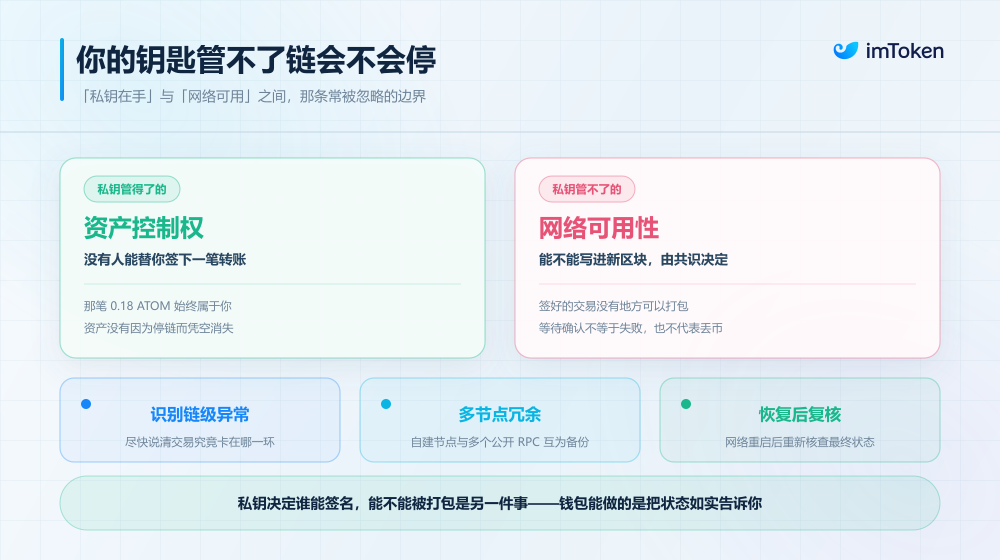
這句話當然依舊成立,只是它強調的是資產控制權——只要私鑰在自己手裡,錢包、交易平台或者其他第三方不能替你正常簽署一筆轉帳。
前提是,你所在的區塊鏈必須在任何時候都有能力處理這筆簽名。
Cosmos Hub 停止出塊的那一天,用戶依然持有自己的私鑰,資產也沒有因此憑空消失,只是你即使正確簽署了一筆交易,也沒有新的區塊可以接受它。
恢復過程又進一步說明,如果足夠多的共識參與者接受一套新的狀態規則,特定帳戶的鏈上狀態,也可能在沒有原地址私鑰簽名的情況下發生變化。
這並不會讓「Not your keys, not your coins」失效,但提醒我們,私鑰自主權和底層共識權,從來不是同一件事情。
而對於錢包來說,同樣如此。
錢包可以確保私鑰和簽名權掌握在用戶自己手中,可以盡快識別鏈級異常、準確展示交易狀態、建立 RPC 與節點冗餘,並在網路恢復之後重新確認交易最終結果。
但錢包不能替一條公鏈恢復共識,也無法保證底層網路永遠不會中斷,更無法保證鏈上的規則和狀態永遠不會發生共識層面的變化。
所以,一個成熟的去中心化系統真正需要追求的,可能從來都不是「任何東西絕對不能改」;相反,應該盡可能把這些並不完美的邊界說清楚:誰能夠讓共識暫停?需要多大的權重?什麼情況下允許緊急干預?
因為真正的去中心化,不可能讓系統永遠不會遇到事故,關鍵在於,即使事故真的發生,我們依然能夠知道是誰、依據什麼規則、以多大的共識,決定了這本帳接下來該怎麼記。





