






SignalPlus: 생성 AI 소개


머리말
“What I cannot create, I do not understand.”
-Richard Feynman
머리말
Stable Diffusion과 MidJourney를 활용하여 멋진 이미지를 만들어 보세요.
ChatGPT 및 LLaMa를 사용하여 우아한 단어를 만드는 데 능숙합니다.
MuseNet과 MuseGAN 사이를 오가며 산악 음악을 만들 수 있습니다.
의심할 바 없이 인간의 가장 독특한 능력은 창조하는 것이지만, 오늘날 끊임없이 변화하는 기술 속에서 우리는 기계를 창조함으로써 창조합니다! 기계는 주어진 스타일에 따라 독창적인 예술 작품을 그리고(그리기), 길고 일관성 있는 글을 작성하고(쓰기), 아름다운 음악을 작곡하고(작곡), 복잡한 게임의 승리 전략을 공식화할 수 있습니다(놀이). 이 기술은생성 인공 지능 (Generative Artificial Intelligence,첫 번째 수준 제목
1. 생성 모델과 차별 모델
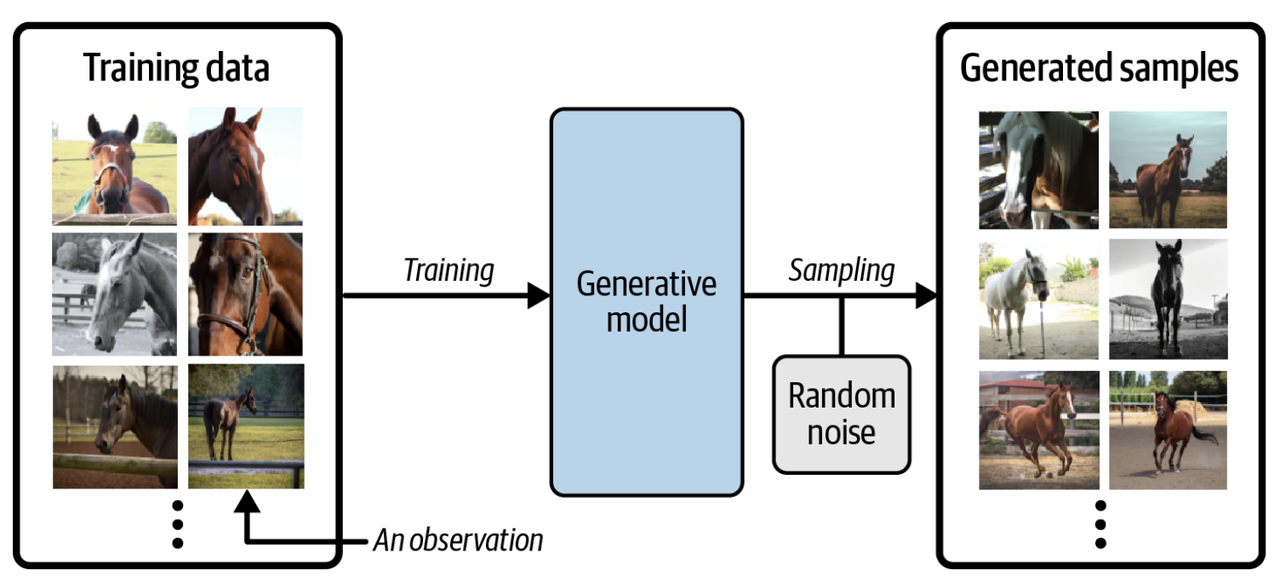
GenAI는 유행어이며, 그 뒤에 숨은 본질은모델 생성(생성 모델)은 주어진 데이터 세트와 유사한 새로운 데이터를 생성하도록 모델을 훈련시키는 것이 목표인 기계 학습의 한 분야입니다.
말 데이터세트가 있다고 가정해 보겠습니다. 첫째, 이 데이터 세트에 대한 생성 모델을 훈련하여 말 이미지의 픽셀 간의 복잡한 관계를 제어하는 규칙을 포착할 수 있습니다. 그런 다음 이 모델을 샘플링하여 아래 그림과 같이 원본 데이터세트에 존재하지 않았던 말의 사실적인 이미지를 생성합니다.
생성 모델의 목적과 중요성을 실제로 이해하려면 다음과 비교하십시오.판별 모델(차별 모델) 비교가 필요합니다. 실제로 기계 학습의 대부분의 문제는 판별 모델로 해결됩니다. 다음 예를 참조하세요.
일부는 반 고흐의 그림이고 일부는 다른 예술가의 그림 데이터세트가 있다고 가정해 보겠습니다. 충분한 데이터가 있으면 아래 그림과 같이 특정 그림이 반 고흐의 작품인지 예측하는 식별 모델을 훈련할 수 있습니다.
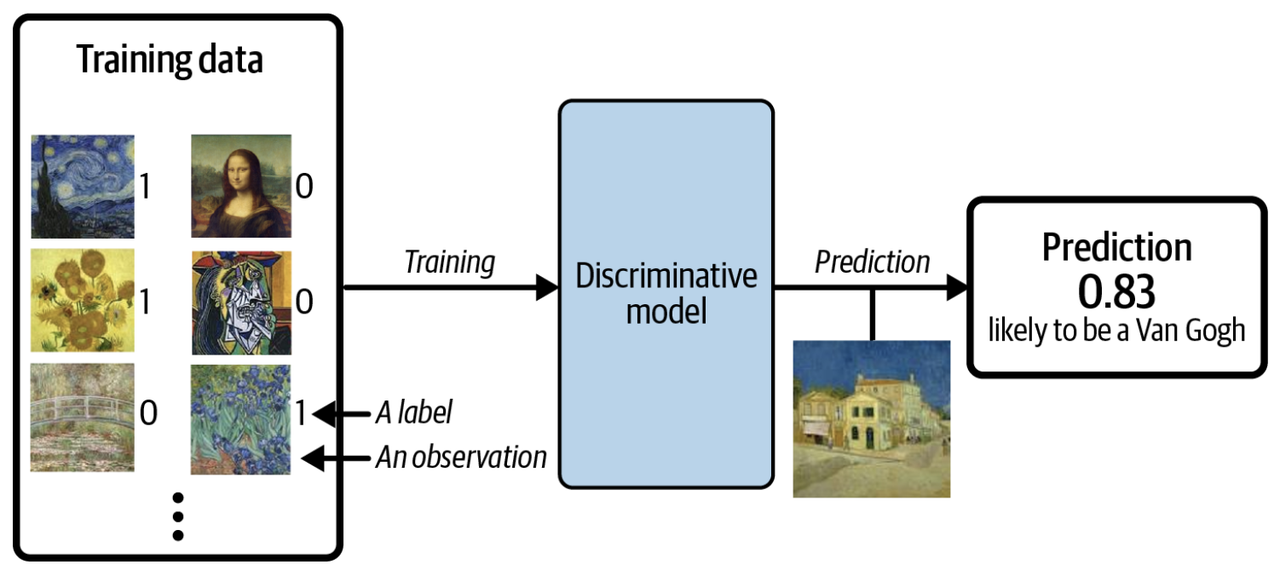
판별 모델을 사용할 때 훈련 세트의 각 예에는 레이블(label)이 있는데, 위의 두 범주 문제의 경우 반 고흐 그림의 레이블은 일반적으로 1이고 반 고흐가 아닌 그림의 레이블은 0입니다. 위 그림에서 모델의 최종 예측확률은 0.83으로 반고흐가 만들었을 가능성이 매우 높다. 판별 모델과 달리 생성 모델의 목표는 데이터 레이블을 예측하는 것이 아니라 새 데이터를 생성하는 것이므로 레이블을 포함하기 위해 예제가 필요하지 않습니다.
예제를 읽은 후 수학적 표기법을 사용하여 생성 모델과 판별 모델을 정확하게 정의해 보겠습니다.
판별 모델 쌍 P(y|x) 모델링, 지정된 기능x 라벨을 추정하기 위해 y 조건부 확률 .
모델 쌍 생성 P(x) 모델링, 특징 직접 추정 x의 확률은 이 확률 분포에서 샘플링하여 새로운 특징을 생성할 수 있습니다.
첫 번째 수준 제목
2. 생성 모델을 위한 프레임워크
생성 모델 프레임워크에 들어가기 전에 게임을 플레이해 보겠습니다. 아래 그림의 점들이 어떤 규칙에 의해 생성된다고 가정하여 이 규칙을 호출합니다. P이제 다른 데이터를 생성할 수 있습니다.x = (x 1,x 2) 점이 동일한 규칙에 의해 결정되는 것처럼 보이게 합니다.P데이터에 의해 생성됩니다.
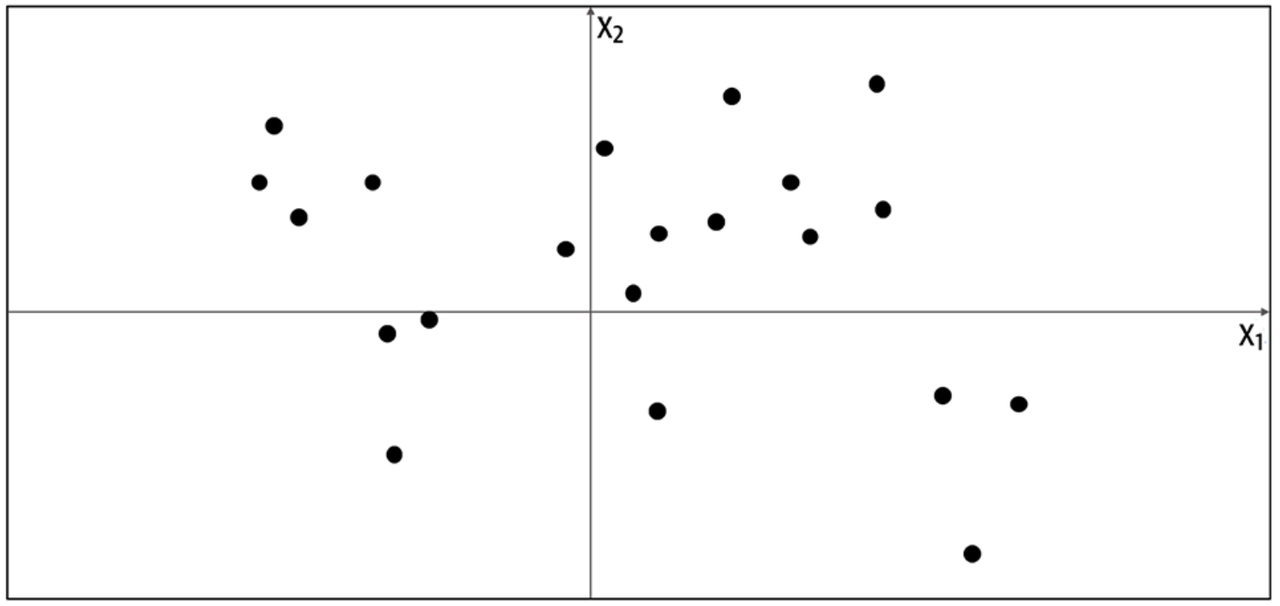
이 점을 어떻게 생성하겠습니까? 주어진 포인트를 이용하여 머릿속에 모델을 생성할 수 있습니다.P모델이며, 이 모델이 차지하는 위치에 따라 원하는 포인트가 생성될 수 있습니다. 이를 통해 모델이 다음과 같은 것을 알 수 있습니다.P모델은P데이터 추정. 그렇다면 가장 간단한 모델P모델은 아래 그림의 주황색 상자이며, 상자 내부에서만 포인트가 생성될 수 있고 상자 외부에서는 포인트가 생성되지 않습니다.
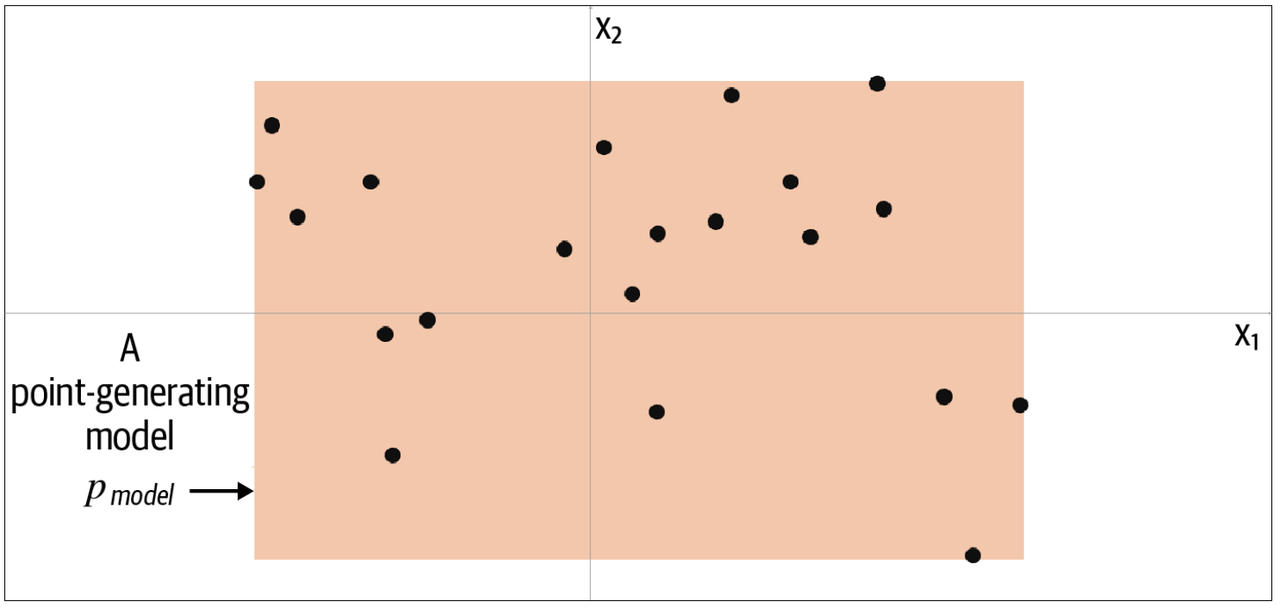
새로운 점을 생성하기 위해 모델에서 더 엄격하게 상자에서 점을 무작위로 선택할 수 있습니다.P모델 분포의 샘플링. 이것은 미니멀리스트 생성 모델입니다. 학습 데이터(검은색 점)에서 모델(주황색 상자)을 생성한 다음, 생성된 점이 학습 세트의 점과 유사해 보이길 바라며 모델에서 샘플링합니다.
이제 생성 학습을 위한 프레임워크를 공식적으로 제안할 수 있습니다.
이제 실제 데이터 생성 분포를 공개하겠습니다.P위의 프레임워크가 이 예에 어떻게 적용되는지 확인하세요. 아래 그림에서 데이터 생성 규칙을 볼 수 있습니다.P데이터는 포인트가 육지에 균일하게 분포되어 있고 바다에는 나타나지 않는다는 것입니다.
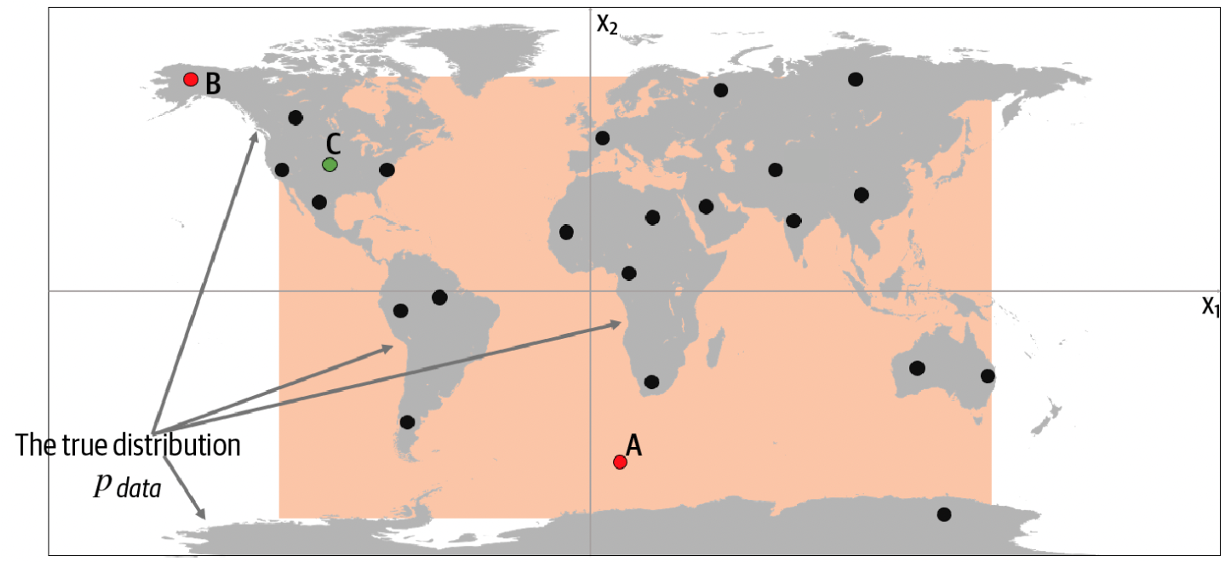
분명히 우리 모델은P모델이 원칙이다P데이터의 단순화. 위 다이어그램의 A, B, C 지점을 검토하면 모델을 이해하는 데 도움이 됩니다.P모델이 규칙을 성공적으로 모방하는지 여부Pdata。
A점은 규칙을 충족하지 않습니다. P데이터는 바다에 나타나는 것과 같으나 모델에 따라 결정될 수 있습니다.P모델은 주황색 상자 안에 나타나는 대로 생성됩니다.
점 B는 다음으로 모델링할 수 없습니다.P모델은 주황색 상자 외부에 나타나기 때문에 생성되지만 규칙을 준수합니다.P데이터는 육지에 나타나는 대로 표시됩니다.
점 C는 다음과 같이 모델링됩니다.P모델이 생성되고 규칙을 준수합니다.Pdata。
첫 번째 수준 제목
3. 최초의 생성 모델
당신이 회사의 최고 패션 책임자(CFO)이고 당신의 임무가 새롭고 트렌디한 옷을 만드는 것이라고 가정해 보겠습니다. 올해 당신은 패션 코디에 대한 50개의 데이터 세트를 받았고(아래 참조), 10개의 새로운 패션 코디를 만들어야 합니다.
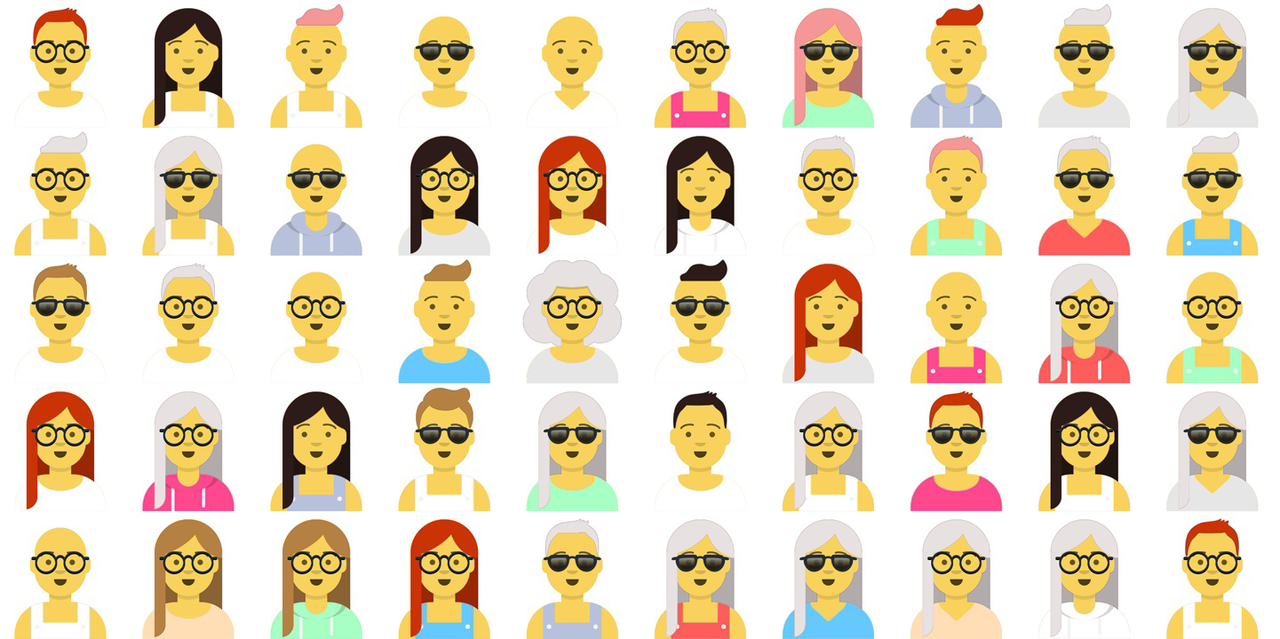
귀하는 최고 패션 책임자이면서 데이터 과학자이기도 하므로 이 문제를 해결하기 위해 생성 모델을 사용하기로 결정했습니다. 위의 50장의 사진을 읽은 후 5가지 기능을 사용하기로 결정하고,액세서리 유형 (accessies type)、옷 색깔 (clothing color)、의류 종류 (clothing type)、머리 색깔(머리 색깔) 그리고머리 스타일(머리 모양), 패션 코디를 설명합니다.
이미지 데이터의 상위 10가지 특징은 다음과 같습니다.
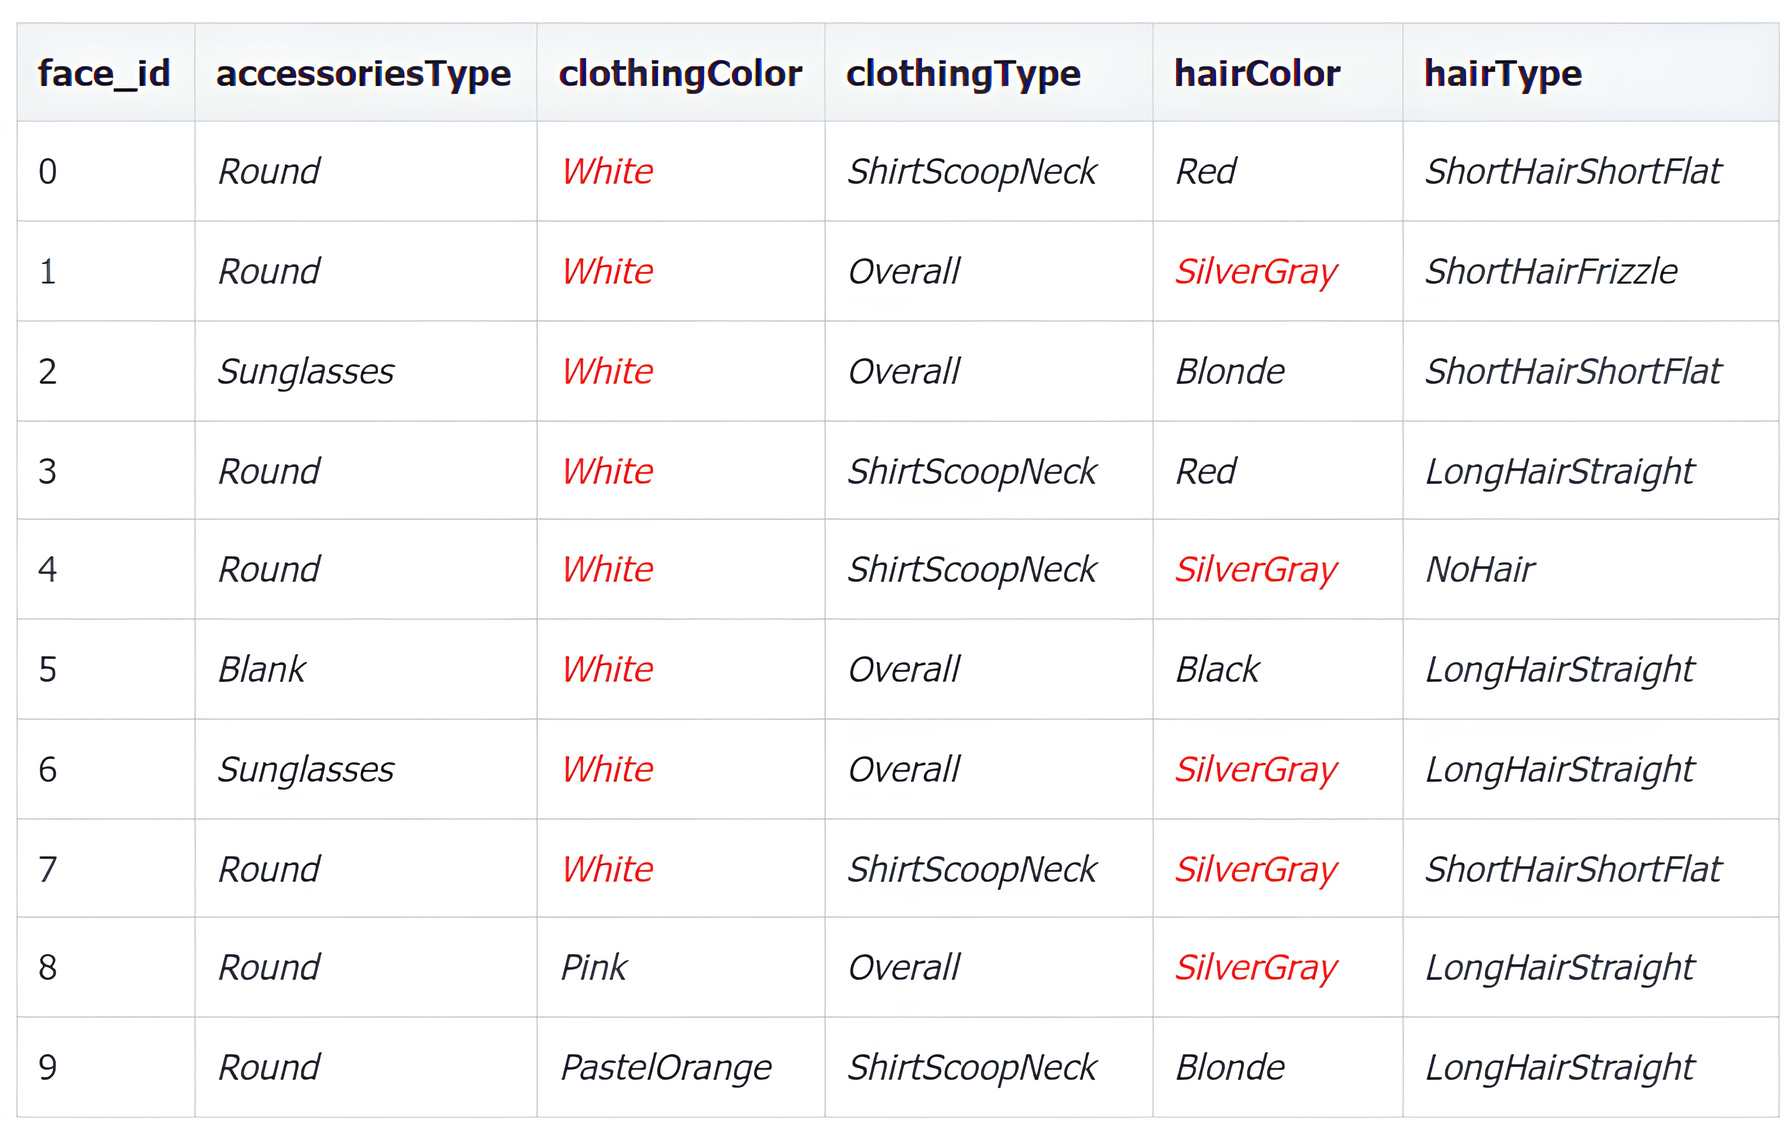
또한 각 기능에는 고유값 개수가 다릅니다.
3가지 유형의 액세서리(액세서리 유형):
Blank, Round, Sunglasses
8가지 의류 색상:
Black, Blue 01, Gray 01, PastelGreen, PastelOrange, Pink, Red, White
4가지 의류 유형:
Hoodie, Overall, ShirtScoopNeck, ShirtVNeck
6가지 헤어 컬러:
Black, Blonde, Brown, PastelPink, Red, SilverGray
7가지 헤어 유형:
NoHair, LongHairBun, LongHairCurly, LongHairStraight, ShortHairShortWaved, ShortHairShortFlat, ShortHairFrizzle
이런 식으로 3 * 8 * 4 * 6 * 7 = 4032개의 특징 조합이 있으므로 표본 공간에는 4032개의 포인트가 포함되어 있다고 상상할 수 있습니다. 주어진 50개의 데이터 포인트에서 다음을 알 수 있습니다.P데이터는 다양한 특성에 대해 특정 특성 값을 선호합니다. 위 표를 보면 이미지에는 흰색 옷색상과 은회색 머리색상이 더 많은 것을 알 수 있습니다. 우리는 진짜를 모르기 때문에P데이터를 구축하는 데는 이 50개의 데이터만 사용할 수 있습니다.P함께 사용할 수 있도록 모델P보조 제목
3.1 미니멀리스트 모델
가장 간단한 방법 중 하나는 4032개의 특성 조합의 각 포인트에 확률 매개변수를 할당하는 것입니다. 그러면 모델에 4031개의 매개변수가 포함됩니다. 왜냐하면 모든 확률 매개변수의 합은 1과 같기 때문입니다. 이제 50개의 데이터를 하나씩 검사하고 모델의 매개변수를 업데이트해 보겠습니다.(θ 1 ,θ 2 ,…,θ 4031 )~에
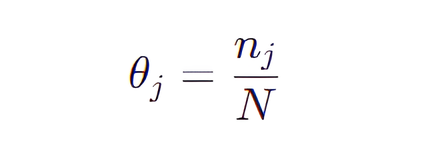
~에 N는 관측된 데이터의 수, 즉 50이고,nj첫 번째입니다j50개의 데이터에 나타나는 기능 조합의 수입니다.
예를 들어 (LongHairStraight, Red, Round, ShirtScoopNeck, White)의 특징 조합(조합 1이라고 함)이 두 번 나타난 다음
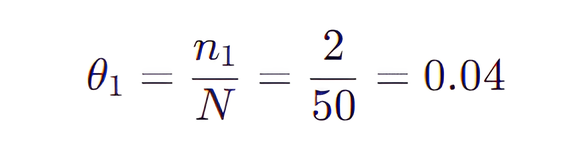
예를 들어 (LongHairStraight, Red, Round, ShirtScoopNeck, Blue 01)의 특징 조합(조합 2라고 함)이 나타나지 않으면
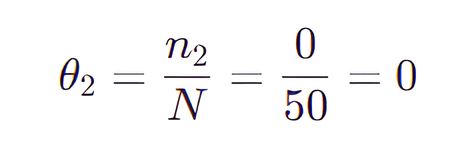
위의 규칙에 따라 4031의 조합을 계산해 보겠습니다.θ값이 많다는 것을 확인하는 것은 어렵지 않습니다.θ값은 모두 0이고, 더 나쁜 것은 보이지 않는 새로운 그림을 생성할 수 없다는 것입니다(θ= 0은 해당 특징 조합이 포함된 이미지가 관찰된 적이 없음을 의미합니다. 이 문제를 해결하려면 총 특징 수 d를 분모에 추가하고 분자에 1을 추가하면 됩니다. 이 기법을 라플라스 평활화(Laplace Smoothing)라고 합니다.
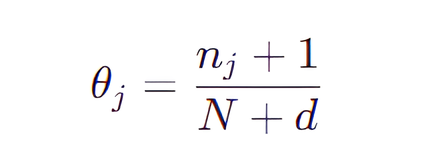
이제 모든 조합(원래 데이터 세트에 없는 조합 포함)은 0이 아닌 샘플링 확률을 가지지만, 원본 데이터 세트에 없는 포인트의 확률은 상수이므로 이는 여전히 만족스러운 생성 모델이 아닙니다. 반 고흐의 그림을 생성하기 위해 이러한 모델을 사용하려고 하면 다음 두 그림에 대해 동일한 확률로 작동됩니다.
원본 반 고흐 그림의 복제(원본 데이터 세트에 없음)
임의의 픽셀로 구성된 그림(원본 데이터세트에는 없음)
보조 제목
3.2 아주 간단한 모델
Naive Bayes 모델(Naive Bayes)은 위 특성의 조합 수를 크게 줄일 수 있으며, 해당 모델에 따라 각 특성은 서로 독립적이라고 가정합니다. 위의 데이터로 돌아가서 사람의 머리 색깔(특징)xj) 및 의복 색상 (특징 xk )는 연결이 없으며, 수학식으로 표현하면 다음과 같습니다.
p(xj | xk) = p(xk)
이 가정을 통해 우리는 다음을 계산할 수 있습니다.
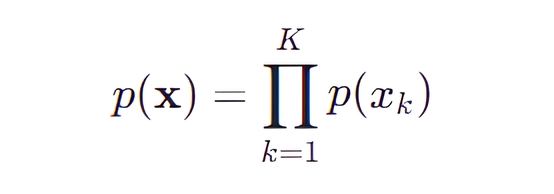
Naive Bayesian 모델은 원래 문제인 각 특성 조합에 대한 확률 추정을 각 특성에 대한 확률 추정으로 단순화합니다. 원래는 4031( 3 * 8 * 4 * 6 * 7) 매개변수를 사용해야 했습니다. 이제 23( 3 + 8 + 4 + 6 + 7) 매개변수가 필수이며, 각 매개변수의 표현은 다음과 같습니다.
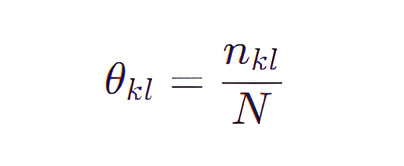
여기서 N은 관찰된 데이터의 수, 즉 50이고,nkl 첫 번째입니다 k다음 기능l 고유값의 수.
50개 데이터의 통계를 통해 다음 표는 Naive Bayesian 모델의 모수값을 보여준다.
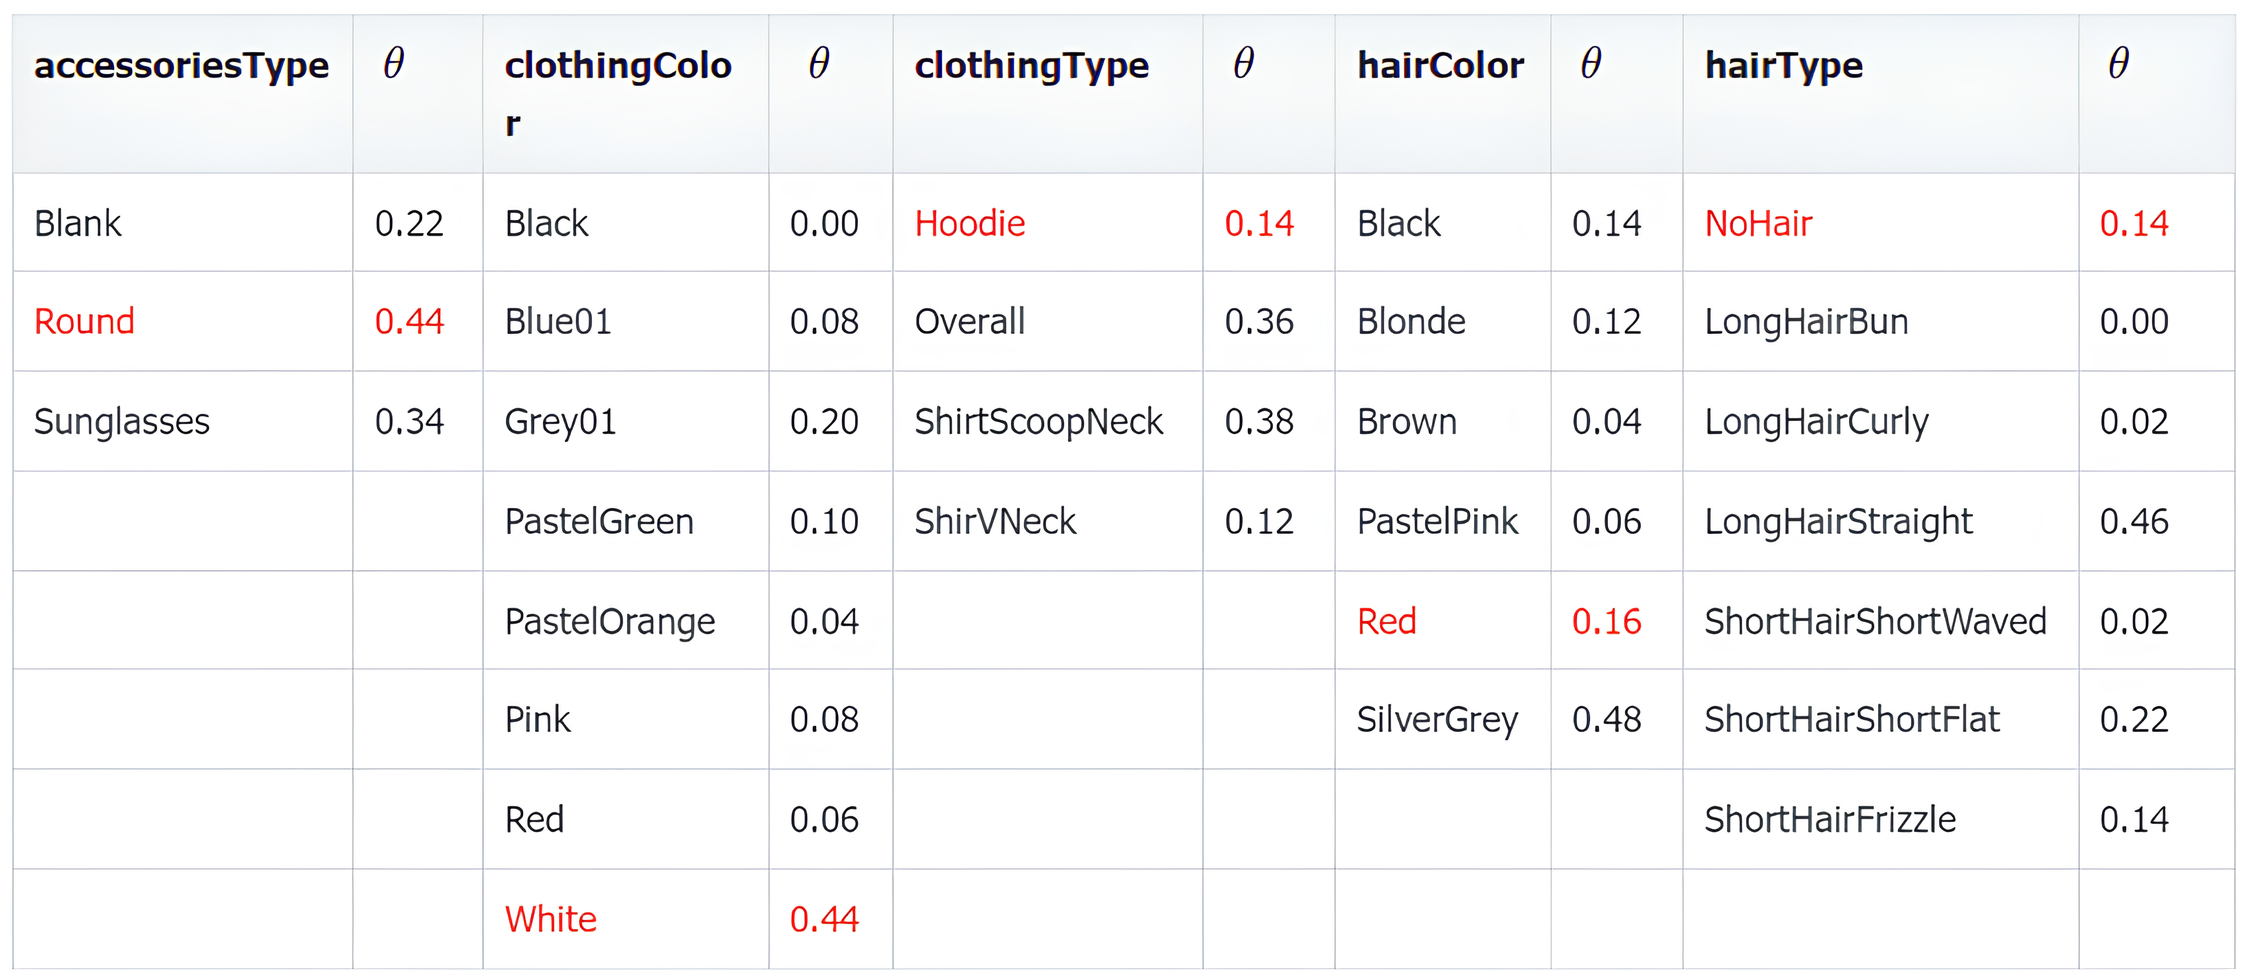
모델이 데이터 특성을 생성할 확률을 계산하려면 위 표의 확률을 곱하면 됩니다. 예를 들면 다음과 같습니다.
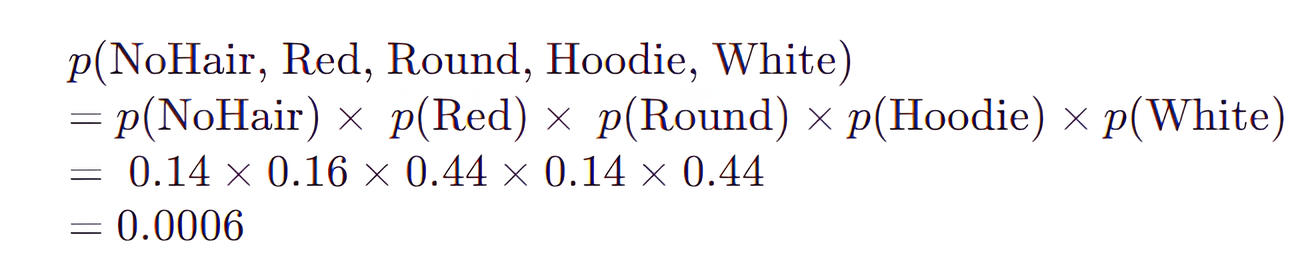
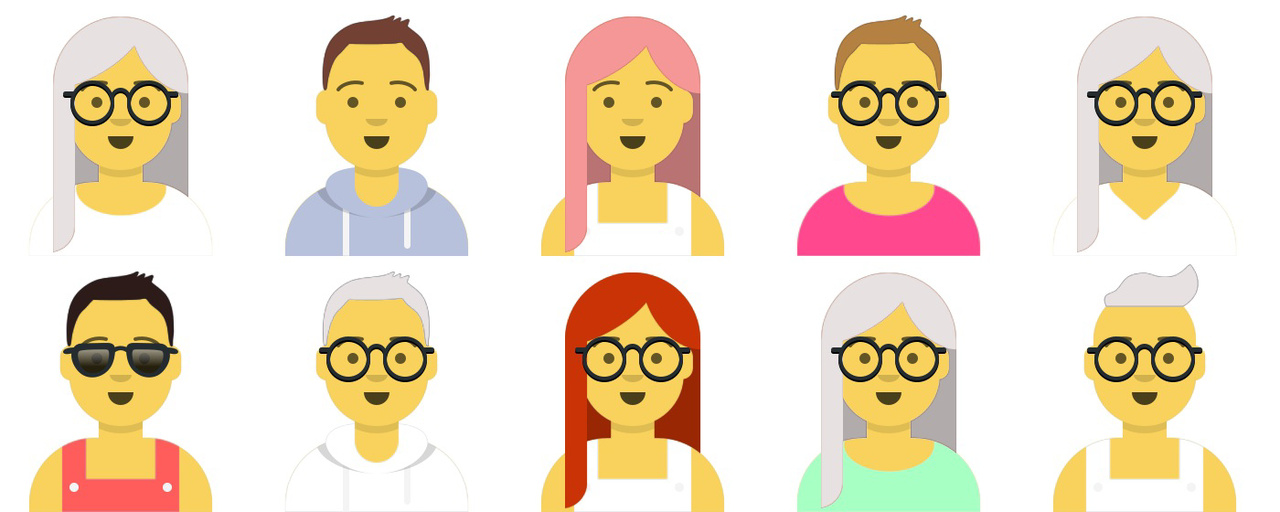
위의 조합은 원래 데이터 세트에는 나타나지 않았지만 모델은 여전히 0이 아닌 확률을 할당했기 때문에 여전히 모델에서 생성할 수 있었습니다. 따라서 Naive Bayesian 모델은 데이터에서 일부 구조를 학습하고 이를 사용하여 원래 데이터 세트에서 볼 수 없는 새로운 예를 생성할 수 있습니다. 아래 사진은 모델이 연출한 10가지 새로운 패션 코디 사진이다.
첫 번째 수준 제목
보조 제목
4.1 고차원 데이터
최고 패션 책임자로서 귀하는 Naive Bayesian을 사용하여 10개의 새로운 패션 조합을 성공적으로 생성했습니다. 귀하는 다음 데이터 세트를 만날 때까지 귀하의 모델이 무적이라고 확신합니다.
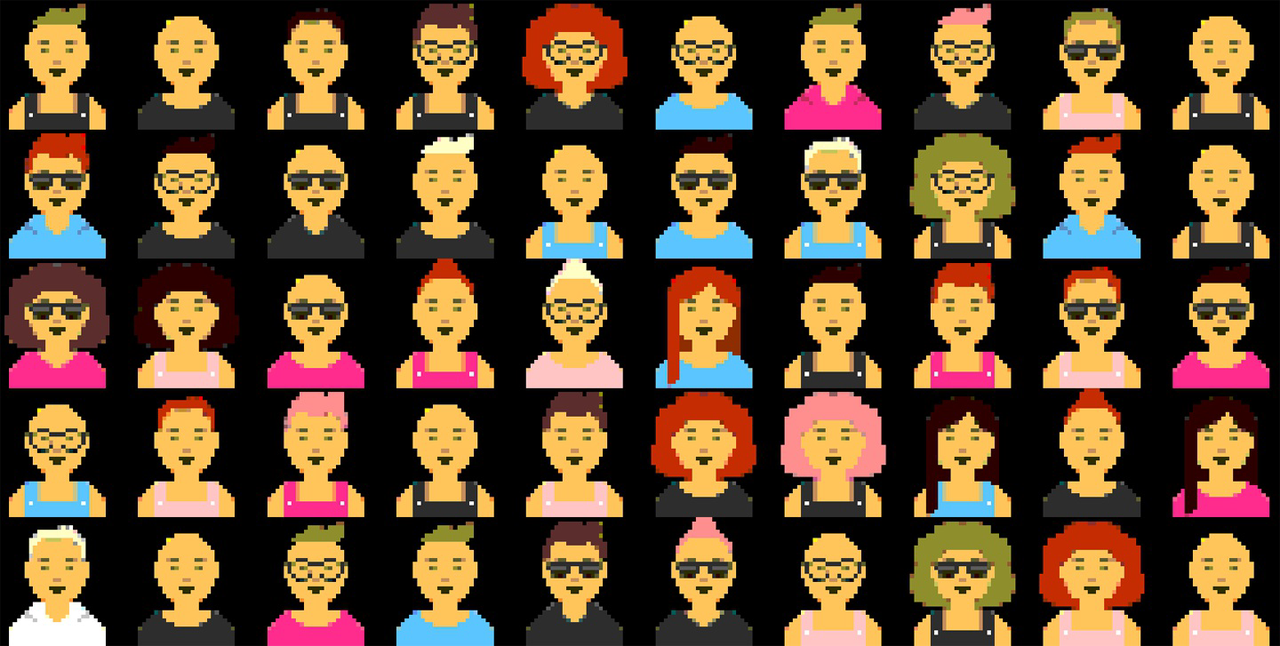
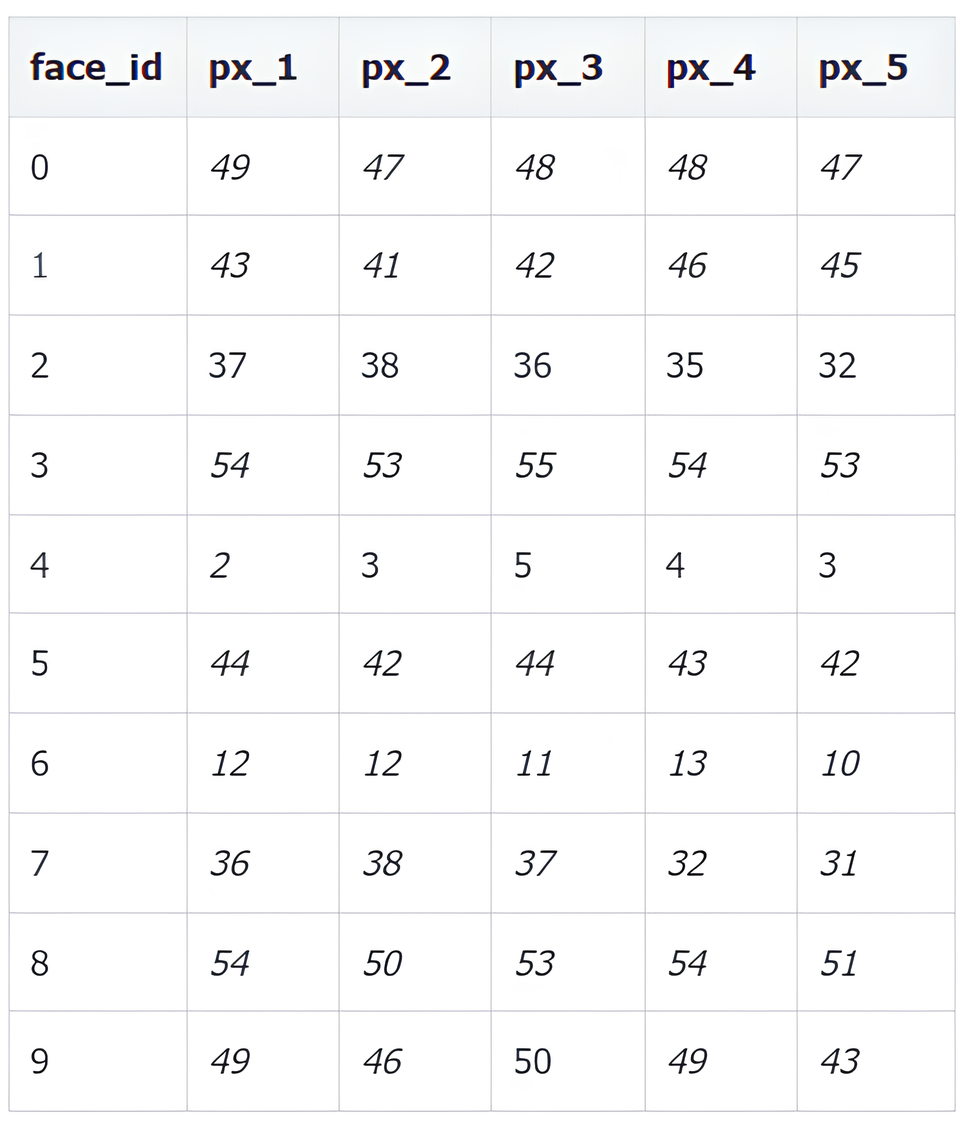
데이터 세트는 더 이상 5개의 특징으로 표시되지 않고 32* 32 = 1024픽셀로 표시되며 각 픽셀 값은 0~255 중 하나일 수 있으며 0은 흰색, 255는 검은색을 의미합니다. 다음 표에는 처음 10개 이미지에 대한 픽셀 1~5의 값이 나열되어 있습니다.
같은 모델을 사용하여 10벌의 새로운 패션 코디를 생성하면 다음과 같은 모델 생성 결과가 있는데, 모두 보기 흉하고 비슷해 서로 다른 특징을 구별할 수 없는데, 왜 그럴까요?
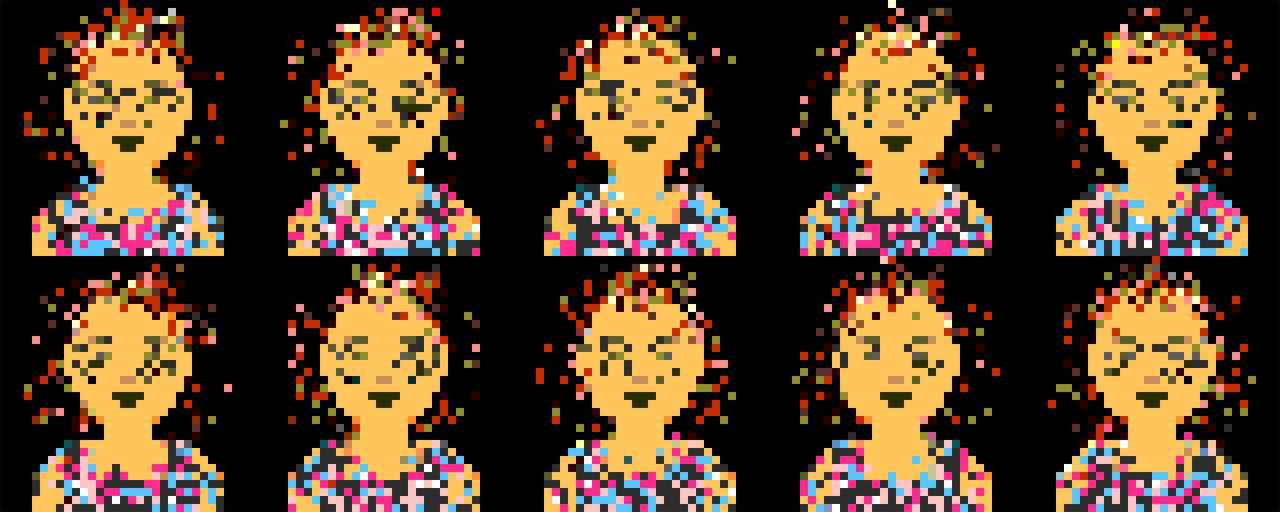
우선 Naive Bayesian 모델은 픽셀을 독립적으로 샘플링하기 때문에 인접한 픽셀은 실제로 매우 유사합니다. 사실 옷의 경우 픽셀이 거의 같아야 하는데, 모델이 랜덤하게 샘플링되었기 때문에 위 사진의 옷들은 모두 컬러풀합니다. 둘째, 고차원 표본 공간에는 가능성이 너무 많고 그 중 일부만 식별할 수 있습니다. Naive Bayesian 모델이 이처럼 상관 관계가 높은 픽셀 값을 직접 처리하는 경우 만족스러운 값 조합을 찾을 가능성은 매우 적습니다.
요약하면, 낮은 차원과 특징의 상관관계가 낮은 표본 공간에서는 독립 샘플링을 통해 Naive Bayesian 효과가 매우 좋지만, 높은 차원과 특징의 상관 관계가 높은 표본 공간에서는 효과적인 사람의 얼굴을 찾기 위해 독립 샘플링 픽셀을 사용합니다. 거의 불가능한.
이 예에서는 생성 모델이 성공하기 위해 극복해야 하는 두 가지 어려움을 강조합니다.
모델은 고차원 특성 간의 조건부 종속성을 어떻게 처리합니까?
모델은 고차원 표본 공간에서 조건을 충족하는 아주 작은 비율의 관측치를 어떻게 찾나요?
생성 모델이 고차원적이고 상관도가 높은 샘플 공간에서 성공하려면 딥 러닝 모델을 활용해야 합니다. 어떤 가정을 미리 해야 하는지 알려주는 대신 데이터에서 관련 구조를 추론할 수 있는 모델이 필요합니다. 딥러닝은 저차원 공간에서 자신만의 특징을 형성할 수 있으며, 이는표현 학습보조 제목
4.2 표현 학습
표현학습이란 고차원 데이터의 표현이 가지는 의미를 학습하는 것입니다.
한 번도 만난 적이 없는 네티즌을 만나러 갔는데, 모임 장소에서 그녀를 찾을 수 없는 사람들이 많아서 그녀에게 전화를 걸어 당신의 외모를 설명한다고 가정해보자. 이미지의 픽셀 1 색상은 검은색, 픽셀 2 색상은 연한 검정색, 픽셀 3 색상은 회색 등이라고 말하지는 않을 것입니다. 반대로 네티즌들은 보통 사람들의 외모에 대해 전반적으로 이해하고 이러한 이해를 통해 픽셀 그룹의 특징을 설명할 것이라고 생각할 것입니다. 예를 들어 짧은 검은색 머리에 아름다운 머리를 하고 있으며, 황금 안경 등. 보통 10개 이하의 설명으로 네티즌은 자신의 마음에서 당신에 대한 이미지를 생성할 수 있습니다.이미지가 거칠 수 있지만 네티즌이 당신을 한 번도 본 적이 없더라도 수백 명의 사람들 중에서 당신을 찾는 것을 막지는 못합니다.
이것이 직접적으로 시도하지 않고 표현 학습의 핵심 아이디어입니다.고차원 표본 공간(고차원 표본 공간) 모델링을 위해 사용하지만 일부저차원 잠재공간(저차원 잠재 공간) 훈련 세트의 각 관찰을 설명하고 다음을 학습합니다.매핑 기능(매핑 기능)은 잠재 공간의 한 점을 가져와 원래 샘플 공간에 매핑합니다. 즉, 잠재공간의 각 점은 고차원 데이터의 특징을 나타냅니다.
위의 단어가 이해하기 쉽지 않다면 일부 회색조 jar 이미지로 구성된 아래 훈련 세트를 참조하세요.
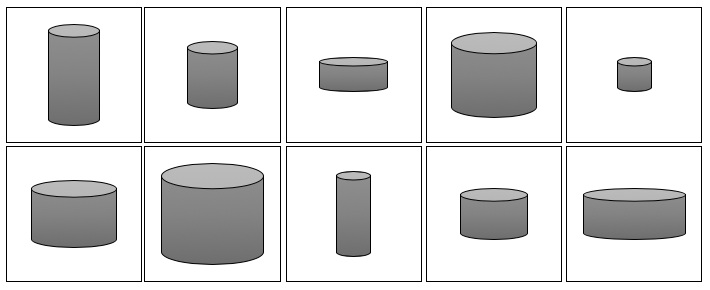
이 항아리가 높이와 너비라는 두 가지 특성으로만 설명될 수 있다는 것을 아는 것은 어렵지 않습니다. 따라서 아래 그림과 같이 이미지의 고차원 픽셀 공간을 2차원 잠재 공간으로 변환할 수 있습니다. 이 방법으로 잠재 공간(파란색 점)에서 샘플링한 다음 매핑 기능을 전달할 수 있습니다.f이미지로 변환해 보세요.
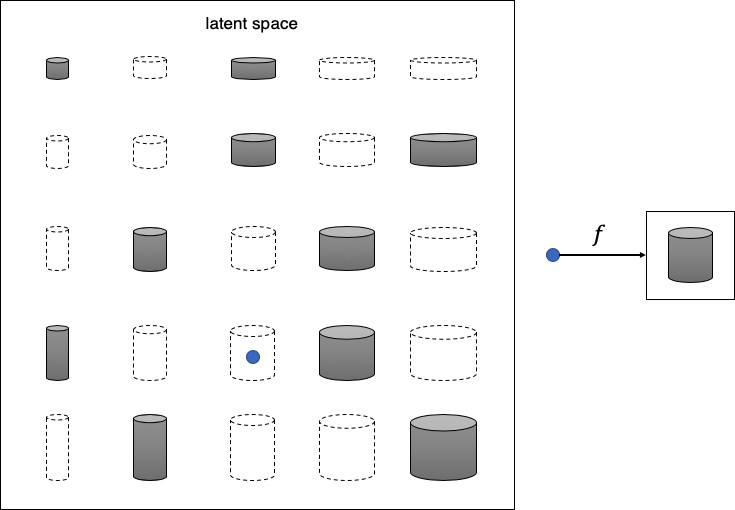
원본 데이터 세트가 더 단순한 잠재 공간으로 표현될 수 있다는 것을 기계가 인식하는 것은 쉽지 않습니다. 먼저 기계는 높이와 너비가 데이터 세트를 가장 잘 설명하는 두 개의 잠재 공간 차원인지 결정한 후 학습해야 합니다. 매핑 기능f 첫 번째 수준 제목
5. 생성 모델의 분류
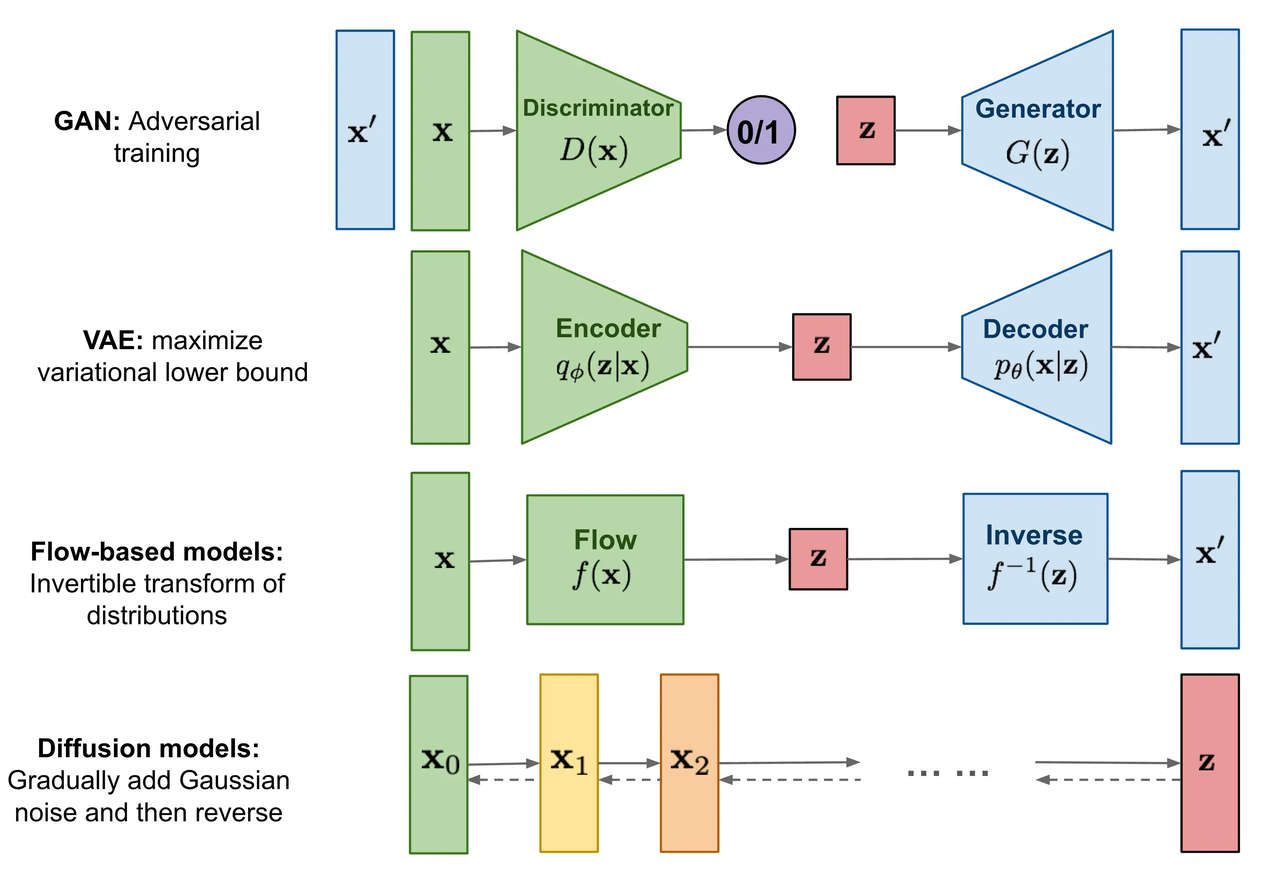
모든 유형의 생성 모델은 궁극적으로 동일한 작업을 해결하는 것을 목표로 하지만 모두 모델 밀도 기능은 약간 다른 방식으로 작동하며 일반적으로 두 가지 범주로 분류됩니다.
쌍 밀도 함수명시적 모델링(explicitly modeling),
그러나 밀도 함수가 계산되도록 모델을 어떻게든 제한합니다.정규화된 흐름 모델(normalizing FLOW model)
그러나 다음과 같이 밀도 함수를 근사화하려면변형 자동 인코더 (variational autoencoder,VAE) 및확산 모델 (diffusion model)
쌍 밀도 함수암시적 모델링(암묵적으로 모델링), 데이터를 직접 생성하는 확률론적 프로세스를 통해. 예를 들어요약하다 (generative adversarial network, GAN)
요약하다
GenAI(생성 인공 지능)는 텍스트, 이미지, 비디오, 음악 등 새로운 콘텐츠와 아이디어를 만드는 데 사용할 수 있는 인공 지능의 한 유형입니다. 모든 인공 지능과 마찬가지로 GenAI는 대량의 데이터를 기반으로 한 딥 러닝 모델로 사전 훈련된 매우 큰 모델입니다.기본 모델(foundation model,FM). GenAI를 사용하면 더 멋진 이미지를 그리고 더 아름다운 텍스트를 쓰고 더 감동적인 음악을 작곡할 수 있지만, 첫 번째 단계에서는 기사의 책임자인 Richard Feynman이 나는 이해하지 못할 것입니다. 내가 만들 수 없는 것.





