






SignalPlus: 심층 신경망에 대해 이야기


머리말
Deep neural networks are completely flexible by design, and there really are no fixed rules when it comes to model architecture.
-- David Foster
머리말
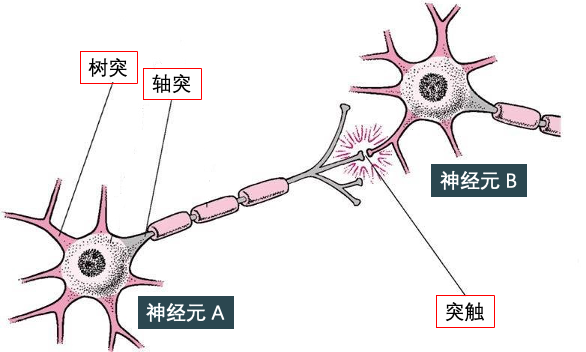
신경망(신경망) 인간의 뇌에서 영감을 받아 생물학적 뉴런을 모방하여 서로 신호를 전달할 수 있습니다. 신경망은 뉴런으로 구성된 시스템입니다. 아래 그림과 같이 뉴런에는 많은수상돌기(수상돌기) 입력에는축삭(축삭) 출력용. 여기에는 흥분성과 전도성이라는 두 가지 주요 특성이 있습니다.
흥분성이란 자극 강도가 특정 역치에 도달하지 않으면 신경 자극이 발생하지 않으며, 자극 강도가 이 값에 도달하면 신경 자극이 발생하여 순간적으로 최대 강도에 도달할 수 있음을 의미합니다.
전도도는 인접한 뉴런 사이의 작은 간격을 통한 뉴런의 전도를 나타냅니다. 이 작은 틈이라고 불리는시냅스(시냅스), 그 기능은 서로 다른 뉴런 사이에 신경 자극을 전달하는 것이며, 아래 그림의 시냅스는 뉴런 A와 B를 함께 연결합니다.
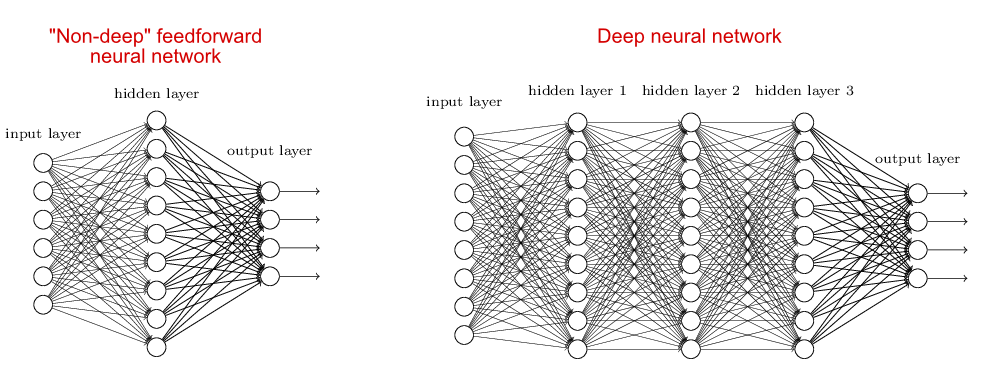
많은 시냅스가 많은 뉴런을 연결한다고 상상해보십시오. 그것이 신경망을 형성하지 않습니까? 응, 비유하자면인공 신경망 (artificial neural network,ANN) 역시 아래 왼쪽과 같이 수많은 인공뉴런으로 구성되어 있습니다.얕은 신경망(그림자 신경망)과 오른쪽 아래의 심층 신경망(심층 신경망)입니다.
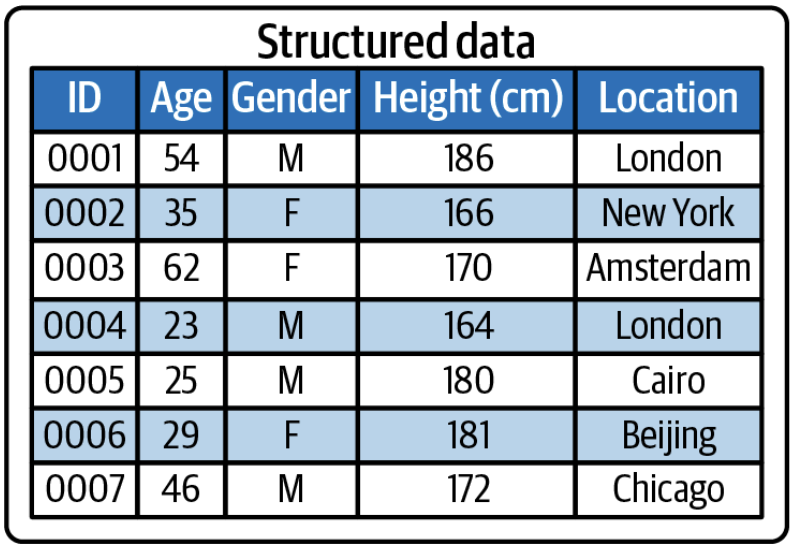
얕은 신경망은 다음에 적합합니다.구조화된 데이터아래 그림의 엑셀에 저장된 2차원 데이터와 같은 (구조화된 데이터)
 심층 신경망은 다음에 적합합니다.구조화되지 않은 데이터(비정형 데이터)는 아래 그림과 같이 이미지, 텍스트, 음성 데이터 등입니다.
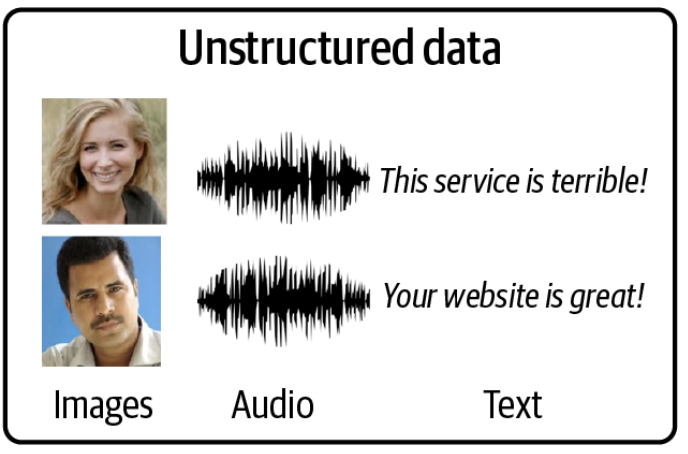
생성 AI 모델은 주로 비정형 데이터를 생성하므로 심층 신경망에 대한 이해가 필요합니다. 이 기사부터 시작하여 모델과 코드를 날릴 것입니다.
Talk is cheap. Show me the code.
-- Linus Torvalds
첫 번째 수준 제목
보조 제목
1.1 신경망에 대한 첫 번째 살펴보기
다음 신경망이 훈련된 후 사진에 웃는 얼굴이 포함되어 있는지 여부를 예측하는 데 사용되었다고 가정합니다.
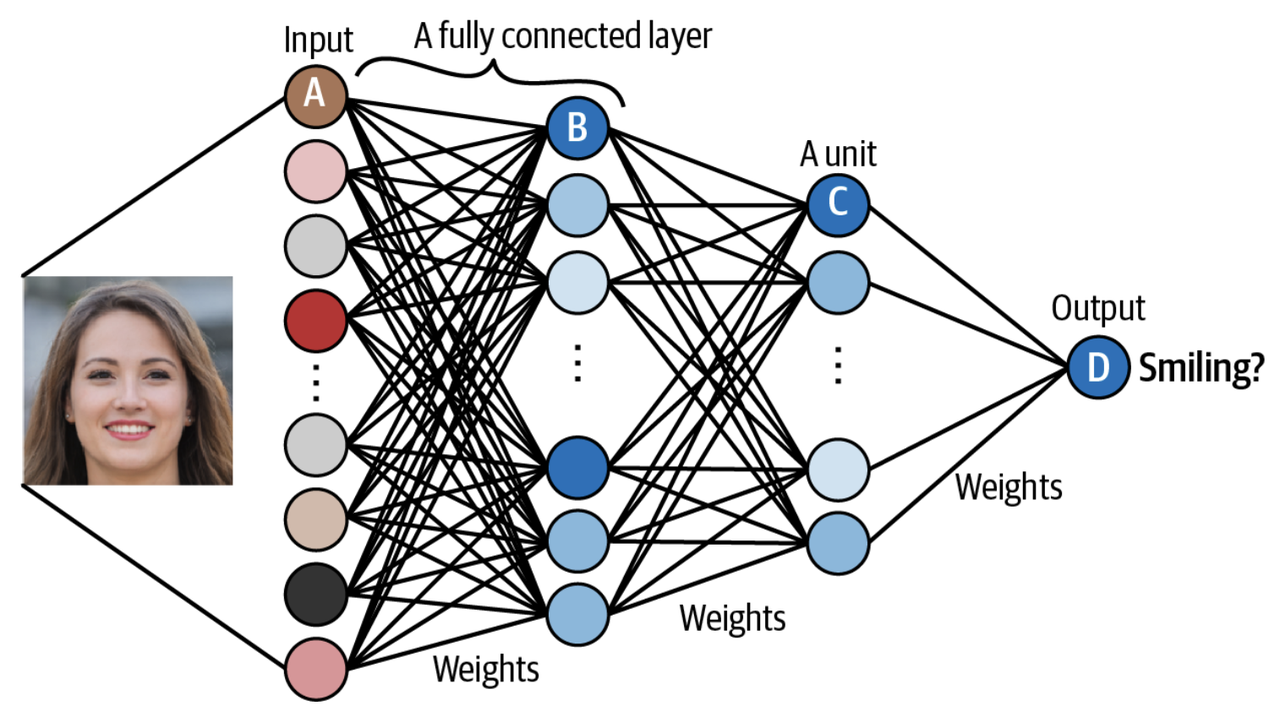
장치 A는 이미지의 픽셀 정보를 수신합니다.
유닛 B는 원본 이미지가 다음과 같은 경우 입력 픽셀을 결합합니다.낮은 수준의 기능(로우 레벨 기능) 예를 들어 에지(edge)에 도달하면 가장 강한 신호가 방출됩니다.
유닛 C는 다음과 같은 경우 낮은 수준의 기능을 결합합니다.고급 기능치아(teech)와 같은 (고수준 기능) 가장 강한 신호가 방출됩니다.
Unit D에는 원본 이미지의 인물이 웃고 있을 때 가장 강한 신호를 보내는 고급 기능이 포함되어 있습니다.
이 신경망에 충분한 데이터(예: 이미지)가 공급되면 일련의 이미지를 찾게 됩니다.가중치(가중치)를 사용하여 최종 예측을 최대한 정확하게 만듭니다. 가중치를 찾는 과정은 실제로 신경망을 훈련시키는 것입니다.
보조 제목
1.2 케라스 훈련 과정
모델
모델 (models)
층 (layers),입력하다(입력) 및산출 (output)
옵티마이저(최적화 프로그램) 및손실 함수 (loss)
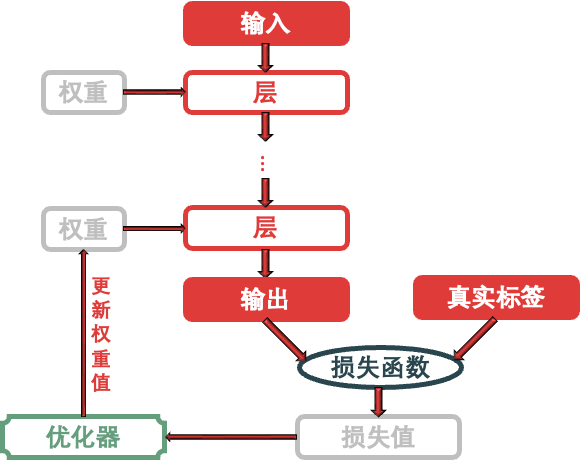
위의 키워드를 사용하여 Keras의 신경망 훈련 과정을 요약합니다.층모델모델,할 것이다입력하다데이터는 예측된 값에 매핑됩니다. 그 다음에손실 함수이 예측값을 취하세요.산출, 목표와 비교하여 손실 값을 얻습니다(네트워크 예측 값이 예상 결과와 얼마나 잘 일치하는지 측정하는 데 사용됨).옵티마이저이 손실 값을 사용하여 네트워크 가중치를 업데이트합니다.
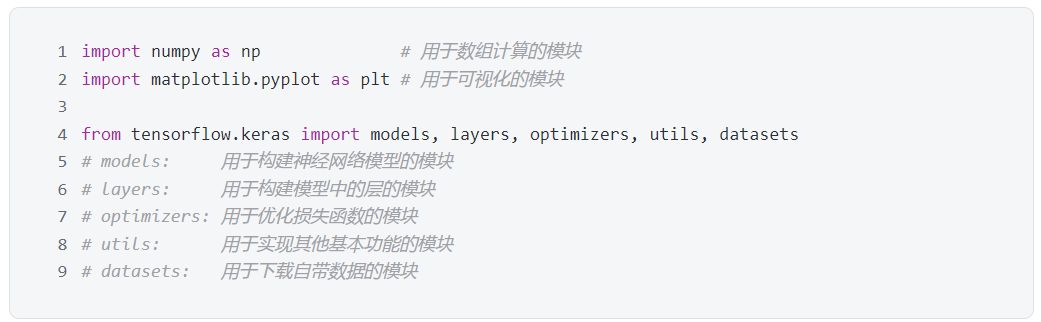
이 시점에서는 도구 라이브러리가 도입되더라도 마침내 일부 코드를 표시하는 것이 가능해졌습니다. 첫째, tensorflow.keras 라이브러리에서 신경망을 구축하는 데 사용되는 모듈입니다.
보조 제목
1.3 미니멀리스트 신경망
그리고x 그리고y 자료:
x = [-1, 0, 1, 2, 3, 4 ]
y = [-3, -1, 1, 3, 5, 7 ]
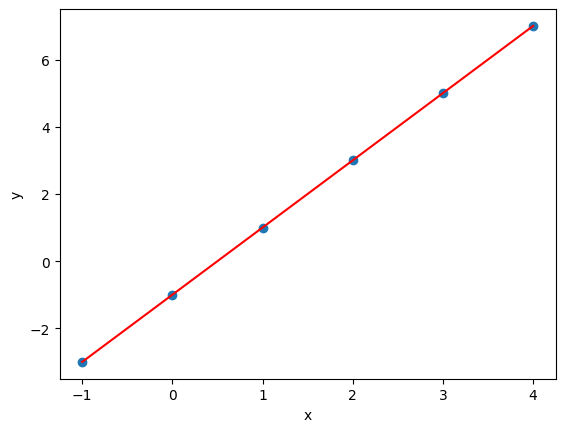
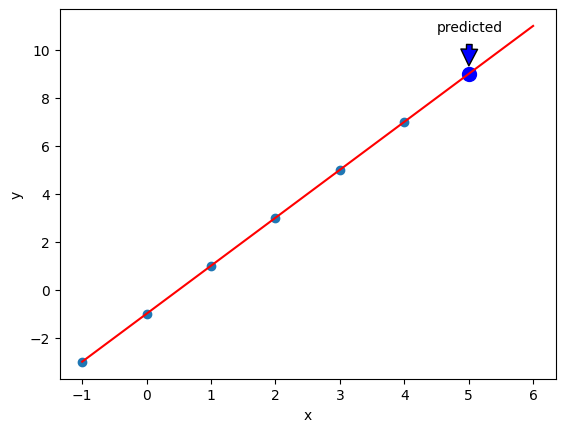
그리고x 그리고 y 언제 x 사이의 관계new= 10, 물어보세요new얼마나?
아래 그림과 같이,x그리고 y흩어진 점 형태로 그리면 아래 그림의 빨간 선이 임을 찾는 것은 어렵지 않습니다. x그리고 y보조 제목
1.3.1 모델 생성
하나의 뉴런이 있는 신경망 계층을 사용하면 코드는 다음과 같습니다.
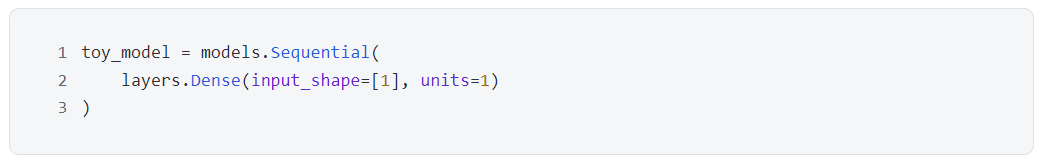
처음 사용models.Sequential() 빈 신경망을 생성한 다음 레이어를 계속 추가합니다. 여기에 추가했습니다.layers.Dense()보조 제목
1.3.2 모델 확인
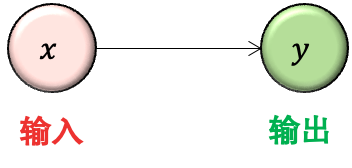
모델 정보를 확인해 보니 이상한 점은 매개변수 개수(아래 그림의 Param #)가 실제로 1개가 아닌 2개라는 점입니다. 왜냐면 위 사진에서y = wx, 만 있어야합니다w매개변수.
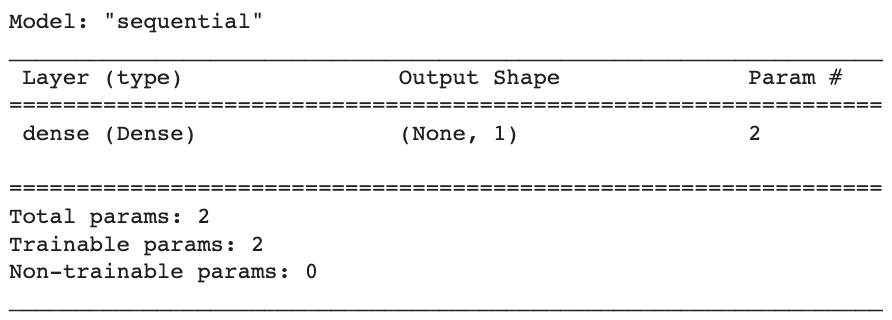
그 이유는 각 레이어의 매개변수 개수를 계산할 때 각 뉴런은 기본적으로 1의 값으로 연결되어 있기 때문이다.바이어스 단위(바이어스 단위)이므로 실제로 위 그림을 좀 더 정확하게 보면 다음과 같습니다.
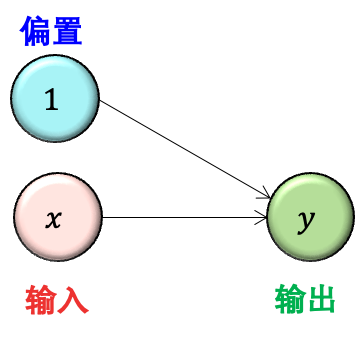
그렇죠, 이때는y = wx+b, 네w그리고 b 두 개의 매개변수.
엄밀히 말하면 사실 Dense()함수에는 여전히 활성화라는 매개변수가 있는데, 이는 문자 그대로 활성화 함수를 의미하며, 이것이 본질적으로 수행하는 작업은 다음과 같습니다.wx+b는 비선형 모드 스위치에 제공됩니다. y. 활성화 함수가 다음과 같이 정의되면 g,그래서y = g(wx+비). Keras에서는 활성화 값을 지정하지 않으면 비선형 변환을 수행할 필요가 없습니다. 활성화 함수의 개념을 추가하면 완전한 그림이 제공됩니다.
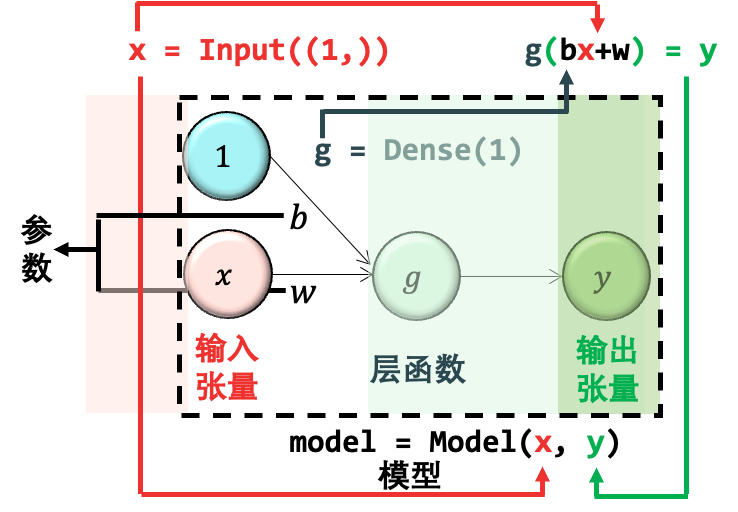
우리의 목표는 위 그림에서 매개변수인 가중치를 찾는 것입니다.w보조 제목
1.3.3 모델 컴파일
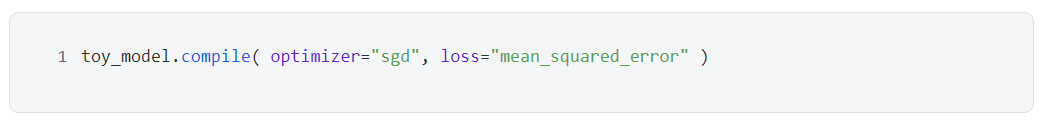
모델 프레임워크가 설정된 후 다음 단계는 다음과 같이 문제를 최적화하는 것입니다.complie()기능 설정 매개변수 최적화="sgd"즉, 최적화 방법을 확률적 경사하강법으로 지정하고 매개변수 loss=를 설정합니다."mean_squared_error"보조 제목
1.3.4 훈련 모델
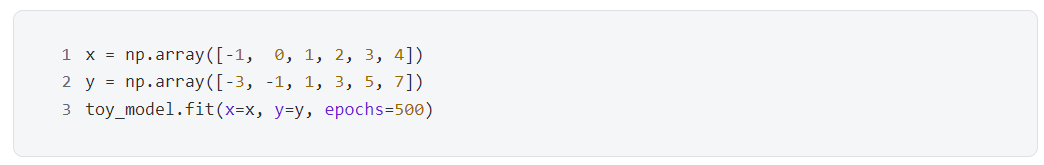
훈련 모델 fit()함수, 데이터 x와 y를 전달합니다. 매개변수 epochs= 500, epoch는 중국어로 기간, 즉 전체 훈련 세트가 알고리즘에 의해 순회되는 횟수라는 점에 주목할 가치가 있습니다. 여기서는 500회 순회 후 모델 훈련이 종료됩니다.
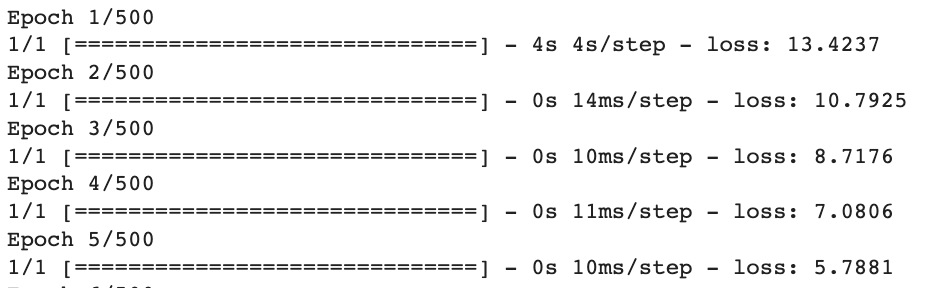
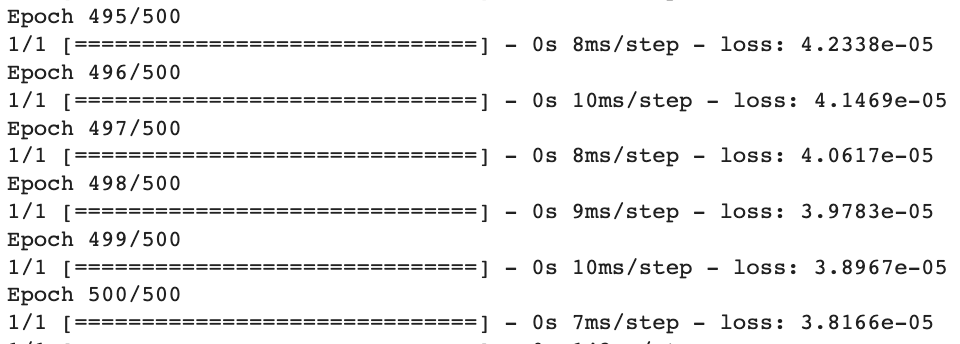
처음과 마지막 5개 기간의 정보를 출력해 보면 13.4237 시작 부분에서는 손실이 매우 크고 끝 부분에서는 손실이 3.8166e-05에 불과하여 매우 작은 것을 쉽게 알 수 있어 예측값이 훈련 세트의 값은 실제 값과 거의 동일합니다.
모델 학습 후에는 다음을 사용할 수 있습니다.get_weights() 매개변수를 확인하는 기능입니다.
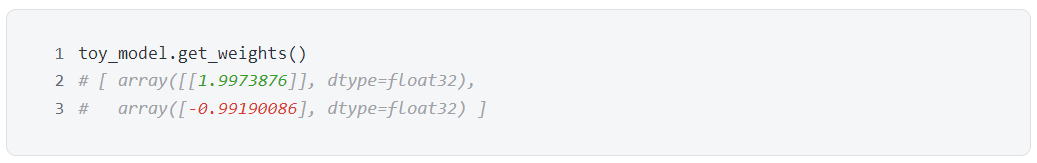 반환된 첫 번째 결과는 가중치입니다.w, 두 번째 편견b보조 제목y = 1.9973876 x - 0.99190086 ≈ 2 x - 1 。
1.3.5 평가 모델
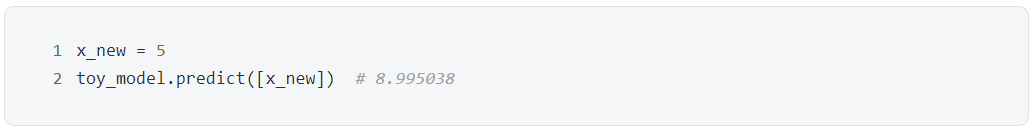
모델 평가를 위한predict() 함수, 새 데이터 x_new를 전달하고 결과 8.995028을 얻습니다. 이는 2*x_new - 1 = 9에 매우 가깝습니다.
아래 그림에서 볼 수 있듯이 신경망은 6개의 데이터(짙은 청록색 점)로부터 모델(빨간색 선)을 학습했으며, 해당 모델은 새로운 데이터(파란색 점)에 사용될 수 있습니다.
신경망의 전체 과정을 요약하면 다음과 같습니다.
모델 생성:사용Sequential(), 물론 다른 더 나은 방법이 있으며 이에 대해서는 다음 섹션에서 설명합니다.
모델 확인:사용summary()
모델 컴파일:사용compile()
훈련 모델:사용fit()
평가 모델:사용predict()
이 예제에서는 미니멀리스트 신경망을 구축하지만 5단계가 많고, 복잡한 신경망을 구축하려면 이 5단계도 필요합니다. 차이점은 첫 번째 단계에서는 모델을 생성할 때 많은 레이어가 서로 연결된다는 점입니다. 다섯 번째 단계에서는 더 발전된 최적화 프로그램이 선택되지만 결코 변경되지 않습니다. 다음 두 섹션에서는 약간 더 복잡한 두 가지 신경망, 즉앞으로피드백 신경망 (feedforward neural network,FNN) 및첫 번째 수준 제목 (convoluational neural network, CNN)。
2. 피드포워드 신경망(FNN)
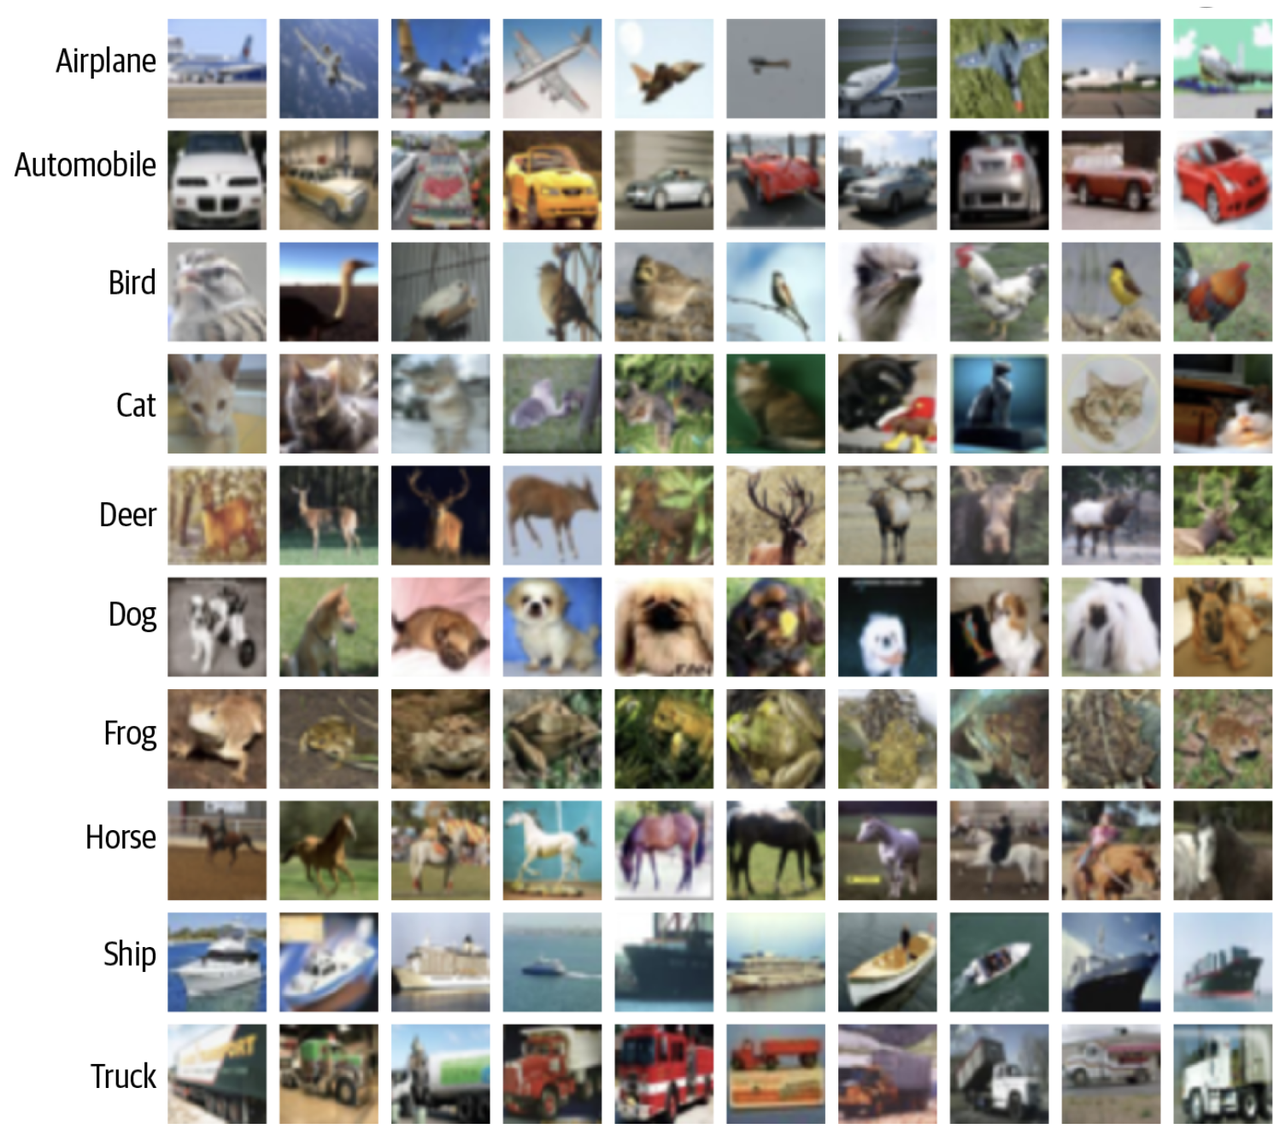
이전 섹션의 미니멀리스트 신경망은 너무 지루하지만 주로 Keras에서 신경망의 개념과 단계를 명확히 하는 데 사용됩니다. 신경망을 살펴보고 몇 가지 흥미로운 작업을 수행하고 이미지 카테고리를 예측해 보겠습니다. 먼저 사용된 데이터세트 CIFAR-10(https://www.cs.toronto.edu/~kriz/cifar.html)을 살펴보세요.
데이터 세트에는 총 60,000개의 컬러 이미지가 있으며, 이러한 이미지는 32*32이고 10개의 클래스로 나뉘며 각 클래스에는 6000개의 이미지가 있습니다. 이 중 50,000개의 이미지는 훈련에 사용되고 나머지 10,000개는 테스트에 사용됩니다. 다음 그림은 10개의 카테고리 목록과 각 카테고리에 무작위로 표시된 10개의 사진입니다.
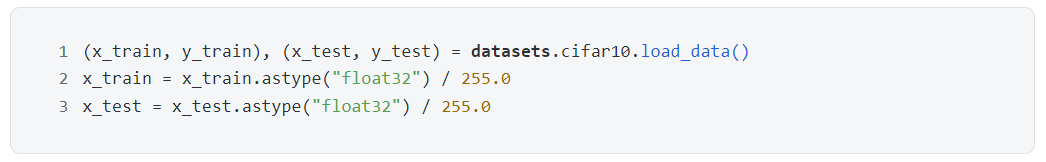
모듈 데이터세트의 load_data() 함수를 사용하여 데이터를 다운로드하고 이미지의 픽셀을 정규화합니다. 원래 픽셀은 0에서 255 사이였지만 이제 0에서 1 사이로 정규화됩니다.
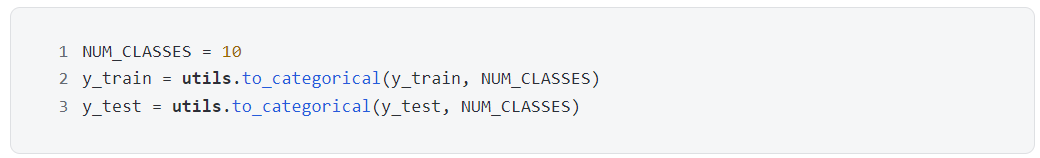
카테고리의 경우 모듈 utils의 기능을 사용하십시오.to_categorical() 이 함수는 범주에 대해 원-핫 인코딩을 수행합니다. 아이디어는 단 하나의 1을 포함하는 벡터로 정수를 표현하는 것입니다. 예를 들어 카테고리 5는 원-핫 인코딩 후 [0, 0, 0, 0, 1, 0, 0, 0, 0, 0 ]이 되고, 벡터는 10개입니다. 요소 수는 카테고리 수와 같습니다. 벡터의 다섯 번째 요소만 1(uniquely hot🔥)이고 나머지는 0(so cold🧊)입니다.
보조 제목

보조 제목
2.1.1 순서
우리는 이전 섹션에서 순차 모델링을 보았습니다.models.Sequential()은 빈 신경망을 생성한 다음 레이어를 계속 추가합니다. 이 예에는 레벨링 레이어가 있습니다.layers.Flatten() 및 세 개의 조밀한 레이어layers.Dense()。
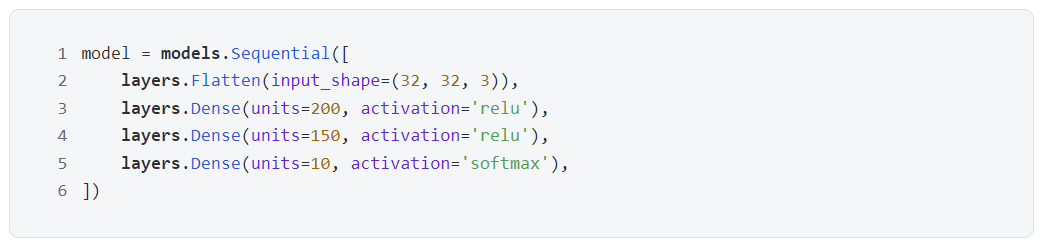
위의 코드는 아래 그림에 표시된 모델을 제공합니다.
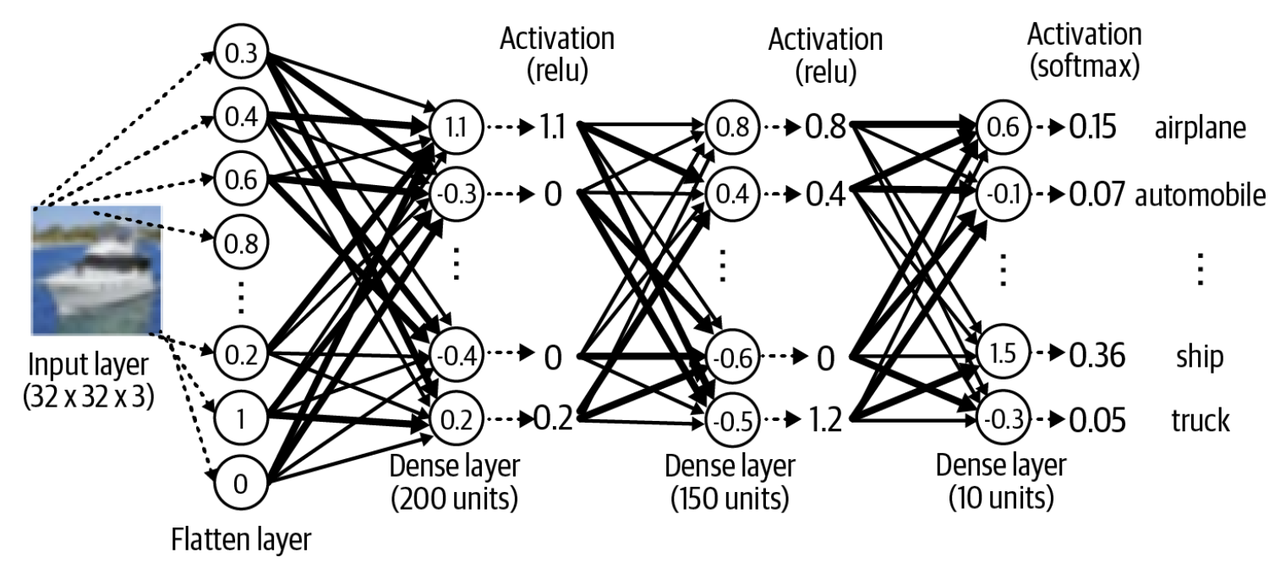
감각적 지식을 가지고 코드를 공부해보자. 레벨링 레이어가 필요한 이유는 무엇입니까? 이미지는 너비, 높이, 색상 채널의 3차원을 가지므로 1차원으로 병합하는 과정은 아래 그림과 같습니다.
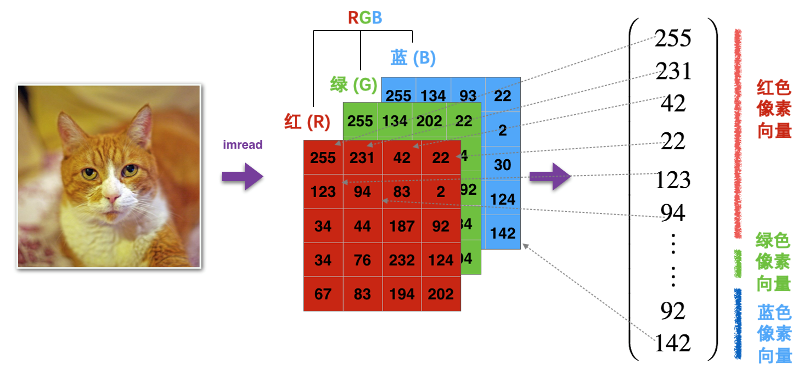
원본 이미지(32, 32, 3)는 평탄화 레이어에 입력되고(input_shape 매개변수에 이미지 차원 크기 지정) 평탄화 후에는 32*32*3 = 3072의 벡터가 되는데, 이는 다음과 같이 상상할 수 있다. 이제 입력에는 3072개의 뉴런이 있습니다. 3개의 조밀한 층 이후
뉴런(매개변수 단위)의 수는 각각 200, 150, 10개이며, 처음 두 개의 200과 150은 임의로 부여되거나 하이퍼 매개변수로 디버깅되지만 마지막 10개는 카테고리 수와 일치합니다.
사용된 활성화 함수(파라미터 활성화)는 각각 relu, relu, softmax인데 처음 두 relu는 거의 표준이나 마지막 소프트맥스가 작업과 관련된 문제라면 다중 분류 문제라면 소프트맥스를 사용한다.
흔한활성화 기능(활성화 기능) 아래와 같이:
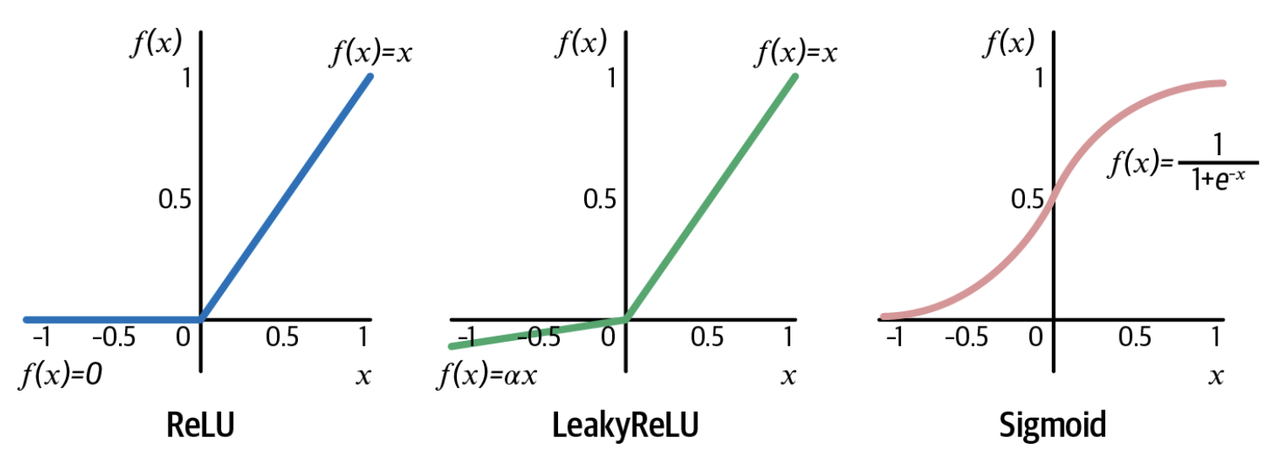
ReLU는 음수 입력(x < 0)을 0으로 변환하고 양수 입력(x > 0)은 변경되지 않은 상태로 유지합니다. LeakyReLU는 ReLU와 매우 유사하지만 유일한 차이점은 음수 입력(x< 0), 변환 결과도 입력에 비해 음수(ax)입니다.
Sigmoid 실수를 0~1 사이의 숫자로 변환하면 이 숫자는 확률로 간주될 수 있으므로Sigmoid 이진 분류 문제를 위한 함수, 확장 버전Softmax보조 제목
2.1.2 기능적 스타일
실제로 우리는 다음을 사용하는 데 더 익숙합니다.기능의(기능적) 모델링. 순차적으로 구축된 모델은 함수형 방식으로 완성할 수 있고, 그 반대도 가능하며, 둘 중 하나를 선택한다면 함수형 방식만을 사용하여 모델을 구축하는 것이 좋습니다. 코드는 아래와 같이 표시됩니다.
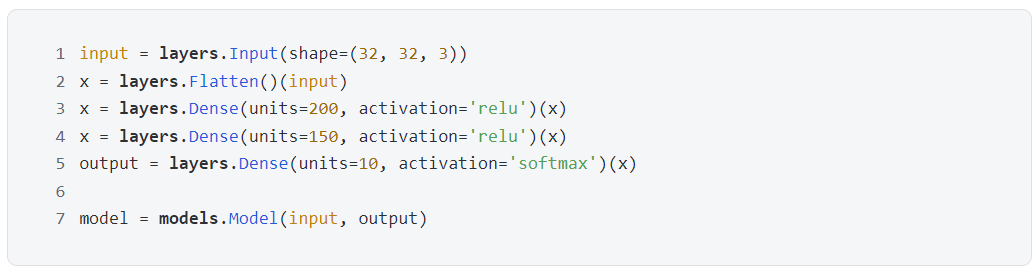
기능적 모델링은 다음 문장 하나만 기억하면 됩니다.레이어를 함수로 사용. 이 문장을 염두에 두면 코드는 몇 초 안에 이해될 수 있습니다.
1호선, Input() 이미지 데이터를 수신합니다.
2호선, 넣어Flatten() 함수로f, 단순화는 x = f(입력)이 아닙니다.
3번째 줄에 다음을 입력하세요.Dense(units= 200,활성화='relu')를 함수로g, 단순화는 x = g(x)가 아닙니다.
4번째 줄, 넣어Dense(units= 150,활성화='relu')를 함수로h, 단순화는 x = h(x)가 아닙니다.
5번째 줄, 넣어Dense(units= 10,활성화='softmax')를 함수로q, 단순화는 출력되지 않습니다 = q(x)
이러한 계층별 함수는 입력을 출력으로 전달하고 출력 = q(h(g(f(input))))를 사용하고 마지막으로 다음을 사용합니다.models.보조 제목
2.2 모델 확인
모델이 생성된 후 사용하기 전에 다음을 사용하여 신경망의 각 계층의 데이터 모양이 올바른지 확인하는 것이 가장 좋습니다.summary() 기능을 사용하면 그러한 정보를 인쇄할 수 있습니다.
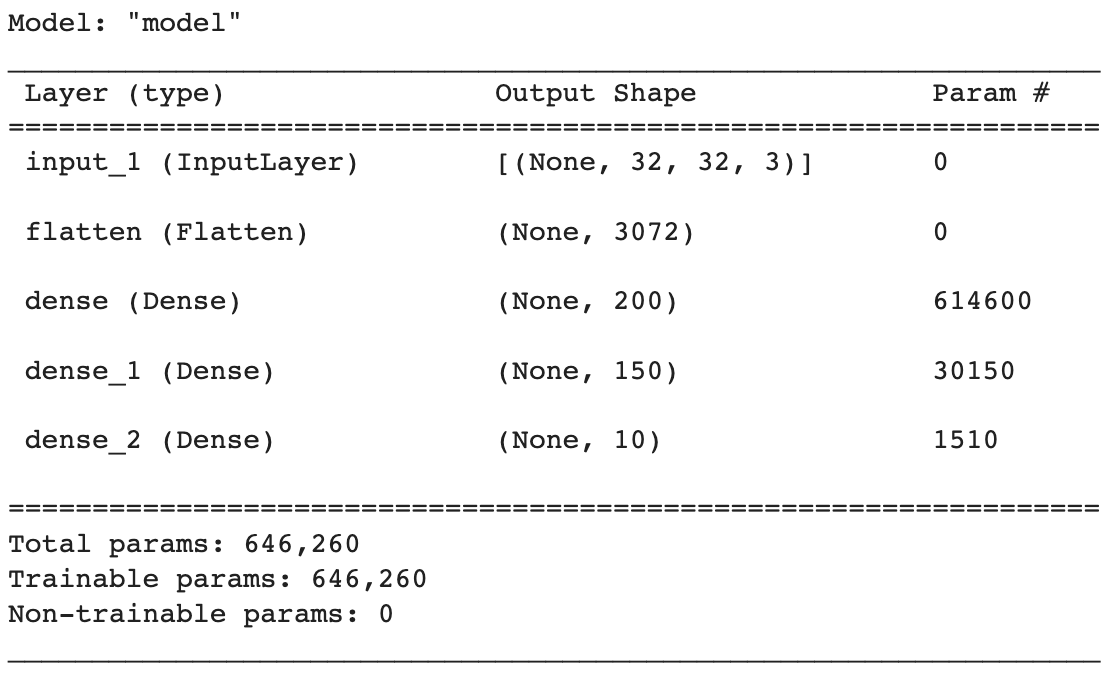
모델 이름은 자동으로 model로 지정되고, 각 레이어의 이름 유형(레이어(type)), 출력 모양(Output Shape) 및 매개변수 수(Param #)를 설명하는 테이블이 표시됩니다. 레이어별로 살펴보자
InputLayer 레이어의 이름은 input_ 1 이고 출력 모양은 [None, 32, 32, 3 ]입니다. 마지막 세 요소는 이미지 너비, 높이 및 색상 채널에 해당합니다. 첫 번째 None 은 실제로 샘플 수를 나타냅니다. 더 엄밀하게 말하면 말하자면 배치의 샘플 수입니다. 코드 간결성을 위해 일반적으로 이 샘플 번호는 모델링 시 명시적으로 작성할 필요가 없습니다.
Flatten 레이어의 이름은 flatten이고, 3072는 병합 후 32* 32* 3의 수이고 매개변수 수는 0입니다. 왜냐하면 병합은 단지 배열의 모양을 변경하기 위한 것이고 모양 변경 작업을 완료하는 데 매개변수가 필요하지 않기 때문입니다.
첫 번째 Dense 레이어의 이름은 Dense이고 출력 모양은 200이며 매개변수 614, 600 = ( 3072 + 1) * 200입니다. 바이어스 단위를 잊지 마세요.
두 번째 Dense 레이어의 이름은density_1이고 출력 모양은 150이며 매개 변수는 30, 150 = (200 + 1) * 150이며 바이어스 단위도 고려합니다.
세 번째 Dense 레이어의 이름은density_2이고 출력 모양은 10이며 매개 변수는 1, 510 = (150 + 1) * 10이며 바이어스 단위도 고려합니다.
하단에는 전체 매개변수(Total params)도 나열되어 있습니다.646, 260 , 훈련 가능한 매개변수의 양(Trainable params)646, 260 , 훈련 불가능한 매개변수의 양(Non-trainable params)0 보조 제목
2.3 모델 컴파일
모델이 구축되면 모델을 컴파일해야 하며 다음 세 가지 사항을 설정해야 합니다.
해결하려는 작업에 따라 손실 함수를 선택하세요.
이상적인 최적화 프로그램을 선택하세요
모니터링하려는 측정항목을 선택하세요.
다음을 사용하여 모델을 컴파일합니다.complie() 존재하다
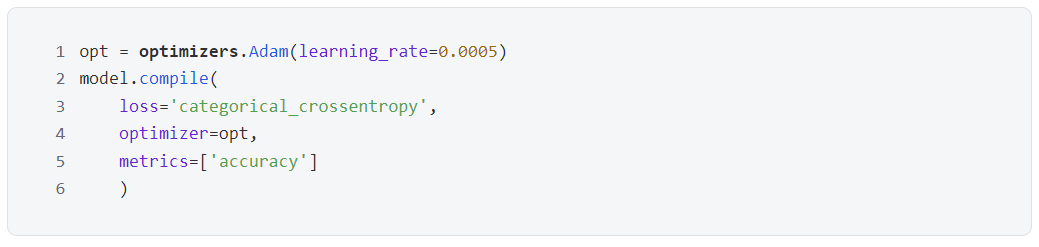
존재하다complie()기능에서:
매개변수 손실의 경우 이 예제는 매우 수준 높은 문제이므로 사용된 손실 함수는 categorical_crossentropy입니다.
두 가지 분류 문제: 손실 함수는 Binary_crossentropy입니다.
회귀 문제: 손실 함수는 평균 제곱_오류입니다.
매개변수 최적화 프로그램의 경우 기본 학습률과 함께 adam 및 rmsprop 최적화 프로그램을 사용하는 것은 대부분의 경우 안전합니다. 이 매개변수를 설정할 때 이름을 사용하고 개체를 인스턴스화하여 호출할 수도 있습니다.
이름 : 'sgd'
개체: Optimizers.Adam(learning_rate= 0.0005)
매개변수 측정항목의 경우 이름을 사용하고 개체를 인스턴스화하여 호출할 수도 있습니다. 이 예에서는 표시기가 정밀도이므로 다음과 같이 작성할 수 있습니다.
이름: ['정확도']
개체: [metrics.categorical_accuracy]
보조 제목
2.4 훈련 모델
훈련 모델은 모든 데이터를 함께 넣지 않고 일괄적으로 넣습니다. 훈련 모델을 소개하기 전에 몇 가지 개념을 명확히 해야 합니다.
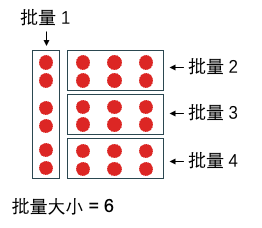
배치 크기(배치 크기)는 배치의 샘플 수를 나타냅니다. 다음 예에서는 총 24개의 데이터가 있는데, 각 배치에 6개의 데이터가 있으면 전체 사무실을 4개의 배치로 나눌 수 있습니다.
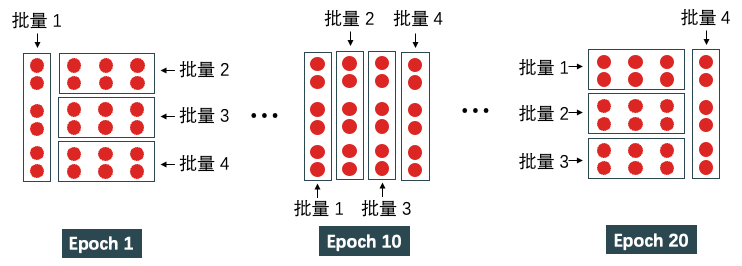
예상하다(에포크)는 알고리즘이 전체 훈련 세트를 한 번 통과한다는 것을 의미합니다. Epoch가 20으로 설정되면 전체 훈련 세트를 다양한 방식으로 20회 순회해야 합니다. 전체 데이터 세트를 순회하려면 한 에포크가 4번의 반복을 거쳐야 합니다. 즉, 총 샘플 수 / 배치 크기 = 24 / 6 반복입니다. 20 에포크의 실행 과정은 아래 그림과 같습니다.
훈련 모델fit()함수의 코드는 다음과 같습니다.
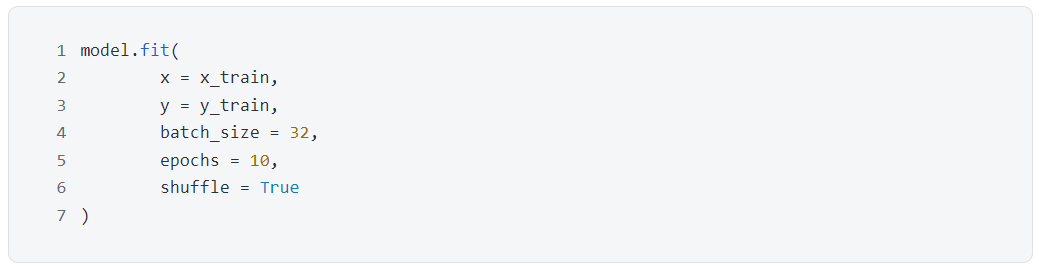
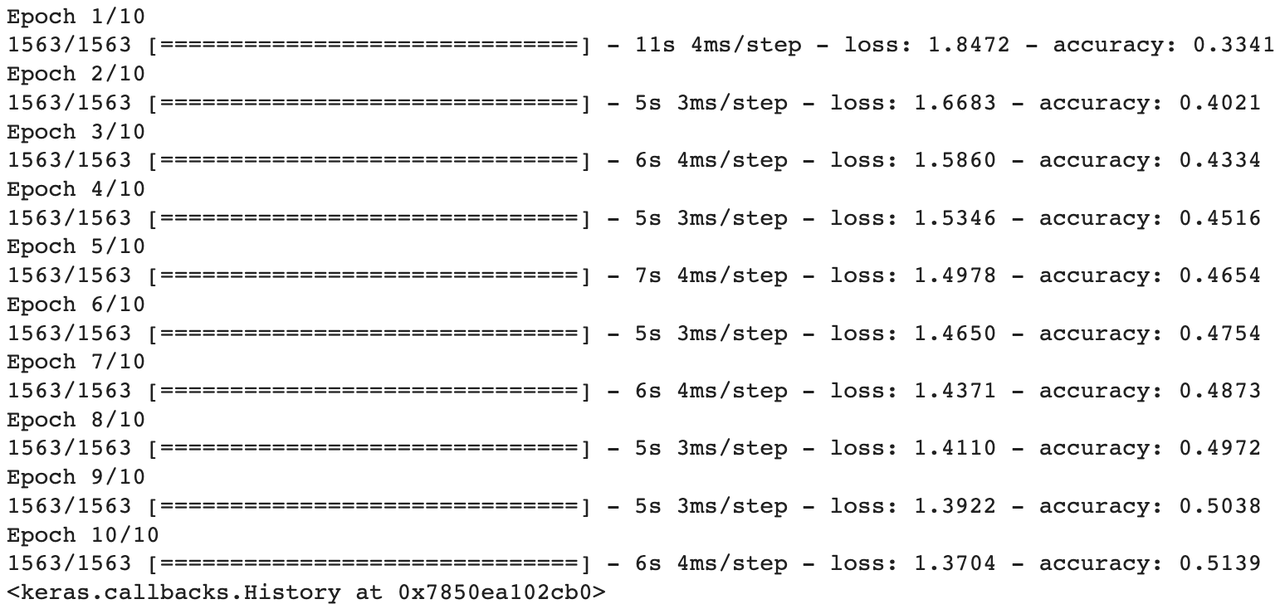
위 그림은 훈련 단계를 보여주고 있는데, 훈련 세트가 1563개의 파일로 나누어져 있으며 각각 32개의 이미지(배치 크기)를 포함하고 있음을 쉽게 알 수 있습니다. 10 에포크 이후,손실 함수(범주형 교차 엔트로피)는 1.8472에서 1.3696으로 떨어졌습니다.정확성(정확도)가 33.41%에서 으로 증가했습니다. 51.39% . 훈련 세트에서 모델에 접근할 수 있습니다.51.39% 보조 제목
2.5 평가 모델
사용evaluate()이 기능은 정확도에 직접적으로 의존합니다.
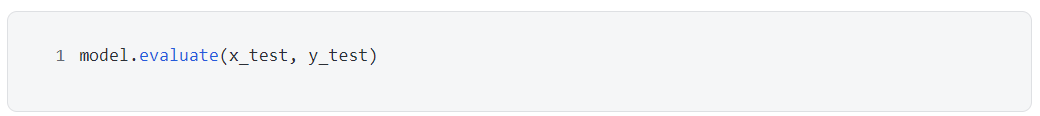
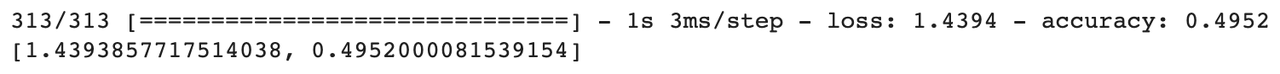
테스트 세트에서 모델의 정확도는 다음과 같습니다.49.52% 이는 범주를 무작위로 예측하는 정확도 10%보다 훨씬 높습니다(범주가 10개이기 때문). 이미지 카테고리를 예측하기 위해 매우 간단한 피드포워드 신경망을 사용하므로,49.52% 정확도는 이미 좋은 결과로 간주됩니다.
사용predict()함수는 예측된 클래스와 실제 클래스를 비교합니다.
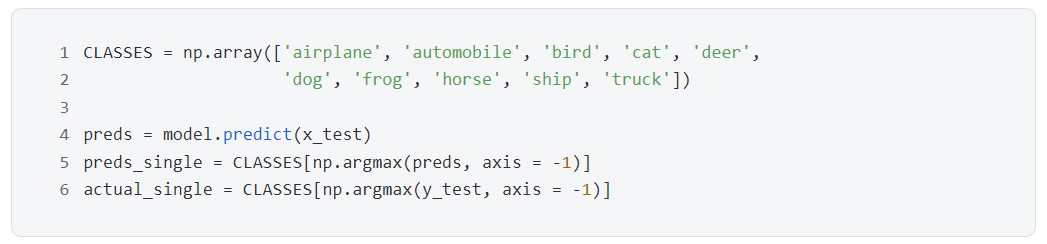
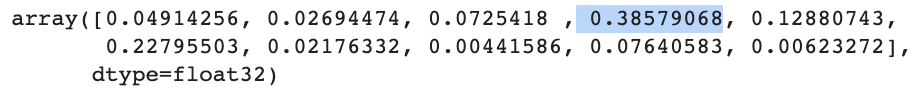
테스트 세트에는 10,000장의 사진이 있고, 10개의 카테고리가 있으므로 preds는 [10000, 10]의 배열이고, 각 행은 해당 사진에 대해 모델이 예측한 10개의 카테고리의 확률입니다. 물론 모든 확률은 1 까지 더하세요. 테스트 세트의 첫 번째 이미지에 대한 예측을 살펴보세요.
y_test는 또한 [ 10000, 10 ]의 배열이며, 각 행은 해당 그림의 실제 범주이므로 10개의 요소에는 9개의 0과 1개의 1이 있습니다. 테스트 세트에 있는 첫 번째 이미지의 실제 카테고리를 살펴보세요.
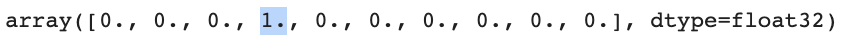
예측 결과 preds[0,:]에서 카테고리 4의 확률이 0.38579068로 가장 높고, 실제 카테고리 test[0.:]가 카테고리 4(네 번째 요소가 1임)임을 확인하는 것은 어렵지 않습니다. np.argmax를 사용하여 예측 결과 preds[0,:]와 실제 카테고리 test[0.:]에서 최대값에 해당하는 인덱스를 찾고, CLASSES에서 카테고리 설명을 매핑합니다.
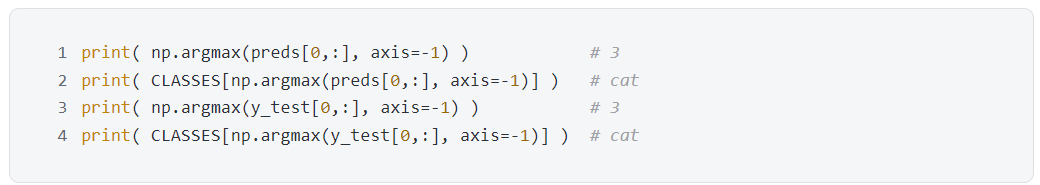
테스트 세트의 첫 번째 사진은 고양이이고 모델은 고양이를 예측하므로 맞습니다!
네 번째 것을 다시 시도해 보세요.
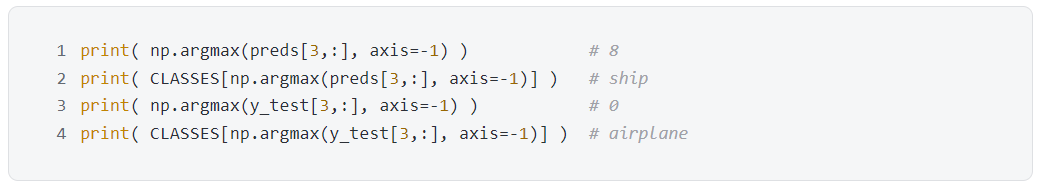
테스트 세트의 네 번째 사진은 배인데, 모델이 비행기를 예측했는데, 이는 틀렸습니다!
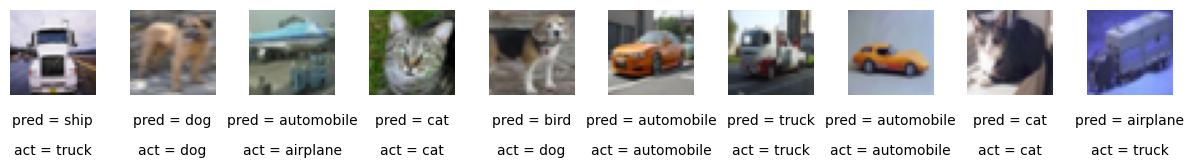
시각화: 위의 비교 방법은 너무 번거롭기 때문에 테스트 세트에서 무작위로 10개의 사진을 선택하고 각 사진을 인쇄한 후 모델 예측 카테고리와 실제 카테고리를 사진 아래에 붙여넣을 수 있습니다.
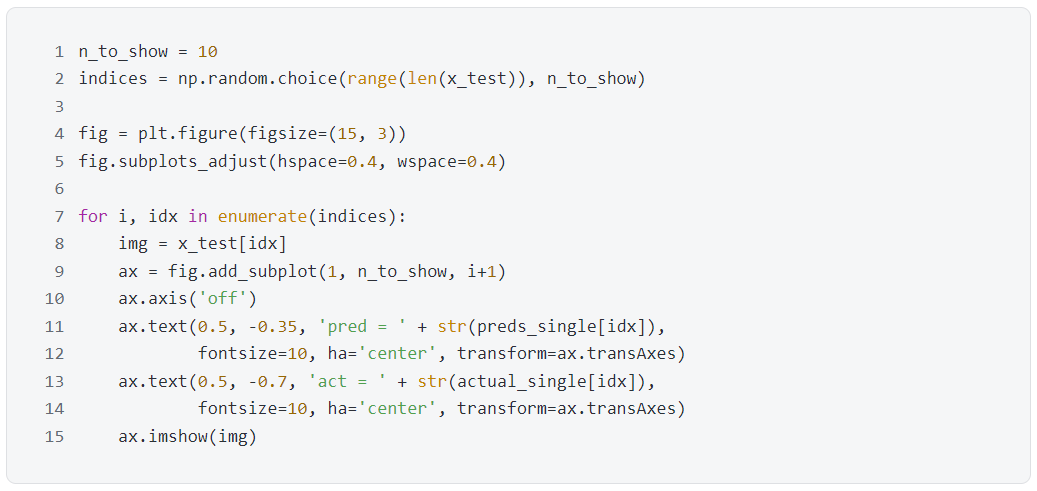
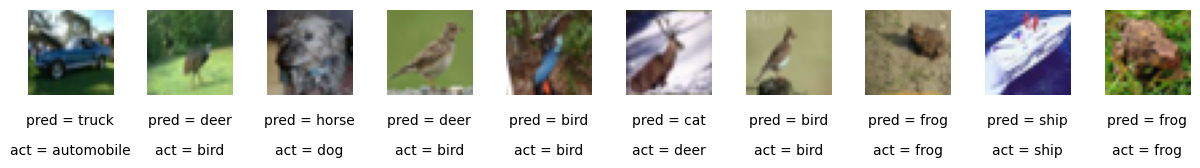
위의 10개의 작은 그림에서 모델이 50%의 정확한 비율로 5개를 올바르게 예측한 것을 볼 수 있으며 이는 이전 통계 49.52%와 일치합니다. 이는 예측을 위한 식별 모델일 뿐이지만 이 섹션에서 소개된 내용(예: 레이어, 활성화 함수, 최적화 도구 등)은 생성 모델을 생성할 때에도 적용됩니다.
첫 번째 수준 제목
3. 컨볼루셔널 신경망(CNN)
보조 제목
3.1 기본 개념
어둠 속에서 거대한 그림이 눈앞에 나타나고 어둠 속에서 자동차처럼 보이지 않는다고 가정해 보세요. 손전등을 사용하여 조금씩 스캔하고 매번 보는 것을 화면에 투영할 수 있습니다. 다음 레이어까지 등등. 예를 들어, 첫 번째 레이어에서는 수평선, 수직선 및 사선을 볼 수 있고, 두 번째 레이어에서는 원과 사각형을 볼 수 있으며, 세 번째 레이어에서는 바퀴, 문 및 차체, 네 번째 레이어에서는 자동차를 볼 수 있습니다. 이렇게 하면 손전등을 사용하여 어둠 속에서 사진 속의 자동차를 발견할 수 있습니다.
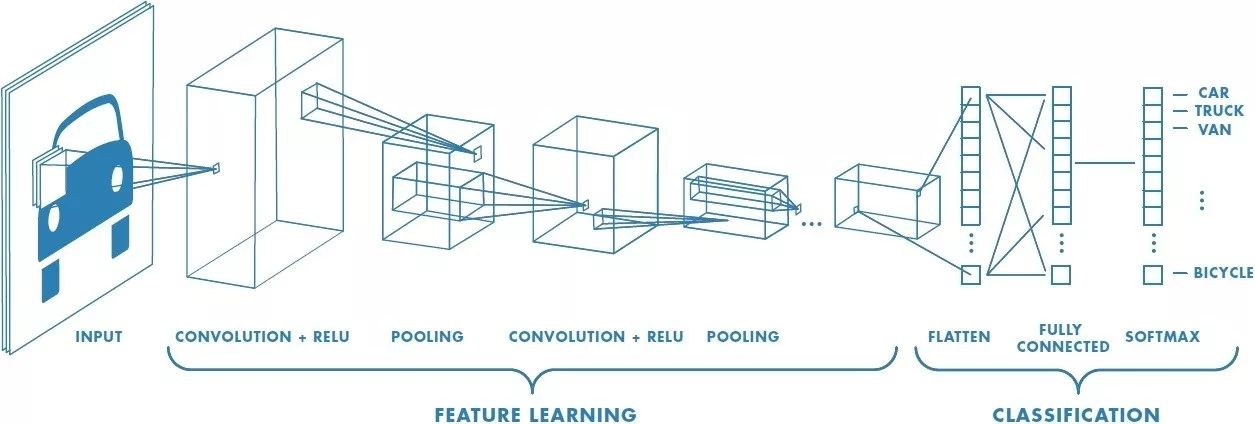
위의 예는 실제로 컨볼루션 신경망을 통해 이미지를 인식하는 과정입니다. 먼저 몇 가지 정의를 명확히 합니다.
필터(필터): 위 예의 손전등처럼 입력 데이터와 컨볼루션하면서 입력 데이터의 너비와 높이를 스와이프합니다.
회선(컨볼루션): 여기서 정의는 모든 필터의 픽셀에 이미지를 스윕하는 필터의 픽셀을 곱하고 합산하는 것입니다.
단계 크기(stride): 이미지를 탐색할 때 필터의 단계 크기, 기본값은 1입니다. 즉, 필터는 한 번에 한 픽셀씩 이동합니다.
충전재(패딩): 입력 데이터의 가장자리가 0으로 채워지는 경우가 있는데, 이는 출력 데이터의 크기를 제어할 수 있습니다(가장 일반적으로 사용되는 것은 출력 데이터의 크기를 입력 데이터와 일관되게 유지하는 것입니다).
회선
컨볼루션 신경망의 가장 큰 특징은 물론 컨볼루션 연산이다. 위의 정의를 다시 살펴보면, 필터의 픽셀수에 필터가 스윕한 이미지의 픽셀수를 곱하고 더해 줍니다. 필터의 크기를 3*3이라고 가정하여 다음 두 예를 참조하세요.
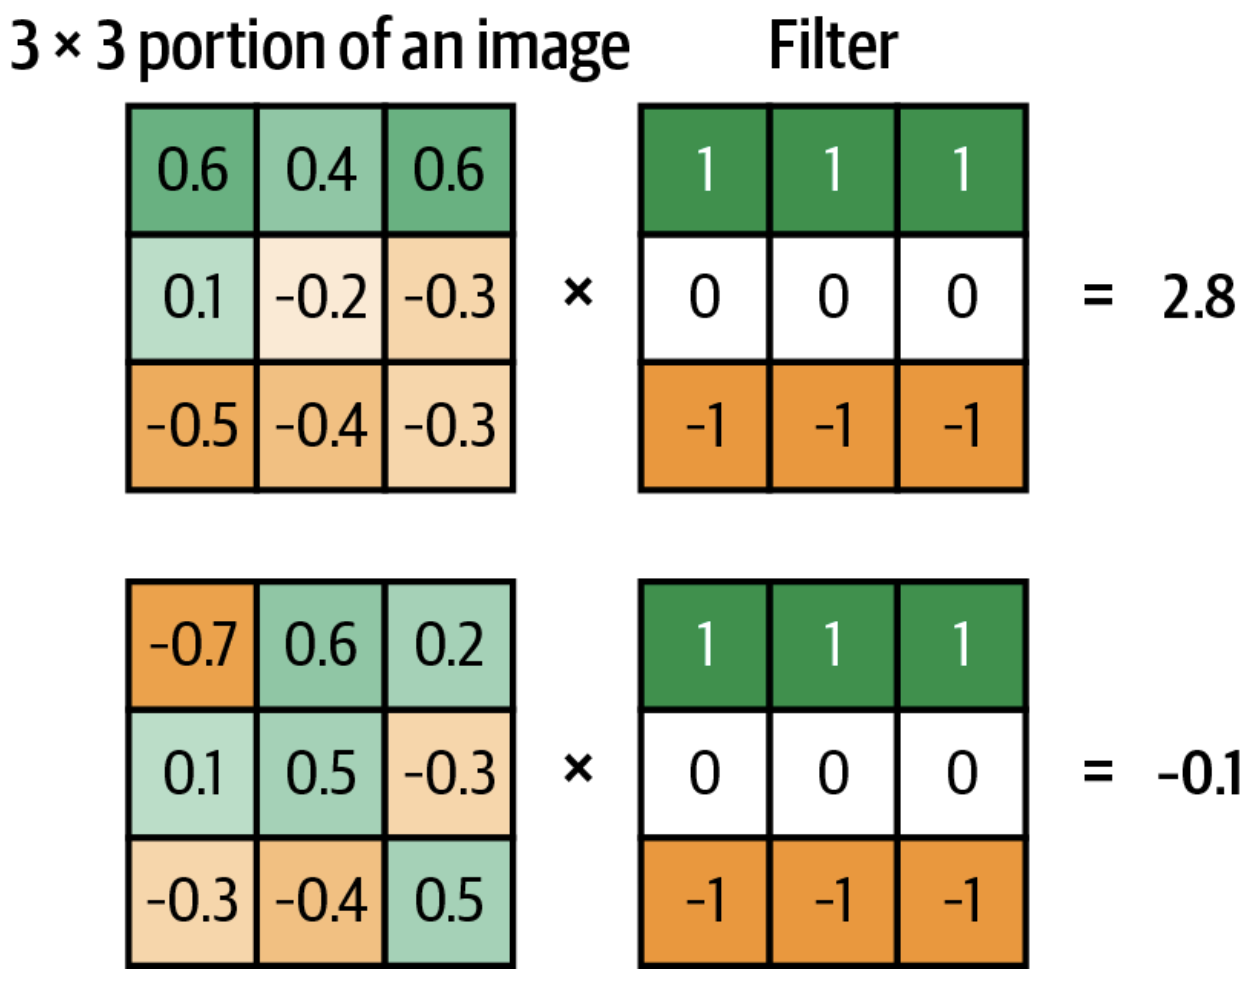
첫 번째 이미지와 필터의 컨볼루션은 0.6*1 + 0.4*1 + 0.6*1 + 0.1*0 + (-0.2)*0 + (-0.3)*0 + (-0.5)*(-1) + (-0.4)*(-1) + (-0.3)*(-1) =2.8 。
두 번째 이미지와 필터의 컨볼루션은 (-0.7)* 1 + 0.6* 1 + 0.2* 1 + 0.1* 0 + 0.5* 0 + (-0.3)* 0 + (-0.3)*(-1) + (-0.4)*(-1) + 0.5*(-1) =-0.1 。
컨볼루션 값이 더 클 때단지, 필터와 이미지가 더 많다는 것을 나타냅니다.성냥; 컨볼루션 값이 더 높을 때부담, 필터와 이미지가 더 많다는 것을 나타냅니다.일치하지 않습니다. 위 예에서 첫 번째 이미지와 필터의 컨볼루션 값은 다음과 같습니다.2.8 , 둘 다성냥; 두 번째 이미지와 필터의 컨볼루션 값은 다음과 같습니다.-0.1 , 둘 다일치하지 않습니다。
필터
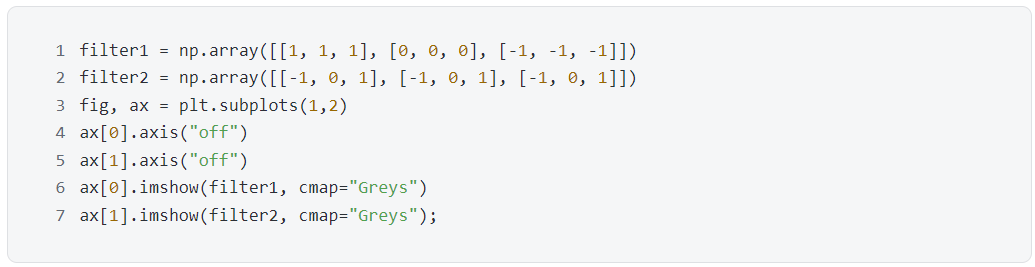
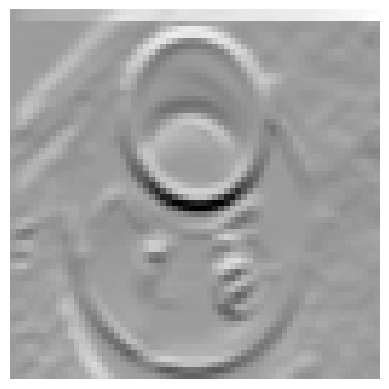
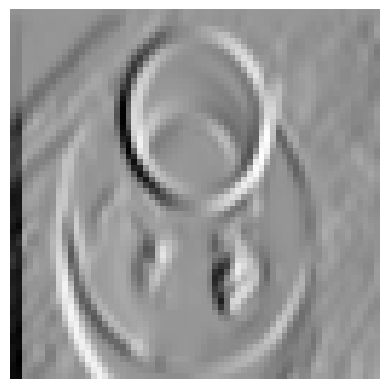
필터의 기능은 필터링, 즉 일부 정보를 필터링하는 것입니다. 이는 보유된 정보를 추출하는 것과 같습니다. 다음 코드는 3*3 크기의 필터 2개를 생성하며, 필터 1은 이미지의 가로선을 추출하고 필터 2는 이미지의 세로선을 추출합니다. 여기서 1은 검정색, 0은 회색, -1은 흰색을 나타냅니다.
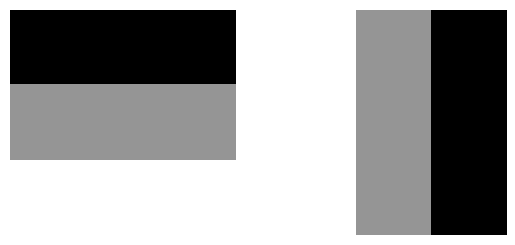
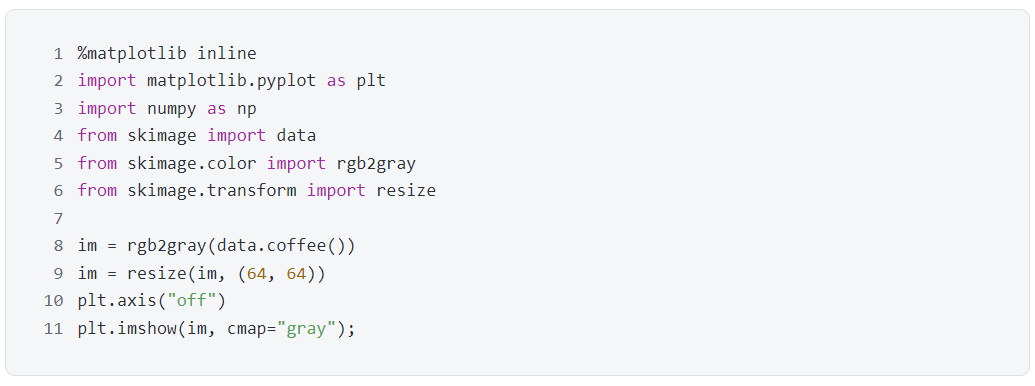
이 두 가지 필터를 사용하여 정보를 추출하는 방법을 살펴보겠습니다.원본 그림은 다음과 같습니다.
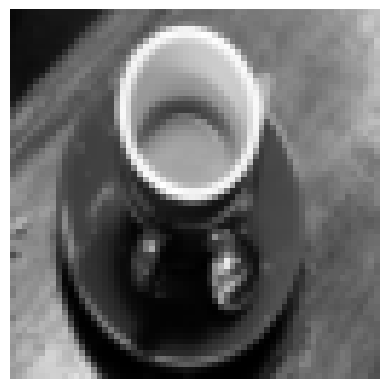
필터 1이 컵 입구의 위쪽 및 아래쪽 가장자리와 같은 이미지에서 수평 가장자리 정보를 추출한다는 것을 찾는 것은 어렵지 않습니다.
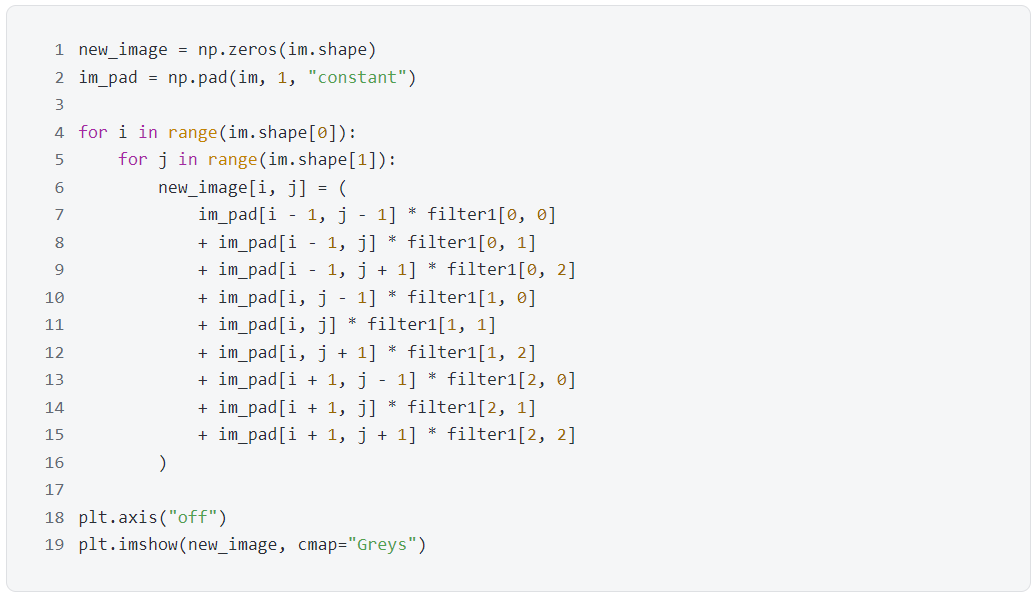
필터 2가 컵 입구의 왼쪽 및 오른쪽 가장자리와 같은 이미지에서 수직 가장자리 정보를 추출한다는 것을 찾는 것은 어렵지 않습니다.
필터를 추가하면 다음을 만들 수 있습니다.컨벌루션 레이어(컨볼루션 레이어). 컨볼루셔널 레이어는 본질적으로 필터의 집합인데, 아래 예시에서는 숫자가 2이고, 필터의 요소 값을 가중치라고 부르며, 이는 CNN을 훈련시켜 학습됩니다.
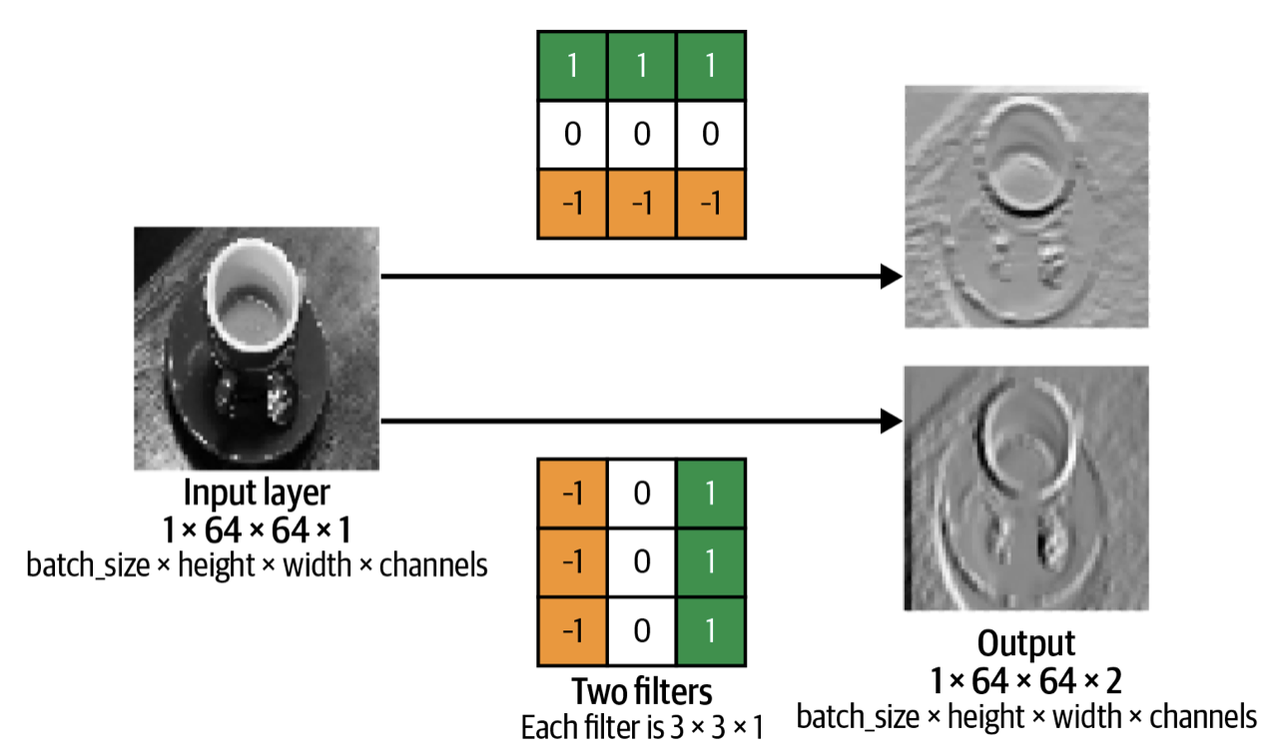
케라스에서 사용됨layers.Con v 2 D() 컨벌루션 레이어를 생성합니다. 여기서 흑백 사진은 64* 64* 1(컬러 채널이 1개만 있음)이고 필터가 2개 있고(filters 매개변수는 2로 설정됨), 필터 크기는 3* 3(kernel_size 매개변수가 설정됨)입니다. (3, 3)).
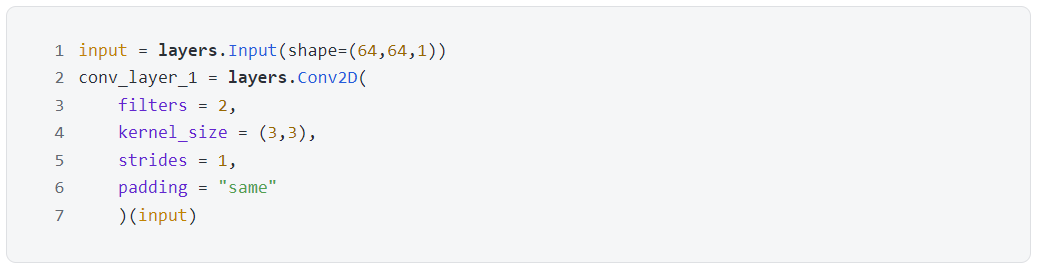
두 가지 매개변수인 보폭과 패딩은 무엇입니까?
스텝 길이
단계 크기는 필터가 이미지를 탐색할 때 이동하는 픽셀 수입니다. 기본값은 1이며, 이는 필터가 한 번에 한 픽셀씩 이동한다는 의미입니다. stride가 2인 경우 출력 이미지 크기가 입력 이미지 크기의 절반에 불과하다고 상상하는 것은 어렵지 않습니다.
심
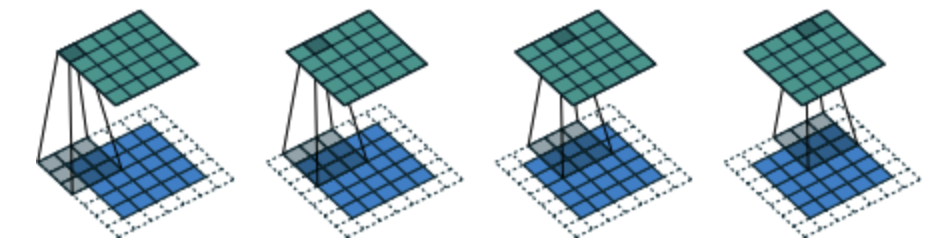
패딩은 이름에서 알 수 있듯이 이미지 주위에 요소를 추가하는 것입니다. 패딩할 때 ="same"strides = 1이면 출력 이미지가 입력 이미지와 동일한 크기인지 확인할 수 있습니다. 아래 그림의 입력 이미지 크기는 5*5(파란색 이미지)이고, 채운 후 이미지 크기는 7*7(흰색 이미지), 필터 크기는 3*3(회색), 출력 이미지 크기는 5로 유지됩니다. *5(녹색 그림).
보조 제목
3.2 연결된 컨벌루션 레이어
먼저 코드를 살펴보세요.
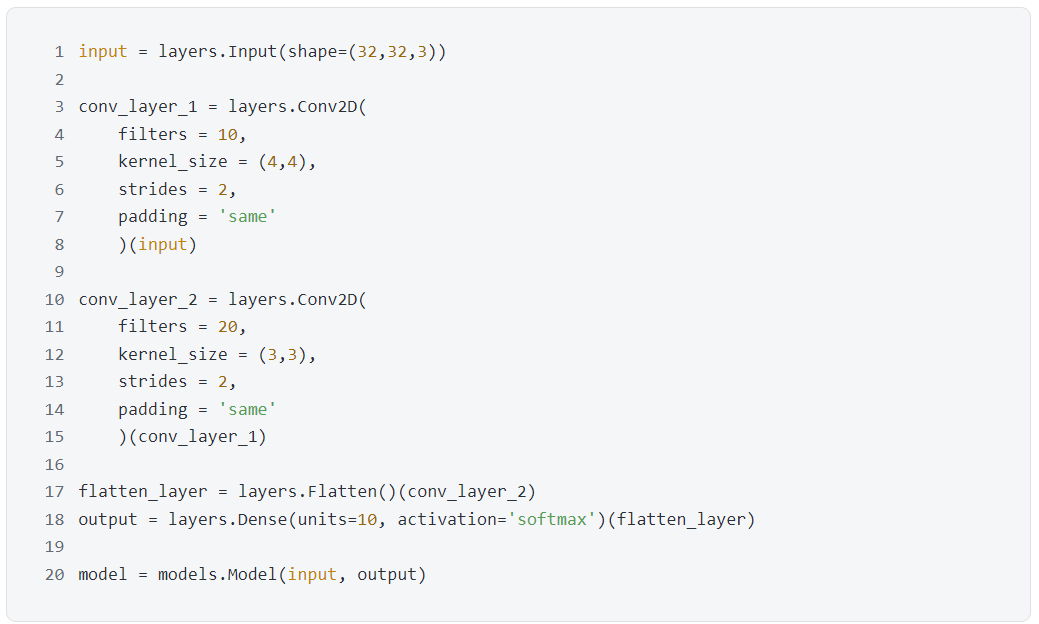
위의 코드는 아래 이미지와 일치합니다.
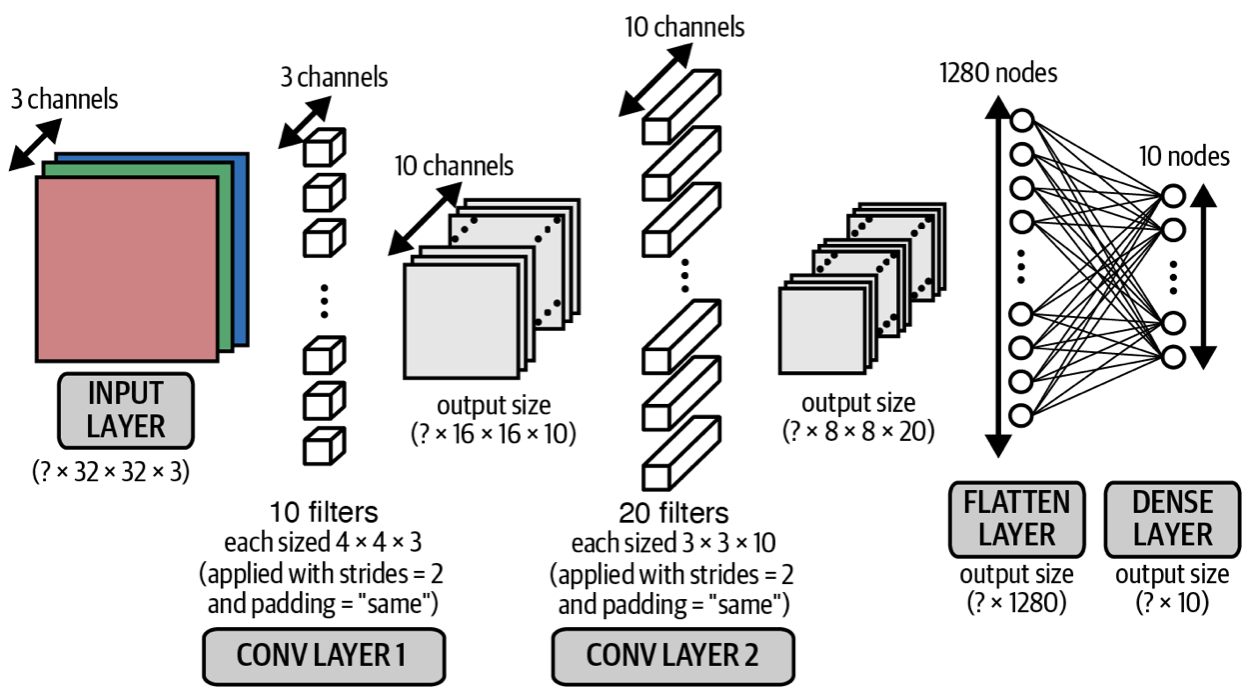
위의 각 컨볼루션 레이어의 출력 크기는 눈부시다. nI 입력 이미지의 크기를 나타냅니다.f 필터의 크기를 나타냅니다.s단계 크기를 나타냅니다.p채우기 레이어 수를 나타냅니다.nO입력 이미지의 크기를 나타내며 다음과 같은 관계가 있습니다.
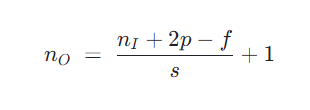
이 공식을 사용하여 첫 번째 및 두 번째 컨벌루션 레이어 출력의 너비와 높이를 확인합니다.
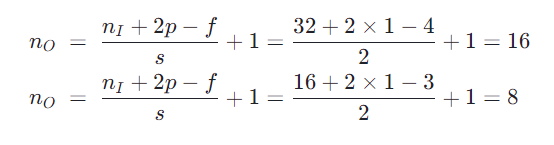
여기서 가장 중요한 것이 나옵니다.컨벌루션 레이어의 출력 색상 채널은 필터 수(즉, 코드의 매개변수 필터)와 동일합니다.. 직관적으로 이해하면 각 필터는 스캔 이미지에 대해 병렬로 컨볼루션을 수행하고 최종 출력은 필터 수에 해당하는 차원 크기를 가져야 합니다.
모델을 확인해 보세요.
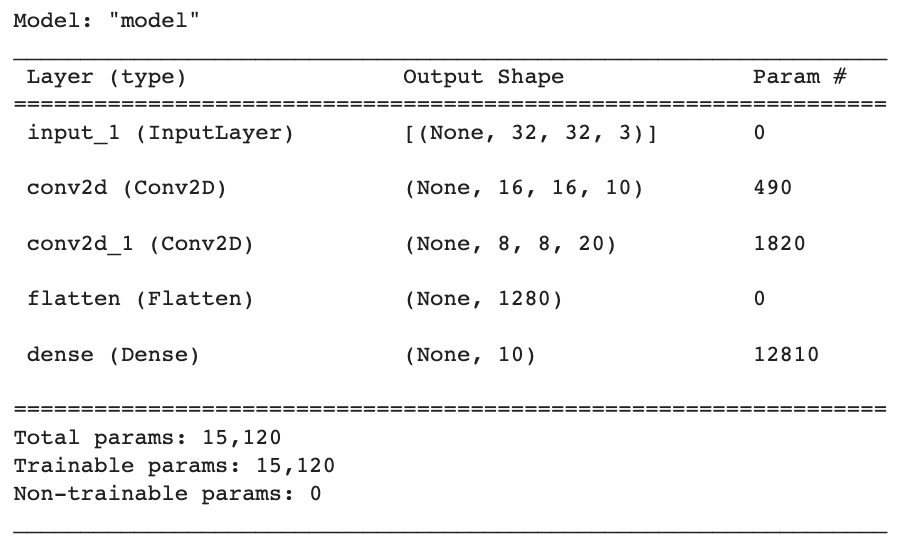
모델 이름은 자동으로 model로 지정되고, 각 레이어의 이름 유형(레이어(type)), 출력 모양(Output Shape) 및 매개변수 수(Param #)를 설명하는 테이블이 표시됩니다. 레이어별로 살펴보자
InputLayer 레이어의 이름은 input_ 1 이고 출력 모양은 [None, 32, 32, 3 ]입니다. 마지막 세 요소는 이미지 너비, 높이 및 색상 채널에 해당합니다. 첫 번째 None 은 실제로 샘플 수를 나타냅니다. 더 엄밀하게 말하면 말하자면 배치의 샘플 수입니다. 코드 간결성을 위해 일반적으로 이 샘플 번호는 모델링 시 명시적으로 작성할 필요가 없습니다.
첫 번째 Con v 2 D 레이어의 이름은 con v 2 d이고, 출력 형태는 [None, 16, 16, 10], 매개변수 490 = ( 4* 4* 3 + 1) * 10, 우선 그렇지 않습니다. 편향이 있다는 것을 잊어버리십시오. 다음으로 4* 4는 필터의 크기이고 3은 입력 색상 채널 수이므로 각 필터를 설명하려면 4* 4* 3 가중치가 필요하며 총 10개가 있습니다.
두 번째 Con v 2 D 레이어의 이름은 con v 2 d_ 1 이고 출력 형태는 [None, 8, 8, 20 ], 매개변수 1, 820 = ( 3* 3* 10 + 1) * 20입니다. 먼저 same 바이어스 단위 다음에 3* 3은 필터 크기이고 10은 입력 색상 채널 수이므로 이 필터를 설명하려면 3* 3* 10 가중치, 총 20개가 필요합니다.
Flatten 레이어의 이름은 flatten이고, 1, 280은 병합 후 8* 8* 20의 수이고 매개변수 수는 0입니다. 왜냐하면 병합은 단지 배열의 모양을 변경하기 위한 것이고 모양 변경 작업을 완료하는 데 매개변수가 필요하지 않기 때문입니다.
마지막 Dense 레이어의 이름은 Dense이고 출력 모양은 10이며 매개변수는 12, 810 = (1280 + 1) * 10이며 바이어스 단위도 고려합니다.
하단에는 전체 매개변수(Total params) 15, 120, 훈련 가능한 매개변수(Trainable params) 15, 120, 훈련 불가능한 매개변수(Non-trainable params) 0도 나열되어 있습니다.
이 시점에서 CNN은 기본적으로 구축되었으며 CNN이 더 잘 작동하도록 두 가지 기술을 추가합니다.배치 정규화(일괄 정규화) 및보조 제목 (dropout)。
3.3 배치 정규화
CNN을 훈련할 때 모델 성공의 핵심은 가중치가 특정 범위 내에 유지되도록 하는 것입니다. 그렇지 않으면 폭발적인 기울기가 발생합니다. 배치 정규화는 이 문제를 해결할 수 있으며, 각 계층에서 배치(미니 배치)별로 데이터를 계산합니다.평균(평균) 그리고표준 편차(표준편차)를 선택한 다음 각 데이터의 표준편차로 나눈 평균을 뺍니다. 데이터를 복원하려면 두 가지 매개변수, 즉 스케일링 매개변수를 학습해야 합니다.γ및 번역 매개변수β。
배치 정규화 알고리즘은 다음과 같습니다.
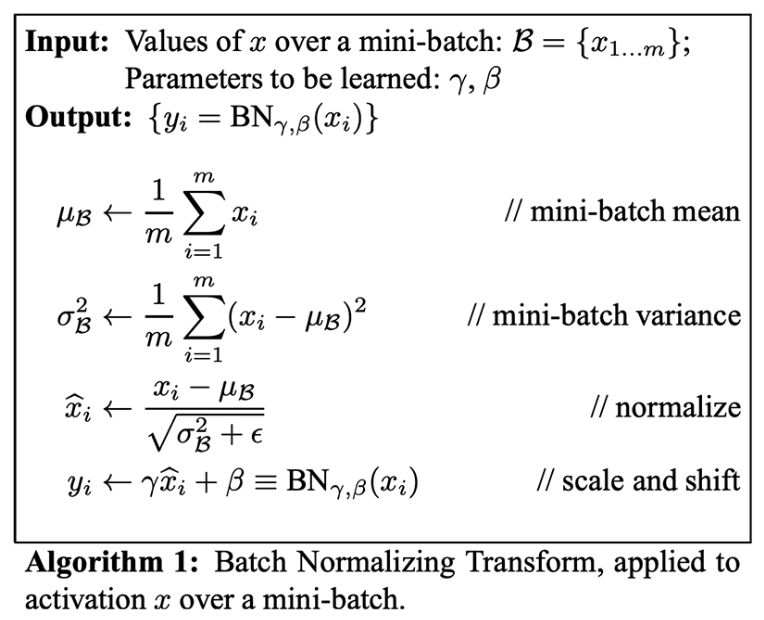
BatchNormalization()은 Keras에서 배치 정규화를 달성하는 데 사용됩니다. 배치 정규화 레이어는 일반적으로 Dense 레이어나 Convolutional 레이어 뒤에 배치됩니다.
보조 제목
3.4 무작위 비활성화
무작위화는 시험에서 영감을 얻었습니다. 일반적으로 시험 전에 학생들은 지식 포인트를 배우기 위해 전년도의 논문을 작성합니다. 일부 학생들은 암기식으로 문제를 해결하기 때문에 지식 포인트를 실제로 이해하지 못하기 때문에 실제 시험에서 좋은 성적을 거두지 못할 수도 있습니다. 좋은 학생들은 종이를 사용하여 상식적인 지식을 이해함으로써 새로운 질문에 올바르게 답할 수 있습니다.
같은 방식으로 신경망의 암기 기억을 방지하기 위해 아래 그림과 같이 일부 뉴런을 무작위로 비활성화 즉 출력을 0으로 만들 수 있습니다.
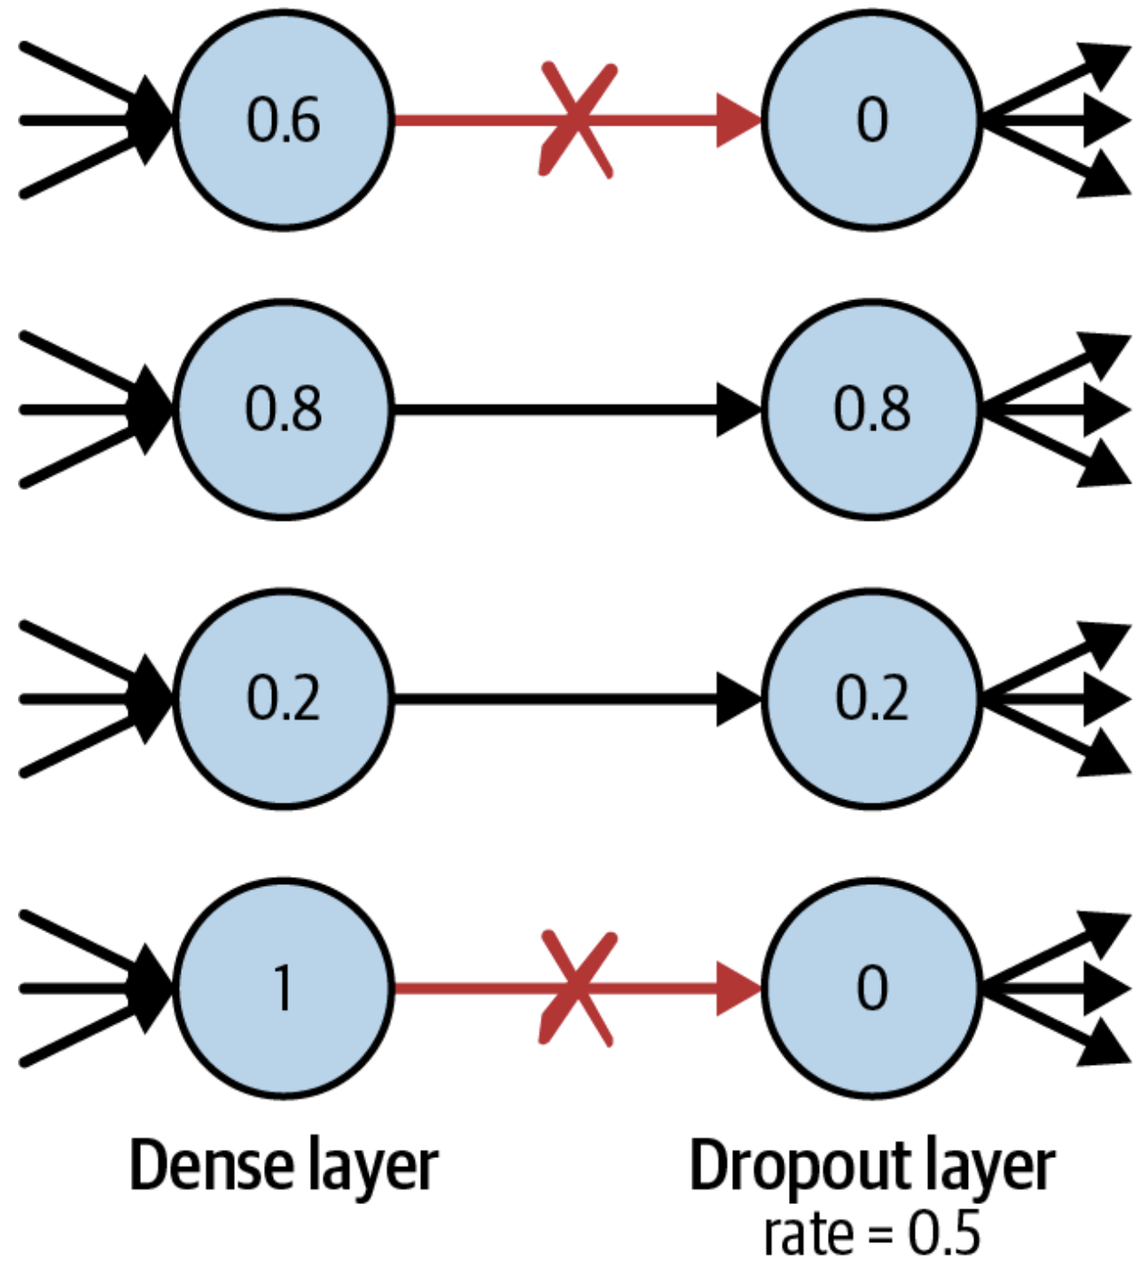
예측 과정에서 뉴런은 비활성화되지 않으므로 완전한 신경망이 예측에 사용됩니다.
케라스에서 사용됨Dropout()비활성화 레이어를 구현합니다. 비활성화층은 일반적으로 치밀층 뒤에 배치됩니다.
보조 제목
3.5 완전한 모델
이제 모델을 개선하기 위해 이전 CNN에 배치 정규화 계층과 비활성화 계층을 추가할 수 있습니다.
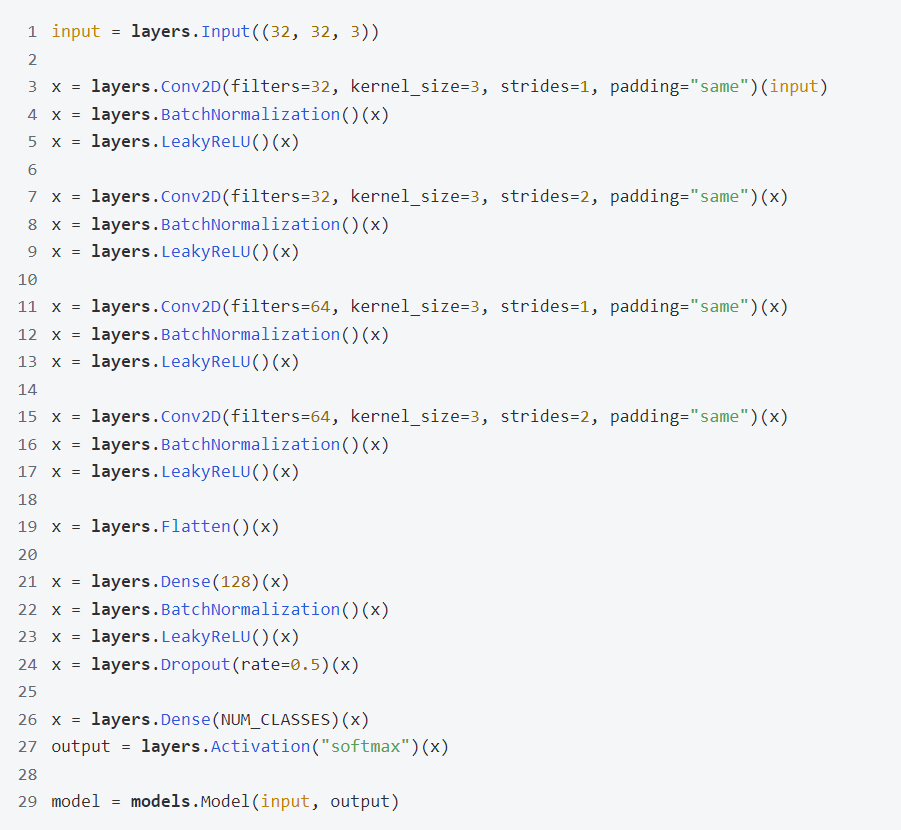
위 코드가 이해하기 쉬운지 확인하세요. CNN에는 4개의 컨볼루셔널 레이어가 있고 각 레이어 뒤에 배치 정규화 레이어와 LeakyReLu 레이어가 있습니다. Keras의 모든 것은 레이어로 사용될 수 있으며, 활성화 함수도 레이어 형태로 구현될 수 있습니다. 그런 다음 평탄화 레이어를 사용하여 데이터를 평탄화한 다음 Dense 레이어, 배치 정규화 레이어, LeakyReLu 레이어, 비활성화 레이어 및 Dense 레이어를 사용하고 마지막으로 Softmax를 사용하여 확률 형식으로 출력합니다.
이 세련된 CNN 모델을 확인해 보세요.
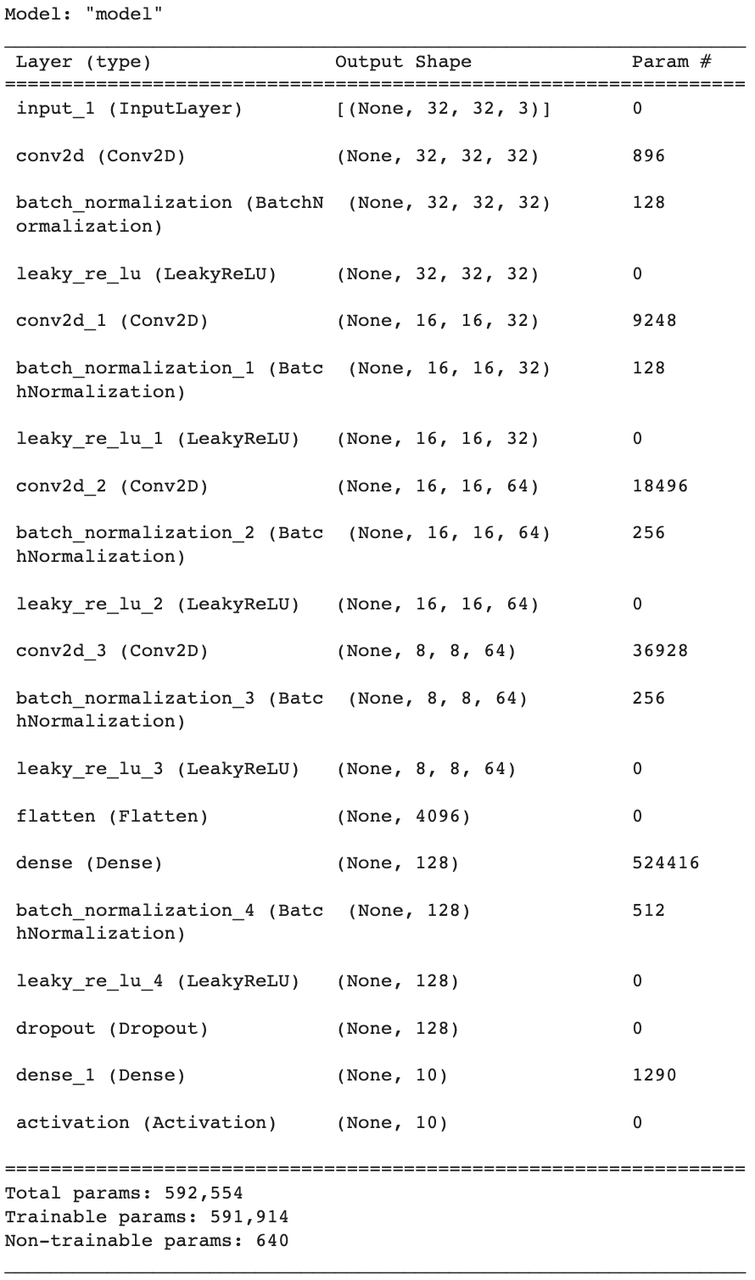
활성화 레이어는 변환이기 때문에 매개변수가 포함되어 있지 않으며, 평탄화 레이어와 비활성화 레이어에는 매개변수가 포함되어 있지 않아 이해하기 쉽습니다. 알고리즘은 이전에 설명한 바 있으며, 배치 정규화를 위해서는 채널별로 스케일링 매개변수를 학습해야 합니다.γ및 번역 매개변수β, 이동 평균 및 이동 표준 편차를 포함하므로 포함된 매개변수는 채널 수 * 4 와 같습니다.
보조 제목
3.6 훈련 평가
모든 것이 준비되어 있으며 훈련만 필요합니다. 이번에는 훈련 중 모델이 과적합되는지 모니터링하기 위해 검증_데이터(validation_data) 매개변수를 추가했는데, 훈련 오류(손실)는 감소했지만 검증 오류(val_loss)는 증가하는 경우 과적합이 발생합니다. 아래 사진을 보면 그런 문제는 없습니다.
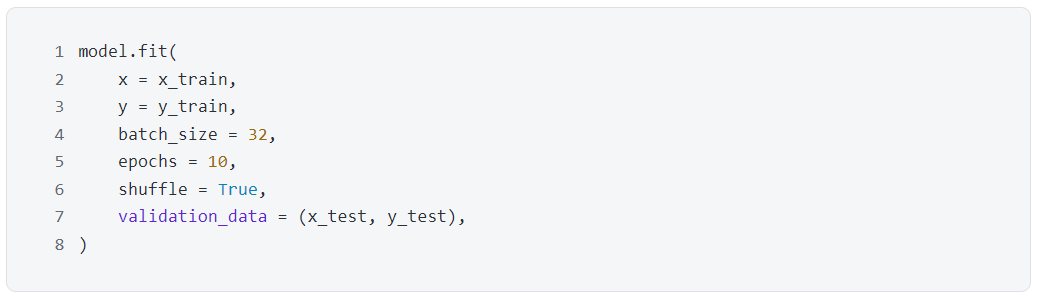
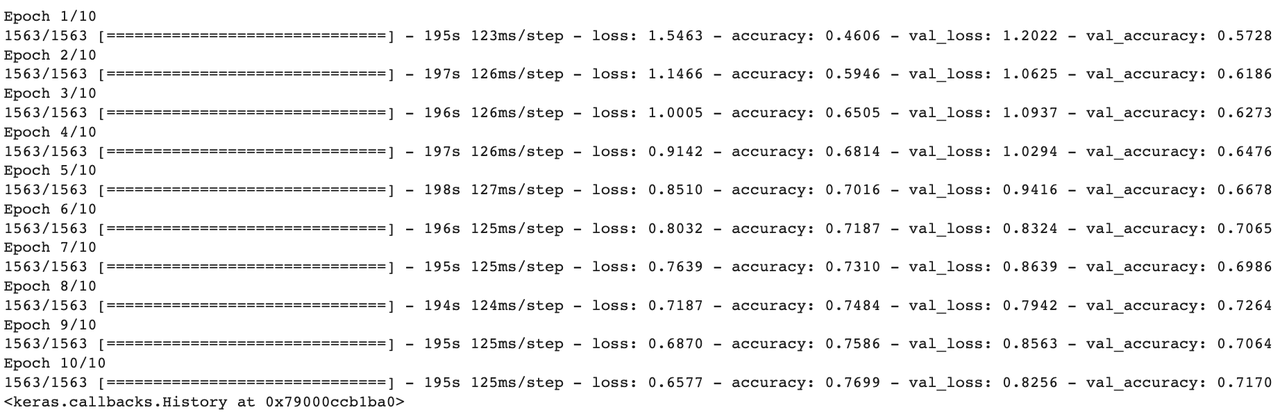

현재 CNN(Convolutional Neural Network) 및 기존 FNN(Feedforward Neural Network)과 비교하면 훈련 세트 내 기존 모델의 정확도가 51.39%에서 76.99%로 증가했고, 훈련 세트의 정확도도 2019년 5월부터 76.99%로 높아졌다. 49.52% 최대 71.70%까지 모델 성능이 크게 향상되었습니다.
놀랍게도 CNN의 매개변수(592, 554)는 실제로 FNN의 매개변수(646, 260)보다 훨씬 적지만 모델 성능이 많이 향상되었으며 이러한 개선은 컨볼루셔널 레이어를 포함하도록 모델 아키텍처를 변경하기만 하면 됩니다. 배치(batch)는 하나의 레이어를 정규화하고 해당 레이어를 비활성화함으로써 구현할 수 있습니다. CNN은 FNN보다 매개변수가 적지만 레이어 수가 훨씬 많기 때문에 심층 신경망의 장점은 네트워크의 중간 레이어가 우리가 가장 관심 있는 상위 수준 기능을 포착하기 때문입니다.
요약하다
요약하다
이 기사에서는 심층 생성 모델 구축을 시작하는 데 필요한 핵심 심층 학습 개념을 소개했습니다. Keras를 사용하여 FNN(피드포워드 신경망)을 구축하고 CIFAR-10 데이터세트에서 특정 이미지의 클래스를 예측하도록 모델을 교육합니다. 그런 다음 CNN(컨벌루션 신경망)을 생성하기 위해 컨벌루션 계층, 배치 정규화 계층 및 비활성화 계층을 도입하여 이 아키텍처를 개선합니다.
심층 신경망의 디자인은 완전히 유연하고 가능한 한 모범 사례가 있지만 다양한 레이어와 레이어가 나타나는 순서를 자유롭게 시도해 볼 수 있습니다. Keras를 사용하는 것은 마치 레고 블록을 만드는 것만큼 부드럽습니다. 신경망은 자신의 상상력에 따라 제한되어야 합니다.
ChatGPT 4.0의 플러그인 스토어에서 SignalPlus를 검색하여 실시간 암호화 정보를 얻을 수 있습니다. 업데이트를 즉시 받으려면 Twitter 계정 @SignalPlus_Web 3을 팔로우하거나 WeChat 그룹(소규모 도우미 WeChat 추가: chillywzq), Telegram 그룹 및 Discord 커뮤니티에 가입하여 더 많은 친구들과 소통하고 소통하세요.
ChatGPT 4.0의 플러그인 스토어에서 SignalPlus를 검색하여 실시간 암호화 정보를 얻을 수 있습니다. 업데이트를 즉시 받으려면 Twitter 계정 @SignalPlus_Web 3을 팔로우하거나 WeChat 그룹(소규모 도우미 WeChat 추가: chillywzq), Telegram 그룹 및 Discord 커뮤니티에 가입하여 더 많은 친구들과 소통하고 소통하세요.
SignalPlus Official Website: https://www.signalplus.com





