


一文讀懂以太坊2.0的混洗算法


簡介
作者|簡介簡介
鬼步舞
作者|簡介如果你想學Fisher-Yeats shuffle鬼步舞
論文
。我最近在Eth2客戶端
Swap-or-Not混洗算法
中
重寫
Swap-or-Not混洗算法
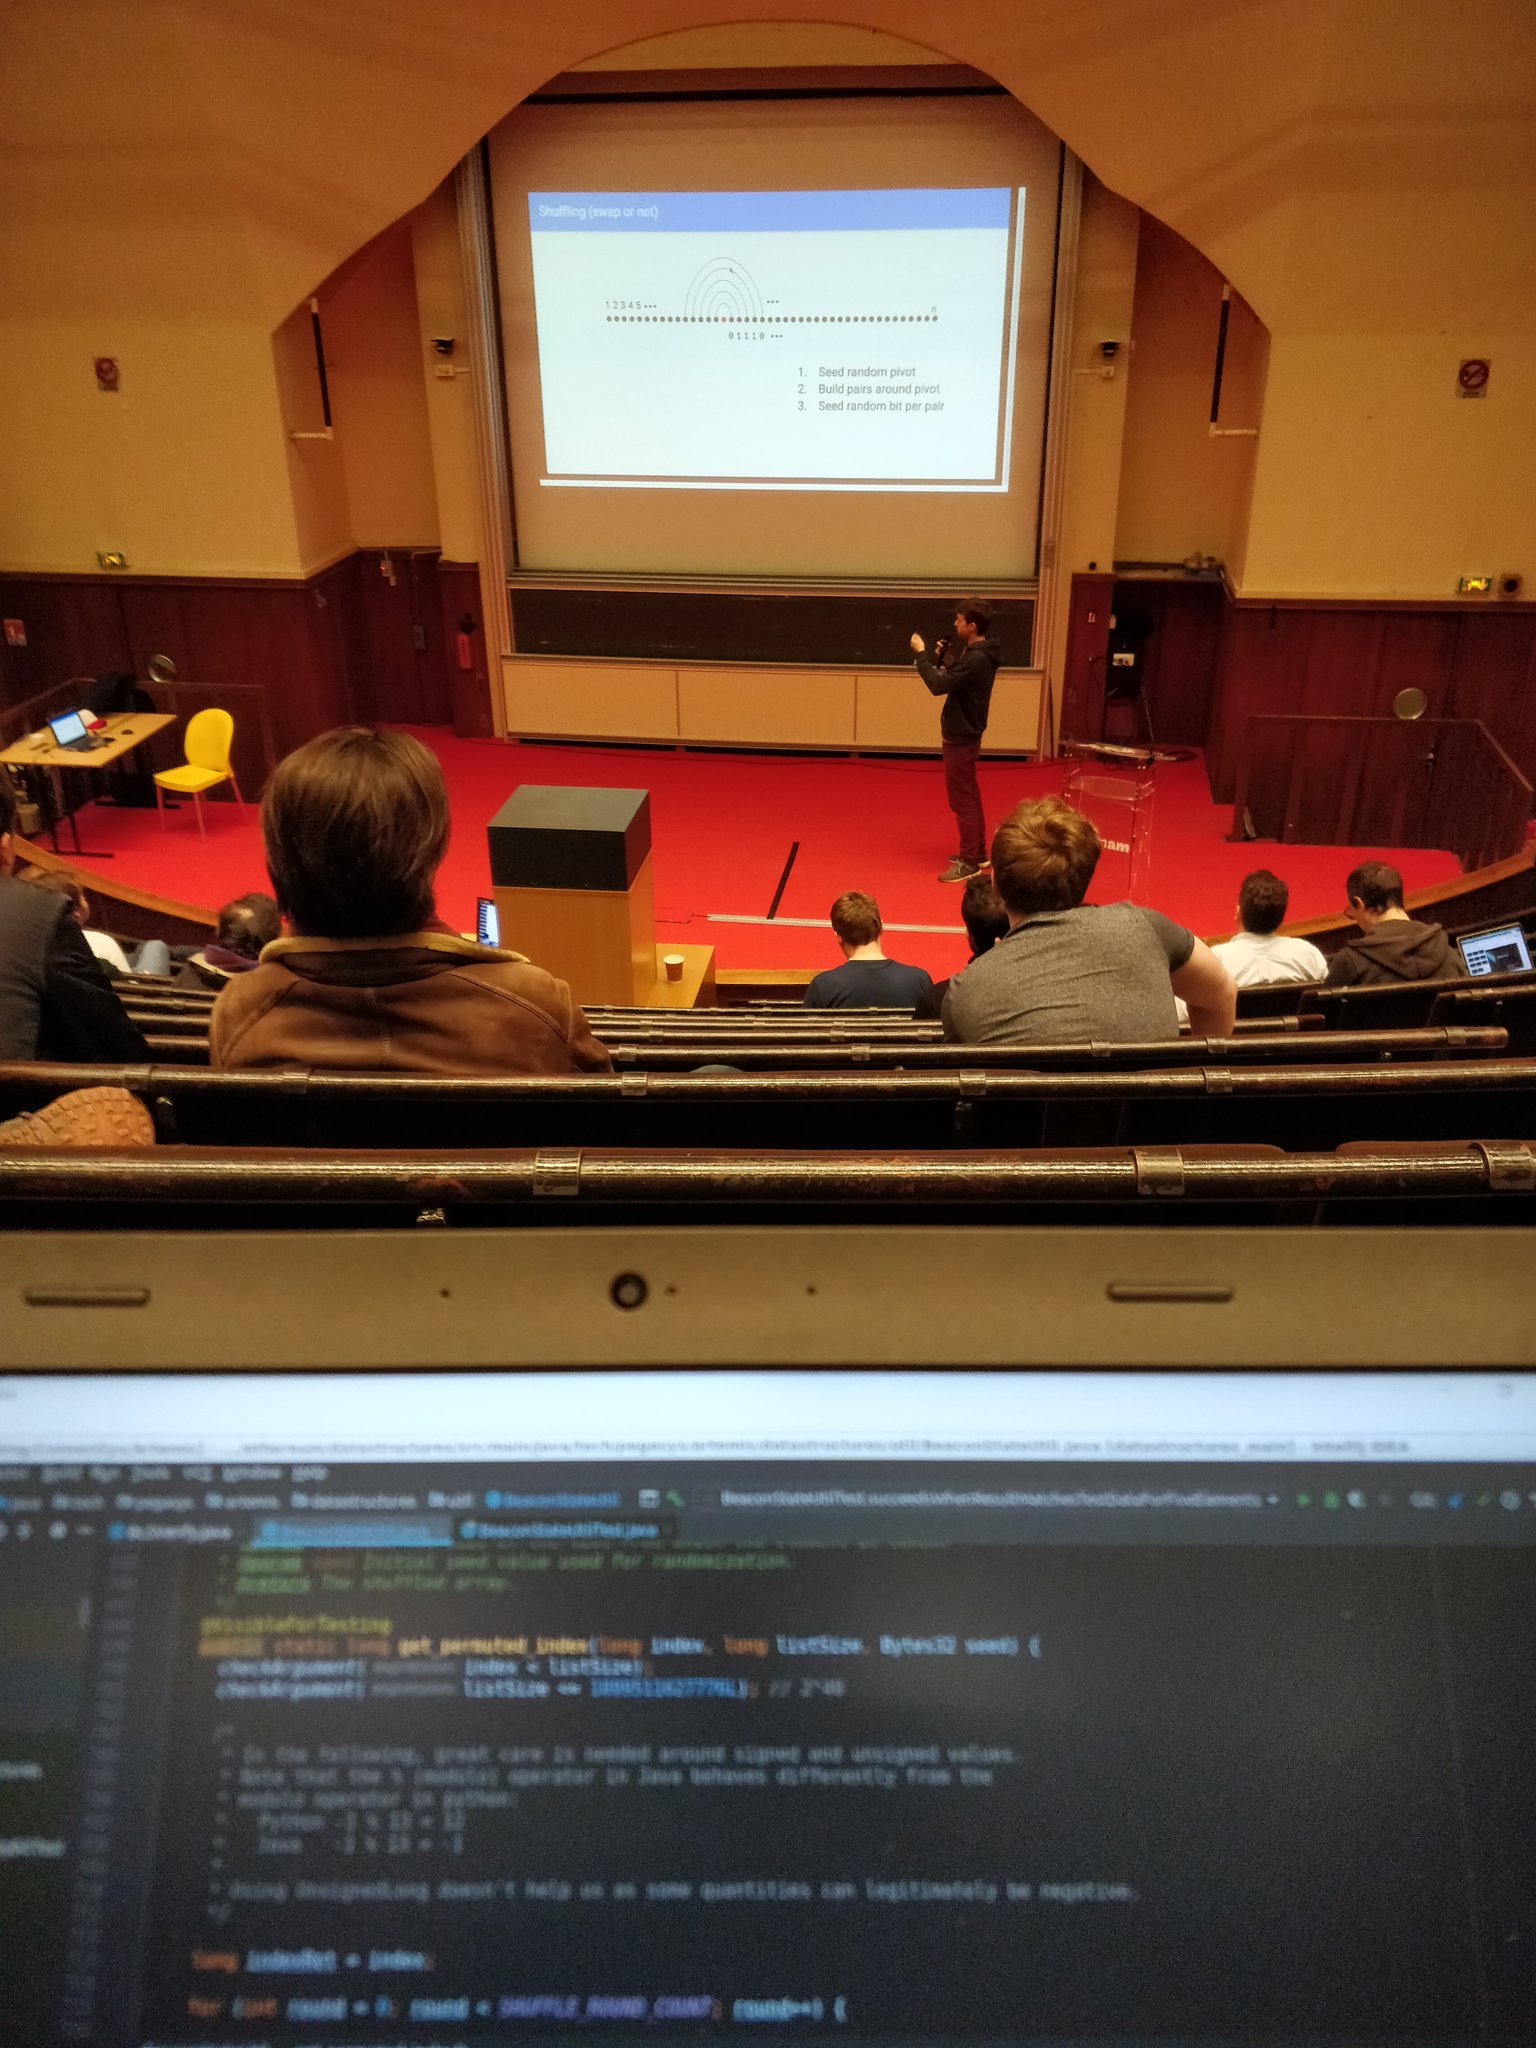
混洗以輪次進行。每輪的過程是一樣的,因此我在下面只會演示一輪的過程,它比看上去簡單多了。
圖片描述
首先,我們選一個軸心索引p,這是基於輪次和其他一些種子數據,通過偽隨機選出的。這個軸心選出後就在該輪次裡固定了。
圖片描述
基於這個軸心點,我們在p和0的中間點選出一個鏡像索引m1,即m1=p/2。 (為了方便解釋,我們將忽略麻煩的差一錯誤舍入問題)
軸心點和第一個鏡像index
對於鏡像索引m1和軸心索引p之間的每個索引,我們隨機決定是否對這些元素進行替換。
圖片描述
圖片描述
圖片描述
圖片描述
圖片描述
圖片描述
圖片描述
4. 從軸心點到第二個鏡像,替換與否
最後,我們重複swap-or-not的過程,考慮所有點到軸心p替換的決定,即p到第二個鏡像m2的決定。如果我們選擇不替換,就繼續下一個。如果我們選擇替換,那麼我們在鏡像索引m2上把j1上的元素與它在j1'上的鏡像進行替換。
從軸心到第二個鏡像索引的swap-or-not決定
圖片描述
圖片描述
巧妙的地方下一輪以增加(或減少) 輪次開啟,這樣我們會有一個新的軸心索引,然後開始循環上述的過程。圖片描述
同一輪中從一個鏡像移向另一個鏡像的過程
巧妙的地方實現當在決定要不要替換的時候,這個算法會巧妙地選擇候選索引或其鏡像中的更高者。意思是當在軸心之下時,被選擇的是i_1而不是i_1';當在軸心之上時,被選擇的時i_k'而不是i_k。這意味著,我們可以靈活遍歷列表中的索引:我們可以將0到m1和p到m2分為兩個獨立的循環,或將兩者合在同一個從m1到m2的循環,如我在上文所描繪(和實現)的。這兩種做法的結果是一樣的:無論我考慮的是i_1還是鏡像i_1'都沒有關係;替換與否得出的是相同的結果。
輪次
在Eth2,上述的過程會進行90次。Issue F原始論文
裡提到要經歷6lgN個輪次才能“開始在選擇性密碼攻擊(CCA) 上出現較好的安全性界限”,其中N是列表的長度。在Vitalik的
註釋規範
裡,他說“密碼學專家建議我們4log2N個輪次就能提供足夠的安全性了”。在Eth2裡驗證者數量的絕對最大值,也就是我們需要混洗的列表最大次數,大概是222 (420萬)。 Vitalik給出的預估值是88輪,在論文裡的預估值是92輪(假設lg是自然對數)。因此,我們現在處於一個大致正確的範圍,特別是我們最後非常可能沒有這麼多活躍驗證者。
基於列表長度來調整輪次可能會得出有趣的結果,但我們不會這麼做,這可能是不必要的優化。
有意思的是,當Least Authority審計信標鏈的規範時,他們一開始發現在選擇區塊提議者的混洗中是有偏倚的(參考
)。但結果是他們錯誤使用了只有10輪次的混洗配置。當他們將混洗配置增加到90輪(我們在主網使用的輪次) 時,偏倚的情況消失了。
(偽)隨機
在Eth2,我們肯定會從一個種子值產生隨機性,由此這同一個種子總會產生同一個混洗結果。
效率
軸心指標是由把與輪次串聯的種子進行8字節的SHA2哈希產生的,
軸心索引由種子值SHA2哈希的八個字節生成,該種子值與輪次相串聯,因此它通常在每輪裡都有會改變。
用來決定是否要替換元素的決定性數位從以下幾個元素中提取:種子的SHA256哈希、輪次、列表上元素的索引。
效率
為什麼選擇swap-or-not這種算法?
因此,如果我們想知道索引217的元素被混洗到哪裡了,我們可以運行只針對該索引的算法,而無需混洗整個列表。此外,相反地,如果我們想知道是什麼元素被混洗到索引217,我們可以將算法倒過來運行來找到元素217 (倒過來的意思是從高到低運行輪次,而不是從低到高)。
在
總之,我們可以在恆定時間內計算出元素i被混洗到哪裡,也可以計算出元素i的源頭在哪裡(用反向操作),計算時間並不取決於列表的長度。 Fisher-Yates混洗並不具有這種特性,且不能對單個索引進行混洗,它們往往需要重複混洗整個列表。
這裡這裡。
最後
最後
聲明:ECN的翻譯工作旨在為中國以太坊社區傳遞優質資訊和學習資源,文章版權歸原作者所有,轉載須註明原文出處以及ethereum.cn,若需長期轉載,請聯繫ethereumcn@gmail.com進行授權。





