Làm thế nào để công bằng và hiệu quả mà không cần sử dụng bằng chứng công việc


lời tựa
lời tựa
tiêu đề phụ
Vẻ đẹp của POW
Pow là một thuật toán đồng thuận đơn giản và thanh lịch. Mỗi nút giải một câu đố mã hóa đơn giản và giải pháp có được thông qua đoán nhanh và ai đoán đúng trước sẽ được chọn để tạo khối tiếp theo.
Nó đơn giản mà.
Thuật toán đơn giản này cũng cung cấp tính ngẫu nhiên thực sự - cho các đề xuất khối công bằng và phi tập trung; một độ trễ nhất định - để đảm bảo rằng có đủ thời gian để phát sóng, giảm thiểu xác suất fork; thế chấp kinh tế - — bằng cách đầu tư vào phần cứng và điện để những người khai thác có một quan tâm đến việc làm một cách trung thực.
tiêu đề phụ
Mô tả hình ảnh
dây chuyền lắp ráp sớm làm việc cạnh nhau
Một vấn đề chính với cơ chế PoW đơn giản và thanh lịch là các vấn đề khó khăn của nó có thể được xử lý ở mức độ song song cao. Những câu đố này thường là một hàm băm, trong đó các nút tiếp tục tạo các chuỗi ngẫu nhiên, băm chúng và xem liệu hàm băm kết quả có khớp với các tiêu chí nhất định hay không. Nếu bạn chỉ là một người chơi (ví dụ: máy, đề), giả sử trung bình bạn có thể đoán đúng câu trả lời sau N giây. Nhưng nếu bạn là một trăm người chơi, thời gian trung bình để bạn đoán câu trả lời đúng là N/100 giây, vì bạn có thể dễ dàng phân phối công việc. Ví dụ: nếu có tổng số M câu trả lời có thể xảy ra, bạn có thể sắp xếp người chơi 1 kiểm tra câu trả lời 1 để trả lời M/100, sau đó sắp xếp người chơi 2 kiểm tra câu trả lời M/100 để trả lời M/200, v.v.
Những người khai thác làm việc trong hệ thống chuỗi khối PoW thường mua một số lượng lớn máy tính chuyên dụng hoặc mạch tích hợp dành riêng cho ứng dụng (ASIC) và gọi các chương trình phối hợp phân công lao động của các ASIC này để đoán câu trả lời, vì vậy tốc độ trung bình tại mà họ đoán câu trả lời đúng sẽ nhanh hơn. Theo thời gian, những người khai thác khác nhau quyết định hợp tác để chia sẻ công việc của các nhóm ASIC của họ, do đó, các nhóm khai thác.
Đối với một mạng như Bitcoin, nếu những người khai thác đoán câu trả lời quá nhanh, thì nó có một bộ thuật toán nội bộ có thể làm tăng độ khó đoán câu trả lời và cuối cùng duy trì thời gian tạo khối ở tốc độ trung bình khoảng 10 phút. Do đó, những người khai thác đoán càng nhanh thì câu đố càng khó, điều này khuyến khích những người khai thác tăng tốc hoặc xây dựng nhiều ASIC hơn thông qua ASIC.
Máy khai thác ngày càng nhanh hơn và nhiều hơn, tiêu thụ ngày càng nhiều năng lượng hơn, cho đến khi mức tiêu thụ năng lượng để duy trì mạng cao đến mức nực cười.
tiêu đề phụ
Mục tiêu thiết kế: Độ trễ ngẫu nhiên
Do đó, nếu chúng ta muốn thiết kế một hệ thống không lãng phí tài nguyên như PoW, nhưng có thể đồng thời đạt được độ trễ ngẫu nhiên, chúng ta cần đạt được các mục tiêu thiết kế sau:
Tính ngẫu nhiên thực sự để đảm bảo tính công bằng và phân cấp
Không thể giảm độ trễ thông qua xử lý song song để giảm thiểu mức tiêu thụ năng lượng
Hãy xem cách tối ưu hóa:
Mô tả hình ảnh
Tiếng ồn trắng là một nguồn ngẫu nhiên xảy ra tự nhiên
Sự ngẫu nhiên thực sự là một câu hỏi triết học nhiều hơn. Khi chúng tôi nói "ngẫu nhiên", điều chúng tôi thực sự muốn nói là "không thể đoán trước". Nếu kết quả của cơ chế của chúng tôi là không thể đoán trước bởi bất kỳ người tham gia nào trong mạng, thì chúng tôi coi kết quả là ngẫu nhiên và công bằng.
Nhiều hàm mật mã dường như tạo ra các đầu ra ngẫu nhiên, chẳng hạn như hàm băm và cơ chế chữ ký. Tuy nhiên, chúng không được thiết kế đặc biệt để tạo ra các đầu ra không thể đoán trước và người quan sát có thể suy ra các mẫu với số lượng mẫu đủ lớn.
Năm 1999, một bài báo của Micali, Rabin và Vadhan đã được xuất bản mô tả một chức năng ngẫu nhiên có thể kiểm chứng (VRF) được thiết kế đặc biệt để tạo ra các đầu ra rất khó đoán. Sau đó, Giáo sư Micali đã thành lập dự án Algorand, sau đó Sergey Gorbunov, một thành viên cốt cán của dự án, đã viết một bài báo chi tiết và dễ hiểu hơn. Nếu bạn quan tâm đến cách xử lý VRF kỹ thuật hơn, bạn có thể tham khảo các bài viết và tài liệu ở trên.
Trong kiến trúc khối DAG của Taraxa, VRF cung cấp tính ngẫu nhiên cho độ trễ ngẫu nhiên. Đầu ra của VRF là:
Cấp độ DAG của khối (L): Khi người đề xuất đóng gói khối, "cấp độ" ở đây là độ dài của chuỗi neo + 1. Vì vậy, nếu bạn là người đề xuất, bạn tính toán chuỗi neo L hiện tại và tìm khối cuối cùng trên ranh giới nơi bạn sẽ xây dựng con trỏ ma (con trỏ), khi đó cấp độ khối bạn đề xuất là L+1. Cần lưu ý rằng định nghĩa ở đây là một khái niệm khác với "độ sâu" thường được nói.
Băm khối (P) của khối Khoảng thời gian mới nhất: Đây là khối hoàn thành mới nhất trong khối DAG, có thể đạt được xác nhận cuối cùng thực sự thông qua quy trình PBFT song song (chi tiết trong bài viết tiếp theo). Xem xét rằng người đề xuất chưa nhận được khối Khoảng thời gian (P) được xác nhận mới nhất trên ranh giới, giao thức sẽ có một dung sai nhất định, nghĩa là hàm băm khối trước đó của khối Khoảng thời gian mới nhất cũng được chấp nhận.
Khóa VRF bí mật của người đề xuất khối (SK): Điều này là cần thiết để xây dựng chức năng VRF. Điều này khác với cơ chế chữ ký giao dịch, được tạo đặc biệt cho mỗi nút để xây dựng VRF.
Đầu ra của chức năng VRF được chia thành hai phần:
v là một giá trị giả ngẫu nhiên được sử dụng để xác định độ dài của độ trễ.
p là bằng chứng mà các nút khác có thể sử dụng để xác minh rằng VRF đã được thực hiện trung thực và chính xác. Nó có thể được coi là một chữ ký và với khóa công khai VRF của người đề xuất, bất kỳ nút nào khác cũng có thể dễ dàng xác định tính đúng đắn của phép tính.
Cuối cùng, chúng ta có thể viết một phương trình đơn giản:
VRF(L, P, SK) → (v, p)
■ Chức năng định hình độ khó bị trì hoãn
Trước khi đầu ra của VRF (độ khó trễ hoặc độ dài trễ) có thể được chuyển đổi thành độ trễ, chúng ta sẽ cần làm cho nó tạo thành một phân phối nhất định. Các đặc điểm của phân phối đại khái như sau:
Cần có độ trễ tối thiểu vì chúng tôi không thể tạo các khối ngay lập tức mà không có thời gian để phát sóng mạng thích hợp
Cần có độ trễ tối đa vì chúng tôi không muốn toàn bộ mạng bị tắc nghẽn và chúng tôi không muốn các khối được tạo ra trong một thời gian dài
Một số người đề xuất nhanh, trong khi số còn lại chậm, điều này liên quan đến số lượng người đề xuất đủ điều kiện và đường kính của toàn bộ mạng (nghĩa là thời gian cần thiết để một khối tiếp cận hầu hết các nút được đề xuất)
Mô tả hình ảnh
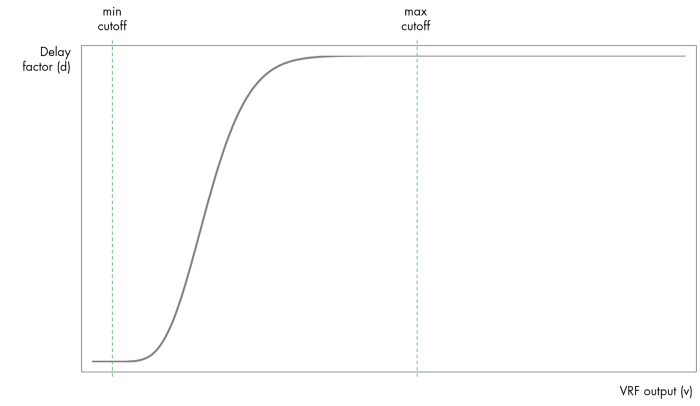
chức năng định hình
Đặt hàm loại là S, chúng ta có thể nhận được công thức sau:
S(v) = d
Ở đây d là hệ số khó khăn của giai đoạn tiếp theo.
■ Độ trễ của chức năng trì hoãn có thể kiểm chứng
Mã thông báo giống như thẻ xe buýt, có thể tự tạo ra chuyển giá trị và chuỗi liên minh không có chuyển giá trị gốc. Đất nước đang đàn áp các mô hình kim tự tháp, nhưng trên thực tế vẫn có nhiều mã thông báo có giá trị, khi ngành công nghiệp phát triển và công chúng nhận ra nó ở một mức độ nhất định, chuỗi công khai chất lượng cao có thể tránh được tình trạng một kích cỡ phù hợp với tất cả . Vào thời điểm này, có thể có nhiều sự hợp tác hơn giữa chuỗi liên minh và chuỗi công khai.
Một mình vất vả chẳng ai kề vai sát cánh =(
Như đã thảo luận ở đầu bài viết này, PoW là tốt, nhưng xử lý song song là thủ phạm của "chủ nghĩa nạn nhân" của nó. Do đó, các Hàm độ trễ có thể kiểm chứng (VDF) đã xuất hiện, được thiết kế đặc biệt để mô phỏng độ trễ không thể tăng tốc bằng cách xử lý song song.
Một chức năng có thể được phân loại nghiêm ngặt là VDF nếu nó đáp ứng hai tiêu chí đơn giản sau:
phải tuần tựTrong trường hợp này, không ai có thể tăng tốc độ tính toán chức năng VDF thông qua nhiều quy trình song song, khác với PoW.
phải dễ dàng kiểm chứng,Người quan sát có thể chỉ cần xác minh (nghĩa là thời gian cần thiết để xác minh ngắn hơn nhiều so với thời gian tính toán chức năng) để xác nhận rằng tính toán VDF là chính xác và xảy ra độ trễ thích hợp, tương tự như PoW.
Boneh và cộng sự, Pietrzak, và Wesolowski và cộng sự đều đề xuất các VDF đáp ứng các tiêu chí này.Đặc biệt, Pietrzak và Wesolowski đều độc lập đề xuất các phương pháp rất giống nhau dựa trên nguyên tắc bình phương lặp lại trong các nhóm không xác định thứ tự, có hiệu quả chống lại quá trình xử lý song song.
Hãy kiểm tra các chức năng này ở cấp độ cao hơn, bởi vì toán học rất phức tạp.
Các VDF này được xây dựng để thực hiện các phép tính bình phương lặp đi lặp lại không thể xử lý song song vì mỗi lần lặp yêu cầu đầu vào từ lần lặp trước và không có thông tin về các lần lặp trong tương lai trong bất kỳ lần lặp cụ thể nào. Nói cách khác, bạn sẽ không biết câu trả lời cho đến khi bạn bước qua tất cả các lần lặp lại. Điều này đảm bảo rằng chức năng là tuần tự.
Điều làm cho VDF dễ dàng xác minh là bạn có thể xây dựng bằng chứng với sự kết hợp tuyến tính ngẫu nhiên của đầu vào trung gian VDF và đầu ra cuối cùng. Việc tính toán các tổ hợp tuyến tính hạn chế này rất đơn giản vì nó bao gồm ít bước hơn nhiều so với việc tính toán toàn bộ VDF. Một sự tương tự đơn giản là sự khác biệt giữa việc tính toán tất cả các giá trị trong toàn bộ đường cong (tính toán toàn bộ VDF) và chọn một mũi tên để đẩy về phía trước một vài bước (chứng minh tính hiệu quả của VDF). Thời gian mũi tên tiến thêm vài bước rõ ràng là ít hơn nhiều so với tính toán. Điều này đảm bảo rằng chức năng có thể dễ dàng kiểm chứng.
Ở Taraxa, chúng tôi đặt các mục đầu vào sau trong VDF:
Parent Hash (gP) hoặc khối cha mà khối mới tạo của bạn trỏ tới thông qua một con trỏ ma
Hàm băm của tất cả các giao dịch (Tx), hàm băm của tất cả các giao dịch mà bạn dự định đưa vào khối, do đó bạn không thể tính toán VDF trước
d, yếu tố khó khăn của bước trước
Do đó, trước khi nút đề xuất một khối, phép tính hàm VDF sẽ như sau:
VDF(gP, Tx, d) = z
Trong thực tế, để đảm bảo rằng việc xác minh đầu ra z là không tương tác, người đề xuất nút cần chèn bằng chứng trung gian cũng như đầu ra cuối cùng vào khối đề xuất.
Mô tả hình ảnh
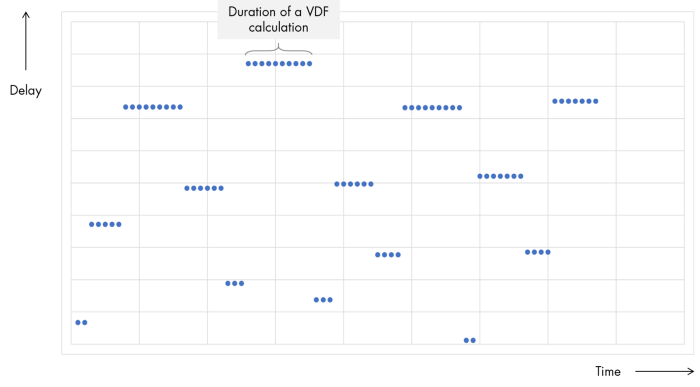
Đối với mục đích minh họa, điều này được tạo ra từ phân phối thống nhất
Khi viết bài này, VDF vẫn là một công nghệ rất thử nghiệm và đang được nghiên cứu và thử nghiệm tích cực. Taraxa sẽ hợp tác với những người giỏi nhất trong lĩnh vực nguồn mở và cộng đồng học thuật để đảm bảo rằng sổ cái của chúng tôi áp dụng giải pháp ổn định, hiệu quả và an toàn nhất.