如何在不使用工作量證明的情況下實現公平且高效


前言
前言
二級標題
POW之美
前言
前言
就這麼簡單。
二級標題
圖片描述
這個簡單的算法同時提供了真正的隨機性——來進行公平且去中心化的區塊提議;一定的延遲——確保有足夠的時間來廣播,最大程度降低分叉概率;經濟上的抵押— —通過硬件和電力投資來實現,這樣礦工就有既得利益來誠實工作。
二級標題
二級標題
圖片描述
簡單又優雅的PoW機制有一個關鍵問題,那就是它的難題是可以高度並行處理的。這些難題通常是一個哈希函數,節點只是不停生成隨機字符串,用哈希法進行處理,然後看得出的哈希值是否符合特定條件。如果你只是一名玩家(例如一台機器、一個線程),假設你平均能在N秒後猜對答案。但如果你是一百名玩家,那麼平均你猜對答案的時間就是N/100秒,因為你可以輕鬆分配工作。舉個例子,假如一共有M種可能的答案,你可以安排玩家1號測試答案1到答案M/100,再安排玩家2號測試答案M/100到答案M/200,以此類推。
二級標題
在PoW區塊鏈系統中工作的礦工們通常會購買大量的專用電腦,或者專用集成電路(ASIC),並調用程序協調這些ASIC的分工來猜答案,所以平均算下來他們猜中正確答案的速度會快些。隨時時間的推移,不同的礦工決定抱團來分擔他們ASIC集團的工作,因此就有了礦池。
對於比特幣這樣的網絡,如果礦工猜答案猜得太快,它有一套內部算法可以提高猜答案的難度,最終將出塊時間維持在平均10分鐘左右一塊的速度。因此,礦工猜得越快,謎題難度越大,這樣也就激勵了礦工通過ASIC提速或者搭建更多的ASIC。
礦機速度越來越快,數量越來越多,消耗的能量也越來越多,直到維護網絡的能耗高得離譜。
二級標題
所以,如果我們想要設計一套不像PoW那麼浪費資源的系統,但同時又能做到隨機延遲的話,我們需要達成以下設計目標:
圖片描述
真正的隨機性以確保公平與去中心化
延遲不可以通過並行而降低,以最大程度減少能耗
下面我們來看看如何優化:
圖片描述
圖片描述
白噪音就是自然出現的一種隨機源
真正的隨機性更多的是一個哲學問題。我們在說“隨機”的時候,我們真正想要的是“不可預測”。如果我們的機制輸出的結果是網絡任何參與方都無法預測的,那麼我們就認為這個結果是隨機的,且是公正的。
許多加密函數似乎都能生成隨機輸出,例如哈希函數和簽名機制。但是,他們並不是專門為了生成不可預測的輸出而設計的,且觀察者能夠在給定足夠大量樣本的情況下得出模式。
在1999年,一篇由Micali,Rabin和Vadhan撰寫的論文發表了,他們描述了一種可驗證的隨機函數(VRF),這個函數是專門為了生成高度不可預測的輸出而設計的。後來,Micali教授成立了Algorand項目,之後該項目核心成員Sergey Gorbunov寫了一篇更詳細且更容易理解的文章。如果你對VRF的更多技術處理感興趣,可以參閱上述文章和論文。
在Taraxa的區塊DAG架構裡,VRF為隨機延遲提供了隨機性。 VRF的輸出是:
區塊DAG的級別(L):在提議者打包區塊時,這裡的“級別”就是錨定鏈的長度+1。所以,如果你是提議者,你計算了當前的錨定鏈L,發現了你將要搭建幽靈指針(pointer)的邊界上的終結塊,那麼你提議的區塊級別就是L+1。需要注意的是,這裡的定義與常說的“深度”是不同概念。
最新Period區塊的區塊哈希(P):這是在區塊DAG中最新完成的區塊,能夠通過一個並行PBFT流程(下一篇文章會詳述)實現真正的最終確認。考慮到在邊界上提議者尚未接收到最新確認的Period區塊(P),所以協議會有一定的容忍,即最新Period區塊的上一個區塊哈希也是可接受的。
VRF(L, P, SK) → (v, p)
區塊提議者的秘密VRF密鑰(SK):這個是搭建VRF函數所需要的。這與交易簽名機制不同,是專門為每個節點生成用於搭建VRF的。
VRF函數的輸出分兩塊:
v是一個偽隨機值,用於確定延遲長度。
p是一個證明,其他節點可以用其來驗證VRF已誠實且正確地執行。可以把它當作一個簽名,有了提議者的VRF公鑰,任意其他節點都可以輕鬆確定計算的正確性。
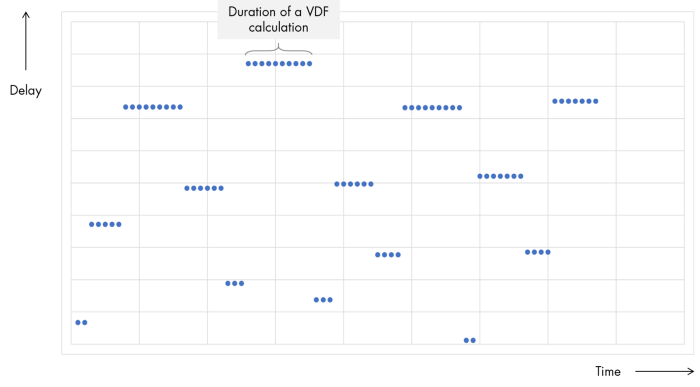
在VRF的輸出(延遲難度或延遲長度)轉換為延遲之前,我們會需要讓其形成一定的分佈。分佈的特徵大致如下:
圖片描述
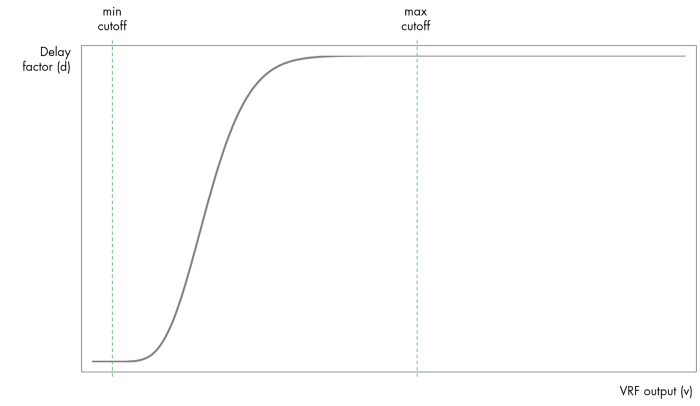
需要有一個最小延遲,因為我們不能讓區塊立即生成,不然會沒有時間進行適當的網絡廣播
需要有一個最大延遲,因為我們不希望整個網絡堵塞,也不希望長時間不生產塊
S(v) = d
部分提議者速度要快,而剩下一部分要慢,這與合格提議者數量以及整個網絡的直徑(也就是一個區塊到達大多數提議節點所需的時間)有關
圖片描述
圖片描述
成型函數
設成型函數為S,我們可以得出以下公式:
這裡d就是下一階段的難度係數。
■可驗證延遲函數的延遲Token 像個公交卡,能自身產生價值轉移,聯盟鏈沒有原生的價值轉移。國家打擊的是傳銷盤,但其實還有很多的具有價值的代幣,當行業發展和公眾認知到一定程度的時候,優質的公鏈能避免一刀切的狀況。等到這個時候,聯盟鍊和公鏈的合作可能更多。
獨自辛苦獨自忙,無人並肩共作戰=(正如本文開頭討論的那樣,PoW好是好,但並行處理是其“風評被害”的罪魁禍首。於是,可驗證延遲函數(VDF)出現了,這個函數是專門為了模擬無法通過並行處理加速的延遲而設計的。
如果一個函數符合以下兩點簡單的標準,那麼就可以嚴格將其歸為VDF:必須是順序的,
這種情況下無人能夠通過多個並行處理來加快VDF函數的計算,這一點與PoW不同。
必須是可簡單驗證的,
觀察者能夠簡單地進行驗證(也就是其用來驗證的時間遠比計算函數的時間短),確認VDF計算正確且出現的是適當的延遲,這一點與PoW相似。
Boneh et al.,Pietrzak和Wesolowski等人都提出了滿足這些標準的VDF。
特別是,Pietrzak和Wesolowski都基於在未知順序的組別裡重複平方的原理,各自獨立地提出了高度相似的方法,這些方法能夠有效抵抗並行處理。
讓我們在更高層次測試一下這些函數吧,因為數學是非常複雜的。
這些VDF的構建是執行重複平方的計算,這些計算是無法並行處理的,因為每次迭代都需要上一次迭代的輸入,且任何給定迭代中不會提供關於未來迭代的信息。換句話說,除非你一步步完成所有迭代,否則你無法知曉答案。這一點確保了這個函數是順序的。
而讓VDF能夠簡單驗證的是,你可以用包含VDF中間輸入與最終輸出的隨機線性組合來搭建一個證明。這些限線性組合的計算很簡單,因為比起計算整個VDF來說,它涉及的步驟要少很多。簡單地類比一下就是,計算整個曲線中的所有數值(計算整個VDF)與選個箭頭往前推幾步(證明VDF的有效性)的差距。箭頭前進幾步所花費的時間顯然比計算少得多。這一點確保了這個函數是可簡單驗證的。
VDF(gP, Tx, d) = z
所有交易的哈希(Tx),你計劃打包到區塊中的所有交易的哈希,所以你無法事先計算VDF
圖片描述
d,上一步的難度係數
所以,在節點提議區塊之前,VDF函數計算長這樣: