


SignalPlus: Giới thiệu về AI sáng tạo


lời tựa
“What I cannot create, I do not understand.”
-Richard Feynman
lời tựa
Bạn sử dụng Stable Diffusion và MidJourney để tạo ra những hình ảnh tuyệt đẹp.
Bạn thành thạo sử dụng ChatGPT và LLaMa để tạo ra những từ ngữ trang nhã.
Bạn chuyển đổi qua lại giữa MuseNet và MuseGAN để tạo ra âm nhạc miền núi.
Không còn nghi ngờ gì nữa, khả năng độc đáo nhất của con người là sáng tạo, nhưng trong thời đại công nghệ luôn thay đổi ngày nay, chúng ta tạo ra bằng cách tạo ra máy móc! Một chiếc máy có thể vẽ tác phẩm nghệ thuật gốc (vẽ), soạn một bài báo dài mạch lạc (viết), soạn nhạc du dương (sáng tác) và hình thành các chiến lược chiến thắng cho các trò chơi phức tạp (chơi), theo một phong cách nhất định. Công nghệ này làtrí tuệ nhân tạo sáng tạo (Generative Artificial Intelligence,danh hiệu cấp một
1. Mô hình sáng tạo và phân biệt đối xử
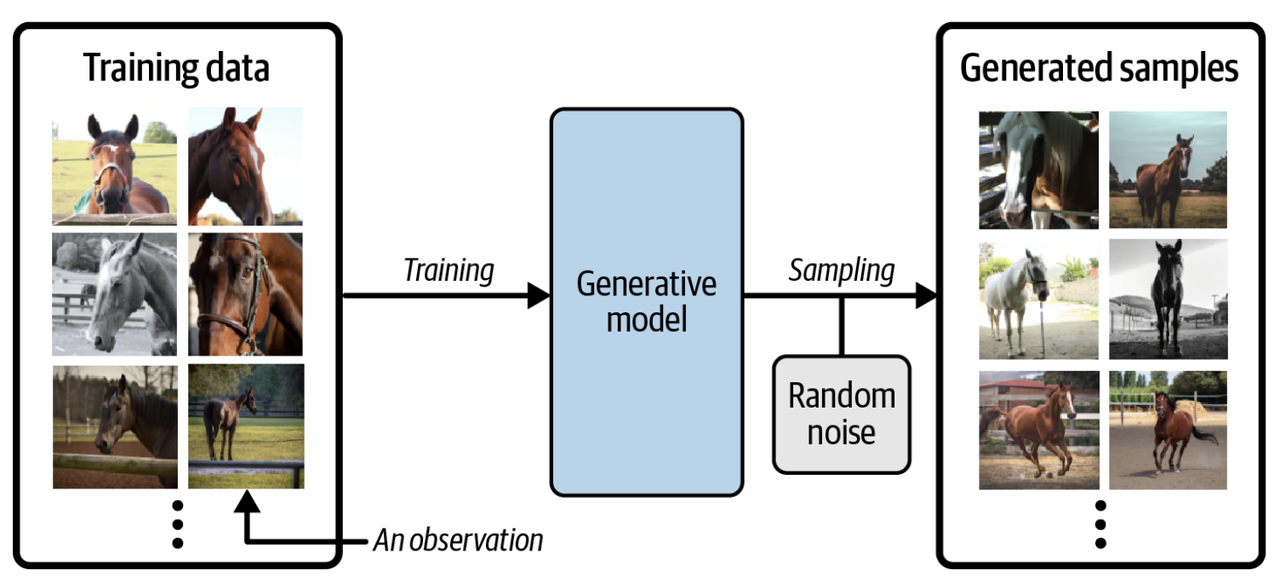
GenAI là một từ thông dụng, bản chất đằng sau nó làtạo mô hình(mô hình tổng quát), là một nhánh của học máy với mục tiêu là huấn luyện một mô hình để tạo ra dữ liệu mới tương tự như một tập dữ liệu nhất định.
Giả sử chúng ta có một tập dữ liệu về ngựa. Đầu tiên, chúng ta có thể huấn luyện một mô hình tổng quát trên tập dữ liệu này để nắm bắt các quy tắc chi phối mối quan hệ phức tạp giữa các pixel trong hình ảnh con ngựa. Mô hình này sau đó được lấy mẫu để tạo ra hình ảnh thực tế về những con ngựa không tồn tại trong tập dữ liệu ban đầu, như trong hình bên dưới.
Để thực sự hiểu mục đích và tầm quan trọng của các mô hình tổng quát, hãy so sánh chúng vớimô hình phân biệt(mô hình phân biệt đối xử) so sánh là cần thiết. Trên thực tế, hầu hết các vấn đề trong học máy đều được giải quyết bằng mô hình phân biệt, hãy xem các ví dụ sau.
Giả sử chúng ta có một tập dữ liệu về các bức tranh, một số của Van Gogh và một số của các họa sĩ khác. Với đủ dữ liệu, chúng ta có thể huấn luyện một mô hình phân biệt để dự đoán liệu một bức tranh nhất định có phải của Van Gogh hay không, như trong hình bên dưới.
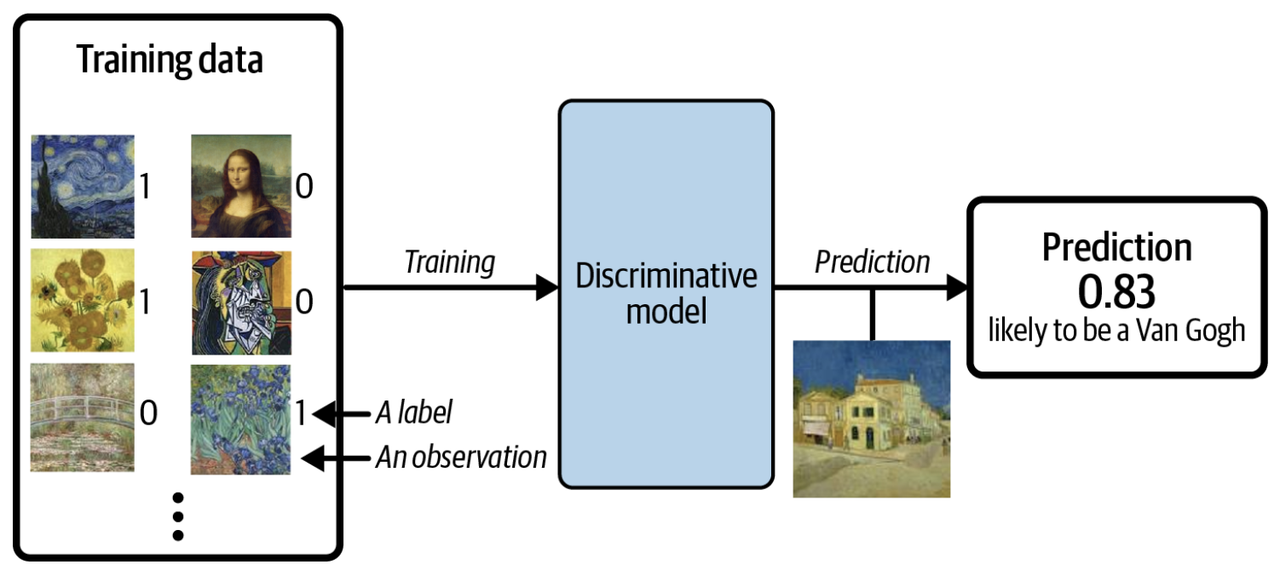
Khi sử dụng mô hình phân biệt, mỗi mẫu trong tập huấn luyện đều có một nhãn (label), đối với bài toán hai loại trên, nhãn của bức tranh của Van Gogh thường là 1, và nhãn của bức tranh không phải của Van Gogh là 0. Trong hình trên, xác suất dự đoán cuối cùng của mô hình là 0,83 nên rất có thể nó được tạo ra bởi Van Gogh. Không giống như mô hình phân biệt đối xử, mô hình tổng quát không yêu cầu các ví dụ phải chứa nhãn vì mục tiêu của nó là tạo ra dữ liệu mới chứ không phải dự đoán nhãn cho dữ liệu.
Sau khi đọc ví dụ, chúng ta hãy sử dụng ký hiệu toán học để xác định chính xác mô hình tổng quát và mô hình phân biệt đối xử:
cặp mô hình phân biệt P(y|x) mô hình hóa, các tính năng nhất địnhx để ước tính nhãn y xác suất có điều kiện của .
Tạo cặp mô hình P(x) mô hình hóa, ước tính các tính năng trực tiếp xXác suất của các đặc điểm mới có thể được tạo ra bằng cách lấy mẫu từ phân bố xác suất này.
danh hiệu cấp một
2. Khung cho các mô hình tổng quát
Trước khi đi vào khung mô hình tổng quát, chúng ta hãy chơi một trò chơi. Giả sử các điểm trong hình dưới đây được tạo ra bởi một quy tắc nhất định, chúng ta gọi quy tắc này là Pdữ liệu, giờ đây cho phép bạn tạo một dữ liệu khácx = (x 1,x 2) làm cho điểm dường như được xác định theo các quy tắc tương tựPđược tạo ra bởi dữ liệu.
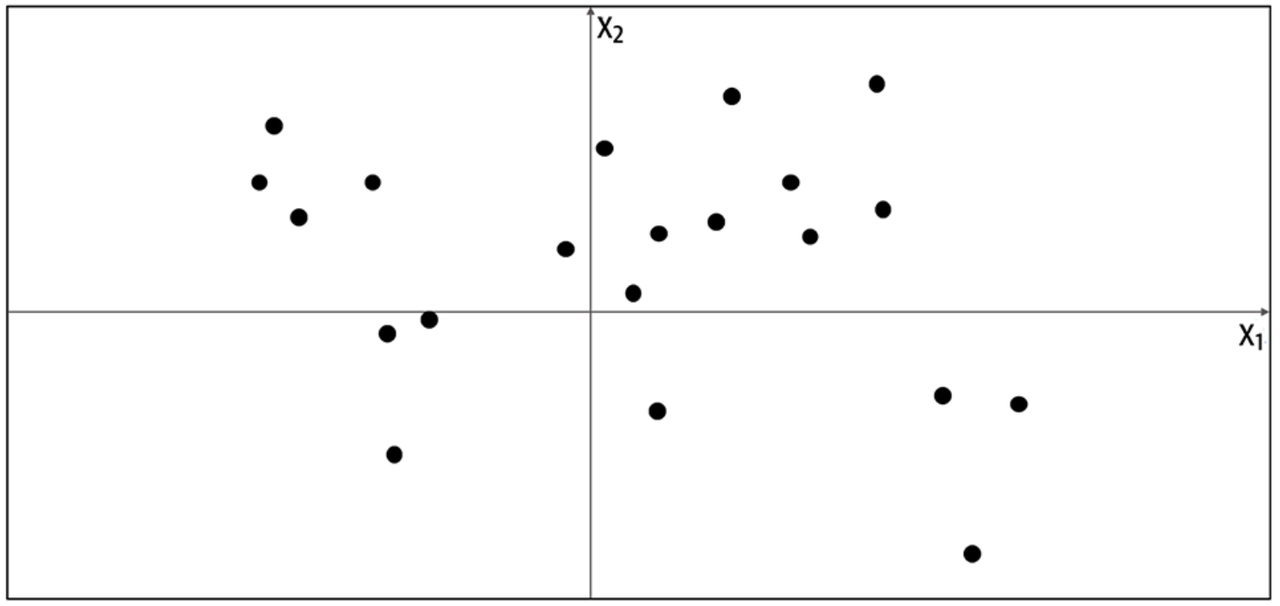
Bạn sẽ tạo ra điểm này như thế nào? Bạn có thể tạo một mô hình trong đầu bằng cách sử dụng các điểm đã choPmô hình và vị trí mà mô hình này chiếm giữ có thể tạo ra các điểm bạn muốn. Từ đó có thể thấy rằng mô hìnhPmô hình làPước lượng dữ liệu. Sau đó, một mô hình đơn giản nhấtPMô hình là hộp màu cam trong hình bên dưới, điểm chỉ có thể được tạo bên trong hộp chứ không thể tạo điểm bên ngoài hộp.
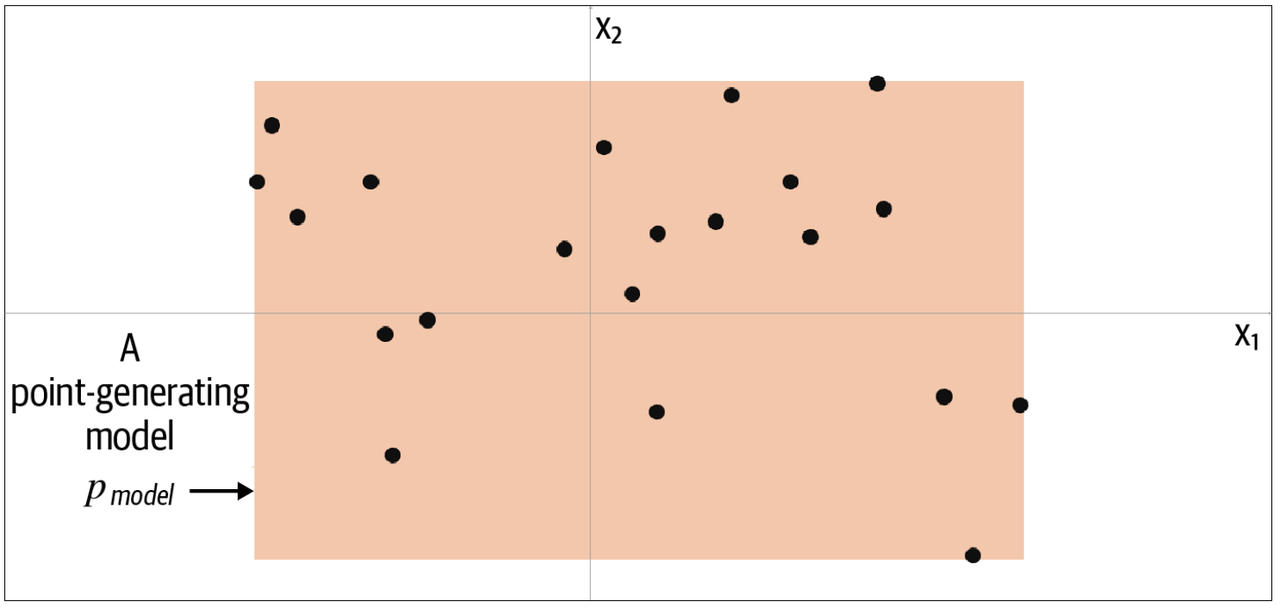
Để tạo một điểm mới, chúng ta có thể chọn ngẫu nhiên một điểm từ hộp, chặt chẽ hơn, từ mô hìnhPLấy mẫu trong phân phối mô hình. Đây là một mô hình sáng tạo tối giản. Bạn tạo một mô hình (hộp màu cam) từ dữ liệu huấn luyện (các chấm đen), sau đó bạn lấy mẫu từ mô hình đó với hy vọng rằng các điểm được tạo trông giống với các điểm trong tập huấn luyện.
Bây giờ chúng ta có thể chính thức đề xuất một khuôn khổ cho việc học tập sáng tạo.
Bây giờ chúng ta hãy tiết lộ phân phối tạo dữ liệu thực sựPdữ liệu và xem khung trên áp dụng như thế nào cho ví dụ này. Từ hình bên dưới, chúng ta có thể thấy rằng các quy tắc tạo dữ liệuPdữ liệu là các điểm chỉ được phân bố đồng đều trên đất liền và không xuất hiện trên đại dương.
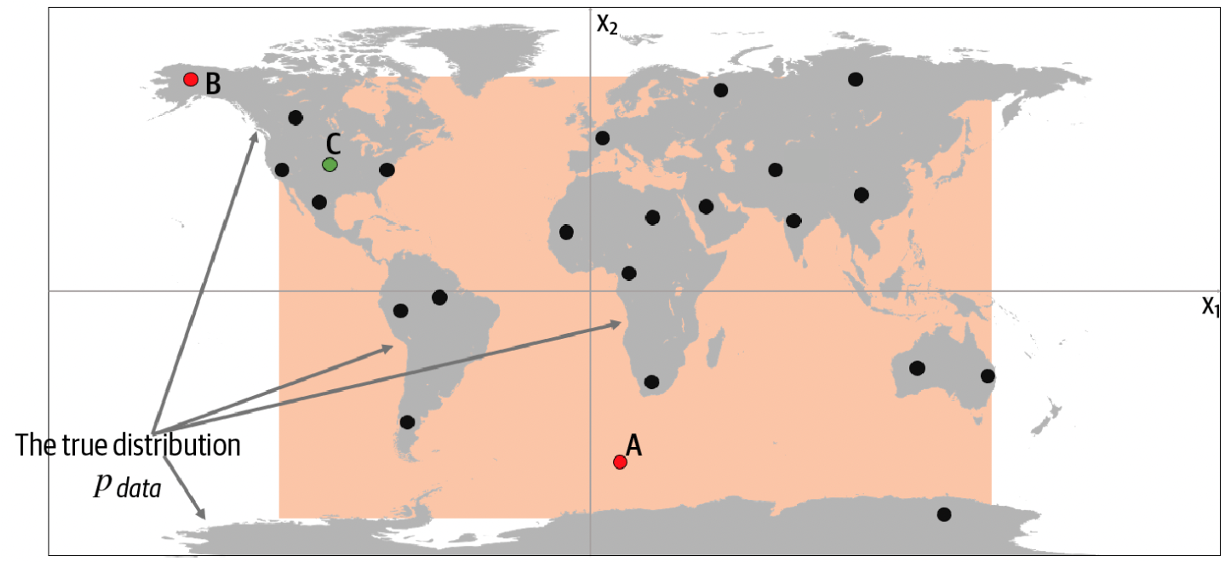
Rõ ràng, mô hình của chúng tôiPmô hình là quy tắcPĐơn giản hóa dữ liệu. Nó giúp chúng ta hiểu mô hình bằng cách kiểm tra các điểm A, B và C của sơ đồ trênPLiệu mô hình có bắt chước thành công quy tắc hay khôngPdata。
Điểm A không thỏa mãn quy luật Pdữ liệu xuất hiện trên biển nhưng có thể được xác định bằng mô hìnhPmô hình được tạo ra khi nó xuất hiện bên trong hộp màu cam.
Điểm B không thể được mô hình hóa bằngPmô hình được tạo vì nó xuất hiện bên ngoài hộp màu cam nhưng tuân thủ các quy tắcPdữ liệu như nó xuất hiện trên đất liền.
Điểm C được mô hình hóa bởiPMô hình được tạo và tuân thủ các quy tắcPdata。
danh hiệu cấp một
3. Mô hình thế hệ đầu tiên
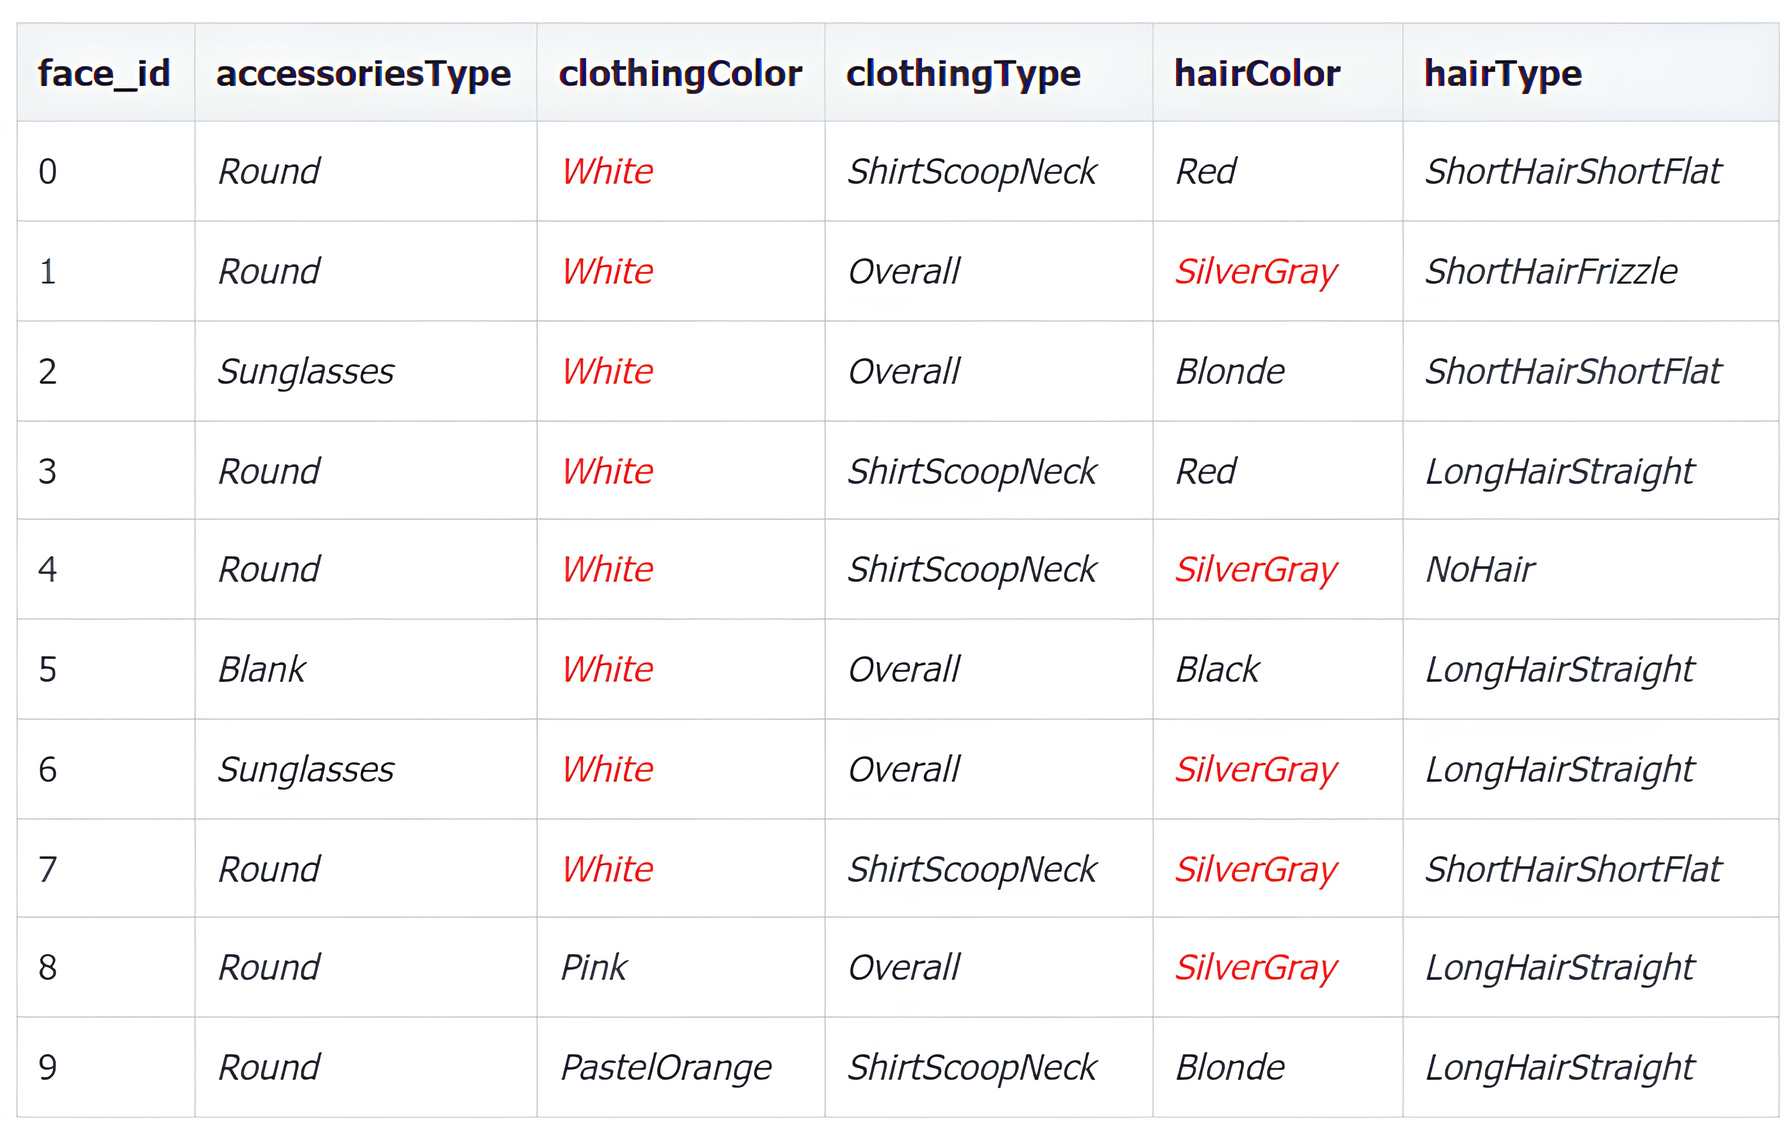
Giả sử bạn là Giám đốc Thời trang (CFO) của một công ty và công việc của bạn là tạo ra những bộ quần áo mới hợp thời trang. Năm nay, bạn đã nhận được 50 bộ dữ liệu về các cụm từ thời trang (như hiển thị bên dưới) và bạn cần tạo 10 cụm từ thời trang mới.
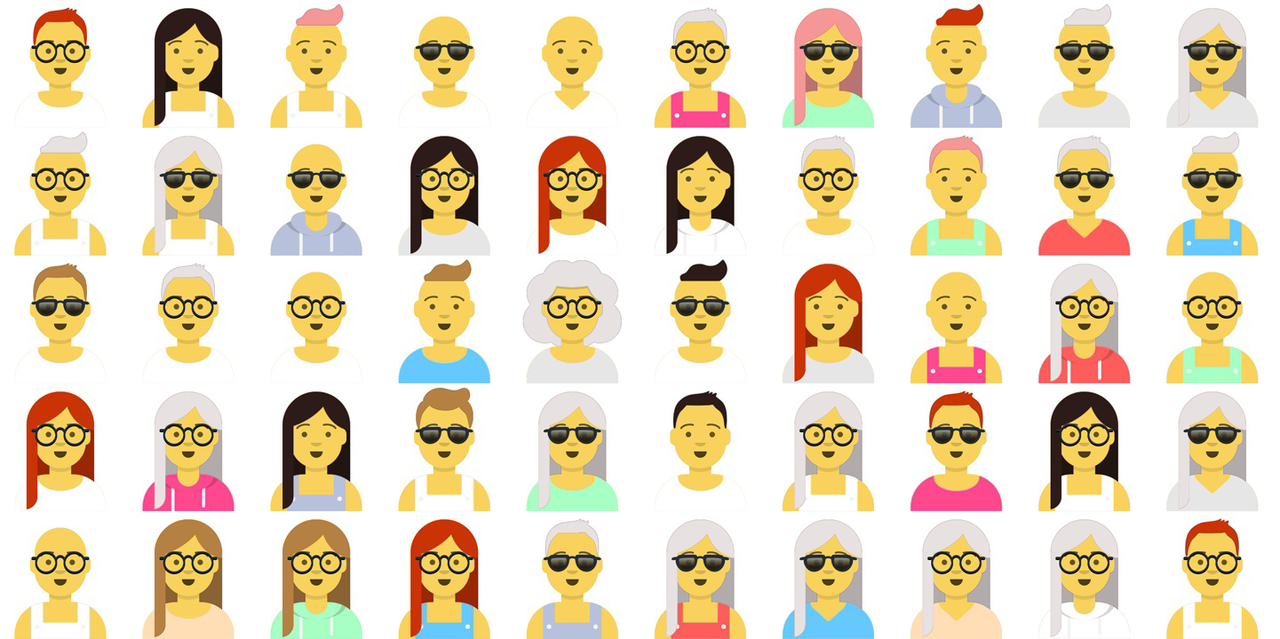
Mặc dù bạn là giám đốc thời trang nhưng bạn cũng là một nhà khoa học dữ liệu nên bạn quyết định sử dụng các mô hình tổng quát để giải quyết vấn đề này. Sau khi đọc 50 bức ảnh trên, bạn quyết định sử dụng năm tính năng,Loại phụ kiện (accessies type)、màu quần áo (clothing color)、loại quần áo (clothing type)、Màu tóc(màu tóc) vàkiểu tóc(loại tóc), để mô tả sự sắp xếp thời trang.
10 tính năng dữ liệu hình ảnh hàng đầu như sau.
Mỗi tính năng cũng có một số giá trị riêng khác nhau:
3 loại phụ kiện (loại phụ kiện):
Blank, Round, Sunglasses
8 màu quần áo:
Black, Blue 01, Gray 01, PastelGreen, PastelOrange, Pink, Red, White
4 loại quần áo:
Hoodie, Overall, ShirtScoopNeck, ShirtVNeck
6 màu tóc:
Black, Blonde, Brown, PastelPink, Red, SilverGray
7 loại tóc:
NoHair, LongHairBun, LongHairCurly, LongHairStraight, ShortHairShortWaved, ShortHairShortFlat, ShortHairFrizzle
Theo cách này, có 3 * 8 * 4 * 6 * 7 = 4032 tổ hợp đặc trưng, do đó có thể tưởng tượng rằng không gian mẫu chứa 4032 điểm. Từ 50 điểm dữ liệu đã cho, có thể thấy rằngPdữ liệu sẽ ưu tiên các giá trị tính năng nhất định cho các tính năng khác nhau. Có thể thấy từ bảng trên có nhiều màu quần áo trắng và màu tóc xám bạc hơn trong ảnh. Vì chúng ta không biết thực tếPdữ liệu, chúng tôi chỉ có thể sử dụng 50 dữ liệu này để xây dựngPmô hình để nó có thể được sử dụng vớiPtiêu đề phụ
3.1 Mô hình tối giản
Một trong những phương pháp đơn giản nhất là gán một tham số xác suất cho mỗi điểm trong tổ hợp đặc trưng 4032, sau đó mô hình chứa 4031 tham số, vì tổng của tất cả các tham số xác suất bằng 1. Bây giờ hãy kiểm tra từng dữ liệu 50 và cập nhật các tham số của mô hình(θ 1 ,θ 2 ,…,θ 4031 )TRONG
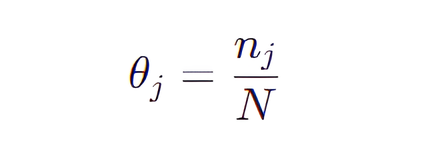
TRONG Nlà số lượng dữ liệu được quan sát, cụ thể là 50,njlà người đầu tiênjSố lượng kết hợp tính năng xuất hiện trong 50 dữ liệu.
Ví dụ: tổ hợp tính năng (được gọi là tổ hợp 1) của (LongHairStraight, Red, Round, ShirtScoopNeck, White) xuất hiện hai lần, sau đó
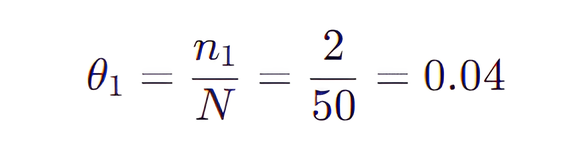
Ví dụ: nếu tổ hợp tính năng (gọi là tổ hợp 2) của (LongHairStraight, Red, Round, ShirtScoopNeck, Blue 01) không xuất hiện thì
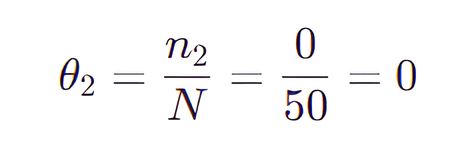
Theo quy tắc trên ta sẽ tính được tổ hợp của 4031θgiá trị, không khó để nhận thấy rằng có rất nhiềuθCác giá trị đều bằng 0 và điều tệ hơn là chúng ta không thể tạo ra những hình ảnh mới chưa nhìn thấy (θ= 0 có nghĩa là không có hình ảnh nào có sự kết hợp các đặc điểm đó từng được quan sát). Để khắc phục điều này, chỉ cần cộng tổng số đặc trưng d vào mẫu số và 1 vào tử số, một kỹ thuật được gọi là làm mịn Laplace.
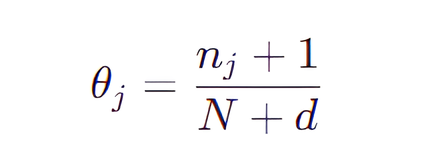
Bây giờ, mọi kết hợp (bao gồm cả những kết hợp không có trong tập dữ liệu gốc) đều có xác suất lấy mẫu khác 0, tuy nhiên đây vẫn không phải là mô hình tổng quát thỏa đáng vì xác suất của một điểm không có trong tập dữ liệu gốc là một hằng số. Nếu chúng ta cố gắng sử dụng một mô hình như vậy để tạo ra một bức tranh của Van Gogh, nó sẽ hoạt động trên hai bức tranh sau với xác suất bằng nhau:
Bản sao các bức tranh gốc của Van Gogh (không có trong tập dữ liệu gốc)
Các bức tranh được tạo từ các pixel ngẫu nhiên (không có trong tập dữ liệu gốc)
tiêu đề phụ
3.2 Mô hình con đơn giản
Mô hình Naive Bayes (Naive Bayes) có thể giảm đáng kể số lượng kết hợp của các tính năng trên và theo mô hình của nó, mỗi tính năng được giả định là độc lập với nhau. Quay trở lại dữ liệu trên, màu tóc của một người (đặc điểmxj) và màu sắc quần áo (đặc trưng xk ) không có mối liên hệ nào, được biểu diễn bằng biểu thức toán học là:
p(xj | xk) = p(xk)
Với giả định này, chúng ta có thể tính toán
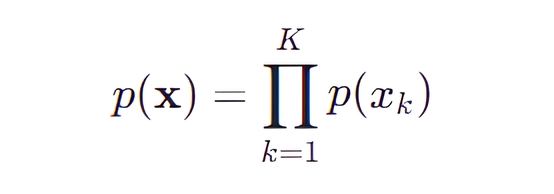
Mô hình Naive Bayesian đơn giản hóa bài toán ban đầu ước tính xác suất cho từng tổ hợp tính năng thành ước tính xác suất cho từng tính năng. Ban đầu, chúng tôi cần sử dụng tham số 4031 ( 3 * 8 * 4 * 6 * 7). Bây giờ chỉ còn 23 ( 3) + 8 + 4 + 6 + 7) là bắt buộc và biểu thức của từng tham số là:
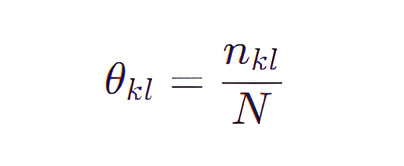
Trong đó N là số lượng dữ liệu quan sát được, cụ thể là 50,nkl là người đầu tiên ktính năng tiếp theol Số lượng giá trị riêng.
Thông qua số liệu thống kê của 50 dữ liệu, bảng sau đây đưa ra các giá trị tham số của mô hình Naive Bayesian.
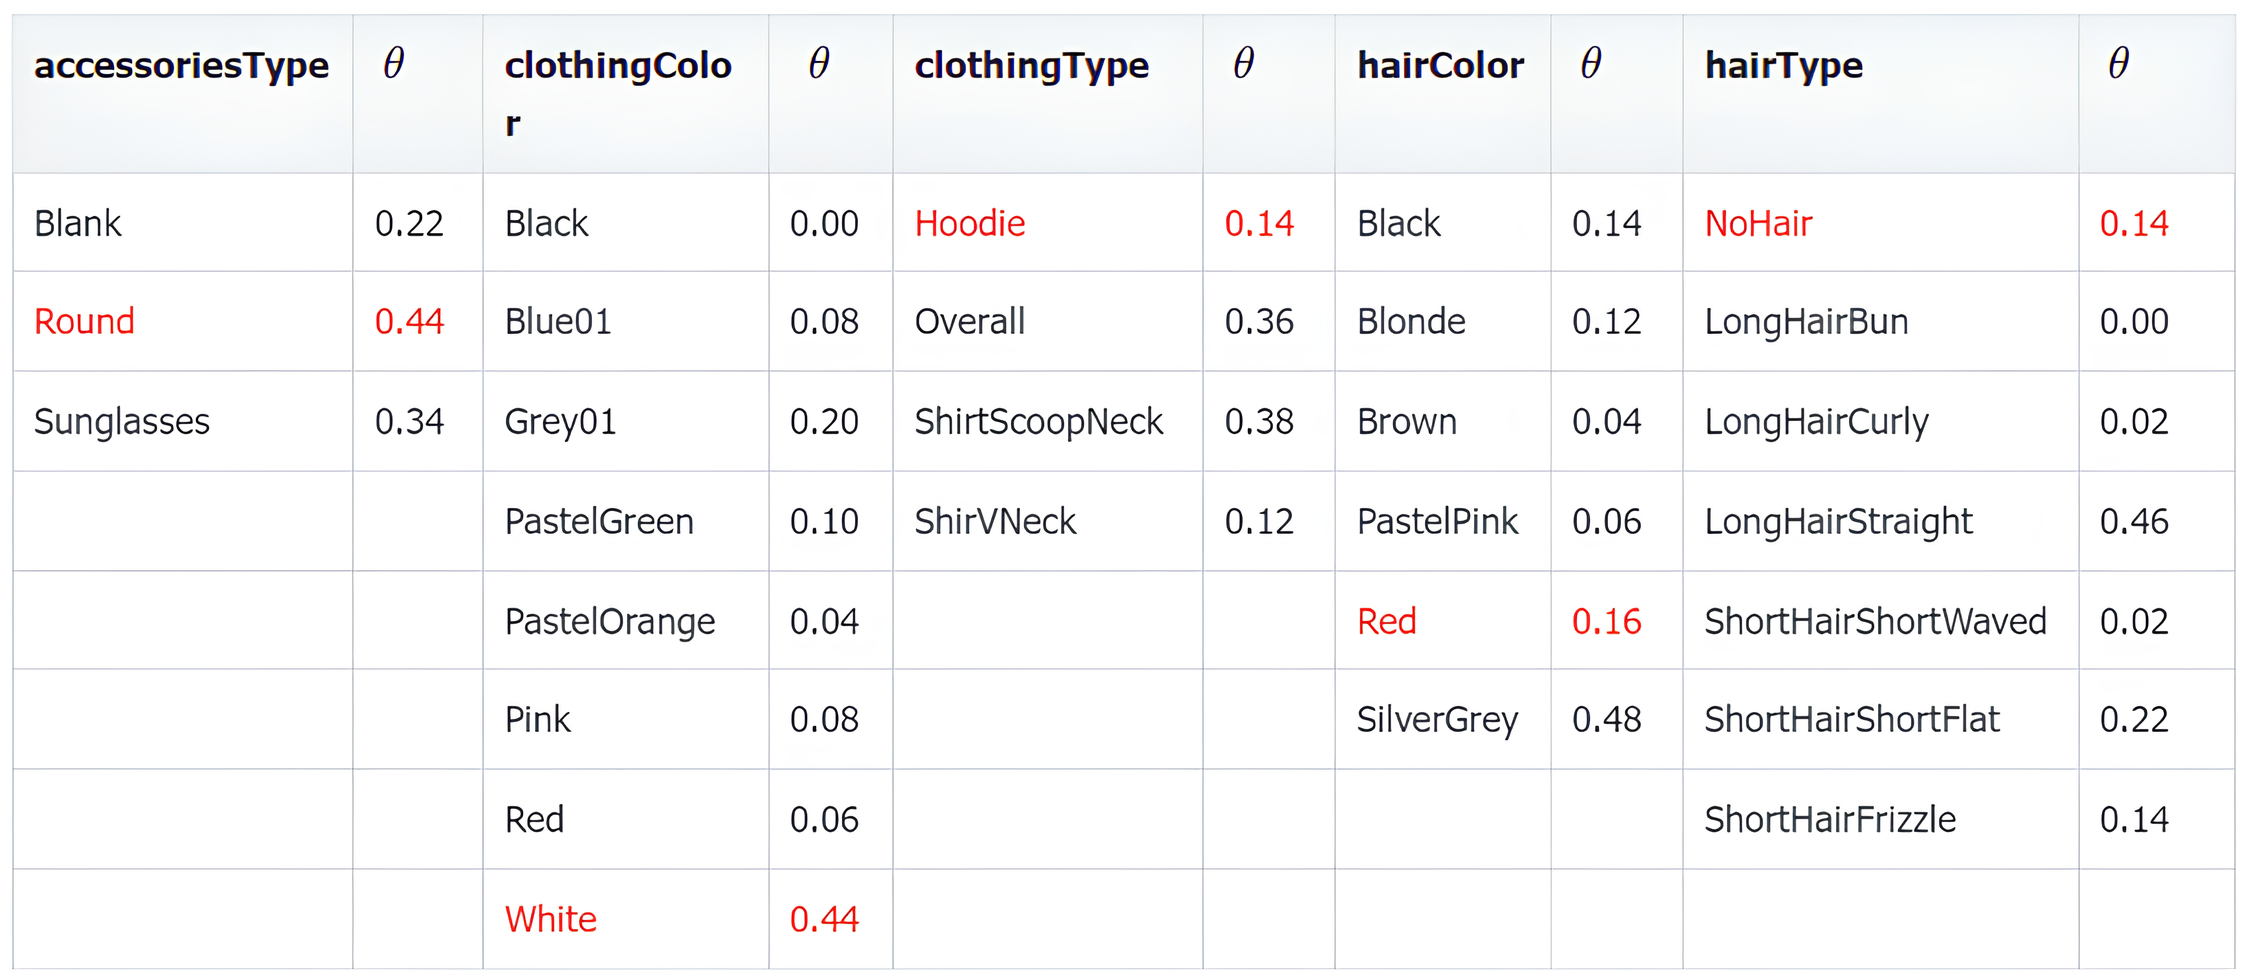
Để tính xác suất của một mô hình tạo ra một đối tượng dữ liệu, chỉ cần nhân các xác suất trong bảng trên, ví dụ:
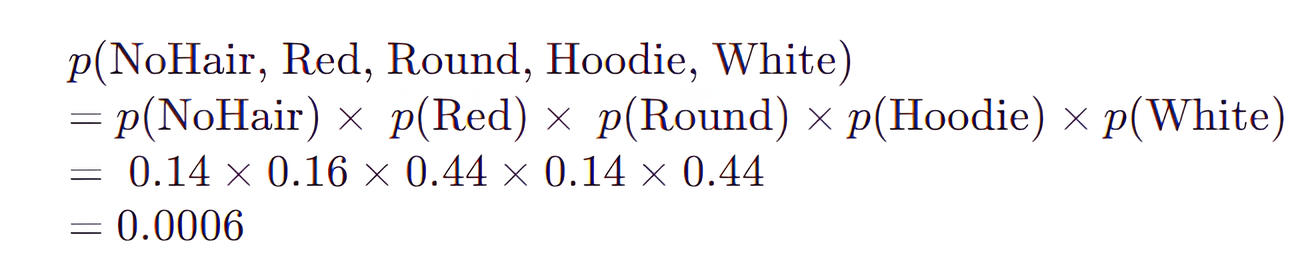
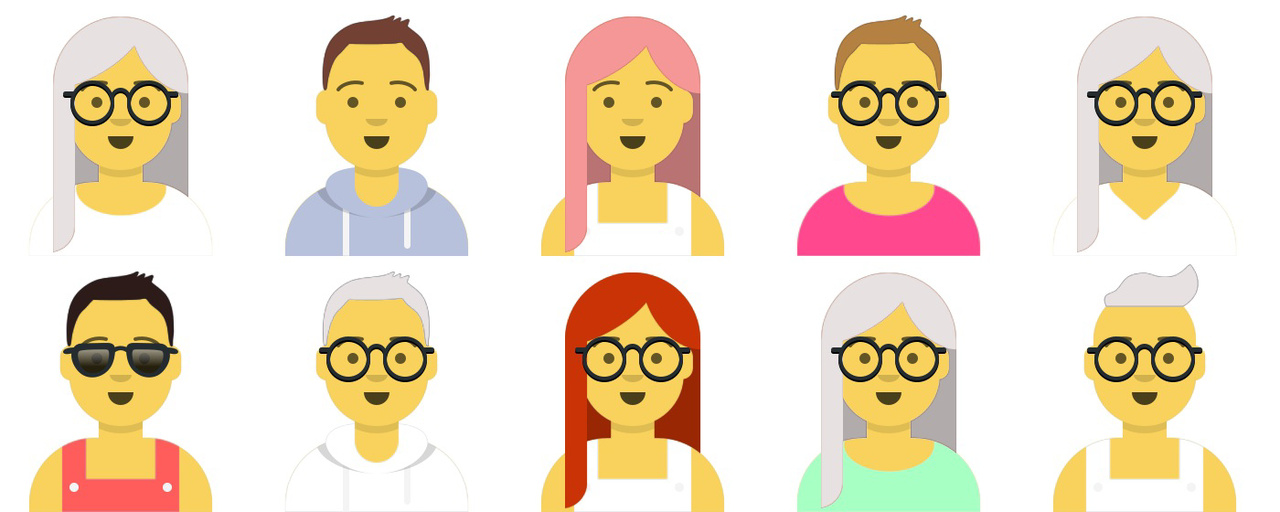
Sự kết hợp trên không xuất hiện trong tập dữ liệu ban đầu, nhưng mô hình vẫn gán cho nó xác suất khác 0, do đó nó vẫn có thể được mô hình tạo ra. Do đó, các mô hình Naive Bayesian có thể tìm hiểu một số cấu trúc từ dữ liệu và sử dụng nó để tạo ra các ví dụ mới chưa từng thấy trong tập dữ liệu gốc. Hình dưới là hình ảnh 10 collocation thời trang mới do người mẫu sáng tạo.
danh hiệu cấp một
tiêu đề phụ
4.1 Dữ liệu chiều cao
Với tư cách là giám đốc thời trang, bạn đã tạo thành công 10 collocation thời trang mới với Naive Bayesian. Bạn rất tự tin rằng mô hình của mình là bất khả chiến bại cho đến khi bạn gặp phải tập dữ liệu sau.
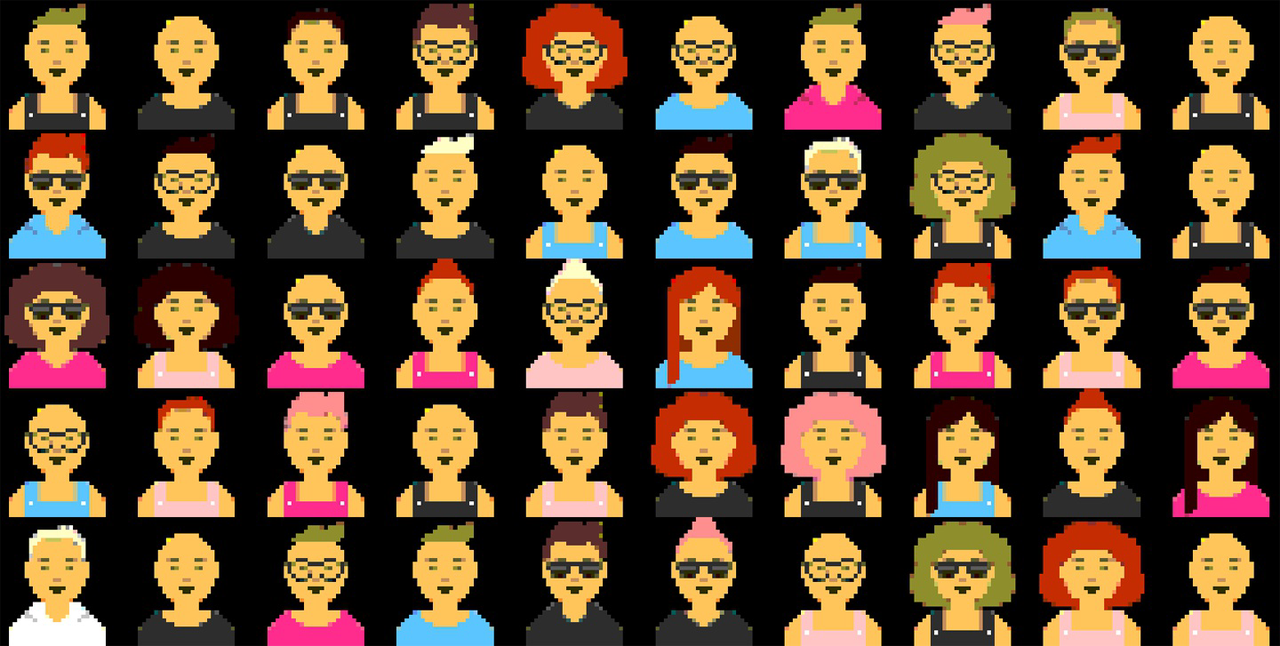
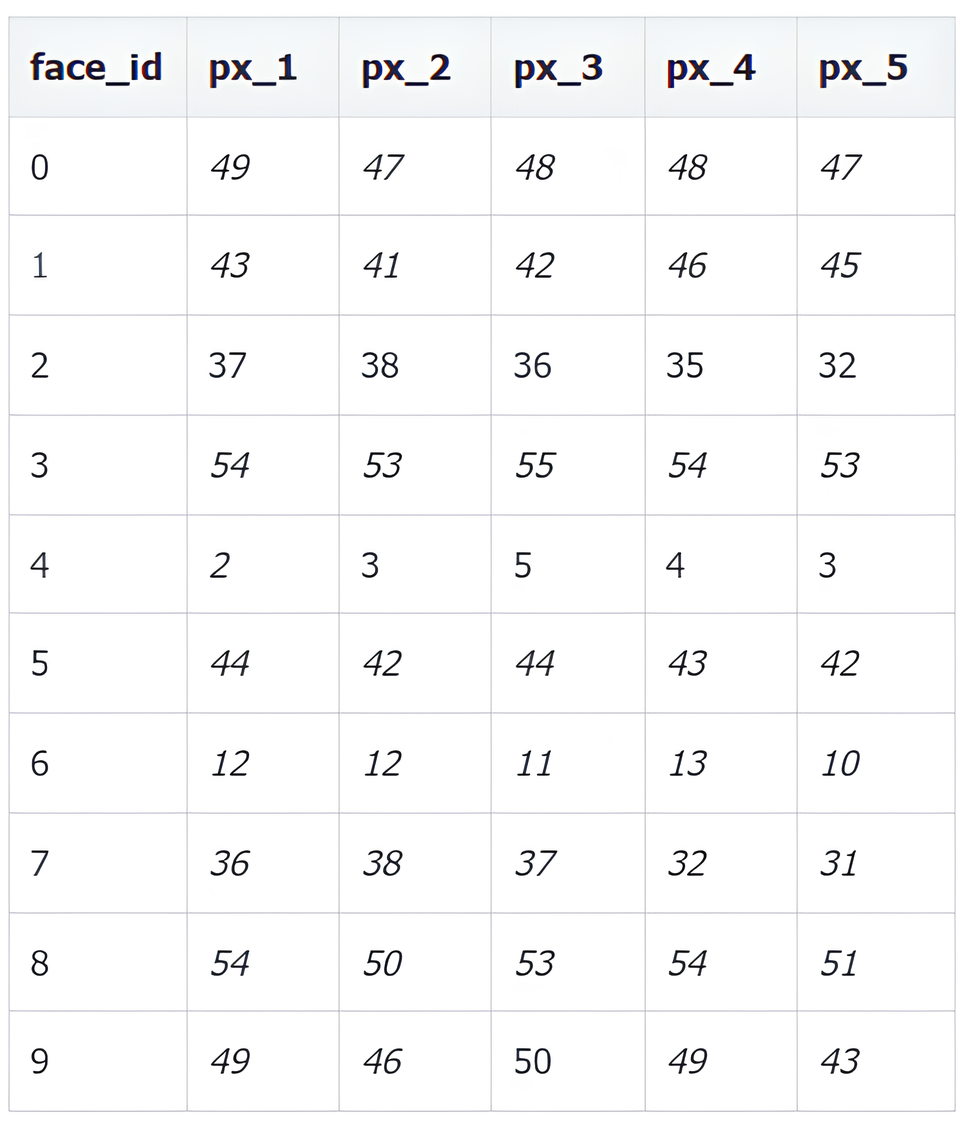
Tập dữ liệu không còn được biểu thị bằng 5 đối tượng mà được biểu thị bằng 32*32 = 1024 pixel, mỗi giá trị pixel có thể là một trong số từ 0 đến 255, 0 có nghĩa là màu trắng và 255 có nghĩa là màu đen. Bảng sau liệt kê các giá trị pixel từ 1 đến 5 cho 10 ảnh đầu tiên.
Sử dụng cùng một mô hình để tạo ra 10 bộ sắp xếp thời trang hoàn toàn mới. Sau đây là kết quả của việc tạo mô hình, mỗi bộ đều xấu và giống nhau, không thể phân biệt được các đặc điểm khác nhau. Tại sao lại như vậy?
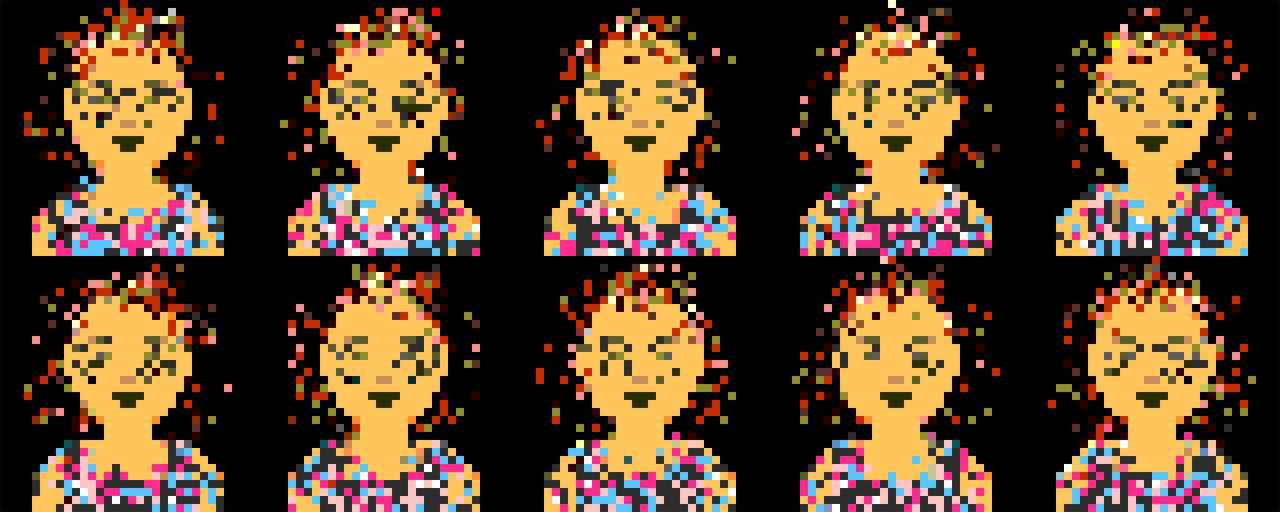
Trước hết, do mô hình Naive Bayesian lấy mẫu các pixel một cách độc lập nên các pixel liền kề thực sự rất giống nhau. Trên thực tế, đối với quần áo, các pixel sẽ gần giống nhau nhưng mẫu được lấy mẫu ngẫu nhiên nên quần áo trong hình trên đều có nhiều màu sắc. Thứ hai, có quá nhiều khả năng trong không gian mẫu nhiều chiều mà chỉ một phần trong số đó có thể nhận dạng được. Nếu một mô hình Naive Bayesian xử lý trực tiếp các giá trị pixel có mối tương quan cao như vậy thì khả năng nó tìm thấy sự kết hợp các giá trị thỏa đáng là rất nhỏ.
Tóm lại, đối với các không gian mẫu có kích thước thấp và độ tương quan của các đặc điểm thấp, hiệu ứng Naive Bayesian rất tốt thông qua lấy mẫu độc lập; nhưng đối với các không gian mẫu có kích thước cao và độ tương quan cao của các đặc điểm, các pixel lấy mẫu độc lập được sử dụng để tìm ra các khuôn mặt con người hiệu quả. gần như không thể.
Ví dụ này nêu bật hai khó khăn mà các mô hình tổng quát phải vượt qua để thành công:
Mô hình xử lý các phụ thuộc có điều kiện giữa các đối tượng nhiều chiều như thế nào?
Làm thế nào để mô hình tìm thấy tỷ lệ rất nhỏ các quan sát thỏa mãn điều kiện trong không gian mẫu nhiều chiều?
Để các mô hình tổng quát thành công trong không gian mẫu có chiều cao và có mối tương quan cao, các mô hình học sâu phải được sử dụng. Chúng ta cần một mô hình có thể suy ra các cấu trúc liên quan từ dữ liệu, thay vì được cho biết trước những giả định nào cần đưa ra. Học sâu có thể hình thành các đặc điểm riêng của nó trong không gian ít chiều, và đây làhọc biểu diễntiêu đề phụ
4.2 Học cách biểu diễn
Học biểu diễn là tìm hiểu ý nghĩa của việc biểu diễn dữ liệu nhiều chiều.
Giả sử bạn đi gặp một cư dân mạng chưa từng gặp mặt và có rất nhiều người không tìm thấy cô ấy ở điểm hẹn nên bạn gọi cho cô ấy để mô tả ngoại hình của mình. Tôi tin rằng bạn sẽ không nói rằng màu của pixel 1 trong ảnh của bạn là đen, màu của pixel 2 là đen nhạt, màu của pixel 3 là xám, v.v. Ngược lại, bạn sẽ cho rằng cư dân mạng sẽ có sự hiểu biết chung về ngoại hình của người bình thường, sau đó đưa ra sự hiểu biết này để mô tả đặc điểm của nhóm pixel, ví dụ: bạn có mái tóc ngắn màu đen và đẹp, đeo một đôi kính vàng và như vậy. Thông thường, với không quá 10 mô tả như vậy, một cư dân mạng có thể tạo ra hình ảnh của bạn từ trong tâm trí, hình ảnh có thể thô nhưng không ngăn cản cư dân mạng tìm thấy bạn giữa hàng trăm người, ngay cả khi cô ấy chưa bao giờ nhìn thấy bạn.
Đây là ý tưởng cốt lõi đằng sau việc học biểu diễn mà không cần cố gắng trực tiếpkhông gian mẫu có chiều cao(không gian mẫu chiều cao) để mô hình hóa, nhưng sử dụng một sốkhông gian tiềm ẩn chiều thấp(không gian ẩn chiều thấp) để mô tả từng quan sát trong tập huấn luyện và sau đó học mộtchức năng ánh xạ(chức năng ánh xạ), lấy một điểm trong không gian tiềm ẩn và ánh xạ nó tới không gian mẫu ban đầu. Nói cách khác, mỗi điểm trong không gian tiềm ẩn thể hiện một đặc điểm của dữ liệu nhiều chiều.
Nếu những từ trên không dễ hiểu, vui lòng xem tập huấn luyện bên dưới bao gồm một số hình ảnh bình thang độ xám.
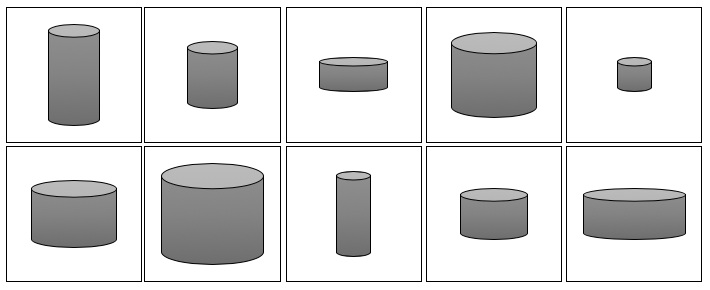
Không khó để nhận ra những chiếc lọ này chỉ có thể miêu tả bằng hai đặc điểm: chiều cao và chiều rộng. Do đó, chúng ta có thể chuyển đổi không gian pixel chiều cao của hình ảnh thành không gian tiềm ẩn hai chiều, như trong hình bên dưới. Bằng cách này, chúng ta có thể lấy mẫu từ không gian tiềm ẩn (các chấm màu xanh) và sau đó chuyển hàm ánh xạfChuyển đổi nó thành một hình ảnh.
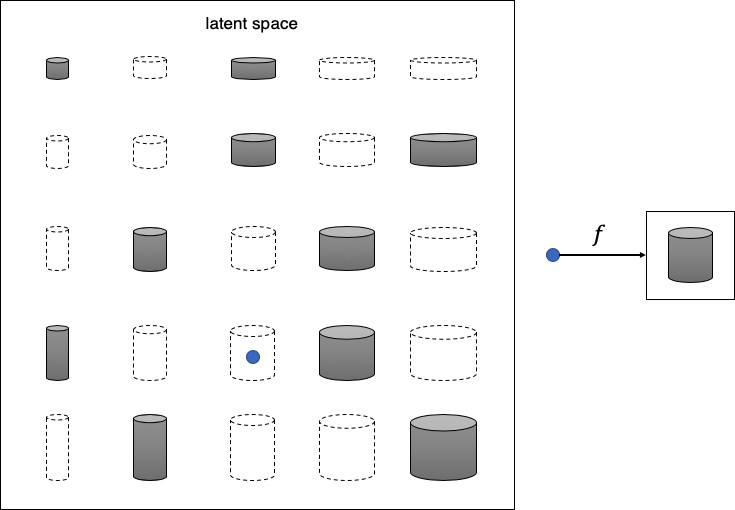
Không dễ để máy nhận ra rằng tập dữ liệu gốc có thể được biểu diễn bằng một không gian tiềm ẩn đơn giản hơn. Đầu tiên, máy cần xác định rằng chiều cao và chiều rộng là hai chiều không gian tiềm ẩn mô tả đúng nhất về tập dữ liệu, sau đó tìm hiểu chức năng ánh xạf danh hiệu cấp một
5. Phân loại mô hình sáng tạo
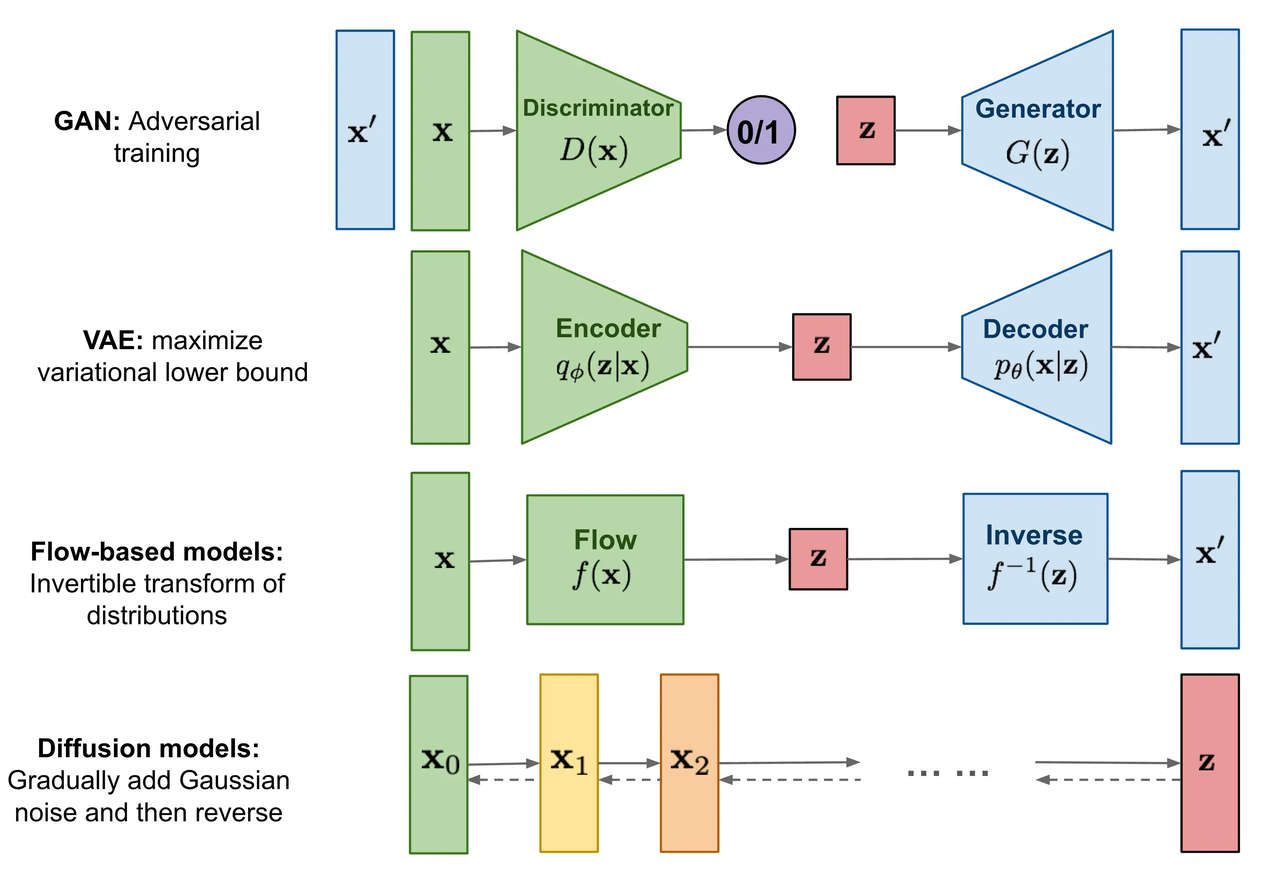
Tất cả các loại mô hình tổng quát cuối cùng đều nhằm mục đích giải quyết cùng một nhiệm vụ, nhưng chúng đều có chức năng mật độ mô hình theo những cách hơi khác nhau và thường rơi vào hai loại:
hàm mật độ cặpmô hình rõ ràng(explicitly modeling),
Nhưng bằng cách nào đó hãy hạn chế mô hình để hàm mật độ được tính toán, nhưMô hình dòng chảy chuẩn hóa(normalizing FLOW model)
Nhưng để tính gần đúng hàm mật độ, chẳng hạn nhưBộ mã hóa tự động biến đổi (variational autoencoder,VAE) vàMô hình khuếch tán (diffusion model)
hàm mật độ cặpmô hình ngầm(mô hình hóa ngầm), thông qua quy trình ngẫu nhiên trực tiếp tạo ra dữ liệu. Ví dụTóm tắt (generative adversarial network, GAN)
Tóm tắt
Trí tuệ nhân tạo sáng tạo (GenAI) là một loại trí tuệ nhân tạo có thể được sử dụng để tạo ra nội dung và ý tưởng mới, bao gồm văn bản, hình ảnh, video và âm nhạc. Giống như tất cả trí tuệ nhân tạo, GenAI là một mô hình rất lớn được đào tạo trước bằng mô hình deep learning dựa trên một lượng lớn dữ liệu, thường được gọi làmô hình cơ sở(foundation model,FM). Với GenAI, chúng ta có thể vẽ ra nhiều hình ảnh ngầu hơn, viết chữ đẹp hơn và sáng tác nhiều bản nhạc cảm động hơn, nhưng bước đầu tiên đòi hỏi chúng ta phải hiểu GenAI tạo ra những thứ mới như thế nào, như người đứng đầu bài viết Richard Feynman đã nói “Tôi sẽ không hiểu”. những gì tôi không thể tạo ra.





