


SignalPlus: Nói về Mạng lưới thần kinh sâu


lời tựa
Deep neural networks are completely flexible by design, and there really are no fixed rules when it comes to model architecture.
-- David Foster
lời tựa
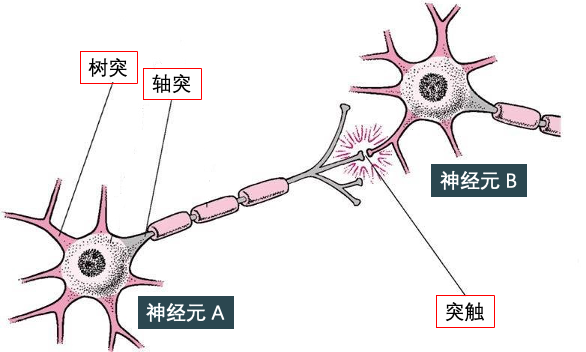
Mạng lưới thần kinh(Mạng lưới thần kinh) Lấy cảm hứng từ bộ não con người, nó có thể bắt chước các nơ-ron sinh học để truyền tín hiệu cho nhau. Mạng nơ-ron là một hệ thống bao gồm các nơ-ron. Như thể hiện trong hình dưới đây, nơ-ron có nhiềuđuôi gai(dendrite) cho đầu vào, có mộtsợi trục(sợi trục) cho đầu ra. Nó có hai tính chất chính: tính dễ bị kích thích và tính dẫn điện:
Tính dễ bị kích thích có nghĩa là khi cường độ kích thích không đạt đến một ngưỡng nhất định thì xung thần kinh sẽ không xảy ra và khi cường độ kích thích đạt đến giá trị này thì xung thần kinh sẽ xuất hiện và có thể đạt cường độ tối đa ngay lập tức.
Độ dẫn điện đề cập đến sự dẫn truyền của các tế bào thần kinh lân cận thông qua một khoảng cách nhỏ giữa chúng. Khoảng cách nhỏ này, được gọi làkhớp thần kinh(khớp thần kinh), chức năng của nó là truyền các xung thần kinh giữa các nơ-ron khác nhau và khớp thần kinh trong hình bên dưới kết nối các nơ-ron A và B với nhau.
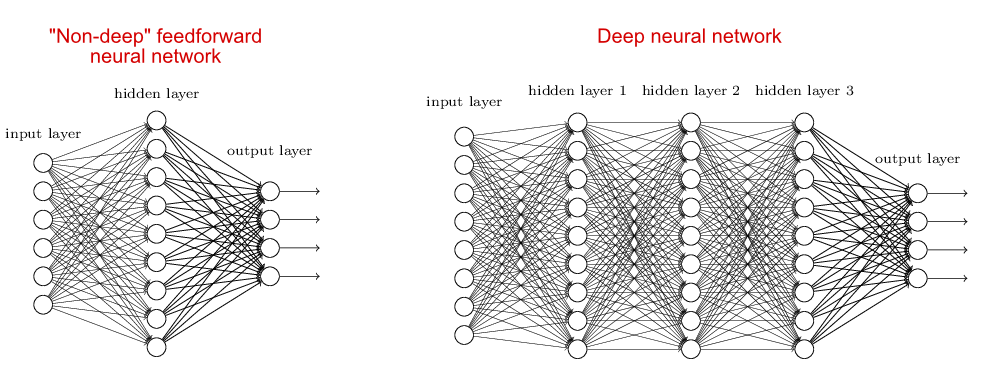
Hãy tưởng tượng rằng nhiều khớp thần kinh kết nối nhiều nơ-ron, nó không tạo thành một mạng lưới thần kinh sao? Vâng, tương tự nhưMạng lưới thần kinh nhân tạo (artificial neural network,ANN) cũng bao gồm vô số tế bào thần kinh nhân tạo, chẳng hạn như tế bào thần kinh bên trái bên dướimạng lưới thần kinh nông(mạng lưới thần kinh bóng tối) và mạng lưới thần kinh sâu (mạng lưới thần kinh sâu) ở bên phải bên dưới.
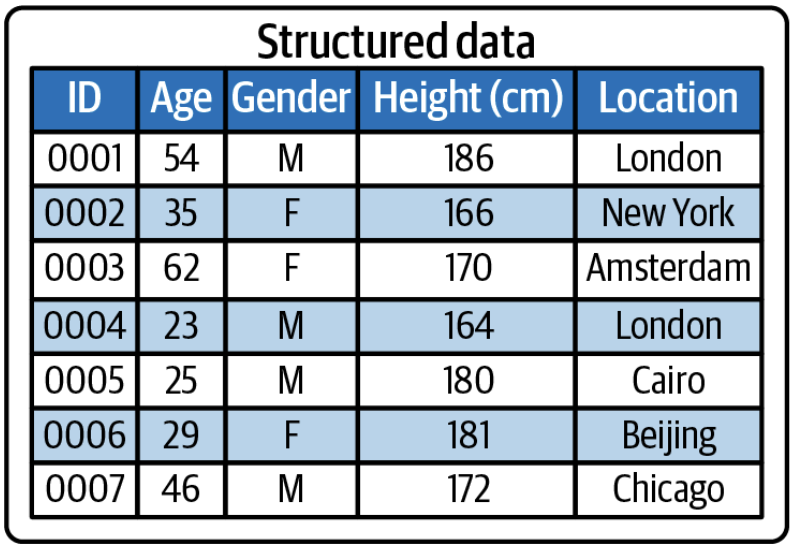
Mạng lưới thần kinh nông thích hợp choDữ liệu có cấu trúc(dữ liệu có cấu trúc), chẳng hạn như dữ liệu hai chiều được lưu trữ trong excel trong hình bên dưới.
 Mạng lưới thần kinh sâu phù hợp chodữ liệu phi cấu trúc(dữ liệu phi cấu trúc), chẳng hạn như dữ liệu hình ảnh, văn bản và giọng nói như trong hình bên dưới.
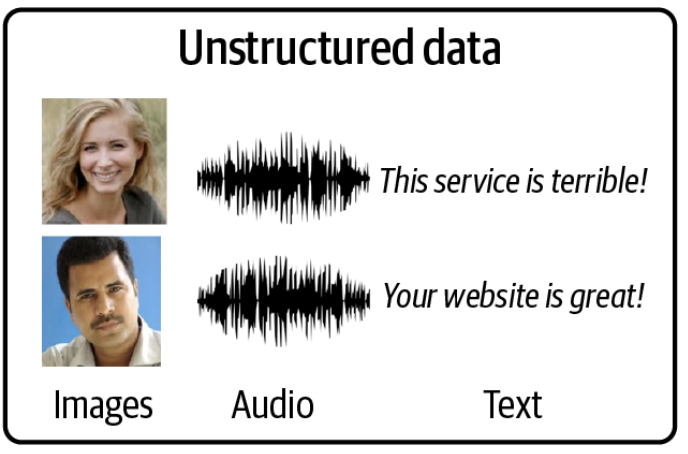
Các mô hình Gener AI chủ yếu tạo ra dữ liệu phi cấu trúc nên việc hiểu rõ về mạng lưới thần kinh sâu là cần thiết. Bắt đầu từ bài viết này, chúng ta sẽ bay mô hình và mã, bởi vì
Talk is cheap. Show me the code.
-- Linus Torvalds
danh hiệu cấp một
tiêu đề phụ
1.1 Đầu tiên hãy nhìn vào mạng lưới thần kinh
Giả sử mạng nơ-ron sau đây đã được huấn luyện và sử dụng để dự đoán xem một bức ảnh có khuôn mặt đang cười hay không.
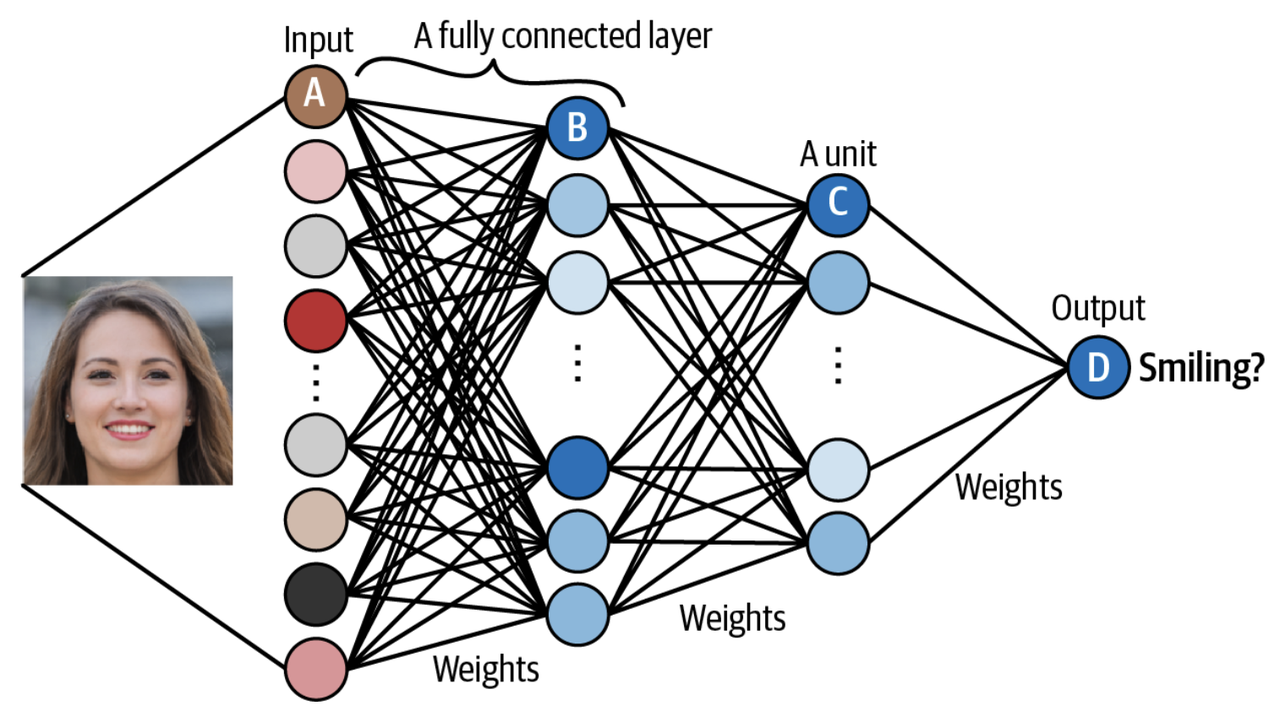
Đơn vị A nhận thông tin pixel trong ảnh.
Đơn vị B kết hợp các pixel đầu vào, khi ảnh gốc cóTính năng cấp thấp(tính năng cấp thấp) Ví dụ: khi cạnh (cạnh), tín hiệu mạnh nhất được phát ra.
Đơn vị C kết hợp các tính năng cấp thấp, khi cócác tính năng tiên tiến(tính năng cấp cao) như răng (tech), tín hiệu mạnh nhất được phát ra.
Unit D kết hợp các tính năng cấp cao mang lại tín hiệu mạnh nhất khi người trong ảnh gốc đang cười.
Khi mạng nơ-ron này được nạp đủ dữ liệu, tức là hình ảnh, nó sẽ tìm một tập hợpTrọng lượng(trọng lượng) để đưa ra dự đoán cuối cùng chính xác nhất có thể. Quá trình tìm trọng số thực sự là đào tạo mạng lưới thần kinh.
tiêu đề phụ
1.2 Quá trình đào tạo Keras
Người mẫu
Người mẫu (models)
lớp (layers),đi vào(đầu vào) vàđầu ra (output)
trình tối ưu hóa(trình tối ưu hóa) vàmất chức năng (loss)
Sử dụng các từ khóa trên để tóm tắt quá trình huấn luyện mạng nơ-ron Keras: kết hợp nhiềulớpNgười mẫuNgười mẫu,Sẽđi vàoDữ liệu được ánh xạ tới các giá trị dự đoán. Sau đómất chức nănglấy những giá trị dự đoán nàyđầu ravà so sánh với mục tiêu để lấy giá trị tổn thất (được sử dụng để đo mức độ phù hợp của giá trị dự đoán của mạng với kết quả mong đợi),trình tối ưu hóaSử dụng giá trị tổn thất này để cập nhật trọng số của mạng.
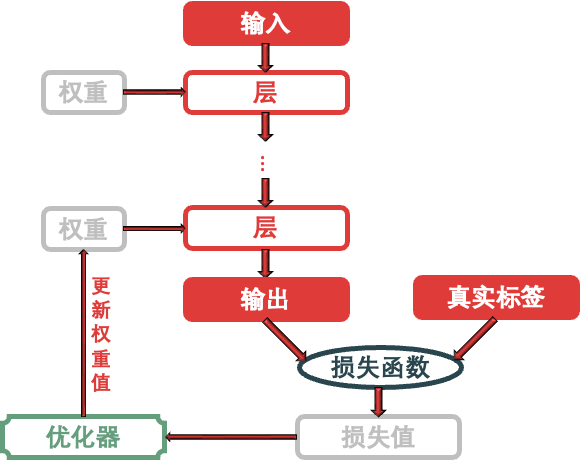
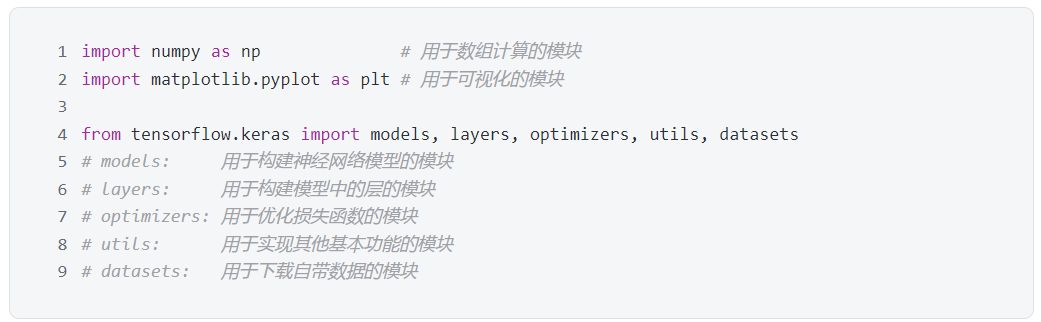
Tại thời điểm này, cuối cùng cũng có thể hiển thị một số mã, ngay cả khi thư viện công cụ được giới thiệu. Đầu tiên, mô-đun được sử dụng để xây dựng mạng lưới thần kinh từ thư viện tensorflow.keras.
tiêu đề phụ
1.3 Mạng nơ-ron tối giản
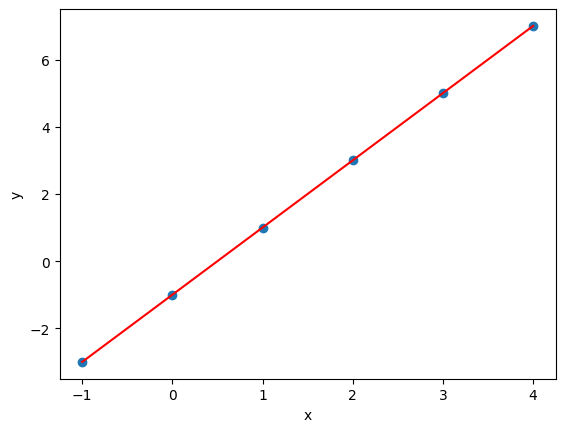
Vàx Vày Dữ liệu:
x = [-1, 0, 1, 2, 3, 4 ]
y = [-3, -1, 1, 3, 5, 7 ]
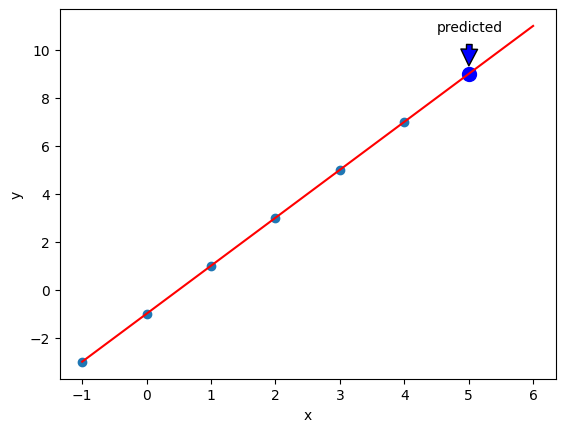
Vàx Và y Mối quan hệ giữa khi xnew= 10, hỏi ynewbao nhiêu?
Như thể hiện trong hình dưới đây,xVà yVẽ nó dưới dạng các điểm rải rác, không khó để nhận ra rằng đường màu đỏ trong hình dưới đây là xVà ytiêu đề phụ
1.3.1 Tạo mô hình
Chỉ cần sử dụng một lớp mạng nơ-ron với một nơ-ron, đoạn mã như sau:
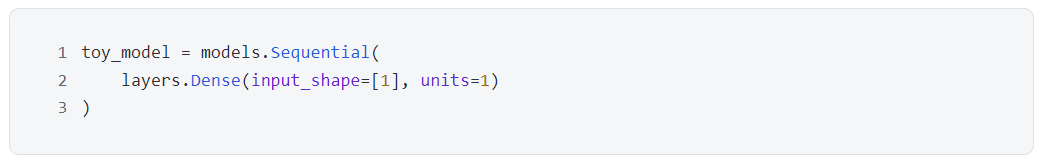
lần dùng đầu tiênmodels.Sequential() Tạo một mạng lưới thần kinh trống, sau đó tiếp tục thêm các lớp, ở đây chúng tôi đã thêmlayers.Dense()tiêu đề phụ
1.3.2 Kiểm tra mô hình
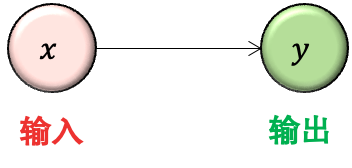
Kiểm tra thông tin model, điều lạ là số lượng tham số (Param # trong hình bên dưới) thực chất là 2 thay vì 1. Bởi vì từ hình ảnh trêny = wx, chỉ nên cówMột tham số.
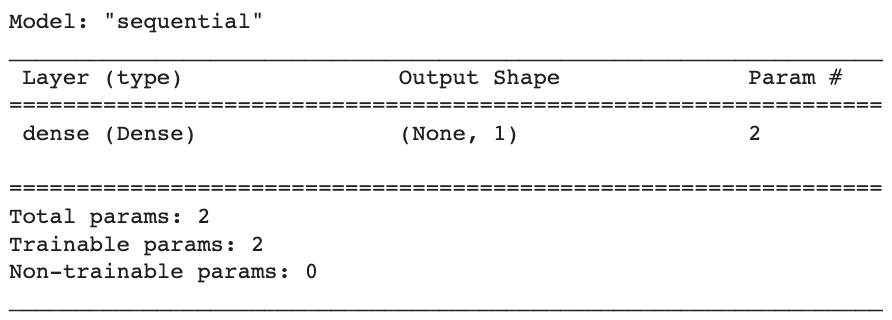
Lý do là khi tính toán số lượng tham số trong mỗi lớp, mỗi nơ-ron được kết nối với giá trị mặc định là 1.đơn vị thiên vị(đơn vị thiên vị), nên trên thực tế, hình ảnh trên trông chính xác hơn như sau:
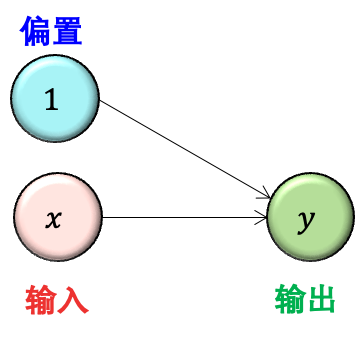
Đúng vậy, vào lúc nàyy = wx+b, vângwVà b hai tham số.
Nói đúng ra, trên thực tế Dense()Vẫn còn một tham số được gọi là kích hoạt trong hàm, nghĩa đen là hàm kích hoạt và chức năng cơ bản của nó là đểwx+b được đưa ra ở chế độ phi tuyến tính chuyển sang y. Nếu hàm kích hoạt được định nghĩa là g,Vì thếy = g(wx+b). Trong Keras, nếu bạn không chỉ định giá trị kích hoạt thì bạn không cần thực hiện bất kỳ chuyển đổi phi tuyến tính nào. Thêm khái niệm về chức năng kích hoạt, chúng tôi đưa ra một bức tranh hoàn chỉnh:
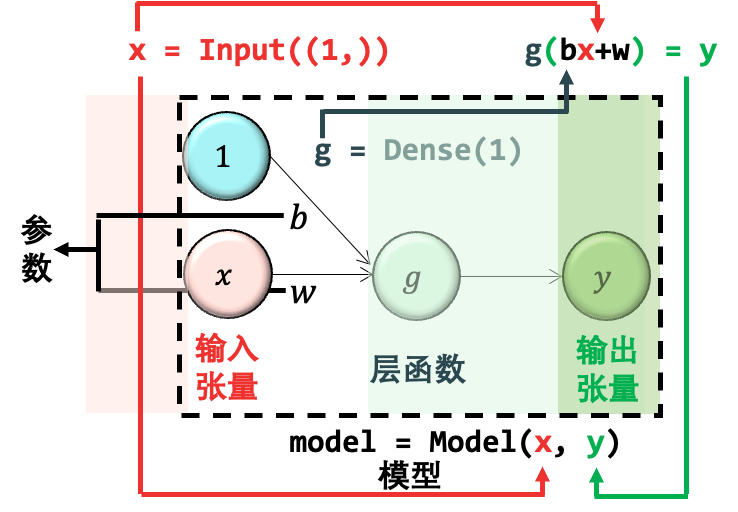
Mục tiêu của chúng ta là tìm các thông số ở hình trên, trọng sốwtiêu đề phụ
1.3.3 Biên dịch mô hình
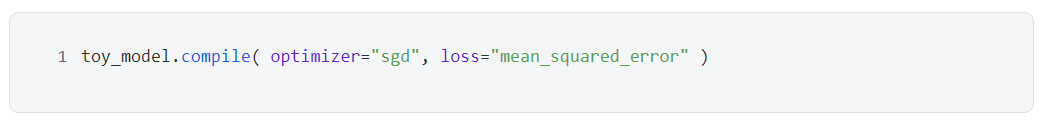
Sau khi đã thiết lập xong khung mô hình, bước tiếp theo là tối ưu hóa bài toán như saucomplie()Trình tối ưu hóa tham số cài đặt chức năng="sgd", nghĩa là chỉ định phương pháp tối ưu hóa là giảm độ dốc ngẫu nhiên và đặt tham số loss="mean_squared_error"tiêu đề phụ
1.3.4 Mô hình đào tạo
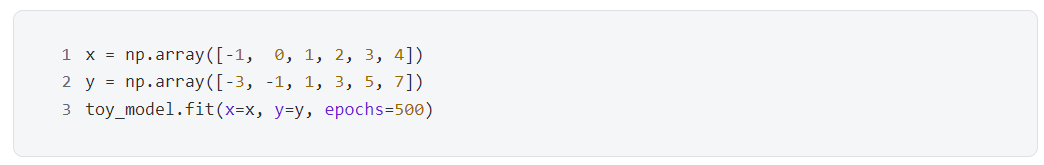
mô hình đào tạo fit()Hàm, truyền vào dữ liệu x và y. Điều đáng chú ý là tham số epochs= 500, epoch là dấu chấm trong tiếng Trung, tức là số lần thuật toán duyệt toàn bộ tập huấn luyện, đây là kết thúc quá trình huấn luyện mô hình sau khi duyệt 500 lần.
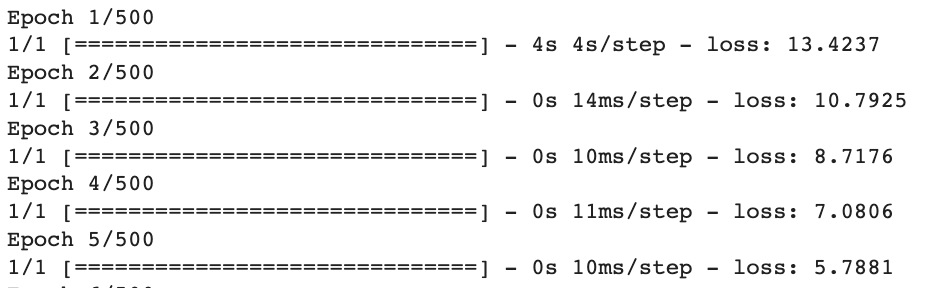
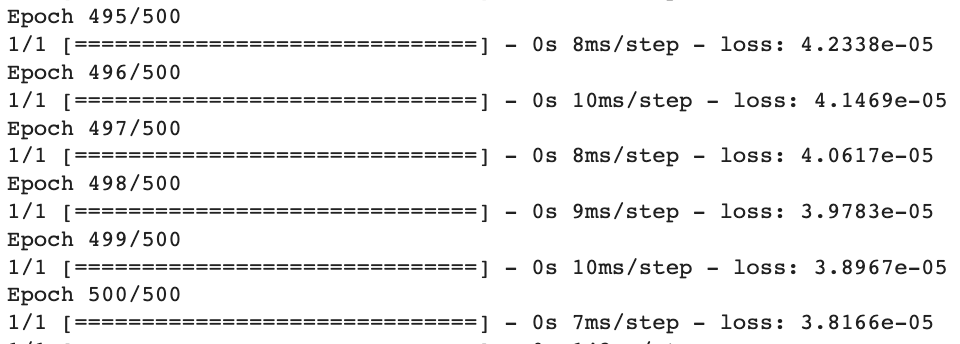
In ra thông tin của 5 tiết đầu và 5 tiết cuối, không khó để nhận ra rằng mức lỗ ở đầu là 13.4237 là rất lớn, và mức lỗ ở cuối là rất nhỏ, chỉ 3.8166 e-05, cho thấy dự đoán giá trị trong tập huấn luyện gần giống với giá trị thực.
Sau khi đào tạo mô hình, bạn có thể sử dụngget_weights() chức năng kiểm tra các thông số.
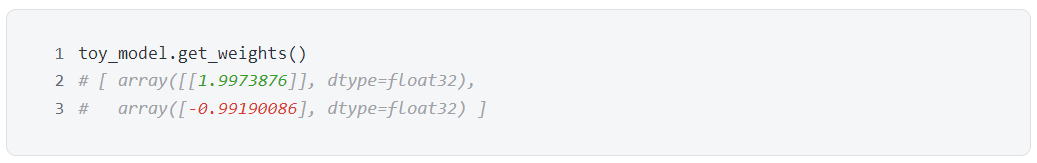 Kết quả đầu tiên trả về là trọng sốw, độ lệch thứ haibtiêu đề phụy = 1.9973876 x - 0.99190086 ≈ 2 x - 1 。
1.3.5 Mô hình đánh giá
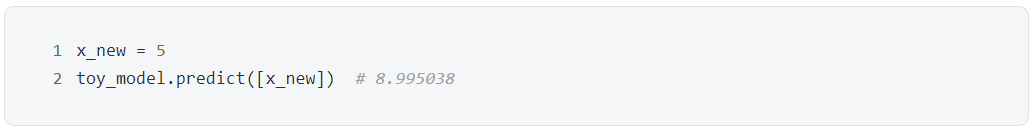
để đánh giá mô hìnhpredict() Hàm chuyển dữ liệu mới x_new vào và nhận kết quả 8,995028, rất gần với 2*x_new - 1 = 9.
Như có thể thấy trong hình bên dưới, mạng lưới thần kinh đã học mô hình (đường màu đỏ) từ 6 dữ liệu (các chấm màu lục lam đậm) và mô hình có thể được sử dụng trên dữ liệu mới (các chấm màu xanh lam).
Tóm tắt toàn bộ quá trình của mạng lưới thần kinh:
tạo mô hình:sử dụngSequential(), tất nhiên còn có những phương pháp khác tốt hơn, sẽ được thảo luận trong phần tiếp theo.
kiểm tra mô hình:sử dụngsummary()
biên dịch mô hình:sử dụngcompile()
mô hình đào tạo:sử dụngfit()
mô hình đánh giá:sử dụngpredict()
Mặc dù ví dụ này xây dựng một mạng lưới thần kinh tối giản nhưng có rất nhiều năm bước và năm bước này cũng được yêu cầu để xây dựng một mạng lưới thần kinh phức tạp. Điểm khác biệt là ở bước đầu tiên, nhiều lớp được ghép lại với nhau khi tạo mô hình, và ở bước thứ năm, một bước nâng cao hơn sẽ được chọn. Trình tối ưu hóa nhưng nó không bao giờ thay đổi. Trong hai phần tiếp theo, chúng ta hãy xem xét hai mạng thần kinh phức tạp hơn một chút, đó làphía trướcmạng lưới thần kinh phản hồi (feedforward neural network,FNN) vàdanh hiệu cấp một (convoluational neural network, CNN)。
2. Mạng thần kinh chuyển tiếp (FNN)
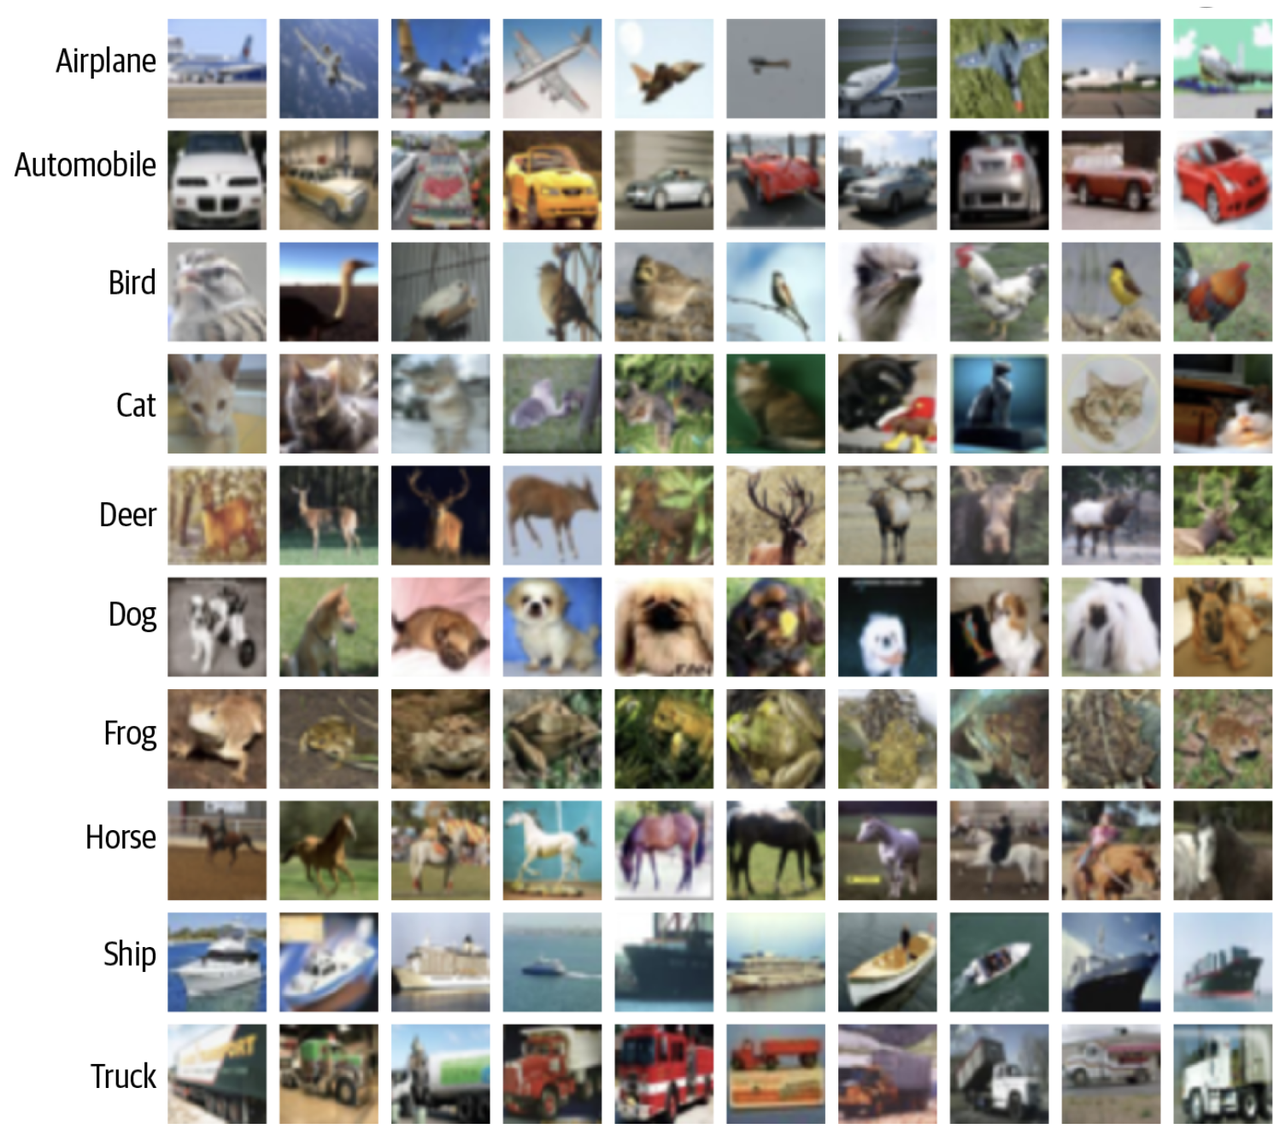
Mạng nơ-ron tối giản ở phần trước quá nhàm chán nhưng nó chủ yếu được sử dụng để làm rõ khái niệm và các bước của mạng nơ-ron trong Keras. Chúng ta hãy cùng xem mạng nơ-ron để làm một số điều thú vị và dự đoán các danh mục hình ảnh. Trước tiên hãy xem tập dữ liệu CIFAR-10 (https://www.cs.toronto.edu/~kriz/cifar.html) được sử dụng.
Bộ dữ liệu có tổng cộng 60.000 ảnh màu, các ảnh này có kích thước 32*32, chia thành 10 lớp, mỗi lớp có 6000 ảnh. Trong số này, 50.000 hình ảnh được sử dụng để đào tạo và 10.000 hình ảnh còn lại được sử dụng để thử nghiệm. Hình dưới đây là danh sách 10 danh mục và 10 hình ảnh được hiển thị ngẫu nhiên trong mỗi danh mục:
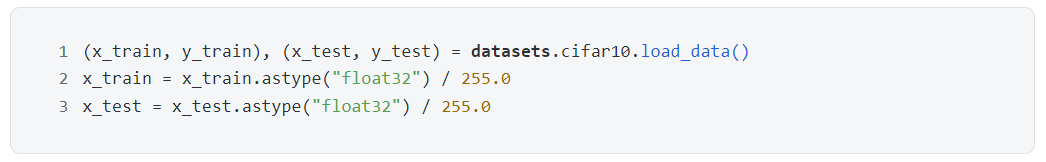
Sử dụng hàm Load_data() trong tập dữ liệu mô-đun để tải dữ liệu xuống và chuẩn hóa các pixel của hình ảnh. Các pixel ban đầu nằm trong khoảng từ 0 đến 255 và bây giờ chúng được chuẩn hóa thành từ 0 đến 1.
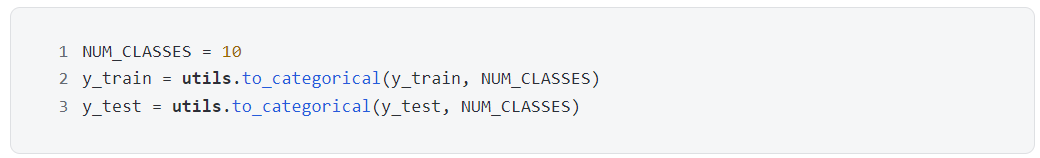
Đối với các danh mục, hãy sử dụng các chức năng trong mô-đun utilsto_categorical() Hàm thực hiện mã hóa một lần trên các danh mục. Ý tưởng là biểu diễn một số nguyên có vectơ chỉ chứa một số 1. Ví dụ: loại 5 trở thành [ 0, 0, 0, 0, 1, 0, 0, 0, 0, 0 ] sau khi mã hóa một lần và ở đó là 10 vectơ Số phần tử bằng số loại, chỉ có phần tử thứ năm của vectơ là 1 (độc nhất nóng🔥), còn lại là 0 (lạnh quá🧊).
tiêu đề phụ

tiêu đề phụ
2.1.1 Trình tự
Chúng ta đã thấy mô hình tuần tự trong phần trước, lần đầu tiên sử dụngmodels.Sequential() tạo một mạng lưới thần kinh trống và sau đó tiếp tục thêm các lớp. Trong ví dụ này có một lớp cân bằnglayers.Flatten() và ba lớp dày đặclayers.Dense()。
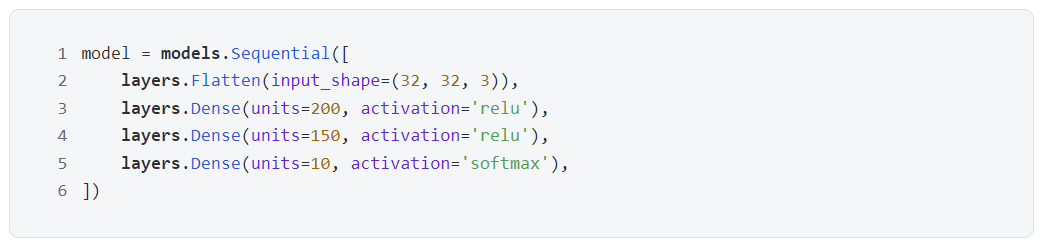
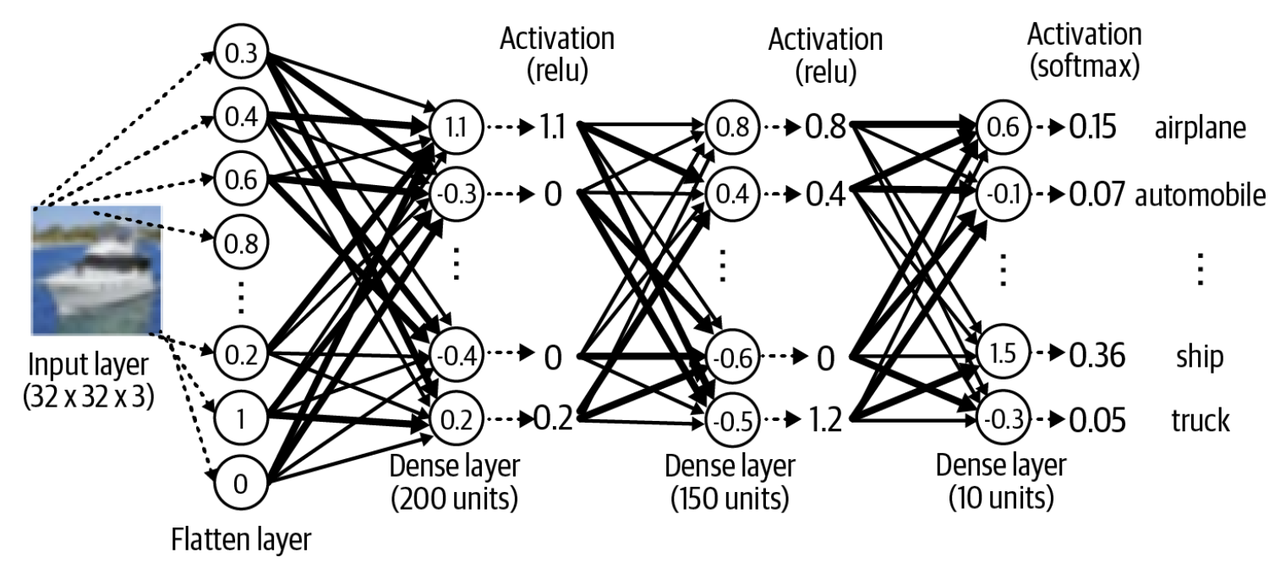
Đoạn mã trên đưa ra mô hình được hiển thị trong hình bên dưới:
Với kiến thức giác quan, chúng ta hãy nghiên cứu mật mã. Tại sao bạn cần một lớp san lấp mặt bằng? Vì hình ảnh có ba chiều là chiều rộng, chiều cao và kênh màu nên quá trình làm phẳng thành một chiều được thể hiện trong hình bên dưới.
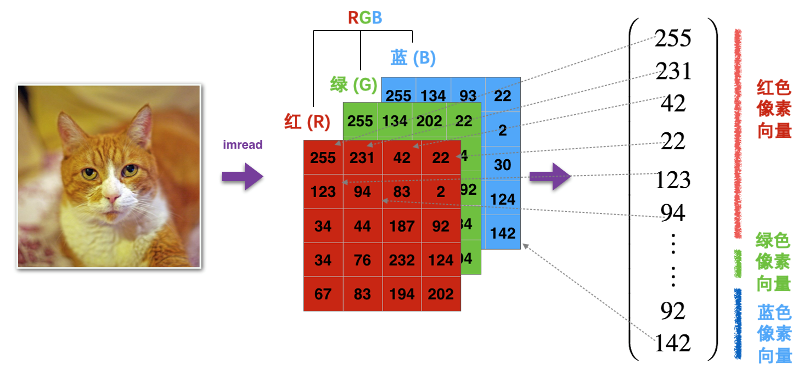
Hình ảnh gốc (32, 32, 3) được đưa vào lớp làm phẳng (chỉ định kích thước kích thước hình ảnh trong tham số input_shape), và sau khi làm phẳng, nó trở thành một vectơ 32*32*3 = 3072, có thể hình dung như sau: đầu vào hiện có 3072 nơ-ron. Sau ba lớp dày đặc
Số lượng tế bào thần kinh (đơn vị tham số) lần lượt là 200, 150 và 10. Hai số 200 và 150 đầu tiên được đưa ra một cách tình cờ hoặc được gỡ lỗi dưới dạng siêu tham số, nhưng 10 số cuối cùng phù hợp với số lượng danh mục.
Các hàm kích hoạt (kích hoạt tham số) được sử dụng lần lượt là relu, relu và softmax. Hai relu đầu tiên gần như là tiêu chuẩn, nhưng softmax cuối cùng có liên quan đến nhiệm vụ. Nếu là vấn đề đa phân loại, hãy sử dụng softmax.
chungchức năng kích hoạt(chức năng kích hoạt) như hình dưới đây:
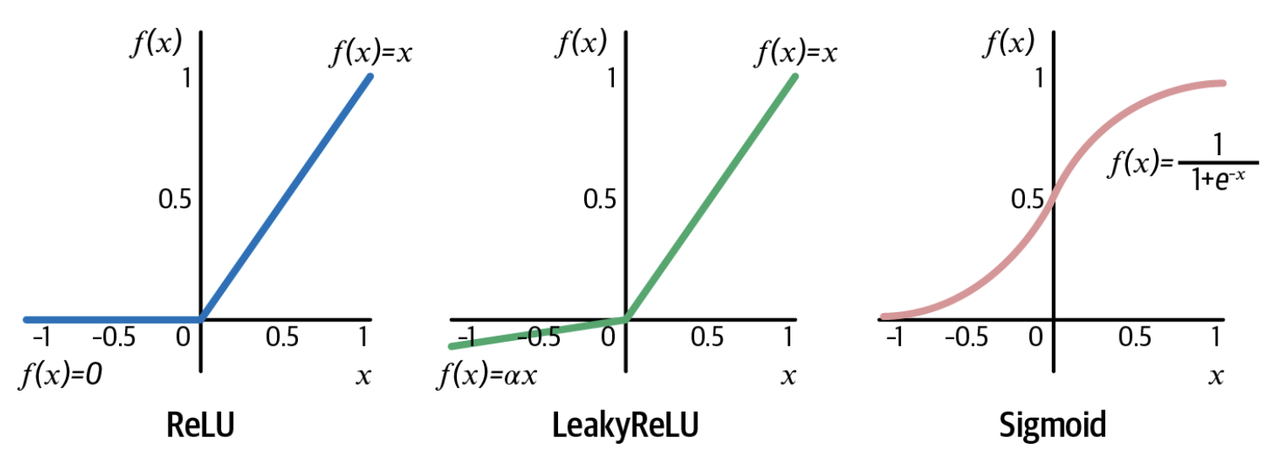
ReLU chuyển đổi đầu vào âm (x < 0) thành 0 và đầu vào dương (x > 0) không thay đổi. LeakyReLU rất giống với ReLU, điểm khác biệt duy nhất là đối với đầu vào âm (x< 0), kết quả của việc chuyển đổi cũng là số âm (ax) so với đầu vào.
Sigmoid Chuyển đổi một số thực thành một số trong khoảng 0-1 và số này có thể được coi là một xác suất, vì vậySigmoid chức năng cho các vấn đề phân loại nhị phân, phiên bản mở rộng của nóSoftmaxtiêu đề phụ
2.1.2 Phong cách chức năng
Trong thực tế, chúng ta quen với việc sử dụngchức năng(chức năng) mô hình hóa. Các mô hình được xây dựng tuần tự có thể được hoàn thiện bằng các phương pháp chức năng và ngược lại, nếu chọn một trong hai thì chỉ nên sử dụng các phương pháp chức năng để xây dựng mô hình. mã hiển thị như dưới đây:
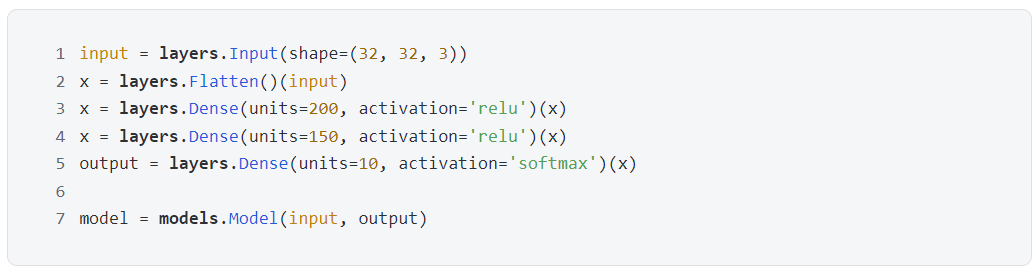
Mô hình chức năng chỉ cần nhớ một câu:sử dụng các lớp làm chức năng. Với câu này trong đầu, mã có thể được hiểu trong vài giây.
Dòng 1, với Input() Nhận dữ liệu hình ảnh.
Dòng 2, đặtFlatten() như một chức năngf, việc đơn giản hóa không phải là x = f(input)
Ở dòng 3, đặtDense(units= 200,kích hoạt='relu') dưới dạng một hàmg, việc đơn giản hóa không phải là x = g(x)
Dòng 4, đặtDense(units= 150,kích hoạt='relu') dưới dạng một hàmh, việc đơn giản hóa không phải là x = h(x)
Dòng 5, đặtDense(units= 10,kích hoạt='softmax') dưới dạng một hàmq, sự đơn giản hóa không xuất ra = q(x)
Các hàm từng lớp như vậy chuyển đầu vào thành đầu ra, đầu ra = q(h(g(f(input)))) và cuối cùng sử dụngmodels.tiêu đề phụ
2.2 Kiểm tra mô hình
Sau khi mô hình được tạo và trước khi sử dụng, tốt nhất nên kiểm tra xem hình dạng dữ liệu của từng lớp của mạng thần kinh có chính xác hay không bằng cách sử dụngsummary() có thể giúp bạn in ra những thông tin đó.
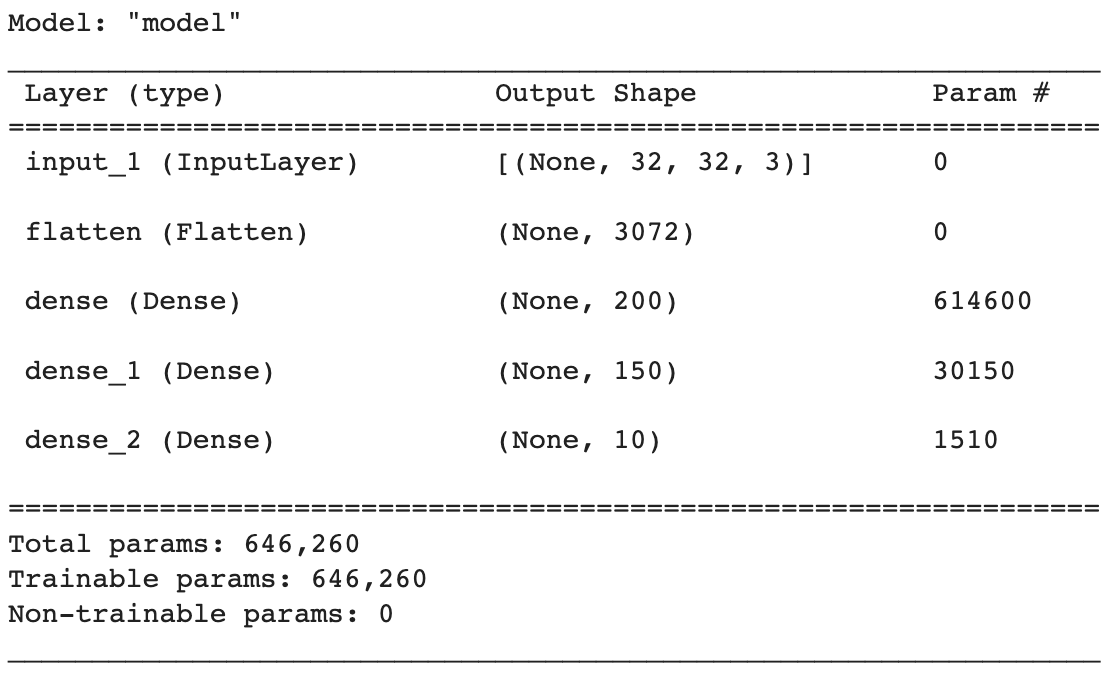
Mô hình được tự động đặt tên là “model”, theo sau là bảng mô tả loại tên (layer (type)), hình dạng đầu ra (Output Shape) và số lượng tham số (Param #) của mỗi lớp. Chúng ta hãy nhìn vào nó từng lớp một
Lớp inputLayer được đặt tên là input_ 1 và hình dạng đầu ra là [None, 32, 32, 3 ]. Ba phần tử cuối cùng tương ứng với chiều rộng, chiều cao và kênh màu của hình ảnh. Phần tử None đầu tiên thực sự đại diện cho số lượng mẫu. Nói đúng hơn Nói một cách dễ hiểu thì đó là Số lượng mẫu trong một đợt. Để mã ngắn gọn, số mẫu này thường không cần phải viết rõ ràng khi lập mô hình.
Lớp Flatten được đặt tên là Flatten, 3072 là số 32*32*3 sau khi làm phẳng và số lượng tham số là 0, vì làm phẳng chỉ là để định hình lại mảng và không cần tham số nào để hoàn thành hành động định hình lại.
Lớp dày đặc đầu tiên được đặt tên là dày đặc, hình dạng đầu ra là 200, tham số 614, 600 = (3072 + 1) * 200, đừng quên đơn vị sai lệch.
Lớp dày đặc thứ hai được đặt tên là dầy đặc_1, hình dạng đầu ra là 150, các tham số 30, 150 = (200 + 1) * 150, cũng được coi là đơn vị sai lệch.
Lớp dày đặc thứ ba được đặt tên là dầy đặc_2, hình dạng đầu ra là 10, tham số 1, 510 = (150 + 1) * 10, cũng được coi là đơn vị sai lệch.
Phía dưới cũng liệt kê các thông số tổng (Total params)646, 260 , số lượng tham số có thể huấn luyện (Trainable params)646, 260 , số lượng tham số không thể huấn luyện được (Thông số không thể huấn luyện)0 tiêu đề phụ
2.3 Biên dịch mô hình
Khi mô hình được xây dựng, sau đó bạn cần biên dịch mô hình, bạn cần đặt ba điểm:
Chọn hàm loss theo nhiệm vụ cần giải quyết
Chọn trình tối ưu hóa lý tưởng
Chọn số liệu bạn muốn theo dõi
Biên dịch mô hình vớicomplie() hiện hữu
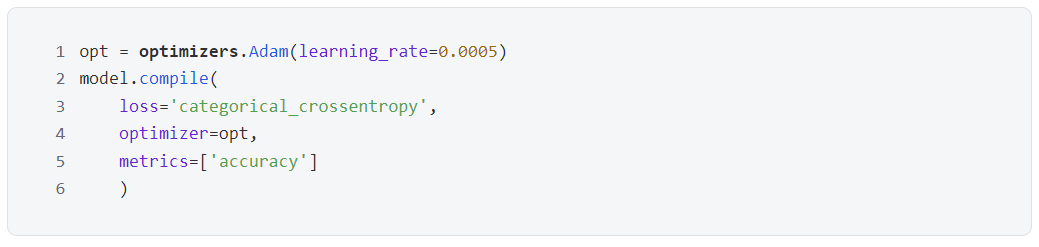
hiện hữucomplie()Trong chức năng:
Đối với việc mất tham số, ví dụ này là một vấn đề rất đẳng cấp, do đó, hàm mất mát được sử dụng là categorical_crossentropy, ngoài ra:
Hai vấn đề phân loại: hàm mất là nhị phân_crossentropy
Vấn đề hồi quy: hàm mất là Mean_squared_error
Đối với trình tối ưu hóa tham số, việc sử dụng trình tối ưu hóa adam và rmsprop với tốc độ học tập mặc định của chúng là an toàn trong hầu hết các trường hợp. Khi thiết lập tham số này, nó cũng có thể được gọi bằng cách sử dụng tên và khởi tạo đối tượng.
tên: 'sgd'
Đối tượng: trình tối ưu hóa.Adam(learning_rate= 0,0005)
Đối với các số liệu tham số, nó cũng có thể được gọi bằng cách sử dụng tên và khởi tạo đối tượng. Trong ví dụ này, chỉ báo là độ chính xác, vì vậy nó có thể được viết là
tên: ['chính xác']
Đối tượng: [metrics.categorical_accuracy]
tiêu đề phụ
2.4 Mô hình đào tạo
Mô hình đào tạo không gộp tất cả dữ liệu lại với nhau mà ném theo từng đợt. Trước khi giới thiệu mô hình đào tạo, cần làm rõ một số khái niệm:
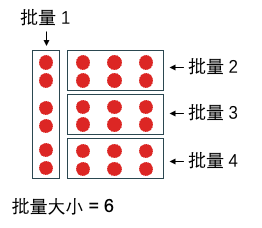
kích thước lô(kích thước lô) đề cập đến số lượng mẫu trong một lô. Tổng cộng có 24 dữ liệu trong ví dụ sau, nếu có 6 dữ liệu trong mỗi đợt thì tổng văn phòng có thể chia thành 4 đợt.
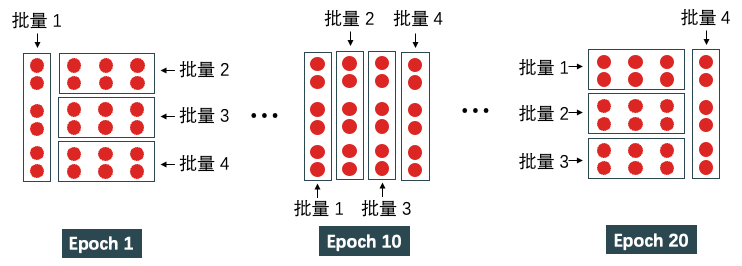
Trông chờ(epoch) có nghĩa là toàn bộ tập huấn luyện được duyệt qua một lần bởi thuật toán. Khi kỷ nguyên được đặt thành 20 thì toàn bộ tập huấn luyện cần được duyệt qua 20 lần theo nhiều cách khác nhau. Một epoch cần trải qua 4 lần lặp để duyệt toàn bộ tập dữ liệu, tức là tổng số mẫu/kích thước batch = 24/6 lần lặp. Quá trình chạy 20 kỷ nguyên được thể hiện trong hình bên dưới.
mô hình đào tạofit()chức năng, mã như sau:
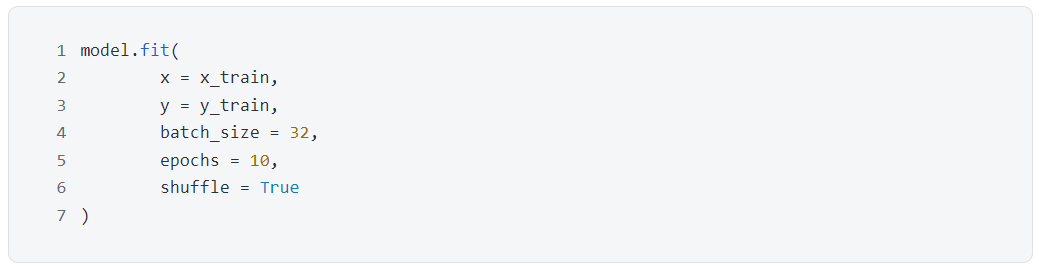
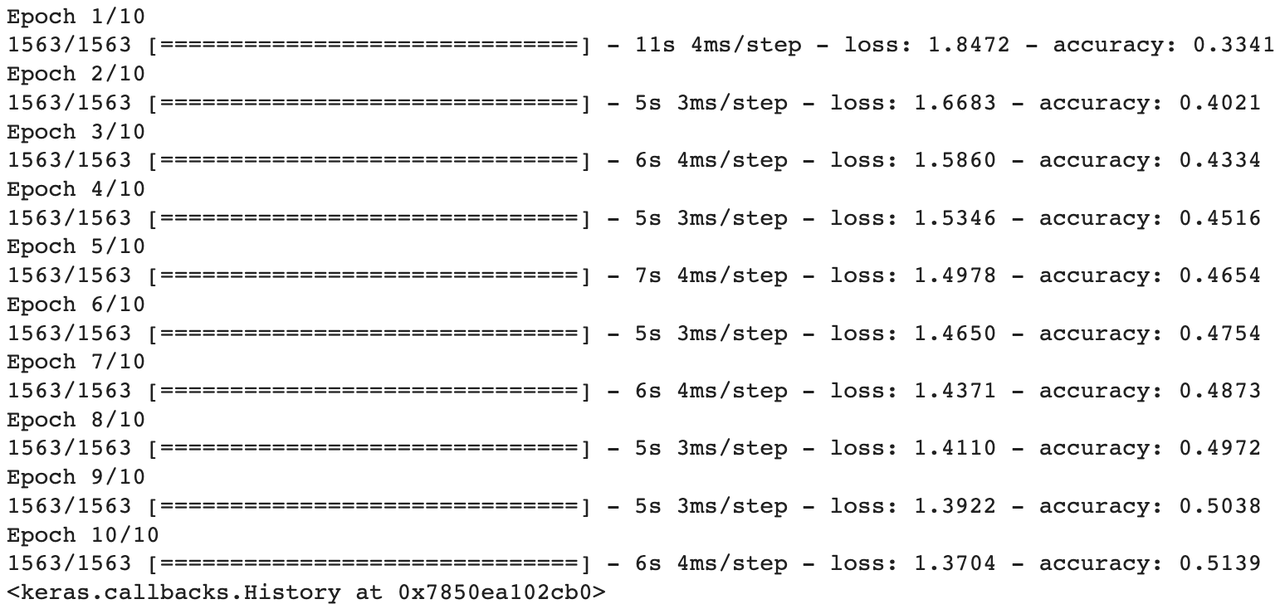
Hình trên thể hiện các bước huấn luyện, không khó nhận thấy tập huấn luyện được chia thành 1563 cọc, mỗi cọc chứa 32 ảnh (kích thước batch). Sau 10 kỷ nguyên,mất chức năng(entropy chéo phân loại) giảm từ 1,8472 xuống 1,3696, trong khiSự chính xác(độ chính xác) tăng từ 33,41% lên 51.39% . Mô hình có thể truy cập được trên tập huấn luyện51.39% tiêu đề phụ
2.5 Mô hình đánh giá
sử dụngevaluate()Chức năng trực tiếp phụ thuộc vào tỷ lệ chính xác.
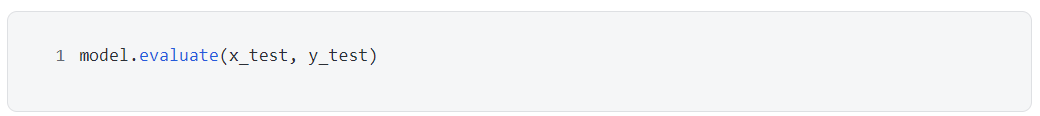
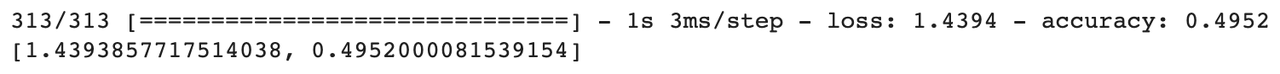
Độ chính xác của mô hình trên tập kiểm tra là49.52% , cao hơn nhiều so với độ chính xác 10% của việc dự đoán ngẫu nhiên một danh mục (vì có mười danh mục). Vì chúng tôi sử dụng mạng thần kinh chuyển tiếp nguồn cấp dữ liệu rất đơn giản như vậy để dự đoán các danh mục hình ảnh,49.52% Tỷ lệ chính xác đã được coi là một kết quả tốt.
sử dụngpredict()Hàm so sánh các lớp được dự đoán và đúng.
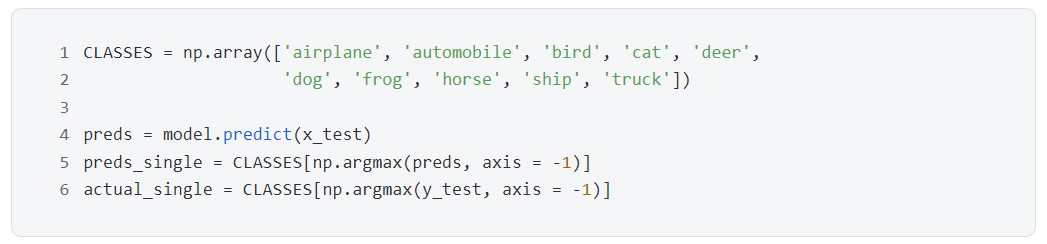
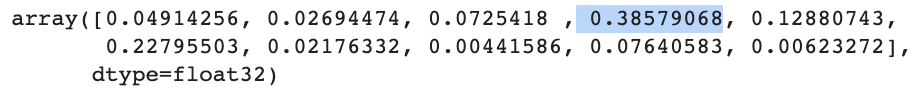
Có 10.000 ảnh trong bộ kiểm tra và có 10 danh mục, vì vậy preds là một mảng [ 10000, 10 ] và mỗi hàng là xác suất của 10 danh mục được mô hình dự đoán cho ảnh tương ứng. cộng lên 1 . Hãy xem dự đoán cho hình ảnh đầu tiên trong bộ thử nghiệm:
y_test cũng là một mảng [10000, 10], mỗi hàng là thể loại thực sự của ảnh tương ứng nên 10 phần tử có 9 số 0 và 1 phần tử. Nhìn vào danh mục thực sự của hình ảnh đầu tiên trong bộ thử nghiệm:
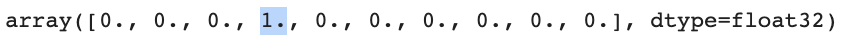
Không khó để nhận thấy xác suất thuộc loại bốn trong kết quả dự đoán preds[0,:] là cao nhất 0,38579068 và xác suất thuộc loại thực test[0.:] là loại bốn (yếu tố thứ tư là một). Sử dụng np.argmax để tìm chỉ mục tương ứng với giá trị lớn nhất từ kết quả dự đoán preds[0,:] và danh mục thực test[0.:], đồng thời ánh xạ mô tả danh mục từ LỚP.
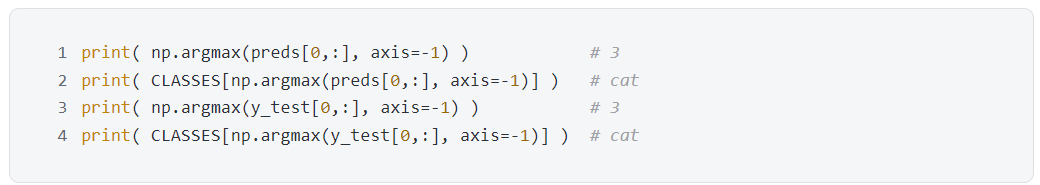
Hình ảnh đầu tiên trong bộ thử nghiệm là một con mèo và mô hình dự đoán về một con mèo nên đúng như vậy!
Hãy thử lại lần thứ tư.
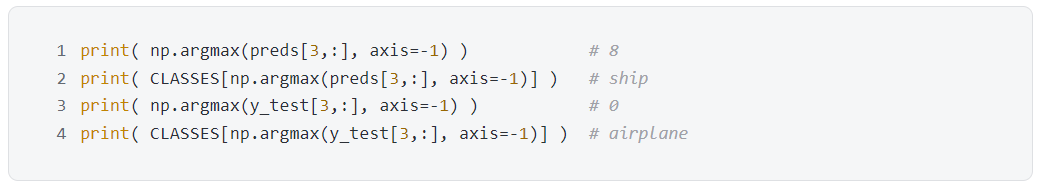
Bức tranh thứ tư trong bộ thử nghiệm là một con tàu, nhưng mô hình đã dự đoán về một chiếc máy bay, điều này là sai!
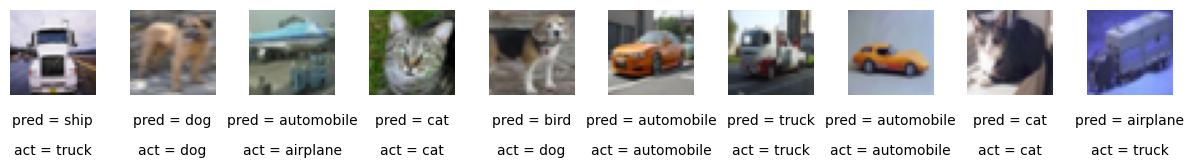
Hình dung: Phương pháp so sánh ở trên quá cồng kềnh, chúng ta có thể chọn ngẫu nhiên 10 ảnh từ bộ thử nghiệm, in ra từng ảnh rồi dán danh mục dự đoán mô hình và danh mục thực của nó vào dưới ảnh.
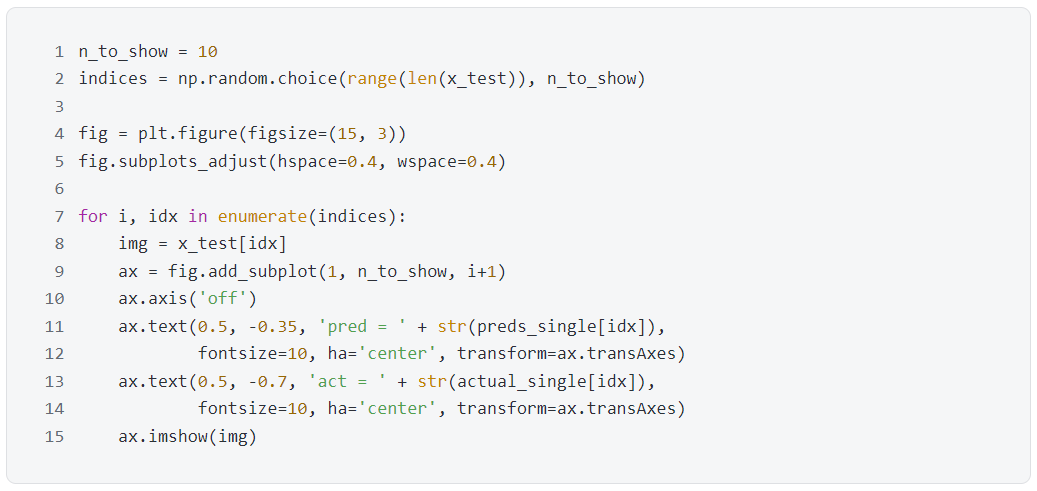
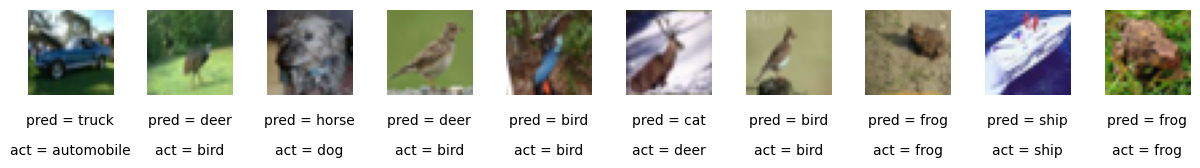
Có thể thấy từ 10 bức ảnh nhỏ trên, mô hình dự đoán đúng 5 trong số đó, với tỷ lệ đúng là 50%, phù hợp với thống kê trước đó là 49,52%. Mặc dù đây chỉ là mô hình phân biệt để dự đoán nhưng nội dung được giới thiệu trong phần này (như lớp, chức năng kích hoạt, trình tối ưu hóa, v.v.) vẫn được áp dụng khi chúng ta tạo mô hình tổng quát.
danh hiệu cấp một
3. Mạng thần kinh chuyển đổi (CNN)
tiêu đề phụ
3.1 Khái niệm cơ bản
Giả sử trong bóng tối xuất hiện một bức tranh khổng lồ trước mặt bạn và bạn không thể nhìn thấy nó như một chiếc ô tô trong bóng tối mà chỉ có thể dùng đèn pin quét từng chút một và chiếu những thứ bạn nhìn thấy mỗi lần lên hình ảnh đó. lớp tiếp theo, vân vân. Ví dụ: bạn có thể thấy một số đường ngang, đường dọc và dấu gạch chéo trên lớp đầu tiên, một số hình tròn và hình vuông trên lớp thứ hai, bánh xe, cửa và thân xe ở lớp thứ ba và một chiếc ô tô ở lớp thứ tư. Bằng cách này, bạn có thể sử dụng đèn pin để phát hiện chiếc ô tô trong ảnh trong bóng tối.
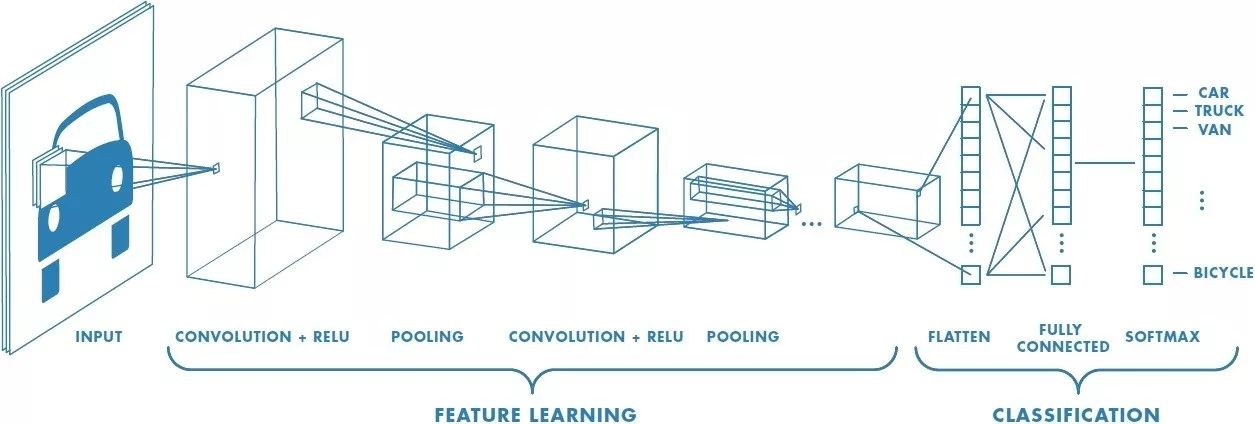
Ví dụ trên thực chất là một quá trình nhận dạng hình ảnh bằng mạng nơ ron tích chập. Trước tiên, hãy làm rõ một số định nghĩa:
lọc(bộ lọc): Vuốt theo chiều rộng và chiều cao của dữ liệu đầu vào, kết hợp với dữ liệu đầu vào, giống như đèn pin trong ví dụ trên.
tích chập(tích chập): Định nghĩa ở đây là nhân tất cả pixel của bộ lọc với pixel của bộ lọc quét hình ảnh và cộng lại.
cỡ bước chân(sải bước): Kích thước bước của bộ lọc khi duyệt ảnh, giá trị mặc định là 1, tức là bộ lọc di chuyển từng pixel một.
đổ đầy(padding): Đôi khi dữ liệu đầu vào được điền bằng 0 ở cạnh, có thể kiểm soát kích thước của dữ liệu đầu ra (cách sử dụng phổ biến nhất là giữ cho kích thước của dữ liệu đầu ra phù hợp với dữ liệu đầu vào).
tích chập
Tất nhiên, tính năng lớn nhất của mạng nơ ron tích chập là hoạt động tích chập. Nhìn lại định nghĩa trên, hãy nhân pixel của bộ lọc với pixel của hình ảnh được bộ lọc quét rồi cộng chúng lại, xem hai ví dụ sau, giả sử kích thước của bộ lọc là 3*3.
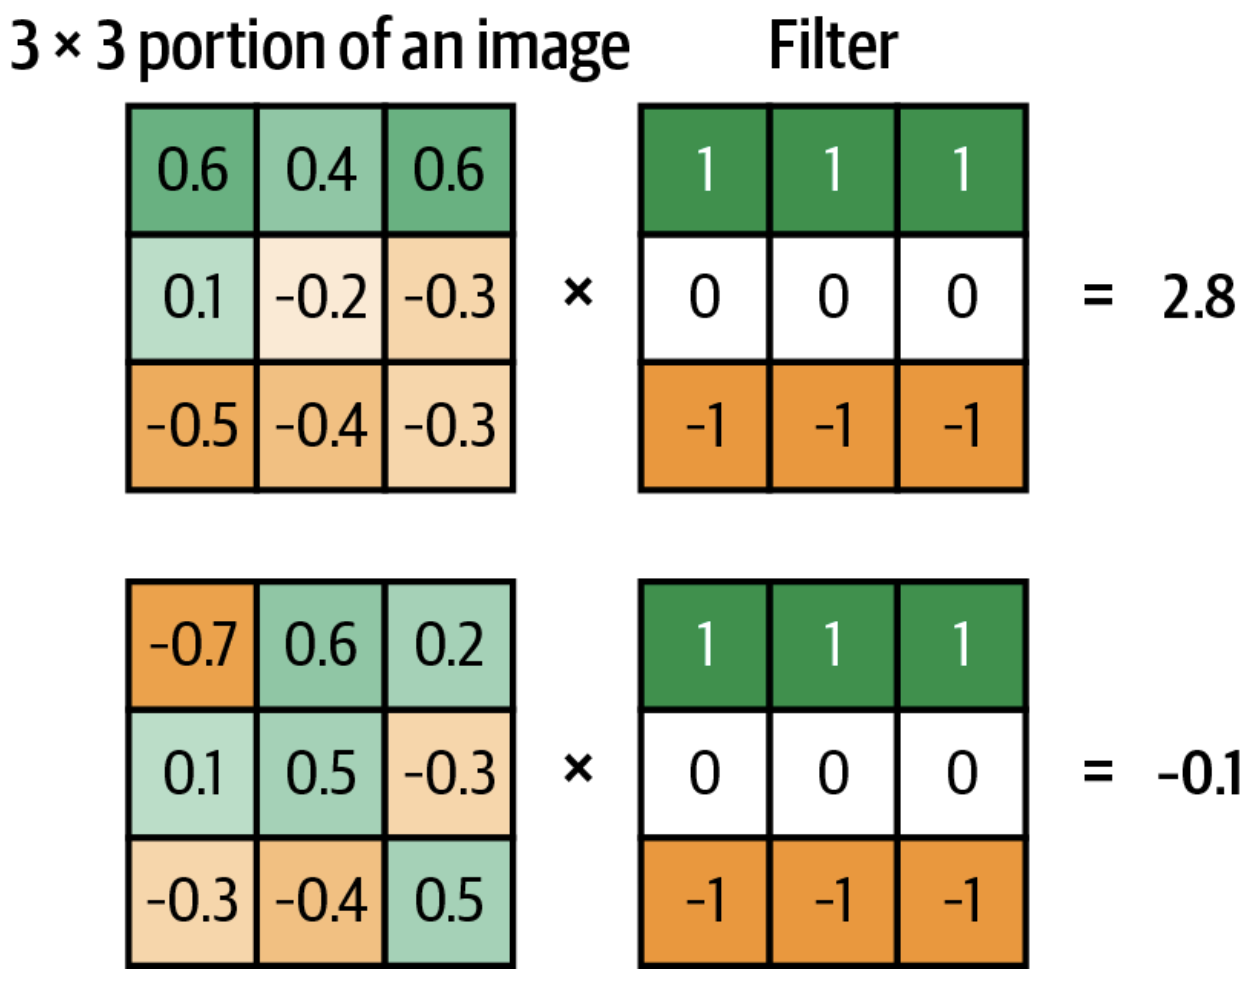
Độ chập của hình ảnh đầu tiên và bộ lọc là 0,6*1 + 0,4*1 + 0,6*1 + 0,1*0 + (-0,2)*0 + (-0,3)*0 + (-0,5)*(-1) + (-0,4)*(-1) + (-0,3)*(-1) =2.8 。
Độ chập của hình ảnh thứ hai và bộ lọc là (-0,7)* 1 + 0,6* 1 + 0,2* 1 + 0,1* 0 + 0,5* 0 + (-0,3)* 0 + (-0,3)*(-1) + (-0,4)*(-1) + 0,5*(-1) =-0.1 。
Khi giá trị tích chập lớn hơnchỉ, cho biết bộ lọc và hình ảnh phù hợp hơncuộc thi đấu; Khi giá trị tích chập cao hơngánh nặng, cho biết bộ lọc và hình ảnh phù hợp hơnkhông phù hợp với. Giá trị tích chập của hình ảnh đầu tiên và bộ lọc trong ví dụ trên là2.8 , cả haicuộc thi đấu; Giá trị tích chập của hình ảnh thứ hai và bộ lọc là-0.1 , cả haikhông phù hợp với。
Lọc
Chức năng của bộ lọc là lọc, tức là lọc ra một số thông tin, tương đương với việc trích xuất thông tin được giữ lại. Đoạn mã sau tạo hai bộ lọc có kích thước 3*3, bộ lọc 1 có thể trích xuất các đường ngang trong ảnh và bộ lọc 2 có thể trích xuất các đường dọc trong ảnh. Lưu ý ở đây rằng 1 tượng trưng cho màu đen, 0 tượng trưng cho màu xám và -1 tượng trưng cho màu trắng.
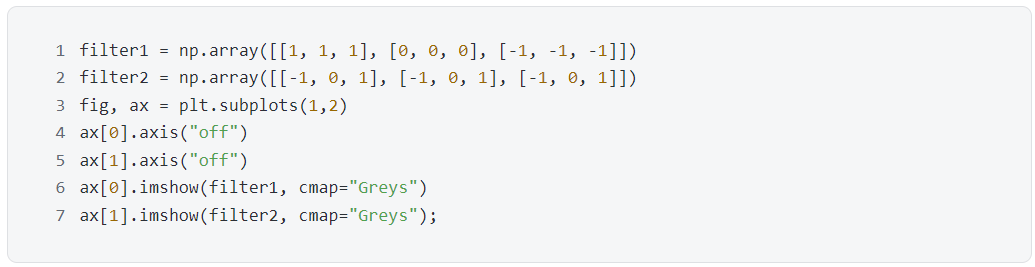
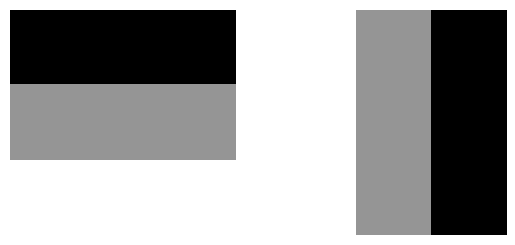
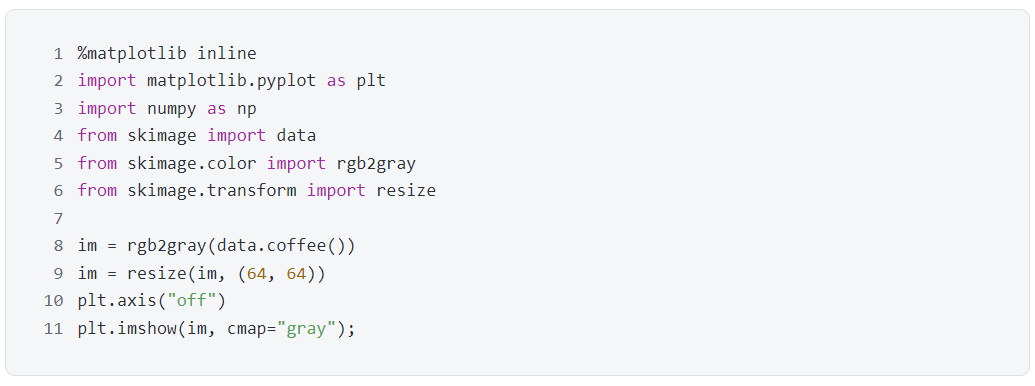
Cùng xem cách sử dụng 2 bộ lọc này để trích xuất thông tin nhé, hình ảnh gốc như sau:
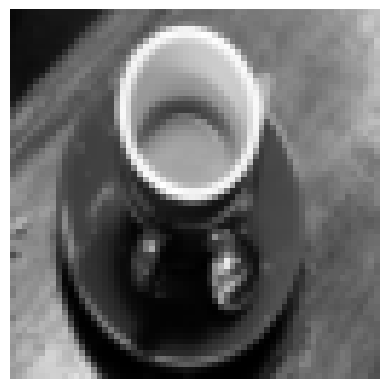
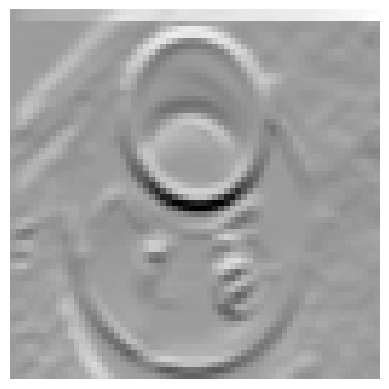
Không khó để nhận thấy rằng bộ lọc 1 có trích xuất thông tin cạnh ngang từ hình ảnh, chẳng hạn như cạnh trên và dưới của miệng cốc.
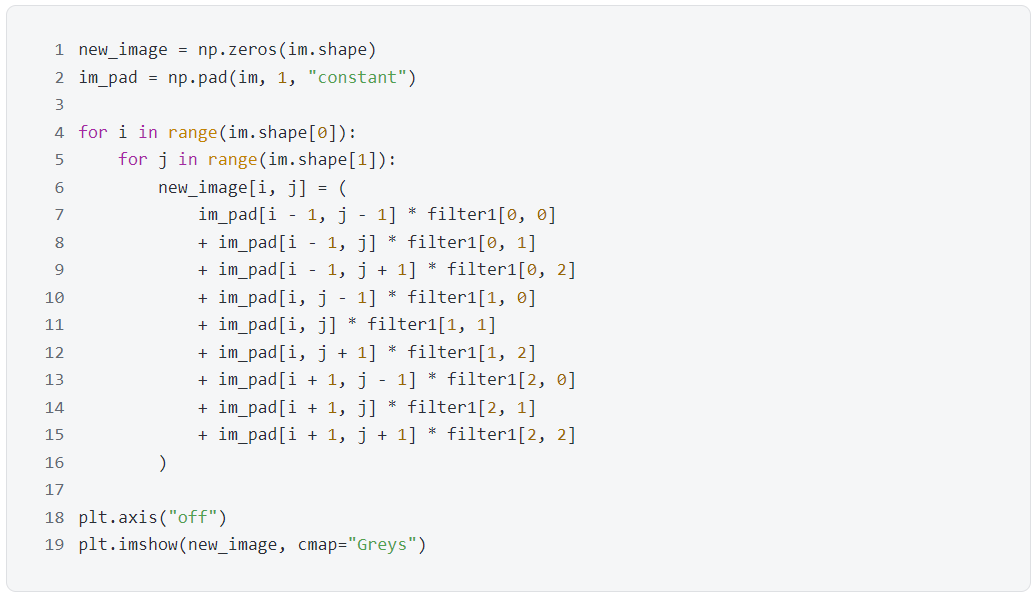
Không khó để nhận thấy rằng bộ lọc 2 có trích xuất thông tin cạnh dọc từ hình ảnh, chẳng hạn như cạnh trái và phải của miệng cốc.
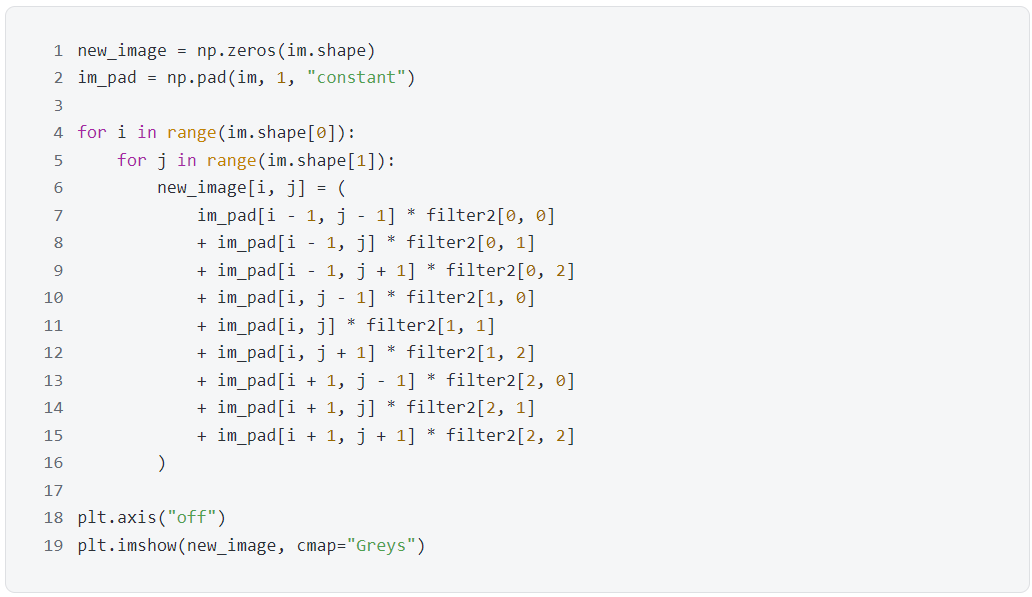
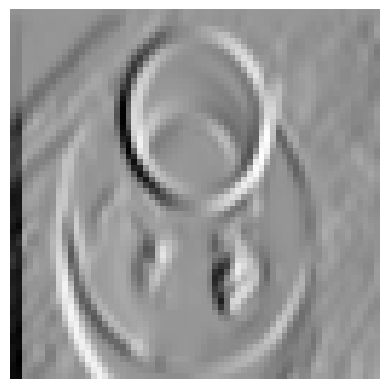
Với việc bổ sung các bộ lọc, chúng ta có thể tạolớp chập(lớp chập). Lớp tích chập về cơ bản là một tập hợp các bộ lọc. Trong ví dụ bên dưới, số lượng là 2 và các giá trị phần tử trong bộ lọc được gọi là trọng số, được học bằng cách huấn luyện CNN.
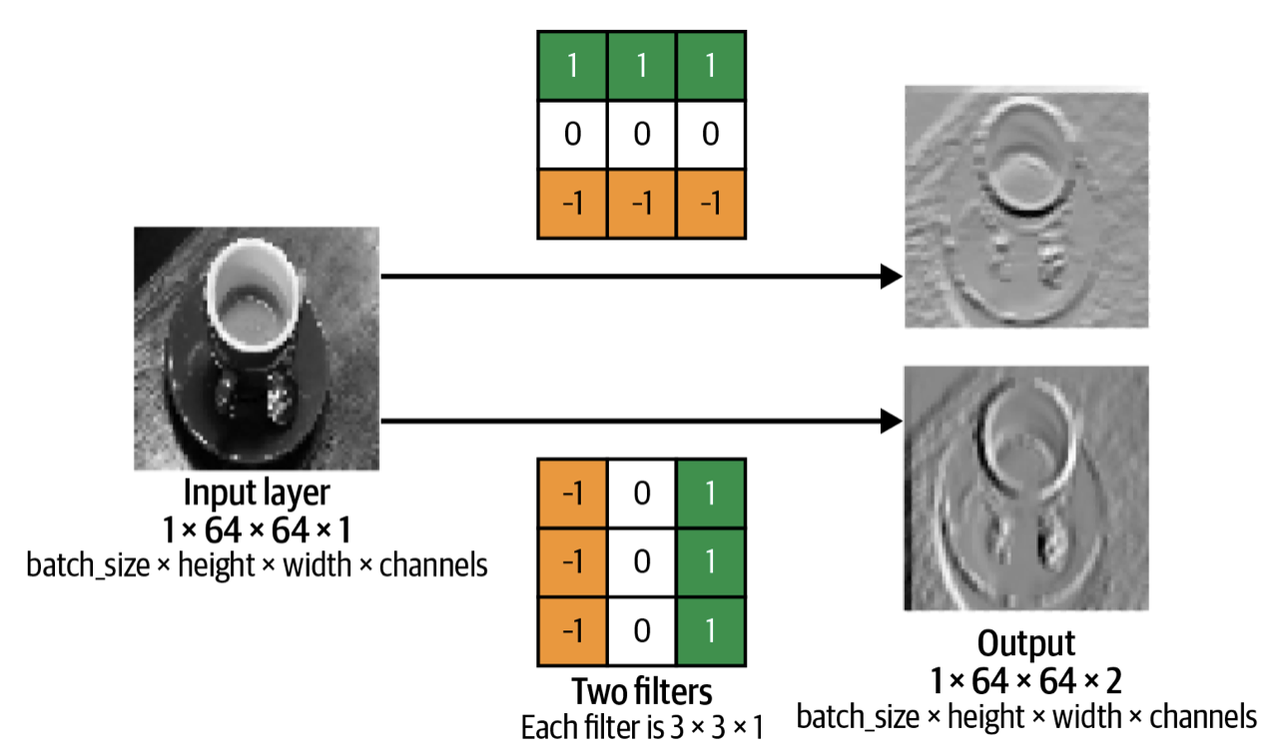
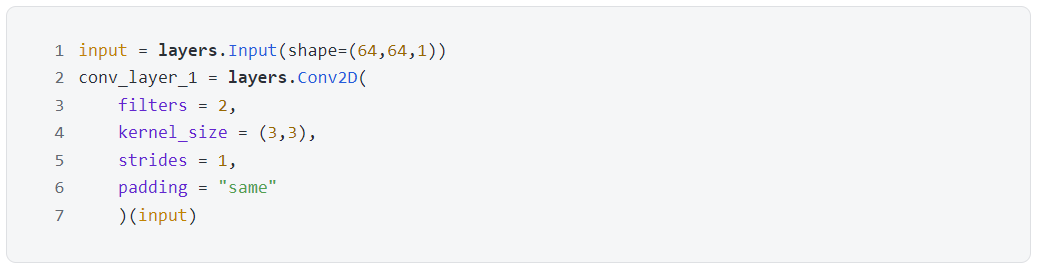
Được sử dụng trong Keraslayers.Con v 2 D() để tạo lớp chập. Ở đây ảnh đen trắng có kích thước 64*64*1 (chỉ có 1 kênh màu) và có hai bộ lọc (tham số bộ lọc được đặt thành 2) và kích thước bộ lọc là 3*3 (tham số kernel_size được đặt đến (3, 3)).
Hai tham số sải chân và phần đệm là gì?
Độ dài bước
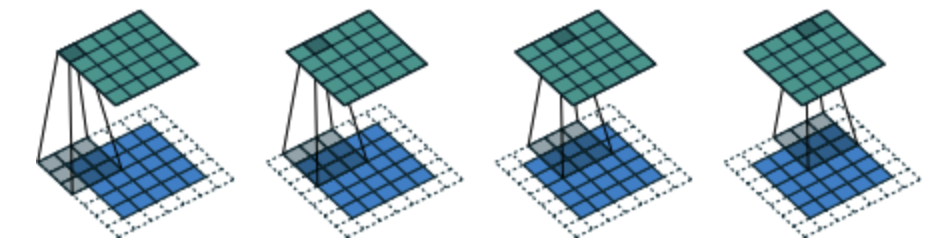
Kích thước bước là số pixel mà bộ lọc di chuyển khi duyệt qua hình ảnh. Giá trị mặc định là 1, có nghĩa là bộ lọc di chuyển từng pixel một. Khi sải chân là 2, không khó để tưởng tượng rằng kích thước hình ảnh đầu ra chỉ bằng một nửa kích thước của hình ảnh đầu vào.
Phần đệm
Đệm, như tên cho thấy, là thêm các phần tử xung quanh hình ảnh. khi đệm ="same"Khi, với sải bước = 1, nó có thể đảm bảo rằng hình ảnh đầu ra có cùng kích thước với hình ảnh đầu vào. Kích thước hình ảnh đầu vào trong hình bên dưới là 5*5 (ảnh màu xanh), sau khi điền, kích thước hình ảnh trở thành 7*7 (ảnh trắng), kích thước bộ lọc là 3*3 (màu xám) và kích thước hình ảnh đầu ra vẫn là 5 *5 (hình màu xanh lá cây).
tiêu đề phụ
3.2 Các lớp chập được nối
Đầu tiên hãy nhìn vào một đoạn mã:
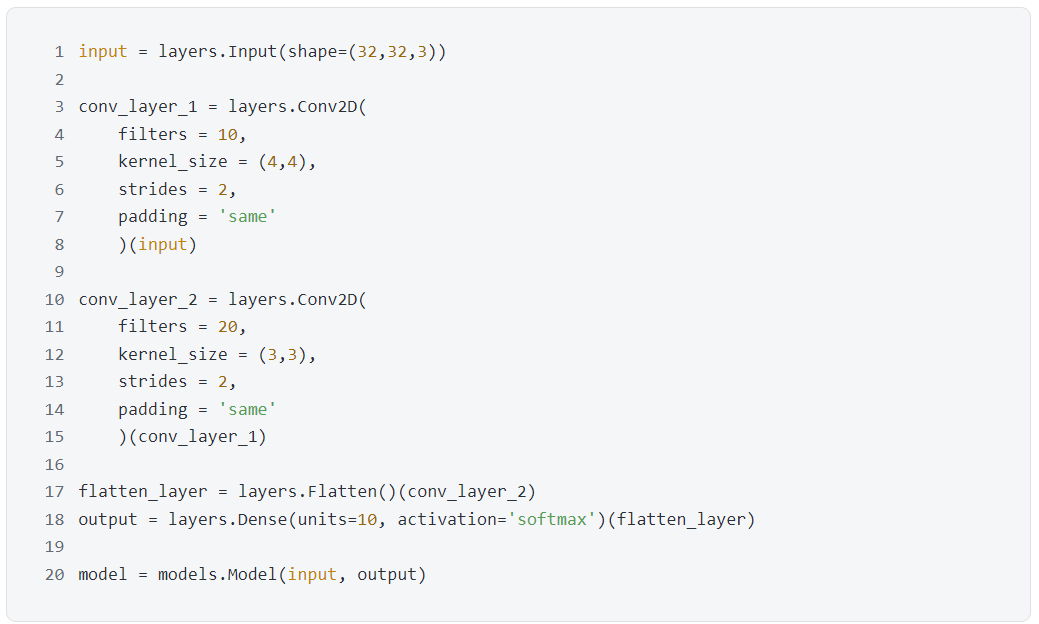
Đoạn mã trên tương ứng với hình ảnh bên dưới.
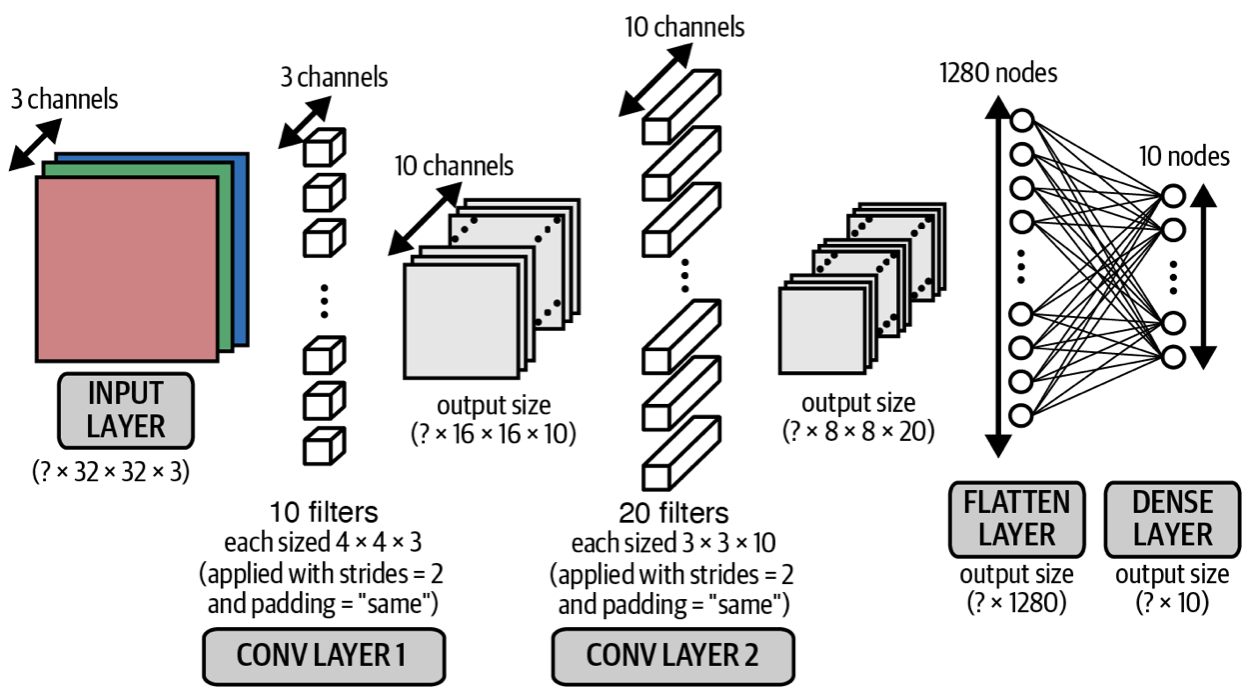
Kích thước đầu ra của mỗi lớp chập ở trên là rất lớn. Nếu bạn sử dụng nI đại diện cho kích thước của hình ảnh đầu vào,f đại diện cho kích thước của bộ lọc,sđại diện cho kích thước bước,pđại diện cho số lượng lớp điền,nOBiểu thị kích thước của hình ảnh đầu vào, khi đó có mối quan hệ sau:
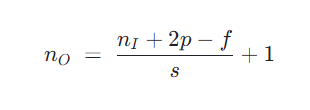
Sử dụng công thức này để xác minh chiều rộng và chiều cao của đầu ra của lớp chập thứ nhất và thứ hai:
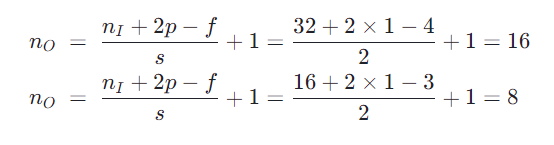
Điều quan trọng nhất đây rồiKênh màu đầu ra của lớp chập bằng số lượng bộ lọc (tức là các bộ lọc tham số trong mã). Hiểu một cách trực quan là mỗi bộ lọc thực hiện song song phép tích chập trên ảnh quét, khi đó đầu ra cuối cùng phải có kích thước thứ nguyên là số lượng bộ lọc.
Kiểm tra mô hình.
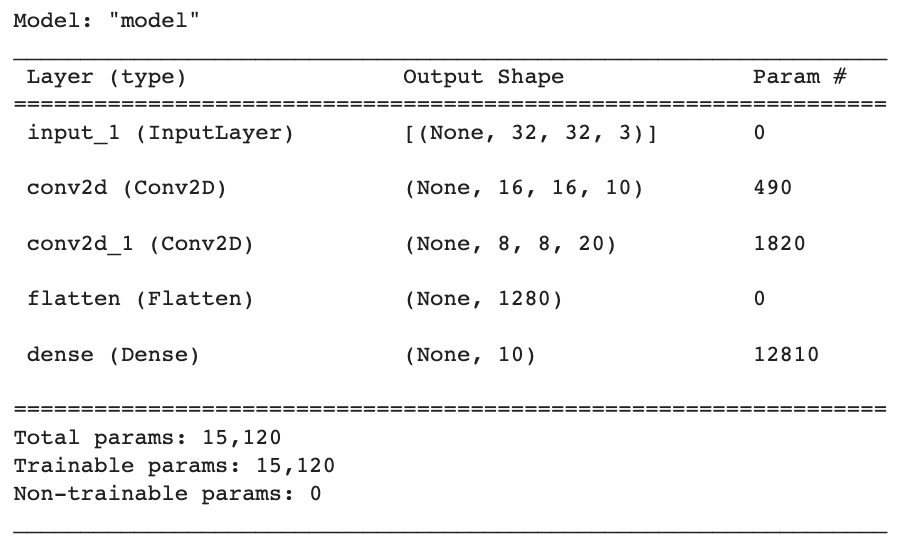
Mô hình được tự động đặt tên là “model”, theo sau là bảng mô tả loại tên (layer (type)), hình dạng đầu ra (Output Shape) và số lượng tham số (Param #) của mỗi lớp. Chúng ta hãy nhìn vào nó từng lớp một
Lớp inputLayer được đặt tên là input_ 1 và hình dạng đầu ra là [None, 32, 32, 3 ]. Ba phần tử cuối cùng tương ứng với chiều rộng, chiều cao và kênh màu của hình ảnh. Phần tử None đầu tiên thực sự đại diện cho số lượng mẫu. Nói đúng hơn Nói một cách dễ hiểu thì đó là Số lượng mẫu trong một đợt. Để mã ngắn gọn, số mẫu này thường không cần phải viết rõ ràng khi lập mô hình.
Lớp Con v 2D đầu tiên tên là con v 2 d, hình xuất ra là [None, 16, 16, 10], tham số 490 = ( 4* 4* 3 + 1) * 10, trước hết là không quên có độ lệch Tiếp theo, 4*4 là kích thước của bộ lọc và 3 là số lượng kênh màu đầu vào, vì vậy chúng ta cần 4*4*3 trọng số để mô tả từng bộ lọc và có tổng cộng 10 bộ lọc.
Lớp Con v 2 D thứ hai có tên con v 2 d_ 1 , hình dạng đầu ra là [None, 8, 8, 20 ], tham số 1, 820 = ( 3* 3* 10 + 1) * 20, trước tiên hãy xem xét đơn vị thiên vị, theo sau là 3*3 là kích thước của bộ lọc và 10 là số lượng kênh màu đầu vào, vì vậy chúng ta cần 3*3*10 trọng số để mô tả bộ lọc này, tổng cộng là 20.
Lớp Flatten được đặt tên là Flatten, 1, 280 là số 8*8*20 sau khi làm phẳng và số lượng tham số là 0, vì làm phẳng chỉ là để định hình lại mảng và không cần tham số nào để hoàn thành hành động định hình lại.
Lớp dày đặc cuối cùng được đặt tên là dày đặc, hình dạng đầu ra là 10, tham số 12, 810 = (1280 + 1) * 10, cũng được coi là đơn vị sai lệch.
Ở phía dưới cùng, tổng các tham số (Tổng thông số) 15, 120, các tham số có thể huấn luyện (Thông số có thể huấn luyện) 15, 120 và các tham số không thể huấn luyện (Thông số không thể huấn luyện) 0 cũng được liệt kê.
Tại thời điểm này, CNN về cơ bản đã được xây dựng và chúng tôi bổ sung thêm hai kỹ thuật nữa để CNN hoạt động tốt hơn:chuẩn hóa hàng loạt(chuẩn hóa hàng loạt) vàtiêu đề phụ (dropout)。
3.3 Chuẩn hóa hàng loạt
Khi đào tạo CNN, chìa khóa thành công của mô hình là đảm bảo các trọng số vẫn nằm trong một phạm vi nhất định, nếu không sẽ xảy ra hiện tượng gradient bùng nổ. Chuẩn hóa hàng loạt có thể giải quyết vấn đề này, nó sẽ tính toán dữ liệu theo lô (mini-batch) ở mỗi lớptrung bình(có nghĩa là) vàđộ lệch chuẩn(độ lệch chuẩn), sau đó trừ đi giá trị trung bình chia cho độ lệch chuẩn trên mỗi dữ liệu. Để “khôi phục” dữ liệu chúng ta cần “tìm hiểu” hai tham số là tham số chia tỷ lệγvà thông số dịch thuậtβ。
Thuật toán chuẩn hóa hàng loạt như sau:
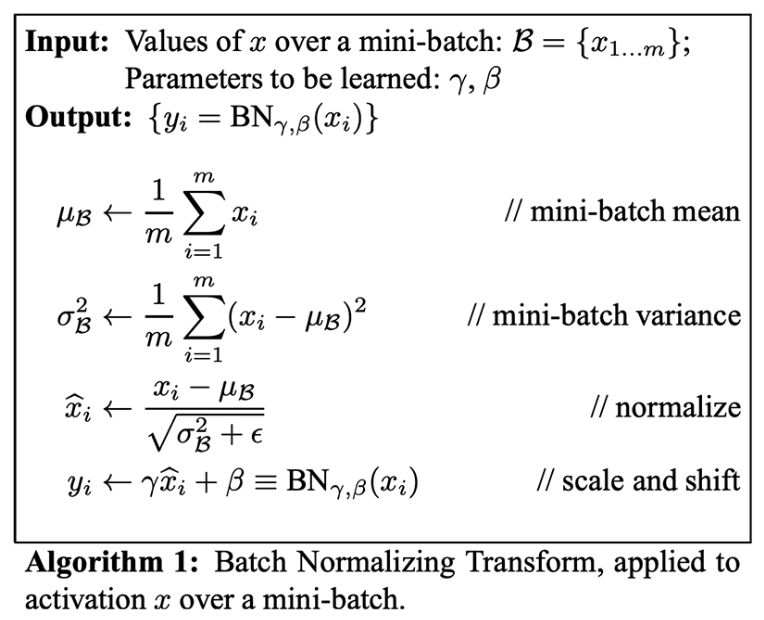
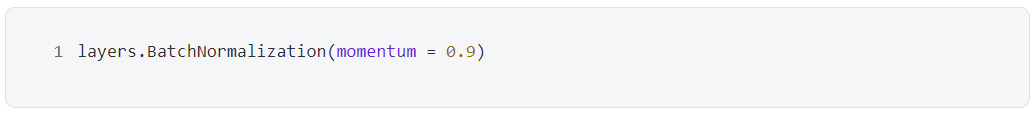
BatchNormalization() được sử dụng trong Keras để đạt được sự chuẩn hóa hàng loạt. Lớp chuẩn hóa hàng loạt thường được đặt sau lớp dày đặc hoặc lớp chập.
tiêu đề phụ
3.4 Vô hiệu hóa ngẫu nhiên
Việc ngẫu nhiên hóa được lấy cảm hứng từ các kỳ thi. Thông thường trước khi thi, học sinh sẽ làm lại các đề thi của các năm trước để ôn lại các điểm kiến thức. Một số học sinh giải bài bằng cách học thuộc lòng nên sẽ không làm tốt bài thi thực tế vì chưa thực sự hiểu rõ các điểm kiến thức. Học sinh giỏi sẽ sử dụng bài để hiểu các điểm kiến thức chung, từ đó trả lời được các câu hỏi mới một cách chính xác.
Theo cách tương tự, để ngăn mạng lưới thần kinh ghi nhớ vẹt, chúng ta có thể vô hiệu hóa ngẫu nhiên một số nơ-ron, nghĩa là đặt đầu ra của chúng về 0, như trong hình bên dưới.
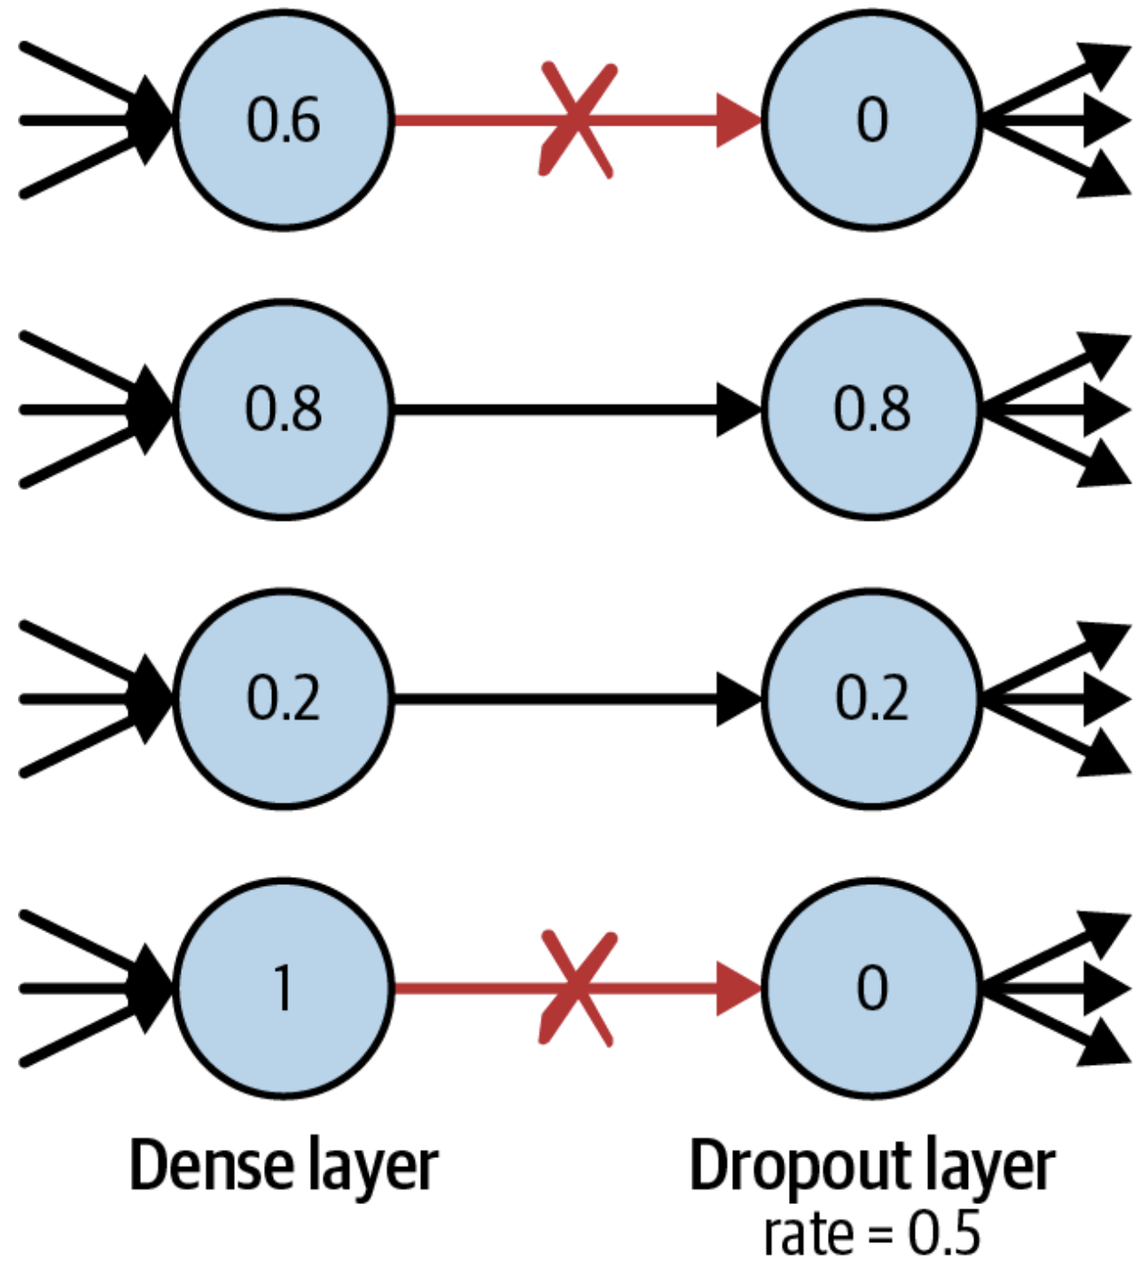
Trong quá trình dự đoán, các nơ-ron không bị ngừng hoạt động nên mạng lưới thần kinh hoàn chỉnh được sử dụng để đưa ra dự đoán.
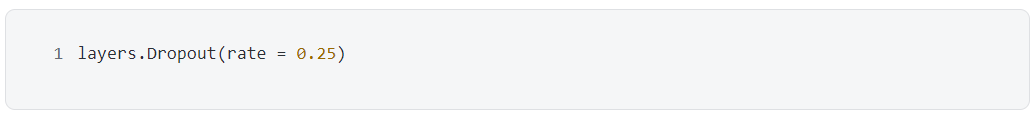
Được sử dụng trong KerasDropout()để nhận ra lớp hủy kích hoạt. Lớp hủy kích hoạt thường được đặt sau lớp dày đặc.
tiêu đề phụ
3.5 Mô hình hoàn chỉnh
Bây giờ chúng ta có thể thêm lớp chuẩn hóa hàng loạt và lớp hủy kích hoạt vào CNN trước đó để cải thiện mô hình.
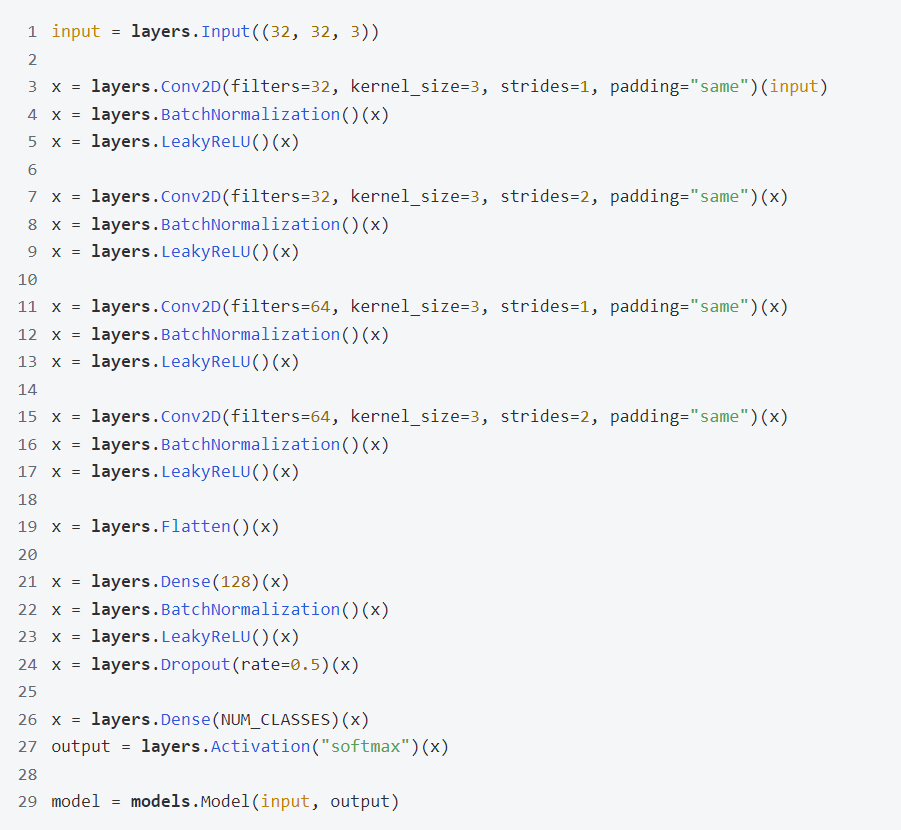
Hãy xem đoạn mã trên có dễ hiểu không. Có bốn lớp chập trong CNN, mỗi lớp theo sau là một lớp chuẩn hóa hàng loạt và một lớp LeakyReLu. Lưu ý rằng mọi thứ trong Keras đều có thể được sử dụng như một lớp, thậm chí các chức năng kích hoạt cũng có thể được triển khai dưới dạng các lớp. Sau đó, sử dụng lớp làm phẳng để làm phẳng dữ liệu, sau đó là lớp dày đặc, lớp chuẩn hóa hàng loạt, lớp LeakyReLu, lớp bất hoạt và lớp dày đặc, cuối cùng sử dụng softmax để xuất ra dưới dạng xác suất.
Hãy xem mô hình CNN tinh tế này.
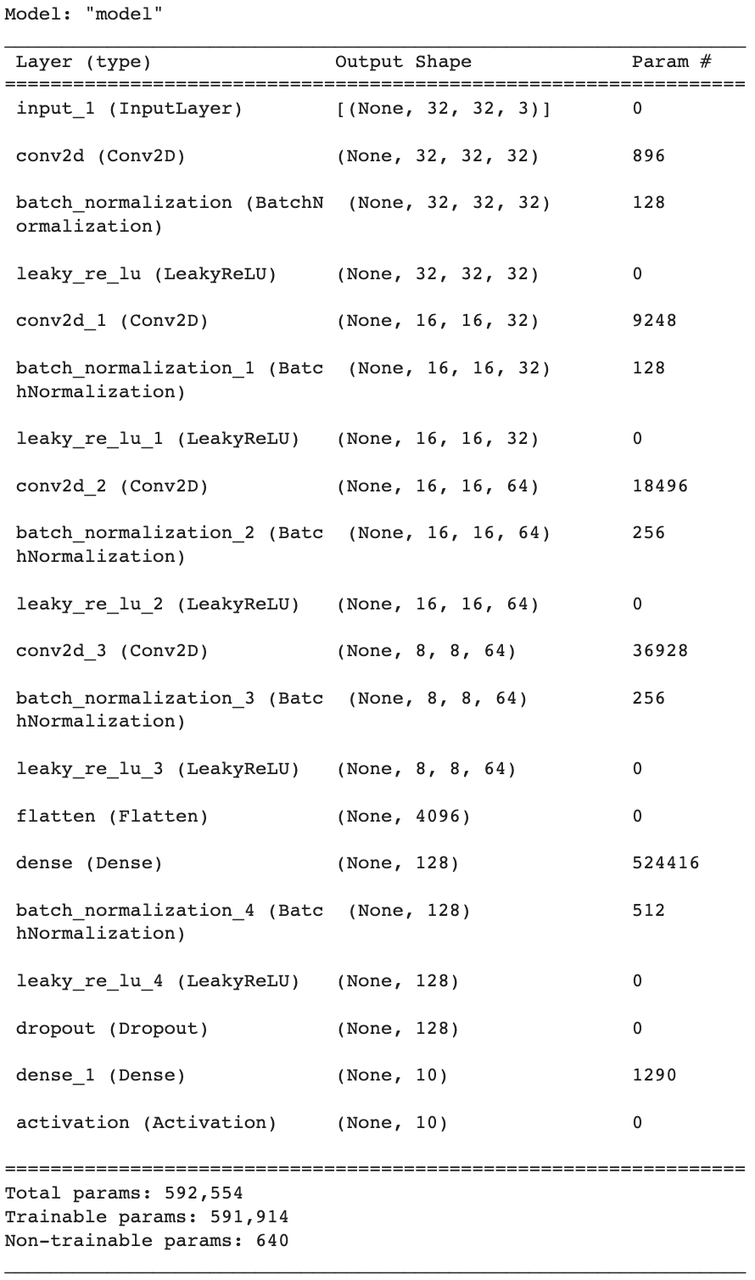
Chúng tôi thấy rằng lớp kích hoạt không chứa tham số, vì nó là một phép biến đổi; lớp làm phẳng và lớp bất hoạt không chứa tham số, điều này cũng dễ hiểu; đối với khối lượng tham số của lớp chập và lớp dày đặc, thuật toán đã được giải thích trước đó; đối với việc chuẩn hóa hàng loạt, cần phải học các tham số tỷ lệ cho mỗi kênhγvà thông số dịch thuậtβvà độ lệch chuẩn di chuyển và trung bình di chuyển, sao cho các tham số bao gồm bằng số kênh * 4 .
tiêu đề phụ
3.6 Đánh giá đào tạo
Mọi thứ đã sẵn sàng, chỉ cần đào tạo. Lần này, chúng tôi đã thêm tham số validation_data để theo dõi xem mô hình có bị trang bị quá mức trong quá trình huấn luyện hay không và trang bị quá mức xảy ra khi lỗi huấn luyện (mất) đang giảm nhưng lỗi xác minh (val_loss) lại tăng lên. Từ hình ảnh dưới đây, không có vấn đề như vậy.
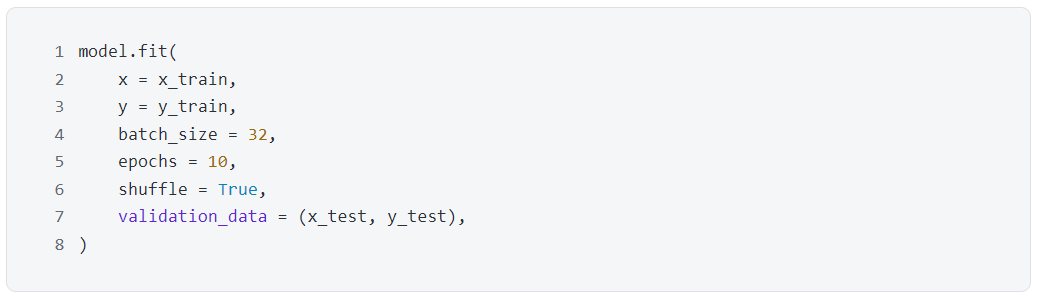
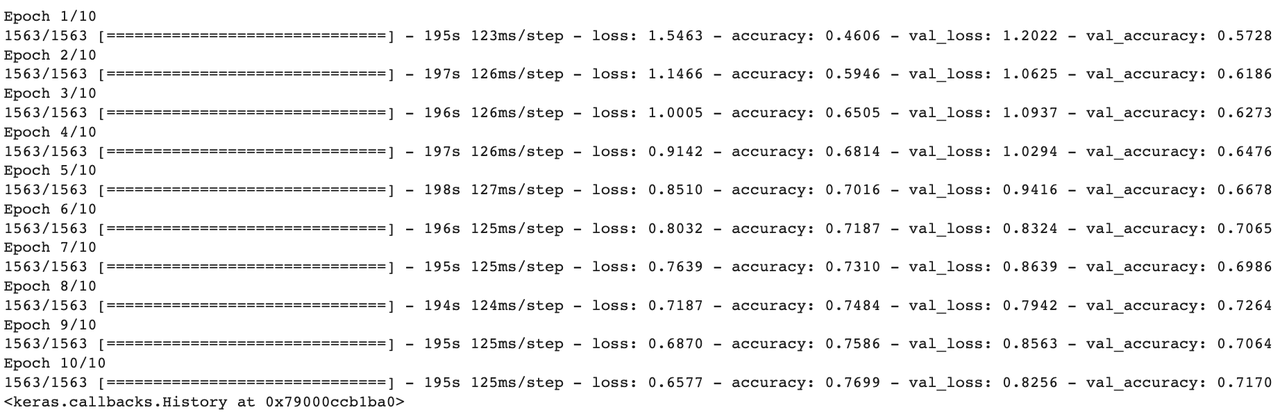
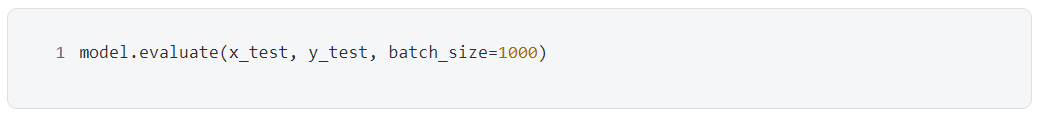

So với mạng nơ-ron tích chập (CNN) hiện tại và mạng nơ-ron chuyển tiếp tiếp liệu (FNN) trước đó, độ chính xác của mô hình hiện có trong tập huấn luyện đã tăng từ 51,39% lên 76,99% và độ chính xác trong tập huấn luyện cũng tăng từ 49,52% Lên đến 71,70%, hiệu suất mô hình được cải thiện rất nhiều.
Điều đáng ngạc nhiên là các tham số của CNN (592, 554) thực tế ít hơn nhiều so với các tham số của FNN (646, 260), nhưng hiệu suất của mô hình đã được cải thiện rất nhiều và cải tiến này chỉ cần thay đổi kiến trúc mô hình để bao gồm các lớp chập, batch Nó có thể được thực hiện bằng cách chuẩn hóa một lớp và tắt lớp đó. Tuy CNN có ít tham số hơn FNN nhưng số lớp lại nhiều hơn, đó là lý do tại sao mạng nơ-ron sâu lại có lợi thế, vì lớp giữa của mạng nắm bắt được các tính năng cấp cao mà chúng ta quan tâm nhất.
Tóm tắt
Tóm tắt
Bài viết này giới thiệu các khái niệm deep learning cốt lõi cần thiết để bắt đầu xây dựng các mô hình thế hệ sâu. Sử dụng Keras để xây dựng mạng nơ-ron chuyển tiếp nguồn cấp dữ liệu (FNN) và huấn luyện mô hình để dự đoán lớp của một hình ảnh nhất định trong tập dữ liệu CIFAR-10. Sau đó, chúng tôi cải thiện kiến trúc này bằng cách giới thiệu các lớp tích chập, các lớp chuẩn hóa hàng loạt và các lớp hủy kích hoạt để tạo ra một mạng nơ ron tích chập (CNN).
Thiết kế của mạng lưới thần kinh sâu hoàn toàn linh hoạt và có những phương pháp thực hành tốt nhất có thể, nhưng chúng tôi có thể thoải mái thử các lớp khác nhau và thứ tự chúng xuất hiện. Sử dụng Keras cũng mượt mà như việc xây dựng các khối Lego. mạng lưới thần kinh chỉ cần bị giới hạn bởi trí tưởng tượng của riêng bạn.
Bạn có thể tìm kiếm SignalPlus trong Plugin Store của ChatGPT 4.0 để lấy thông tin mã hóa theo thời gian thực. Nếu bạn muốn nhận thông tin cập nhật của chúng tôi ngay lập tức, vui lòng theo dõi tài khoản Twitter @SignalPlus_Web 3 của chúng tôi hoặc tham gia nhóm WeChat của chúng tôi (thêm một trợ lý nhỏ WeChat: chillwzq), nhóm Telegram và cộng đồng Discord để giao tiếp và tương tác với nhiều bạn bè hơn.
Bạn có thể tìm kiếm SignalPlus trong Plugin Store của ChatGPT 4.0 để lấy thông tin mã hóa theo thời gian thực. Nếu bạn muốn nhận thông tin cập nhật của chúng tôi ngay lập tức, vui lòng theo dõi tài khoản Twitter @SignalPlus_Web 3 của chúng tôi hoặc tham gia nhóm WeChat của chúng tôi (thêm một trợ lý nhỏ WeChat: chillwzq), nhóm Telegram và cộng đồng Discord để giao tiếp và tương tác với nhiều bạn bè hơn.
SignalPlus Official Website: https://www.signalplus.com





