


Coinbase, 90억 파라미터 모델로 결제 사기 방지 업그레이드: 온라인 사기 거래 30% 감소


- 핵심观点:Coinbase 엔지니어링 팀은 자사의 Onramp 사기 방지 Agent 실천 사례를 공개했다: "전통 모델 1차 필터링 + 대규모 모델의 거래 시퀀스 판독" 분업 아키텍처를 통해, 자체 데이터로 소규모 파라미터 모델을 후훈련하여 사기 거래량 30% 감소, 사기 금액 22% 감소를 달성했다.
- 핵심 요소:
- 2026년 10월 Coinbase는 세 편의 글을 연속 발표하며 사기 방지 Agent의 구축, 모델 선정 및 후훈련 과정을 소개했다.
- 아키텍처상 머신러닝 모델과 규칙 엔진이 먼저 단일 거래를 처리하고, Agent는 컨텍스트가 필요할 때만 최근 거래 시퀀스를 읽고 리스크 분류를 출력한다.
- 회사는 자체 역사 데이터로 도메인 테스트 세트를 구축했으며, 일부 최신 폐쇄형 모델이 정밀도는 향상되었으나 재현율, F1 및 금액 가중 재현율은 오히려 하락한 것을 발견했다.
- 90억 파라미터 오픈소스 모델 Qwen3.5-9B에 RLVR 후훈련을 진행하여, 내부 벤치마크에서 Opus 4.5 대비 정밀도 7.5%포인트, 재현율 12%포인트, F1 9.6%포인트, 금액 가중 재현율 35.4%포인트 높았다.
- 온라인 추론 엔드투엔드 지연이 55% 감소했고, 훈련 비용은 100달러 미만이며, 모델은 리스크 결론만 출력하고 처리 조치는 전략 계층과 인간 검토 폐루프로 실행된다.
图 1|Coinbase 工程团队公开了反欺诈 Agent 系列研究
신용카드로 암호자산을 구매하는 거래는 표면적으로 금액, 기기, 결제 결과만 보인다. 그러나 사기꾼들은 공격을 여러 번의 시도로 나누는 경우가 많다. 먼저 소액 거래로 카드를 테스트하고, 이후 기기나 주소, 결제 수단을 바꾼 뒤 마지막에 더 큰 금액의 구매를 완료한다. 그중 한 건만 보면 위험 신호가 매우 약할 수 있지만, 최근 몇 번의 행동을 함께 놓으면 패턴이 드러난다.
2026년 10월 6일부터 8일까지 Coinbase는 세 편의 엔지니어링 글을 연속으로 발표하며 Onramp 사업을 위해 구축한 반사기 Agent 과정을 소개했다. Coinbase는 먼저 대규모 언어 모델을 기존 머신러닝 모델과 규칙 엔진 뒤에 연결해 거래 시퀀스를 읽도록 했고, 이후 도메인 테스트 세트를 구축해 여러 버전의 폐쇄형 모델을 비교했으며, 마지막으로 자체 사기 데이터를 사용해 90억 파라미터 오픈웨이트 모델을 후속 학습했다. 회사가 공개한 온라인 실험에 따르면 Agent를 추가한 후 사기 거래 건수는 30% 감소하고 사기 금액은 22% 감소했다. 후속 학습 모델은 내부 벤치마크에서 더 높은 F1 점수를 얻었고 엔드투엔드 지연도 더 낮았다.
이 수치는 Coinbase 자체 실험에서 나온 것으로, 외부에서는 현재 전체 데이터 세트를 재현할 수 없다. 하지만 이 실무 사례는 매우 구체적인 기업 AI 샘플을 제공한다. 결제 리스크 관리라는 좁은 과업에서는 모델의 신구와 규모가 반드시 첫 번째가 아닐 수 있다. 실제로 효과에 영향을 미치는 것은 기업이 신뢰할 수 있는 결과 데이터를 가지고 있는지, 실제 업무에 가까운 테스트 세트를 구축할 수 있는지, 그리고 모델 출력이 기존 의사결정 시스템에 어떻게 들어가는지다.
1. 전통 모델이 먼저 필터링하고, Agent가 거래 과정을 읽는다
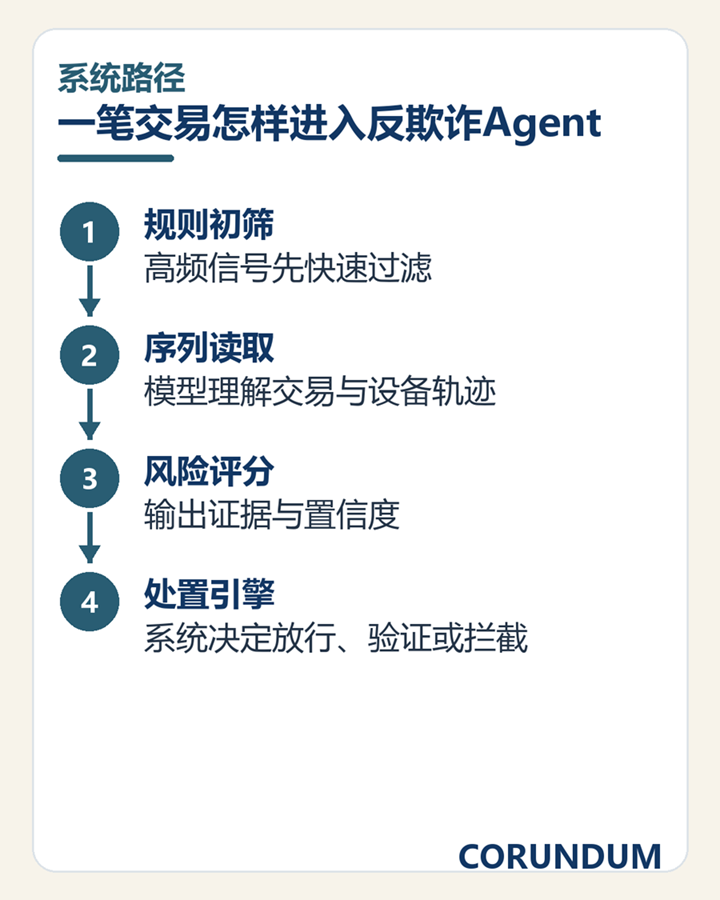
图 2|一笔交易进入反欺诈 Agent 的处理路径
Coinbase Onramp는 사용자가 제휴 앱 내에서 암호자산을 구매하도록 하며, 일부 시나리오에서는 게스트 결제를 허용한다. 게스트는 장기 계정 기록이 없기 때문에 플랫폼이 사용할 수 있는 정보는 주로 현재 결제와 최근 거래 행동에서 나온다. 기존 머신러닝 모델은 단일 거래 특징을 빠르게 처리하는 데 능숙하고, 규칙 엔진은 반복 실패, 기기 급변, 결제 정보 불일치 등 명확한 이상 조건을 차단한다.
어려움은 연속 동작에서 나타난다. 특정 구매의 금액과 기기는 평범하지만, 최근 몇 분의 거래 시퀀스에 다시 놓으면 여러 번의 소액 테스트, 카드 교체, 주소 변경이 바로 뒤따를 수 있다. Coinbase는 최근 거래를 시간순으로 정리해 컨텍스트로 만들고 이를 대규모 언어 모델에 넘겨 위험을 판단한다. 모델은 짧은 위험 분류를 출력하고, 후속 프로그램이 이 분류에 따라 승인, 거절 또는 수동 검토로 결정한다.
이 구조는 전통 리스크 관리 시스템의 속도를 유지한다. 대다수 거래는 먼저 머신러닝 모델과 규칙으로 처리되고, Agent는 더 많은 컨텍스트가 필요할 때만 투입된다. 그 역할도 엄격히 제한된다. 이미 정리된 거래 정보를 읽고, 시퀀스 내 관계를 식별하며, 규정된 형식의 결론을 반환하는 것이다. 최종 조치는 여전히 시스템의 정책 계층이 실행한다.
이러한 분업은 Coinbase가 이를 리스크 Agent라고 부르는 이유를 설명한다. 그것은 스스로 고객을 조사하지도 않고, 모든 내부 시스템을 자유롭게 호출하지도 않는다. 플랫폼은 데이터 범위, 질문 형식, 반환 가능한 답변을 제한했고, 모델은 따라서 '이 거래들이 서로 연결되어 있을 때 이상한가'라는 좁은 문제에 집중할 수 있다.
2. 모델 업그레이드가 조용히 위험 기준을 바꿀 수 있다
1단계 출시 후 Coinbase가 직면한 다음 문제는 모델 선택이었다. 범용 벤치마크는 기업에 어떤 모델의 전반적 능력이 더 강한지 알려주는 경우가 많지만, 결제 리스크 관리가 관심을 두는 지표는 더 구체적이다. 사기 거래를 얼마나 막을 수 있는지, 정상 사용자가 얼마나 오탐될지, 고액 사기가 식별되는지, 그리고 매 판단에 얼마나 오래 걸리는지다.
Coinbase는 자체 과거 데이터로 테스트 세트를 구축해 여러 Opus, Sonnet, GPT 버전을 비교했다. 회사가 공개한 바에 따르면 일부 최신 모델은 정밀도가 높아졌지만 재현율, F1 점수, 금액 가중 재현율은 오히려 하락했다. 정밀도는 모델이 사기로 판단한 거래 중 실제로 사기인 비율을 나타내고, 재현율은 전체 사기 거래 중 얼마나 찾아냈는지를 나타낸다. 리스크 관리 시스템이 높은 정밀도만 추구하면 오탐을 줄일 수 있지만 더 많은 실제 손실을 놓칠 수 있다.
F1 점수는 정밀도와 재현율을 종합적으로 관찰하는 데 사용된다. 간단히 말해, 팀이 모델이 한 지표에서만 좋은 성과를 보이는지 판단하도록 돕는다. Coinbase는 여기에 사기 금액 가중 재현율도 추가했는데, 큰 금액의 사기를 놓쳐 발생하는 손실이 일반적으로 소액 거래를 놓치는 것보다 훨씬 크기 때문이다.
따라서 모델 업그레이드는 하나의 리스크 정책 변경이 된다. 프롬프트, 인터페이스, 승인 규칙이 그대로 유지되더라도 새 모델은 의심스러운 행동을 다르게 이해해 원래 승인하던 거래를 거절로 돌리거나, 구버전이 식별할 수 있었던 사기를 놓칠 수 있다. 기업은 프로덕션 환경에서 모델을 전환하기 전에 자체 테스트 세트로 다시 검증해야 하며, 벤더가 공개한 종합 순위를 출시 근거로 바로 사용해서는 안 된다.
3. 90억 파라미터 모델이 왜 더 큰 폐쇄형 모델을 능가할 수 있는가
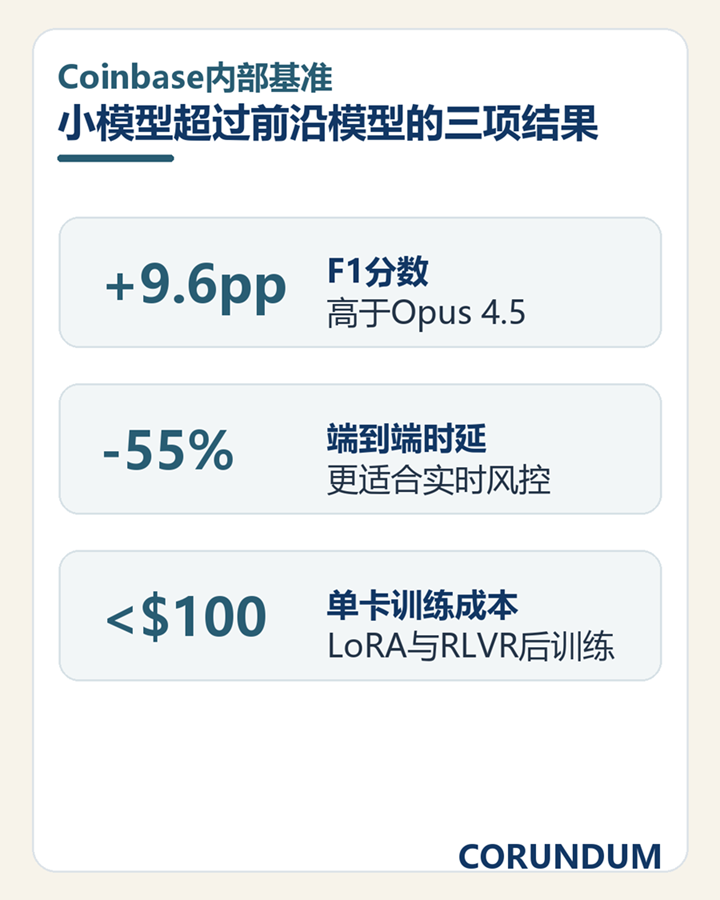
图 3|Coinbase 内部基准显示的小模型三项结果
Coinbase는 이후 Qwen3.5-9B를 선택해 후속 학습을 진행했다. 이 모델은 90억 파라미터에 불과하며 단일 NVIDIA RTX PRO 6000 96GB GPU에서 학습 및 배포할 수 있다. 팀은 과거 거래 결과를 검증 가능한 보상으로 전환했다. 모델 판단이 알려진 사기 결과와 일치하면 보상을 받고, 잘못 판단하면 벌점을 받으며, 이를 강화학습으로 모델을 조정했다.
여기서 사용된 RLVR의 전체 명칭은 '검증 가능 보상 강화학습'이다. 결제 거래는 최종적으로 지불 거절, 사기 확인, 정상 완료 등의 결과를 낳고, 이러한 결과는 비교적 명확한 학습 신호로 사용될 수 있다. 모델은 답변이 '좋은 판단처럼 보이는지'를 평가할 또 다른 대규모 모델이 필요하지 않다. 그것은 이미 발생한 업무 결과를 마주한다.
사기 샘플 수는 일반적으로 정상 거래보다 훨씬 적다. 보상 함수가 전체 정확도만 본다면 모델이 거의 모든 거래를 정상으로 판단해도 괜찮아 보이는 숫자를 얻을 수 있다. 따라서 Coinbase는 사기와 정상 샘플의 기여도를 균형 있게 조정하고 LoRA로 소량의 추가 파라미터를 학습해 모델이 Onramp 업무의 사기 패턴을 학습하도록 했다.
회사가 공개한 바에 따르면 후속 학습 모델은 내부 벤치마크에서 Opus 4.5 대비 정밀도가 7.5%포인트 높고, 재현율이 12%포인트 높으며, F1이 9.6%포인트 높고, 금액 가중 재현율이 35.4%포인트 높았다. 온라인 추론의 엔드투엔드 지연은 55% 감소했고 학습 비용은 100달러 미만이었다. 이 결과는 하나의 좁은 분류 과업을 대상으로 하며, 도메인 적응이 더 작은 모델을 더 적합한 프로덕션 도구로 학습시킬 수 있음을 보여준다.
4. 모델은 위험 결론만 제공하고, 시스템이 처리 방법을 결정한다
Coinbase는 모델이 거래를 직접 통제하도록 하지 않았다. Agent harness는 거래 정보를 입력으로 정리하고, 모델이 반환한 위험 분류를 시스템이 실행할 수 있는 동작으로 변환한다. 학습 단계에서는 모델에 이유 설명을 요구할 수 있지만, 온라인 결제에는 지연과 형식 오류를 줄이기 위해 간결한 위험 결과만 필요하다.
이 중간 프로그램 계층은 매우 중요하다. 모델이 어떤 필드를 볼 수 있는지, 결측값을 어떻게 처리하는지, 어떤 범주를 반환하는지, 얼마나 오래 걸리면 실패로 보는지, 모델이 응답하지 않을 때 어느 구 규칙으로 돌아가는지를 규정한다. 모델 버전은 교체될 수 있지만 결제 시스템의 권한 경계는 계속 프로그램이 통제한다.
수동 검토도 여전히 유지된다. 고위험 거래, 모델과 전통 규칙이 충돌하는 거래, 또는 비교적 큰 금액이 관련된 경계 샘플은 수동 큐로 들어갈 수 있다. 검토 결과는 이후 새 데이터가 되어 팀이 테스트 세트가 다루지 못한 사기 수법을 발견하도록 돕는다. 모델, 규칙, 인간 판단은 이로써 지속적으로 업데이트되는 폐루프를 형성한다.
이러한 폐루프는 새로운 거버넌스 요구도 가져온다. 기업은 모델 버전, 입력 필드, 위험 결론, 최종 처리를 기록해야 민원, 지불 거절, 규제 검사에서 당시 결정을 복원할 수 있다. 학습 데이터에 결제 행동과 기기 정보가 포함될 때는 데이터 접근, 보존 기간, 향후 학습 용도도 통제해야 한다.
5. 기업의 모델 선택 방식이 바뀌고 있다
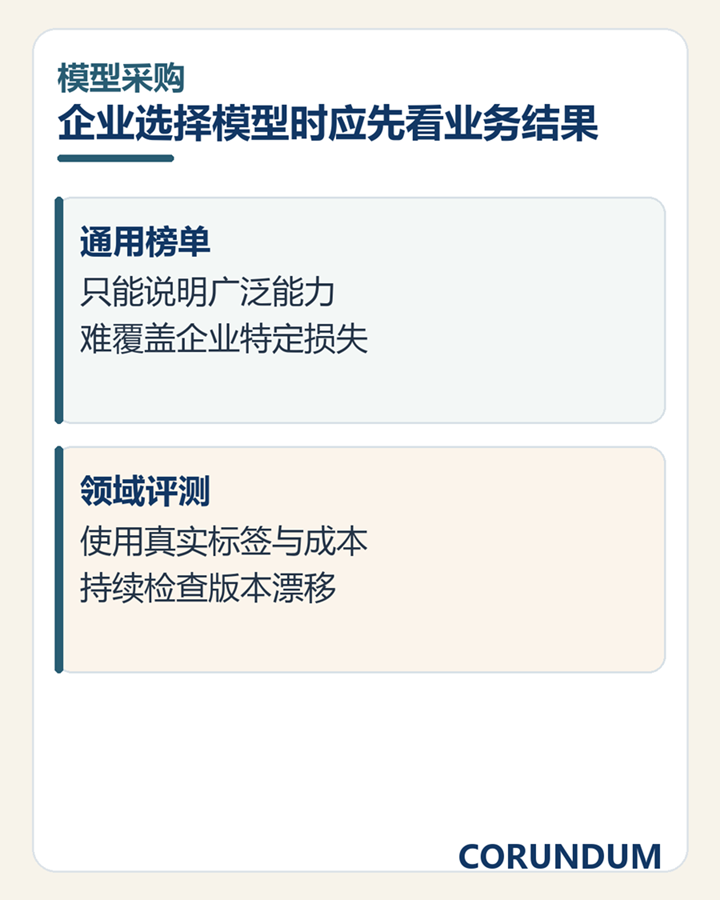
图 4|企业模型采购从通用榜单转向领域评测
대규모 모델 조달은 과거에 종종 범용 능력, 컨텍스트 길이, 벤더 브랜드를 중심으로 이루어졌다. Coinbase 사례는 선택 기준을 구체적 업무로 되돌린다. 테스트 데이터가 실제 트래픽에 가까운지, 오류 비용이 어떻게 분포하는지, 시스템이 얼마나 긴 지연을 감당할 수 있는지, 모델이 기존 인프라에서 안정적으로 실행될 수 있는지다.
금융기관에게 이는 모델 평가를 리스크 정책과 함께 설계해야 한다는 뜻이다. 반사기, 자금세탁방지, 신용 심사, 이상 거래 식별은 모두 샘플 불균형이 존재하며, 단일 정확도는 문제를 쉽게 가릴 수 있다. 팀은 재현율, 오탐률, 금액 손실, 고객 전환을 동시에 관찰한 뒤 승인 임계값을 정해야 한다.
오픈웨이트 모델도 이로써 새로운 위치를 얻는다. 기업은 자체 환경에서 학습 및 배포할 수 있고 모델 가중치, 서비스 방식, 버전 주기의 통제권을 유지할 수 있다. 대가는 기업이 학습 안전, 모델 평가, 인프라, 지속적 유지보수 작업을 떠안아야 한다는 점이다. 데이터를 보유하는 것만으로 충분하지 않으며, 데이터가 명확한 업무 결과에 매핑될 수 있어야 한다.
Coinbase의 실무는 결국 소박한 판단으로 귀결된다. 결제 리스크 관리에는 모든 질문에 답할 수 있는 모델이 필요하지 않다. 이 유형의 거래에 익숙하고, 충분히 빠르게 반응하며, 오류를 측정할 수 있고, 항상 정해진 권한 안에 머무는 모델이 필요하다. 기업 AI가 프로덕션 시스템에 들어간 후 가장 가치 있는 능력은 종종 이러한 좁고 안정적인 적응에서 나온다.
이 글은 법률, 정책 및 업계 연구 교류에만 사용되며, 디지털 금융, 스테이블코인, 디지털 자산 및 관련 규제 동향에 대한 객관적 분석을 목적으로 한다. 어떠한 형태의 투자 조언, 법률 의견, 세무 의견 또는 기타 전문적 조언도 구성하지 않으며, 어떠한 금융 상품, 디지털 자산 또는 상업 프로젝트의 추천, 홍보 또는 권유도 구성하지 않는다. 글에 언급된 규제 규칙, 시장 데이터 및 기관 정보는 주로 공개 자료에서





