






Foresight Ventures:理性看待去中心化算力網絡


一級標題
TL;DR
一級標題一級標題。
目前AI + Crypto 結合的點主要有2 個比較大的方向:分佈式算力和ZKML;關於ZKML 可以參考我之前的一篇文章。本文將圍繞去中心化的分佈式算力網絡做出分析和反思在AI 大模型的發展趨勢下,
算力資源會是下一個十年的大戰場,也是未來人類社會最重要的東西
去中心化的分佈式算力網絡在模型推理上更有機會落地,可以預測未來的增量空間也足夠大。但也面臨通信延遲、數據隱私、模型安全等挑戰。和模型訓練相比,推理時的計算複雜度和數據交互性較低,更適合在分佈式環境中進行。
一級標題
一級標題
二級標題
二級標題
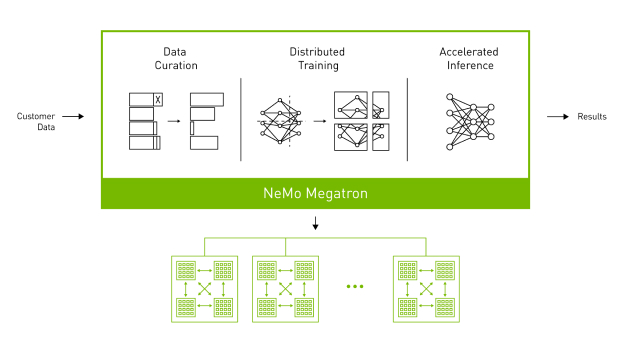
(NVIDIA NeMo Megatron Framework)
圖片描述
二級標題
1.整體訓練流程以訓練一個具有1750 億參數的大模型為例。由於模型規模巨大,需要在很多個GPU 設備上進行並行訓練。假設有一個中心化的機房,有100 個GPU,每個設備具有32 GB 的內存。
數據準備:首先需要一個巨大的數據集,這個數據集包含例如互聯網信息、新聞、書籍等各種數據。在訓練前需要對這些數據進行預處理,包括文本清洗、標記化(tokenization)、詞表構建等。
數據分割:處理完的數據會被分割成多個batch,以在多個GPU 上並行處理。假設選擇的batch 大小是512 ,也就是每個批次包含512 個文本序列。然後,我們將整個數據集分割成多個批次,形成一個批次隊列。
設備間數據傳輸:在每個訓練步驟開始時,CPU 從批次隊列中取出一個批次,然後將這個批次的數據通過PCIe 總線發送到GPU。假設每個文本序列的平均長度是1024 個標記,那麼每個批次的數據大小約為512 * 1024 * 4 B = 2 MB(假設每個標記使用4 字節的單精度浮點數表示)。這個數據傳輸過程通常只需要幾毫秒。
並行訓練梯度聚合和參數更新
同步:在反向傳播計算完成後,每個GPU 都得到了一部分參數的梯度。然後,這些梯度需要在所有的GPU 設備之間進行聚合,以便計算全局梯度。這需要通過網絡進行數據傳輸,假設用的是25 Gbps 的網絡,那麼傳輸700 GB 的數據(假設每個參數使用單精度浮點數,那麼1750 億參數約為700 GB)需要約224 秒。然後,每個GPU 根據全局梯度更新其存儲的參數。
同步:重複上述步驟,直到完成所有批次的訓練,或者達到預定的訓練輪數(epoch)。
二級標題
二級標題
2.通信開銷的瓶頸:做不了需要注意的是,通信的瓶頸也是導致現在分佈式算力網絡
做不了
大語言模型訓練的原因。各個節點需要頻繁地交換信息以協同工作,這就產生了通信開銷。對於大語言模型,由於模型的參數數量巨大這個問題尤為嚴重。通信開銷分這幾個方面:
數據傳輸:訓練時節點需要頻繁地交換模型參數和梯度信息。這需要將大量的數據在網絡中傳輸,消耗大量的網絡帶寬。如果網絡條件差或者計算節點之間的距離較大,數據傳輸的延遲就會很高,進一步加大了通信開銷。
同步問題:訓練時節點需要協同工作以保證訓練的正確進行。這需要在各節點之間進行頻繁的同步操作,例如更新模型參數、計算全局梯度等。這些同步操作需要在網絡中傳輸大量的數據,並且需要等待所有節點完成操作,這會導致大量的通信開銷和等待時間。
梯度累積和更新:訓練過程中各節點需要計算自己的梯度,並將其發送到其他節點進行累積和更新。這需要在網絡中傳輸大量的梯度數據,並且需要等待所有節點完成梯度的計算和傳輸,這也是導致大量通信開銷的原因。
數據一致性
:需要保證各節點的模型參數保持一致。這需要在各節點之間進行頻繁的數據校驗和同步操作,這會導致大量的通信開銷。
雖然有一些方法可以減少通信開銷,比如參數和梯度的壓縮、高效並行策略等,但是這些方法可能會引入額外的計算負擔,或者對模型的訓練效果產生負面影響。並且,這些方法也不能完全解決通信開銷問題,特別是在網絡條件差或計算節點之間的距離較大的情況下。
舉一個例子:
去中心化分佈式算力網絡
GPT-3 模型有1750 億個參數,如果我們使用單精度浮點數(每個參數4 字節)來表示這些參數,那存儲這些參數就需要~ 700 GB 的內存。而在分佈式訓練中,這些參數需要在各個計算節點之間頻繁地傳輸和更新。
假設有100 個計算節點,每個節點每個步驟都需要更新所有的參數,那麼每個步驟都需要傳輸約70 TB(700 GB* 100 )的數據。如果我們假設一個步驟需要1 s(非常樂觀的假設),那麼每秒鐘就需要傳輸70 TB 的數據。這種對帶寬的需求已經遠超過了大多數網絡,也是一個可行性的問題。
實際情況下,由於通信延遲和網絡擁堵,數據傳輸的時間可能會遠超1 s。這意味著計算節點可能需要花費大量的時間等待數據的傳輸,而不是進行實際的計算。這會大大降低訓練的效率,而這種效率上的降低不是等一等就能解決的,而是可行和不可行的差別,會讓整個訓練過程不可行。
中心化機房
就算是在中心化的機房環境下,大模型的訓練仍然需要很重的通信優化。
在中心化的機房環境中,高性能計算設備作為集群,通過高速網絡進行連接來共享計算任務。然而,即使在這種高速網絡環境中訓練參數數量極大的模型,通信開銷仍然是一個瓶頸,因為模型的參數和梯度需要在各計算設備之間進行頻繁的傳輸和更新。
二級標題
二級標題
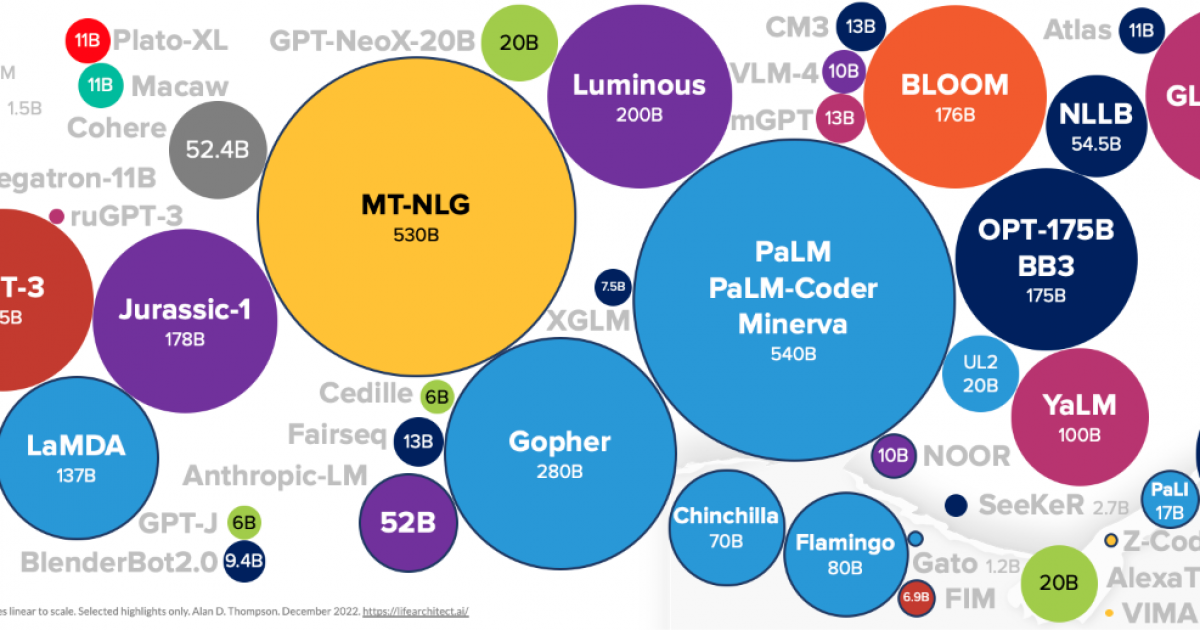
(Data used to train LLM models)
圖片描述
二級標題
1. 3.為什麼分佈式算力網絡不能做這些優化要做也是能做的,但相比中心化的機房,這些優化的效果很受限。
2. 模型並行二級標題
二級標題
二級標題
1. 4.數據安全和隱私的挑戰幾乎所有涉及數據處理和傳輸的環節都可能影響到數據安全和隱私:
2. 數據分配:訓練數據需要被分配到各個參與計算的節點。這個環節數據可能會在分佈式節點被惡意使用/洩漏。
3. 模型訓練:在訓練過程中,各個節點都會使用其分配到的數據進行計算,然後輸出模型參數的更新或梯度。這個過程中,如果節點的計算過程被竊取或者結果被惡意解析,也可能洩露數據。
參數和梯度聚合
:各個節點的輸出需要被聚合以更新全局模型,聚合過程中的通信也可能洩露關於訓練數據的信息。
對於數據隱私問題有哪些解決方案?
安全多方計算:SMC 在某些特定的、規模較小的計算任務中已經被成功應用。但在大規模的分佈式訓練任務中,由於其計算和通信開銷較大,目前還沒有廣泛應用。
差分隱私:應用在某些數據收集和分析任務中,如Chrome 的用戶統計等。但在大規模的深度學習任務中,DP 會對模型的準確性產生影響。同時,設計適當的噪聲生成和添加機制也是一個挑戰。
聯邦學習:應用在一些邊緣設備的模型訓練任務中,比如Android 鍵盤的詞彙預測等。但在更大規模的分佈式訓練任務中,FL 面臨通信開銷大、協調複雜等問題。
同態加密:在一些計算複雜度較小的任務中已經被成功應用。但在大規模的分佈式訓練任務中,由於其計算開銷較大,目前還沒有廣泛應用。
小結一下
以上每種方法都有其適應的場景和局限性,沒有一種方法可以在分佈式算力網絡的大模型訓練中完全解決數據隱私問題。
寄予厚望的ZK 是否能解決大模型訓練時的數據隱私問題?
理論上ZKP 可以用於確保分佈式計算中的數據隱私,讓一個節點證明其已經按照規定進行了計算,但不需要透露實際的輸入和輸出數據。但實際上將ZKP 用於大規模分佈式算力網絡訓練大模型的場景中面臨以下瓶頸:
計算和通信開銷up:構造和驗證零知識證明需要大量的計算資源。此外,ZKP 的通信開銷也很大,因為需要傳輸證明本身。在大模型訓練的情況下,這些開銷可能會變得特別顯著。例如,如果每個小批量的計算都需要生成一個證明,那麼這會顯著增加訓練的總體時間和成本。
ZK 協議的複雜度:設計和實現一個適用於大模型訓練的ZKP 協議會非常複雜。這個協議需要能夠處理大規模的數據和復雜的計算,並且需要能夠處理可能出現的異常報錯。
小結一下
一級標題
一級標題
二級標題
二級標題

(Power LLM inference with NVIDIA Triton)
圖片描述
二級標題
通信延遲:
模型部署和更新:
在分佈式環境中,節點間的通信是必不可少的。在去中心化的分佈式算力網絡中,節點可能遍布全球,因此網絡延遲會是一個問題,特別是對於需要實時響應的推理任務。
模型部署和更新:
數據隱私:
模型安全:
雖然推理任務通常只需要輸入數據和模型,不需要回傳大量的中間數據和參數,但是輸入數據仍然可能包含敏感信息,如用戶的個人信息。
二級標題
二級標題
2.可行性
二級標題
2.可行性
計算複雜度:
在訓練階段,模型需要反复迭代,訓練過程中需要對每一層計算前向傳播和反向傳播,包括激活函數的計算、損失函數的計算、梯度的計算和權重的更新。因此,模型訓練的計算複雜度較高。
在推理階段,只需要一次前向傳播計算預測結果。例如,在GPT-3 中,需要將輸入的文本轉化為向量,然後通過模型的各層(通常為Transformer 層)進行前向傳播,最後得到輸出的概率分佈,並根據這個分佈生成下一個詞。在GANs 中,模型需要根據輸入的噪聲向量生成一張圖片。這些操作只涉及模型的前向傳播,不需要計算梯度或更新參數,計算複雜度較低。
數據交互性:
在推理階段,模型通常處理的是單個輸入,而不是訓練時的大批量的數據。每次推理的結果也只依賴於當前的輸入,而不依賴於其它的輸入或輸出,因此無需進行大量的數據交互,通信壓力也就更小。
小結一下
一級標題
圖片描述
圖片描述
1.Together
(RedPajama from Together)
二級標題
圖片描述
Together 是一家專注於大模型的開源,致力於去中心化的AI 算力方案的公司,希望任何人在任何地方都能接觸和使用AI。 Together 剛完成了Lux Capital 領投的20 m USD 的種子輪融資。
Together 由Chris、Percy、Ce 聯合創立,初衷是由於大模型訓練需要大量高端的GPU 集群和昂貴的支出,並且這些資源和模型訓練的能力也集中在少數大公司。
從我的角度看,一個比較合理的分佈式算力的創業規劃是:
Step 1. 開源模型
要在去中心化的分佈式算力網絡中實現模型推理,先決條件是節點必須能低成本地獲取模型,也就是說使用去中心化算力網絡的模型需要開源(如果模型需要在相應的許可下使用,就會增加實現的複雜性和成本)。比如chatgpt 作為一個非開源的模型,就不適合在去中心化算力網絡上執行。
因此,可以推測出一個提供去中心化算力網絡的公司的隱形壁壘是需要具備強大的大模型開發和維護能力。自研並開源一個強大的base model 能夠一定程度上擺脫對第三方模型開源的依賴,解決去中心化算力網絡最基本的問題。同時也更有利於證明算力網絡能夠有效地進行大模型的訓練和推理。
而Together 也是這麼做的。最近發布的基於LLaMA 的RedPajama 是由Together, Ontocord.ai, ETH DS 3 Lab, Stanford CRFM 和Hazy Research 等團隊聯合啟動的,目標是研發一系列完全開源的大語言模型。
在開源模型的基礎上,Together 的研發團隊針對RedPajama-INCITE-3 B 模型現做了一系列更新,比如利用LoRA 實現低成本的微調,使模型在CPU(特別是使用M 2 Pro 處理器的MacBook Pro)上運行模型更加絲滑。同時,儘管這個模型的規模較小,但它的能力卻超過了相同規模的其他模型,並且在法律、社交等場景得到了實際應用。
圖片描述
圖片描述
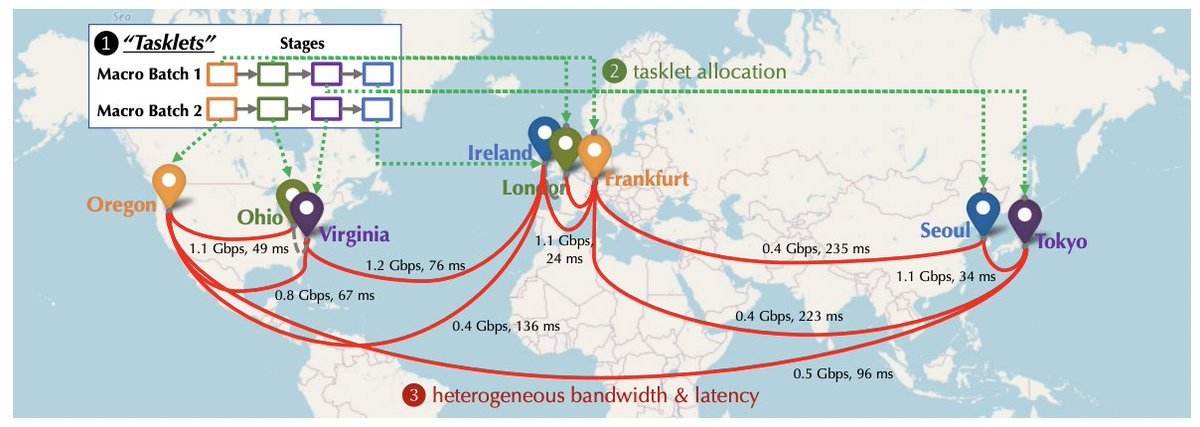
圖片描述Overcoming Communication Bottlenecks for Decentralized Training(Overcoming Communication Bottlenecks for Decentralized Training 的算力網絡示意圖)
從中長期來看,雖然面臨很大的挑戰和技術瓶頸,承接AI 大模型訓練上的算力需求一定是最誘人的。 Together 在建立之初就開始佈局如何克服去中心化訓練中的通信瓶頸方面的工作。他們也在NeurIPS 2022 上發布了相關的論文:
。我們可以主要歸納出以下方向:
調度優化
在去中心化環境中進行訓練時,由於各節點之間的連接具有不同的延遲和帶寬,因此,將需要重度通信的任務分配給擁有較快連接的設備是很重要的。 Together 通過建立模型來描述特定調度策略的成本,更好地優化調度策略,以最小化通信成本,最大化訓練吞吐量。 Together 團隊還發現,即使網絡慢100 倍,端到端的訓練吞吐量也只慢了1.7 至2.3 倍。因此,通過調度優化來追趕分佈式網絡和中心化集群之間的差距很有戲。
通信壓縮優化
圖片描述
圖片描述
2.Gensyn.ai
(Gensyn.ai)
二級標題
圖片描述
從Together 的技術路徑我們可以大致理解去中心化算力網絡在模型訓練和推理上的落地過程以及相應的研發重點。
另一個不能忽視的重點是算力網絡激勵層/共識算法的設計,比如一個優秀的網絡需要具備:
1. 確保收益足夠有吸引力;
2. 確保每個礦工獲得了應有的收益,包括防作弊和多勞多得;
……
3. 確保任務在不同節點直接合理調度和分配,不會有大量閒置節點或者部分節點過度擁擠;
成為節點
驗證
驗證
驗證
驗證
Solver 在更新parameters 的同時生成多個checkpoints(保證工作的透明性和可追溯性),並且會定期生成關於任務的密碼學加密推理proofs(工作進度的證明);
Solver 完成工作並產生了一部分計算結果時,協議會選擇一個verifier,verifier 也會質押一定金額(確保verifier 誠實地執行驗證),並且根據上述提供的proofs 來決定需要驗證哪一部分的計算結果。
如果solver 和verifier 出現分歧
通過基於Merkle tree 的數據結構,定位到計算結果存在分歧的確切位置。整個驗證的操作都會上鍊,作弊者會被扣除質押的金額。
項目總結
激勵和驗證算法的設計使得Gensyn.ai 不需要在驗證過程中去重放整個計算任務的所有結果,而只需要根據提供的證明對一部分結果進行複制和驗證,這極大地提高了驗證的效率。同時,節點只需要存儲部分計算結果,這也降低了存儲空間和計算資源的消耗。另外,潛在的作弊節點無法預測哪些部分會被選中進行驗證,所以這也降低了作弊風險;
這種驗證分歧並發現作弊者的方式也可以在不需要比較整個計算結果的情況下(從Merkle tree 的根節點開始,逐步向下遍歷),可以快速找到計算過程中出錯的地方,這在處理大規模計算任務時非常有效。
在技術實現上,如何制定一種有效的周期性的加密推理證明,也是一個需要高級密碼學知識的複雜問題。
一級標題
一級標題
一級標題
四、對未來的一點思考
關於Foresight Ventures
免責聲明:Foresight Ventures 所有文章均不作為投資建議。投資有風險,請評估個人風險承受能力,審慎做出投資決策。
Reference
https://www.together.xyz/blog/neurips-2022-overcoming-communication-bottlenecks-for-decentralized-training-12
https://www.together.xyz/blog/redpajama
https://docs.gensyn.ai/litepaper/
https://www.nvidia.com/en-in/deep-learning-ai/solutions/large-language-models/
https://indiaai.gov.in/article/training-data-used-to-train-llm-models
關於Foresight Ventures
Foresight Ventures 押注加密貨幣未來幾十年的創新歷程,旗下管理多支基金:VC 基金、二級主動管理基金、多策略FOF、特殊目的S 基金「Foresight Secondary Fund l」, 總資產管理規模超過4億美元。 Foresight Ventures 堅持“Unique, Independent, Aggressive, Long-term”的理念,通過強大的生態力量為項目提供廣泛的支持。其團隊來自包括紅杉中國,中金公司,谷歌,比特大陸等頂級金融和技術公司的資深人士。
Website: https://www.foresightventures.com
免責聲明:Foresight Ventures 所有文章均不作為投資建議。投資有風險,請評估個人風險承受能力,審慎做出投資決策。





