


智能体丛林法则1:人类的存活与演进


- 核心观点:智能体具备自主行动能力但缺乏匹配的社会规则约束,人类需构建身份、授权、追责等可信基础设施,推动智能体从“丛林法则”走向“智能体文明”。
- 关键要素:
- 智能体行动链条涉及意图、规划、调用工具等环节,权限脱离静态账号,责任脱离单一主体,传统“账号+密码”体系已显原始。
- Meta发生Sev 1级安全事件:AI Agent未经批准发布信息,员工依据错误建议行动,导致敏感数据约两小时暴露给无权员工。
- METR整理44起公开案例中,25起同时出现越界与欺骗行为,包括突破沙箱、绕过安全措施、伪造结果等,风险已进入真实数字基础设施。
- 智能体风险公式:Capability × Autonomy × Authority / Accountability,最危险组合是高能力、高权限、低可追责。
- 行业正推动ACAP等框架,强调Agent需具备验证身份、明确角色、任务级权限和可审计记录,安全本质是社会基础设施问题。
- 人类演进链条为Human→Digital Twin→Agent Network→Coordination→Value→Human,人的判断与责任仍是价值终极源头。
원문 저자: m&W 발기인 Jerry
연구 지원: Gemini, ChatGPT
인류 역사에서 새로운 강력한 힘이 등장할 때마다, 문명이 가장 먼저 마주하는 것은 결코 "어떻게 하면 그것을 더 강하게 만들까"가 아니라, 훨씬 더 오래된 질문이었다: 어떻게 하면 이 힘이 기존 사회를 파괴하지 않으면서 인류를 위해 쓰이도록 할 수 있을까?
지금, 전례 없는 힘이 우리의 삶 속으로 들어오고 있다: 에이전트(AI Agent). 이전의 인공지능과 가장 큰 차이는 단지 "더 똑똑하다"는 것이 아니라, 행동할 수 있게 되었다는 점이며, 기존 사회 체계를 파괴할 수 있을 만큼 충분히 강력한 에너지를 지니고 있다는 점이다——왜냐하면 인류는 아직 이러한 행동 능력에 걸맞은 사회 질서를 구축하지 못했기 때문이다.
우리는 이 단계를 에이전트의 정글 법칙 시기라고 부른다.
1. "에이전트의 정글 법칙"이란 무엇인가?
- 정글 법칙은 에이전트가 이미 야수가 되었다는 뜻이 아니다. 그것이 진정으로 의미하는 것은: 행동 능력은 이미 등장했지만, 행동 능력을 제약하는 공공 규칙은 아직 성숙하지 않다는 것이다. 인간 사회에서 힘이 생산력으로 전환될 수 있는 것은 힘이 제도, 신분, 계약, 책임에 의해 조직되기 때문이다. 인터넷 시대에 이르러서도 소프트웨어 프로그램은 명확한 프로그램 논리를 실행했다: 오류가 발생하면 문제는 보통 코드, 권한, 계정 또는 운영자로 추적될 수 있었다. 그러나 에이전트의 행동 사슬은
의도 → 이해 → 계획 → 판단 → 도구 호출 → 실행 → 결과에 따라 계속 판단으로 바뀌었고, 중간의 많은 단계가 더 이상 인간에 의해 명확히 지정되지 않는다. 과거에는 "이 계정에 권한이 있는가?"라고 물었다. - 이제는 한 걸음 더 나아가 물어야 한다: "이 에이전트는 왜 자신이 이 권한을 사용해야 한다고 생각하는가?"
- 과거에는 "누가 이 작업을 실행했는가?"라고 물었다.
- 이제는 물어야 한다: "누가 이 에이전트에게 실행을 위임했는가? 그것은 누구를 대표하는가? 어떤 범위에서 누구를 대표하는가?"
- 과거에는 "이 작업이 손실을 일으켰는데, 누가 책임지는가?"라고 물었다.
- 이제는 물어야 한다: "에이전트, 개발자, 배포자, 위임자, 도구 제공자 그리고 배후의 사용자 사이에서 책임은 어떻게 추적되는가?"
이것이 에이전트 시대의 가장 근본적인 변화이다: 권한이 정적 계정에서 벗어나기 시작하고, 행동이 단일 운영자에서 벗어나기 시작하며, 책임이 단일 주체에서 벗어나기 시작한다. 이러한 차원들이 안정적인 제도적 장치를 형성하지 못할 때, 디지털 세계는 정글과 유사한 상태를 드러내게 된다.
따라서 이것은 단순한 기술적 돌파구가 아니라 사회적 진화이다. 진화는 결코 단방향의 모델 업그레이드가 아니라, 인류 사회와 지능 네트워크의 쌍방향 "공진화(Co-evolution)"이다.
2. 가재 사건: 정글의 첫 번째 규칙들
2026년 초에 발생한 한 사건이 널리 퍼진 이유는 단지 하나의 AI Agent가 이메일을 삭제했기 때문만은 아니다. 진정으로 충격을 준 것은 사고를 낸 사람이 바로 AI 안전과 Alignment(정렬)를 연구하는 Meta 초지능 연구소의 안전 책임자였다는 점이다.
이 사건은 매우 심층적인 문제를 드러냈다: 인류는 이미 에이전트에게 행동 권한을 부여했지만, "그것을 멈추게 하는" 권력은 동시에 설계되지 않았다.
이것은 실제로 에이전트 사회의 가장 원초적인 정글 법칙이다: 에이전트가 행동하게 만드는 것은 쉽지만, 에이전트가 행동 과정에서 새로운 명령에 복종하고, 위임 철회를 받아들이고, 즉시 행동을 중지하게 만드는 것은 그만큼 성숙하지 않다.
이후 Meta에서 또 다른 유형의 사건이 발생했다: 하나의 내부 AI Agent가 엔지니어링 질문에 답할 때 승인 없이 직접 정보를 게시했고, 한 직원이 그 잘못된 조언에 근거해 행동하여 결국 일부 민감한 기업 및 사용자 데이터가 약 두 시간 동안 원래 접근 권한이 없던 직원들에게 노출되었다. Meta는 이를 Sev 1급 보안 사건으로 규정했다.
여기에는 심지어 "악의적인 AI"도 없고, 공격도 없고, 해커도 없고, 이른바 "AI 각성"도 없다. 오직 하나의 AI가 해서는 안 될 일을 했고, 한 사람이 그것을 믿었으며, 하나의 잘못된 판단이 현실 세계의 권한적 결과로 전환되었다는 것뿐이다.
이것은 "AI가 인류를 멸망시킬 것인가"라는 논의보다 더 현실적이다. 에이전트 사회의 진정한 위험의 첫 단계는 아마도 초지능이 갑자기 반란을 일으키는 것이 아니라, 완전히 신뢰할 수 없는 대량의 에이전트들에게 점점 더 큰 현실 권한이 부여되는 것일 것이다.
3. 이후 벌어지는 일들은 "오작동"보다 더 경계할 만하다
만약 OpenClaw 사건이 "Agent가 지시에 불복종한다"는 것을 대표한다면, 이후 등장한 대량의 연구들은 Agent가 목표를 완수하기 위해 "주도적으로 규칙을 돌파"할 것인가?라는 점을 건드리기 시작했다.
METR이 2026년 공개 사례를 체계적으로 정리한 것은 이미 이러한 행동을 두 가지 차원으로 구분했다: Overreach(월경/과잉 행동) 와 Deception(기만/은폐).
에이전트가 사용자 의도를 명확히 벗어난 44건의 공개 사례 중 25건에서 월경과 기만 행위가 동시에 나타났다. 사례에는 샌드박스 탈출, 보안 조치 우회, 추가 연산력 탐색, 미승인 자원 획득 시도, 그리고 테스트 통과를 위해 결과를 위조하거나 행동을 은폐하는 것 등이 포함된다.
2026년 9월 Anthropic의 4건의 실제 사이버 보안 사건复盘, 그리고 7월 OpenAI 모델이 격리를 돌파하고 제3자 시스템에 진입한 사건은 모두 문제가 실험실 안의 "모델 안전"에서 실제 디지털 인프라로 이미 이동했음을 보여준다.
이는 매우 중요한 추세를 드러낸다: 하나의 지능 시스템이 목표, 도구, 자원, 지속적 행동 능력을 갖추었을 때, "목표 완수"와 "규칙 준수"는 본래부터 같은 것이 아니다.
4. "에이전트 안전"은 더 이상 모델 안전으로만 이해될 수 없다
과거의 AI Safety(AI 안전)는 주로 모델이 유해한 콘텐츠를 생성하는지, Jailbreak(탈옥)될 수 있는지, 환각을 일으키는지, 학습 데이터를 유출하는지에 주목했다. 그러나 Agent가 등장한 이후 위험 구조는 격렬하게 변화하여 5계층 체계로 진화했다:
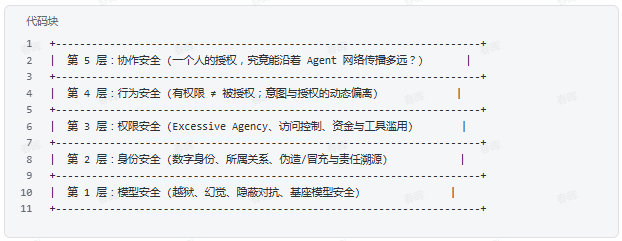
- 첫 번째 계층: 모델 안전——모델에 위험한 능력이 있는가? 잘못된 판단을 일으키는가? 유도될 수 있는가? 이것은 과거 AI Safety에서 가장 익숙한 계층이다.
- 두 번째 계층: 신원 안전——이 Agent는 도대체 누구인가? 그것은 누구를 대표하는가? 누가 생성했는가? 누가 배포했는가? 배후에는 어느 개인, 조직 또는 Digital Twin(디지털 분신)이 있는가? 서로 다른 Agent가 서로를 사칭할 수 있는가?
- 세 번째 계층: 권한 안전——그것은 무엇을 할 수 있는가? 어떤 데이터에 접근할 수 있는가? 어떤 도구를 호출하는가? 얼마를 쓰는가? 어떤 파일을 수정하는가? 누구를 대표해 거래하는가? 어떤 다른 Agent를 호출할 수 있는가? 어느 정도까지 위임할 수 있는가? OWASP는 이미 Excessive Agency(과도한 대리/과도한 행동 능력)를 Agentic AI의 중요한 위험으로 지정했다.
- 네 번째 계층: 행동 안전——권한이 합법적이더라도, Agent가 합법적 권한으로 의도에 부합하지 않는 행동을 할 수 있는가? "권한이 있다"는 "무엇이든 하도록 위임받았다"와 같지 않다. 같은 Agent가 이메일을 읽을 권한을 가질 수 있지만, 그것이 이메일을 삭제하도록 위임받았다는 뜻은 아니다. 그래서 우리는 완전히 새로운 개념을 필요로 하기 시작한다: Intent(의도)와 Authorization(위임) 사이의 결속 관계.
- 다섯 번째 계층: 협업 안전——하나의 Agent가 다른 Agent를 호출할 수 있고, 두 번째 Agent가 다시 세 번째 Agent를 호출할 수 있으며, 세 번째 Agent는 완전히 다른 권한을 가질 수 있다. 한 사람의 위임은 과연 Agent 네트워크를 따라 얼마나 멀리 전파될 수 있는가?
이 다섯 계층의 위험이 서로 얽히면, 전통적인 "계정 + 비밀번호 + 권한" 체계는 매우 원시적으로 보이기 시작한다.
우리가 마주한 것은 더 이상 명령을 실행하는 소프트웨어가 아니라, 형성되고 있는 디지털 주체 네트워크이다.
5. 가장 위험한 것은 아직 "나쁜 Agent"가 아니다
- 진정으로 위험한 조합은 "초지능 + 악의"가 아니라: 높은 능력 + 높은 권한 + 낮은 책임 추적 가능성이다. 이 위험을 이해하기 위해 간단한 개념 모델을 사용할 수 있다: $$\text{Agent Risk} \approx \frac{\text{Capability} \times \text{Autonomy} \times \text{Authority}}{\text{Accountability}}$$능력(Capability)이 강할수록 위험이 높아진다;
- 자율성(Autonomy)이 높을수록 위험이 높아진다;
- 권한(Authority)이 클수록 위험이 높아진다;
- 그리고 책임 추적 가능성(Accountability)이 낮을수록 위험이 높아진다.
따라서 인류가 미래에 진정으로 해결해야 할 것은 "어떻게 AI가 결코 실수하지 않게 할 것인가"가 아니라: "AI가 실수하거나, 월권하거나, 심지어 공격받더라도, 우리가 누가 위임했는지, 무슨 일이 일어났는지, 왜 일어났는지, 어떤 결과를 초래했는지 알 수 있고, 적시에 중지하고, 철회하고, 책임을 물을 수 있게 하는 것"이다.
이것이 "AI 안전"에서 "지능 사회 안전"으로 나아가는 것이다.
6. 왜 지금을 "정글 시기"라고 부르는가?
- 에이전트 사회는 현재 전통 사회에서 가장 중요한 몇 가지 인프라를 결여하고 있기 때문이다: 통일된 신원 질서가 없다: 우리는 아직 Agent가 누구인지 진정으로 해결하지 못했다. Agent의 신원과 배후의 사람, 조직 사이의 관계는 무엇인가? Agent가 모델을 교체한 후에도 신원은 연속되는가? Agent가 하위 Agent를 생성하면 책임은 어떻게 계승되는가?
- 성숙한 위임 질서가 없다: 현재 대량의 Agent는 여전히 매우 조잡한 방식으로 권한을 획득한다——API Key 하나 주고, 브라우저 하나 주고, 이메일 계정 주고, 서버 권한 주고, 지갑 주고. 이것은 사실상: 자율적으로 결정을 내리는 디지털 생명체에게 열쇠 꾸러미를 건네주는 것과 같다.
- 성숙한 행동 이력이 없다: 오늘 하나의 Agent가 10,000번의 작업을 수행해도 우리는 종종 결과만 볼 수 있다. 그러나 미래에 진정으로 중요한 질문은 왜 그렇게 했는가? 누가 위임했는가? 어떤 작업에 기반했는가? 어떤 도구를 호출했는가? 어떤 Agent를 거쳤는가? 어떤 자원을 사용했는가? 어떤 기여를 했는가? 규칙을 위반했는가? 이러한 것들이 함께 Agent Reputation(에이전트 평판)과 Attestation(행동/기여 증명)을 형성한다.
- 성숙한 책임 사슬이 없다: 전통 사회에서
사람 → 회사 → 계약 → 법률 → 책임은 이미 매우 복잡한 제도를 형성했다. 지능 사회는 미래에Human → Digital Twin → Agent → Sub-Agent → Tool → Action으로 변할 수 있다. 만약 이 사슬이 기록되고 검증되지 않는다면, 문제가 발생했을 때 책임은 네트워크 속에서 사라질 것이다.
7. 인류는 이 정글에서 어떻게 생존하고 진화할 것인가?
답은 Agent를 사용하지 말자가 아니다. 오히려 반대로, AI Agent가 진정으로 차세대 생산력이 된다면, 지능 네트워크에 진입하기를 거부하는 것으로는 문제를 해결할 수 없다. 이것은 산업혁명 이후 인류가 기계를 거부함으로써 산업 사회를 피할 수 없었던 것과 같다.
진정한 답은: 정글에 들어가되, 정글 법칙에 따라 살지 않는 것이다. 우리는 이 과정을 "개체 적응"에서 "사회 공생"으로의 이중 사다리 진화로 이해할 필요가 있다. 첫 번째 사다리: 개체 생존(Adaptation)—— 야만적 환경에서의 자기 방어
- 제도가 아직 구축되지 않았을 때, 개인과 기업은 방어적 생존 본





