


Coinbase 以 90 億參數模型升級支付反詐欺:線上詐欺交易減少 30%


- 核心觀點:Coinbase 工程團隊披露其 Onramp 反詐欺 Agent 實踐:透過「傳統模型初篩+大模型讀交易序列」的分工架構,結合自有數據後訓練小參數模型,實現詐欺交易量下降 30%、詐欺金額下降 22%。
- 關鍵要素:
- 2026 年 10 月 Coinbase 連發三篇文章,介紹反詐欺 Agent 的搭建、模型選型與後訓練過程。
- 架構上,機器學習模型與規則引擎先處理單筆交易,Agent 僅在需要上下文時閱讀近期交易序列並輸出風險分類。
- 公司用自有歷史數據建立領域測試集,發現部分較新閉源模型雖精確率提升,但召回率、F1 及金額加權召回率反而下降。
- 對 90 億參數開源模型 Qwen3.5-9B 進行 RLVR 後訓練,在內部基準上較 Opus 4.5 精確率高 7.5 個百分點、召回率高 12 個百分點、F1 高 9.6 個百分點,金額加權召回率高 35.4 個百分點。
- 線上推理端到端延遲下降 55%,訓練成本低於 100 美元,模型僅輸出風險結論,處置動作由策略層與人工複核閉環執行。
圖 1|Coinbase 工程團隊公開了反詐欺 Agent 系列研究
一筆信用卡購買加密資產的交易,表面上只有金額、裝置和付款結果。詐欺者卻常常把攻擊拆成多次嘗試:先用小額交易測試卡片,再更換裝置、地址或支付工具,最後完成金額更大的購買。單看其中一筆,風險訊號可能很弱;把最近幾次動作放在一起,模式才會浮現。
2026 年 10 月 6 日至 8 日,Coinbase 連續發布三篇工程文章,介紹其為 Onramp 業務搭建反詐欺 Agent 的過程。Coinbase 先把大模型接在既有機器學習模型和規則引擎之後,用它閱讀交易序列;隨後建立領域測試集,比較不同版本的閉源模型;最後用自有詐欺數據對一個 90 億參數的開源權重模型進行後訓練。公司披露的線上實驗顯示,加入 Agent 後,詐欺交易數量下降 30%,詐欺金額下降 22%。後訓練模型在其內部基準上獲得更高的 F1 分數,端到端延遲也更低。
這些數字來自 Coinbase 自己的實驗,外部目前無法復現完整數據集。不過,這組實踐提供了一個很具體的企業 AI 樣本:在支付風控這種窄任務裡,模型的新舊和規模未必排在第一位。真正影響效果的,是企業有沒有可靠的結果數據、能不能建立接近真實業務的測試集,以及模型輸出怎樣進入原有決策系統。
一、傳統模型先篩一遍,Agent 負責閱讀交易過程
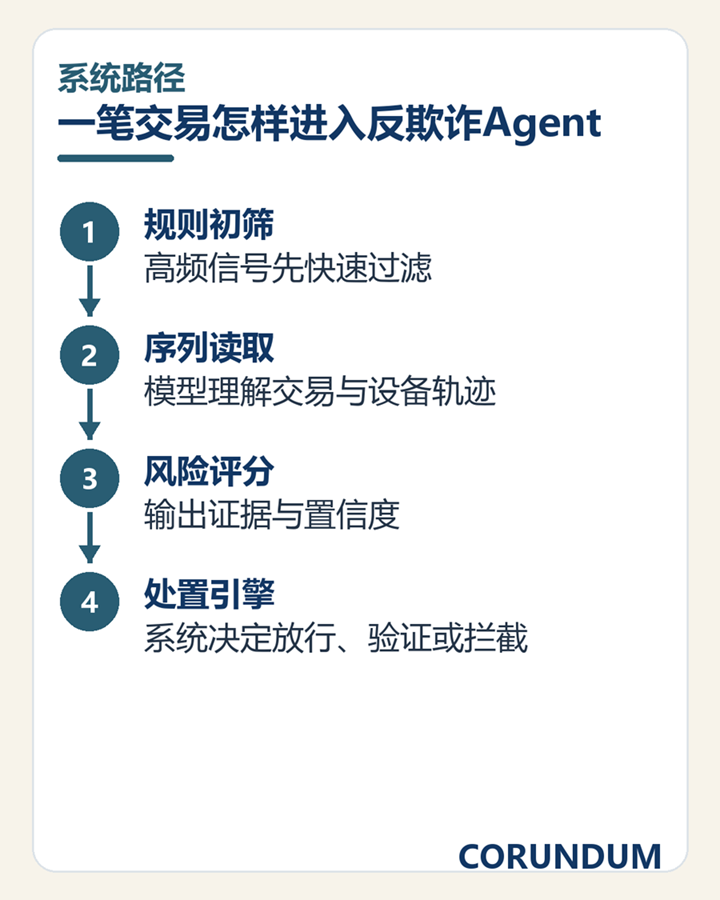
圖 2|一筆交易進入反詐欺 Agent 的處理路徑
Coinbase Onramp 讓用戶在合作應用內購買加密資產,其中部分場景允許訪客結帳。訪客沒有長期帳戶記錄,平台能夠使用的資訊主要來自當前付款和近期交易行為。原有機器學習模型擅長快速處理單筆交易特徵,規則引擎則攔截明確的異常條件,例如重複失敗、裝置突變或支付資訊不一致。
難點出現在連續動作裡。某次購買的金額和裝置都很普通,放回最近幾分鐘的交易序列後,它可能緊跟多次小額測試、銀行卡更換和地址變化。Coinbase 把近期交易按時間整理成上下文,再交給大模型判斷風險。模型輸出一個簡短的風險分類,後續程式依據這個分類決定放行、拒絕或進入人工複核。
這種結構保留了傳統風控系統的速度。絕大多數交易先由機器學習模型和規則完成處理,Agent 只在需要更多上下文時加入。它的任務也受到嚴格限制:閱讀已經整理好的交易資訊,識別序列中的關係,返回規定格式的結論。最終動作仍由系統中的策略層執行。
這套分工解釋了為什麼 Coinbase 把它稱為風險 Agent。它沒有自行調查客戶,也沒有自由調用所有內部系統。平台給它限定了數據範圍、問題形式和可返回的答案,模型因此能夠把注意力放在「這些交易連在一起是否異常」這個窄問題上。
二、模型升級可能悄悄改變風險尺度
第一階段上線後,Coinbase 遇到的下一個問題是選模型。通用基準往往告訴企業哪個模型整體能力更強,支付風控關心的指標卻更具體:詐欺交易能攔住多少,正常用戶會被誤傷多少,高金額詐欺是否被識別,以及每次判斷需要多長時間。
Coinbase 用自有歷史數據建立測試集,比較多個 Opus、Sonnet 和 GPT 版本。公司披露,部分較新的模型雖然精確率提高,召回率、F1 分數和按金額加權的召回率反而下降。精確率表示模型判為詐欺的交易中有多少確實是詐欺;召回率表示全部詐欺交易中有多少被找到。風控系統如果只追求較高精確率,可能減少誤傷,同時漏掉更多真實損失。
F1 分數用於綜合觀察精確率與召回率。簡單來說,它幫助團隊判斷模型是否只在某一個指標上表現漂亮。Coinbase 又加入按詐欺金額加權的召回率,因為漏掉一筆大額詐欺造成的損失,通常遠高於漏掉一筆小額交易。
模型升級由此成為一次風險政策變更。即便提示詞、接口和審批規則保持不變,新模型也可能重新理解可疑行為,把原來放行的交易轉入拒絕,或者放過舊版本能夠識別的詐欺。企業在生產環境切換模型前,需要使用自己的測試集重新驗證,不能直接把廠商公布的綜合排名當作上線依據。
三、90 億參數模型為什麼能超過更大的閉源模型
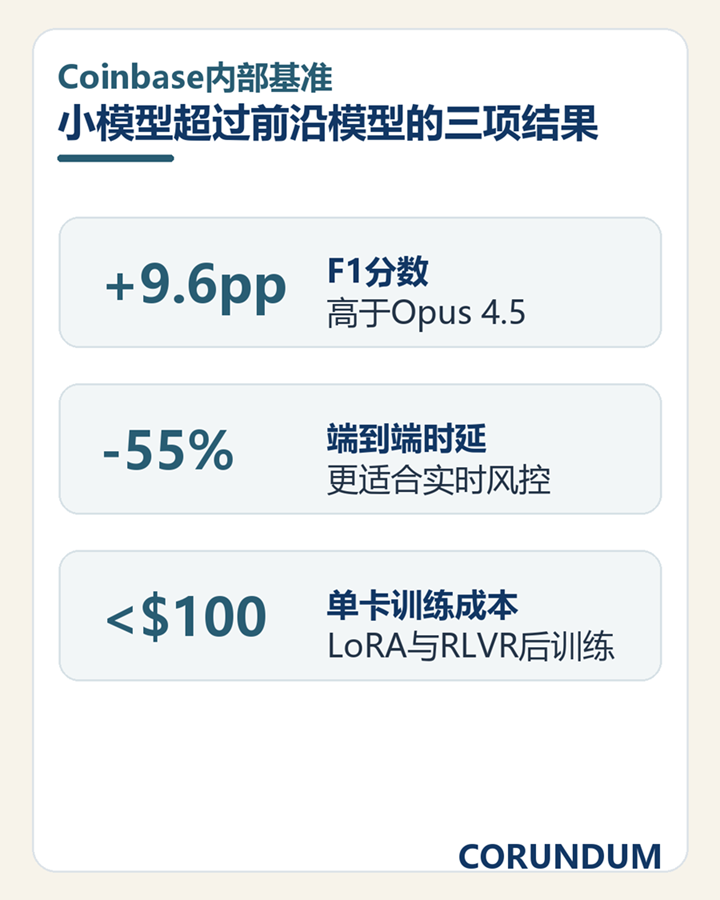
圖 3|Coinbase 內部基準顯示的小模型三項結果
Coinbase 隨後選擇 Qwen3.5-9B 進行後訓練。這個模型只有 90 億參數,可以在單張 NVIDIA RTX PRO 6000 96GB GPU 上訓練和部署。團隊把歷史交易結果轉化為可驗證獎勵:模型判斷與已知詐欺結果一致時獲得獎勵,判斷錯誤時受到懲罰,再通過強化學習調整模型。
這裡使用的 RLVR 全稱是「可驗證獎勵強化學習」。支付交易最終會產生拒付、確認詐欺或正常完成等結果,這些結果可以作為相對明確的訓練訊號。模型不需要另一個大模型來評價回答是否「像一個好判斷」,它面對的是已經發生的業務結果。
詐欺樣本數量通常遠少於正常交易。如果獎勵函數只看整體準確率,模型把幾乎所有交易判為正常,也可能得到一個看起來不錯的數字。Coinbase 因此平衡了詐欺和正常樣本的貢獻,並使用 LoRA 訓練少量附加參數,讓模型學習 Onramp 業務中的詐欺模式。
公司披露,後訓練模型在內部基準上相較 Opus 4.5 的精確率高 7.5 個百分點、召回率高 12 個百分點、F1 高 9.6 個百分點,按金額加權的召回率高 35.4 個百分點。線上推理的端到端延遲下降 55%,訓練成本低於 100 美元。這些結果針對一項狹窄分類任務,顯示領域適配可以把一個較小模型訓練成更合適的生產工具。
四、模型只給風險結論,系統決定如何處置
Coinbase 沒有讓模型直接控制交易。Agent harness 負責把交易資訊整理成輸入,再把模型返回的風險分類翻譯成系統能夠執行的動作。訓練階段可以要求模型解釋理由,線上支付只需要一個緊湊的風險結果,以減少延遲和格式錯誤。
這一層中間程式很重要。它規定模型能夠看見哪些欄位,如何處理缺失值,返回哪些類別,超過多長時間視為失敗,以及模型無響應時回到哪套舊規則。模型版本可以更換,支付系統的權限邊界繼續由程式控制。
人工複核仍然保留。高風險交易、模型與傳統規則發生衝突的交易,或者涉及較大金額的邊緣樣本,可以進入人工隊列。複核結果隨後成為新數據,幫助團隊發現測試集沒有覆蓋的詐欺手法。模型、規則與人工判斷由此形成持續更新的閉環。
這種閉環也帶來新的治理要求。企業需要記錄模型版本、輸入欄位、風險結論和最終處置,才能在投訴、拒付或監管檢查中還原當時的決定。訓練數據包含支付行為和裝置資訊時,還要控制數據訪問、保存期限和後續訓練用途。
五、企業選擇模型的方法正在改變
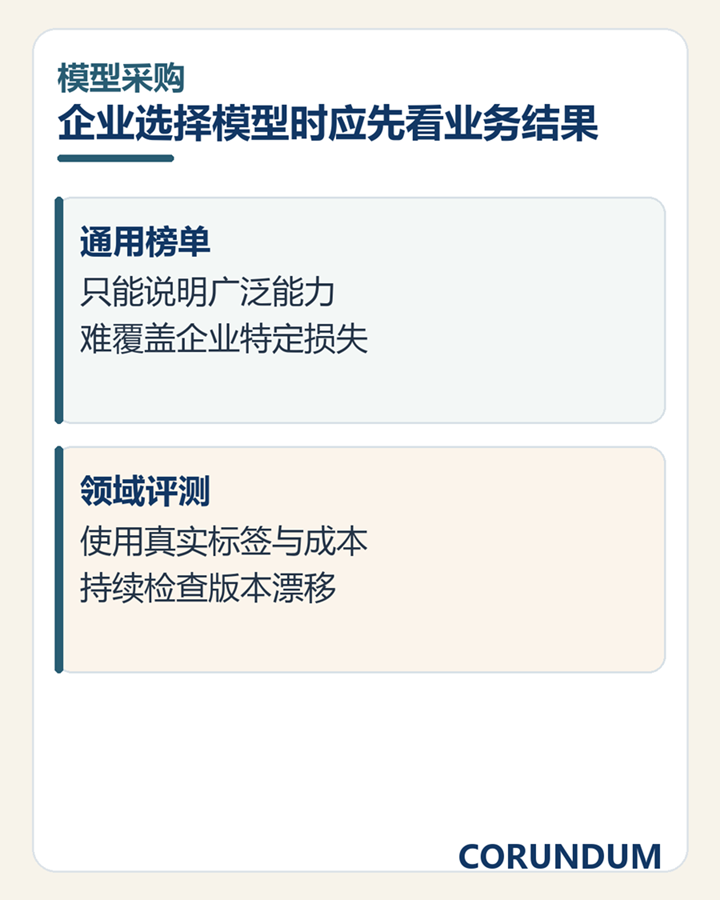
圖 4|企業模型採購從通用榜單轉向領域評測
大模型採購過去常常圍繞通用能力、上下文長度和廠商品牌展開。Coinbase 案例把選擇標準拉回到具體業務:測試數據是否接近真實流量,錯誤成本怎樣分布,系統能承受多長延遲,模型是否能夠在現有基礎設施中穩定運行。
對金融機構而言,這意味著模型評估要與風險政策一起設計。反詐欺、反洗錢、信用審核和異常交易識別都存在樣本不平衡,單一準確率很容易掩蓋問題。團隊需要同時觀察召回率、誤報率、金額損失和客戶轉化,再確定放行閾值。
開源權重模型也因此獲得新的位置。企業能夠在自有環境中訓練和部署,保留模型權重、服務方式和版本節奏的控制權。代價是企業要承擔訓練安全、模型評估、基礎設施和持續維護工作。擁有數據並不足夠,數據還要能夠映射到清楚的業務結果。
Coinbase 的實踐最後落在一個樸素的判斷上:支付風控不需要一個能夠回答所有問題的模型。它需要一個熟悉這類交易、反應足夠快、錯誤能夠被衡量,並且始終留在既定權限內的模型。企業 AI 進入生產系統後,最有價值的能力往往來自這類窄而穩定的適配。
本文僅用於法律、政策及行業研究交流,旨在對數字金融、穩定幣、數字資產及相關監管動態進行客觀分析,不構成任何形式的投資建議、法律意見、稅務意見或其他專業建議,也不構成任何金融產品、數字資產或商業項目的推薦、宣傳或招攬。文中涉及的監管規則、市場數據及機構資訊主要來源於公開資料,可能因法律法規、監管政策、市場環境及項目進展變化而發生調整,請讀者結合最新公開資訊獨立判斷,並遵守所在國家或地區適用的法律法規。作者及發布平台不對任何因依賴本文內容所產生的投資、交易或其他商業決策承擔責任。





