






DePin賽道的落地應用展示:Utility AI容器雲使用報告


DePin ,是Decentralized Physical Infrastructure Networks(中心化實體基礎設施網絡) 的簡稱。 DePin 概念核心在於利用代幣激勵用戶部署硬體設備,以提供真實世界的商品與服務或數字資源例如算力、儲存和網路帶寬等。根據Messrai 報導,目前整個賽道估值大概在90 億美金左右,到2028 年預計將成長到3.5 兆美金的規模。
目前符合DePin 概念的項目也有不少,其中主打分散式AI 算力調度的UtilityNet(以下簡稱Utility)經過一年來的發展,在近期剛推出基於TPU(AI 專用加速芯片)和相關智算服務器構建的AI 容器雲測試平台。有興趣的AI 開發者透過Utility 官方Twitter 帳號公佈的郵件地址,可以申請參與Utility AI 容器雲的測試,以此獲得一定的AI 雲算力進行大模型的部署和推理。這些雲端算力背後的晶片和設備都是由參與目前封閉測試期的Utility 礦工提供的。
Utility 創新的提出了一個全新的Proof Of ComputationIntegrity(簡稱POCI,中文翻譯為“可信計算”)共識機制,通過AI 專用芯片內部的安全引擎模組,結合鏈上的加密學原理,讓芯片能夠自我證明,從而達到不損耗算力就可以獲得激勵的目的。因為過去流行的POW 共識把設備算力在挖礦過程中都已經消耗殆盡了,這顯然跟DePin 理念是衝突的,算力被挖礦消耗掉,就無法流轉給真正的需求方。因此,Utility 這套創新POCI 共識為其Token 真正的實現算力從礦工到租用者之間的流轉提供了現實的解決方案。
身為AI 開發者,已關注Utility 這個專案一段時間,在透過官方頻道申請並試用了測試版的Utility AI 容器雲之後,為大家分享一下相關的試用報告。
基於Utility 去中心化的挖礦激勵原理,Utility AI 容器雲的使用界面設計了礦工管理端與芯片客戶端,區分不同的用戶與操作邏輯,使得Utility AI 容器雲平台中不同類型的用戶可以出色地協調配合,以完成算力從礦工到算力租用者之間的流轉。
一、 Utility AI 容器雲礦工管理端
1.礦工管理端說明
Utility AI 容器雲礦工管理端具有獨立的存取入口頁面,目前測試版存取地址為https://cloud.utlab.io/admin/#/,登入頁面如下:
2.平台監控
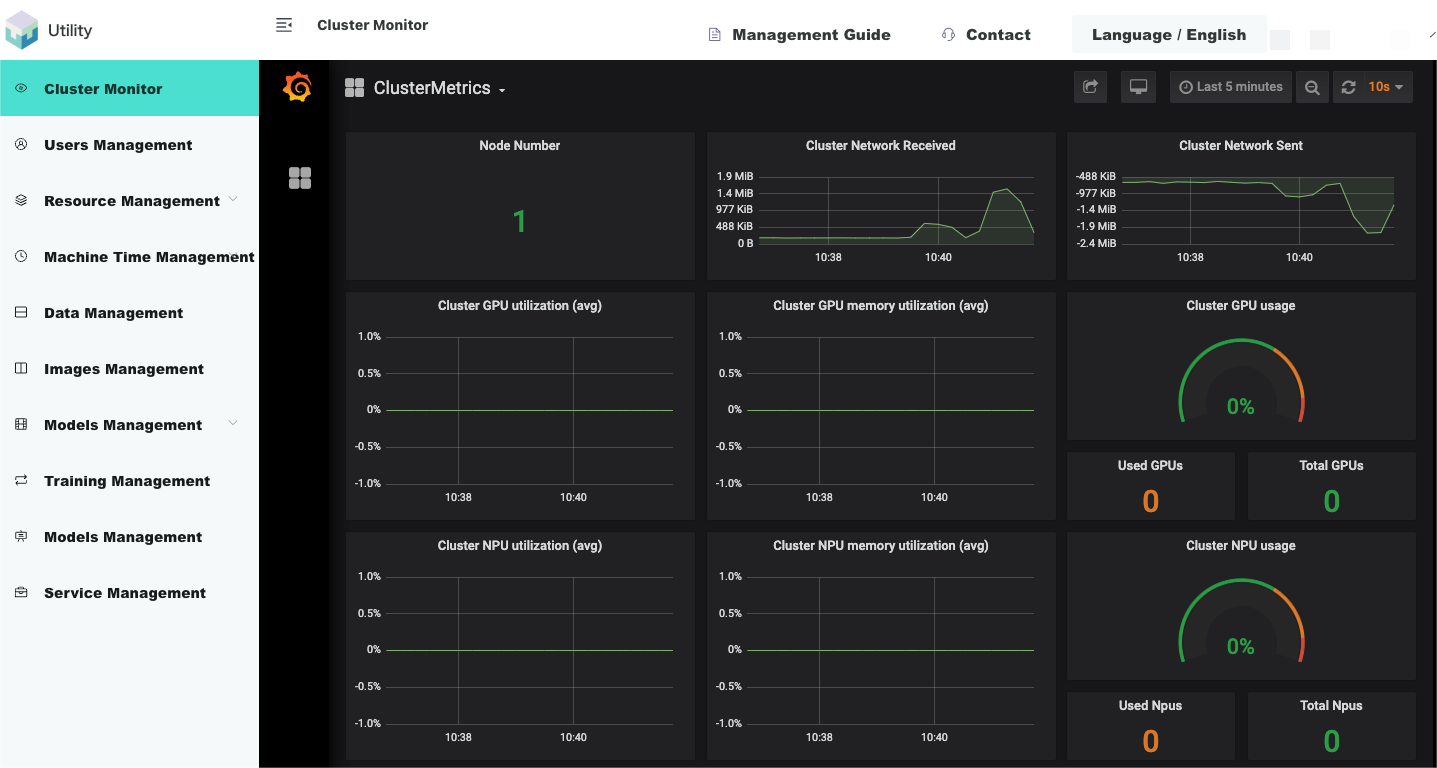
Utility AI 容器雲的監控架構為NodeExporter+Prometheus+Grafana,以物件導向為叢集監控和訓練任務監控,以Grafana 網頁的形式展示。 NodeExporter 可以收集到節點的各種資源信息,使用情況,並以prometheus 支援的資料格式儲存與本機檔案。 Prometheus 以Pull 的形式,將每個節點的NodeExporter 服務的本機資料收集匯集到其中心資料庫。 Grafana 網頁前端服務啟動前配置好Prometheus 的數據庫API 呼叫路徑,定時請求Prometheus 的數據指標,就可向礦工動態地展示集群和平台中所有AI 芯片用戶正在運行的任務的指標數據的圖表。
叢集監控
叢集監控以Grafana 網頁的形式內嵌於管理端網頁內。
如下圖,【登錄管理網路端/叢集監控】展示了叢集資訊:
3.資源管理
Utility AI 容器雲礦工管理端支援對平台硬件資源進行便利管理。平台資源管理模組可分為服務器節點、系統資源、自訂資源、資源規格、資源池。
節點
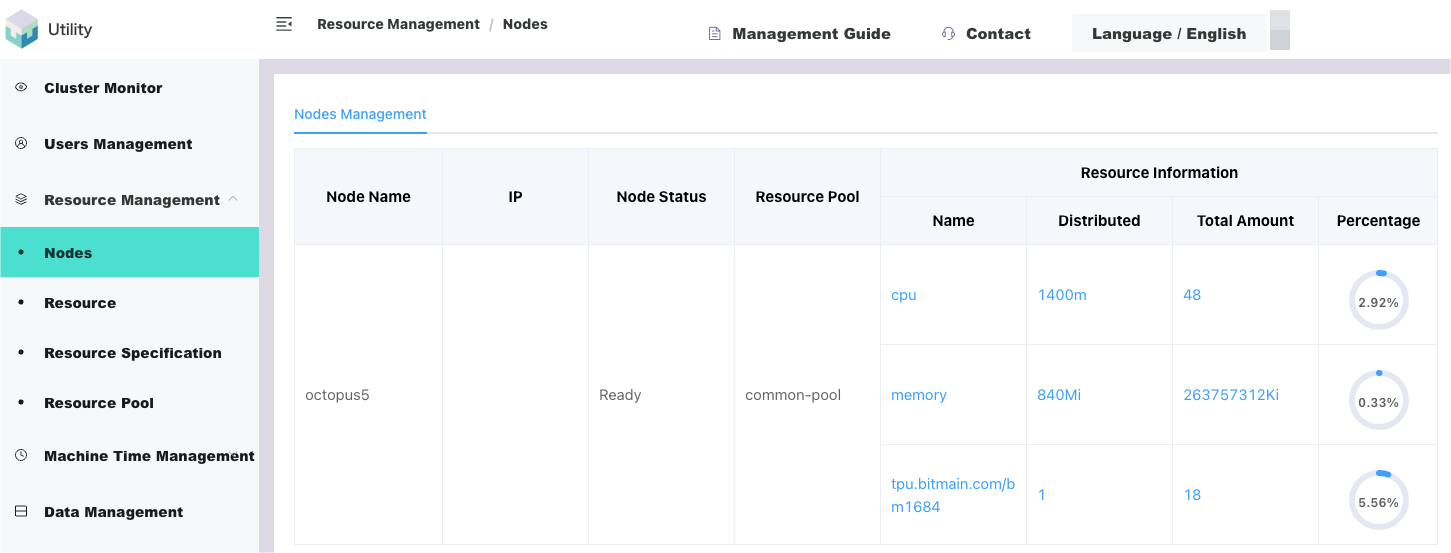
節點即服務器,平台底層叢集系統在啟動的時候會自動發現已經組成叢集的伺服器,發現其各種屬性。如IP、Hostname、所賦予的標籤、是否Ready 的狀態、擁有何種資源等詳情。
如下圖,【登錄礦工管理端/資源管理/節點】展示了系統自動發現的節點清單:
資源
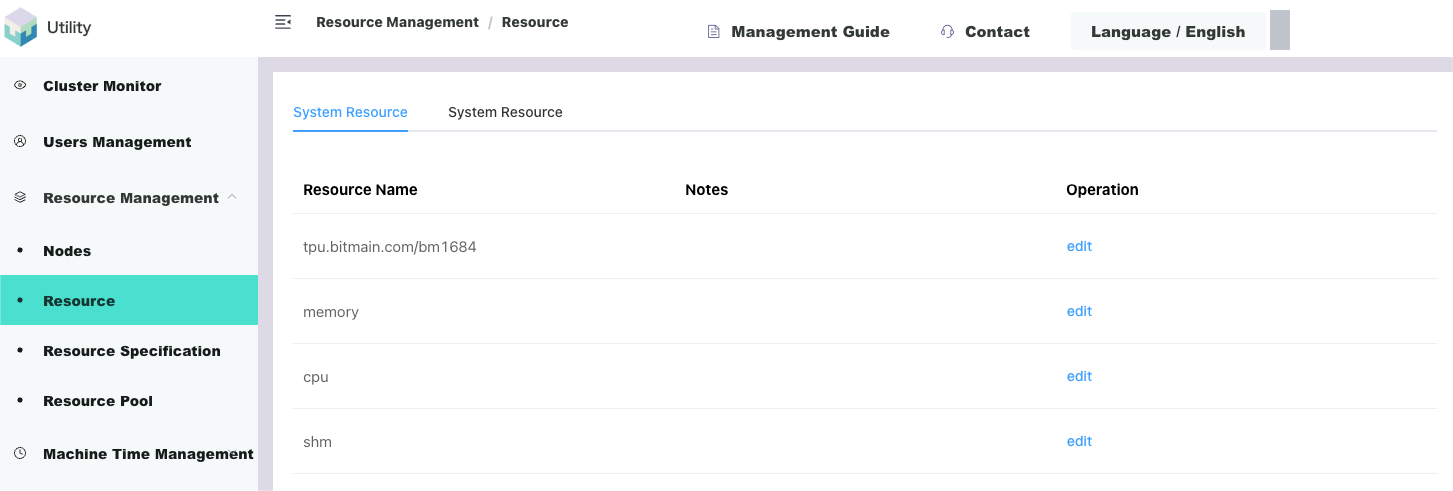
從物理上看,所有資源都組裝於伺服器節點,並由平台系統自動發現,也就是系統資源。系統資源有各種名字,各種區分形式,它可以根據各種邏輯來劃分。
如下圖,【登錄礦工管理端/資源管理/資源】展示了自動發現的系統資源清單:
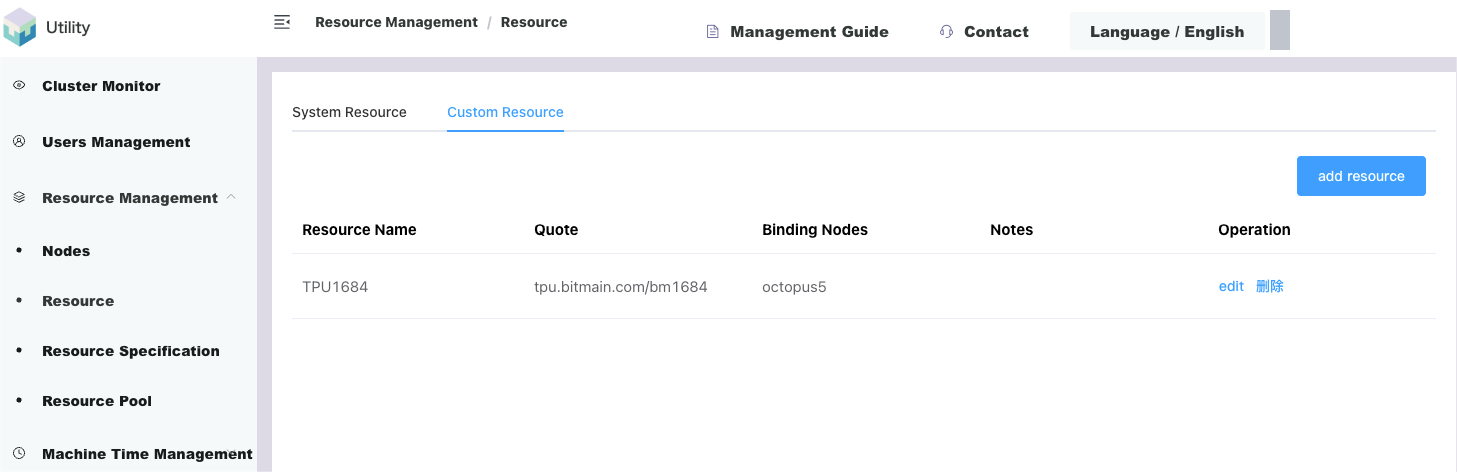
為了方便管理、友善展示、感性利用,平台設計了自訂資源功能,礦工可根據不同的邏輯將現有的系統資源重新定義為一種新的自訂資源。
如下圖,【登錄礦工管理端/資源管理/資源/自訂資源】可依系統資源增加自訂資源--TPU 1684 或TPU 1684 X(1684 系列是AI 晶片名稱):
資源規格
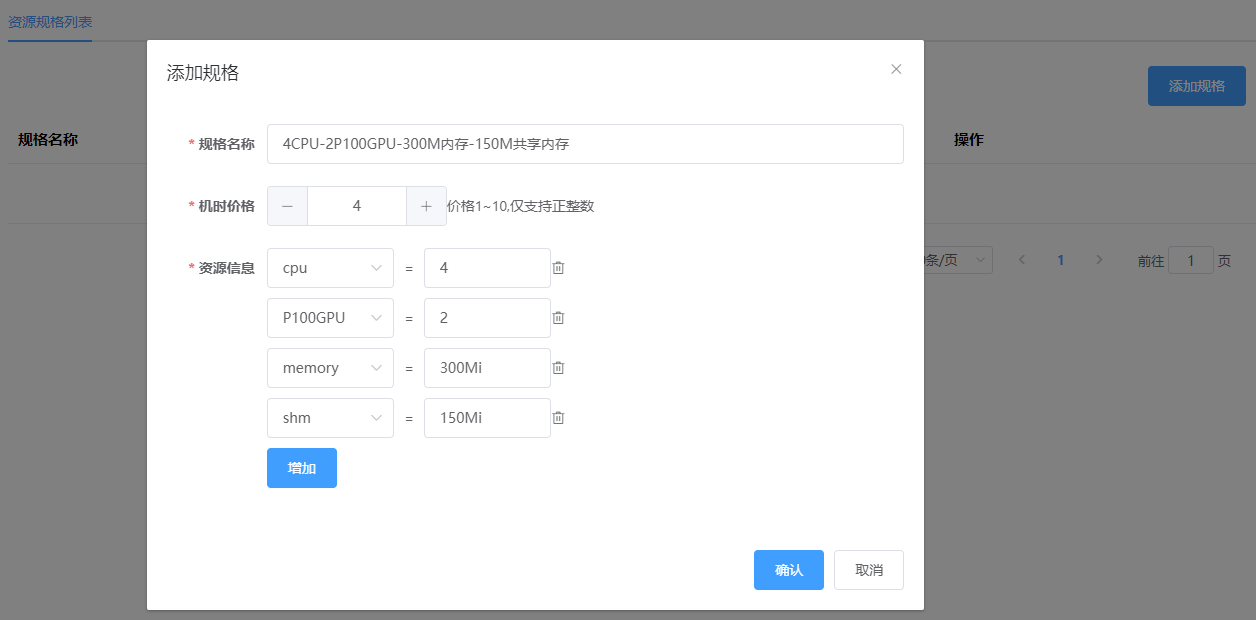
為了更好地向用戶展示平台所擁有的資源還有更好地統計用戶使用資源的情況。平台將伺服器上組裝的不同種類的資源歸為一個群組,這種將資源歸為群組的功能即是資源規格。管理員定義好資源規格的名字,使用者就可感性地從資源規格名字中獲取資源的信息,選擇自己想要的資源組用於運行自己的任務。
如下圖,【登錄管理網頁端/資源管理/資源規格】可依所有資源建立資源規格(4 CPU-2 GB-2 TPU 1684):
資源池
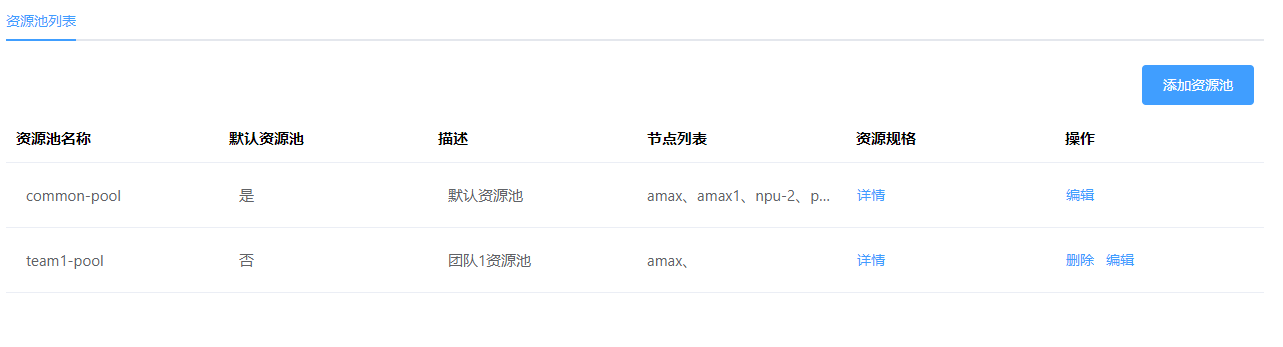
資源池用於隔離叢集的伺服器資源。縱向看,資源以服務器節點為粒度。橫向看,資源又以資源規格為粒度。服務器節點面向管理員,資源規格面向使用者。自然地,如果要更好地將資源與使用者解耦與隔離,則需要一個資源池的概念。資源池將資源邏輯地重新分割,Utility AI 容器雲以服務器節點為粒度,將資源以服務器節點的形式整體劃分到不同的資源池,不同的資源池可以綁定到使用者群組。以這樣的形式,可以很好地將叢集的資源隔離,不同的資源可指派給不同的使用者群。
如下圖,【登錄礦工管理端/資源管理/資源池】系統自帶的預設資源池初始化包含所有資源節點,也可依不同業務邏輯點選按鈕建立新的資源池:
礦工管理端支援對平台硬件資源進行便捷管理。平台資源管理模組可分為服務器節點、系統資源、自訂資源、資源規格、資源池。
4.機時管理
礦工可以根據UNC/機時的價格設定租用各種AI 晶片費用,當算力租賃用戶購買了晶片租用訂單,AI 晶片容器任務啟動時間開始,平台會扣取相應的機時。平台依資源規格設定單價UNC/機時,計費規則如下:
AI 晶片容器任務機時= 子任務1 機時+ 子任務2 小時+ ... + 子任務n 機時
子任務機時= 副本1 機時+ 副本2 機時+ ... + 副本n 機時
副本機時= 資源規格* (副本運轉終止時間- 副本運轉起始時間)
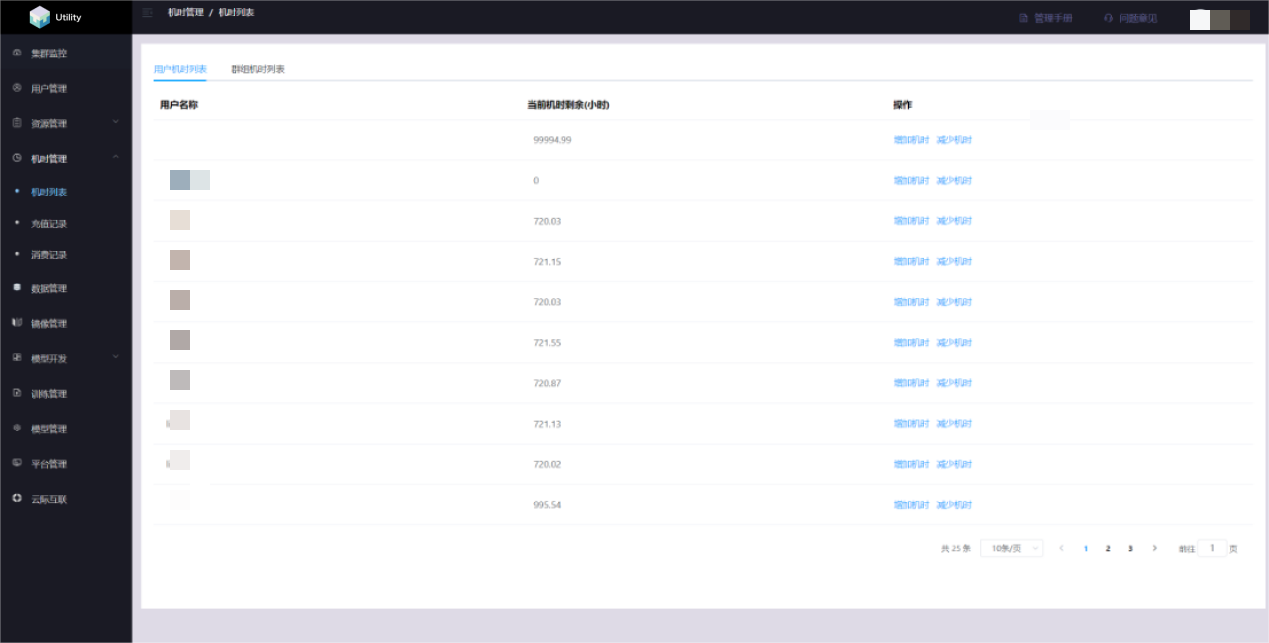
機時管理包括機時列表,儲值記錄和消費記錄
用戶機時列表
二、 AI 容器雲晶片客戶端
1. 用戶使用說明
Utility AI 容器雲晶片客戶端的存取位址為https://console.utlab.io/utnetai/,登入頁面如下:
2. 概覽
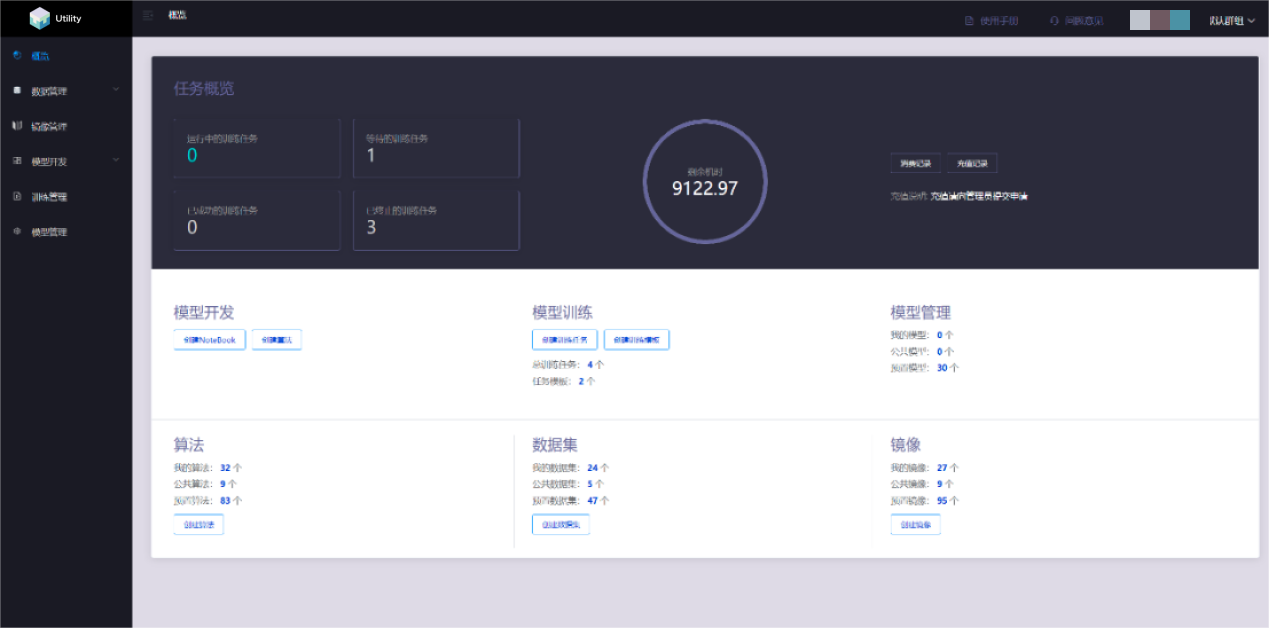
概覽頁用於展示不同狀態的訓練任務的個數信息,剩餘機時信息,消費及充值記錄信息,同時向用戶提供快速創建Jupyter notebook,算法,訓練任務,任務模板,算法,數據集,鏡像功能。
3. 模型開發
Jupyter notebook 管理
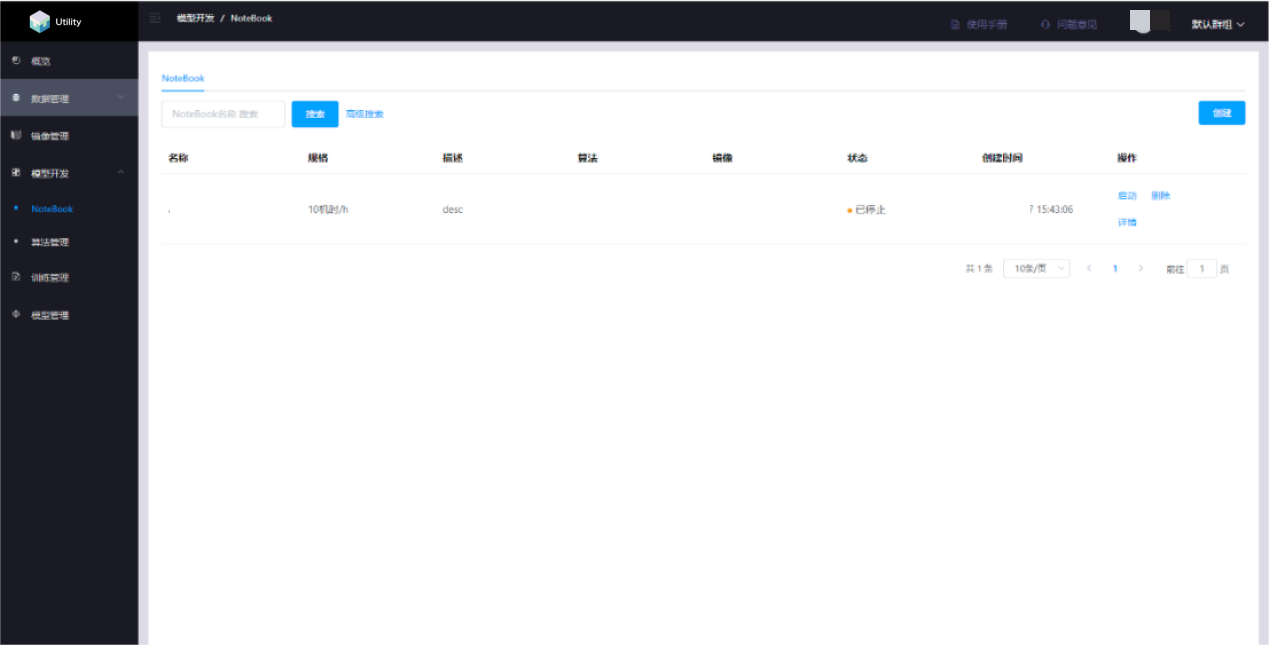
Jupyter notebook 管理提供線上程式設計環境,用來調試、運行和保存演算法以支援後續的模型訓練。此模組支援開源的JupterLab,使用者需要事先製作包含Jupyterlab 程式的鏡像。使用者可以建立、開啟、啟動、停止、刪除notebook,使用者在JupterLab 裡編輯演算法將會自動儲存
建立notebook
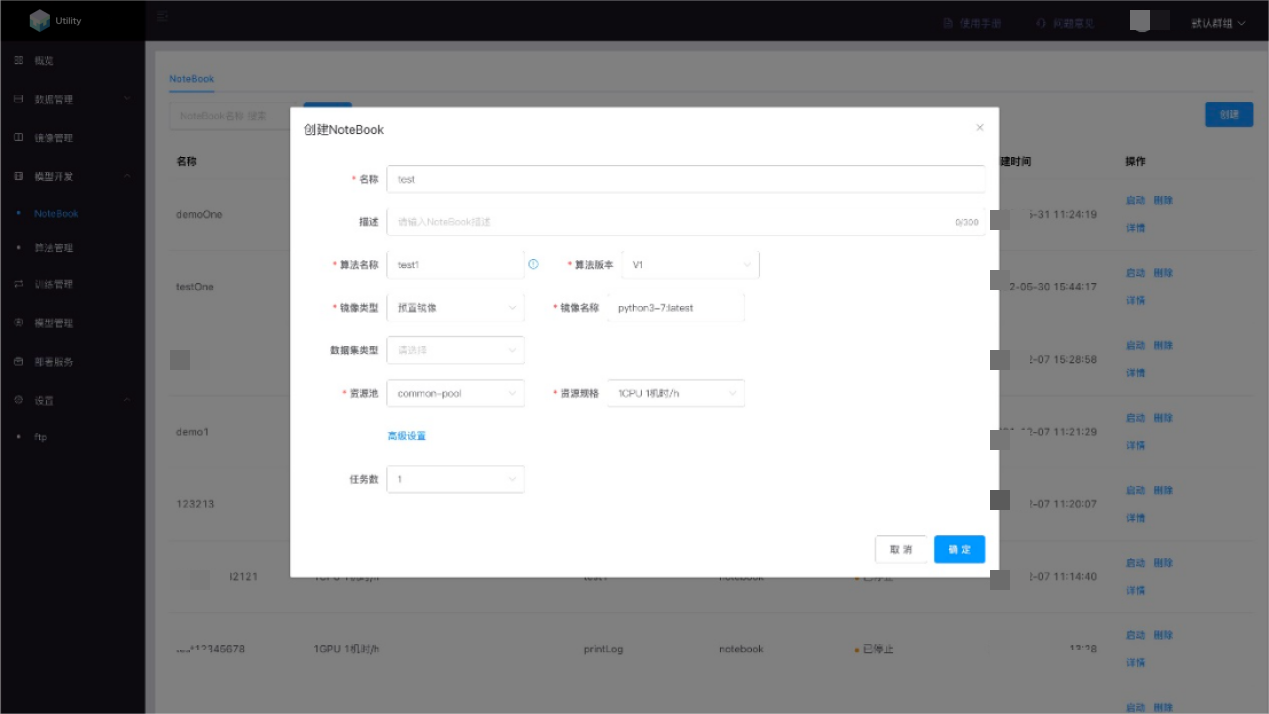
點選建立按鈕,選擇對應算法、鏡像、資料集(選用)和資源,可在「進階設定」中選擇任務數,點選確定建立notebook。
開啟notebook
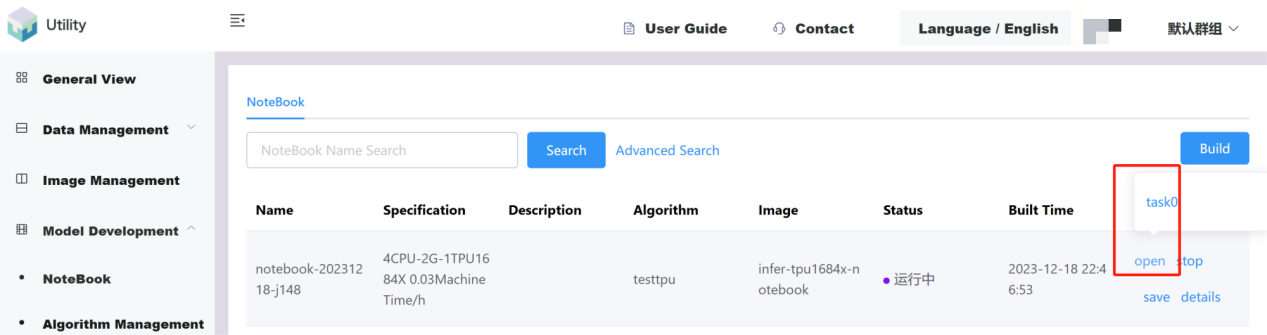
點選開啟按鈕,彈出懸浮窗,選擇對應子任務,開啟notebook
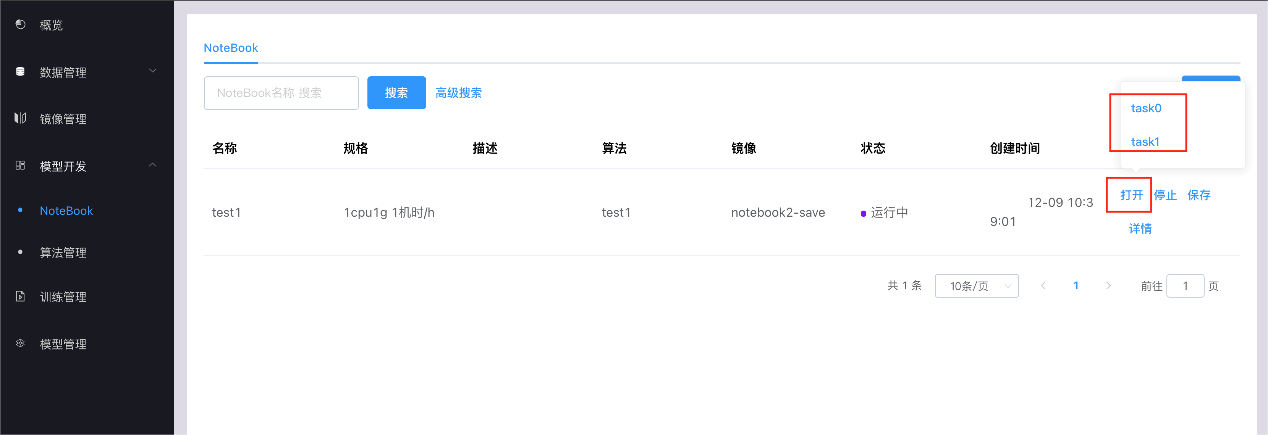
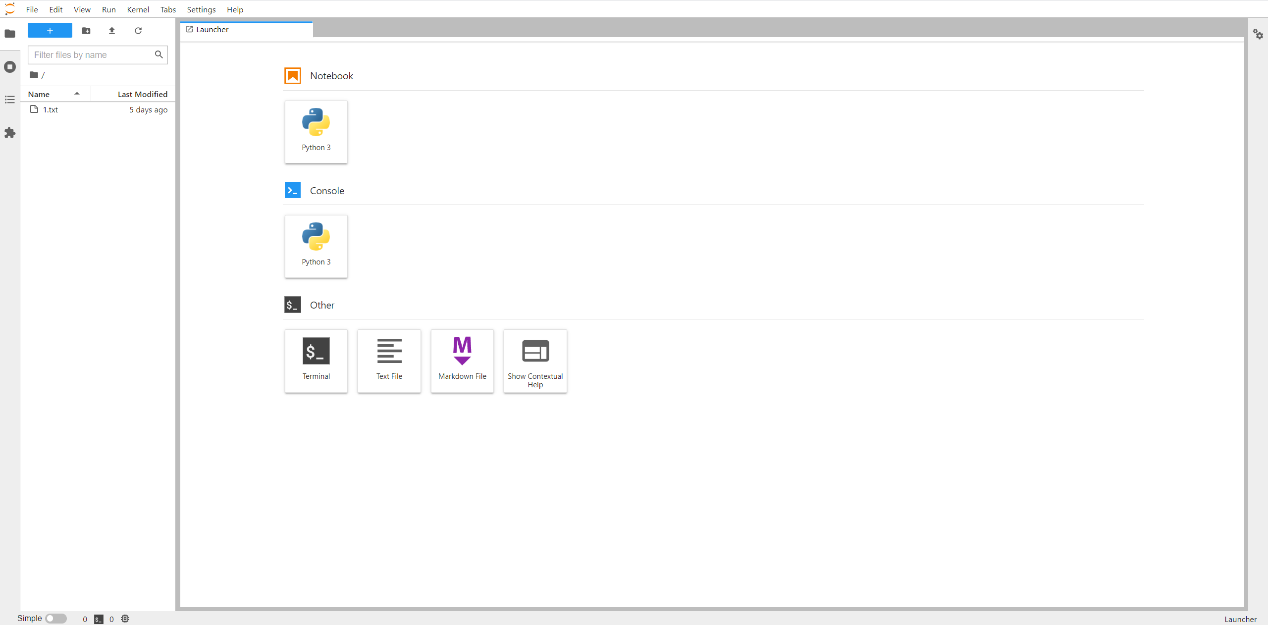
本次嘗試部署ONNX 模型,該模型從清華GLM-6 B 轉換而來,相關推理在Nvidia Tesla A 100 40 G 上部署成功,現嘗試在申請到的官方給到4 CPU 2 G + 1 顆1684 x芯片的infer 容器環境推理,如下圖
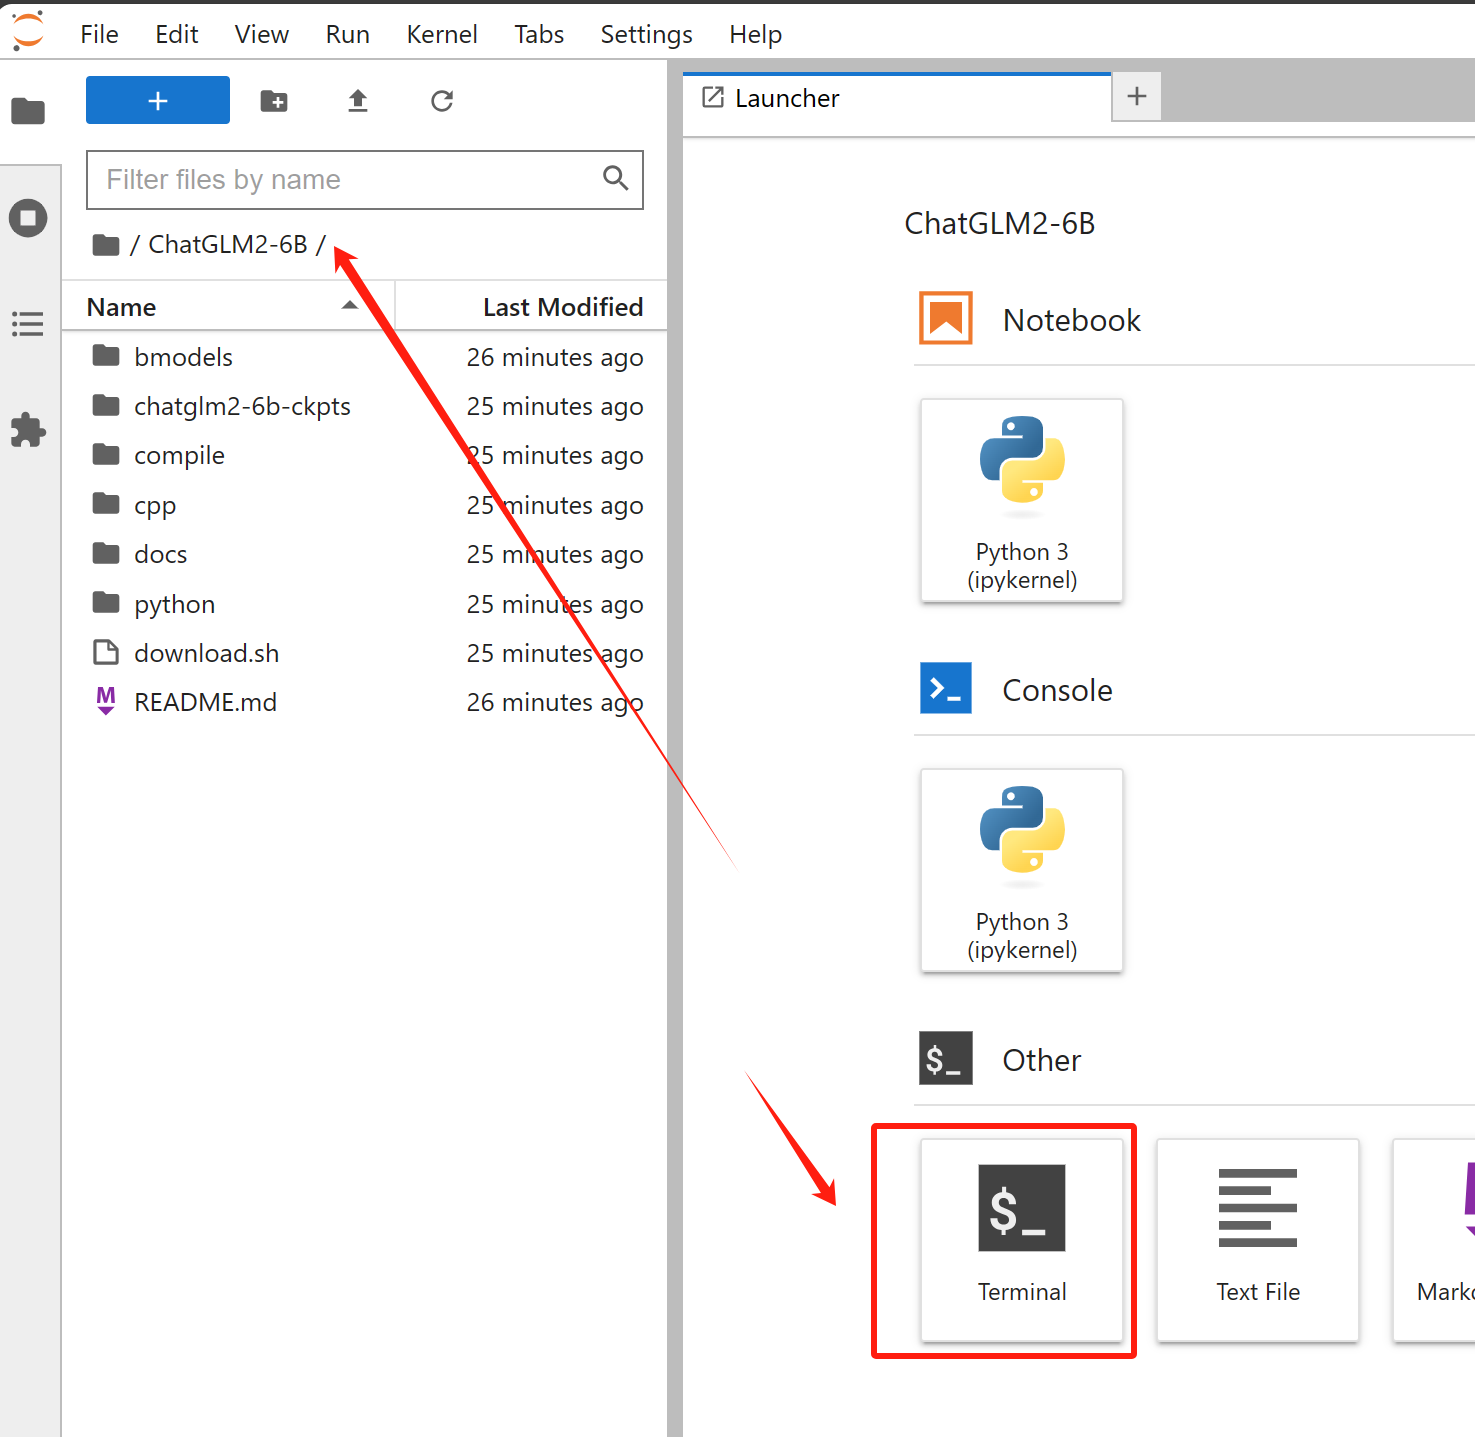
之後上傳好模型經過編譯後目錄已經確定,嘗試在notebook 中打開,並成功加載目錄和控制台,不得不說在該容器中的體驗和傳統AI 工程師工作流程幾乎吻合,可以見得該容器雲專業性和投入,這裡要給UtilityNet 團隊點個贊,兼容Jupiter 的全套環境對於需要plot 監控和專業輸出的開發者實在太友好了。在notebook 中,可以看到目錄中相關載入如圖
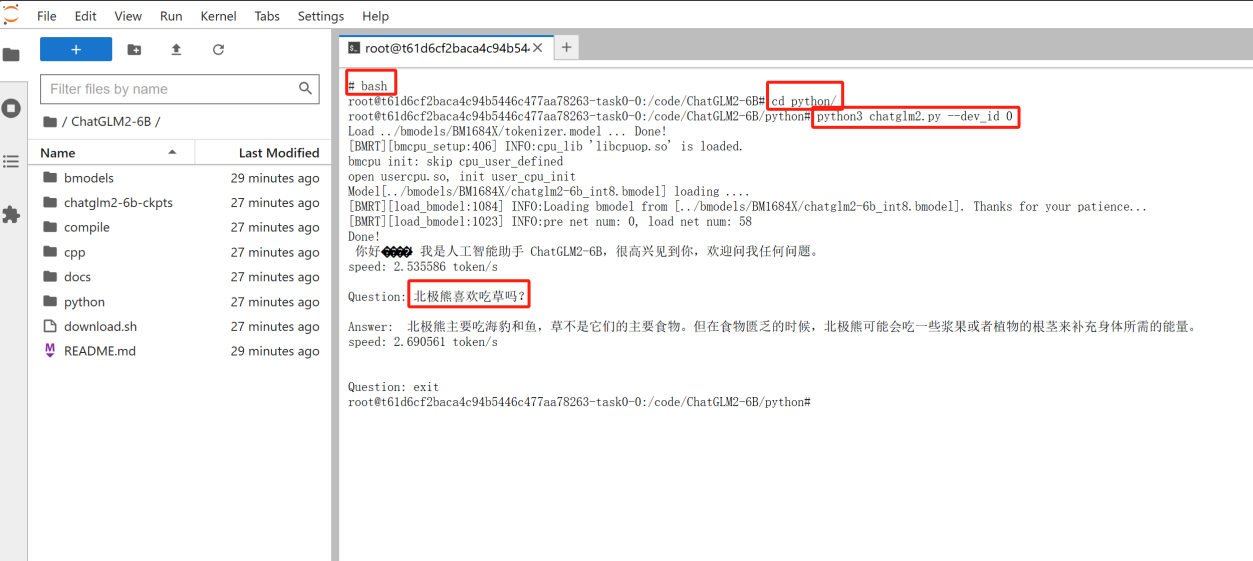
接下來進入容器控制台,體驗幾乎完美,可能因為申請試用的服務器群集在亞洲的原因,所以延時基本上和之前採購的AWS 香港服務器差不多。因為編譯好的緣故,我們直接用Pytho n3運行,dev 0 就是分配到的那張SC 7 三芯BM 1684 X 卡中屬於我的第一顆芯片,通過命令指定並運行,短暫延時後成功推理,因此單卡可以並行三個ChatGLM,透過分發到三個使用者提供並行體驗,讓我們對BM 1684 x 在UtilityNet 的廣泛場景充滿期待,相關測試可以參考下圖
停止notebook
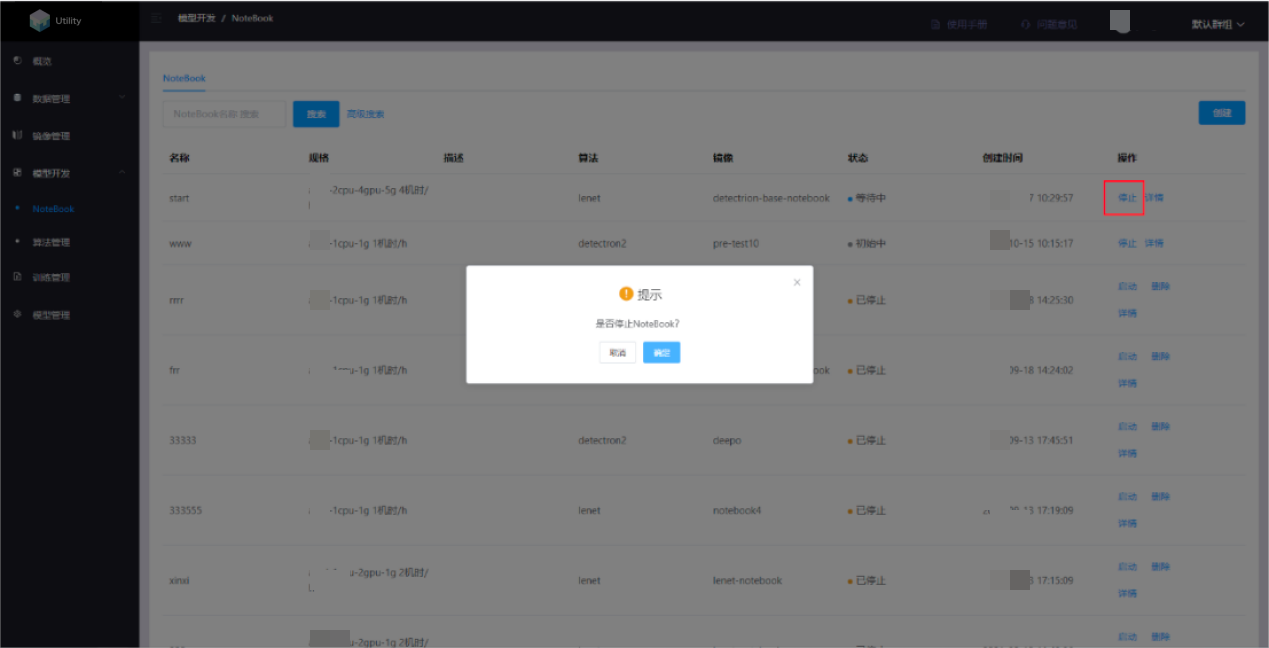
最後,點選停止按鈕,停止notebook,結束體驗和機時。
三、總結
通過全流程體驗,從申請容器,到分配到2C PU 4 G 單芯1684 x 容器,到部署編譯在infer 環境中,到notebook 便捷展開Jupiter,到控制台文件目錄和GLM 的成功推理,整個流程無比絲滑,對相關AI 開發者和算力使用者非常友善。不得不對如此強大的容器雲未來能夠開源和一鍵部署在UtilityNet 的算力提供商節點充滿無限期待,對官方明年2-3 月份的公開測試網和分散式算力的未來也更加肯定了信心。





