






SignalPlus:淺談深度神經網絡


前言
Deep neural networks are completely flexible by design, and there really are no fixed rules when it comes to model architecture.
-- David Foster
前言
前言一級標題前言神經網絡(neural network) 受到人腦的啟發,可模仿生物神經元相互傳遞信號。神經網絡就是由神經元組成的系統。如下圖所示,神經元有許多樹突
(dendrite) 用來輸入,有一個
軸突(axon) 用來輸出。它具有兩個最主要的特性:興奮性和傳導性:興奮性是指當刺激強度未達到某一閾限值時,神經衝動不會發生;而當刺激強度達到該值時,神經衝動發生並能瞬時達到最大強度。
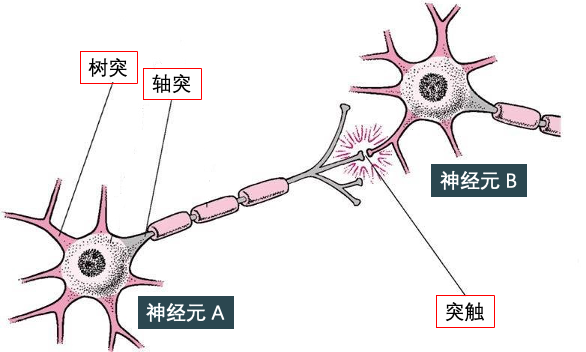
傳導性是指相鄰神經元靠其間一小空隙進行傳導。這一小空隙,叫做突觸 (artificial neural network,(synapse),其作用在於傳遞不同神經元之間的神經衝動,下圖突觸將神經元A 和B 連在一起。試想很多突觸連接很多神經元,不就形成了一個神經網絡了嗎?沒錯,類比到人工神經網絡
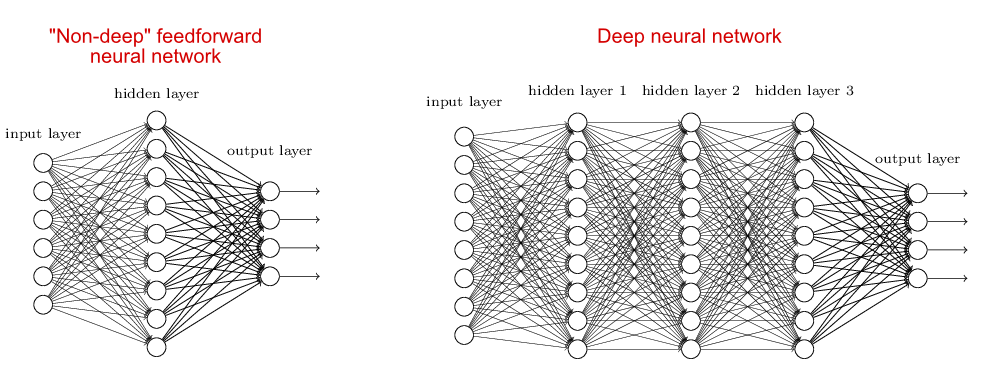
ANN),也是由無數的人工神經元組成一起的,比如下左圖的淺度神經網絡(shadow neural network) 和下右圖的深度神經網絡(deep neural network)。
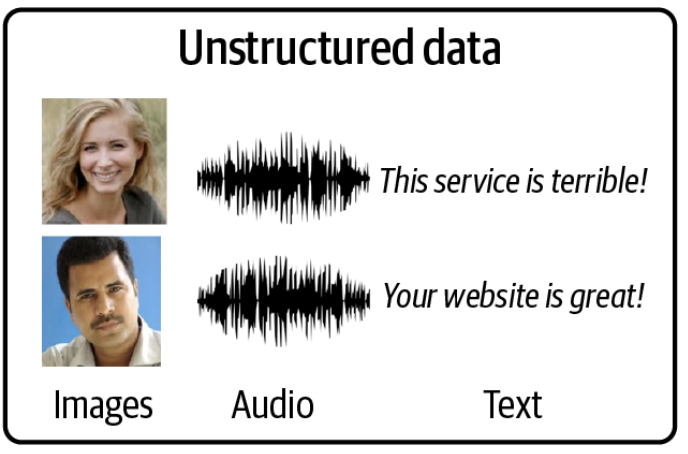
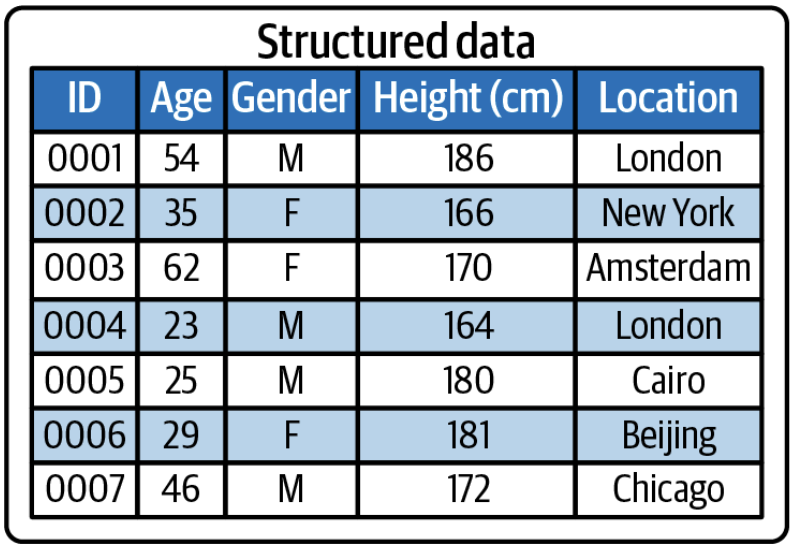 淺度神經網絡適用於結構化數據(structured data),比如像下圖中excel 裡存儲的二維數據。
一級標題
Talk is cheap. Show me the code.
-- Linus Torvalds
一級標題
二級標題
一級標題
二級標題
二級標題
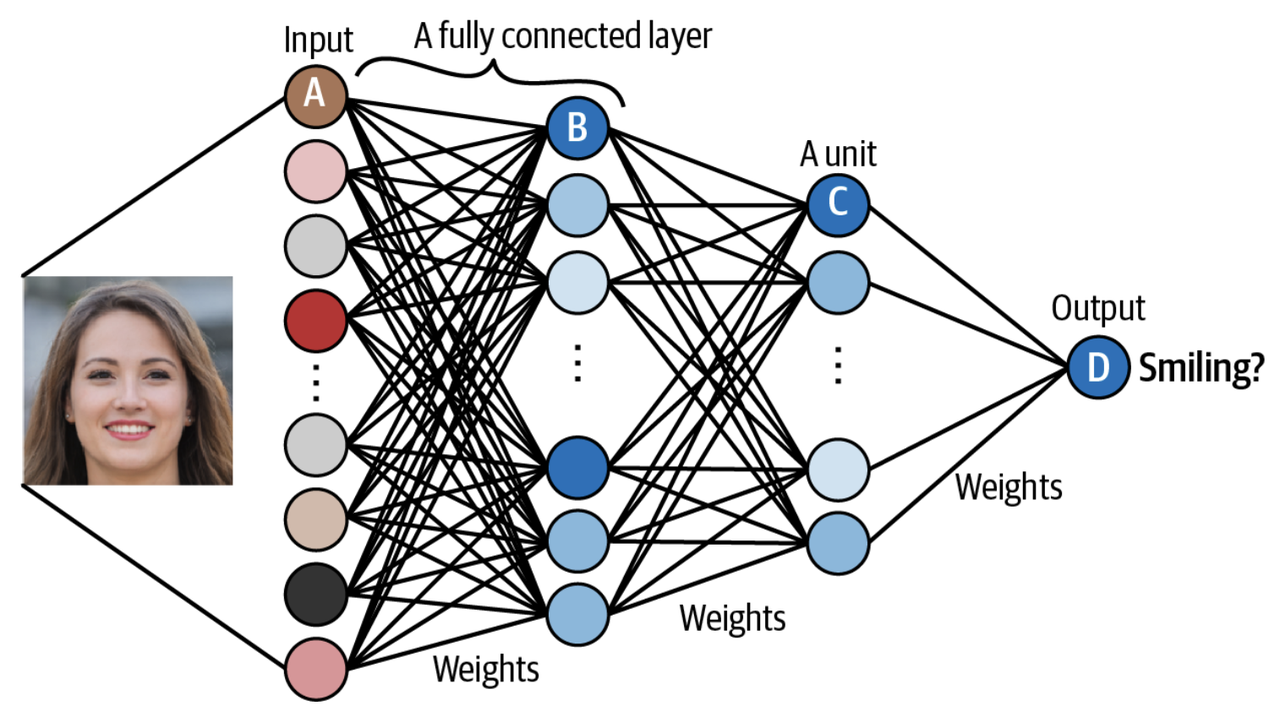
1.1 神經網絡初見假設下面的神經網絡已經被訓練好,接著用來預測圖片中是否含有笑臉。單元A 接收圖像裡的像素信息。
單元B 結合了輸入像素,當原始圖像中有低級特徵(low-level feature) 比如邊緣(edge) 時,發出最強信號。
單元C 結合了低級特徵,當原始圖像中有
高級特徵(high-level feature) 比如牙齒(teech) 時,發出最強信號。權重
二級標題
二級標題
模型
模型 (models)
1.2 Keras 訓練流程 (layers),模型模型層 (output)
輸入(input) 和輸出 (loss)
優化器用上面的關鍵詞來總結Keras 訓練神經網絡的流程:將多個模型模型層模型模型,將輸入數據映射為預測值。然後損失函數將這些預測值輸出
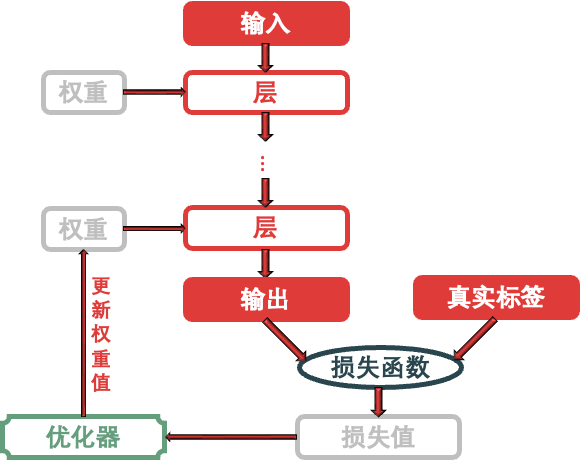
利用這個損失值來更新網絡的權重。
二級標題
二級標題
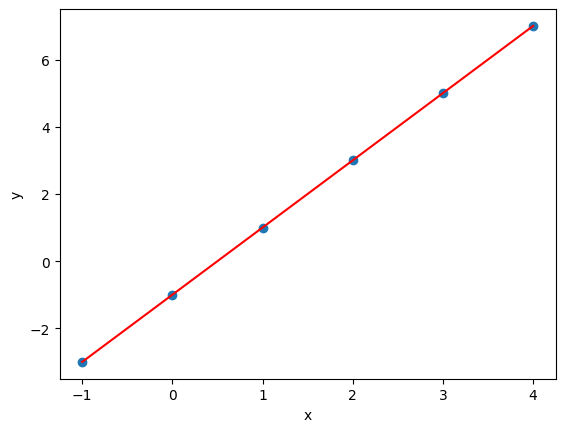
和x 和y 和
x = [-1, 0, 1, 2, 3, 4 ]
y = [-3, -1, 1, 3, 5, 7 ]
和x 和 y 的數據:new和new和
= 10 時,問 yx和 y以散點的形式畫出來,不難發現下圖的紅線就是 x和 y二級標題
和
二級標題
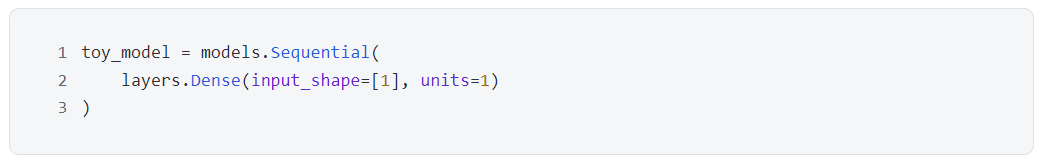
二級標題models.Sequential() 首先用layers.Dense()二級標題
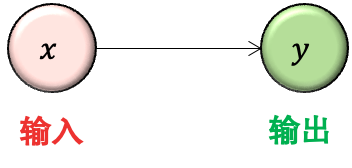
創建一個空神經網絡,然後不斷添加層,這裡我們添加了
二級標題y = wx二級標題w1.3.2 檢查模型
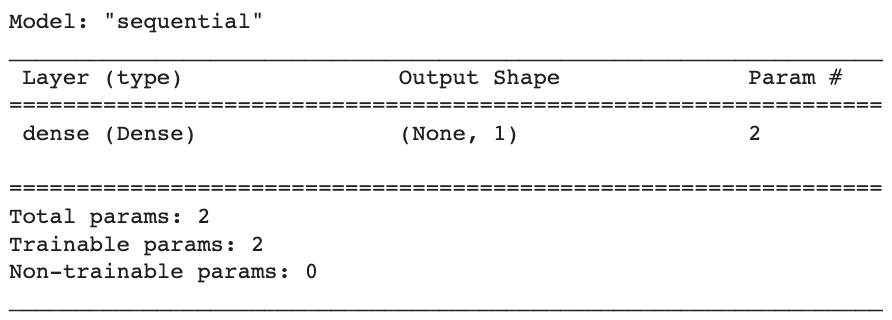
檢查一下模型信息,奇怪的是參數個數(下圖Param #) 居然是2 個而不是1 個。因為從上圖來看,只應該有一個參數啊。
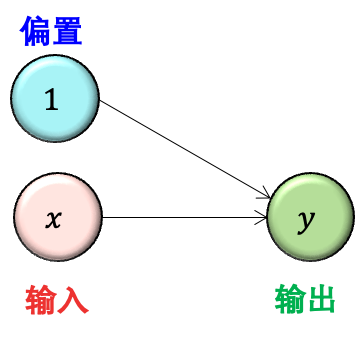
原因是在計算每層參數個數時,每個神經元默認會連接到一個值為1 的y = wx(bias unit),因此其實上圖更準確的樣子如下:w和 b 這樣就對了,此時
+b,有 Dense()和wx兩個參數了。 y嚴格來說,其實 g函數裡還是一個參數叫activation,它字面意思是激活函數,本質上做的事情是將y = g(wx+b 以非線性的模式轉換再賦予給
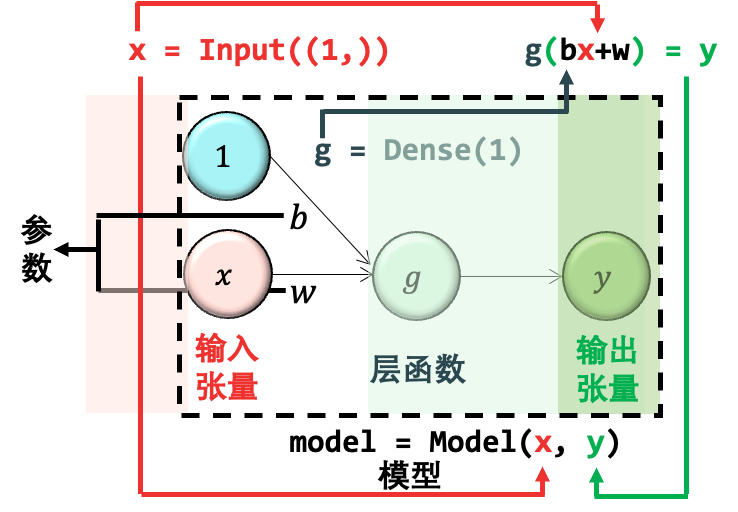
+b)。在Keras 如果不給activation 指定值,那麼就不需要做任何非線性轉換。加上激活函數這個概念,我們給出一個完整的圖:w二級標題
我們的目標就是求出上圖中的參數,權重
二級標題complie()二級標題"sgd"函數設定參數optimizer="mean_squared_error"二級標題
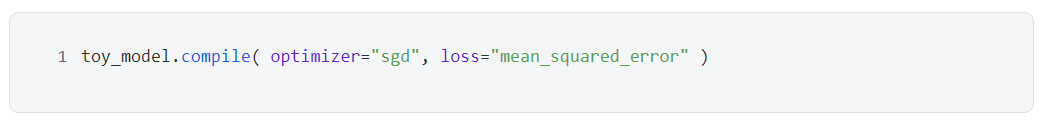
,即指定優化方法為隨機梯度下降,設定參數loss=
二級標題 fit()二級標題
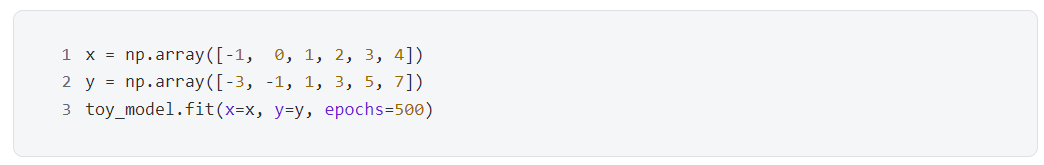
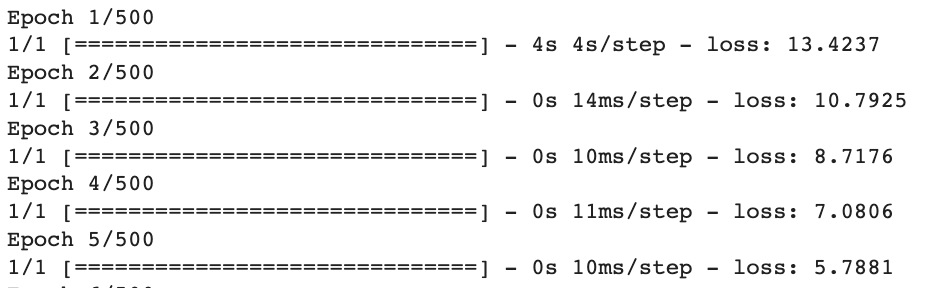
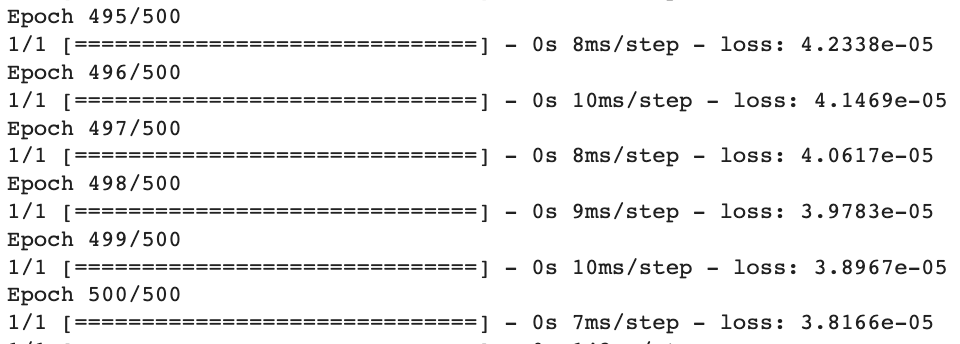
1.3.4 訓練模型
訓練模型用get_weights() 函數,把數據x 和y 傳進去。值得注意的是參數epochs= 500 ,epoch 中文是期,即整個訓練集被算法遍歷的次數,這裡就是遍歷500 次模型訓練結束。
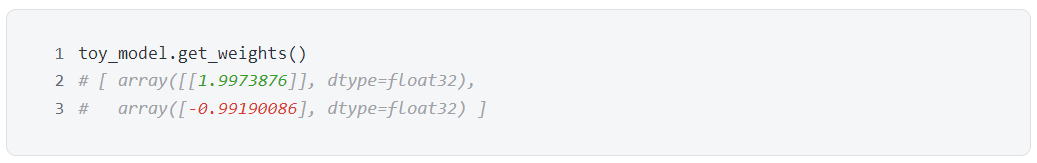 打印出首尾5 期的信息,不難發現一開始loss 很大13.4237 ,到最後loss 非常小只有3.8166 e-05 ,說明在訓練集裡的預測值和真實值幾乎一致。w返回結果第一個是權重b二級標題y = 1.9973876 x - 0.99190086 ≈ 2 x - 1 。
,第二個偏置
二級標題predict() 二級標題
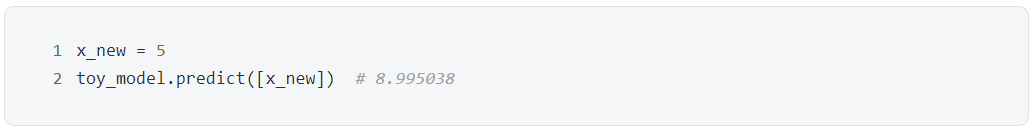
1.3.5 評估模型
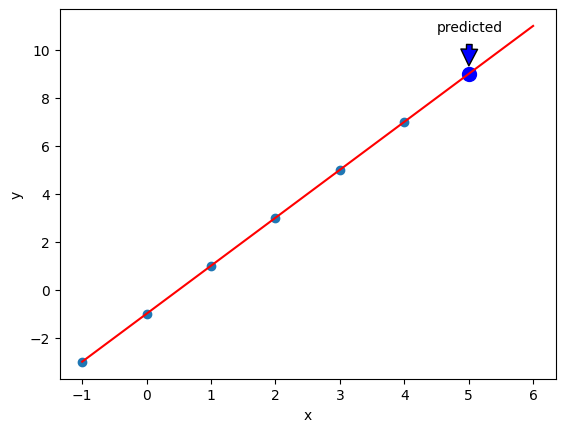
評估模型用
函數,將新數據x_new 傳進去,得到結果8.995028 ,非常接近2*x_new - 1 = 9 。從下圖可看出,神經網絡從6 個數據(深青點) 中“學到”了模型(紅線),而該模型可用在新數據(藍點) 上。Sequential()總結一下神經網絡全流程:
創建模型:用summary()
,當然還有其他更好的方法,下節講。檢查模型compile()
:用編譯模型fit()
:用訓練模型predict()
評估模型前:用 (feedforward neural network,反饋神經網絡一級標題 (convoluational neural network, CNN)。
FNN) 和
一級標題
一級標題
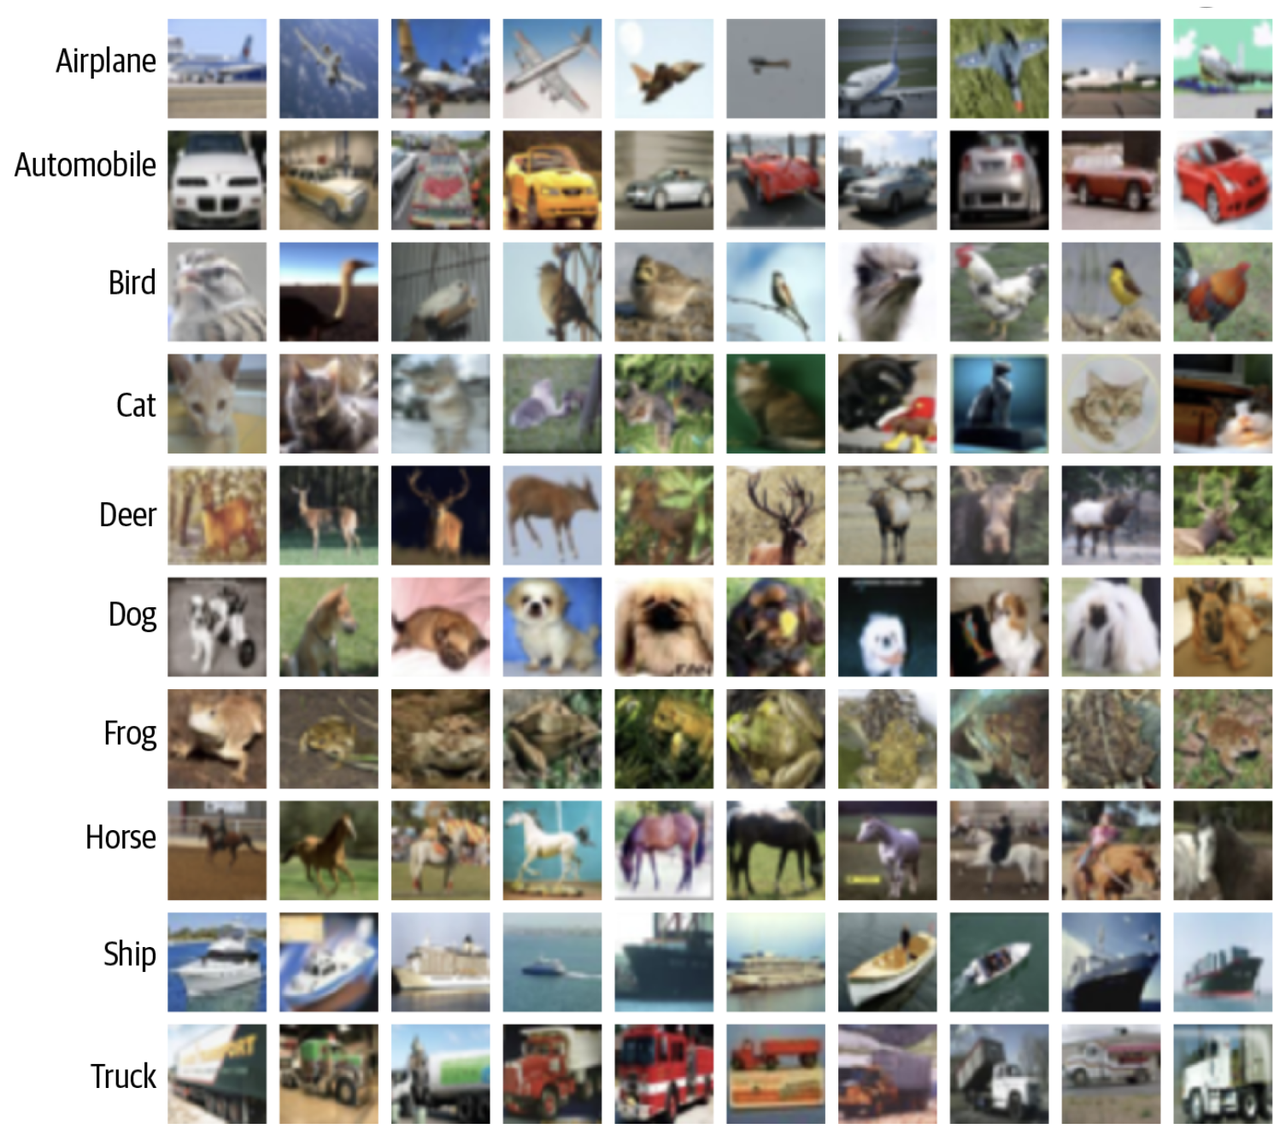
2. 前饋神經網絡(FNN)
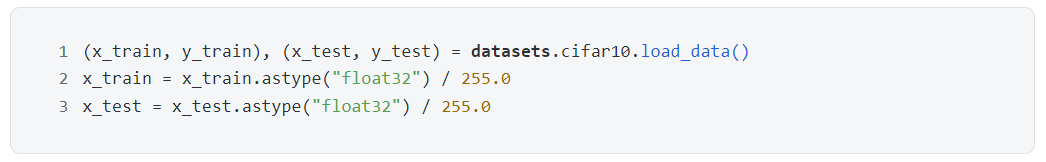
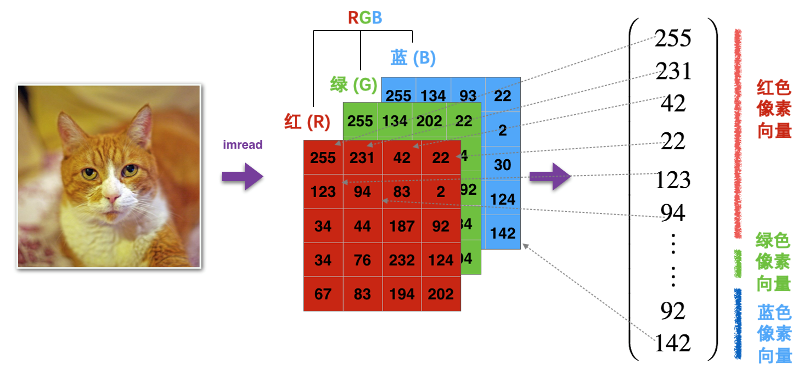
上節的極簡神經網絡太無聊了,但是主要是用來明晰Keras 裡神經網絡的概念而步驟,下面來看看神經網絡做一些有趣的事情,預測圖像類別。首先看看使用的數據集CIFAR-10 (https://www.cs.toronto.edu/~kriz/cifar.html)。to_categorical() 二級標題
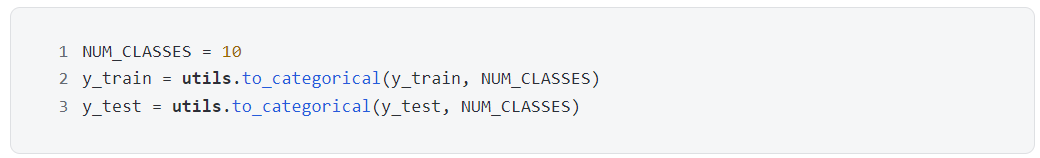
二級標題

二級標題
2.1.1 序列式
二級標題models.二級標題layers.2.1.1 序列式layers.Dense()。
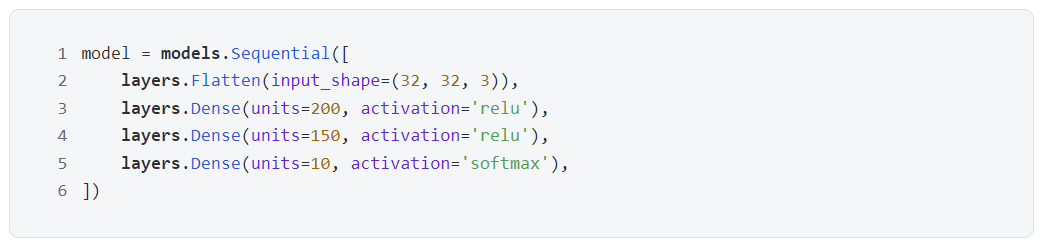
上節已經見識過序列式(sequential) 建模了,首先用
Sequential() 創建一個空神經網絡,然後不斷添加層。本例中有一個打平層
Flatten() 和三個稠密層
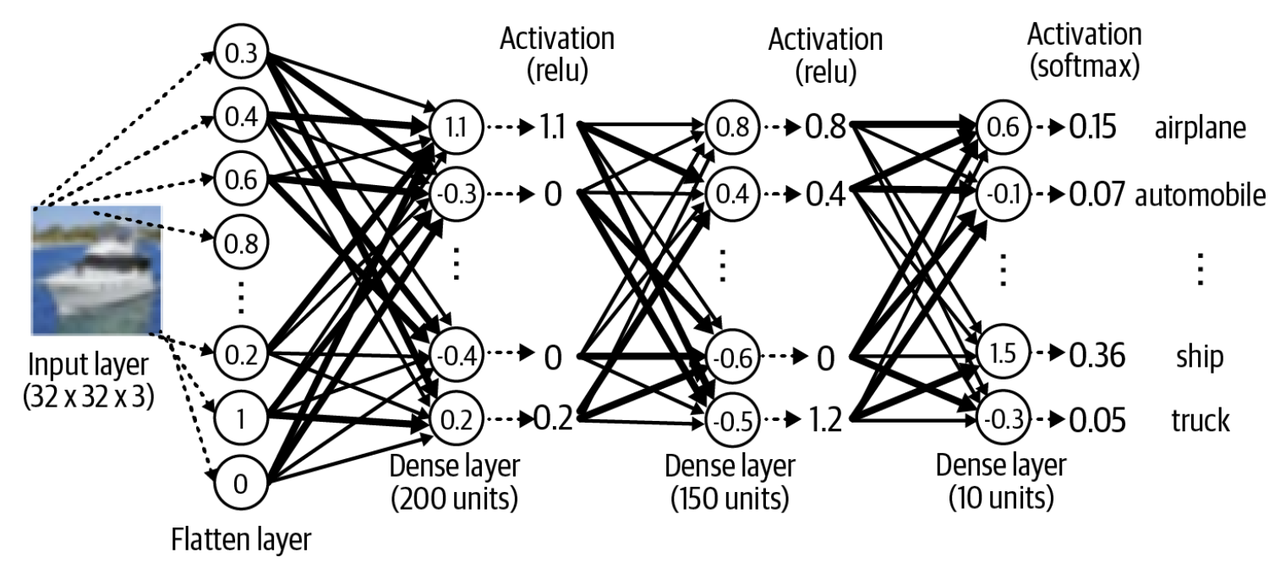
上面代碼給出下圖所示的模型:
原始圖像( 32, 32, 3) 輸入打平層(在參數input_shape 指定圖像維度大小),打平之後變成了一個32* 32* 3 = 3072 的向量,可以想成現在輸入有3072 個神經元。之後三個稠密層的
常用的神經元個數(參數units) 分別為200, 150 和10 ,前兩個200 和150 是隨便給的或者當成超參數調試出來,但最後一個10 是和類別的個數一致。用到的激活函數(參數activation) 分別是relu, relu 和softmax,前兩個relu 幾乎是標配,但最後一個softmax 和任務相關,如果是多分類問題就用softmax。
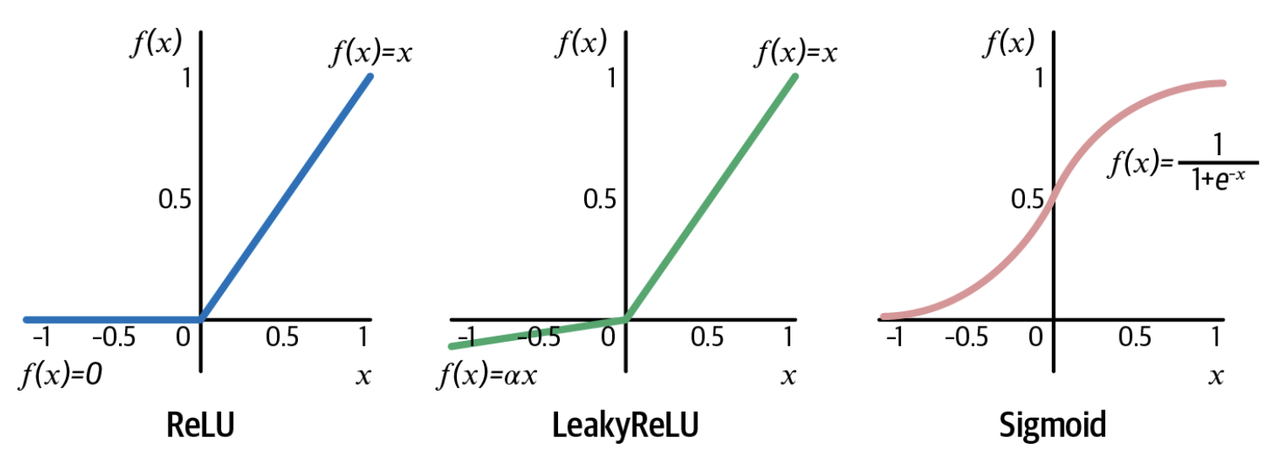
常用的
Sigmoid 激活函數Sigmoid 將實數轉換成0-1 之間的數,而這個數可當成概率,因此Softmax二級標題
函數用於二分類問題,它的延伸版
二級標題二級標題2.1.2 函數式
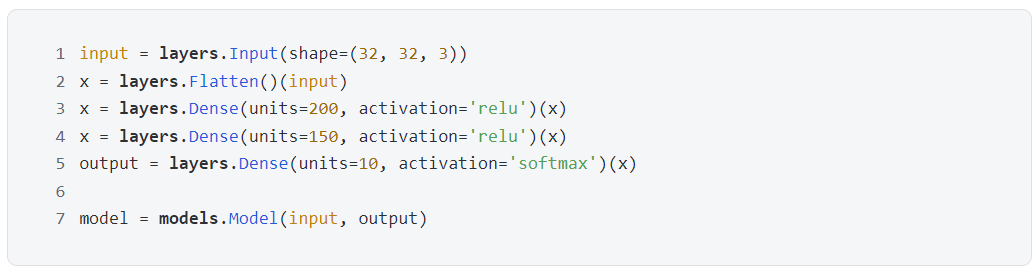
在實操中,我們更習慣用函數式(functional) 建模。序列式構建的模型都可以用函數式來完成,反之不行,如果在兩者選一,建議只用函數式來構建模型。代碼如下:
函數式建模只用記住一句話: Input() 把層當做函數用
。有了這句在心,代碼秒看懂。Flatten() 第1 行,用f接收圖像數據。
第2 行,把Dense(units= 200,當成函數g,化簡不就是x = f(input)
第3 行,把Dense(units= 150,activation='relu') 當成函數h,化簡不就是x = g(x)
第4 行,把Dense(units= 10,activation='relu') 當成函數q,化簡不就是x = h(x)
,化簡不就是output = q(x)models.二級標題
這樣一層層函數接著函數把input 傳遞到output,output = q(h(g(f(input)))),最後再用
二級標題summary() 二級標題
2.2 檢查模型
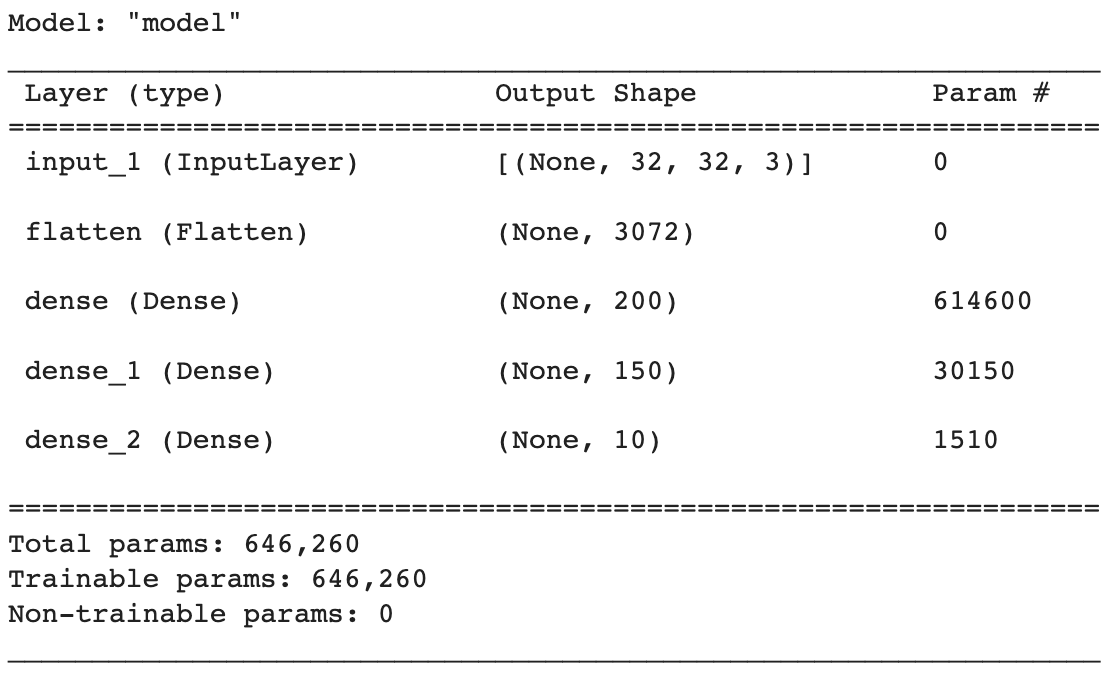
當模型創建之後和使用之前,最好是檢查一下神經網絡每層的數據形狀是否正確,用
函數就能幫你打印出此類信息。
該模型自動被命名“model”,接著一張表分別描述每層的名稱類型(layer (type))、輸出形狀(Output Shape) 和參數個數(Param #)。我們一層層來看
InputLayer 層被命名成input_ 1 ,輸出形狀為[None, 32, 32, 3 ],後面三個元素對應著圖像寬、高和色道,第一個None 其實代表的樣本數,更嚴謹的講是一批(batch) 裡面的樣本數。為了代碼簡潔,這個樣本數在建模時通常不需要顯性寫出來。
Flatten 層被命名成flatten, 3072 就是32* 32* 3 打平之後的個數,參數個數為0 ,因為打平只是重塑數組,不需要任何參數來完成重塑動作。
第一個Dense 層被命名為dense,輸出形狀是200 ,參數614, 600 = ( 3072 + 1) * 200 ,不要忘了有偏置單元。646, 260 第二個Dense 層被命名為dense_ 1 ,輸出形狀是150 ,參數30, 150 = ( 200 + 1) * 150 ,同樣考慮偏置單元。646, 260 ,可訓練參數量(Trainable params)0 二級標題
,不可訓練參數量(Non-trainable params)
二級標題
二級標題
2.3 編譯模型
當構建模型完畢,接著需要編譯模型,需要設定三點:
選取想監控的指標complie() 在
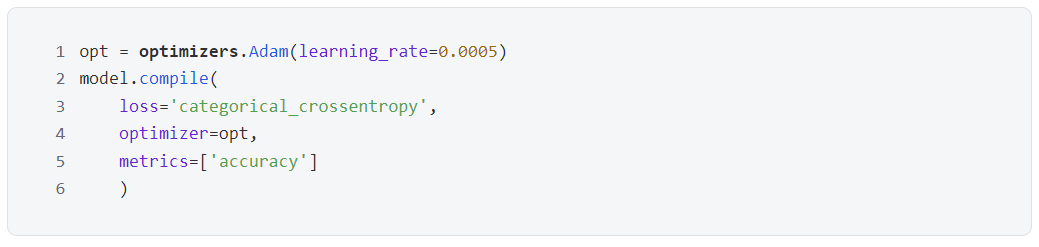
在complie()編譯模型用
在
在
函數中:
對於參數loss,本例是十分類問題,因此用的損失函數是categorical_crossentropy,此外:
二分類問題:損失函數是binary_crossentropy
回歸問題:損失函數是mean_squared_error
對於參數optimizer,大多數情況下,使用adam 和rmsprop 優化器及其默認的學習率是穩妥的。在設定該參數時,也可以通過用名稱和實例化對象來調用。
名稱:'sgd'
名稱:['accuracy']
二級標題
對象:[metrics.categorical_accuracy]
二級標題
批量大小訓練模型不是把所有數據一起丟進去,而是按批量丟進去。在介紹訓練模型前,需要明晰幾個概念:
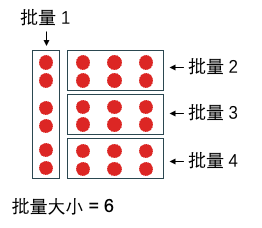
期批量大小
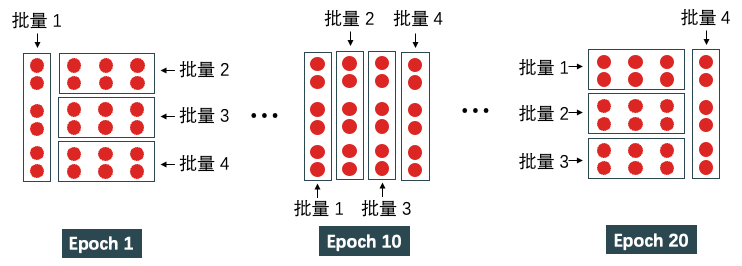
(batch size) 指一個批量裡的樣本個數。下例中總共有24 個數據,如果每個批裡有6 個數據,那麼總局可分成4 批。fit()期
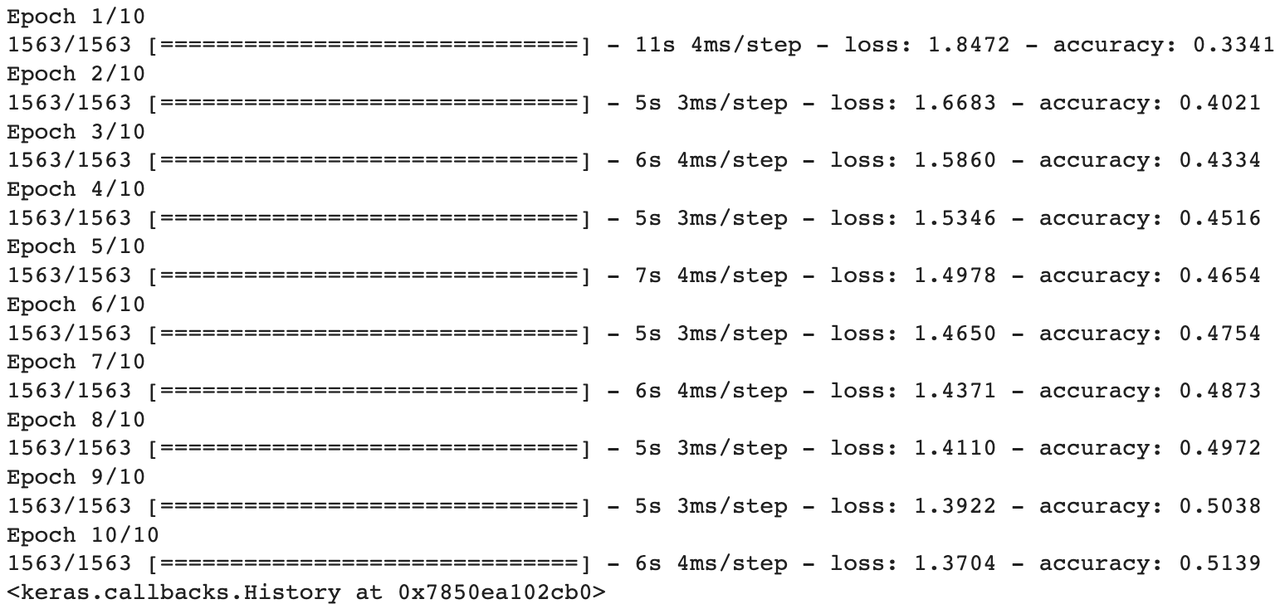
(epoch)指整個訓練集被算法遍歷一次。當設epoch 為20 時,那麼要以不同的方式遍歷整個訓練集20 次。一次epoch 要經歷4 次迭代才能遍歷整個數據集,即樣本總數/ 批量大小= 24 / 6 次迭代。 20 次epoch 運行過程如下圖所示。訓練模型用函數,代碼如下:上圖給出訓練步驟,不難看出訓練集被分成1563 個堆,每堆含32 張圖(batch size)。 10 個epoch 之後,損失函數 51.39% (accuracy) 從33.41% 提升到51.39% 二級標題
。模型在訓練集上可以到達
二級標題evaluate()二級標題
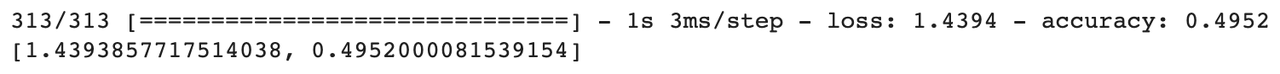
2.5 評估模型49.52% 用49.52% 函數直接看準確率。
模型在測試集上的準確率為predict(),比隨機預測一個類別的準確率10% 高多了(因為有十類)。由於我們用這樣一個非常簡單的前饋神經網絡來預測圖片類別,
的準確率已經算是不錯的結果了。
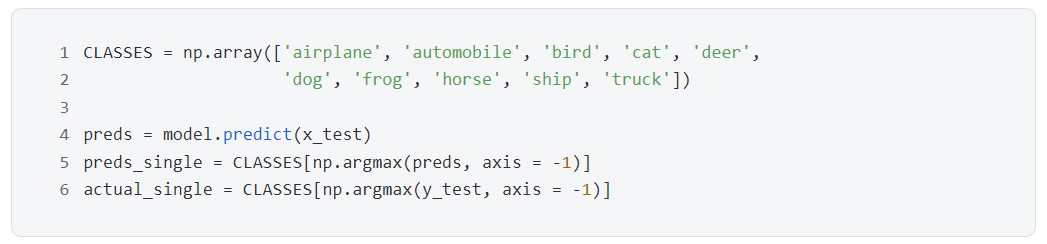
用
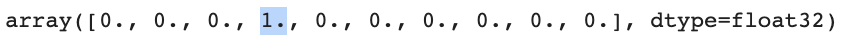
函數比對預測和真實類別。
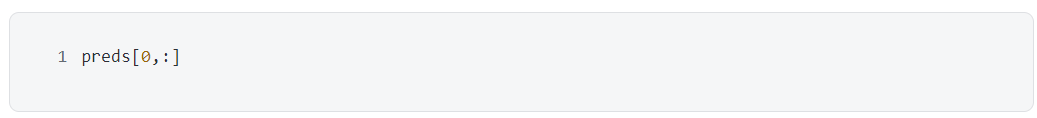
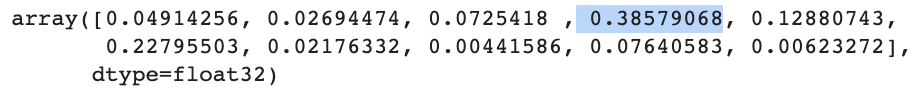
測試集裡用10, 000 張圖,類別是10 個,因此preds 是一個[ 10000, 10 ] 的數組,每一行都是模型對相應圖片預測的10 個類別的概率,當然所有概率加起來等於1 。看看測試集裡第一張圖片的預測結果:
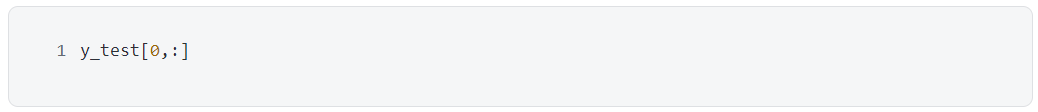
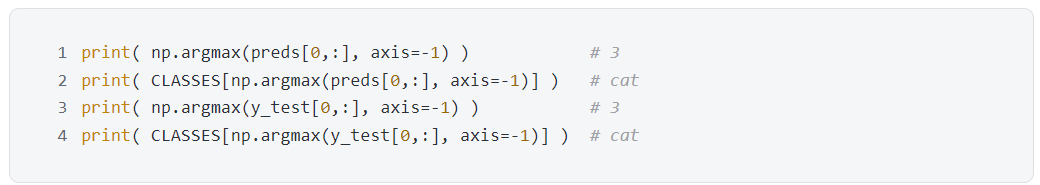
y_test 也是一個[ 10000, 10 ] 的數組,每一行都是相應圖片真實的類別,因此10 個元素有9 個零和1 個一。看看測試集裡第一張圖片的真實類別:
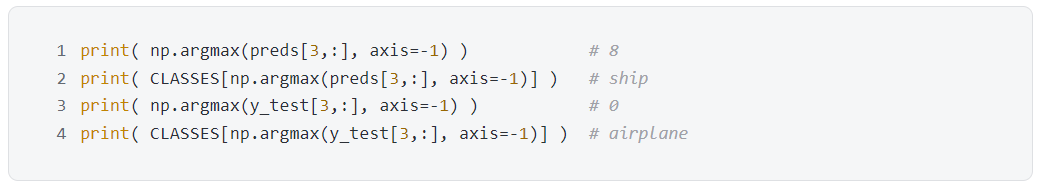
不難看出,預測結果preds[ 0,:] 中類別四的概率最高0.38579068 ,而真實類別test[ 0.:] 就是類別四(第4 個元素是一)。用np.argmax 分別從預測結果preds[ 0,:] 和真實類別test[ 0.:] 中找到最大值對應的索引,並從CLASSES 中映射出類別描述。
測試集第一張是貓,而模型預測的也是貓,做對了!
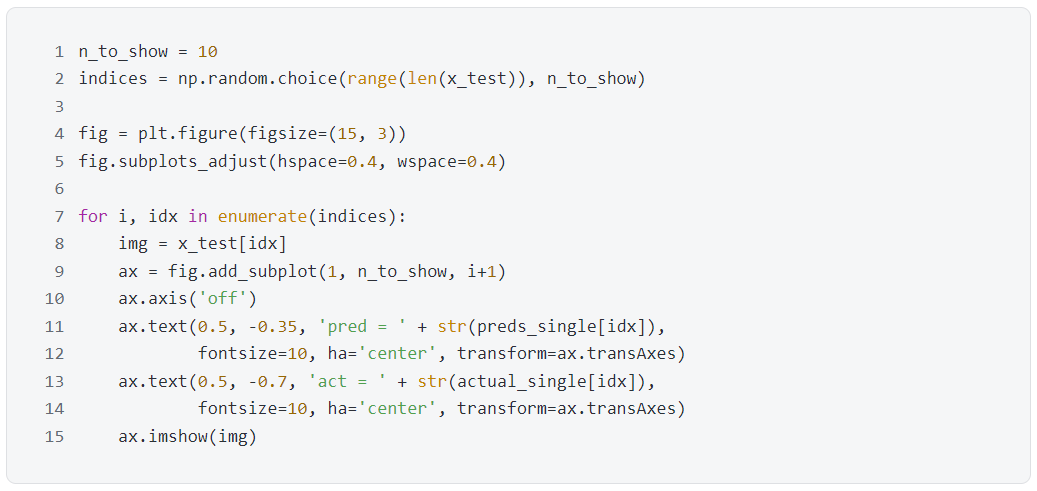
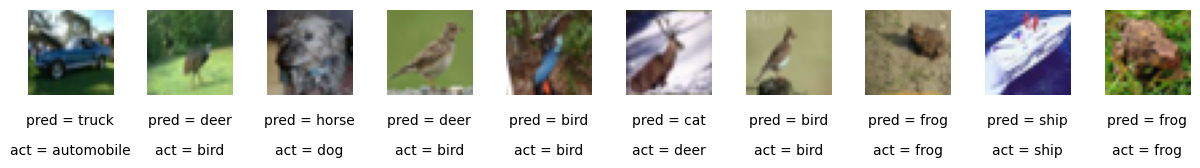
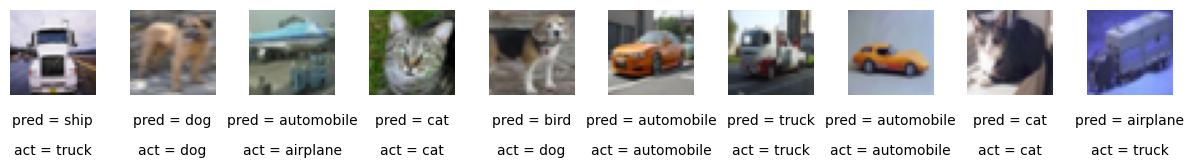
可視化:上面的對比方法太麻煩,我們可以隨機抽取測試集裡的10 張,打印出每張圖片,在圖片下還貼上模型預測類別和其真實類別。
一級標題
3. 卷積神經網絡(CNN)
二級標題
3.1 基本概念
二級標題
二級標題
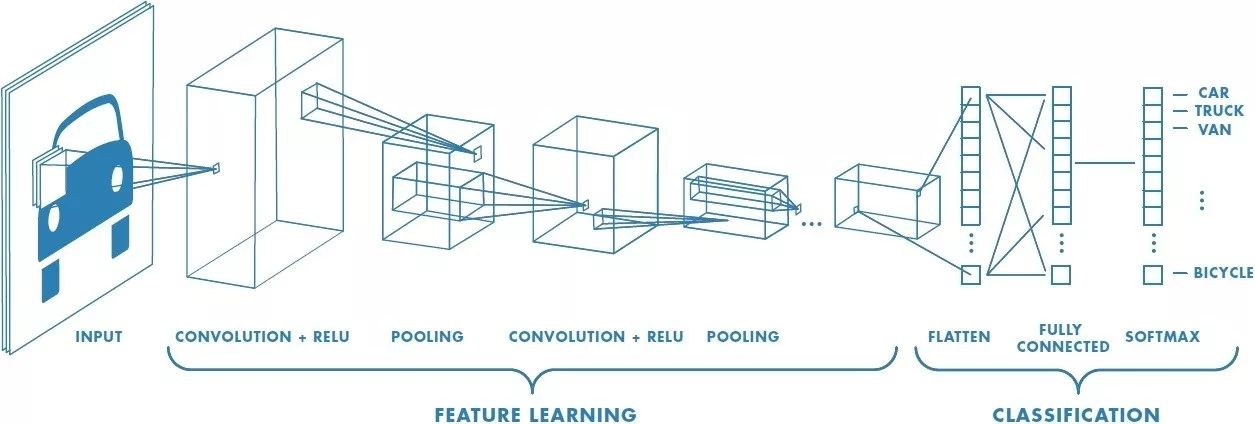
3.1 基本概念假設在黑夜你面前出現一張巨幅圖片,黑暗中你看不出來是輛車,你只能用手電筒一點一點掃過,把每次掃過看到的東西投影到下一層,以此類推。比如第一層你看到一些橫線豎線斜線,第二層組合成一些圓形方形,第三層組合成輪子車門車身,第四層組合成一輛車。這樣就能用個手電筒在黑夜裡辨別出照片裡有輛車了。
上例其實就是一個卷積神經網絡識別圖像的過程了,首先明晰幾個定義:濾波器
(filter):在輸入數據的寬度和高度上滑動,與輸入數據進行卷積,就像上例中的手電筒。(convolution):在這裡的定義就是把所有“濾波器的像素”乘以“濾波器掃過圖片的像素”再加總。
填充步長
(stride):遍歷圖像時濾波器的步長,默認值為1 ,既濾波器每次移動一個像素。
填充
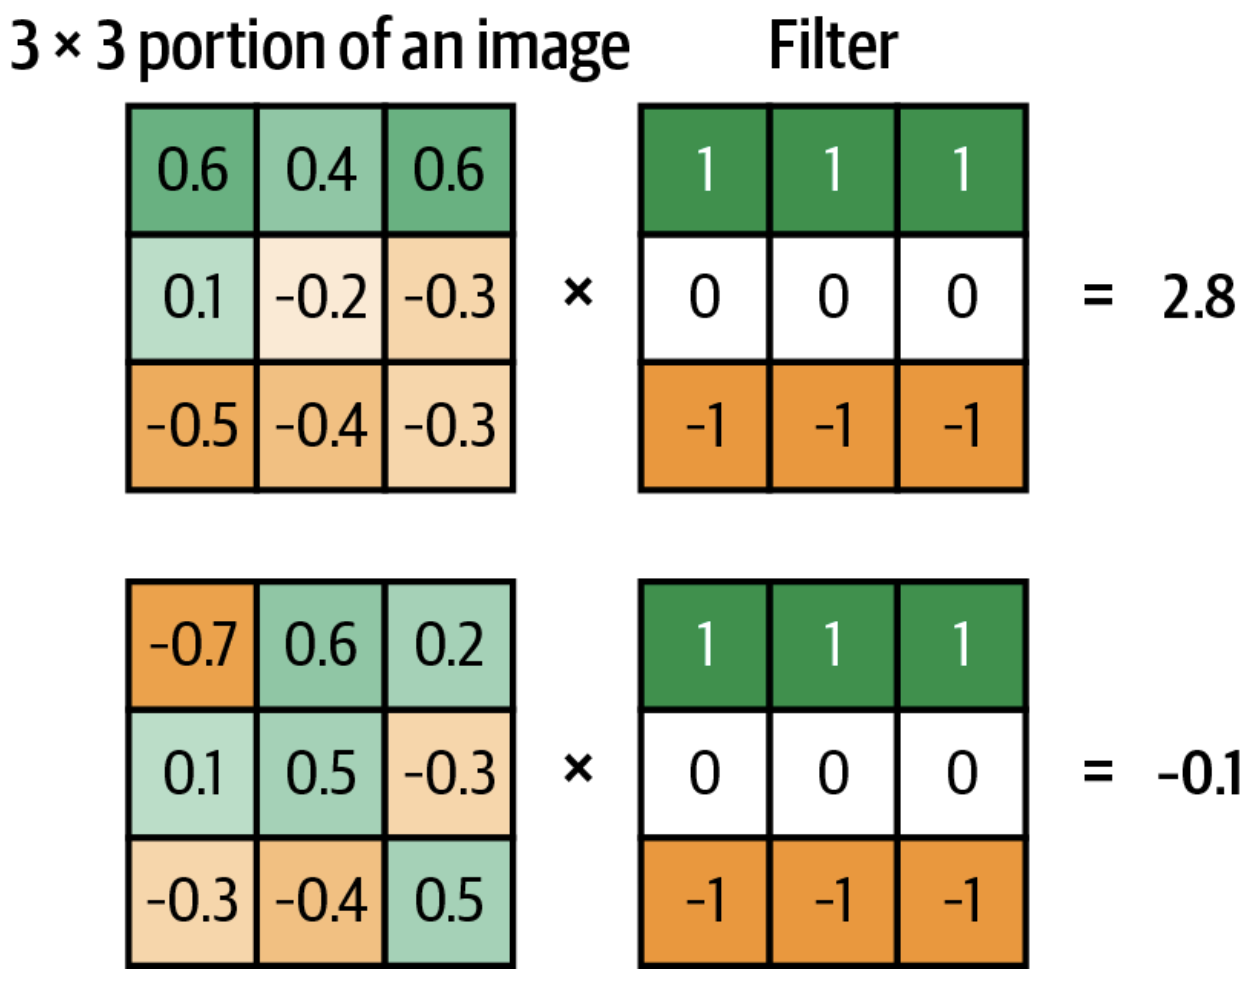
(padding):有時候會將輸入數據用0 在邊緣進行填充,可以控制輸出數據的尺寸(最常用的是保持輸出數據的尺寸與輸入數據一致)。2.8 。
卷積(Convolution)-0.1 。
第一張圖片和濾波器的捲積為0.6* 1 + 0.4* 1 + 0.6* 1 + 0.1* 0 + (-0.2)* 0 + (-0.3)* 0 + (-0.5)*(-1) + (-0.4)*(-1) + (-0.3)*(-1) =正當卷積值越相符正,說明濾波器和圖片越;當卷積值越不符負2.8 不符相符。上例中第一張圖片和濾波器的捲積值為-0.1 相符不符。
;第二張圖片和濾波器的捲積值為
,兩者
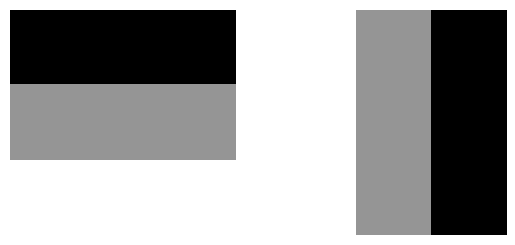
不符
濾波器(Filter)
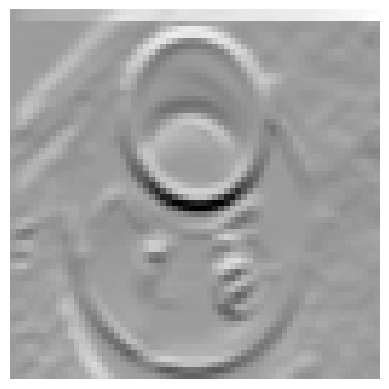
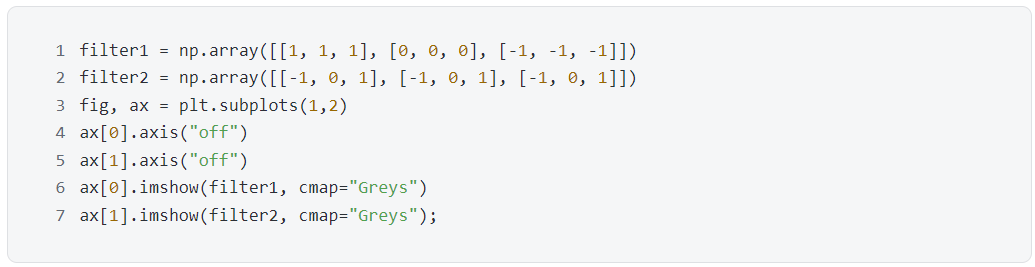
濾波器的作用就是濾波,即過濾掉一些信息,等價於提取保留下的信息。下面代碼創建兩個3* 3 大小的濾波器,filter 1 能提取圖像中的水平線,filter 2 能提取圖像中的豎直線。注意這裡1 代表黑, 0 代表灰,-1 代表白色。
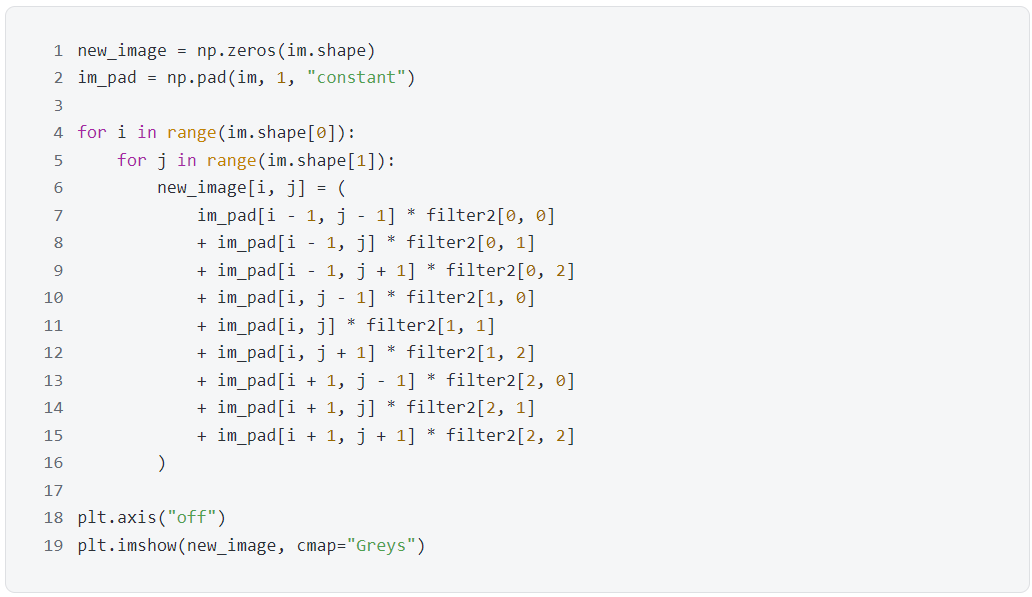
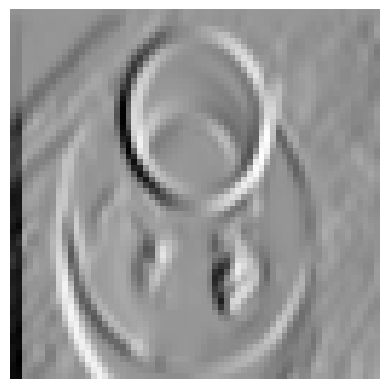
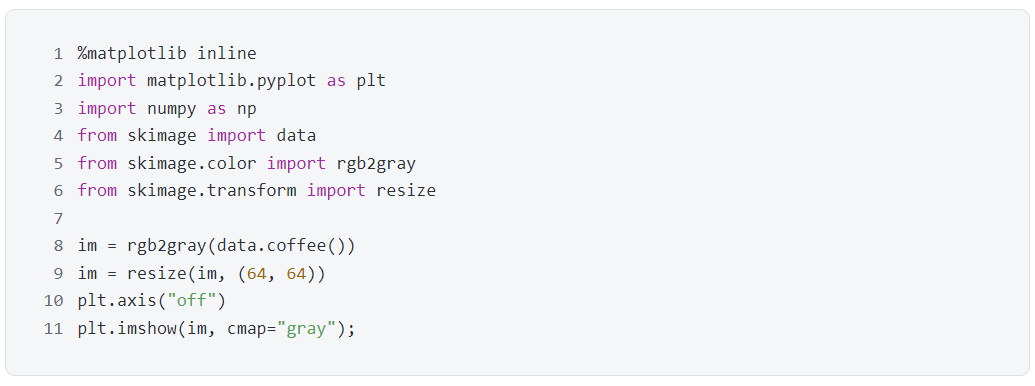
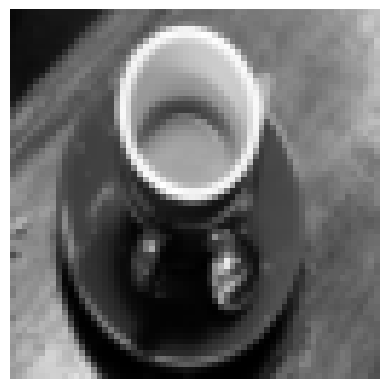
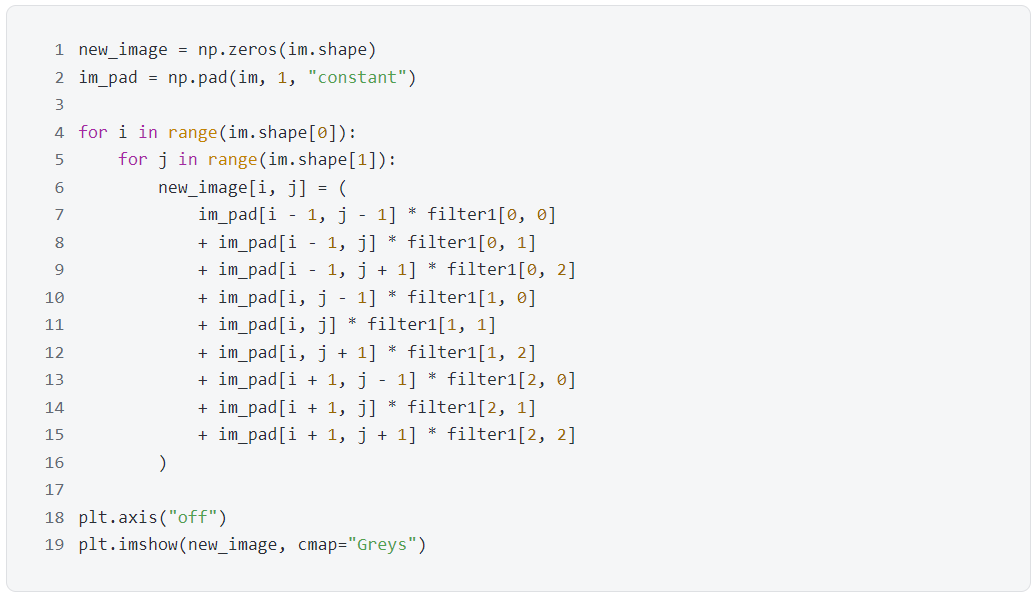
下面看一個如何用這兩個濾波器來提取信息的,原始圖片如下:不難發現,filter 1 的確從圖像中提取到水平的邊緣信息,比如杯子口的上下沿。不難發現,filter 2 的確從圖像中提取到豎直邊緣的信息,比如杯子口的左右沿。
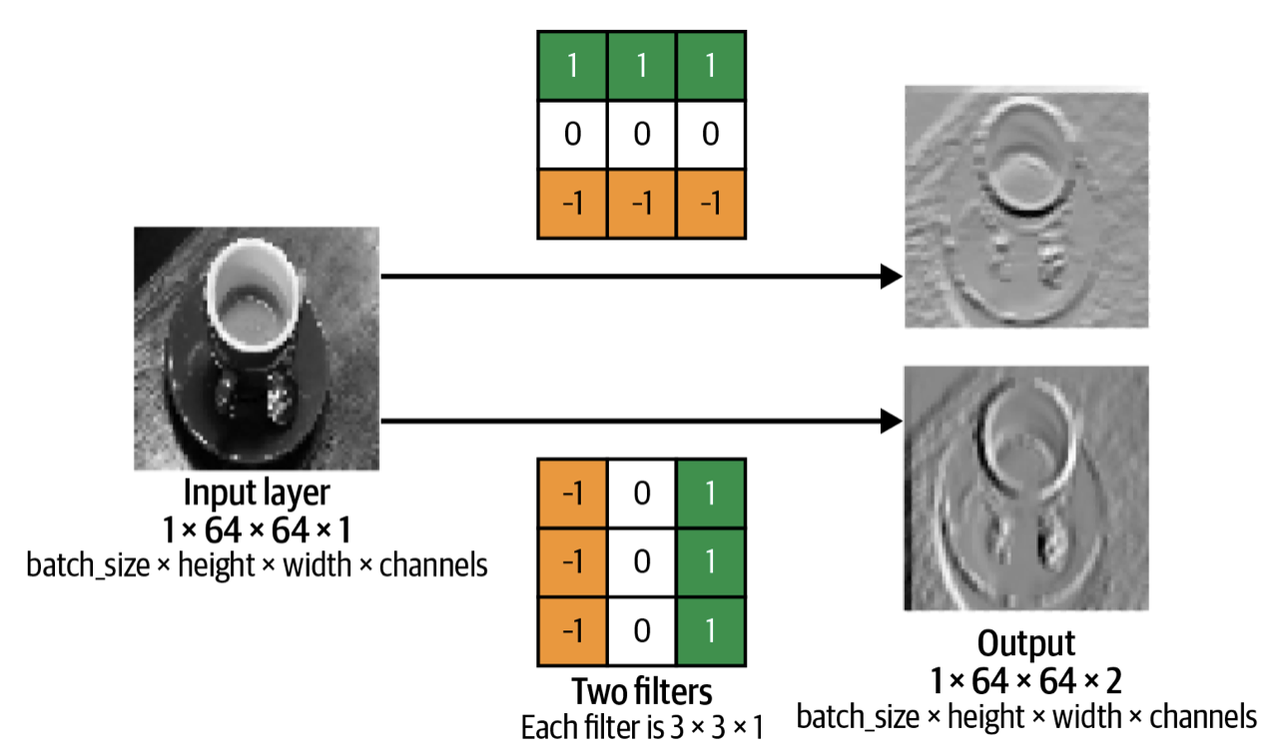
有了濾波器的加入,我們可以創建layers卷積層
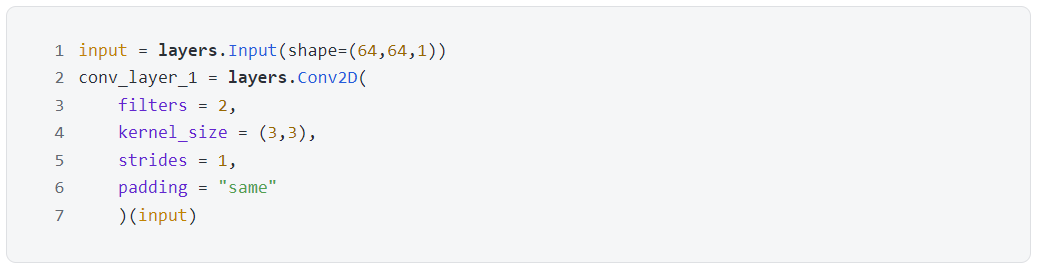
(convoluational layer) 了。卷積層本質上就是一組濾波器,下例中個數是2 個,而濾波器中的元素值稱為權重(weights),是通過訓練CNN 學到的。
在Keras 中用
.Con v 2 D() 來創建卷積層。這里黑白相片是64* 64* 1 (色道只有1 個),而濾波器有兩個(參數filters 設置為2),濾波器大小是3* 3 (參數kernel_size 設置為( 3, 3))。
還有兩個參數strides 和padding 是什麼東西?
步長(Stride)"same"顧名思義,填充就是在圖像四周添加元素。當padding =
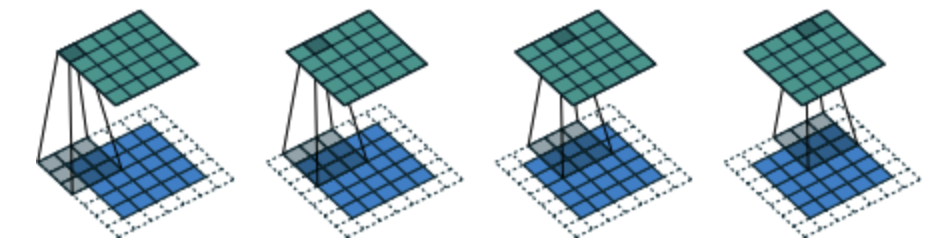
二級標題
時,配著strides = 1 ,可以保證輸出圖像和輸入圖像的大小一樣。下圖輸入圖像大小是5* 5 (藍色圖片),填充之後圖像大小變成7* 7 (帶白色的圖片),濾波器大小是3* 3 (灰色),輸出圖像大小還保持5 * 5 (綠色圖片)。
二級標題
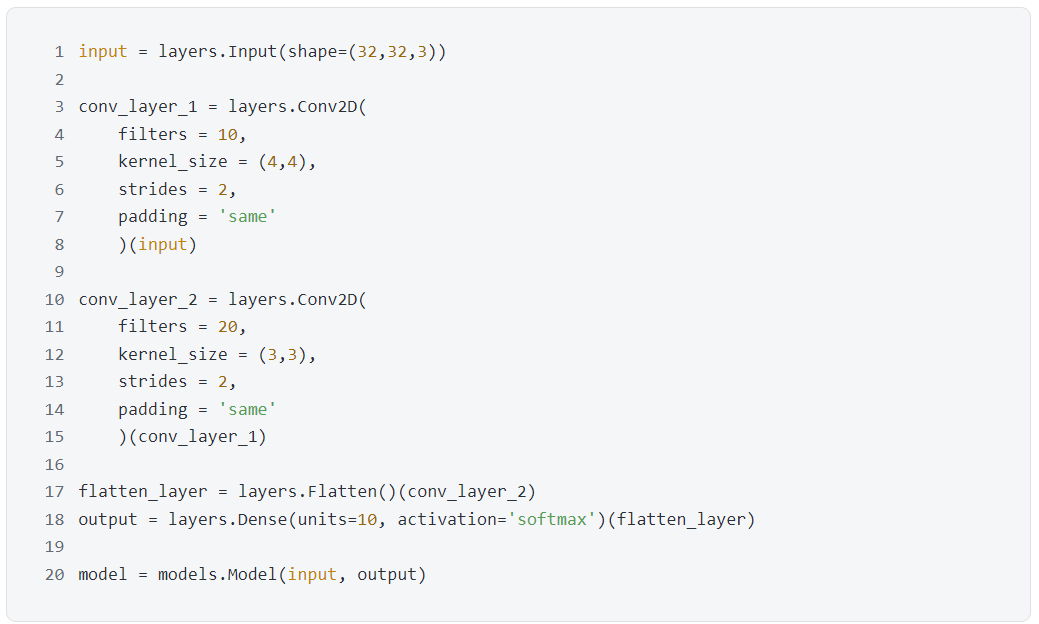
二級標題
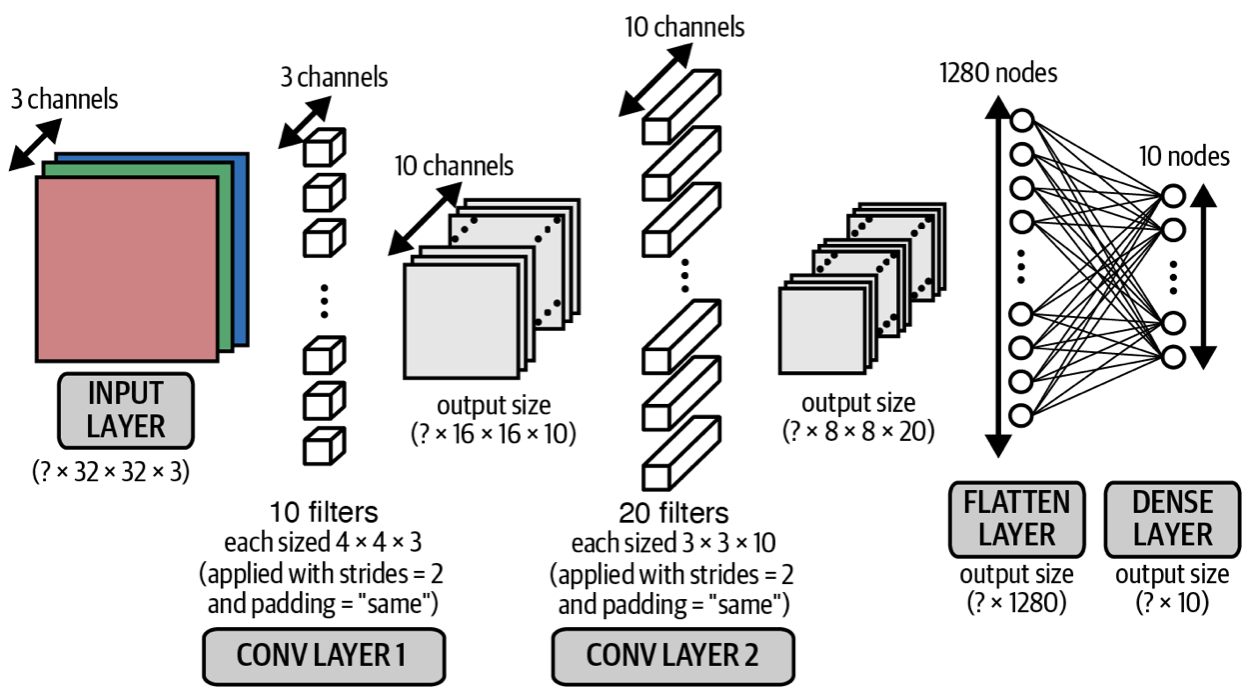
3.2 拼接卷積層 nI 先看一段代碼:f 上段代碼對應著下圖的樣子。s上面每個卷積層輸出的大小讓人眼花繚亂,如果用p代表輸入圖像的大小,nO代表濾波器的大小,
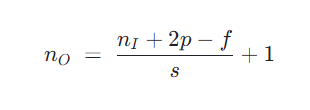
代表步長,
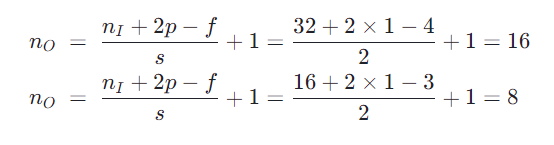
代表填充層數,代表輸入圖像的大小,那麼有以下關係:用這個公式來驗證第一個和第二個卷積層的輸出的寬度和高度:
最重要的東西來了,
卷積層的輸出色道等於濾波器個數(即代碼裡面的參數filters)
。一個直觀理解是每個濾波器並行在“掃描”圖片做卷積,那麼最終產出一定有一個維度大小是濾波器的個數。
檢查一下模型。
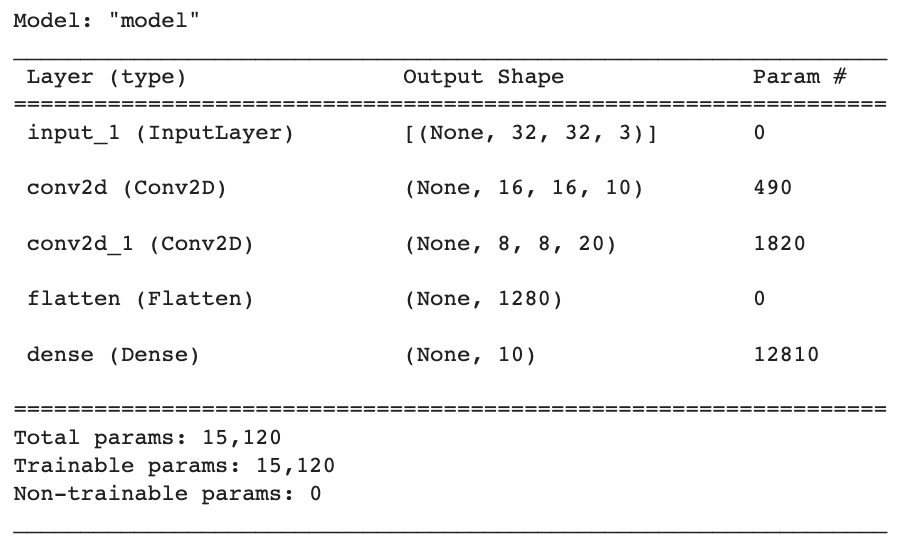
該模型自動被命名“model”,接著一張表分別描述每層的名稱類型(layer (type))、輸出形狀(Output Shape) 和參數個數(Param #)。我們一層層來看
InputLayer 層被命名成input_ 1 ,輸出形狀為[None, 32, 32, 3 ],後面三個元素對應著圖像寬、高和色道,第一個None 其實代表的樣本數,更嚴謹的講是一批(batch) 裡面的樣本數。為了代碼簡潔,這個樣本數在建模時通常不需要顯性寫出來。
第一個Con v 2 D 層被命名為con v 2 d,輸出形狀是[None, 16, 16, 10 ],參數490 = ( 4* 4* 3 + 1) * 10 ,首先不要忘了有偏置單元,其次4* 4 是濾波器的大小, 3 是輸入的色道個數,因此我們需要4* 4* 3 個權重來描述每個濾波器,一共有10 個。
第二個Con v 2 D 層被命名為con v 2 d_ 1 ,輸出形狀是[None, 8, 8, 20 ],參數1, 820 = ( 3* 3* 10 + 1) * 20 ,首先同樣考慮偏置單元,其次3* 3 是濾波器的大小, 10 是輸入的色道個數,因此我們需要3* 3* 10 個權重來描述這個濾波器,一共有20 個。
Flatten 層被命名成flatten, 1, 280 就是8* 8* 20 打平之後的個數,參數個數為0 ,因為打平只是重塑數組,不需要任何參數來完成重塑動作。批量歸一(batch normalization) 和二級標題 (dropout)。
(batch normalization) 和
二級標題均值3.3 批量歸一在訓練CNN 時,模型成功關鍵時要確保權重保持在一定的範圍內,要不然會出現梯度爆炸(exploding gradient) 的情況。批量歸一可以解決此問題,它在每層都會按批(mini-batch) 計算數據的均值γ(mean) 和β。
標準差
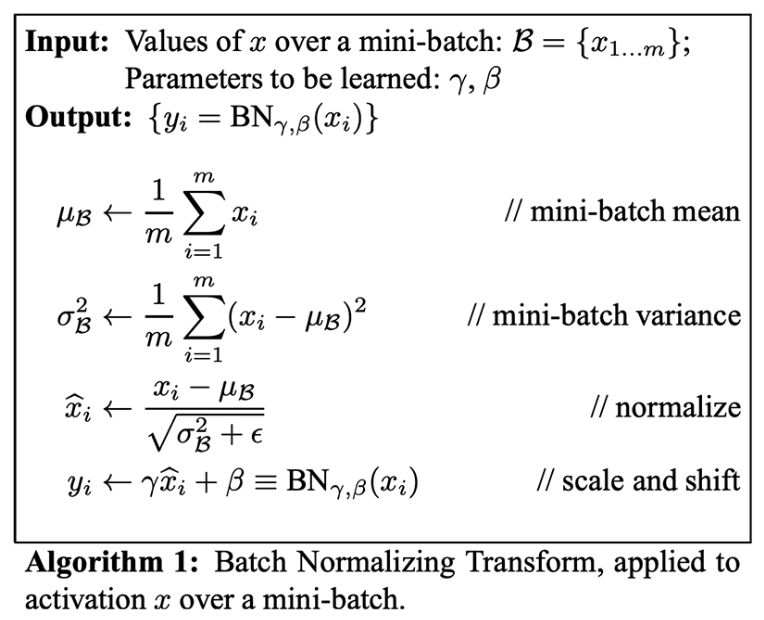
批量歸一的算法如下:
二級標題
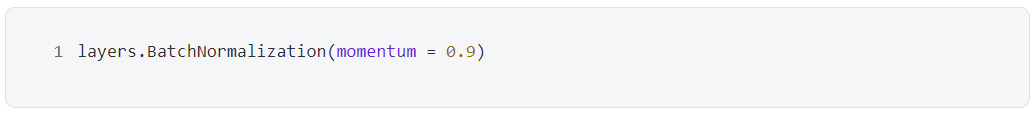
Keras 中用BatchNormalization() 來實現批量歸一層。批量歸一層一般放在稠密層或卷積層之後。
二級標題
二級標題
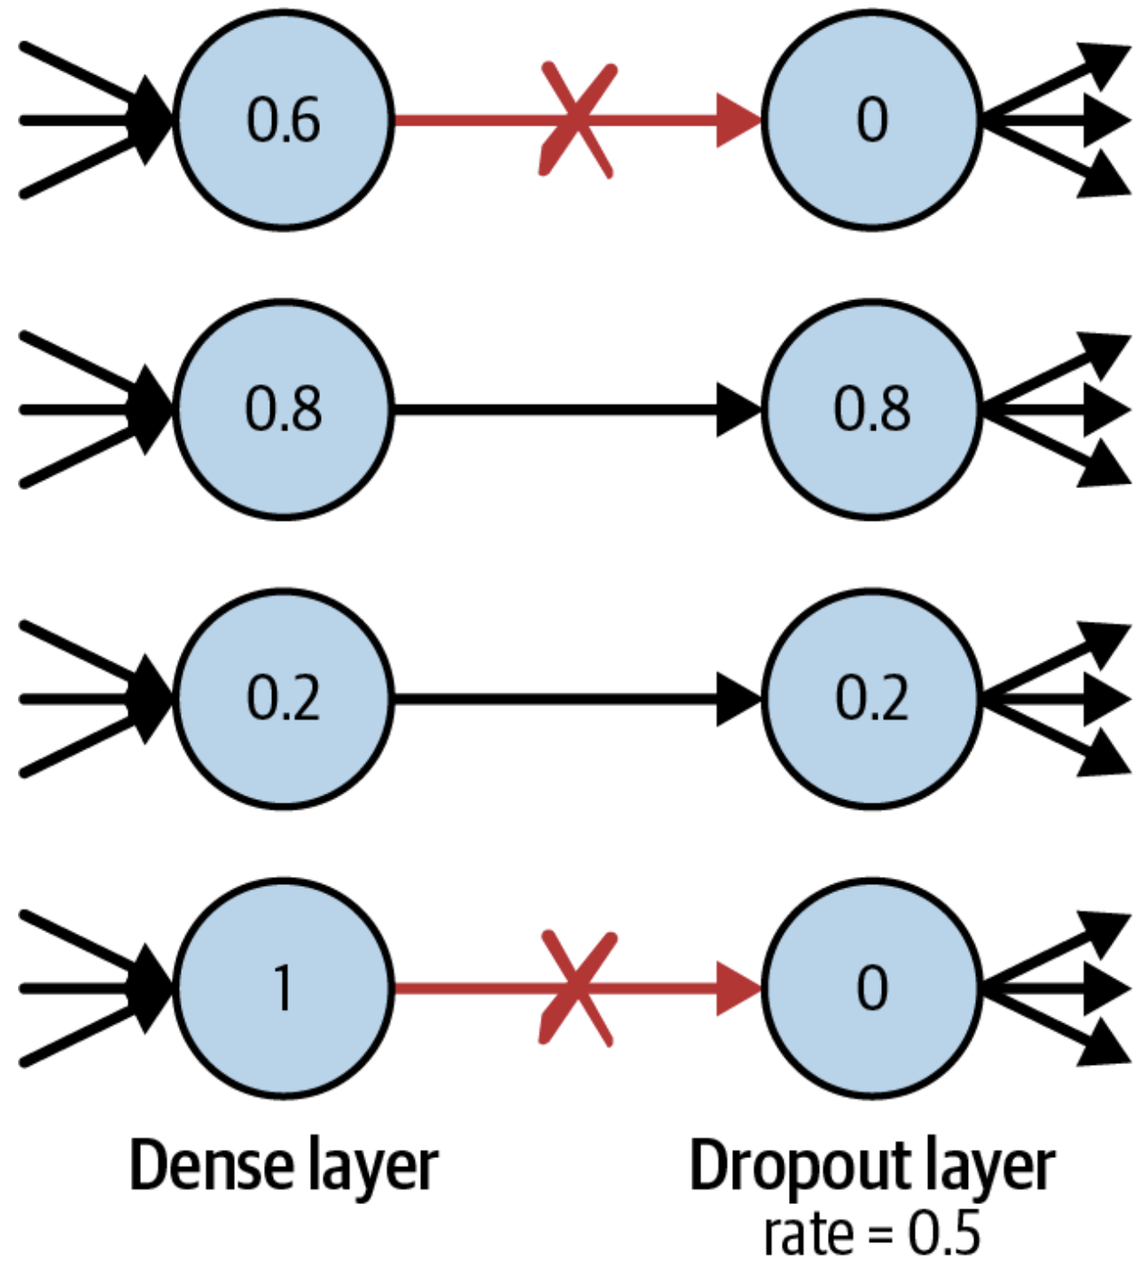
3.4 隨機失活
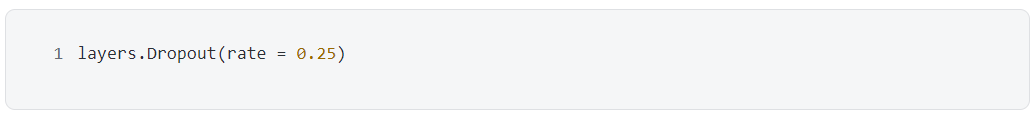
隨機失活的靈感來自考試。通常考試前,學生會做往年的捲子來學習知識點。有的學生死記硬背來解題,這樣到了實際考試中就會表現不好,因為他們沒有真正理解知識點。好的學生會通過卷子來理解通用的知識點,這樣出現新題也能正確解答。Dropout()來實現失活層。失活層一般放在稠密層之後。
二級標題
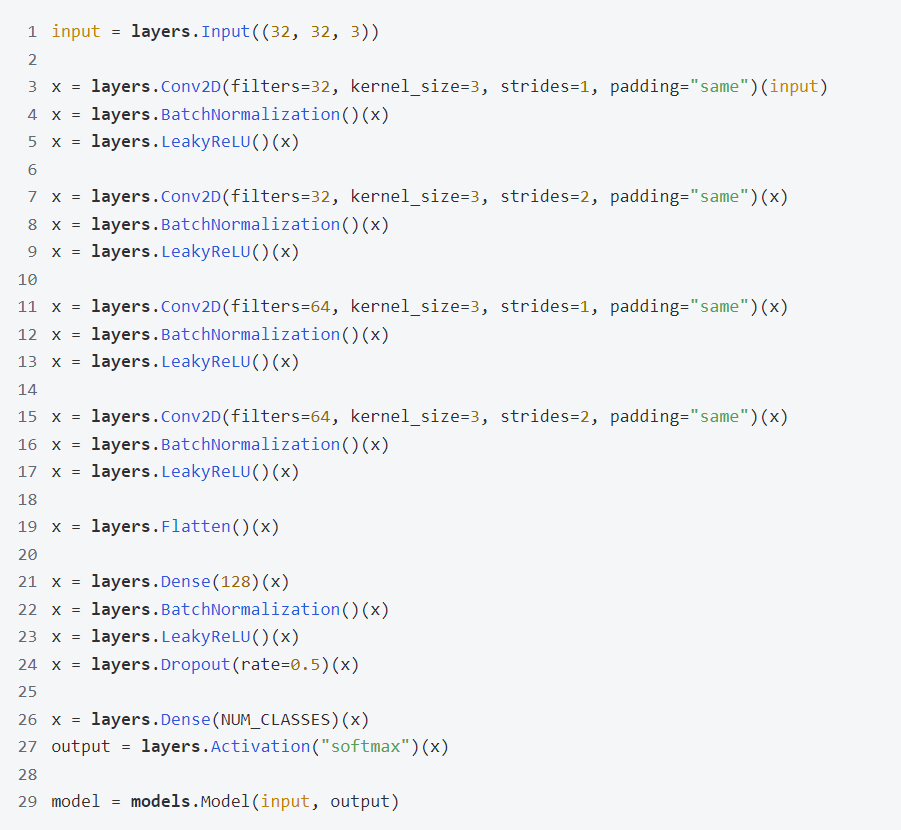
3.5 完整模型
二級標題
二級標題
3.5 完整模型
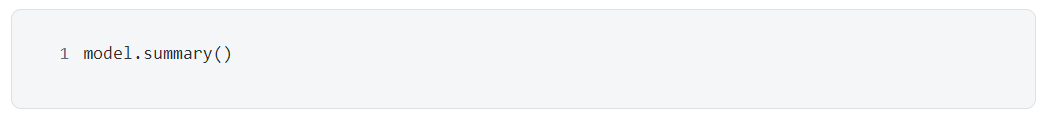
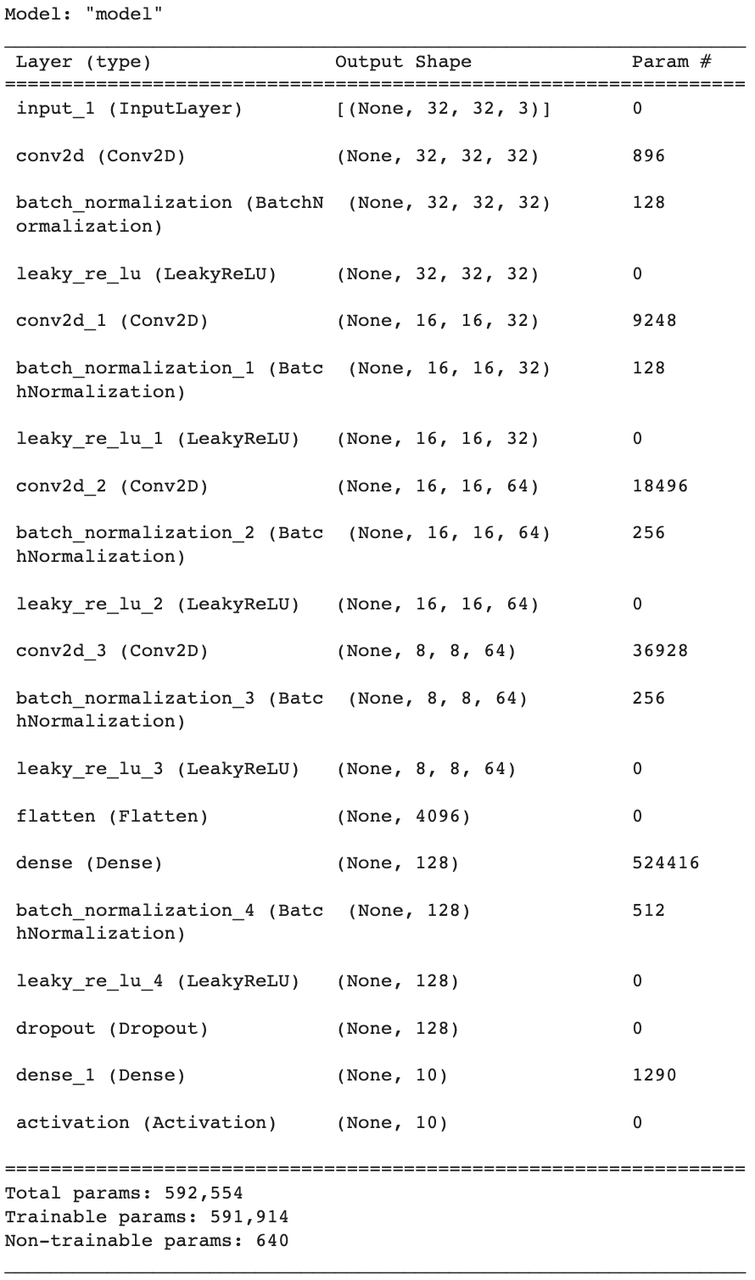
現在我們可以在之前的CNN 加上批量歸一層和失活層來完善模型了。γ再看上面的代碼是不是很好理解了,該CNN 中有四個卷積層,每個後面接一個批量歸一層和一個LeakyReLu 層。注意Keras 裡時萬物皆可作為層,甚至像激活函數也可以用層的形式實現。接著用一個打平層將數據打平,接一個稠密層,個批量歸一層,一個LeakyReLu 層,一個失活層和一個稠密層,最後用softmax 以概率的形式輸出。β和平移參數
二級標題
,以及移動均值和移動標準差,這樣包含參數就等於channel 個數* 4 。
二級標題
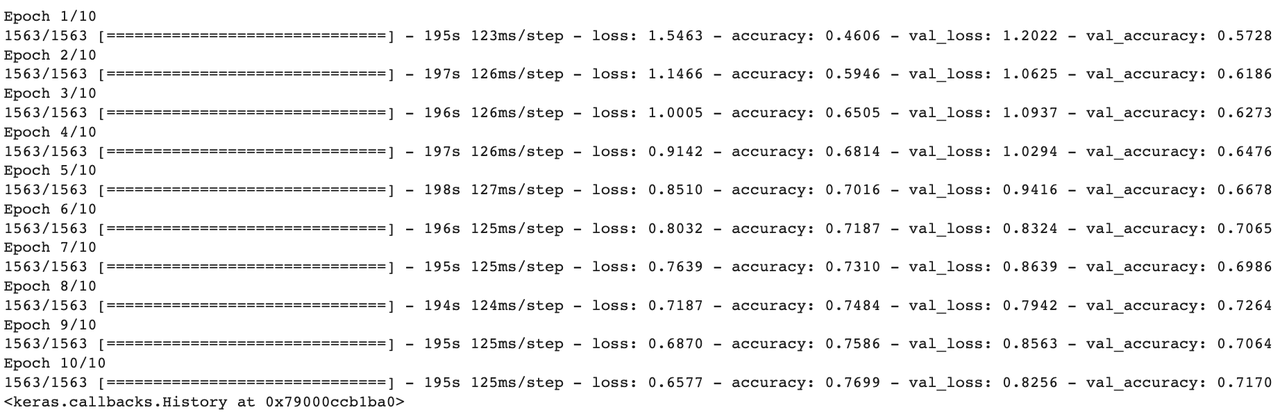
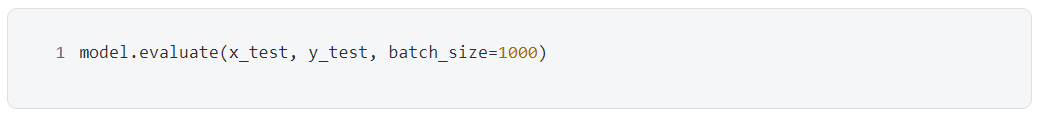

二級標題
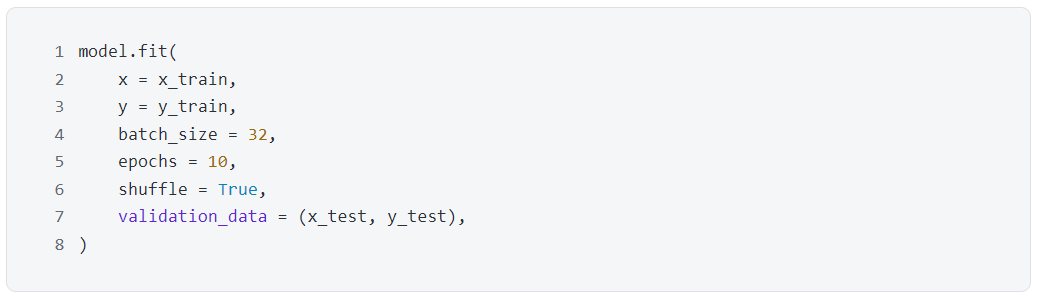
神奇的是,CNN 的參數( 592, 554) 其實比FNN 的參數( 646, 260) 少很多,但模型性能卻提高了不少,而這種提升只需更改模型架構以包括卷積層、批量歸一層和失活層即可實現。雖然CNN 比FNN 的參數少,但是層數確多很多,這就是為什麼深度神經網絡的優勢,因為網絡的中間層捕獲了我們最感興趣的高級特徵(high-level features)。
總結
總結
總結
本篇介紹了開始構建深度生成模型所需的核心深度學習概念。使用Keras 構建前饋神經網絡(FNN),並訓練模型來預測CIFAR-10 數據集中給定圖像的類別。然後,我們通過引入卷積層、批量歸一層和失活層來改進此架構,以創建卷積神經網絡(CNN)。
您可在ChatGPT 4.0 的Plugin Store 搜索SignalPlus ,獲取實時加密資訊。如果想即時收到我們的更新,歡迎關注我們的推特賬號@SignalPlus_Web 3 ,或者加入我們的微信群(添加小助手微信:chillywzq)、Telegram 群以及Discord 社群,和更多朋友一起交流互動。
您可在ChatGPT 4.0 的Plugin Store 搜索SignalPlus ,獲取實時加密資訊。如果想即時收到我們的更新,歡迎關注我們的推特賬號@SignalPlus_Web 3 ,或者加入我們的微信群(添加小助手微信:chillywzq)、Telegram 群以及Discord 社群,和更多朋友一起交流互動。
SignalPlus Official Website: https://www.signalplus.com





